Tek kameralı derinlik tahmini nedir? Genel bakış
Tek kameralı derinlik tahmininin nasıl çalıştığını, sensör tabanlı derinlik yöntemleriyle nasıl karşılaştırıldığını ve görüntü sistemlerinde ölçeklenebilir 3B algıyı nasıl mümkün kıldığını öğren.
 Abirami Vina15 dakikalık okuma
Otonom araçlar, güvenli bir şekilde sürüş yapabilmek için çevrelerinde neler olduğunu anlayacak biçimde tasarlanır. Bu, yayaları veya diğer araçları tanımaktan daha fazlasını gerektirir.
Doğru tepki verebilmeleri için bu nesnelerin ne kadar uzakta olduğunu da bilmeleri gerekir. Ancak makinelere mesafe algısı kazandırmak kolay değildir. İnsanlardan farklı olarak makineler görüntülerden derinliği doğal olarak algılayamaz; bunu yapabilmeleri için açıkça eğitilmeleri gerekir.
Bunun nedenlerinden biri, çoğu kameranın dünyayı düz, iki boyutlu görüntüler olarak kaydetmesidir. Bu görüntüleri gerçek dünyadaki derinliği ve 3B yapıyı yansıtan bir şeye dönüştürmek, özellikle sistemlerin günlük koşullarda güvenilir şekilde çalışması gerektiğinde zordur.
İlginçtir ki görsel verileri yorumlamaya ve anlamaya odaklanan bir yapay zekâ dalı olan bilgisayarlı görü, makinelerin görüntülerden dünyayı daha iyi anlamasını mümkün kılar. Örneğin tek kameralı derinlik tahmini, nesnelerin mesafesini yalnızca tek bir kamera görüntüsü kullanarak tahmin eden bir bilgisayarlı görü tekniğidir.
Nesne boyutu, perspektif, doku ve gölgeleme gibi görsel ipuçlarını öğrenen bu modeller, LiDAR (Işık Algılama ve Mesafe Ölçümü) veya stereo kameralar gibi ek sensörlere ihtiyaç duymadan derinliği tahmin edebilir. Bu makalede tek kameralı derinlik tahmininin ne olduğunu, nasıl çalıştığını ve gerçek dünyadaki bazı uygulamalarını inceleyeceğiz.
Tek kameralı derinlik tahminine kısa bir giriş#
Tek kameralı derinlik tahmini, bir makinenin yalnızca tek bir görüntü kullanarak nesnelerin kendisinden ne kadar uzakta olduğunu anlamasını sağlar. Yalnızca tek bir kameraya dayandığı için bu yaklaşım, daha düşük maliyet ve daha basit donanım gereksinimleri gibi çeşitli avantajlar sunar.
Örneğin, tek kamerayla çalışan uygun fiyatlı ev robotlarında kullanılabilir. Robotik sistem tek bir görüntüden bile hangi duvarların daha yakın, hangi kapıların daha uzakta olduğunu belirleyebilir ve ortamın genel derinliğini çıkarabilir.
Tek bir görüntüde çoğu zaman doğru ölçekte bilgi bulunmadığından, tek kameralı derinlik tahmini genellikle göreli derinliğe odaklanır. Başka bir deyişle, kesin mesafeler bilinmese bile hangi nesnelerin daha yakın, hangilerinin daha uzakta olduğunu belirleyebilir.
Bir model, LiDAR gibi sensörlerden alınan derinlik ölçümleri gibi gerçek değerli mesafeler veya mutlak derinlik içeren verilerle eğitildiğinde mesafeleri metre gibi gerçek dünya birimleriyle tahmin etmeyi öğrenebilir. Bu tür referans veriler olmadan model yine göreli derinliği çıkarabilir ancak mutlak mesafeleri güvenilir şekilde tahmin edemez.
Tek kameralı derinlik tahmininin çıktısı genellikle derinlik haritasıdır; bu, her pikselin sahnenin ilgili kısmının ne kadar yakın veya uzakta olduğunu gösterdiği bir görüntüdür. Derinlik haritası, görsel sistemlere ortamın 3B yapısını temel düzeyde anlama olanağı sağlar.
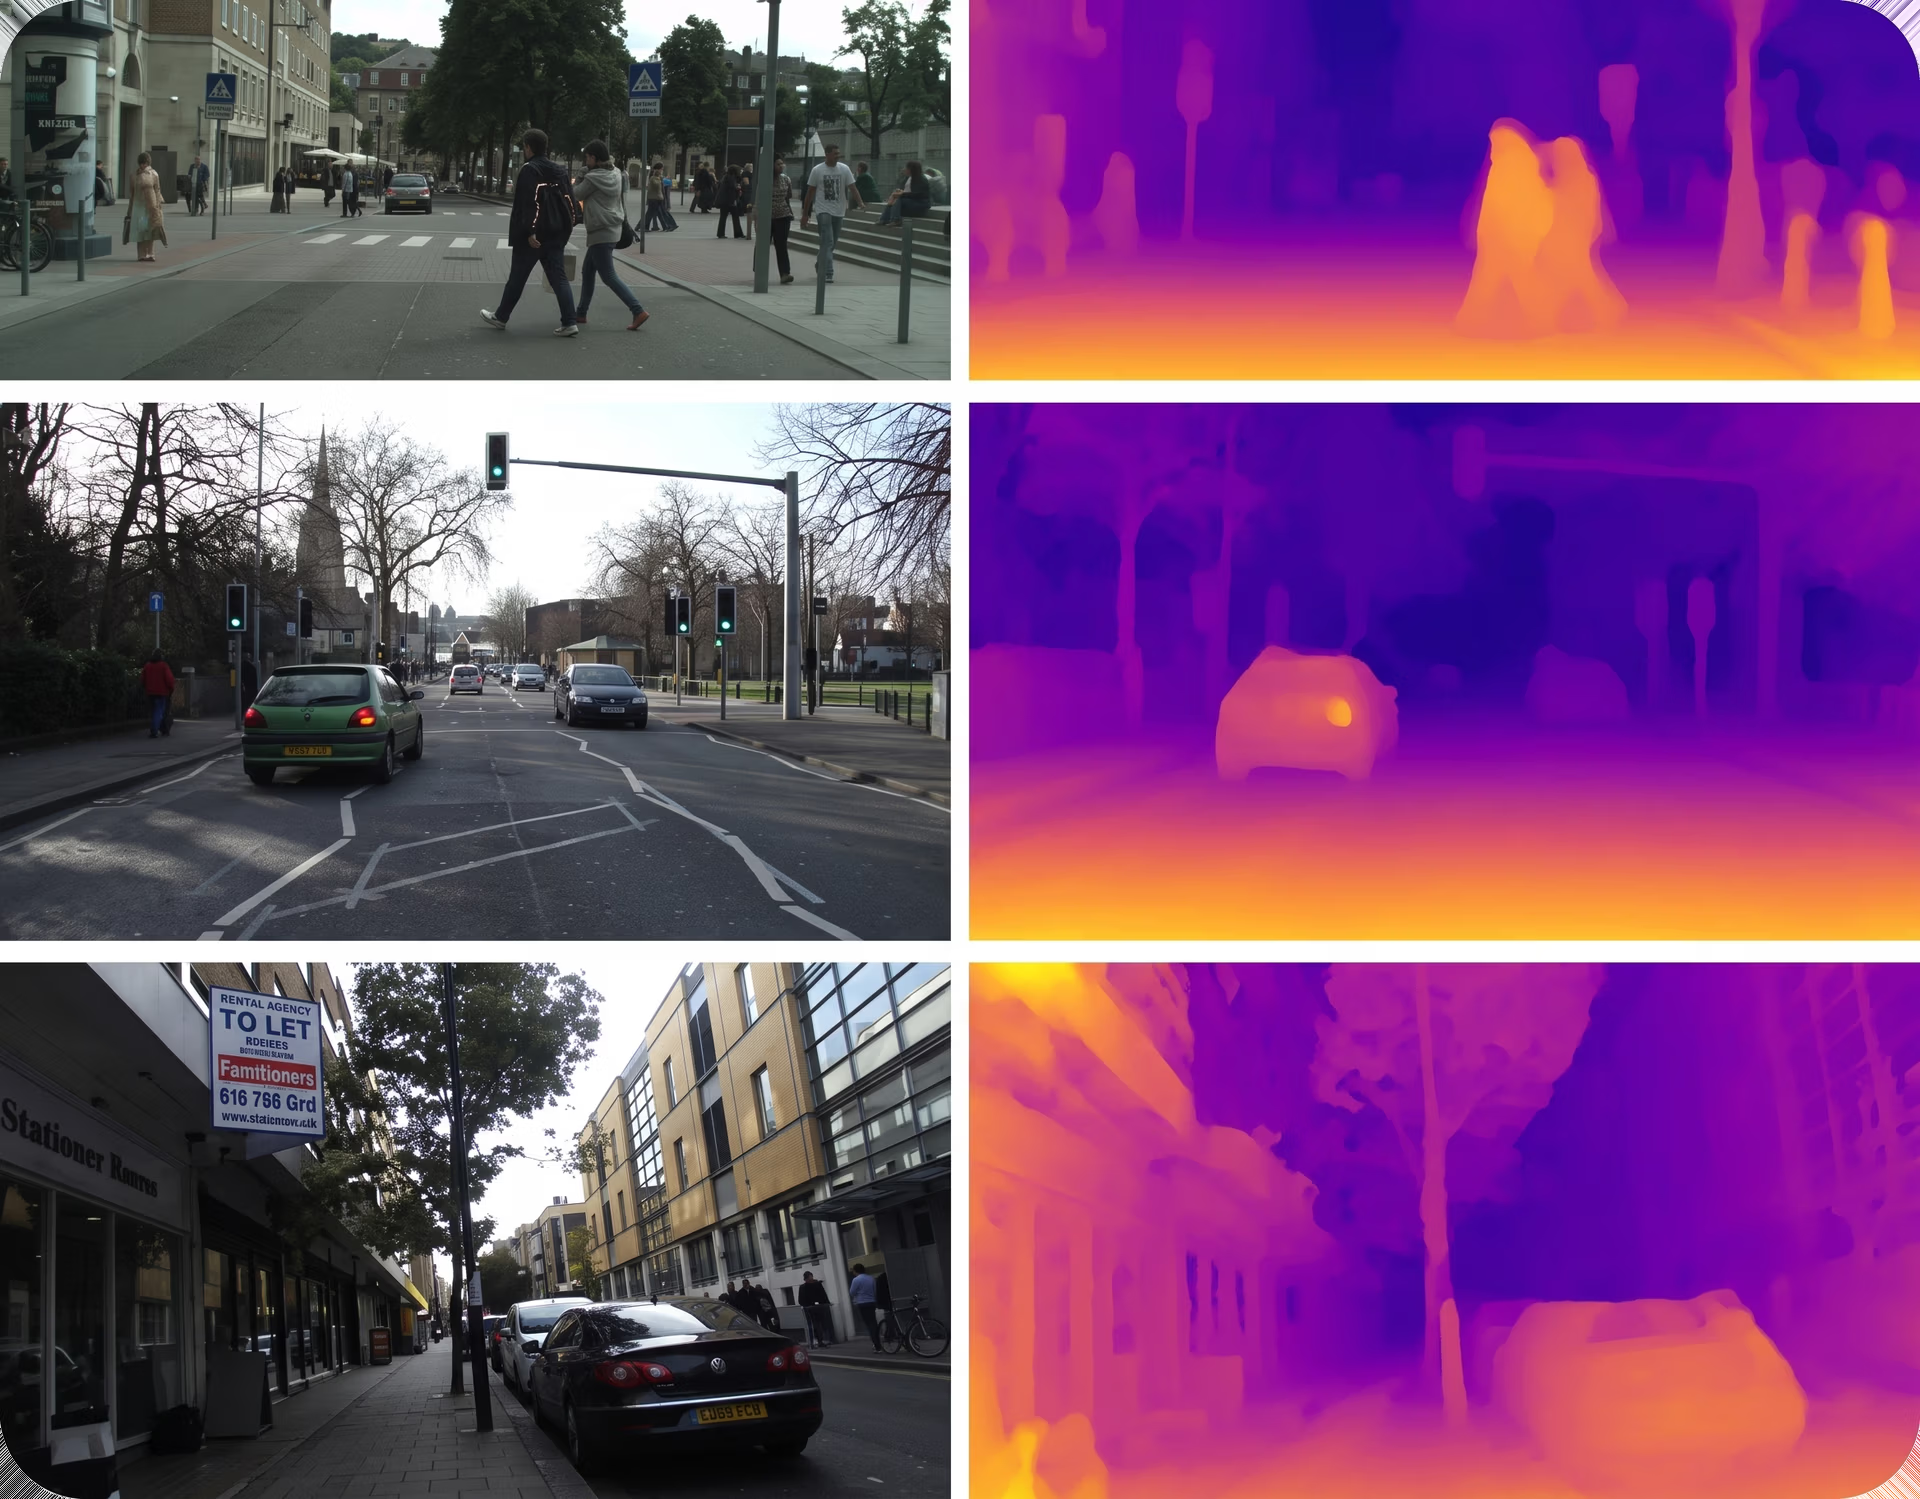
Şekil 1. Tek kameralı derinlik tahminiyle oluşturulan tahmini derinlik haritası örneği (Kaynak)
Sensörlerden görüntülere: Derinlik tahmini#
Derinlik tahmini; mevcut sensörlere, donanım kısıtlamalarına ve doğruluk gereksinimlerine bağlı olarak çeşitli yöntemlerle yapılabilir. Geleneksel yöntemler, mesafeyi doğrudan ölçmek için çoğunlukla birden fazla bakış noktasına veya özel sensörlere dayanır.
Yaygın yaklaşımlardan biri, biraz farklı bakış noktalarından çekilmiş, eşzamanlı iki görüntüyü karşılaştırarak derinliği tahmin eden stereo görüdür. Sistem, iki görüntüdeki eşleşen noktalar arasındaki farkı ölçerek nesnelerin kameradan ne kadar uzakta olduğunu çıkarabilir.
Bir diğer yaklaşım, her pikseldeki mesafeyi doğrudan ölçmek için etkin derinlik sensörleri kullanan RGB-D (Kırmızı, Yeşil, Mavi ve Derinlik) sistemleridir. Bu sistemler kontrollü ortamlarda doğru derinlik bilgisi sağlayabilir, ancak ek donanım gerektirir.
LiDAR tabanlı yöntemler ise sahnenin hassas üç boyutlu temsillerini oluşturmak için lazer darbeleri kullanır. Son derece doğru olsalar da LiDAR sensörleri genellikle pahalıdır ve donanım karmaşıklığını önemli ölçüde artırır.
Buna karşılık tek kameralı derinlik tahmini, derinliği yalnızca tek bir RGB görüntüsü kullanarak çıkarır. Birden fazla kameraya veya özel sensörlere dayanmadığı için geniş ölçekte dağıtımı daha kolaydır ve maliyetin ya da donanım kaynaklarının sınırlı olduğu durumlarda iyi bir seçenektir.
Tek bir görüntüden derinliği öğrenmek#
Tek bir görüntüden derinlik tahmini yaparken tek kameralı derinlik modelleri, insanların mesafeyi sezgisel olarak değerlendirmek için kullandığı görsel ipuçlarını tanımayı öğrenir. Bu ipuçları arasında perspektif çizgileri, nesne boyutu, doku yoğunluğu, nesnelerin örtüşmesi ve gölgelendirme bulunur; bunların tümü, nesnelerin kameradan ne kadar uzakta olduğuna dair ipuçları verir.
Bu ipuçları birlikte çalışarak derinlik algısı oluşturur. Daha küçük görünen veya kısmen örtülen nesneler genellikle daha uzaktadır; daha net ayrıntılar ve daha büyük görünen nesneler ise çoğunlukla daha yakında olduklarını gösterir.
Bu örüntüleri öğrenmek için tek kameralı derinlik modelleri, çoğunlukla LiDAR veya stereo sistemler gibi başka kaynaklardan elde edilen derinlik bilgileriyle eşleştirilmiş büyük ölçekli görüntü veri kümeleri üzerinde eğitilir. Eğitim sırasında modeller, görsel ipuçlarının derinlikle nasıl ilişkili olduğunu öğrenerek çıkarım sırasında tek bir görüntüden mesafeyi tahmin edebilir.
Çeşitli eğitim verileri sayesinde modern görsel modeller, bu öğrenilmiş anlayışı iç ve dış mekân sahneleri dâhil çok çeşitli ortamlara genelleyebilir ve alışılmadık bakış açılarıyla başa çıkabilir.
Çeşitli tek kameralı derinlik tahmini tekniklerine bakış#
Şimdi tek bir görüntüden derinlik tahmin etmek için kullanılan temel yaklaşımları ve bu yöntemlerin zaman içinde nasıl geliştiğini inceleyeceğiz.
Klasik ve geometri tabanlı yaklaşımlar#
İlk derinlik tahmini yöntemleri, kamera geometrisiyle ilişkili basit görsel kurallara dayanıyordu. Mesafeyi tahmin etmek için perspektif, nesne boyutu ve bir nesnenin diğerini engelleyip engellemediği gibi ipuçları kullanılıyordu.
Örneğin, benzer iki nesne farklı boyutlarda göründüğünde küçük olanın daha uzakta olduğu varsayılıyordu. Aydınlatma, kamera konumu ve sahne düzeni gibi etkenlerin tutarlı kaldığı kontrollü ortamlarda bu yaklaşımlar makul ölçüde iyi çalışıyordu.
Ancak gerçek dünya sahnelerinde bu varsayımlar çoğu zaman geçerliliğini yitirir. Aydınlatma değişiklikleri, bakış açısının değişmesi ve sahne karmaşıklığının artması güvenilmez derinlik tahminlerine yol açabilir ve klasik yöntemlerin kontrolsüz ortamlardaki etkinliğini sınırlar.
İlk makine öğrenimi yaklaşımları#
İlk makine öğrenimi yöntemleri, örüntüleri doğrudan verilerden öğrenerek derinlik tahminine daha fazla esneklik kazandırdı. Bu modeller yalnızca sabit geometrik kurallara dayanmak yerine görsel bilgi ile mesafe arasındaki ilişkiyi öğrenmeye çalışıyor, derinlik tahminini kenarlar, dokular ve renk değişimleri gibi ipuçlarına dayalı bir regresyon problemi olarak ele alıyordu.
Bu özellikleri seçmek sürecin önemli bir parçasıydı. Mühendislerin hangi görsel sinyallerin çıkarılacağına ve bunların nasıl temsil edileceğine karar vermesi gerekiyordu; modelin performansı büyük ölçüde bu seçimlere bağlıydı.
Bu yaklaşım önceki yöntemlerden daha iyi çalışsa da hâlâ sınırlamaları vardı. Seçilen özellikler önemli bağlam bilgilerini içermediğinde derinlik tahminleri daha az doğru oluyordu. Sahneler daha karmaşık ve çeşitli hâle geldikçe bu modeller çoğunlukla güvenilir sonuçlar üretmekte zorlanıyordu.
Derin öğrenme algoritmaları#
Modern tek kameralı derinlik tahmini sistemlerinin çoğu, verilerden karmaşık örüntüler öğrenebilen çok katmanlı sinir ağlarını ifade eden derin öğrenmeyi kullanır. Bu modeller derinliği doğrudan görüntülerden tahmin etmeyi öğrenir ve derinlik haritaları üretir.
Birçok yaklaşım, kenarlar ve şekiller gibi örüntüleri tespit ederek görüntüleri işlemek üzere tasarlanmış bir sinir ağı türü olan evrişimli sinir ağları (CNNs) kullanılarak oluşturulur. Bu modellerde genellikle kodlayıcı-kod çözücü düzeni kullanılır: kodlayıcı görüntüden görsel özellikleri çıkarır, kod çözücü ise bu özellikleri derinlik haritasına dönüştürür. Görüntünün birden fazla ölçekte işlenmesi, modelin belirgin nesne sınırlarını korurken sahnenin genel düzenini de kavramasına yardımcı olur.
Daha yeni modeller, görüntünün farklı bölümleri arasındaki ilişkileri anlamaya odaklanır. Transformer tabanlı ve Vision Transformer (ViT) modelleri, modelin görüntünün en önemli bölgelerini belirlemesini ve birbirinden uzak bölgeleri ilişkilendirmesini sağlayan dikkat mekanizmaları kullanır. Bu, modelin tüm sahnedeki derinliği daha tutarlı şekilde anlamasına yardımcı olur.
Bazı sistemler her iki fikri birleştirir. Hibrit CNN–Transformer modelleri ince yerel ayrıntıları yakalamak için CNN’leri, sahnenin küresel bağlamını modellemek içinse Transformer’ları kullanır. Bu yaklaşım çoğunlukla doğruluğu artırsa da genellikle ek bellek ve işlem gücü gibi daha fazla hesaplama kaynağı gerektirir.
Görsel yapay zekâ sistemleri için derinliği anlamak neden önemlidir?#
Tek kameralı derinlik tahmini hakkında bilgi edinirken derinliği anlamanın görsel tabanlı yapay zekâ sistemlerinin neden bu kadar önemli bir parçası olduğunu merak ediyor olabilirsin.
Bir sistem nesnelerin ve yüzeylerin ne kadar uzakta olduğunu tahmin edebildiğinde sahnenin nasıl düzenlendiğini ve farklı öğelerin birbiriyle nasıl ilişkili olduğunu daha iyi anlar. Bu tür bir uzamsal farkındalık, özellikle otonom sürüş gibi gerçek dünya uygulamalarında güvenilir kararlar almak için gereklidir.
Derinlik bilgisi, diğer bilgisayarlı görü görevlerine de değerli bağlam katar. Örneğin Ultralytics YOLO26 gibi modellerle desteklenen nesne tespiti, sisteme sahnede ne olduğunu söyleyebilir; derinlik ise bu nesnelerin kameraya ve birbirlerine göre nerede bulunduğunu anlamaya yardımcı olur.
Bu yetenekler birlikte 3B haritalar oluşturma, karmaşık ortamlarda gezinme ve sahneyi bir bütün olarak anlama gibi çok çeşitli görsel yapay zekâ uygulamalarını mümkün kılar.
Robotlar ve otonom araçlar güvenli hareket etmek, engellerden kaçınmak ve değişikliklere gerçek zamanlı tepki vermek için bu bilgiye ihtiyaç duyar. Örneğin Tesla’nın yalnızca görme sistemine dayalı sürüş yaklaşımı, nesnelerin ne kadar uzakta olduğunu ve yolda nasıl konumlandığını anlamak için LiDAR yerine kamera görüntülerini derinlik tahminiyle birleştirir.
Tek kameralı derinlik tahmini modelleri nasıl çalışır?#
Model mimarileri farklılık gösterse de tek kameralı derinlik tahmini modellerinin çoğu, tek bir görüntüyü derinlik haritasına dönüştürmek için benzer bir süreç izler. Sürecin temel adımlarına hızlıca göz atalım:
- Girdi ve ön işleme: İş akışı bir girdi görüntüsüyle başlar. Modelin girdisi hâline getirilmeden önce özgün görüntü genellikle yeniden boyutlandırılır, normalize edilir ve sinir ağlarının görüntü verilerini verimli şekilde işlemesini sağlayan bir biçim olan tensöre dönüştürülür.
- Özellik çıkarımı: Kodlayıcı ağı, anlamlı görsel özellikleri çıkarmak için görüntüyü analiz eder. Bu özellikler doku, nesne sınırları ve sahnenin genel düzeni gibi bilgileri yakalar. Çoğu model hem ince ayrıntıları hem de genel yapıyı anlayabilmek için birden fazla ölçekte çalışır.
- Derinlik çıkarımı: Model, çıkarılan özellikleri kullanarak sahnedeki uzamsal ilişkiler hakkında çıkarım yapmak için yerel ayrıntıları küresel bağlamla birleştirir. Bu aşamada görüntünün hangi bölgelerinin kameraya daha yakın, hangilerinin daha uzakta olduğunu öğrenir.
- Derinlik haritası oluşturma: Ardından bir kod çözücü bu bilgileri yoğun bir derinlik haritasına dönüştürür. Görüntüdeki her piksele bir derinlik değeri atanır; doğruluğu ve tutarlılığı artırmak için bu değerler genellikle farklı ölçeklerdeki tahminlerin birleştirilmesiyle elde edilir.
Tek kameralı derinlik tahmini modelleri nasıl eğitilir?#
Az önce ele aldığımız süreç, önceden eğitilmiş bir modelimizin olduğunu varsayıyor. Peki tek kameralı derinlik tahmini modeli eğitimi gerçekte nasıl işliyor?
Eğitim, görüntü verilerinin ağ tarafından verimli şekilde işlenebilmesi için hazırlanmasıyla başlar. Girdi görüntüleri yeniden boyutlandırılır ve tutarlı bir ölçeğe göre normalize edilir; ardından her pikseldeki mesafeyi tahmin eden bir derinlik haritası oluşturması için modelden geçirilir.
Daha sonra tahmini derinlik haritası, modelin tahmininin gerçek değer derinlikten ne kadar farklı olduğunu ölçen bir kayıp fonksiyonu kullanılarak referans derinlik verileriyle karşılaştırılır. Bu kayıp değeri modelin o anki hatasını gösterir ve iyileştirme için bir sinyal sağlar.
Bir optimize edici, modelin iç ağırlıklarını ayarlayarak bu sinyali kullanır ve modeli günceller. Bunun için optimize edici, kaybın her model parametresine göre nasıl değiştiğini açıklayan gradyanı hesaplar ve bu güncellemeleri birden fazla dönem boyunca ya da eğitim veri kümesinin tamamı üzerinden tekrar tekrar uygular.
Bu yinelemeli denetimli eğitim sürecinde, her güncelleme adımının ne kadar büyük olacağını belirleyen öğrenme oranı ve aynı anda kaç görüntünün işleneceğini belirleyen yığın boyutu gibi hiperparametrelerden yararlanılır. Eğitim çok sayıda matematiksel işlem içerdiğinden, genellikle paralel hesaplamada başarılı olan grafik işlem birimi (GPU) kullanılarak hızlandırılır.
Eğitim tamamlandıktan sonra model, eğitim sırasında kullanılmamış görüntülerden oluşan bir doğrulama kümesinde standart değerlendirme ölçütleri kullanılarak değerlendirilir. Bu değerlendirme, modelin yeni verilere ne kadar iyi genelleme yaptığını ölçmeye yardımcı olur.
Eğitilen model daha sonra yeniden kullanılabilir veya yeni senaryolara göre ince ayar yapılabilir. Genel olarak bu eğitim süreci, tek kameralı derinlik tahmini modellerinin 3B yeniden oluşturma ve gerçek dünyaya dağıtım gibi sonraki görevler için gerekli olan tutarlı derinlik tahminleri üretmesini sağlar.
Son teknoloji modelleri ve araştırma eğilimlerini incelemek#
Modeller küçük görsel ayrıntılardan ziyade tüm sahneyi anlamada geliştikçe tek kameralı derinlik tahmini de hızla ilerledi. İlk yaklaşımlar, özellikle karmaşık ortamlarda çoğunlukla tutarsız derinlik haritaları üretiyordu.
arXiv'de yayımlanan güncel araştırmalarda görüldüğü üzere daha yeni modeller, genel bağlama daha fazla odaklanıyor ve bunun sonucunda derinlik tahminleri daha kararlı ve gerçekçi görünüyor. MiDaS ve DPT gibi tanınmış modeller, farklı ve yüksek çözünürlüklü veri kümelerinden derinlik öğrenip çok çeşitli sahnelere iyi genelleme yaparak bu değişimin önünü açtı.
ZoeDepth ve Depth Anything V2 dahil daha yeni modeller, geniş bir ayar yelpazesinde güçlü performanslarını korurken ölçek tutarlılığını iyileştirerek bu çalışmaları ileri taşıyor. Bu tür ilerlemeler genellikle hem dış hem de iç mekân sahnelerini kapsayan KITTI ve NYU Depth V2 gibi yaygın kıyaslama veri kümeleriyle ölçülür.
Bir diğer belirgin eğilim, doğruluğu pratiklikle dengelemektir. Daha küçük modeller hız için optimize edilir ve uç ya da mobil cihazlarda gerçek zamanlı çalışabilir; daha büyük modeller ise daha yüksek çözünürlüğe ve uzak mesafelerde derinlik doğruluğuna öncelik verir. Örneğin, Ultralytics YOLO26 derinlik modelleri, gerçek zamanlı uç kullanımı için hafif YOLO26n-depth modelinden daha büyük ve daha doğru YOLO26x-depth modeline kadar uzanır.
Tek kameralı derinlik tahmini uygulamaları#
Şimdi tek bir görüntüden sahnenin 3B yapısı hakkında çıkarım yapmak için tek kameralı derinlik tahmininin nasıl kullanıldığını gösteren bazı gerçek dünya örneklerine bakalım.
Tüm bu örneklerde derinlik bilgisinin kesin bir ölçüm değil, görsel ipuçlarından çıkarılan bir tahmin olduğunu unutmamak önemlidir. Bu nedenle tek kameralı derinlik tahmini, göreli düzeni ve uzamsal ilişkileri anlamak için yararlıdır; ancak LiDAR veya stereo sistemler gibi mesafeyi doğru ölçmek üzere tasarlanmış sensörlerin yerini tutmaz.
Drone tabanlı arazi haritalama ve navigasyon#
Dronlar genellikle ormanlar, şantiyeler, afet bölgeleri veya yoğun kentsel alanlar gibi GPS sinyallerinin güvenilmez olduğu ortamlarda çalışır. Bu koşullarda güvenli uçabilmeleri için çevredeki araziyi anlamaları ve engellerin ne kadar uzakta olduğunu bilmeleri gerekir. Geçmişte bunun için genellikle LiDAR veya stereo kameralar gibi ağırlığı, güç tüketimini ve toplam maliyeti artıran sensörler eklemek gerekiyordu.
Tek kameralı derinlik tahmini daha basit bir alternatiftir. Dronlar yalnızca tek bir RGB kamera kullanarak görüntülerden derinliği tahmin edebilir ve çevrelerinin temel bir 3B anlayışını oluşturabilir. Böylece bina, ağaç veya arazideki ani değişiklikler gibi engelleri tespit edip uçuş rotalarını gerçek zamanlı olarak ayarlayabilirler.
Bu derinlik tahminleri; engellerden kaçınma, irtifa kontrolü ve güvenli iniş dâhil temel navigasyon görevlerini destekler. Sonuç olarak hafif dronlar, özel derinlik sensörlerine dayanmadan haritalama, denetim ve navigasyon görevlerini gerçekleştirebilir.
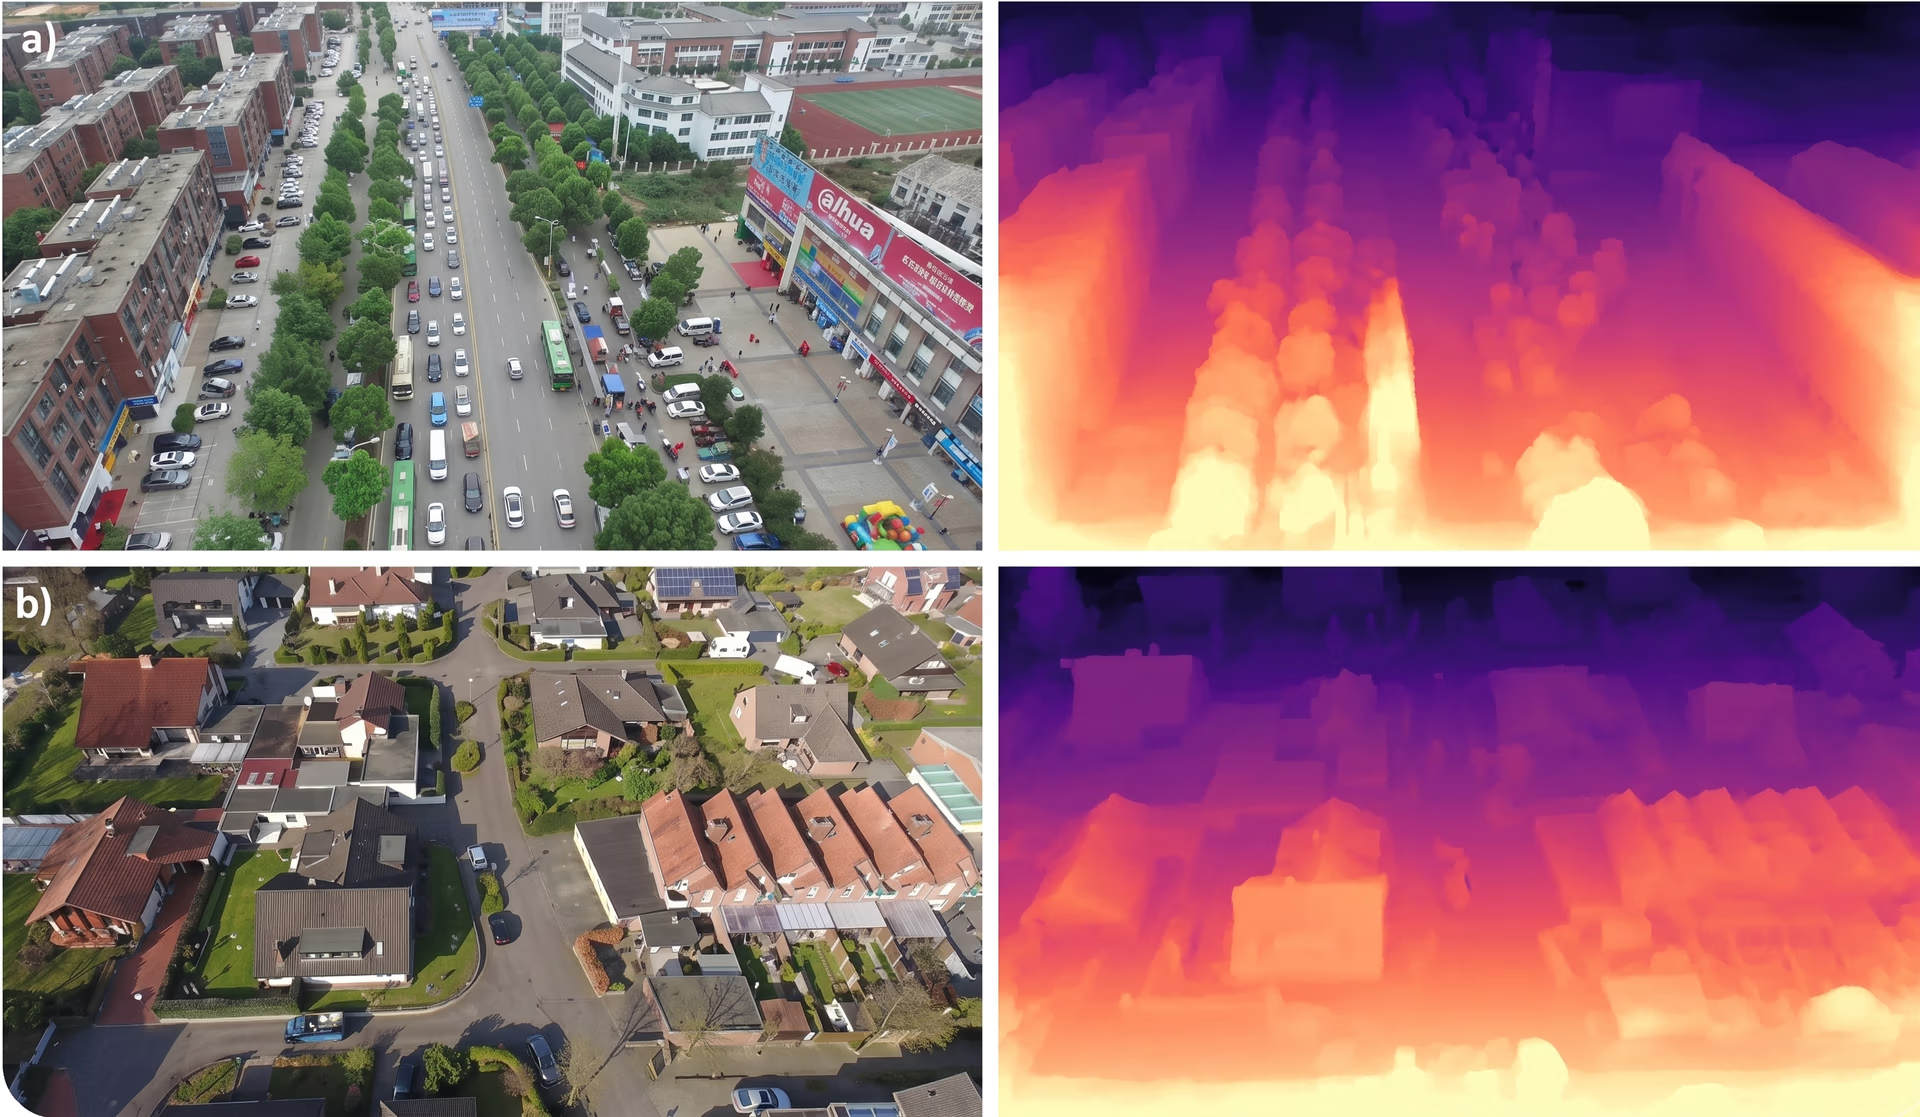
Şekil 2. Drone görüntülerini analiz etmek için tek kameralı derinlik tahmini kullanılabilir (Kaynak)
Otonom yarış araçlarının kör noktalarını doldurmak#
Otonom araçlar genellikle mesafeyi ölçmek ve yolun 3B görünümünü oluşturmak için lazer darbeleri kullanan LiDAR sensörlerine büyük ölçüde dayanır. LiDAR son derece doğru olsa da keskin yol çıkıntılarında, dik yokuşlarda, örtülmede veya aracın aniden eğilmesinde zorlanabilir ve bazen seyrek ya da eksik derinlik verileri döndürebilir.
Monoküler derinlik kestirimi, LiDAR verileri eksik olsa bile tek bir RGB görüntüsünden yoğun derinlik bilgisi sağlayarak bu boşlukları doldurmaya yardımcı olabilir. Otonom bir otomobil yokuşun tepesine hızla yaklaşırken yaşanan bir durumu düşün. LiDAR ışınları tepenin ötesindeki yolu ıskalayabilir ve ileride ne olduğu konusunda belirsizlik yaratabilir.
Bununla birlikte, kamera tabanlı derinlik kestirimi perspektif ve doku gibi görsel ipuçlarından yolun şeklini yine de çıkarabilir ve LiDAR verileri kararlı hâle gelene kadar aracın güvenilir algılama yapmasını sağlayabilir. LiDAR ve monoküler derinlik kestirimi birlikte, zorlu sürüş koşullarında daha kararlı algılama ve daha güvenli kontrol sağlar.
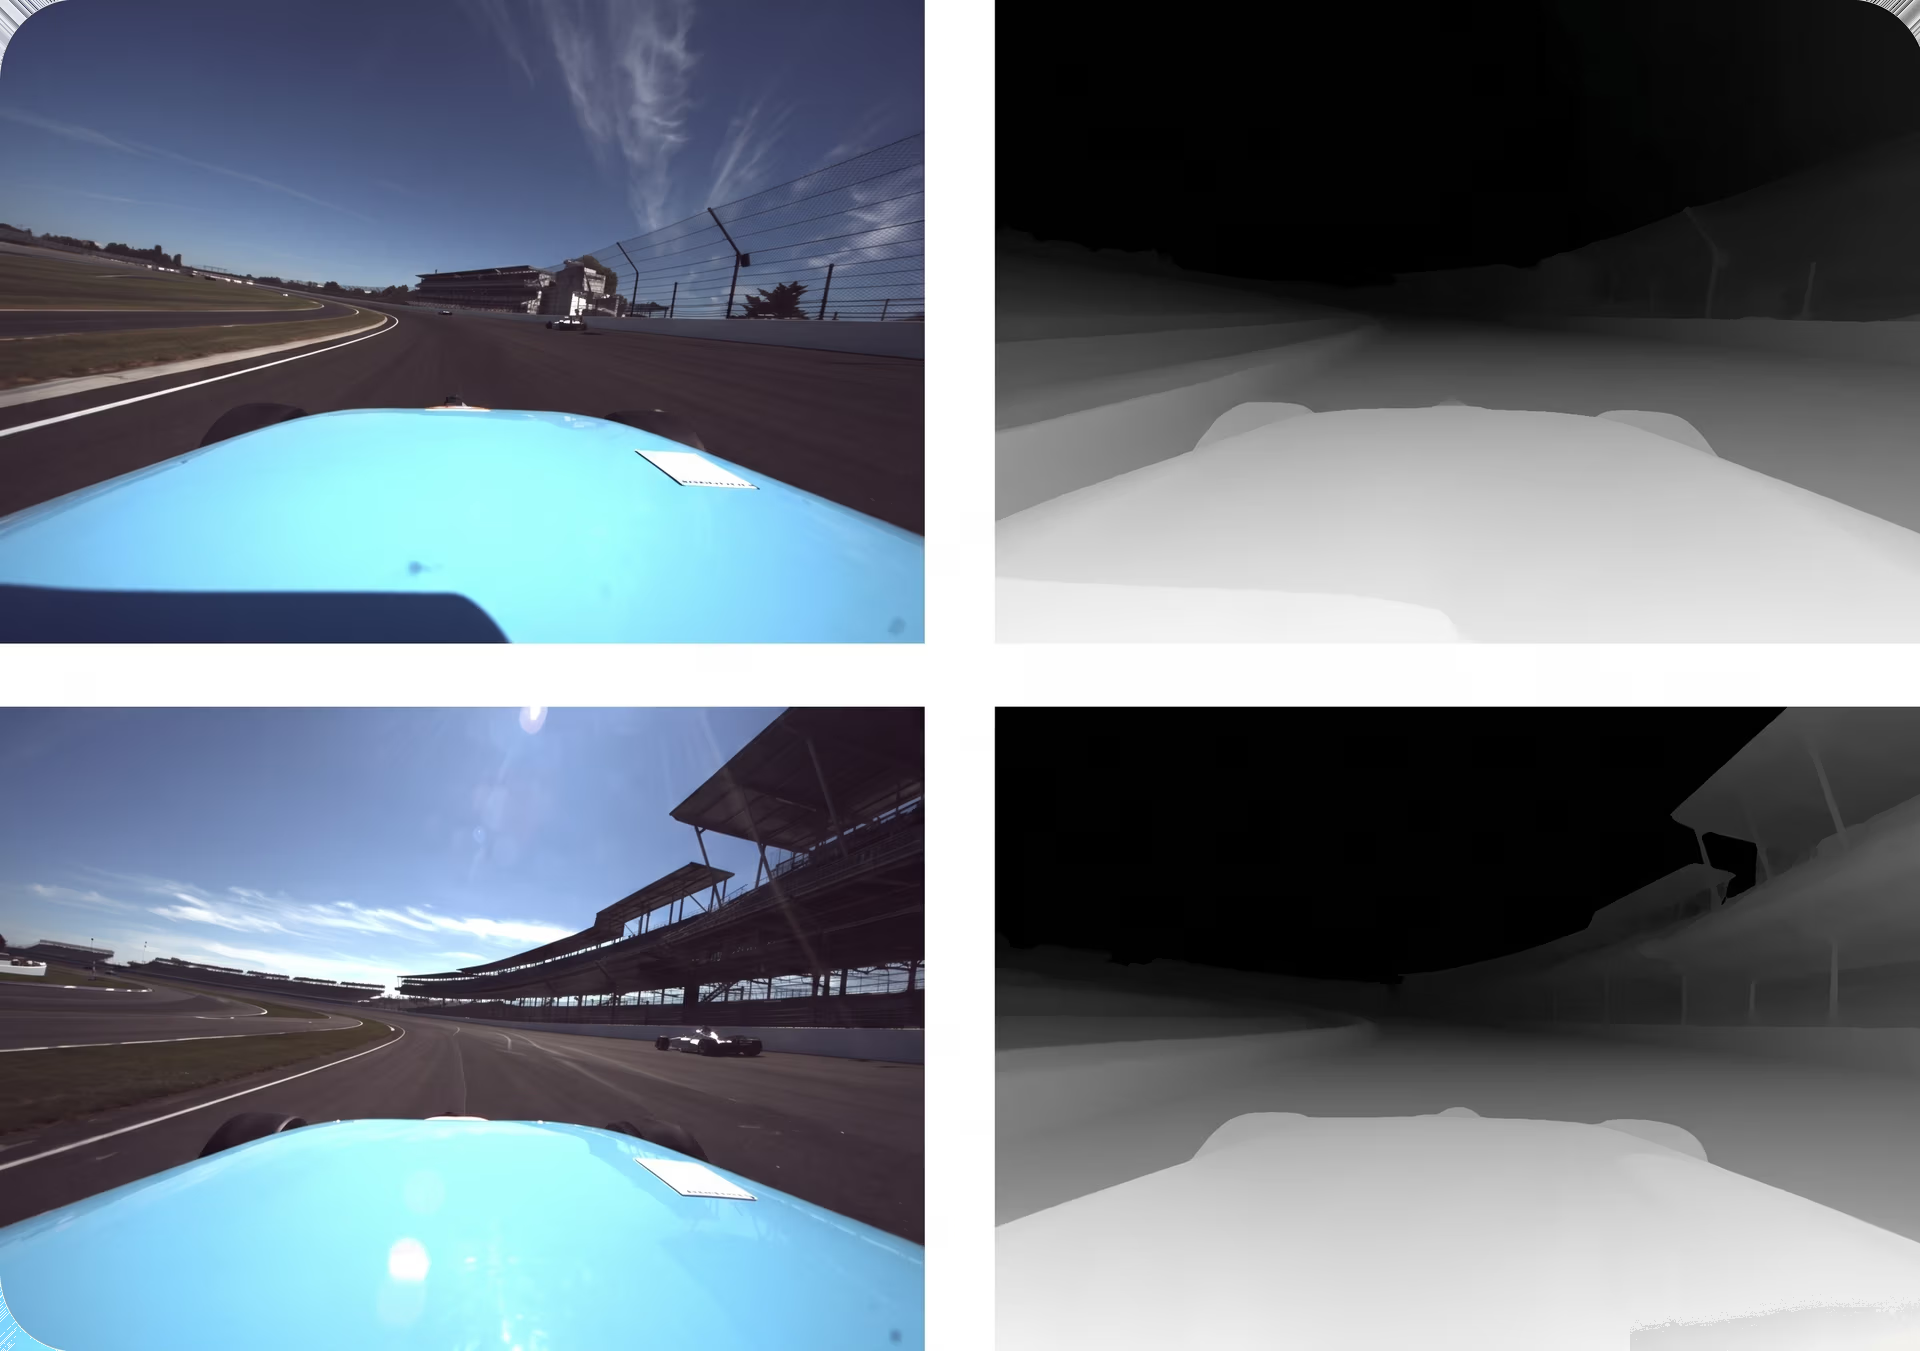
Şekil 3. Otonom yarışlarda monoküler derinlik kestiriminin kullanımını gösteren görselleştirme (Kaynak)
Robot navigasyonu ve engellerden kaçınma#
Robotlar genellikle ayrıntılı haritaların bulunmadığı ve koşulların sürekli değiştiği yerlerde çalıştırılır. Güvenli hareket edebilmeleri için çevrelerindeki alanın genişliğini ve engellerin konumunu güvenilir biçimde algılamaları gerekir.
Monoküler derinlik kestirimi, ağır veya pahalı donanımlara ihtiyaç duymadan tek bir RGB kamerayla bu uzamsal farkındalığı sağlayabilir. Derinlik kestirimi modelleri, ölçek ve perspektif gibi görsel ipuçlarını öğrenerek çevrenin yoğun derinlik haritalarını oluşturabilir. Böylece robotlar yüzeylere ve nesnelere olan mesafeyi net biçimde görebilir.
Özellikle derinlik bilgisi nesne tespiti ve anlamsal bölümleme gibi bilgisayarlı görü görevleriyle birleştirildiğinde robotlar çevrelerini daha kapsamlı biçimde görebilir. Nesneleri belirleyebilir, nesnelerin uzaklığını anlayabilir ve nerede güvenle hareket edebileceklerine karar verebilirler. Bu da engellerden kaçınmayı, boş alan tespitini ve gerçek zamanlı rota planlamasını destekler.
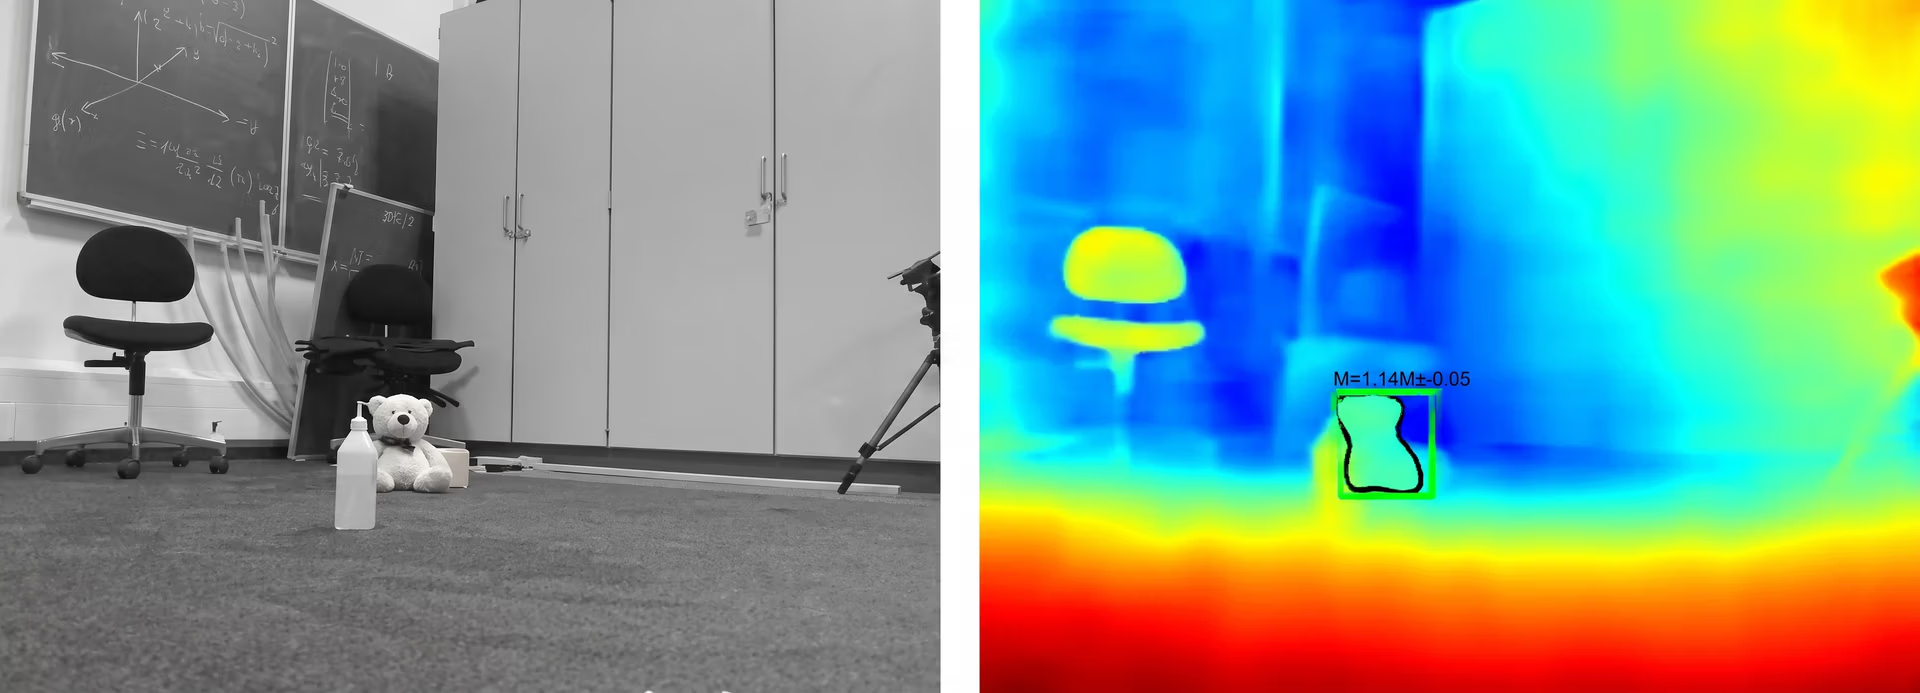
Şekil 4. Monoküler derinlik kestirimi ve nesne algılama kullanılarak nesnelerin algılanması (Kaynak)
Monoküler derinlik kestiriminin artıları ve eksileri#
Monoküler derinlik kestirimi kullanmanın başlıca avantajlarından bazıları şunlardır:
- Hafif ve enerji tasarruflu: Tek bir kamera kullanmak sistemin ağırlığını ve güç tüketimini azaltır; bu, özellikle mobil robotlar, dronlar ve gömülü sistemler için önemlidir.
- Sensör füzyonuna elverişli: Monoküler derinlik, boşlukları doldurarak veya yedeklilik sağlayarak LiDAR ya da radar gibi diğer sensörleri tamamlayabilir.
- Birçok ortamda çalışır: Aynı kamera tabanlı yaklaşım, donanım değişikliği gerektirmeden iç ve dış mekânlarda ve farklı platformlarda kullanılabilir.
Monoküler derinlik kestirimi belirgin avantajlar sunsa da göz önünde bulundurman gereken bazı sınırlamalar şunlardır:
- Etkin sensörlerden daha düşük doğruluk: Hızla gelişmesine rağmen monoküler derinlik kestirimi, kontrollü koşullarda genellikle LiDAR'ın veya yapılandırılmış ışık sensörlerinin mutlak doğruluğuna ulaşamaz.
- Aydınlatma koşullarına duyarlılık: Düşük ışıklı ortamlarda, yoğun gölgelerde, parlamada veya dokunun yetersiz olduğu sahnelerde performans düşebilir.
- Genelleme zorlukları: Bir ortamda eğitilen model, uyarlama veya ince ayar yapılmadan daha önce görmediği alanlara her zaman güvenilir biçimde aktarılamayabilir.
Monoküler derinlik kestirimine ne zaman güvenmemelisin#
Monoküler derinlik kestirimi ilgi çekici bir araştırma alanı olsa da nerelerde pratikte kullanılabileceğini ve kullanılamayacağını anlamak önemlidir. Ürettiği mesafeler, gerçek dünyada alınmış kesin ölçümler değil, modelin görüntüde gördüklerine dayalı tahminlerdir.
Bu nedenle sonuçların kalitesi aydınlatma, sahne karmaşıklığı ve sahnenin modelin eğitim aldığı verilere ne kadar benzediği gibi etkenlere bağlı olarak değişebilir. Monoküler derinlik kestirimi genellikle neyin daha yakın, neyin daha uzak olduğunu belirlemede başarılıdır; ancak kesin mesafeler gerektiğinde güvenilir değildir.
Güvenlik açısından kritik sistemler, endüstriyel denetim veya nesnelerle çok hassas etkileşim kurması gereken robotlar gibi hassasiyetin gerçekten önemli olduğu durumlarda derinlik doğrudan ölçülmelidir. LiDAR, radar, stereo kameralar veya yapılandırılmış ışık sistemleri gibi sensörler bu iş için tasarlanmıştır ve çok daha güvenilir mesafe bilgisi sağlar.
Monoküler derinlik kestirimi, görsel açıdan zorlu koşullarda da sorun yaşayabilir. Yetersiz aydınlatma, yoğun gölgeler, yansıtıcı veya şeffaf yüzeyler, sis, duman ya da görsel dokunun çok az olduğu sahneler derinlik tahminlerinin güvenilirliğini azaltabilir. Uzun mesafelerde derinlik kestirimi de özel sensörlerin genellikle daha iyi performans gösterdiği bir başka durumdur.
Gerçek dünya çözümlerinde monoküler derinlik kestirimi, bağımsız bir çözümden ziyade destekleyici bir araç olarak en iyi sonucu verir. Kullanışlı uzamsal bağlam ekleyebilir, diğer sensörlerin kısıtlı olduğu durumlarda boşlukları doldurmaya yardımcı olabilir ve genel sahne anlayışını geliştirebilir. Ancak doğruluk, güvenlik veya katı güvenilirlik gereksinimleri önemli olduğunda tek derinlik bilgisi kaynağı olmamalıdır.
Önemli çıkarımlar#
Monoküler derinlik kestirimi, makinelerin yalnızca tek bir kamera görüntüsünü kullanarak nesnelerin ne kadar uzakta olduğunu tahmin etmesini sağlayan bir bilgisayarlı görü tekniğidir. Perspektif, nesne boyutu, doku ve gölgelendirme gibi görsel ipuçlarını öğrenen bu yapay zekâ modelleri, LiDAR veya stereo kameralar gibi sensörlere ihtiyaç duymadan bir sahnenin 3B yapısını çıkarabilir. Bu özellik, monoküler derinlik kestirimini otonom sürüş, robotik ve 3B sahne anlama gibi uygulamalar için uygun maliyetli ve ölçeklenebilir bir yaklaşım hâline getirir.
Görsel yapay zekâ hakkında daha fazla bilgi edinmek için GitHub depomuzu ziyaret et ve topluluğumuza katıl. Robotikte yapay zekâ ve üretimde bilgisayarlı görü hakkında bilgi edinmek için çözüm sayfalarımıza göz at. Bilgisayarlı görüyle bugün çalışmaya başlamak için lisans seçeneklerimizi keşfet!
Yazan
İçerik Üreticisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









