比较 Ultralytics YOLO11 与之前的 YOLO 模型
比较 Ultralytics YOLOv8、YOLOv9、YOLOv10 和 Ultralytics YOLO11,了解这些模型在 2023 年至 2025 年间的演进和改进。

从自动化日常任务到帮助人们实时做出明智决策,人工智能(AI)正在重塑各个行业的未来。AI 中一个尤其引人入胜的领域是计算机视觉,也称为视觉 AI。它致力于让机器像人类一样分析和解读视觉数据。
具体来说,计算机视觉模型正在推动提升安全性和效率的创新。例如,这些模型被用于自动驾驶汽车检测行人,也被用于安防摄像头全天候监控场所。
最知名的计算机视觉模型包括 YOLO(只看一次)模型,它们以实时目标检测能力而闻名。随着时间推移,YOLO 模型不断改进,每个新版本都带来了更出色的性能和更高的灵活性。
较新的版本(如 Ultralytics YOLO11)可以处理各种任务,例如实例分割、图像分类、姿态估计和多目标跟踪,在准确率、速度和精度方面都达到了前所未有的水平。
本文将比较 Ultralytics YOLOv8、YOLOv9、YOLOv10 和 Ultralytics YOLO11,以更好地了解这些模型是如何演进的。我们将分析它们的主要特性、基准测试结果和性能差异。让我们开始吧!
Ultralytics YOLOv8 概览#
YOLOv8 由 Ultralytics 于 2023 年 1 月 10 日发布,相较于早期 YOLO 模型实现了重大进步。它针对实时且准确的检测进行了优化,将经过验证的方法与创新更新相结合,以获得更好的结果。
除了目标检测之外,它还支持以下计算机视觉任务:实例分割、姿态估计、定向边界框(OBB)目标检测和图像分类。Ultralytics YOLOv8 的另一项重要特性是提供五种不同的模型变体——Nano、Small、Medium、Large 和 X,因此你可以根据需求选择速度与准确率之间的适当平衡。
凭借其多功能性和出色性能,Ultralytics YOLOv8 可用于许多现实世界的应用,例如安防系统、智慧城市、医疗保健和工业自动化。

图 1。使用 YOLOv8 进行智慧城市停车管理。
Ultralytics YOLOv8 的主要特性#
下面详细介绍 Ultralytics YOLOv8 的其他一些主要特性:
- 增强型检测架构:Ultralytics YOLOv8 使用了改进的 CSPDarknet 主干网络。该主干网络针对特征提取进行了优化,特征提取是指从输入图像中识别并捕获重要模式或细节的过程,这些模式或细节有助于模型做出准确预测。
- 检测头:它采用无锚框、解耦设计,也就是说它不依赖预设的边界框形状(锚框),而是直接学习预测目标位置。得益于解耦设置,目标分类和位置预测(回归)由不同部分分别处理,这有助于提高准确率并加快训练速度。
- 平衡准确率与速度:该模型在保持快速推理速度的同时实现了出色的准确率,适用于云端和边缘环境。
- 易于使用:YOLOv8 的设计易于上手——使用 Ultralytics Python 软件包,你只需几分钟就能开始预测并查看结果。
YOLOv9 专注于计算效率#
YOLOv9 于 2024 年 2 月 21 日由中国台湾中央研究院信息科学研究所的 Chien-Yao Wang 和 Hong-Yuan Mark Liao 发布。它支持目标检测和实例分割等任务。
该模型基于 Ultralytics YOLOv5 构建,并引入了两项重大创新:可编程梯度信息(PGI)和广义高效层聚合网络(GELAN)。
PGI 可帮助 YOLOv9 在数据经过各层处理时保留重要信息,从而带来更准确的结果。同时,GELAN 改进了模型使用各层的方式,提升了性能和计算效率。得益于这些升级,YOLOv9 可以在边缘设备和移动应用上处理实时任务,而这些环境通常受到计算资源限制。

图 2。了解 GELAN 如何提升 YOLOv9 的准确率。
YOLOv9 的主要特性#
下面简要介绍 YOLOv9 的其他一些主要特性:
- 高精度与高效率:YOLOv9 无需消耗大量计算能力即可实现高检测准确率,因此在资源有限时是很好的选择。
- 轻量级模型:YOLOv9 的轻量级模型变体针对边缘设备和移动端部署进行了优化。
- **易于使用:**YOLOv9 获得 Ultralytics Python 软件包支持,因此无论你使用代码还是命令行,都可以在不同环境中轻松设置和运行。
YOLOv10 实现无 NMS 目标检测#
YOLOv10 于 2024 年 5 月 23 日由清华大学研究人员推出,专注于实时目标检测。它通过移除非极大值抑制(NMS)的需求并改进整体模型设计,解决了早期 YOLO 版本的局限性。非极大值抑制是一种用于消除重复检测结果的后处理步骤。这样既能实现更快、更高效的目标检测,又能保持先进的准确率。
实现这一点的关键部分是一种称为一致的双标签分配的训练方法。它结合了两种策略:一种允许多个预测从同一目标中学习(一对多),另一种专注于选择唯一的最佳预测(一对一)。由于两种策略遵循相同的匹配规则,模型能够自行学习避免重复,因此不需要 NMS。

图 3。YOLOv10 使用一致的双标签分配进行无 NMS 训练。
YOLOv10 的架构还使用改进的 CSPNet 主干网络来更有效地学习特征,并采用 PAN(路径聚合网络)颈部网络来整合不同层的信息,因此更擅长检测大目标和小目标。这些改进使 YOLOv10 能够用于制造业、零售业和自动驾驶等现实世界的应用。
YOLOv10 的主要特性#
下面介绍 YOLOv10 的其他一些突出特性:
-
**大核卷积:**模型使用大核卷积从图像更宽广的区域捕获更多上下文信息,帮助其更好地理解整体场景。
-
**部分自注意力模块:**模型加入部分自注意力模块,在不过多消耗计算能力的情况下关注图像中最重要的部分,从而高效提升性能。
-
**独特的模型变体:**除了常见的 YOLOv10 尺寸——Nano、Small、Medium、Large 和 X——之外,还有一个名为 YOLOv10b(平衡版)的特殊版本。它是更宽的模型,也就是说它在每一层处理更多特征,这有助于提高准确率,同时保持速度和尺寸之间的平衡。
-
**易于使用:**YOLOv10 兼容 Ultralytics Python 软件包,使用起来十分方便。
Ultralytics YOLO11:提升速度和准确率#
今年 9 月 30 日,Ultralytics 在年度混合活动 YOLO Vision 2024(YV24) 上正式发布了 YOLO11,这是 YOLO 系列中最新的模型之一。
此次发布相较于之前的版本带来了显著改进。Ultralytics YOLO11 更快、更准确且效率更高。它支持 YOLOv8 用户熟悉的完整计算机视觉任务,包括目标检测、实例分割和图像分类。它还保持了与 YOLOv8 工作流的兼容性,让用户能够轻松平稳地过渡到新版本。
此外,Ultralytics YOLO11 的设计旨在满足广泛的计算需求——从轻量级边缘设备到强大的云系统。该模型同时提供开源版和企业版,因此可以适应不同的使用场景。
对于医学影像和卫星检测等精密任务,以及自动驾驶汽车、农业和医疗保健等更广泛的应用,它都是很好的选择。

图 4。使用 Ultralytics YOLO11 检测、计数和跟踪交通流量。
Ultralytics YOLO11 的主要特性#
下面介绍 Ultralytics YOLO11 的其他一些独特特性:
- **快速高效的检测:**Ultralytics YOLO11 采用了专为低延迟设计的检测头,在不影响性能的情况下,专注于提升最终预测层的速度。
- 改进的特征提取:经过优化的主干网络和颈部网络架构增强了特征提取能力,从而带来更精确的预测。
- 跨平台无缝部署:Ultralytics YOLO11 经过优化,可在边缘设备、云平台和 NVIDIA GPU 上高效运行,确保能够适应不同环境。
在 COCO 数据集上对 YOLO 模型进行基准测试#
探索不同模型时,仅通过查看其特性来比较它们并不总是容易。这时就需要进行基准测试。通过在同一数据集上运行所有模型,我们可以客观地测量和比较它们的性能。下面来看看每个模型在 COCO 数据集上的表现。
比较 YOLO 模型时,每个新版本都会在准确率、速度和灵活性方面带来显著改进。具体来说,YOLO11m 在这方面实现了飞跃:它比 YOLOv8m 少使用 22% 的参数,这意味着运行起来更轻量、更快速。此外,尽管尺寸更小,它在 COCO 数据集上仍取得了更高的平均精度(mAP)。该指标用于衡量模型检测和定位目标的能力,因此 mAP 越高,预测就越准确。
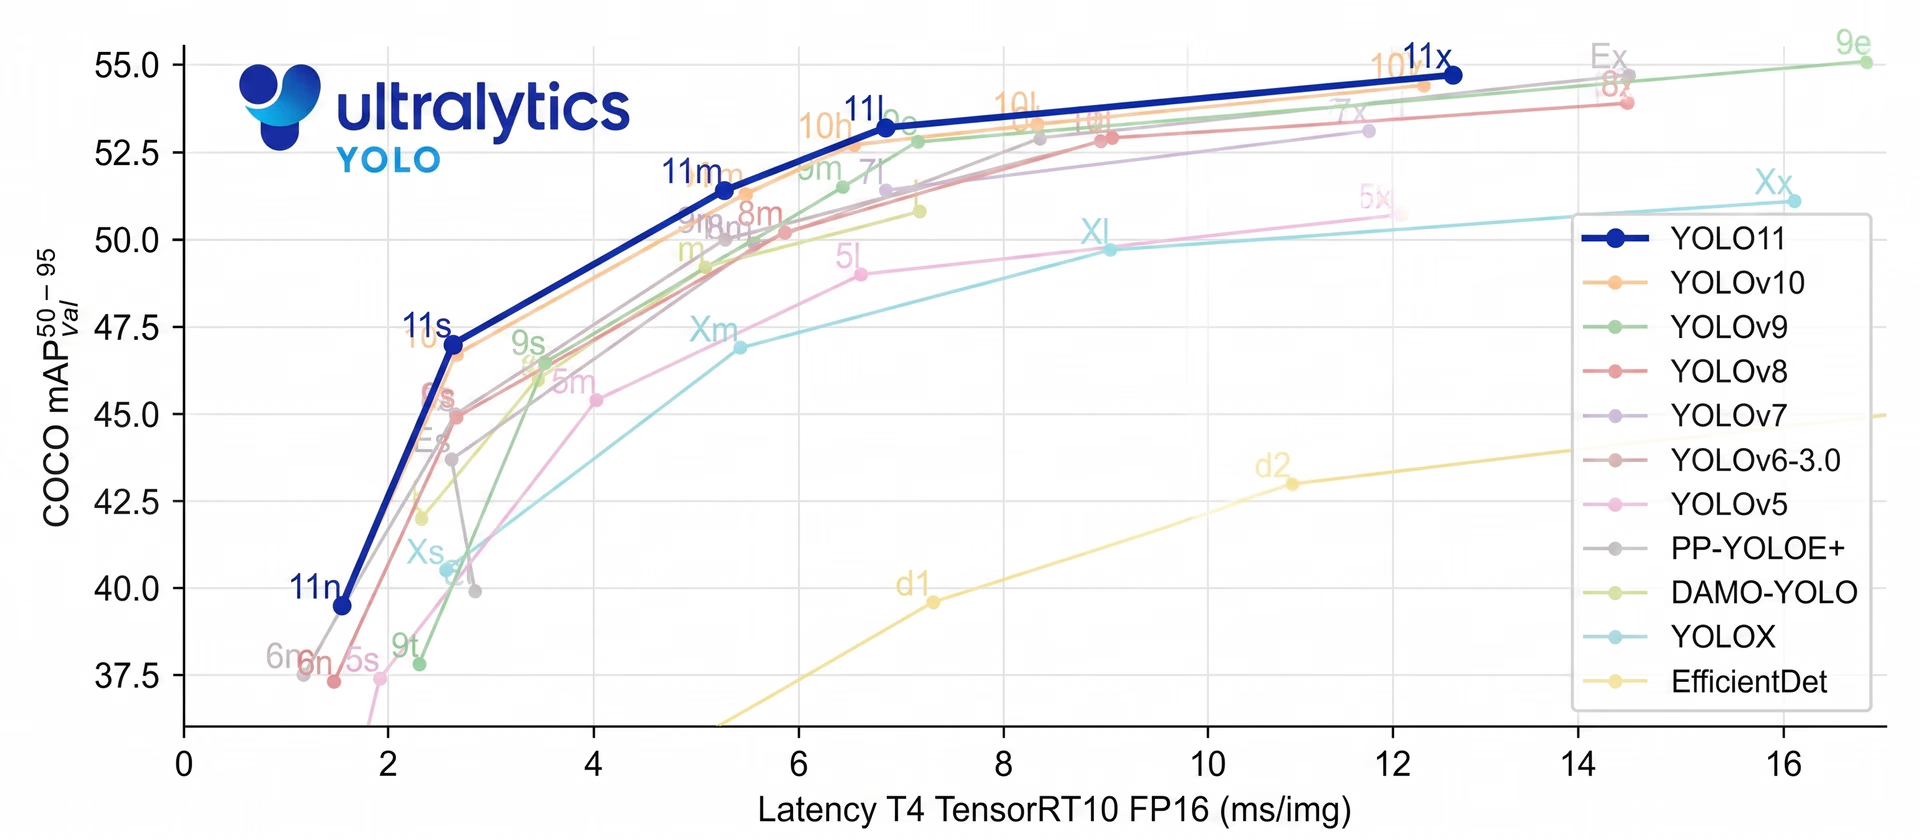
图 5。在 COCO 数据集上对 YOLO11 和其他 YOLO 模型进行基准测试。
在视频中测试和比较 YOLO 模型#
让我们来了解这些模型在现实场景中的表现。
为了比较 YOLOv8、YOLOv9、YOLOv10 和 YOLO11,我们让这四个模型都在同一段交通视频上运行,使用 0.3 的置信度分数(只有当模型至少有 30% 的把握正确识别目标时,才会显示检测结果)和 640 的图像尺寸,以进行公平评估。目标检测和跟踪结果突显了检测准确率、速度和精度方面的主要差异。
从第一帧开始,YOLO11 就检测到了卡车等大型车辆,而 YOLOv10 漏检了这些车辆。YOLOv8 和 YOLOv9 的表现不错,但会因光照条件和目标大小而有所不同。较小且距离较远的车辆仍然是所有模型面临的挑战,不过 YOLO11 在这些目标的检测方面也展现出了明显改进。

图 6。比较 YOLOv8、YOLOv9、YOLOv10 和 YOLO11。
在速度方面,所有模型每帧的处理时间都在 10 到 20 毫秒之间,足以支持超过 50 FPS 的实时任务。一方面,Ultralytics YOLOv8 和 YOLOv9 在整个视频中都提供了稳定可靠的检测结果。有趣的是,YOLOv10 专为降低延迟而设计,运行速度更快,但在检测某些目标类型时表现出一些不一致。
另一方面,Ultralytics YOLO11 凭借其精度脱颖而出,在速度和准确率之间实现了良好平衡。尽管没有任何模型在每一帧中都表现完美,但并排比较清楚地表明,YOLO11 的整体性能最佳。
哪个 YOLO 模型最适合计算机视觉任务?#
为项目选择模型取决于具体需求。例如,有些应用可能优先考虑速度,而另一些应用可能需要更高的准确率,或者面临会影响选择的部署限制。
另一个重要因素是你需要处理的计算机视觉任务类型。如果你希望在不同任务之间获得更广泛的灵活性,YOLOv8 和 YOLO11 都是不错的选择。
选择 YOLOv8 还是 YOLO11,实际上取决于你的需求。如果你刚开始接触计算机视觉,并且看重更大的社区、更多教程以及丰富的第三方集成,那么 YOLOv8 是稳妥的选择。
另一方面,如果你追求更先进的性能、更高的准确率和更快的速度,Ultralytics YOLO11 是更好的选择,不过由于它是较新的版本,社区规模较小,集成也更少。
要点总结#
从 Ultralytics YOLOv8 到 Ultralytics YOLO11,YOLO 模型系列的演进体现了计算机视觉模型不断朝着更智能的方向发展。YOLO 的每个版本都在速度、准确率和精度方面带来了有意义的升级。
随着计算机视觉不断发展,这些模型为从目标检测到自主系统等现实世界的挑战提供了可靠解决方案。YOLO 模型的持续发展展现了这一领域取得的巨大进步,也让我们期待未来会有更多突破。
如需进一步了解 AI,请访问我们的 GitHub 代码仓库,并加入我们的社区。了解各行业的进展,从制造业中的视觉 AI到医疗保健中的计算机视觉。查看我们的许可选项,立即开始你的视觉 AI 项目。








