如何训练 Ultralytics YOLO 模型检测野生动物
了解如何使用 African Wildlife Dataset 训练 YOLO 模型来检测野生动物,并使用模型对未见过的图像进行推理。
地球上的野生动物种类极其丰富,从嗡嗡飞舞的蜜蜂到高大的大象,应有尽有。保护这种生物多样性是维持生态系统平衡的关键。然而,栖息地丧失、偷猎和气候变化正让保护工作变得越来越困难。这些因素都会对野生动物种群造成负面影响。
传统的动物监测方法,例如手动分析红外相机图像和开展实地调查,速度可能较慢且耗费大量资源。这些工作往往无法有效覆盖广阔区域和大量种群。
为克服这些局限,人工智能 (AI) 可以成为野生动物保护的有效工具。具体来说,Ultralytics YOLO11等计算机视觉模型可以分析图像和视频等视觉数据,自动实时识别和跟踪动物。
由 Ultralytics YOLO11 支持的目标检测和实例分割等计算机视觉任务在此非常有用。通过分析视觉数据,这些任务能帮助我们收集重要数据、识别生态规律,并更有效地应对环境威胁。
本文将介绍训练 Ultralytics YOLO11 检测动物的流程。开始吧!
开始使用 Ultralytics YOLO11#
开始教程之前,我们先来看看训练和使用 Ultralytics YOLO11 所需的各种环境配置选项和工具。
你需要的主要工具是 Ultralytics Python 软件包,它让你可以轻松使用 YOLO 模型执行训练、目标检测和推理等任务。要使用 Ultralytics 软件包,你需要设置一个运行代码的环境,并且有多种环境可供选择。
以下是几种最常用的开发环境配置方式:
- 命令行界面 (CLI):CLI,也称为终端,是一种基于文本的工具,你可以通过输入命令与计算机交互。与通过点击按钮、使用鼠标操作的图形用户界面 (GUI) 不同,使用 CLI 需要输入文本指令来运行程序或执行任务。
- Jupyter Notebooks:你可以在这些笔记本中将代码分成称为单元格的小段来编写和运行。它具有交互性,意味着你可以立即查看代码的输出,因此测试和调试会更容易。
- Google Colab:Google Colab 是一个基于云的平台,类似于 Jupyter Notebooks,但可以免费使用高性能 GPU。它易于配置,而且无需在计算机上安装任何东西。
虽然你还可以在 Ultralytics 官方文档中探索其他环境配置选项,但上述三种方式只需极少的配置且易于使用,非常适合快速入门。
本教程将演示如何使用 Google Colab、Jupyter Notebooks 或简单的 Python 文件来配置环境并训练 Ultralytics YOLO11,因为这些环境中的操作步骤非常相似。
了解非洲野生动物数据集#
选择开发环境后,要训练 Ultralytics YOLO11 专门检测野生动物,我们需要一个包含标注图像的高质量数据集。每张图像都应清楚展示动物的位置和种类,这样模型才能通过监督学习识别动物。
本教程将使用非洲野生动物数据集。该数据集受到 Ultralytics Python 软件包支持,专为检测非洲生态系统中常见的动物而设计,其中包含四种关键物种的标注图像:水牛、大象、犀牛和斑马。
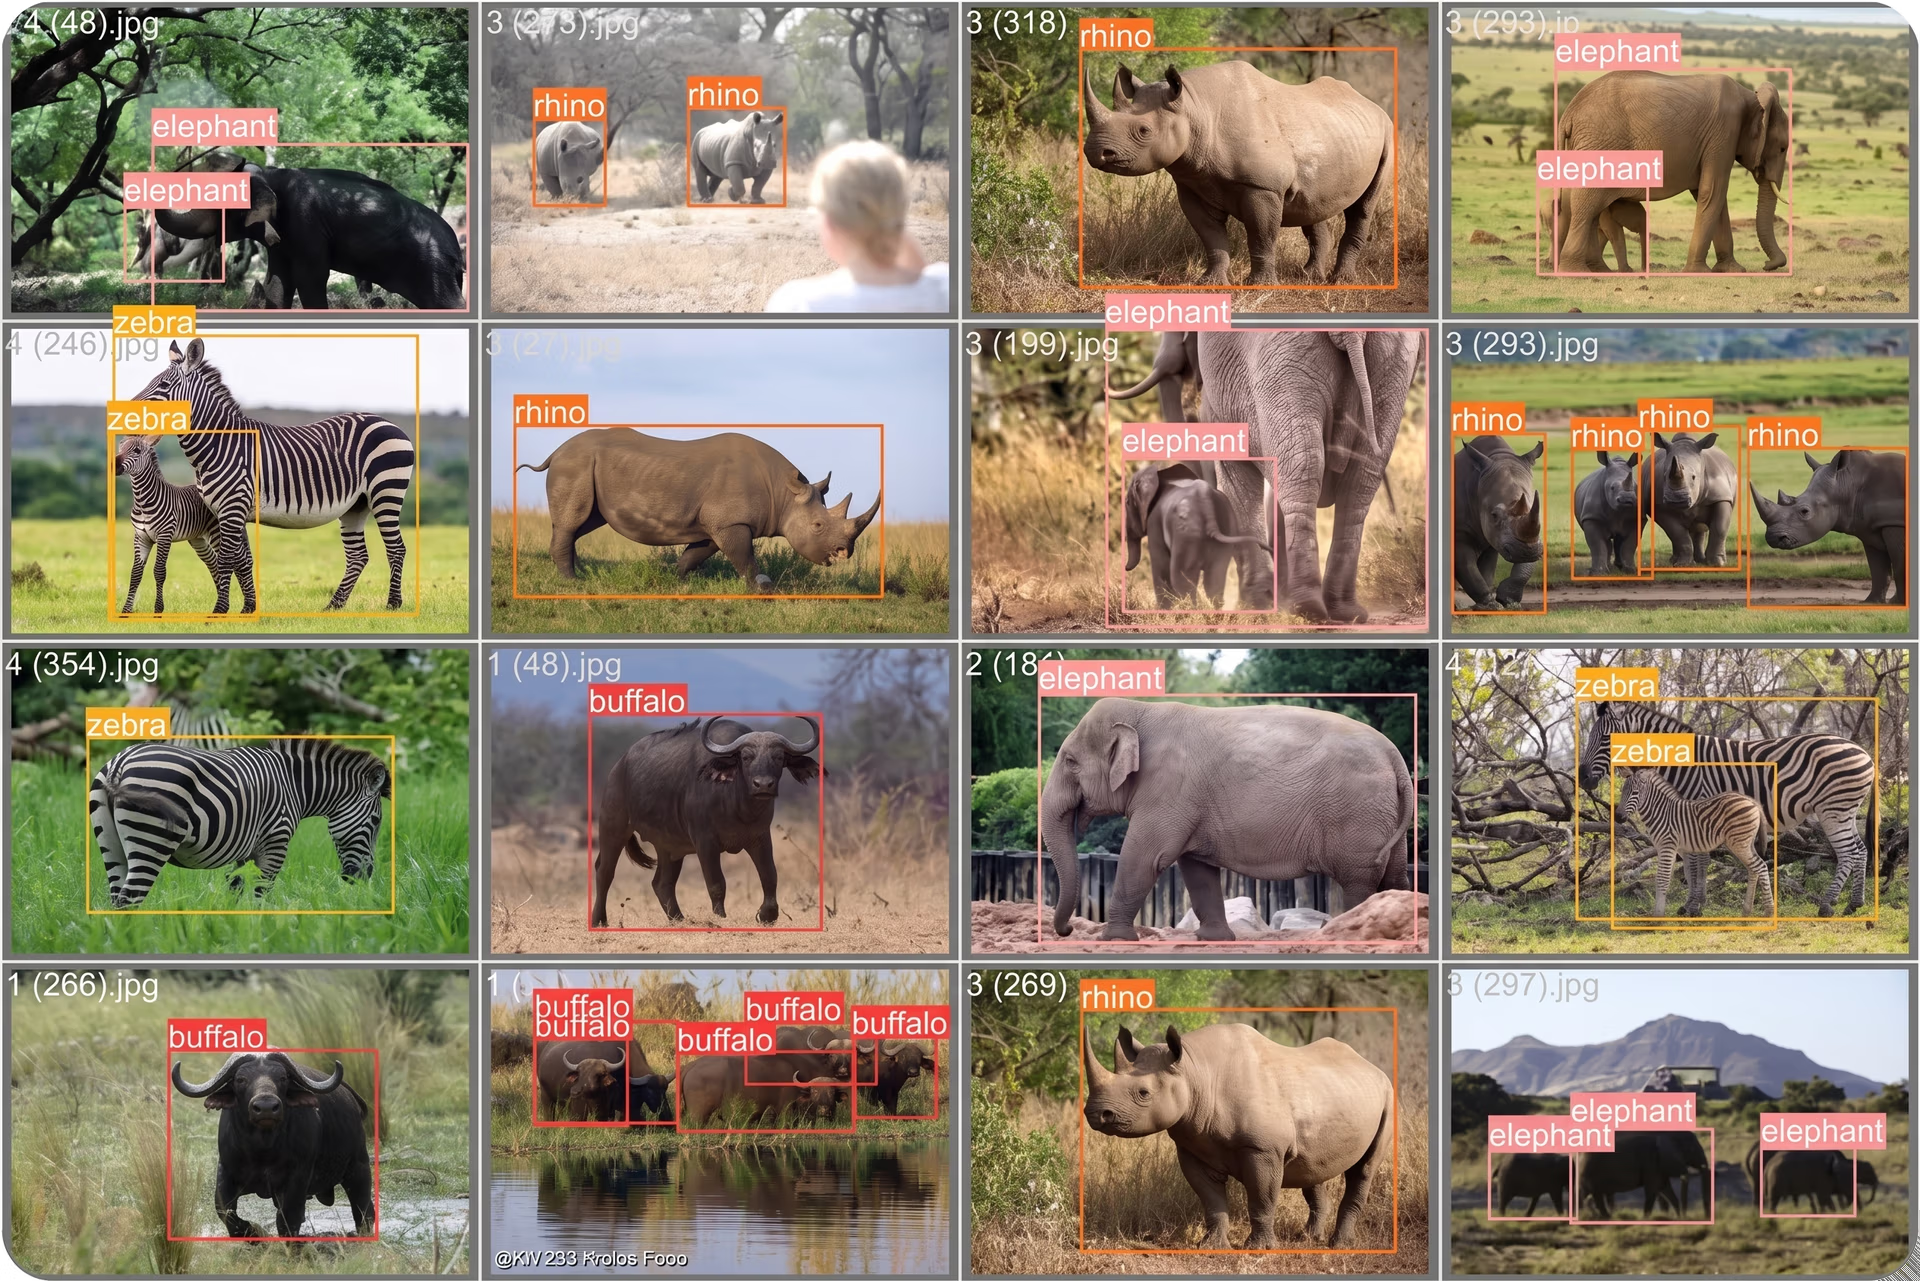
图 1. 非洲野生动物数据集一览。
以下是非洲野生动物数据集的一些主要特点:
- 规模:该数据集包含 1504 张图像,分为三个子集:1052 张训练图像、225 张验证图像和 227 张测试图像。这种划分可以确保模型得到有效学习和全面评估。
- 无缝集成:Ultralytics 提供 YAML 配置文件,用于定义数据集路径、类别和其他详细信息,让你可以轻松地将其用于 YOLO 模型训练。
- 开放许可:该数据集以 AGPL-3.0 许可协议发布,鼓励透明与协作。
训练 Ultralytics YOLO11 进行动物检测#
了解非洲野生动物数据集后,我们可以开始训练 Ultralytics YOLO11 模型来检测图像中的动物。整个过程包括配置开发环境、训练 YOLO11 模型以及评估模型性能。
步骤 1:配置环境#
首先,我们要准备一个用于训练和测试模型的环境。你可以根据自己的偏好使用 Google Colab、Jupyter Notebooks 或简单的 Python 文件。相应地创建一个新的 Google Colab 笔记本、Jupyter Notebook 或 Python 文件。
如果你使用 Google Colab,其环境默认运行在 CPU(中央处理器)上,这可能会减慢训练速度。要加快训练,尤其是训练较大的模型时,可以将运行时切换为使用 GPU。在 Google Colab 中,你可以打开菜单栏的“Runtime”标签页,选择“Change runtime type”,然后将硬件加速器设为 GPU(最好使用 T4 GPU)。这对于缩短训练时间很重要。
接下来,无论使用哪种环境,你都需要安装 Ultralytics Python 软件包。如果使用基于笔记本的环境(Google Colab 或 Jupyter),请在以下命令前加上感叹号 (!) 后运行。
pip install ultralytics步骤 2:加载 Ultralytics YOLO11 并准备数据集#
安装 Ultralytics 软件包后,下一步是加载 YOLO11 模型并准备训练数据集。首先,我们加载已经在通用目标检测任务上预训练的 YOLO11 模型。这个预训练模型为我们提供了良好的起点,因为它已经学会了如何检测各种对象。
然后,我们使用 YAML 文件指定数据集,其中包含图像和标签的信息。该文件会告诉模型数据集的位置,以及模型需要学习识别哪些对象。
Ultralytics 软件包支持非洲野生动物数据集,因此开始训练时会自动下载数据集,省去手动配置的麻烦。
数据集准备就绪后,模型便开始训练。模型会多次遍历数据集,这一过程称为多个 epoch 的训练,以提升其识别图像中动物的能力。在此过程中,图像会被调整为统一的尺寸以便处理,模型每次处理的图像数量则称为一个批次。这有助于模型更高效地学习。
简而言之,运行下面的代码片段后,模型会完成加载,数据集会自动下载,训练随即开始,让模型根据非洲野生动物数据集检测动物。
from ultralytics import YOLO

model = YOLO("yolo11n.pt")
results = model.train(data="african-wildlife.yaml", epochs=30, batch=8)
步骤 3:Ultralytics YOLO11 训练流程详解#
运行上面的代码片段后,模型便会根据我们提供的设置开始训练。我们已经通过代码告诉模型,将训练图像遍历 30 次。这意味着模型会把数据集中的所有图像看 30 遍,每遍都会多学一些。
想象一下,你正在学习如何画动物。第一次画得可能不太好,但反复练习后,你会逐渐进步。每次重画时,你都会从错误中吸取教训并加以改正。模型的每个 epoch也是如此:它会查看图像、犯错、从错误中学习,并在每一轮中更好地识别动物。
如果训练代码成功运行,你会在训练过程中看到以下输出:
- 训练设置:第一部分显示所使用的 Ultralytics、PyTorch 版本和硬件(此处为 CPU),以及训练配置,包括模型(yolo11n.pt)、批量大小、训练轮数和图像尺寸。
- 模型摘要:此处提供模型复杂度相关信息,例如层数和参数数量,展示模型的大小。
- 优化器和学习率:此处会说明优化器(例如 AdamW)和学习率,它们控制模型在训练期间如何调整参数。
- 数据集扫描:模型会扫描数据集,并显示有效且可用于训练的图像数量。这可以确认数据集没有问题。
- 训练进度:每个训练轮次(训练周期)结束后,输出都会更新,显示训练进度以及关键损失值(box_loss、cls_loss、dfl_loss),这些值反映模型的学习情况。
- 性能指标:每个训练轮次结束后,你都会看到精确率、召回率和 mAP(平均精度均值)等性能指标。这些数值体现模型检测和分类对象的准确程度。
- GPU 内存使用情况:如果你使用 GPU,输出会显示内存使用情况,便于跟踪硬件利用率。
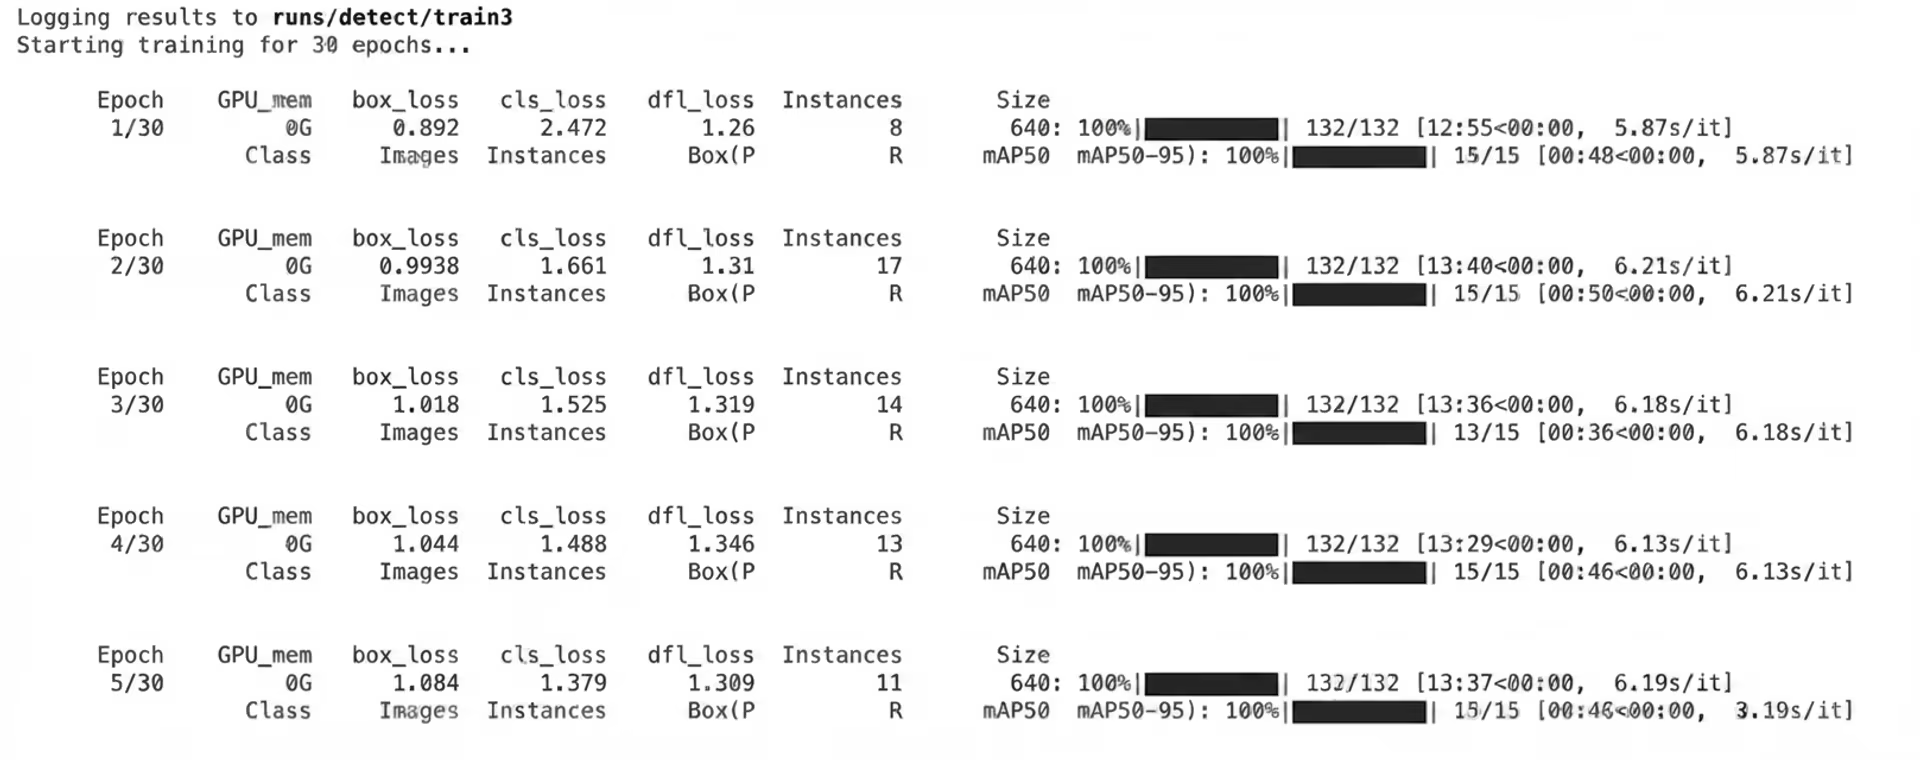
图 2. 模型训练运行时你会看到的输出。
步骤 4:评估自定义训练模型的性能#
训练过程完成后,你可以查看并验证模型的性能指标。在 Google Colab 中,你可以依次打开“runs”文件夹、“detect”文件夹和“train”文件夹,在其中找到显示关键性能指标的日志。
对于 Python 环境中的用户,训练结果默认保存在当前工作目录下的“runs/train/”目录中。每次训练都会创建一个新的子目录(例如 runs/train/exp、runs/train/exp2 等),其中包含与训练相关的日志和其他输出。
如果你使用 CLI,可以通过“yolo settings”命令轻松访问这些结果和设置,该命令可用于查看或修改与训练日志和实验详情相关的路径及其他配置。
日志中还会包含一些图表,你可以查看这些图表,了解模型训练的效果。训练完成后生成的图表会显示模型是否随着训练推进而有所改进,例如错误减少、准确度提高。
这些图表会跟踪模型的进展,展示训练期间损失(模型预测值与实际值之间的差异)如何降低,以及准确度如何提高。这有助于你了解模型识别动物的学习效果,以及训练结束时模型取得了多大进步。
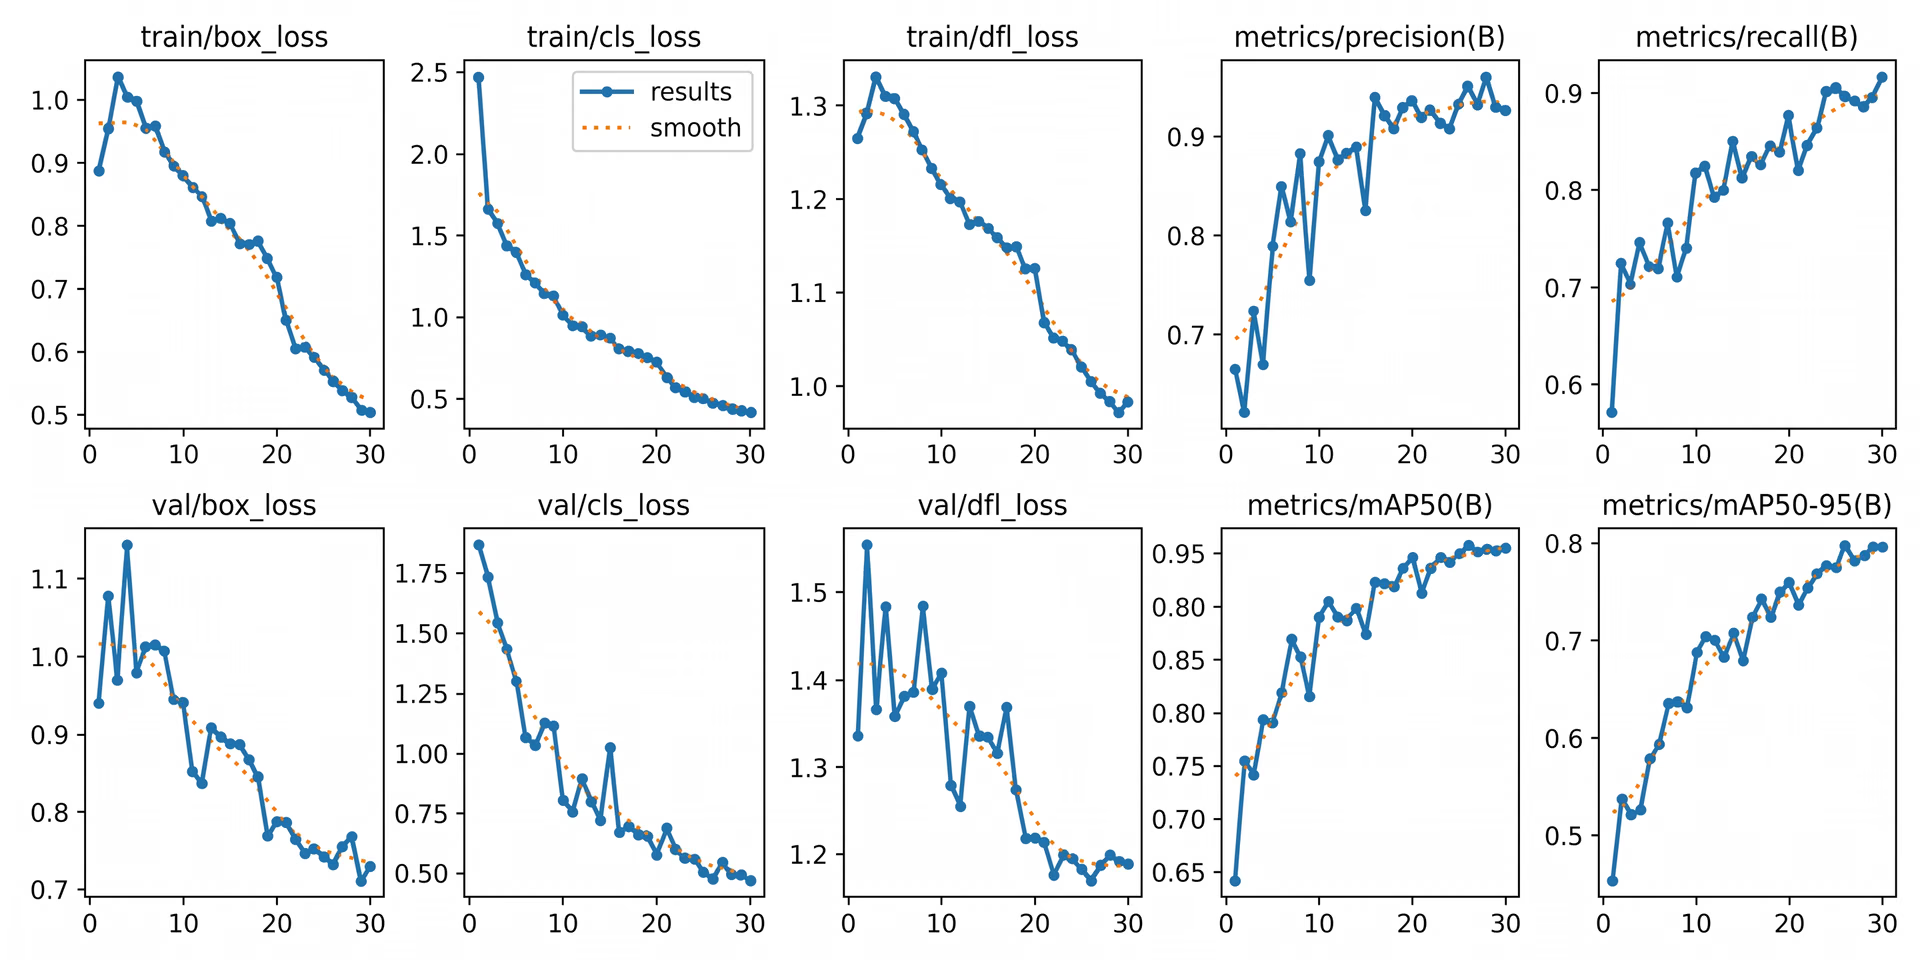
图 3. 可用于评估模型的图表示例。
关键性能评估指标#
此外,下面进一步介绍一些可用于评估模型性能的指标:
- 平均精度均值(mAP):该指标通过对不同召回率水平下的精确率进行平均,衡量模型在所有类别中检测动物的整体准确度。
- 精确率:表示正确检测结果所占的比例,计算方法是将真正例检测数量除以检测总数。
- 召回率:表示图像中被模型正确识别的实际动物所占的比例,反映模型捕获所有相关实例的能力。
这些评估指标有助于微调模型,在将模型用于实际应用之前提升准确度。
使用自定义训练的 Ultralytics YOLO11 模型运行推理#
现在我们已经训练并评估了 Ultralytics YOLO11,接下来可以用它分析图像并运行推理。你可以使用数据集中的测试图像,也可以使用来自其他来源的新图像。
我们将使用以下代码片段,在测试数据集中的一张图像上运行模型。代码会从 Ultralytics 库导入所需模块,然后定义结果目录中最佳模型权重文件(“best.pt”)的路径。接着,使用这些权重加载自定义训练的 YOLO11 模型。
之后,设置一张来自非洲野生动物测试数据集的图像路径。模型会对该图像执行对象检测并生成结果,然后保存输出(例如检测到的对象或标注)。
from ultralytics import YOLO, settings

best_model_path = results.save_dir / "weights/best.pt"
model = YOLO(best_model_path)
image_path = f"{settings['datasets_dir']}/african-wildlife/test/images/1 (168).jpg"
img_results = model(image_path, save=True)
下方展示的输出图像将保存在 runs/detect 目录中的“predict”文件夹内。后续测试会创建“predict2”、“predict3”等新文件夹,用于存储图像。
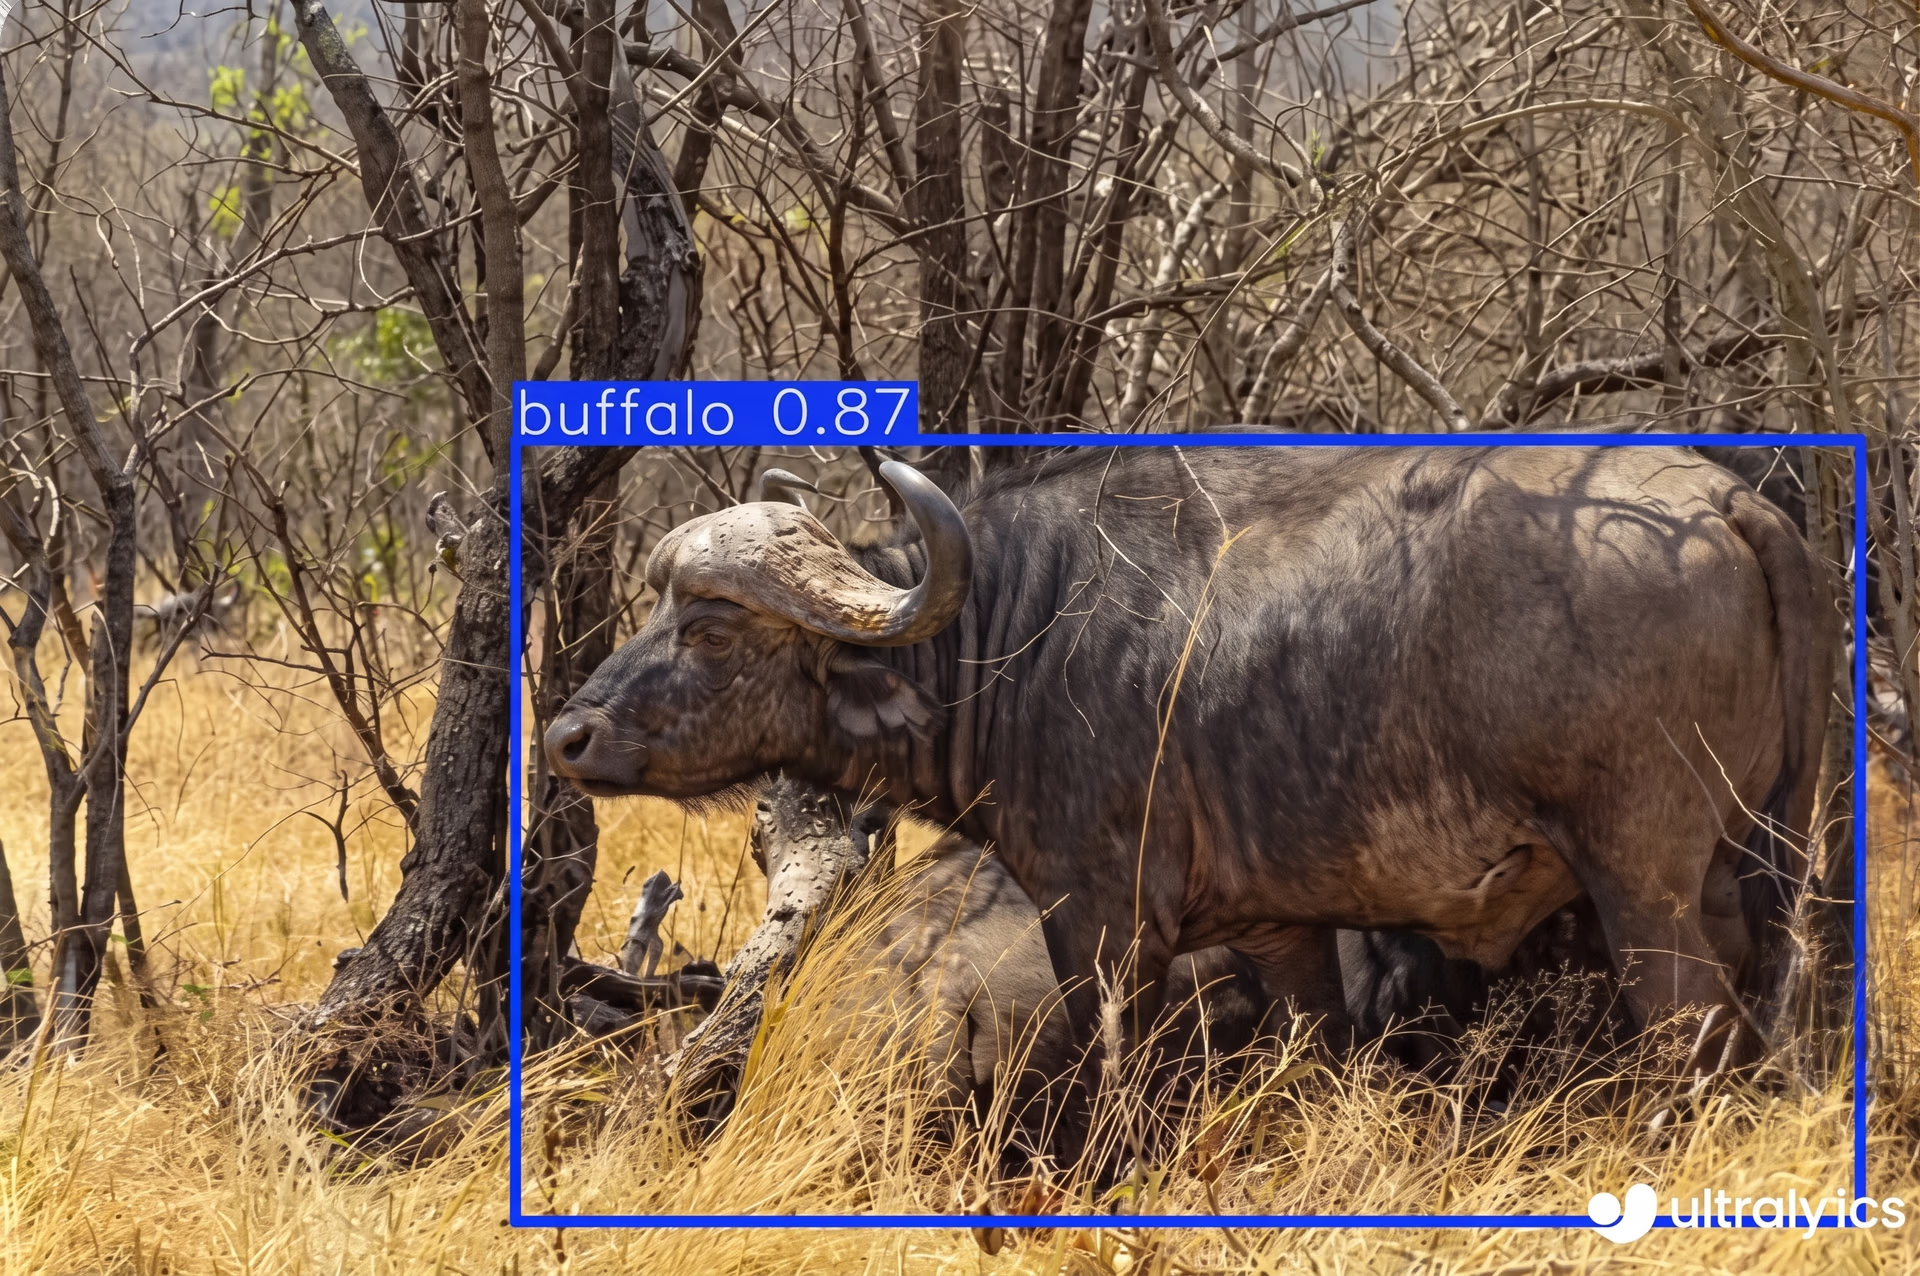
图 4. 使用微调后的 Ultralytics YOLO11 模型对测试图像运行推理。
要测试来自不同来源的图像,你可以使用下面的代码。我们使用了一张来自 Pexels 的图像。你可以使用同一张图像,也可以使用其他相关图像。
from ultralytics import YOLO

best_model_path = results.save_dir / "weights/best.pt"
model = YOLO(best_model_path)
img2_results = model("https://images.pexels.com/photos/18341011/pexels-photo-18341011/free-photo-of-elephant-and-zebras-in-savannah.png", save=True)
下方展示的输出图像将保存在相应文件夹中。
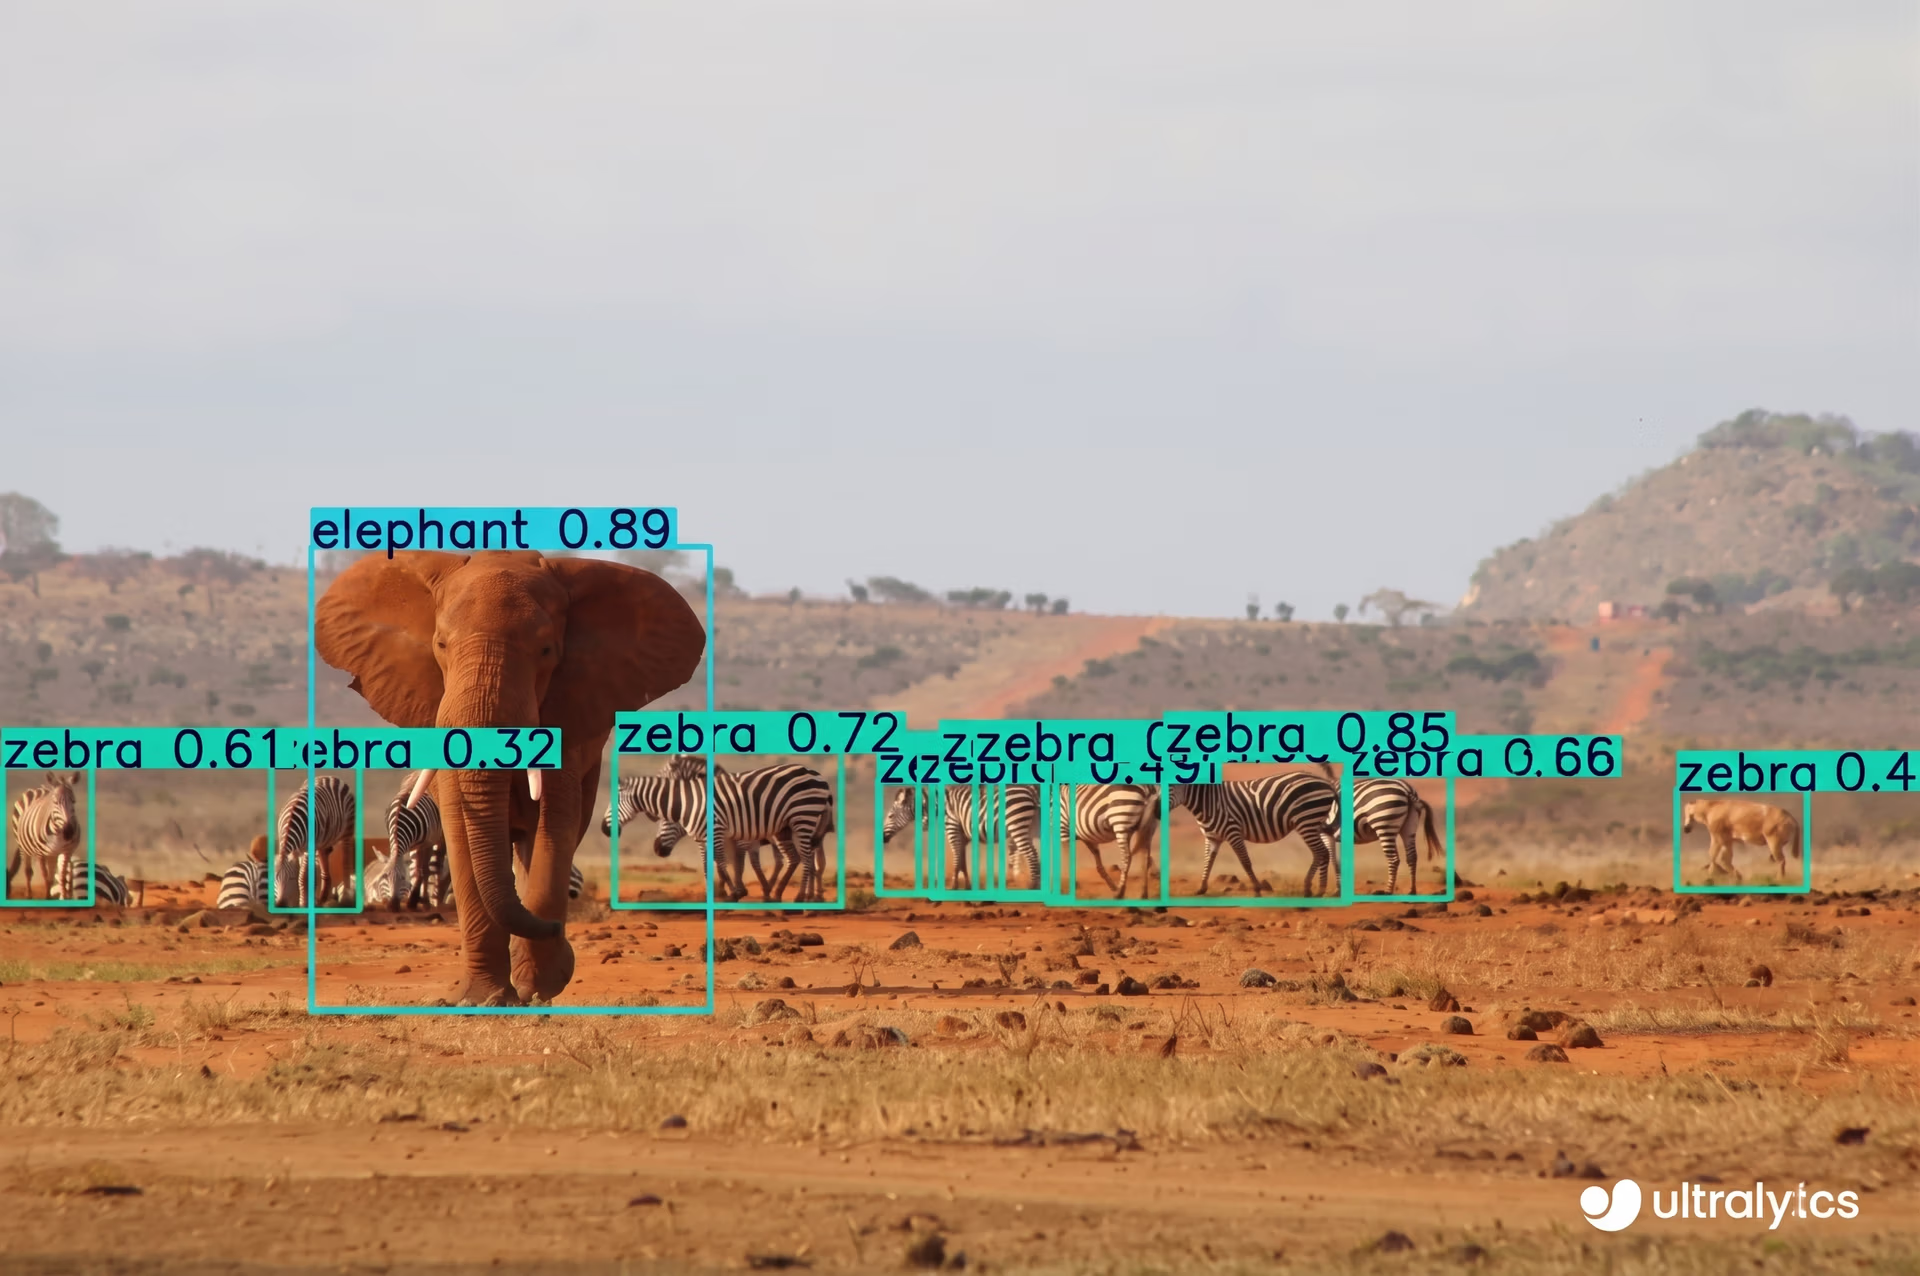
图 5. 使用微调后的 Ultralytics YOLO11 模型检测未见过的图像中的野生动物。
用于野生动物保护的 AI:实际应用#
Ultralytics YOLO11 等模型可以自动检测和跟踪动物,从而支持多种实际应用。以下是视觉 AI 可用于支持野生动物保护工作的一些主要领域:
- 物种监测:视觉 AI 可用于处理图像和视频等视觉数据,从而准确识别物种、统计种群数量并跟踪其长期移动情况。
- 智能摄像头警报:在偏远地区,计算机视觉可用于持续对动物进行分类并发送实时警报,使野生动物管理部门能够迅速应对动物行为异常或人类与野生动物冲突等威胁。
- 行为分析:通过监测迁徙、进食习惯和社交互动,视觉 AI 系统可以全面洞察不同物种之间的动态关系。
- 防止偷猎:视觉 AI 可用于检测未经授权的人员活动和偷猎迹象,同时结合机器学习与历史数据,定位高风险热点区域。
要点#
Ultralytics YOLO11 等计算机视觉模型可以通过自动检测和跟踪动物,在野生动物保护中发挥重要作用。借助视觉 AI,我们可以处理来自不同来源的大量图像和视频,从而准确评估野生动物状况。
尤其是 Ultralytics YOLO11,非常适合实时对象检测,可用于反偷猎监控、行为分析和生态系统监测等任务。将 AI 驱动的模型融入保护工作,有助于我们更好地保护物种、改进生物多样性跟踪,并做出更明智的决策来保护濒危野生动物。
加入我们的社区,并探索 GitHub 代码仓库,进一步了解计算机视觉。访问我们的解决方案页面,了解更多关于医疗保健领域的 AI和制造业中的计算机视觉的应用。查看 Ultralytics 许可选项,开始使用视觉 AI。








