如何使用 Ultralytics YOLO Docs 的 Reference 部分
了解如何使用 Ultralytics YOLO Docs 的 Reference 部分,深入了解 Ultralytics Python 软件包的内部机制。
如今,人工智能 (AI) 比以往任何时候都更容易使用,让任何人都能轻松入门,快速开始使用不同的 AI 模型执行各种前沿任务。
例如,计算机视觉是 AI 的一个分支,可让计算机解读并理解图像和视频中的视觉信息;而像 Ultralytics YOLO11 这样的计算机视觉模型也很容易上手。
Ultralytics YOLO11 支持目标检测、实例分割和图像分类等任务,可用于自动驾驶、安全监控和零售分析等应用。
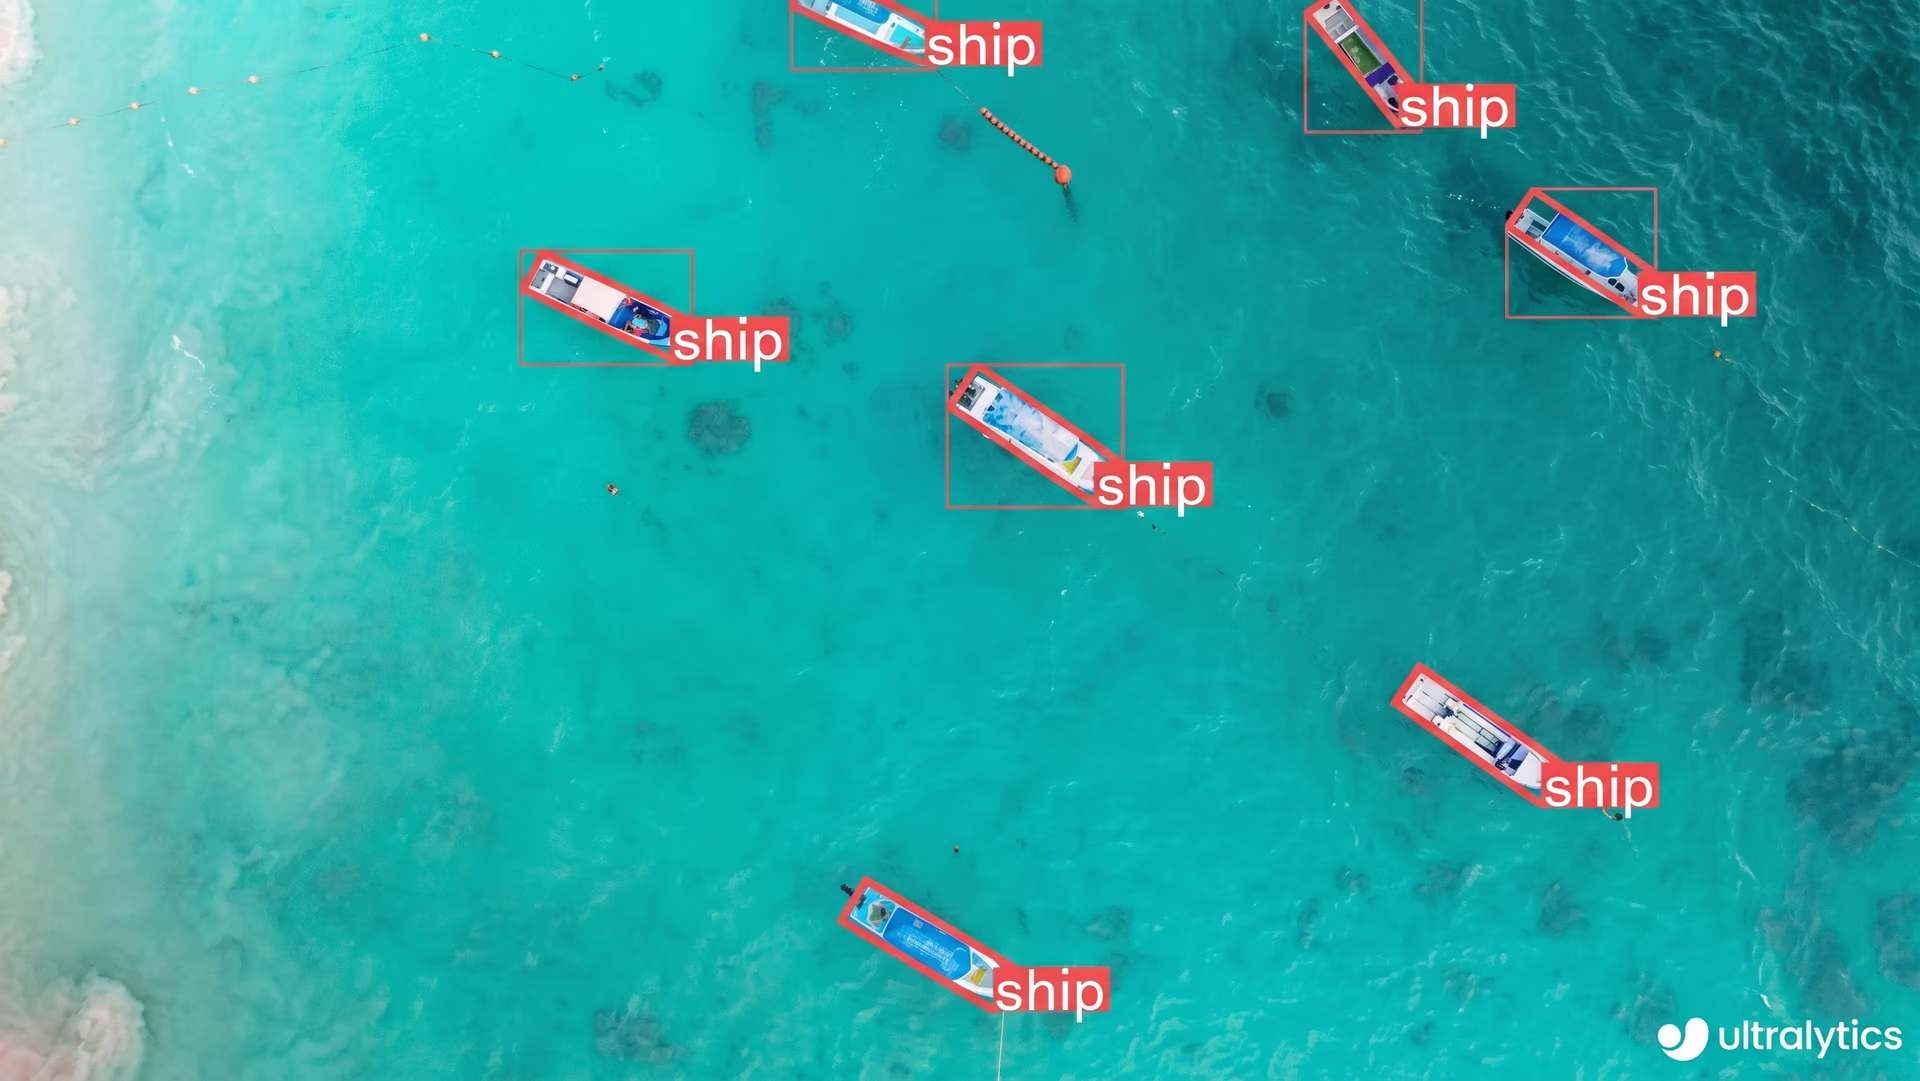
图 1. Ultralytics YOLO11 可用于检测各种物体。
Ultralytics Python 软件包提供易于使用的工具,可快速训练、自定义和部署这些 AI 模型,让各种技能水平的用户都能轻松构建高级计算机视觉应用。
不过,如果你想深入了解其运作原理或创建自己的自定义内容,Ultralytics 文档中的 Reference 部分是很好的资源。该部分介绍了 Ultralytics Python 软件包的内部运作方式,包括如何处理数据、模型训练流程,以及如何可视化预测结果。
本文将带你深入了解 Ultralytics 文档中的 Reference 部分,以及如何在计算机视觉项目中使用该部分。现在就开始吧!
深入了解如何使用 Ultralytics YOLO 模型#
使用 Ultralytics Python 软件包简单又直接。只需几行代码,你就可以训练 YOLO 模型,或在图像中检测物体。
不过,当你熟悉计算机视觉模型的使用后,Ultralytics 文档中的 Reference 部分可以帮助你深入了解代码的运作方式,以及软件包支持哪些函数。该部分还提供易于理解的说明、可配置选项,以及指向 Ultralytics GitHub 代码库中相关代码的链接。
该部分说明了 Ultralytics Python 软件包的结构,并介绍模型设置、数据加载、训练流程,以及如何生成和返回预测结果等关键组件。
所有内容都按类别清晰整理,让你可以轻松找到所需信息。例如,如果你要使用自己的数据集训练模型,可以前往 Reference 部分中介绍数据的内容,更好地了解模型训练时将如何使用你的数据。
如何开始使用 Reference 部分#
前往 Ultralytics YOLO 文档中的 Reference 部分后,你会在页面左侧看到包含不同参考类别的菜单。每个类别都对应 Ultralytics 代码库中的某个特定部分,例如模型、数据处理或训练函数。
点击某个类别即可进入相应页面,查看更详细的信息。
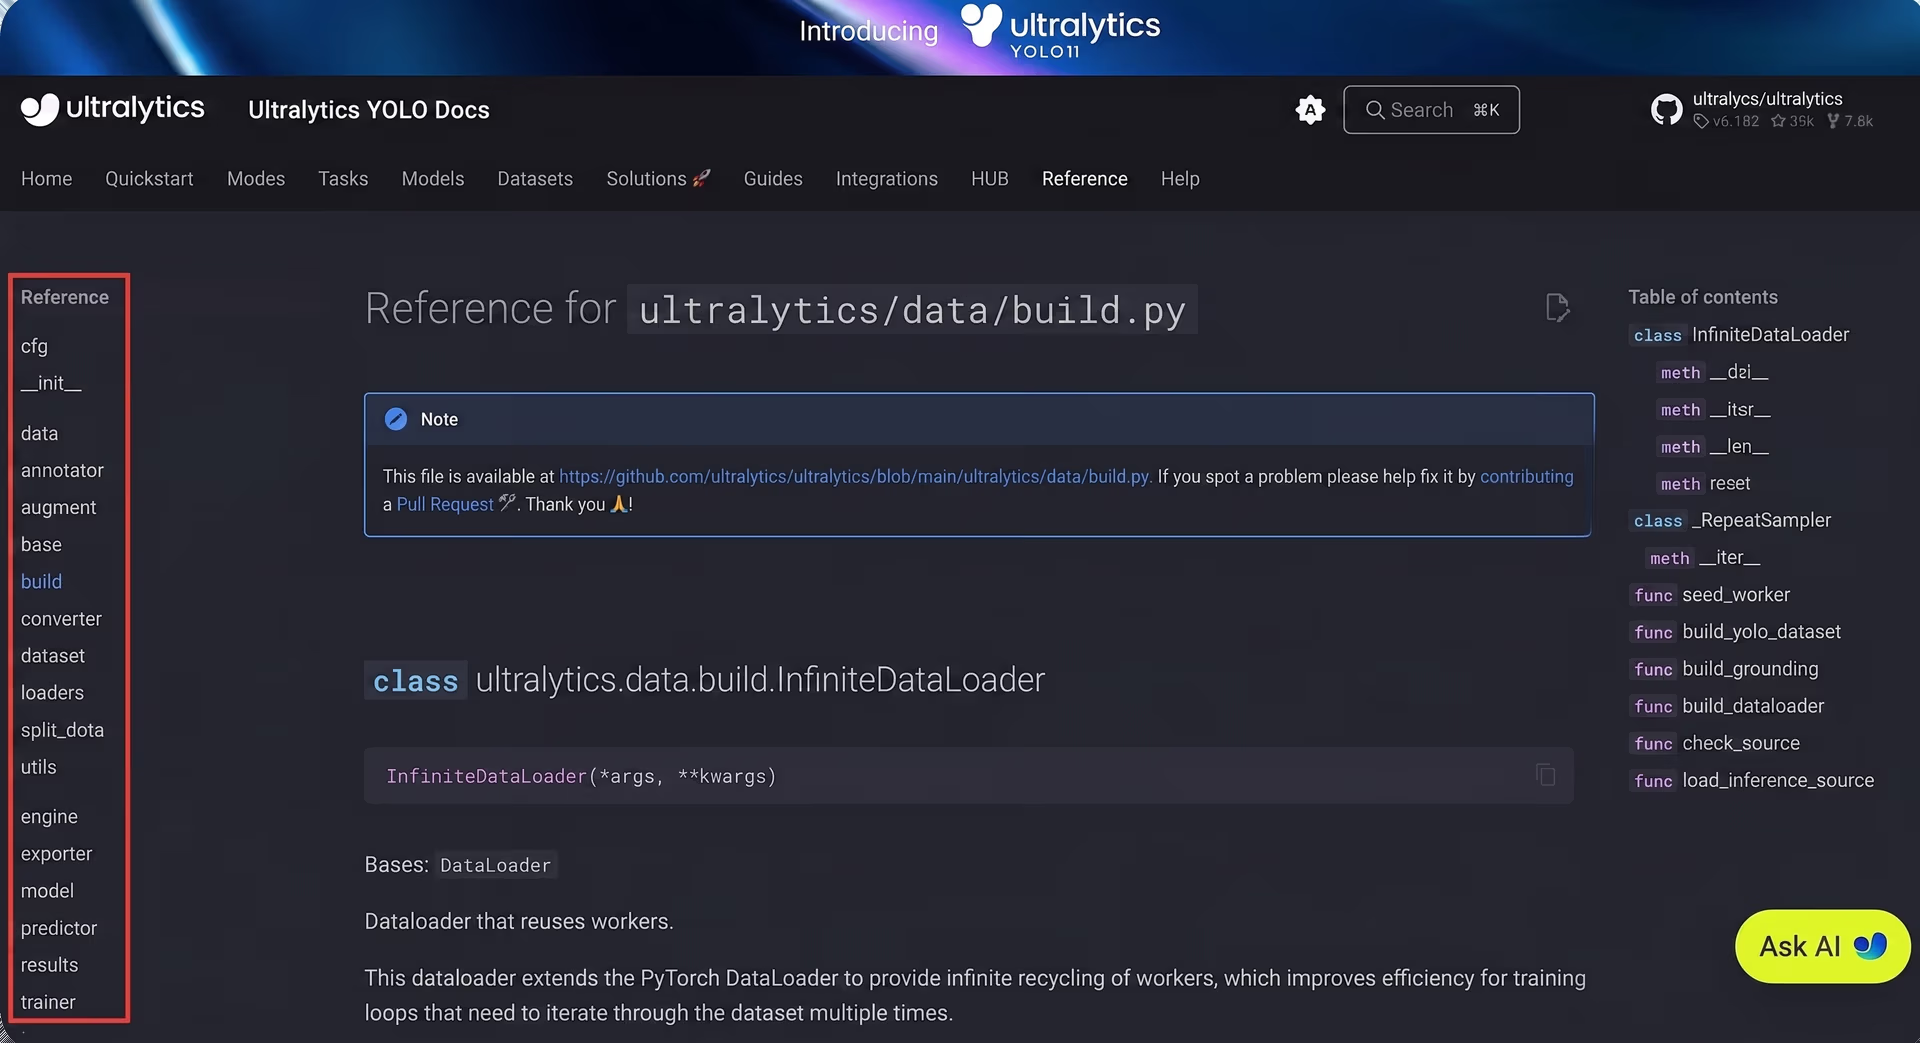
图 2.左侧是包含不同 Reference 类别的菜单。
同样,页面右侧是目录,其中将每个参考页面拆分为关键组成部分,例如函数(可重复使用的代码块)、类(用于创建对象的蓝图)和方法(在类内部定义的函数)。这样你就可以轻松跳转到所需内容。
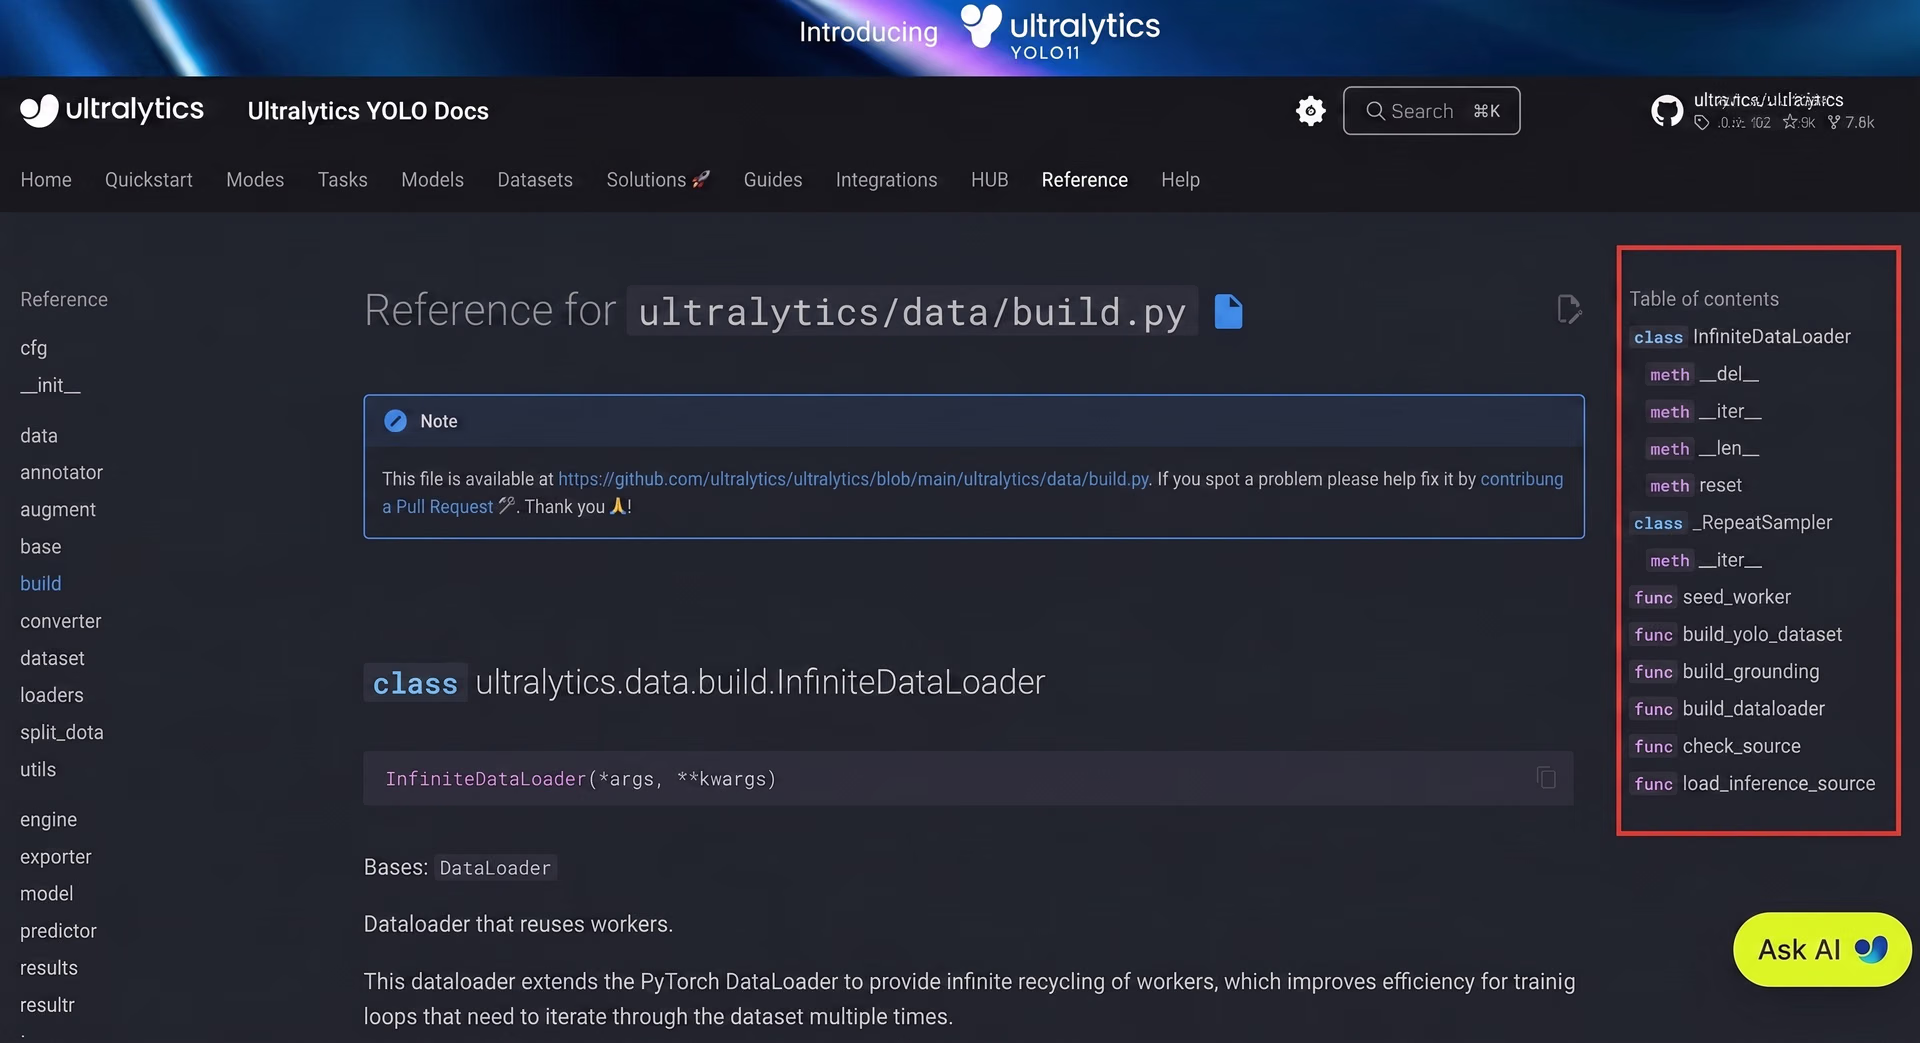
图 3。右侧是你当前查看的特定 Reference 页面的目录。
Ultralytics GitHub 代码库的结构#
Ultralytics GitHub 代码库按照 Ultralytics 软件包的不同组成部分划分为子目录或子软件包,例如模型、训练和数据。文档中的 Reference 部分沿用了相同的结构,因此更容易理解各部分如何协同工作。
以下是 Ultralytics GitHub 代码库和 Ultralytics 文档 Reference 部分中都能看到的一些主要子目录或类别:
- 模型:本部分介绍不同的模型及其模式,例如进行预测、验证性能和导出训练好的模型。
- 引擎:包含用于训练、验证、预测、导出和评估模型的核心逻辑。
- 数据:负责管理数据集的加载、处理和增强。这里包括创建数据加载器(以批次为单位向模型提供数据的工具)、应用变换(例如调整图像大小或翻转图像,帮助模型更好地学习),以及为训练准备数据(整理图像和标签并设置其格式)的函数。
- 实用工具:本部分提供代码库中各处都会用到的多种辅助函数,例如可视化工具、文件处理和指标计算。
- HUB:它连接到 Ultralytics HUB,这是一个无代码计算机视觉平台,可通过 API 使用登录、上传模型和管理数据集等云端功能。
- 跟踪器:实现用于视频或逐帧图像序列应用的目标跟踪逻辑。
GitHub 代码库中的每个子目录在文档中都有对应部分。文档有意采用相同的结构,让你可以更轻松地在阅读文档和浏览源代码之间切换。
事实上,许多 Reference 页面还会展示实际源代码,这样你无需离开文档,就能确切了解函数和类的实现方式。
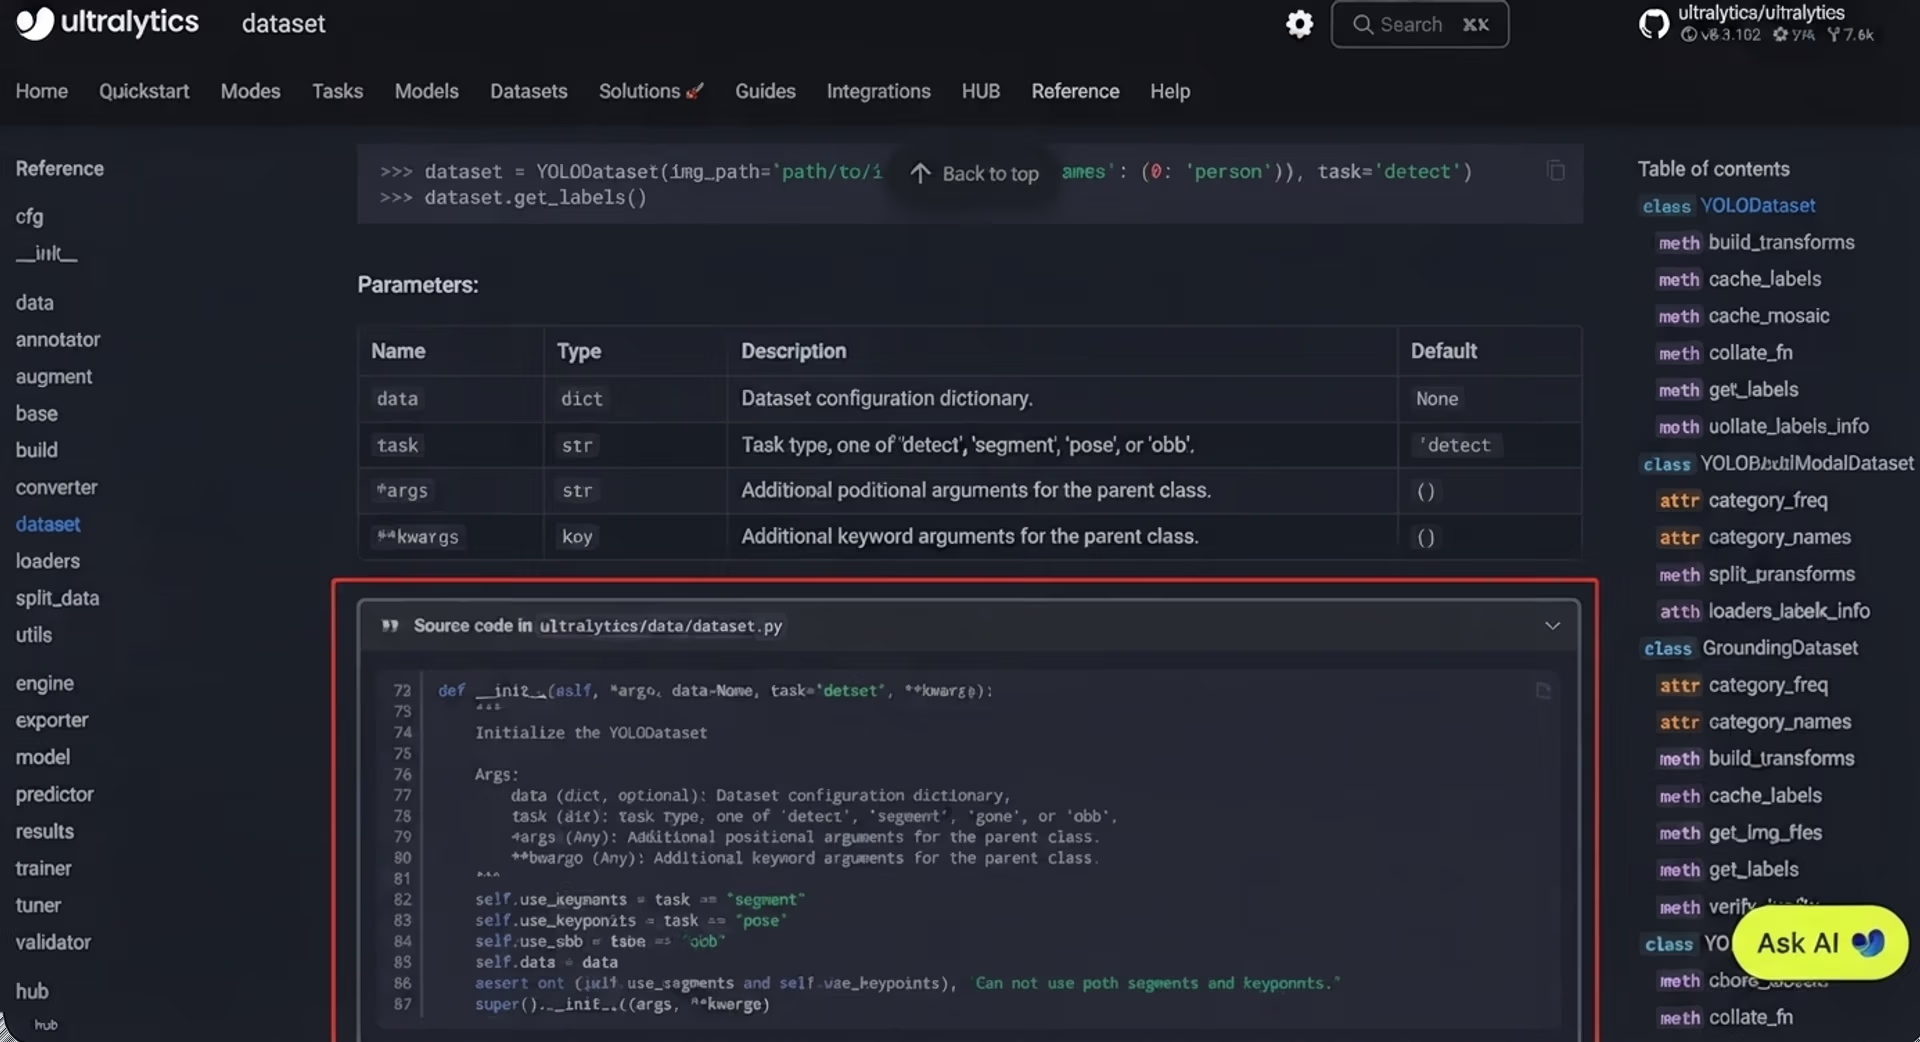
图 4. Reference 页面中也包含源代码。
了解模型、引擎和数据组件#
了解 Reference 部分的组织方式后,我们来仔细看看 Ultralytics 软件包的三个关键部分:模型、引擎和数据。
models 子目录包含定义各类模型工作方式的代码。该目录按模型类型(如 YOLO、FastSAM 或 RT-DETR)和任务(如检测、分割或分类)进行组织。在每个目录中,你都能找到处理特定操作的文件或模块,例如模型如何进行预测、如何训练,或如何评估其性能。
与此同时,engine 子目录在后台管理整个流程。models 子目录侧重于各个模型要执行的任务,而 engine 子目录则侧重于如何以一致且高效的方式实际运行这些任务。
此外,data 子目录负责加载和准备数据集。这部分代码库可确保训练数据干净、结构清晰且内容多样,帮助模型更好地学习并更有效地泛化。
这种清晰的划分让代码更易于维护,也让用户可以灵活地进行自定义。
Reference 部分的使用示例#
你可能会想,了解 Ultralytics 代码库的不同部分为什么重要?如果你知道代码的各个部分分别负责什么,就能更轻松地找到所需信息、进行修改或排查问题。
以下是使用文档中 Reference 部分的一些示例:
- 如果你想知道“模型如何进行预测?”,可以前往 Reference 部分的 Models 类别,选择一种模型类型(如 YOLO),再选择一项任务(如 detect),然后打开 Predict 页面查看详情。
- 如果你想了解如何应用数据增强,可以查看 Data 类别下的 Augment 页面。该页面列出了用于提升模型性能和增加训练数据多样性的内置增强技术。
通过 Reference 部分探索结果#
当你想了解模型返回的输出内容时,Reference 部分也很有帮助。像 Ultralytics YOLO11 这样的模型对图像执行推理后,会返回一组描述检测结果的数据。
例如,在摄像头画面中,模型可能会检测到一个人,并使用边界框标出其位置,同时给出置信度分数——这是一个介于 0 和 1 之间的数值,表示模型对检测结果的确信程度。
如果你想了解如何在项目中使用这些输出,Reference 部分可以为你提供指引。该部分设有 Results 模块页面,详细介绍其中包含的内容以及如何在代码中访问这些内容。页面还介绍了如何查看检测框、检查置信度分数、显示结果或保存结果。
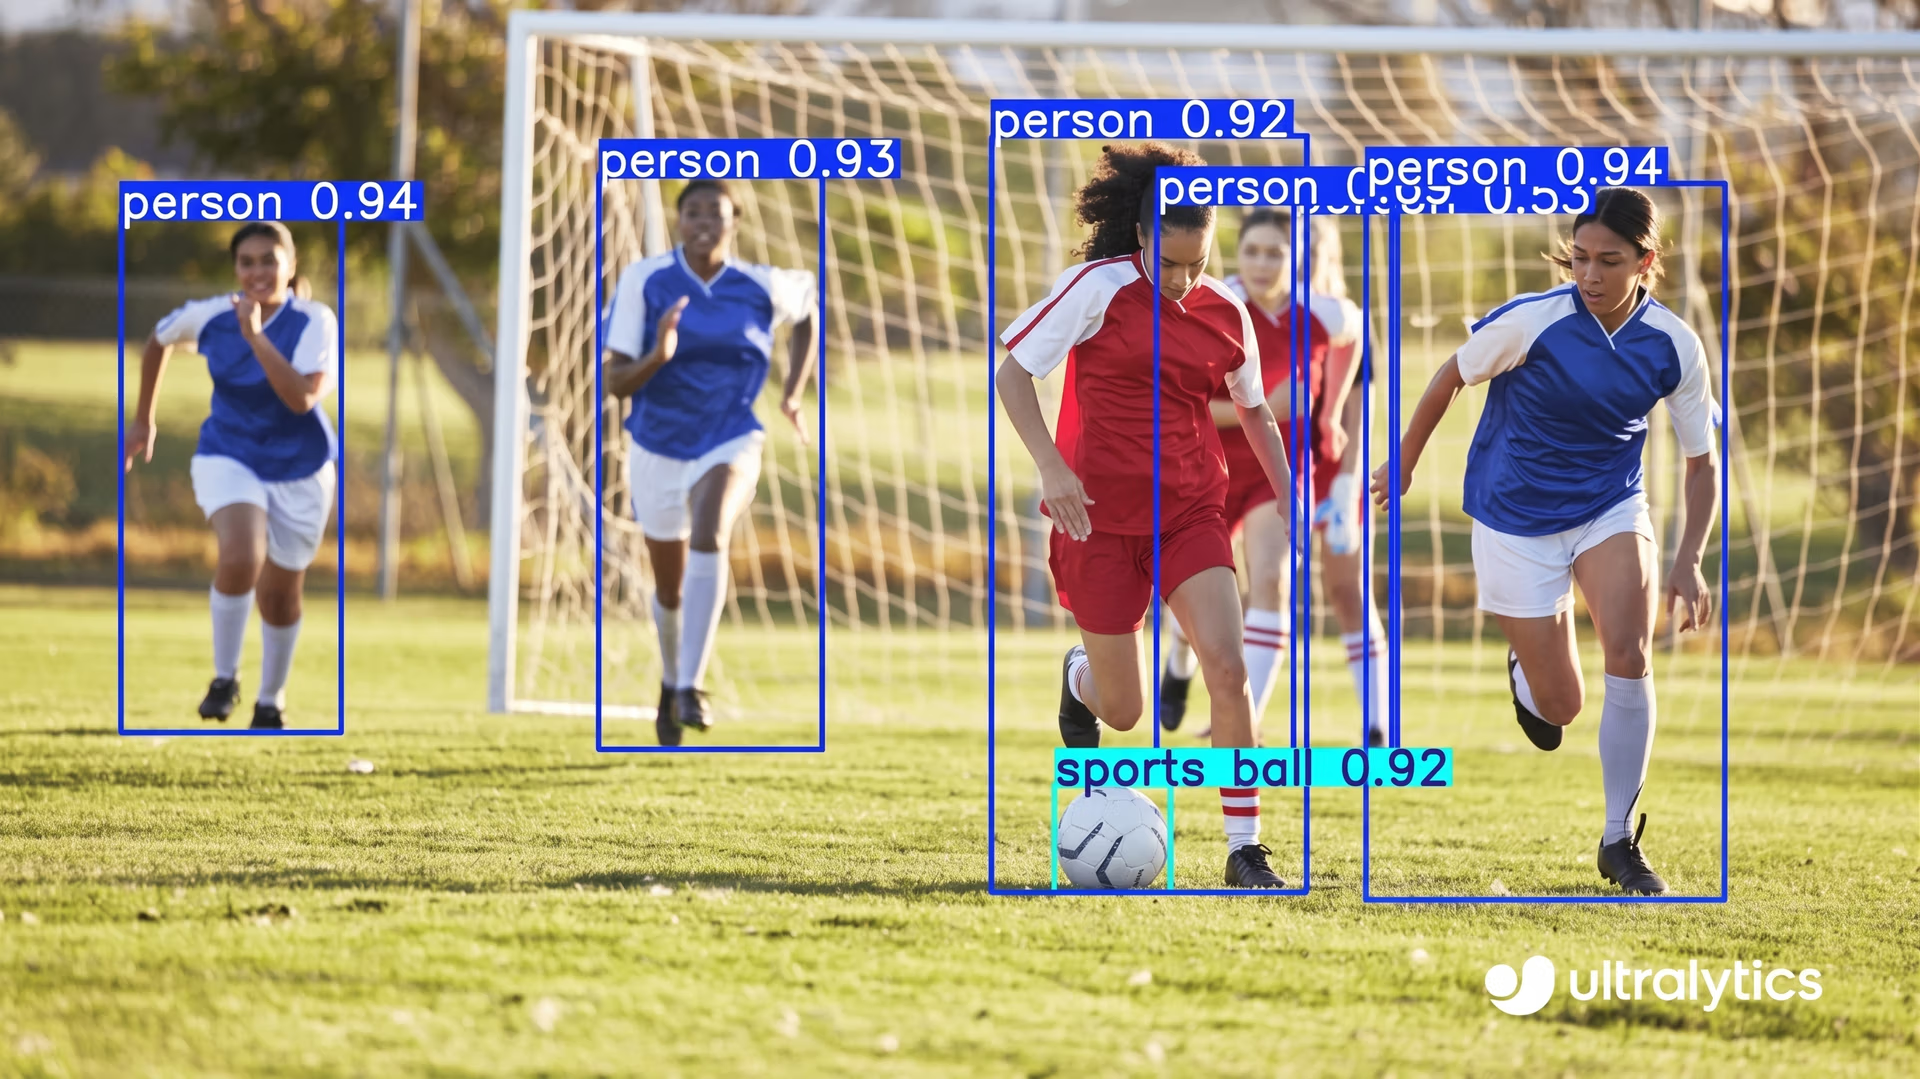
图 5. YOLO11 返回结果的可视化示例。
要点#
Ultralytics 文档可帮助你有效地使用 YOLO 模型。文档介绍了模型训练、数据准备和结果处理等关键流程。每个页面都提供清晰的说明和代码示例,帮助你快速入门。
如果你想了解幕后发生的事情,文档中的 Reference 部分还会逐步进行讲解。该部分展示代码的组织方式、各个部分的作用,以及所有内容如何协同工作。这样你就能更轻松地学习、自定义,并自信地构建自己的计算机视觉项目。
加入活跃的社区,并探索 GitHub 代码库,进一步了解如何利用 AI 进行构建。准备好启动自己的计算机视觉创意了吗?访问我们的许可选项开始使用。访问我们的解决方案页面,了解视觉 AI 在汽车领域的应用和 AI 在医疗保健领域的应用如何产生影响。









