姿势估计工具终极指南
了解如何使用姿势估计工具检测图像和视频中的人体关键点、估计 2D 和 3D 姿势,并为各种视觉 AI 应用提供支持。
 Abirami Vina9 分钟阅读
人类能够凭直觉读懂动作。有人身体前倾、转头或抬起手臂时,你能立刻推断出对方在做什么。这是一种不经意、近乎潜意识的能力,它影响着我们与他人互动以及探索世界的方式。
随着技术在日常生活中变得越来越重要,我们自然希望设备也能像我们一样顺畅地理解动作。人工智能,尤其是基于深度学习的技术,近期取得的进展正让这一点成为可能。具体来说,计算机视觉帮助机器从图像和视频中提取含义,并推动着这一进程。
例如,姿态估计是一项常见的计算机视觉任务,可预测图像或视频帧中预定义身体关键点(如肩部、肘部、髋部和膝盖)的位置。你可以根据固定的骨架定义连接这些关键点,形成简化的姿态表示。
Ultralytics YOLO11 和 Ultralytics YOLO26(现已发布)等计算机视觉模型支持姿态估计等任务,可用于构建实时应用,包括健身和体育训练中的动作反馈、安全监控以及交互式增强现实体验。
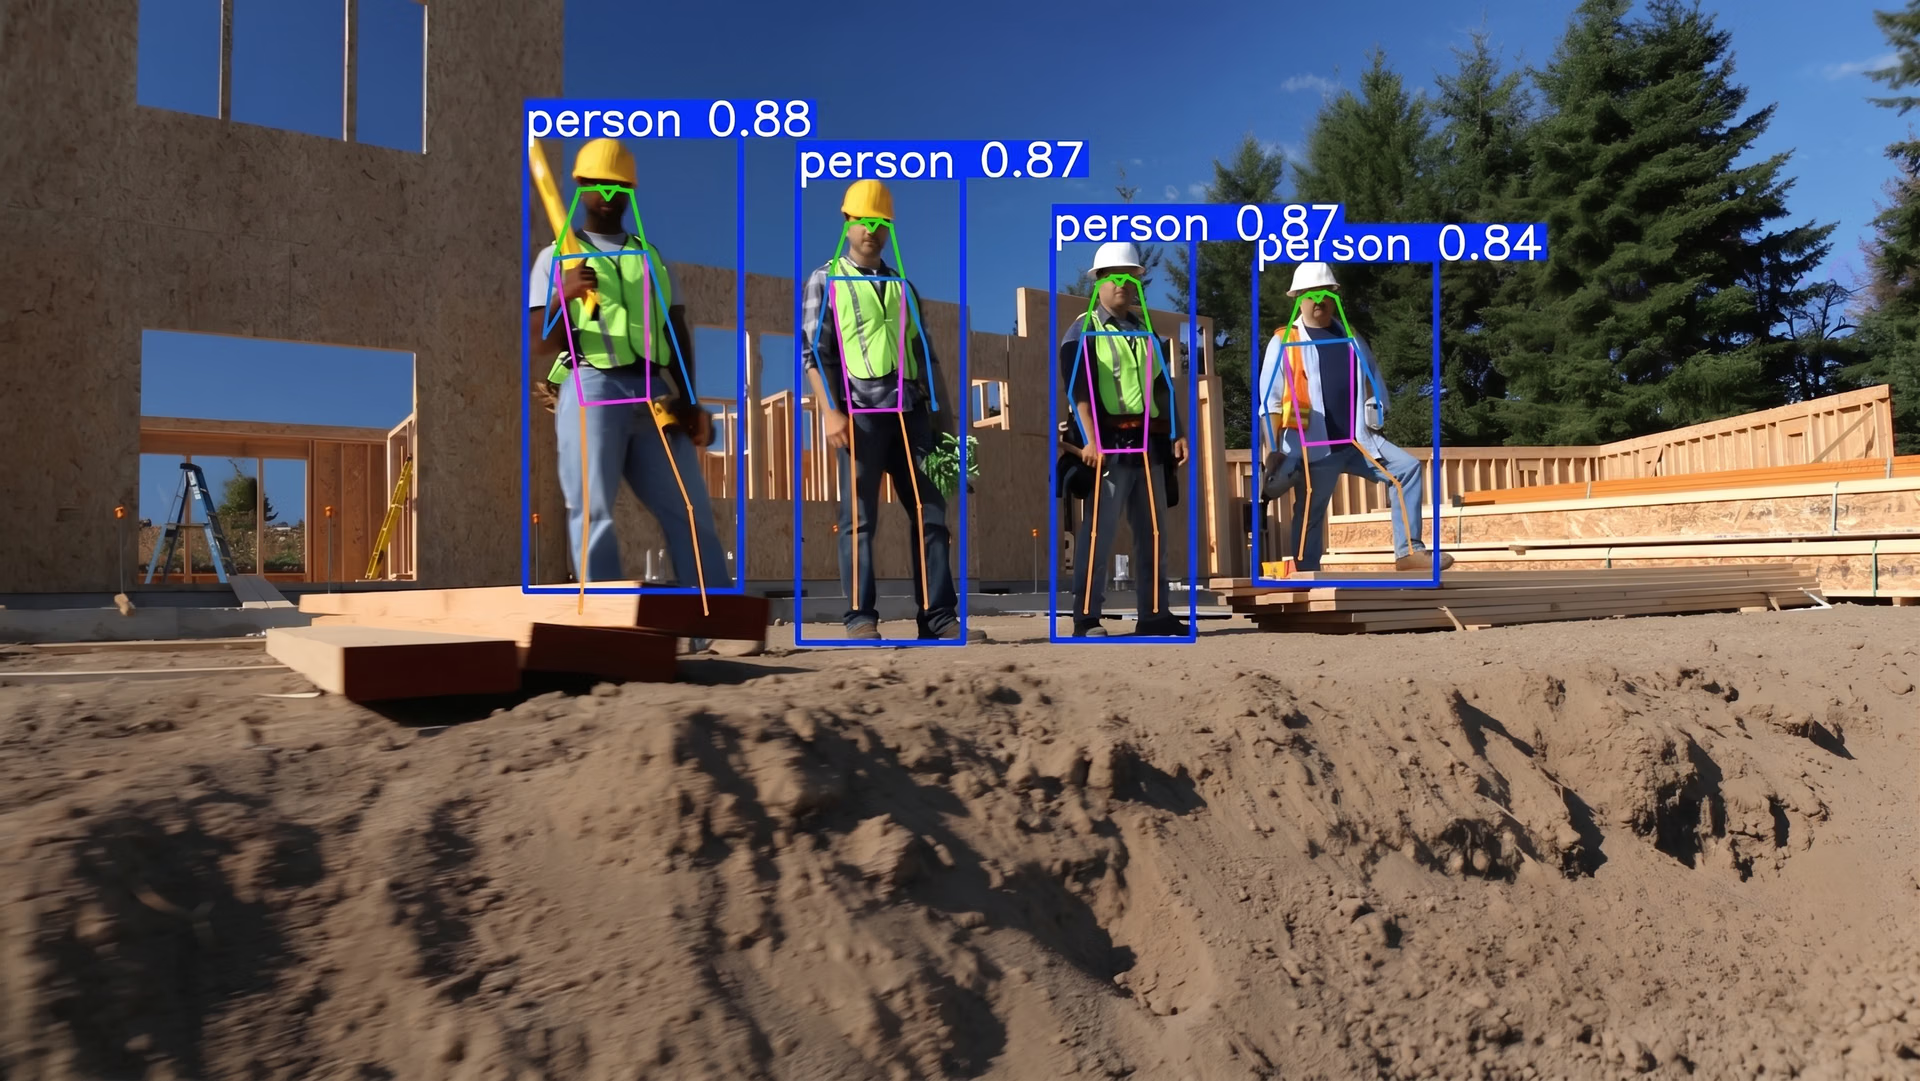
图 1. 使用 Ultralytics YOLO11 进行姿态估计(来源)
本文将深入探讨姿态估计工具,了解姿态估计的工作原理、应用场景,以及目前有哪些优秀模型和库可供使用。
什么是姿态估计?#
姿态估计是一种计算机视觉技术,可帮助系统理解人物或物体在图像或视频中的姿势。它不会平等地分析每个像素,而是预测一组稳定的关键点,例如头部、肩膀、肘部、臀部、膝盖和脚踝。
大多数模型会输出这些关键点的坐标,以及一个反映每项预测正确可能性的分数。之后,可以按照预定义的骨架布局连接这些关键点,形成简单的姿态表示。
在视频中逐帧应用时,可以跨时间关联得到的关键点,以估计动作。这使得动作姿势检查、动作分析和基于手势的交互等应用成为可能。
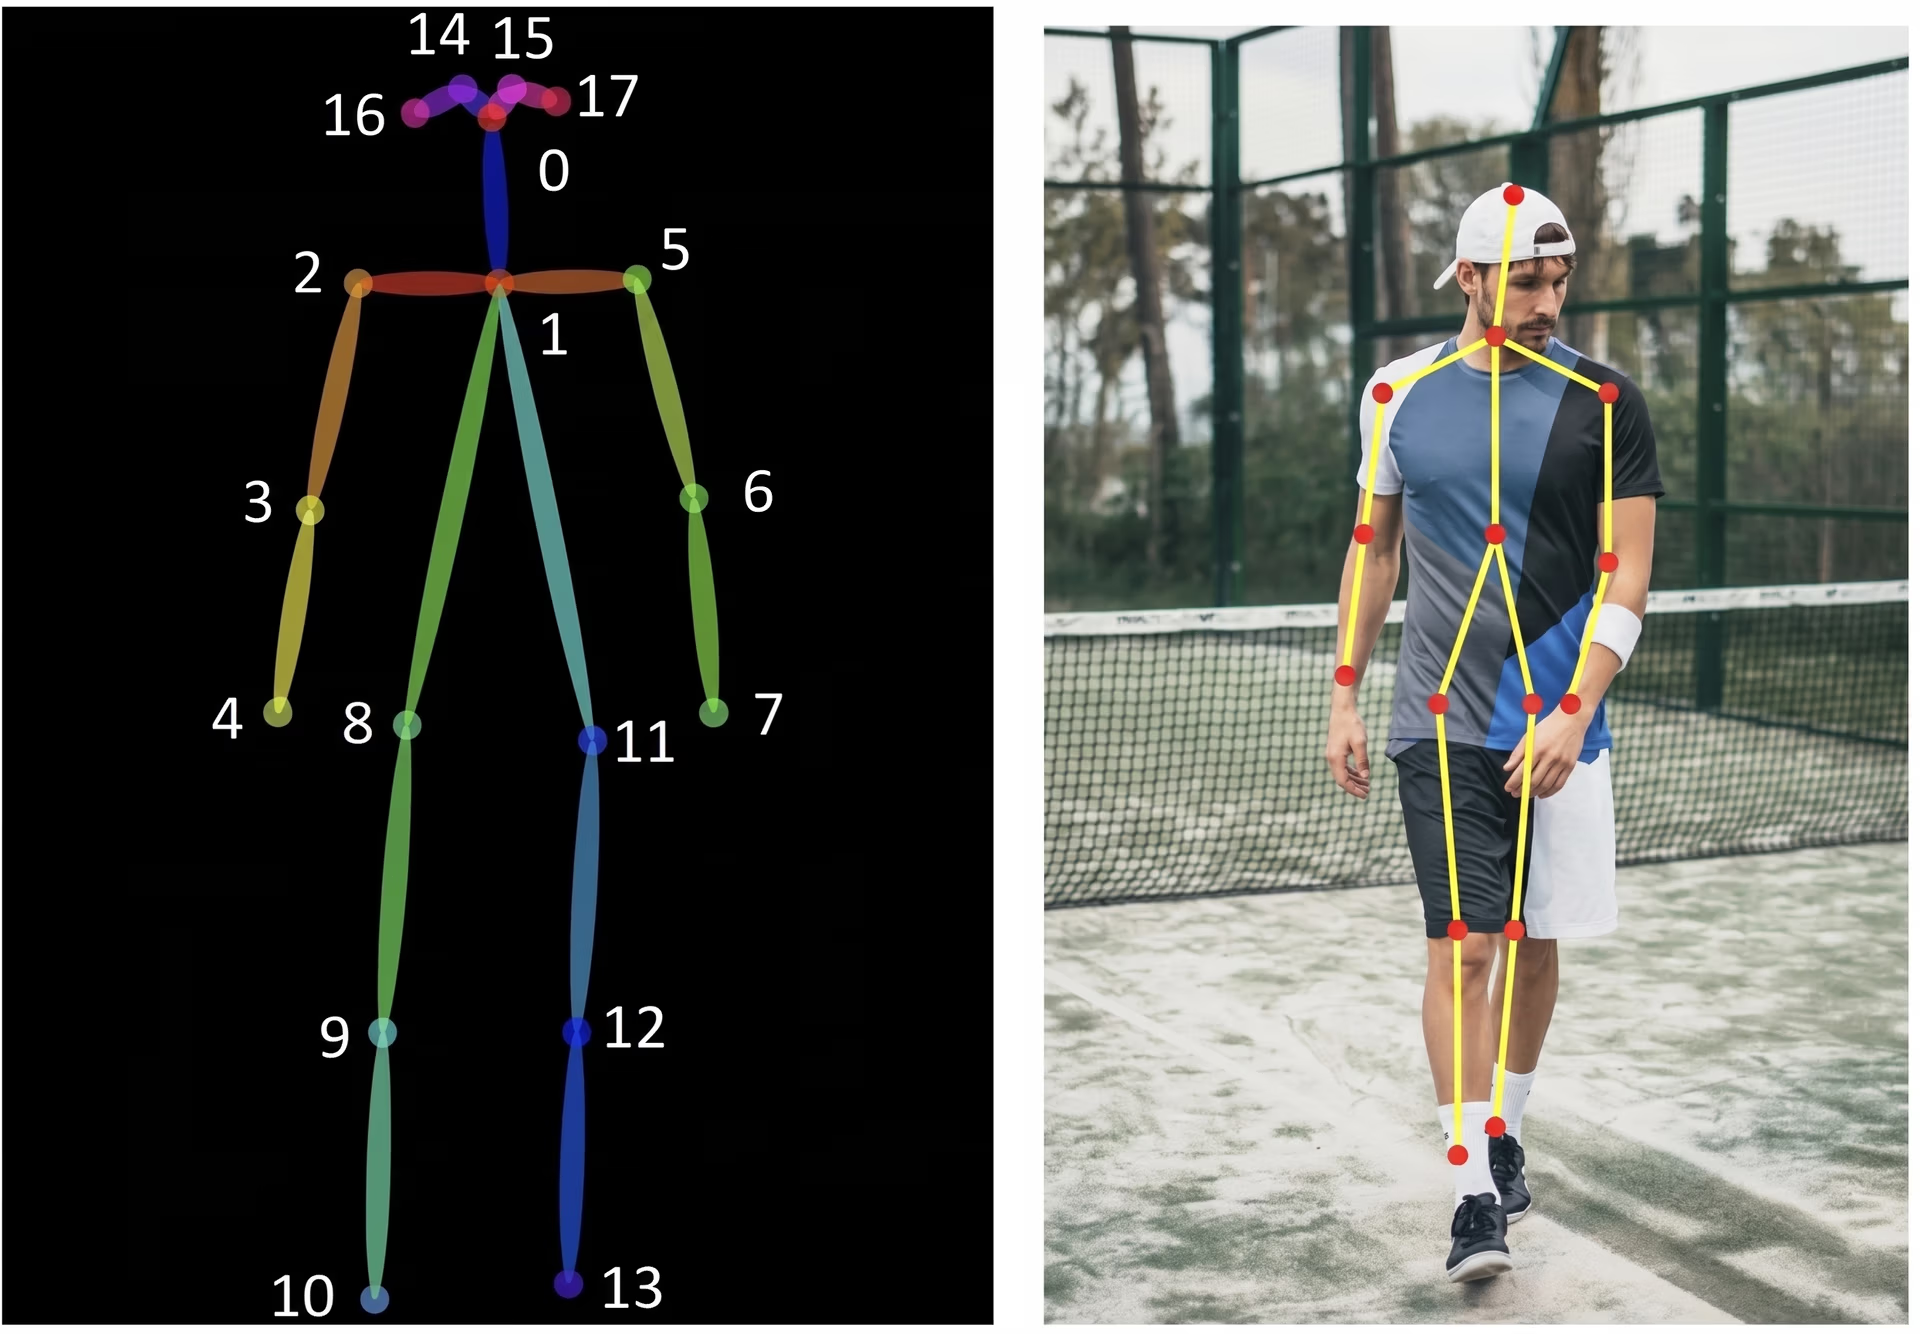
图 2. 姿态估计示例(来源)
姿态估计工具的必要性#
人体动作蕴含大量信息。一个人弯腰、伸手或转移重心的方式,可能透露其意图、用力程度、疲劳状态,甚至受伤风险。直到最近,要捕捉如此细致的信息通常还需要专用传感器、动作捕捉服或受控的实验室环境。
姿态估计改变了这一现状。从普通图像和视频中提取人体关键点,让计算机能够使用标准摄像头分析动作。这让动作分析在现实场景中变得更加普及、可扩展且实用。
以下是姿态估计能够带来影响的几种方式:
- 打造更安全的工作场所:视觉驱动系统可用于在伤害发生前检测危险姿势、重复性劳损或不安全的举重方式。
- 提升健身和体育训练效果:视觉 AI 解决方案可以实时评估动作姿势、平衡能力和技术,让用户无需穿戴设备就能获得即时反馈。
- 医疗保健与康复:临床医生可以通过简单的视频录像远程跟踪康复进展、姿势和关节活动范围。
- 打造交互式体验:姿态估计让数字化身和沉浸式环境更容易准确跟随并呈现人体动作。
姿态估计算法的演进#
姿态估计的概念已经存在多年。早期方法使用简单的几何模型和人工设计的规则,而且通常只在受控环境中有效。
例如,某个系统可能在一个人固定站立时表现良好,但当这个人开始走动、转身或与真实场景中的物体互动时,系统就可能失效。这些方法往往难以应对自然动作、不断变化的摄像机角度、杂乱背景和局部遮挡。
现代姿态估计依靠深度学习来应对这些挑战。通过在大型标注数据集上训练卷积神经网络,模型能够学会有助于在不同姿态、不同人物和不同环境中更可靠地检测关键点的视觉模式。
随着示例不断增加,模型的预测能力会不断提升,也更善于泛化到新的场景。得益于这些进展,姿态估计如今已支持多种实用场景,包括工作场所监控和人体工学,以及教练和分析师研究运动员动作的运动分析。
姿态估计技术的类型#
姿态估计有多种形式,具体取决于应用场景和你需要测量的内容。以下是你会遇到的主要类型:
- 2D 姿态估计:这种方法会检测二维图像或视频帧中的人体关键点。它适用于标准摄像头,计算效率也很高,因此适合基本动作跟踪、姿势分析和实时动作姿势反馈等任务。
- 3D 姿态估计:通过在图像坐标之外估计深度,3D 姿态估计可以从空间角度理解人体动作。当向前和向后的运动很重要时,这种方法尤其有用,例如在运动分析、康复、生物力学和动画领域。具体来说,3D 人体姿态估计可以捕捉三维空间中的关节位置和动作,减少二维投影可能产生的歧义。
- 单人姿态估计:这类系统专为一次跟踪一个人而设计。在受控或半受控环境中,当目标清晰可见时,系统通常表现最佳,例如在指导式锻炼应用、视频通话或动作分析场景中。
- 多人姿态估计:这种方法适用于包含多人的场景,可以同时检测并跟踪多个人的姿态。在工作场所、健身房、公共空间和集体活动等繁忙环境中特别有用,因为不同人物可能会相互重叠或遮挡。
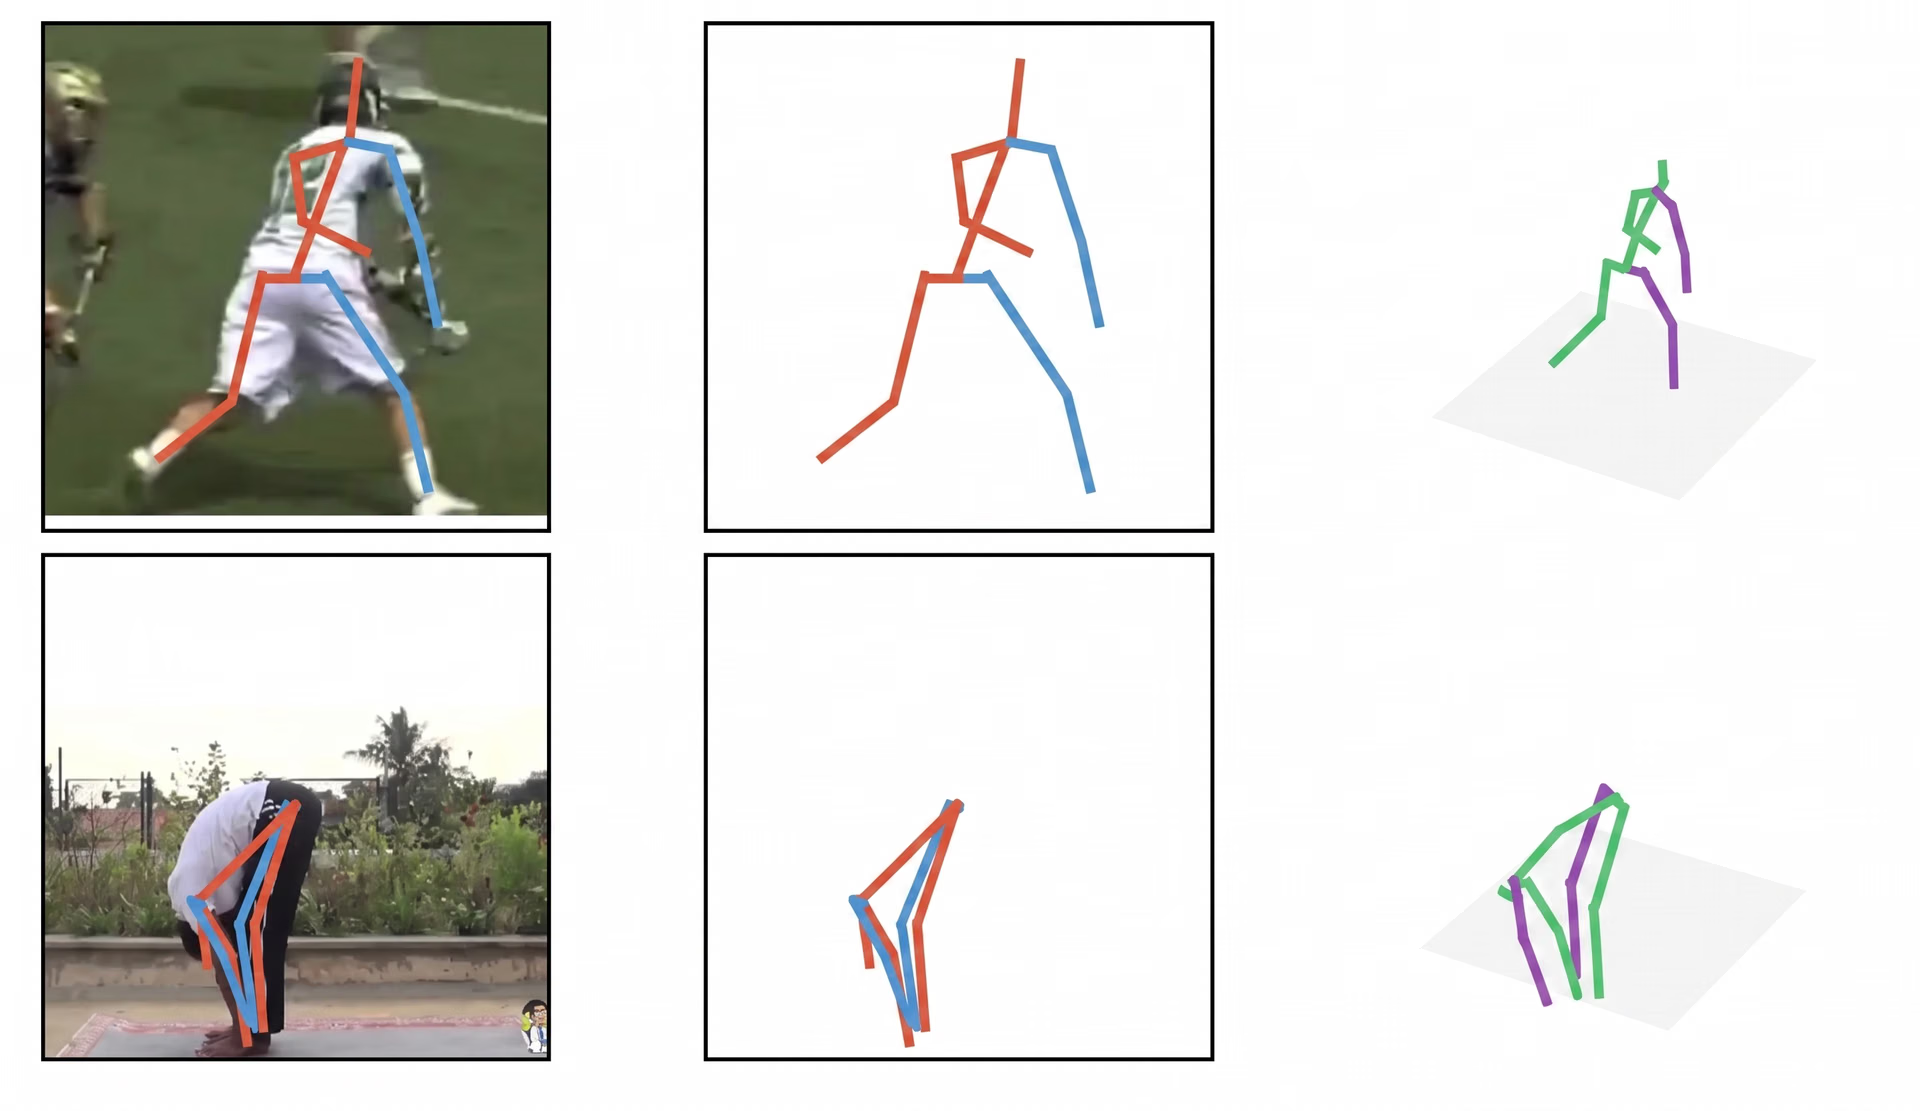
图 3. 理解三维空间与二维图像空间中的人体动作(来源)
了解人体姿态估计模型的工作原理#
姿态估计可以应用于许多类型的物体,但为了简化说明,我们将重点介绍人体姿态估计。
大多数人体姿态估计系统都使用经过标注的数据集进行训练,其中的大量图像和视频帧都标注了关键身体部位。通过这些示例,模型可以学习与肩膀、肘部、臀部、膝盖和脚踝等人体关键点相关的视觉模式,从而准确预测新场景中的关键点。
模型的推理架构也是一个关键因素,它决定了模型如何检测关键点并将它们组合成完整姿态。有些系统会先检测每个人,再估计其所在区域内的关键点;另一些系统则会先在整幅图像中检测关键点,再将它们归组到不同人物。较新的单阶段设计可以通过一次处理来预测姿态,在速度和精度之间取得平衡,适用于实时应用。
接下来,我们详细介绍不同的姿态估计方法。
自底向上的姿态估计#
在自底向上的方法中,模型会查看整幅图像,首先查找头部、肩膀、肘部、臀部、膝盖和脚踝等身体关键点。在这一阶段,模型不会尝试区分不同的人,而是检测场景中姿态骨架定义的所有关键点或身体关节。
之后,系统会执行第二步,将这些点连接起来。系统会关联属于同一个人的关键点,并将它们组合成完整的骨架,每个人对应一个骨架。由于不需要先检测每个人,自底向上的方法通常适用于拥挤场景,即使人物相互重叠、大小不一或部分被遮挡也能处理。
自顶向下的姿态检测#
相比之下,自顶向下的系统会先检测图像中的每个人。系统会在每个人周围框出边界框,并将每个框作为独立区域进行分析。
确定某个人所在区域后,模型会预测该区域内的身体关键点。这种分步方法通常能生成非常准确的结果,尤其是在场景中的人数较少且每个人都清晰可见时。
单阶段或混合式姿态估计#
单阶段模型有时也称为混合式模型,可以通过一次处理来预测姿态。它们不会先进行人物检测、再进行关键点估计,而是同时输出人物位置和身体关键点。
由于所有操作都在一个模块中完成,这些模型通常速度更快、效率更高,因此非常适合实时动作跟踪和动作捕捉等应用。Ultralytics YOLO11 等模型正是基于这一思路构建的,旨在兼顾速度和可靠的关键点预测。
姿态估计模型的训练与评估#
无论采用哪种方法,姿态估计模型要在真实环境中可靠运行,都仍然需要经过谨慎的训练和测试。模型通常使用大量图像(有时也包括视频)进行学习,这些数据中的人体关键点都已标注,可帮助模型应对不同的姿态、摄像机角度和环境。
一些知名的姿态估计数据集包括 COCO Keypoints、MPII Human Pose、CrowdPose 和 OCHuman。如果这些数据集无法反映模型部署时将面对的环境,工程师通常会从目标场景(如工厂车间、健身房或诊所)收集并标注更多图像。
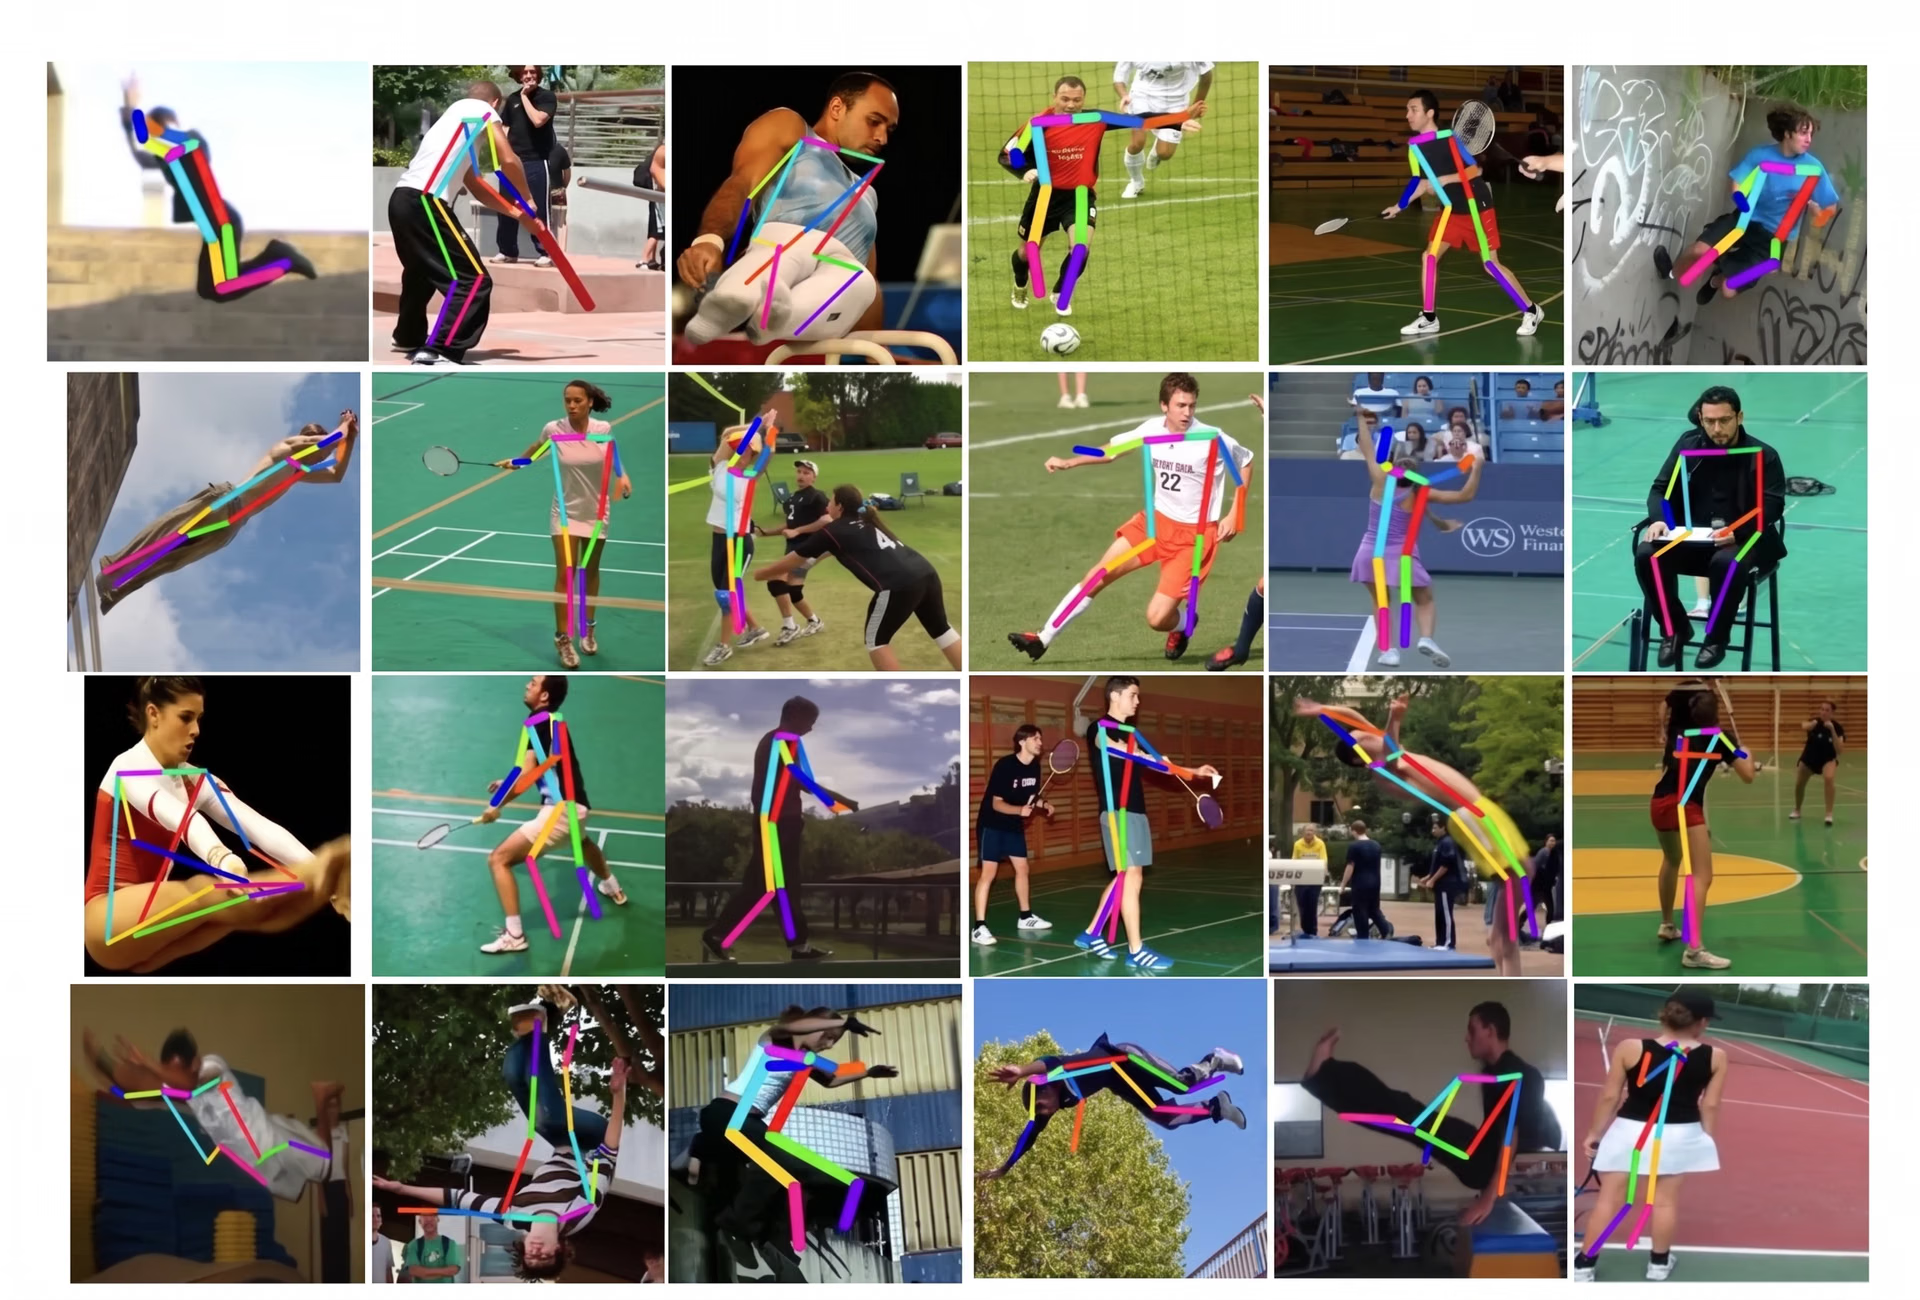
图 4. 使用计算机视觉估计各种姿态(来源)
训练完成后,会在标准基准上评估模型性能,以衡量精度和鲁棒性,并为进一步调整模型以适应真实应用提供依据。结果通常使用平均精度均值报告,通常简称为 mAP。该指标通过将预测姿态与标注的真实值进行比较,汇总模型在不同置信度阈值下的性能。
在许多姿态基准测试中,会使用目标关键点相似度(OKS)将预测姿态与真实标注姿态匹配。OKS 衡量预测关键点与标注关键点之间的接近程度,同时会考虑人物尺度以及各关键点的典型定位难度等因素。
姿态模型还会为检测到的人物和各个关键点输出置信度分数。这些分数反映模型的确信程度,可用于对预测结果排序和筛选;在遮挡、运动模糊或摄像机角度异常等具有挑战性的条件下,这一点尤为重要。
热门姿态估计工具和库#
如今有许多姿态估计工具可供选择,各自在速度、准确度和易用性之间有所取舍。以下是一些最常用的工具和库:
- Ultralytics YOLO11:YOLO11 是先进的开源视觉 AI 模型,基于 Ultralytics YOLOv8 等早期模型开发而来。它提升了速度、准确率和整体效率,同时支持多种计算机视觉任务,包括姿态估计。YOLO11 在从笔记本电脑到边缘设备的各种平台上表现出色,是许多实际部署场景的理想选择。
- Ultralytics YOLO26:这款于 2026 年 1 月发布的新一代模型更轻、更小、速度更快,同时保持了出色的准确率。它专为实时使用和便捷部署而打造,支持目标检测、实例分割和姿态估计等任务,并提供多种模型尺寸,适用于从边缘设备到大型系统的各种场景。
- MediaPipe:这是一个用于构建视觉和机器学习流水线的跨平台框架。它轻量且能在移动设备、平板电脑和 Web 应用中高效运行,并提供可直接使用的解决方案和模型,用于全身姿态估计、人脸关键点检测和手部追踪。
- OpenPose:这套端到端开源姿态估计系统以多人关键点检测而广为人知。它可以同时估计身体、手部和面部关键点,常用于研究、动画和运动分析。
- MMPose:MMPose 是 OpenMMLab 生态系统中基于 PyTorch 的姿态估计工具包。它提供了丰富的模型实现、训练工具和配置选项,适用于实验和深度定制。
- HRNet 和 AlphaPose:这两种较早的姿态估计模型至今仍用于研究。HRNet 是一种姿态模型架构,可在整个网络中保留高分辨率图像特征,从而帮助模型精确定位关键点。AlphaPose 是广泛使用的多人姿态估计系统,常用于拥挤或复杂场景下需要高准确度的情况。
姿态分析与估计的实际应用#
姿态估计正日益用于将普通视频转化为有用的动作洞察。通过逐帧追踪人体关键点,这些系统可以根据摄像头画面推断姿势、动作和身体行为,让这项技术在许多实际场景中得到应用。
例如,在医疗保健和康复领域,姿态追踪可以帮助临床医生观察并测量患者在治疗和康复过程中的动作。通过从普通视频录像中提取人体特征点,这项技术可以用于评估患者的姿势、活动范围以及随时间变化的整体动作模式。这些测量结果可以辅助并优化传统临床评估,在某些情况下,还能让临床医生无需可穿戴传感器或专用设备就能更轻松地追踪康复进展。
同样,在体育和转播领域,姿态估计可以直接根据视频画面分析运动员的动作。一个有意思的例子是鹰眼(Hawk-Eye),这是一套基于摄像头的追踪系统,用于职业体育赛事的裁判工作和转播图形展示。它还可以通过估计摄像头画面中运动员的身体关键点来进行骨骼追踪。
如何选择合适的姿态估计工具#
选择合适的姿态估计工具,首先要了解你的计算机视觉项目需求。有些应用优先考虑实时速度,有些则需要更高的准确度和细节表现。
目标部署设备也会影响选择。移动应用和边缘设备通常需要轻量、高效的模型,而较大的模型往往更适合服务器或云环境。
此外,易用性也会影响选择。完善的文档、顺畅的部署流程以及对自定义训练的支持,都能简化你的项目。
简而言之,不同工具各有所长。例如,Ultralytics YOLO models 在速度、准确度和部署便捷性之间取得了实用的平衡,适用于许多实际姿态估计应用。
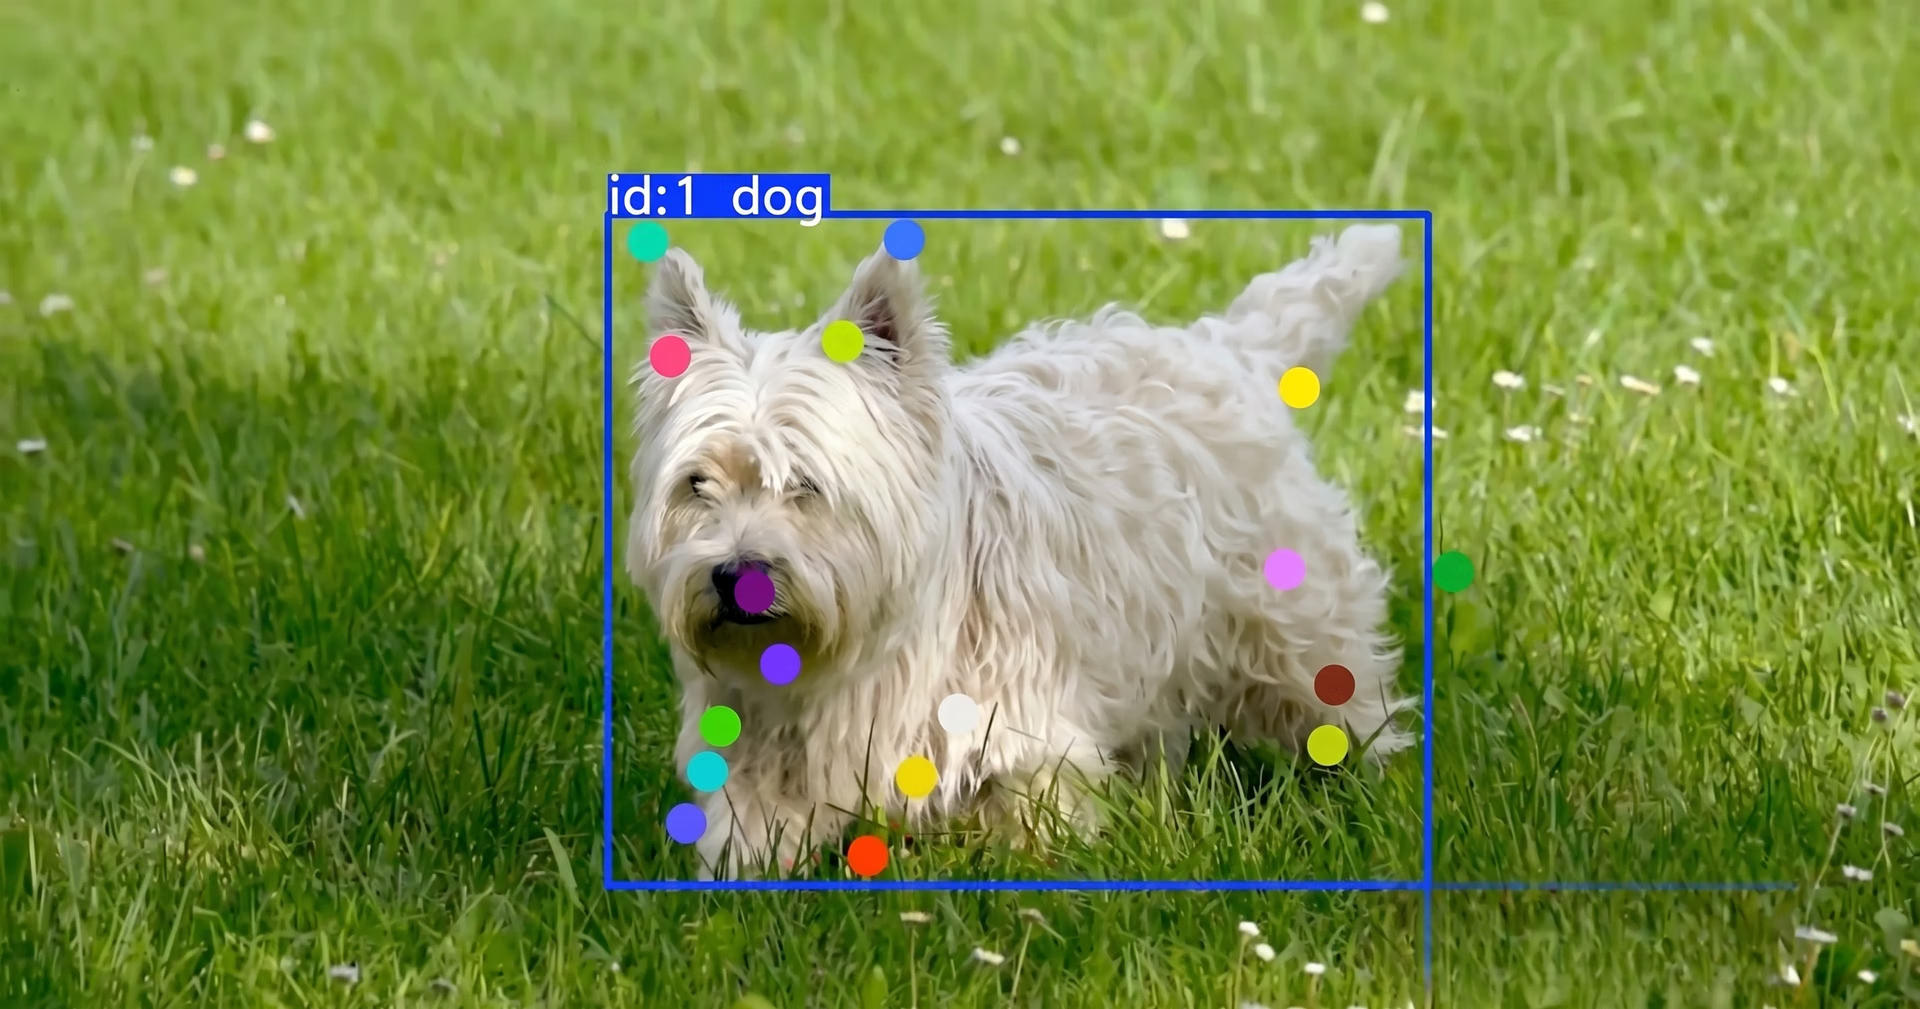
图 5. 使用 Ultralytics YOLO11 进行动物姿态估计(来源)
要点#
姿态估计通过检测图像和视频中的人体关键点,帮助计算机理解人体动作。YOLO11 和 YOLO26 等模型让你更轻松地构建实时应用,适用于体育、医疗保健、工作场所安全和交互式体验等领域。随着模型不断提速并提升准确度,姿态估计很可能会成为许多视觉 AI 系统的常见功能。
想进一步了解 AI?欢迎查看我们的社区和 GitHub 代码仓库。浏览我们的解决方案页面,了解机器人领域的 AI和制造业中的计算机视觉。了解我们的许可选项,立即开始构建计算机视觉应用!
作者
评论
提出问题、分享你的结果,或帮助其他人。









