كيف يوفّر Ultralytics YOLO26 تدريبًا أذكى باستخدام ProgLoss وSTAL وMuSGD
تعرّف على كيفية تدريب Ultralytics YOLO26 بموثوقية أكبر باستخدام موازنة الخسارة التدريجية، وتعيين التسميات المراعي للأهداف الصغيرة، ومُحسِّن MuSGD.
أطلقنا الأسبوع الماضي Ultralytics YOLO26، واضعين معيارًا جديدًا لنماذج الرؤية الحاسوبية الآنية المصممة للمعالجة الطرفية أولًا. وعلى غرار نماذج Ultralytics YOLO السابقة، مثل Ultralytics YOLO11، يدعم YOLO26 مهام الرؤية الحاسوبية الأساسية المألوفة للمستخدمين، بما فيها اكتشاف الأجسام وتجزئة الكائنات وتقدير الوضعيات.
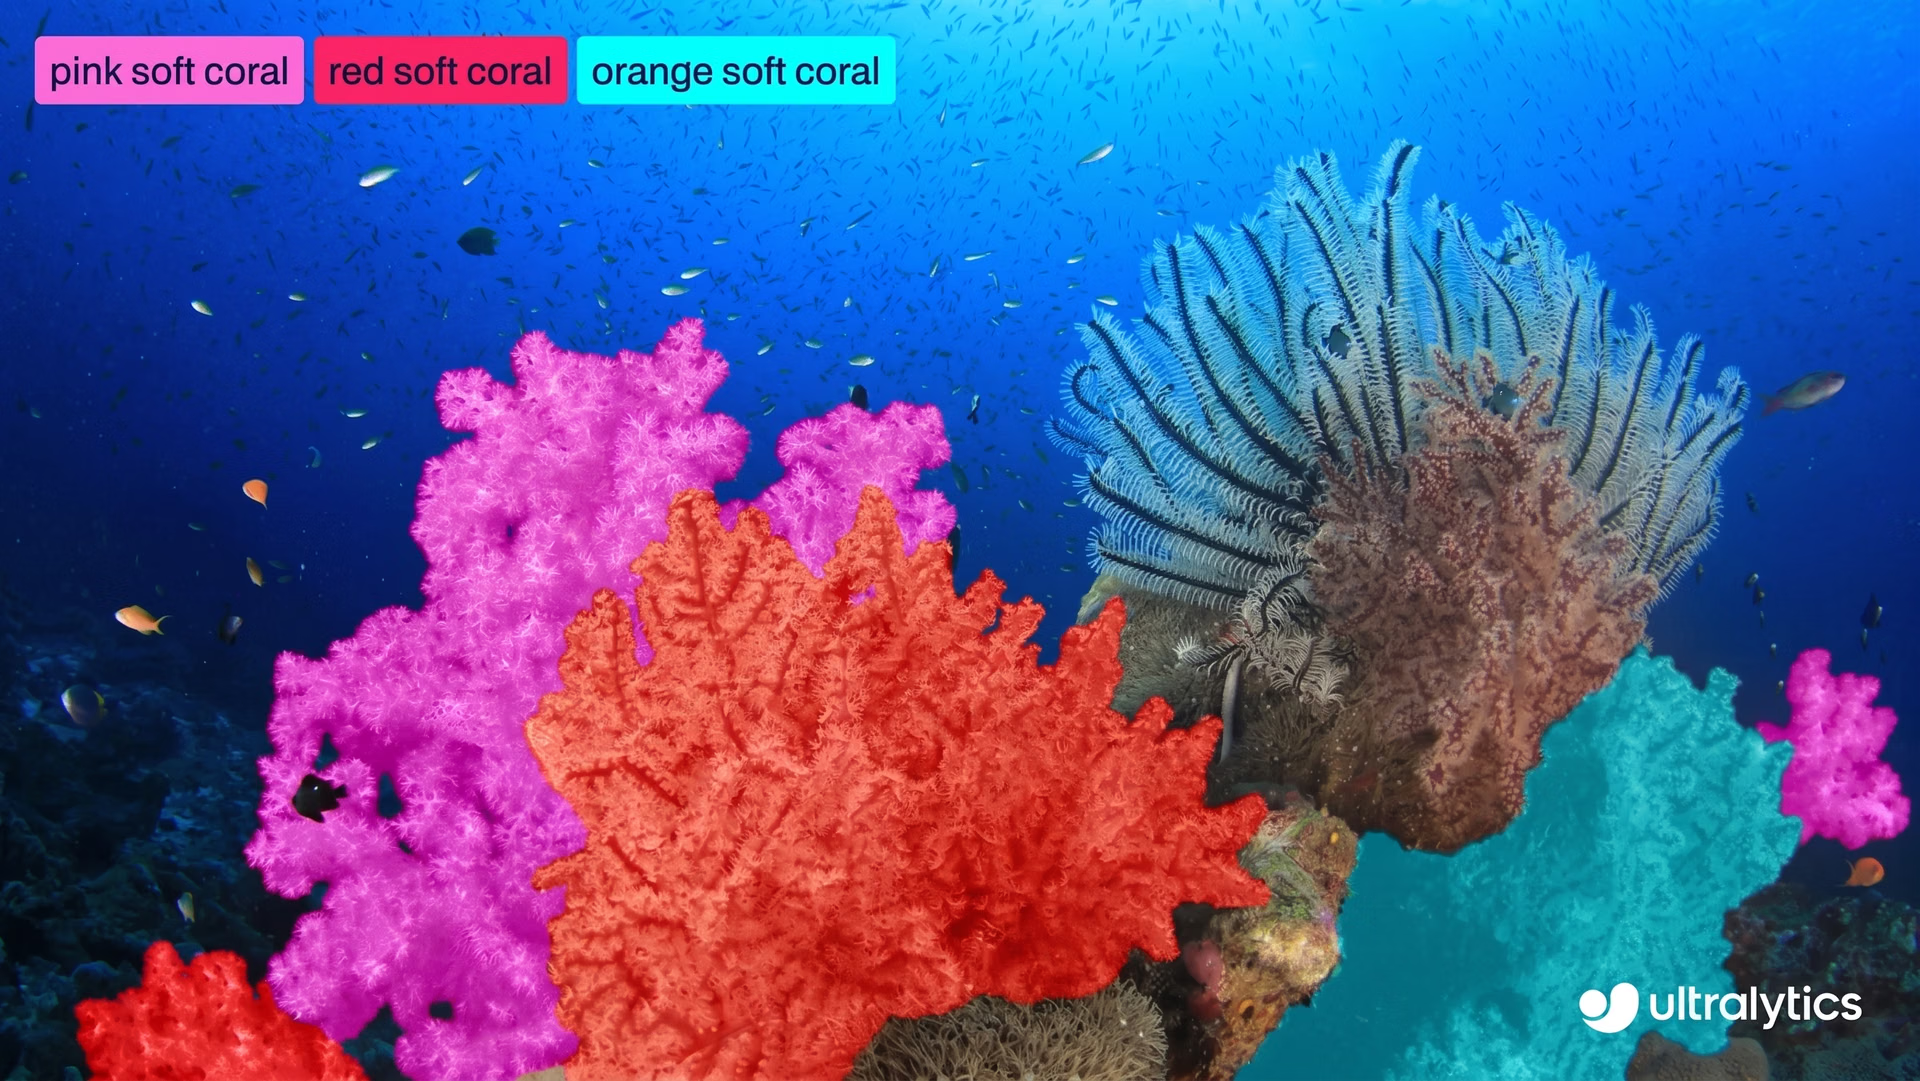
الشكل 1. مثال على استخدام Ultralytics YOLO26 لتجزئة الأجسام في صورة.
لكن Ultralytics YOLO26 ليس مجرد تحديث تدريجي. فعلى الرغم من أن المهام المدعومة قد تبدو مألوفة، يمثل هذا النموذج الجديد خطوة مبتكرة إلى الأمام في طريقة تدريب نماذج الرؤية الحاسوبية. ومع YOLO26، يتجاوز التركيز كفاءة الاستدلال ليشمل جعل التدريب أكثر استقرارًا.
صُمم Ultralytics YOLO26 مع مراعاة دورة التدريب الكاملة. وهذا يعني تقاربًا أسرع، وعمليات تدريب أكثر موثوقية، وسلوكًا متسقًا للنموذج. وتكتسب هذه التحسينات أهمية خاصة في سير العمل الواقعي، حيث تؤثر موثوقية التدريب مباشرةً في سرعة تكرار النماذج ونشرها.
لتحقيق ذلك، يقدم Ultralytics YOLO26 عدة ابتكارات موجّهة في التدريب، مثل موازنة الخسارة التدريجية (ProgLoss)، وإسناد التسميات الواعي بالأهداف الصغيرة (STAL)، ومحسّن MuSGD. وتُحسّن هذه التغييرات مجتمعةً موازنة خسارة التعلم، وإسناد التسميات، وسلوك التحسين بمرور الوقت.
في هذه المقالة، سنستكشف آلية عمل كل واحدة من هذه الآليات، وسبب جعلها تدريب Ultralytics YOLO26 أسهل وأكثر موثوقية على نطاق واسع. لنبدأ!
Ultralytics YOLO26: صُمم لتدريب أذكى، لا لمجرد تشغيل أسرع#
يُبسّط Ultralytics YOLO26 مسار الاستدلال بأكمله بطبيعته، إذ يلغي الاعتماد على خطوات المعالجة اللاحقة مثل كبت غير الأقصى. وبدلًا من إنشاء تنبؤات متداخلة كثيرة وتصفيتها لاحقًا، ينتج YOLO26 الاكتشافات النهائية مباشرةً من الشبكة.
وهذا يجعل YOLO26 نموذجًا شاملًا، إذ يتعلم النموذج نفسه التنبؤات وحل التكرارات والمخرجات النهائية. ويبسّط ذلك النشر ويحسّن كفاءة الاستدلال، كما يؤثر في طريقة تعلّم النموذج أثناء التدريب.
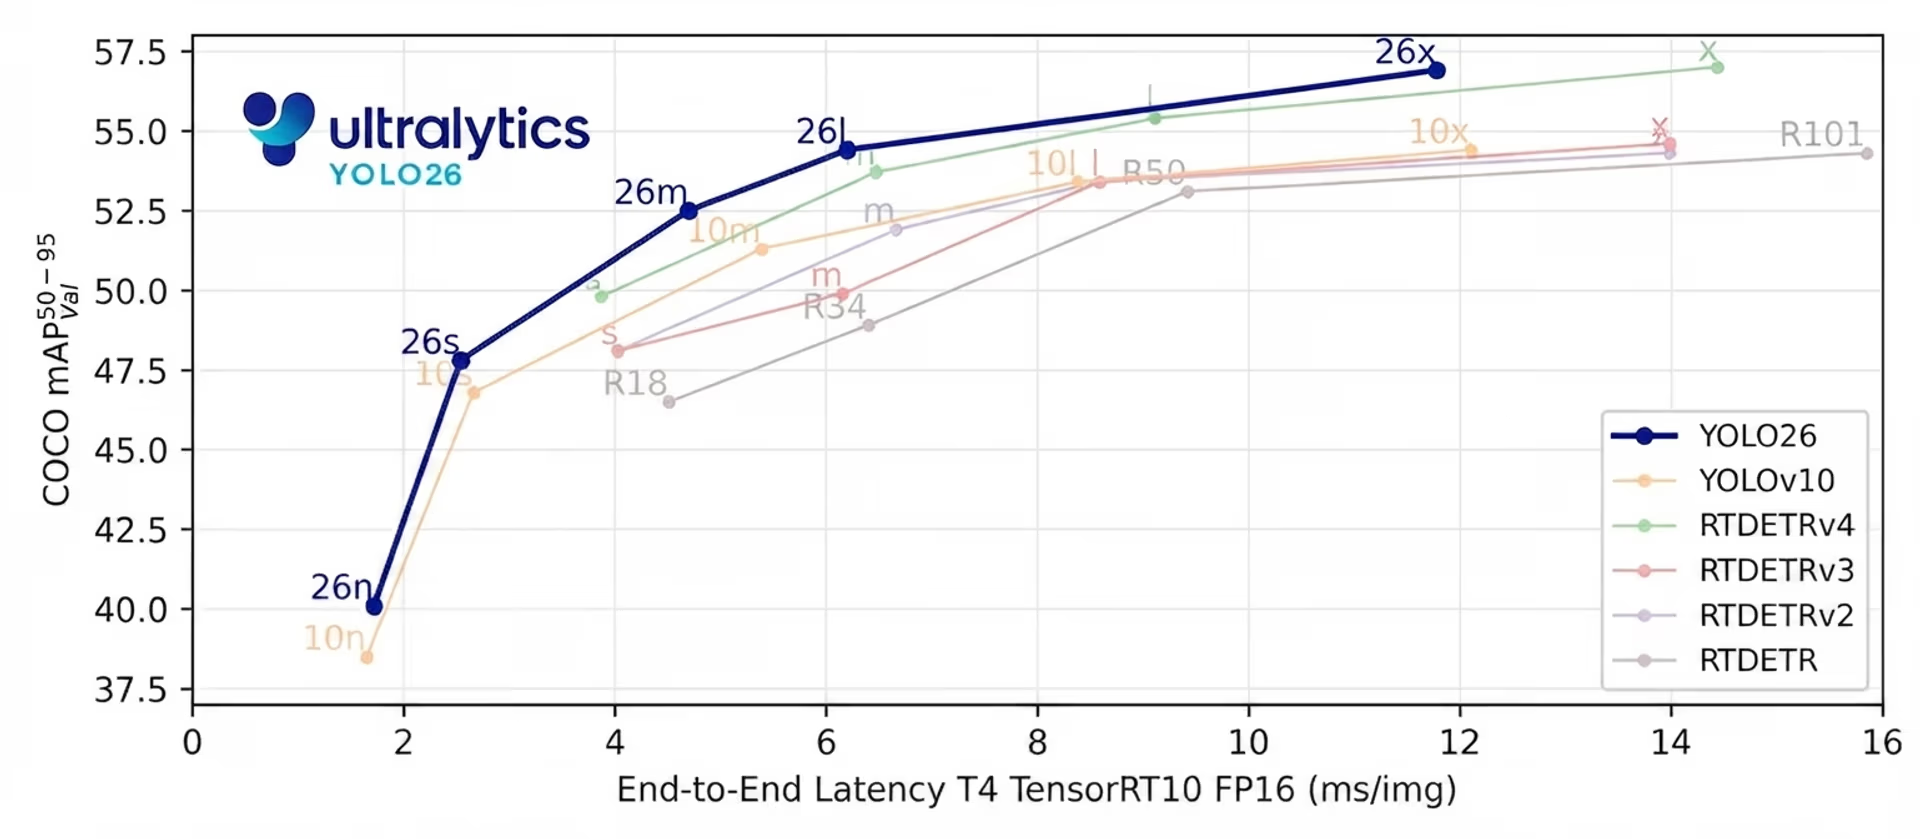
الشكل 2. يقدّم YOLO26 استدلالًا متطورًا من البداية إلى النهاية وخاليًا من NMS (المصدر)
في نظام شامل من البداية إلى النهاية كهذا، يرتبط التدريب والاستدلال ارتباطًا وثيقًا. ولأنه لا توجد مرحلة معالجة لاحقة خارجية لتصحيح التنبؤات لاحقًا، يجب أن يتعلم النموذج اتخاذ قرارات واضحة وواثقة أثناء التدريب نفسه.
لذلك، تكتسب المواءمة بين أهداف التدريب وسلوك الاستدلال أهمية خاصة. فأي تعارض بين طريقة تدريب النموذج وطريقة استخدامه وقت الاستدلال قد يؤدي إلى تعلّم غير مستقر أو تقارب أبطأ.
يعالج Ultralytics YOLO26 ذلك بتصميم عملية التدريب بما يراعي الاستخدام الواقعي منذ البداية. فبدلًا من التركيز على سرعة الاستدلال وحدها، صُمّم نظام التدريب لدعم تعلّم مستقر على مدى فترات طويلة، وتقارب متسق عبر أحجام النماذج من Nano إلى Extra Large، وأداء قوي على مجموعات بيانات متنوعة.
كيف يحسّن رأسا التدريب التعلّم في Ultralytics YOLO26#
يستند أحد ابتكارات التدريب الرئيسية في Ultralytics YOLO26 إلى نهج التدريب ذي الرأسين المستخدم في نماذج YOLO السابقة. في نماذج اكتشاف الكائنات، يشير الرأس إلى جزء الشبكة المسؤول عن إصدار التنبؤات.
بعبارة أخرى، تتعلم رؤوس الكشف التنبؤ بمواقع الكائنات في الصورة وتحديد ماهيتها. وتفعل ذلك من خلال انحدار إحداثيات مربعات الإحاطة، أي إنها تتعلم تقدير موضع كل كائن وحجمه في صورة الإدخال.
أثناء التدريب، يتعلم النموذج من خلال تقليل الخسارة، وهي مقياس عددي لمدى اختلاف تنبؤاته عن الإجابات الصحيحة أو الحقيقة المرجعية. تعني الخسارة الأقل أن تنبؤات النموذج أقرب إلى الحقيقة المرجعية، بينما تشير الخسارة الأعلى إلى أخطاء أكبر. ويوجّه حساب الخسارة كيفية تحديث النموذج لمعاملاته أثناء التدريب.
يستخدم Ultralytics YOLO26 رأسي كشف أثناء التدريب، يشتركان في النموذج الأساسي نفسه لكن لكل منهما غرض مختلف. الرأس واحد إلى واحد هو الرأس المستخدم وقت الاستدلال. ويتعلم ربط كل كائن بتنبؤ واحد موثوق، وهو أمر أساسي لتصميم YOLO26 الشامل من البداية إلى النهاية والخالي من NMS.
أما الرأس واحد إلى متعدد، فلا يُستخدم إلا أثناء التدريب. فهو يتيح ربط عدة تنبؤات بالكائن نفسه، ما يوفر إشرافًا أكثر كثافة. وتساعد إشارة التعلّم الأغنى هذه على تثبيت التدريب وتحسين الدقة، ولا سيما في المراحل المبكرة.
في Ultralytics YOLO26، يستخدم كلا الرأسين حساب الخسارة نفسه لانحدار المربعات والتصنيف. وكانت التطبيقات السابقة تطبّق توازنًا ثابتًا بين إشارتي الخسارة هاتين طوال التدريب.
لكن أهمية كل رأس تتغير بمرور الوقت عمليًا. يكون الإشراف الكثيف أنفع في البداية، بينما تزداد أهمية المواءمة مع سلوك الاستدلال في المراحل اللاحقة من التدريب. صُمّم Ultralytics YOLO26 بالاستناد إلى هذه الرؤية، ما يقود مباشرة إلى كيفية إعادة موازنة إشارات التعلّم مع تقدم التدريب.
يستخدم Ultralytics YOLO26 موازنة الخسارة التدريجية#
فكيف يتعامل Ultralytics YOLO26 مع احتياجات التعلّم المتغيرة هذه أثناء التدريب؟ يستخدم موازنة الخسارة التدريجية لضبط أوزان إشارات التعلّم بمرور الوقت.
تعمل ProgLoss على تغيير مقدار مساهمة كل رأس في الخسارة الإجمالية ديناميكيًا مع تقدم التدريب. في البداية، يُمنح الرأس واحد إلى متعدد وزنًا أكبر لتثبيت التعلّم وتحسين الاستدعاء. ومع استمرار التدريب، يتحول التوازن تدريجيًا نحو الرأس واحد إلى واحد، لمواءمة التدريب بصورة أوثق مع سلوك الاستدلال.
يتيح هذا الانتقال التدريجي لـ Ultralytics YOLO26 التعلّم بالترتيب المناسب. فبدلًا من إجبار النموذج على تحسين أهداف متنافسة كلها في آن واحد، تعطي موازنة الخسارة التدريجية الأولوية لإشارة التعلّم الأكثر فائدة في كل مرحلة من التدريب. والنتيجة تقارب أكثر سلاسة، وجولات تدريب أقل عرضة لعدم الاستقرار، وأداء نهائي أكثر اتساقًا.
كيف تساعد STAL Ultralytics YOLO26 على التعلّم من الكائنات الصغيرة جدًا#
يأتي تحسين تدريبي آخر لافت في Ultralytics YOLO26 من طريقة إسناد النموذج لأهداف التدريب إلى التنبؤات، وهي عملية تُعرف بإسناد التسميات. وتتولى هذه العملية مطابقة كائنات الحقيقة المرجعية بالتنبؤات المرشحة، التي تُسمى غالبًا المراسي.
تحدد هذه المطابقات التنبؤات التي تتلقى الإشراف وتسهم في الخسارة. ويستند Ultralytics YOLO26 إلى أسلوب قائم لإسناد التسميات يُسمى تعلّم مواءمة المهام (TAL)، وقد صُمم لتحسين مواءمة التصنيف وتحديد الموقع أثناء التدريب.
مع أن TAL يحقق نتائج جيدة مع معظم الكائنات، كشف التدريب عن قيد مهم. إذ أمكن إسقاط الكائنات الصغيرة جدًا بالكامل أثناء المطابقة. عمليًا، غالبًا ما لم تحصل الكائنات التي يقل حجمها عن نحو 8 بكسلات في صورة إدخال بحجم 640 بكسل على أي إسنادات للمراسي. وعند حدوث ذلك، لا يتلقى النموذج إشرافًا يُذكر على هذه الكائنات أو لا يتلقى أي إشراف، ما يصعّب عليه تعلّم اكتشافها على نحو موثوق.
لمعالجة هذه المشكلة، يقدّم Ultralytics YOLO26 إسناد التسميات المدرك للأهداف الصغيرة (STAL). ويعدّل STAL عملية الإسناد لضمان عدم تجاهل الكائنات الصغيرة أثناء التدريب. وعلى وجه التحديد، يفرض حدًا أدنى قدره أربعة إسنادات للمراسي للكائنات التي يقل حجمها عن 8 بكسلات. وهذا يضمن أن تسهم حتى الكائنات الصغيرة جدًا باستمرار في خسارة التدريب.
من خلال تعزيز الإشراف على الأهداف الصغيرة، يحسّن STAL استقرار التعلّم وأداء الكشف في الحالات التي تكثر فيها الكائنات الصغيرة أو البعيدة. ويكتسب هذا التحسين أهمية خاصة في تطبيقات YOLO26 المصمم للأطراف أولًا، مثل الصور الجوية والروبوتات وأنظمة إنترنت الأشياء (IoT)، حيث تكون الكائنات غالبًا صغيرة أو بعيدة أو ظاهرة جزئيًا، ويكون الكشف الموثوق أمرًا بالغ الأهمية.
يقدّم Ultralytics YOLO26 المحسّن MuSGD#
لدعم تدريب أكثر استقرارًا وقابلية للتنبؤ، يقدّم Ultralytics YOLO26 أيضًا محسّنًا جديدًا يُسمى MuSGD. صُمّم هذا المحسّن لتحسين التقارب وموثوقية التدريب في نماذج الكشف الشاملة من البداية إلى النهاية، ولا سيما مع زيادة حجم النموذج وتعقيد التدريب.
لكي تتعلم الشبكة العصبية، ومن ثم تغيّر الأوزان وفقًا لذلك أثناء التدريب، نحسب خطأً (يُسمى أيضًا «الخسارة»). لذلك، يقيس النموذج مدى خطأ تنبؤاته باستخدام قيمة الخسارة، ويحسب التدرجات التي تشير إلى كيفية تغيير معاملاته، ثم يحدّث تلك المعاملات لتقليل الخطأ. ويُعد الانحدار المتدرج العشوائي (SGD) محسّنًا واسع الاستخدام ينفذ هذه التحديثات، ما يجعل التدريب فعالًا وقابلًا للتوسع.
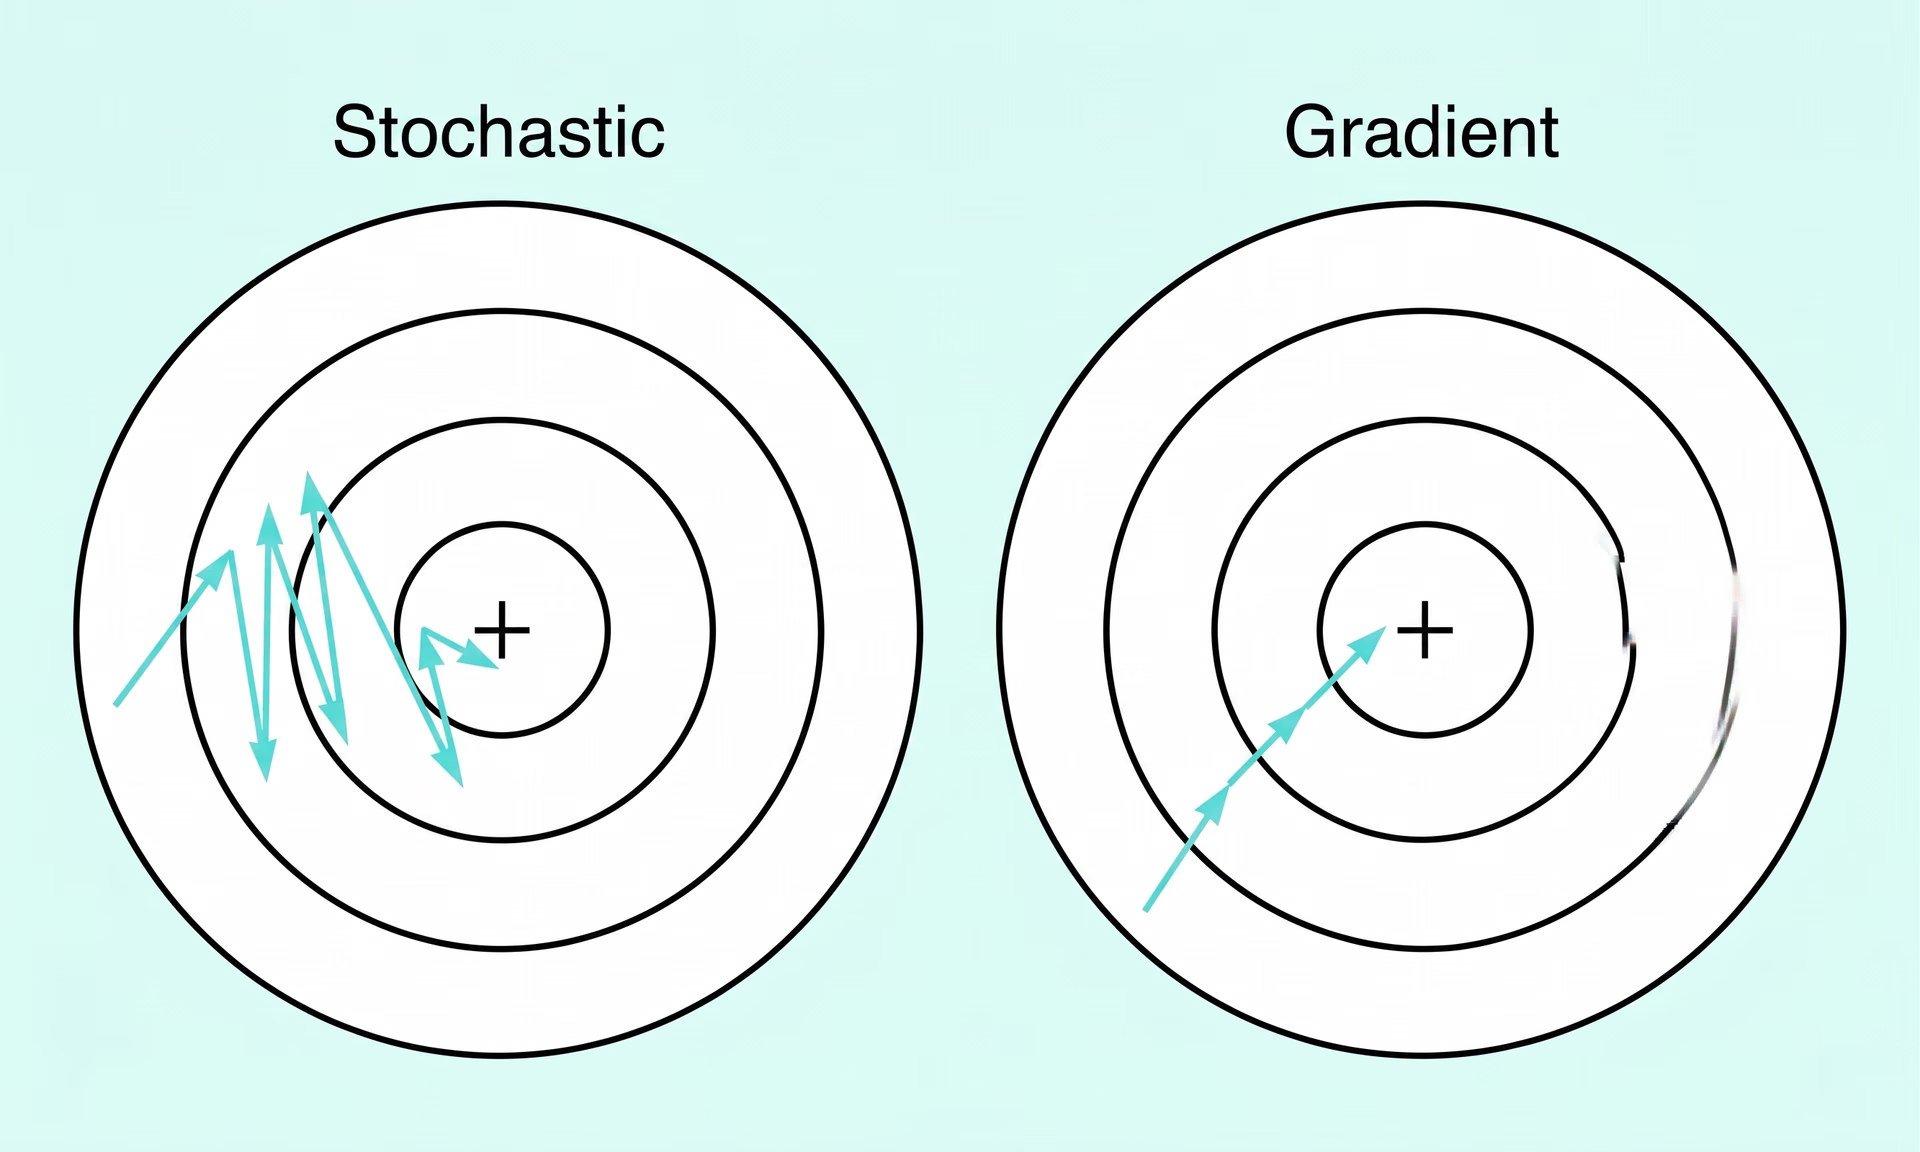
الشكل 3. الانحدار المتدرج العشوائي مقارنةً بالانحدار المتدرج (المصدر)
يستند MuSGD إلى هذا الأساس المألوف، ويضم أفكارًا للتحسين مستوحاة من Muon، وهي طريقة تُستخدم في تدريب النماذج اللغوية الكبيرة. وقد تأثرت هذه الأفكار بتطورات حديثة مثل Kimi K2 من Moonshot AI، التي أظهرت تحسنًا في سلوك التدريب بفضل تحديثات المعاملات الأكثر تنظيمًا.
يستخدم Ultralytics YOLO26 استراتيجية تحديث هجينة. إذ تُحدّث بعض المعاملات بمزيج من التحديثات المستوحاة من Muon وSGD، بينما تستخدم معاملات أخرى SGD وحده. ويتيح ذلك لـ YOLO26 إدخال بنية إضافية في عملية التحسين مع الحفاظ على خصائص المتانة والتعميم التي جعلت SGD فعالًا.
والنتيجة تحسين أكثر سلاسة، وتقارب أسرع، وسلوك تدريبي أكثر قابلية للتنبؤ عبر أحجام النماذج، ما يجعل MuSGD عنصرًا أساسيًا في سهولة تدريب Ultralytics YOLO26 وموثوقيته عند التوسع.
أهمية ابتكارات التدريب في Ultralytics YOLO26#
تجعل ابتكارات التدريب في Ultralytics YOLO26، إلى جانب ميزات رئيسية مثل تصميمه الشامل من البداية إلى النهاية والخالي من NMS والمصمم للأطراف أولًا، النموذج أسهل تدريبًا وأكثر موثوقية عند التوسع. وقد تتساءل عما يعنيه ذلك فعلًا لتطبيقات الرؤية الحاسوبية.
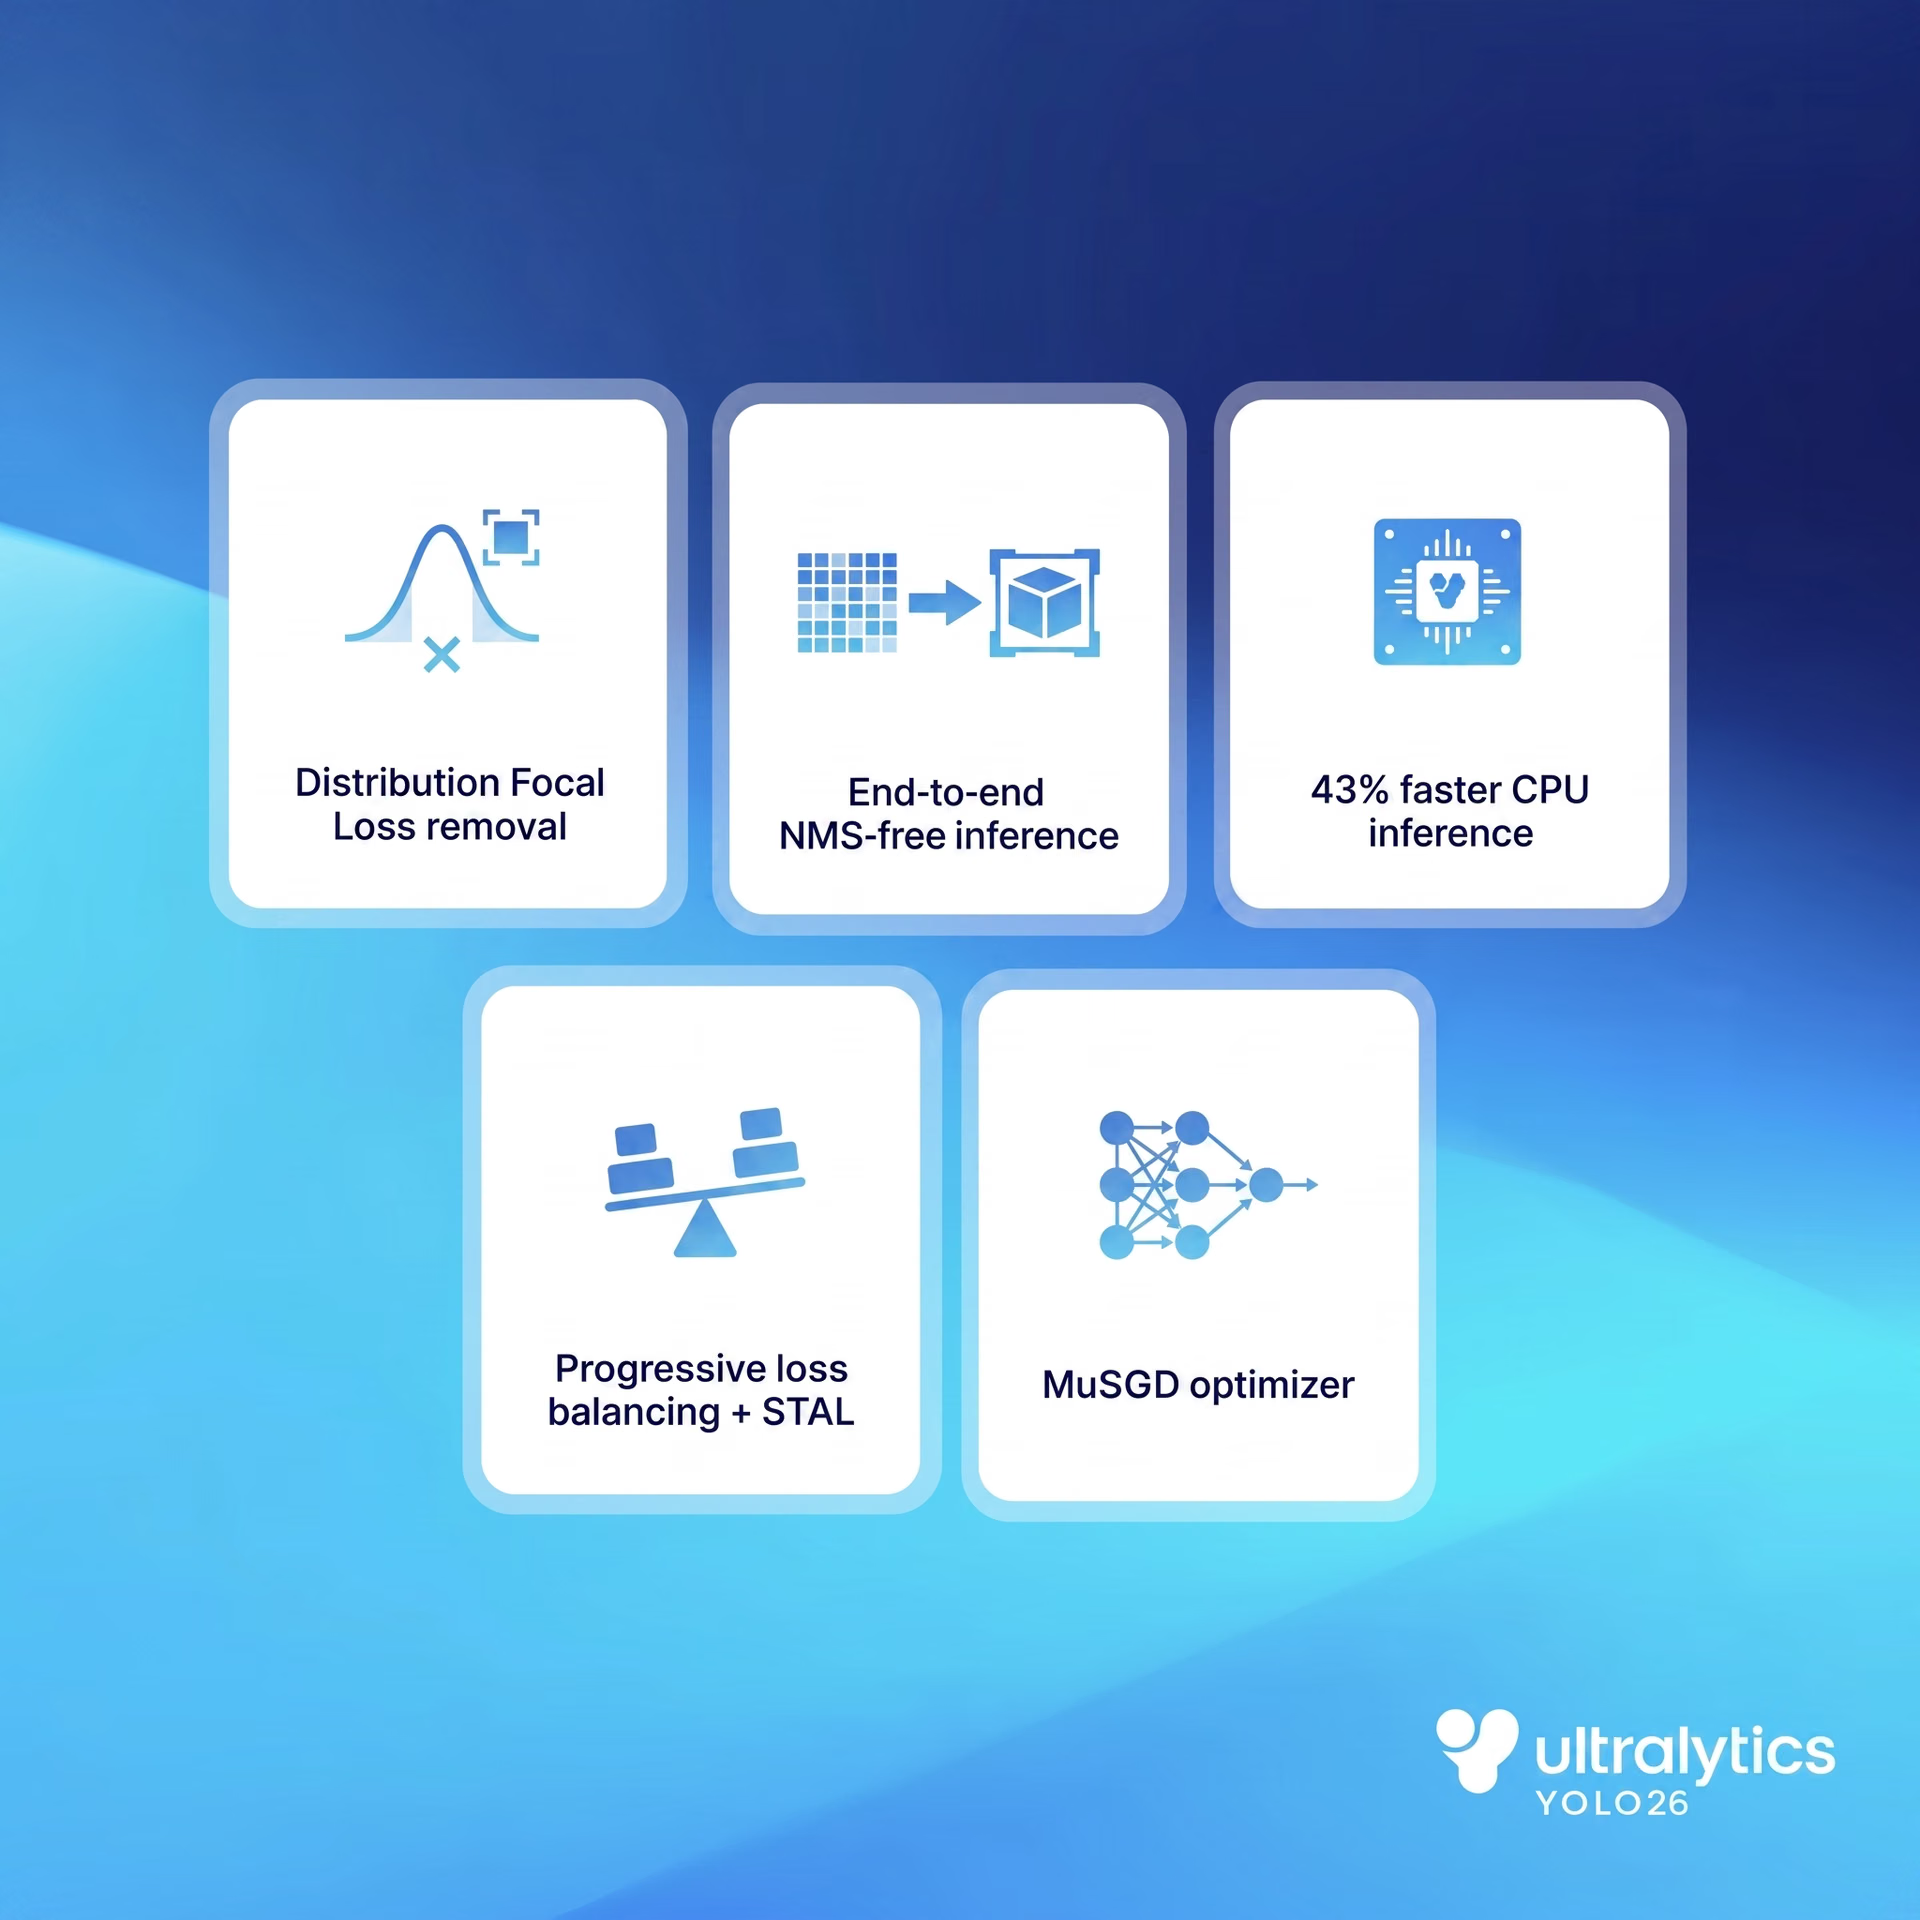
الشكل 4. نظرة على الميزات الرئيسية في YOLO26 (المصدر)
عمليًا، يجعل ذلك نقل الرؤية الحاسوبية إلى البيئات التي تعمل فيها فعليًا أسهل بكثير. إذ تُدرَّب النماذج بمزيد من قابلية التنبؤ، وتتوسع بصورة أكثر اتساقًا عبر الأحجام، ويسهل تكييفها مع مجموعات بيانات جديدة. وهذا يقلل العقبات بين التجريب والنشر، ولا سيما في البيئات التي لا تقل فيها أهمية الموثوقية والكفاءة عن الأداء الخام.
فعلى سبيل المثال، في تطبيقات الروبوتات والرؤية الصناعية، غالبًا ما يلزم إعادة تدريب النماذج بوتيرة متكررة مع تغير البيئات أو المستشعرات أو المهام. ومع Ultralytics YOLO26، تستطيع الفرق تكرار التجارب بسرعة أكبر دون القلق من جولات تدريب غير مستقرة أو سلوك غير متسق بين أحجام النماذج.
أبرز النقاط#
تعتمد أنظمة الرؤية الحاسوبية الموثوقة على كيفية تدريب النماذج بقدر اعتمادها على أدائها وقت الاستدلال. ومن خلال تحسين موازنة إشارات التعلّم، ومعالجة الكائنات الصغيرة، وتقدم عملية التحسين، يجعل Ultralytics YOLO26 التدريب أكثر استقرارًا وأسهل توسعًا. ويساعد هذا التركيز على التدريب الموثوق الفرق على الانتقال بسلاسة أكبر من التجريب إلى النشر في العالم الواقعي، ولا سيما في التطبيقات المصممة للأطراف أولًا.
هل ترغب في التعرّف إلى الذكاء الاصطناعي؟ تفضّل بزيارة مستودع GitHub لاكتشاف المزيد. انضم إلى مجتمعنا النشط وتعرّف على الابتكارات في قطاعات مثل الذكاء الاصطناعي في الخدمات اللوجستية والذكاء الاصطناعي للرؤية في قطاع السيارات. وللبدء اليوم باستخدام الرؤية الحاسوبية، اطّلع على خيارات الترخيص.









