ما هو Mask R-CNN وكيف يعمل؟
تعرّف على كيفية عمل Mask R-CNN، بدءًا من العمود الفقري وشبكة اقتراح المناطق إلى محاذاة ROI والتنبؤ بالقناع، فضلًا عن استخداماته وحدوده وخلفائه من YOLO.
 Abirami Vina8 دقيقة قراءة
أصبحت الابتكارات، مثل الروبوتات في المستودعات والسيارات ذاتية القيادة التي تسير بأمان في الشوارع المزدحمة والطائرات المسيّرة التي تفحص المحاصيل وأنظمة الذكاء الاصطناعي التي تفحص المنتجات في المصانع، أكثر شيوعًا مع تزايد اعتماد الذكاء الاصطناعي. ومن التقنيات الأساسية التي تقود هذه الابتكارات الرؤية الحاسوبية، وهي فرع من الذكاء الاصطناعي يمكّن الآلات من فهم البيانات المرئية وتفسيرها.
فعلى سبيل المثال، اكتشاف الكائنات مهمة في الرؤية الحاسوبية تساعد على تحديد الكائنات وتحديد مواقعها في الصور باستخدام مربعات الإحاطة. وعلى الرغم من أن مربعات الإحاطة توفر معلومات مفيدة، فإنها لا تقدم سوى تقدير تقريبي لموضع الكائن، ولا تستطيع التقاط شكله أو حدوده بدقة. وهذا يجعلها أقل فاعلية في التطبيقات التي تتطلب تحديدًا دقيقًا.
ولحل هذه المشكلة، طور الباحثون نماذج التقسيم التي تلتقط الخطوط الخارجية الدقيقة للكائنات، وتوفر تفاصيل على مستوى البكسل لتحسين دقة الاكتشاف والتحليل.
يُعد Mask R-CNN أحد هذه النماذج. وقد قدمه Facebook AI Research (FAIR) عام 2017، وهو امتداد لنماذج أقدم مثل R-CNN وFast R-CNN وFaster R-CNN. وبوصفه محطة مهمة في تاريخ الرؤية الحاسوبية، مهد Mask R-CNN الطريق لنماذج أكثر تقدمًا، مثل Ultralytics YOLO11.
في هذه المقالة، سنستكشف ماهية Mask R-CNN، وآلية عمله وتطبيقاته، والتحسينات التي ظهرت بعده وأدت إلى Ultralytics YOLO11.
نظرة عامة على Mask R-CNN#
Mask R-CNN، وهو اختصار للشبكة العصبية الالتفافية القائمة على مناطق الأقنعة، نموذج للتعلم العميق مصمم لمهام الرؤية الحاسوبية مثل اكتشاف الكائنات وتقسيم المثيلات.
يتجاوز تقسيم المثيلات اكتشاف الكائنات التقليدي، إذ لا يكتفي بتحديد الكائنات في الصورة، بل يحدد محيط كل منها بدقة أيضًا. ويعين تسمية فريدة لكل كائن مكتشف، ويلتقط شكله الدقيق على مستوى البكسل. ويتيح هذا النهج المفصل التمييز بوضوح بين الكائنات المتداخلة والتعامل بدقة مع الأشكال المعقدة.
يستند Mask R-CNN إلى Faster R-CNN، الذي يكتشف الكائنات ويصنفها، لكنه لا يحدد أشكالها الدقيقة. ويحسن Mask R-CNN ذلك بتحديد البكسلات الدقيقة التي يتكون منها كل كائن، ما يتيح تحليل الصور بتفصيل ودقة أكبر بكثير.
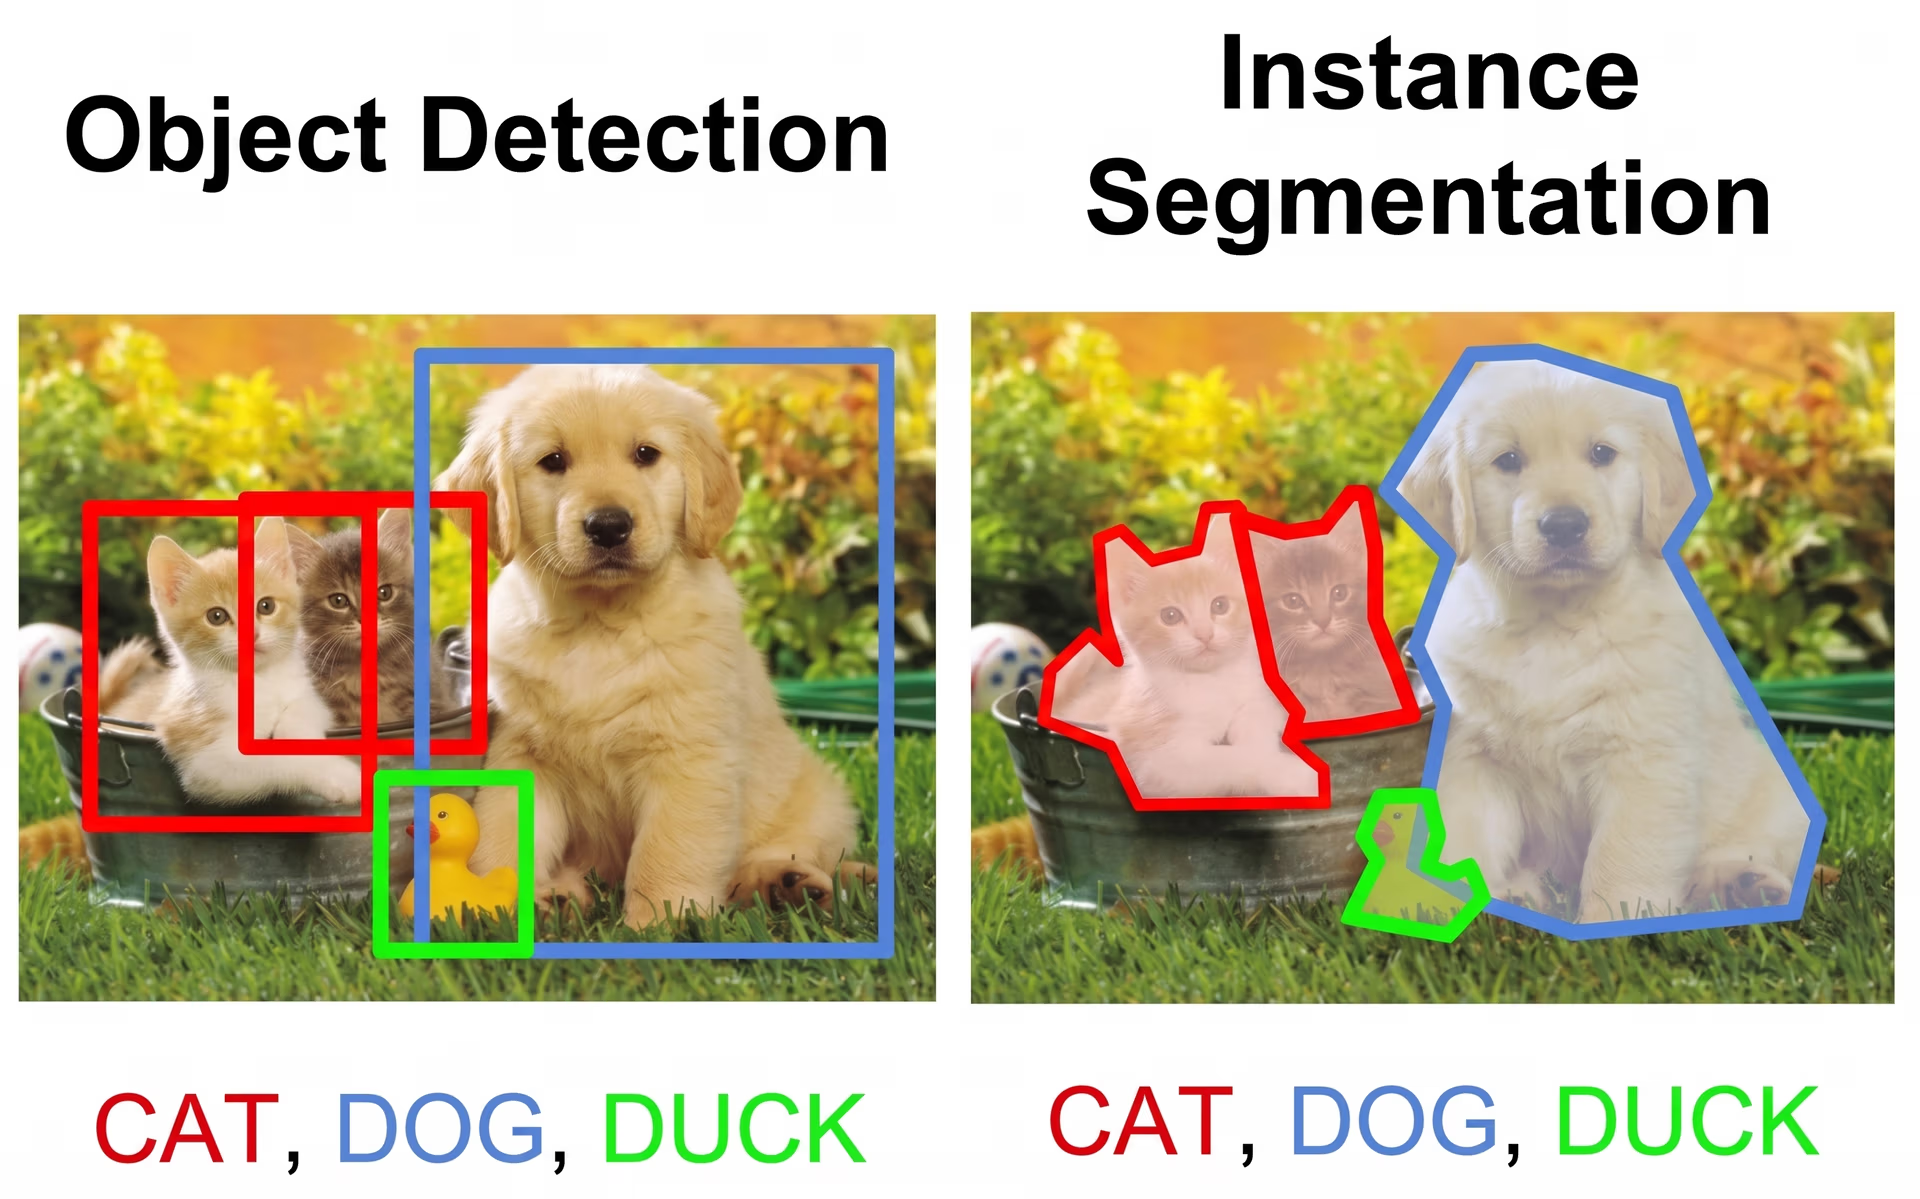
الشكل 1. مقارنة بين اكتشاف الكائنات وتقسيم المثيلات.
نظرة على بنية Mask R-CNN وآلية عمله#
يتبع Mask R-CNN نهجًا تدريجيًا لاكتشاف الكائنات وتقسيمها بدقة. يبدأ باستخراج السمات الأساسية باستخدام شبكة عصبية عميقة (نموذج متعدد الطبقات يتعلم من البيانات)، ثم يحدد المناطق المحتملة للكائنات باستخدام شبكة اقتراح المناطق (مكوّن يقترح المناطق المرجح احتواؤها على كائنات)، وأخيرًا يحسن هذه المناطق بإنشاء أقنعة تقسيم مفصلة (حدود دقيقة للكائنات) تلتقط الشكل الدقيق لكل كائن.
بعد ذلك، نستعرض كل خطوة لفهم آلية عمل Mask R-CNN على نحو أفضل.
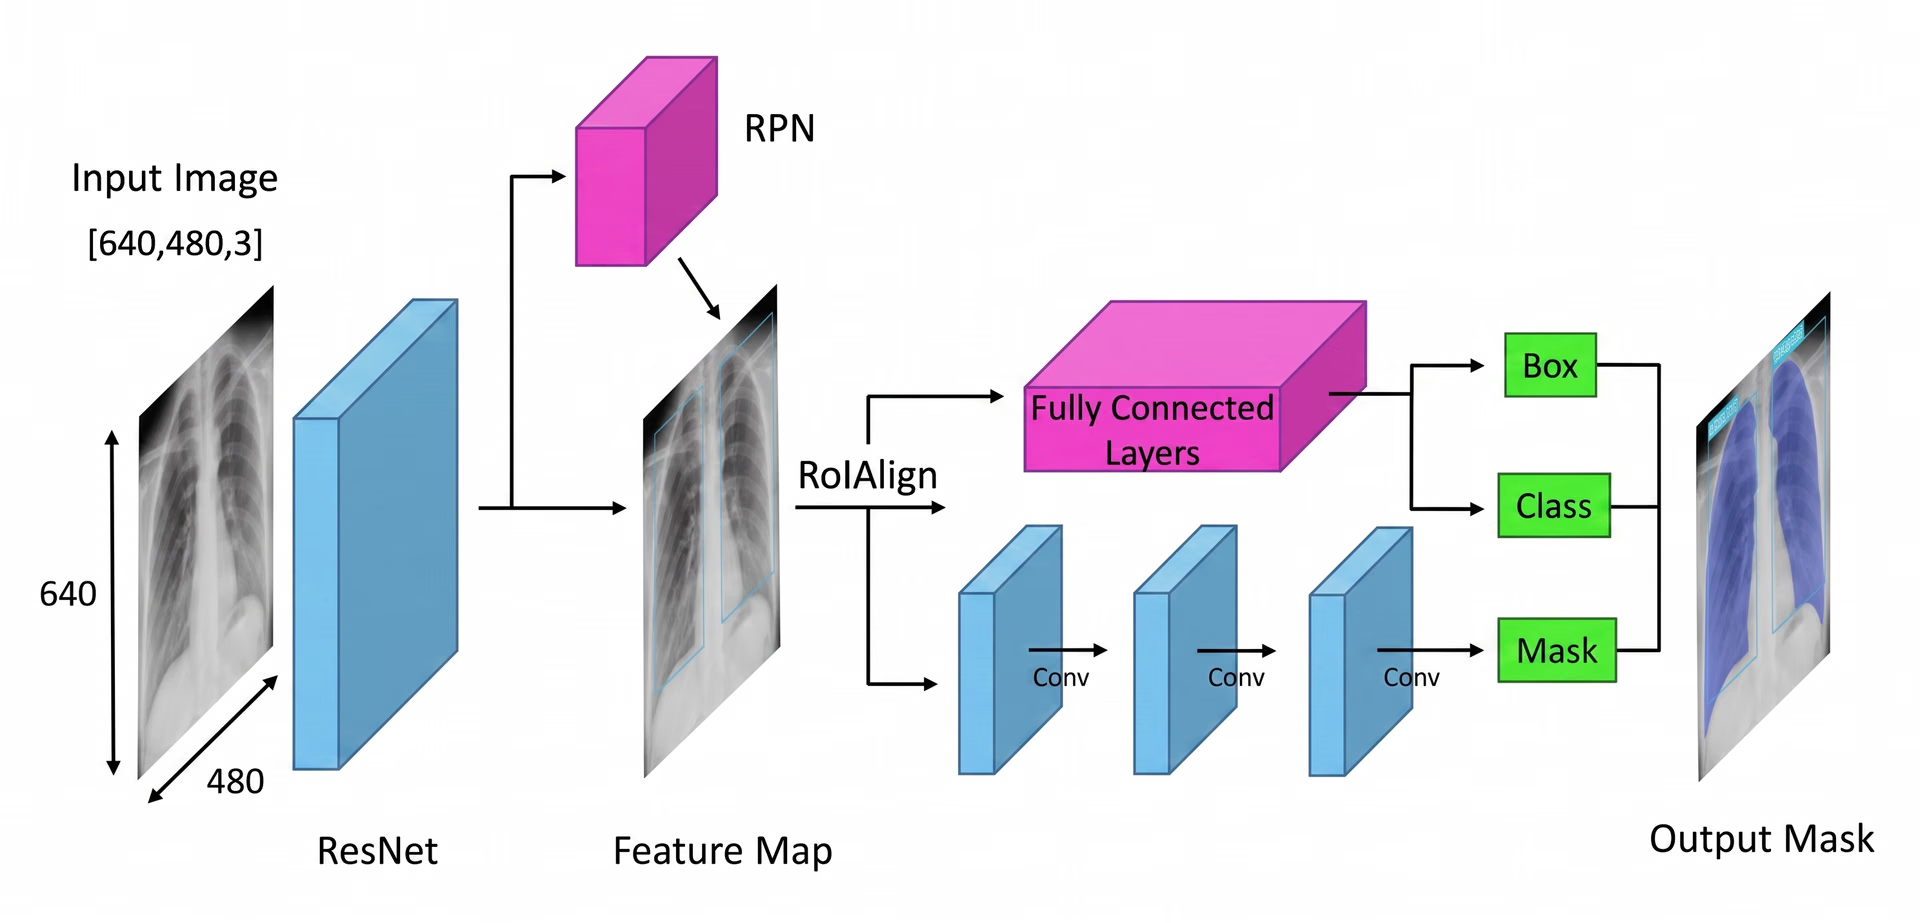
الشكل 2. نظرة عامة على بنية Mask R-CNN (المصدر: researchgate.net).
البدء باستخراج السمات#
تتمثل الخطوة الأولى في معمارية Mask R-CNN في تقسيم الصورة إلى أجزائها الأساسية حتى يتمكن النموذج من فهم محتواها. تخيل الأمر كما لو أنك تنظر إلى صورة وتلاحظ تلقائيًا تفاصيل مثل الأشكال والألوان والحواف. يفعل النموذج شيئًا مشابهًا باستخدام شبكة عصبية عميقة تُسمى «العمود الفقري» (وغالبًا ما تكون ResNet-50 أو ResNet-101)، تعمل بمثابة عينيه لمسح الصورة والتقاط التفاصيل المهمة.
نظرًا إلى أن الأجسام في الصور قد تكون صغيرة جدًا أو كبيرة جدًا، يستخدم Mask R-CNN شبكة هرمية للميزات. يشبه ذلك امتلاك عدسات تكبير مختلفة تتيح للنموذج رؤية التفاصيل الدقيقة والصورة الأشمل، ما يضمن ملاحظة الأجسام بمختلف أحجامها.
بعد استخراج هذه السمات المهمة، ينتقل النموذج إلى تحديد الكائنات المحتملة في الصورة، تمهيدًا لمزيد من التحليل.
اقتراح المناطق المحتمل احتواؤها على كائنات في الصورة#
بعد معالجة الصورة لاستخراج السمات الأساسية، تتولى شبكة اقتراح المناطق المهمة. يفحص هذا الجزء من النموذج الصورة ويقترح المناطق المرجح احتواؤها على كائنات.
ويفعل ذلك من خلال إنشاء عدة مواقع محتملة للكائنات تُسمى المراسي. ثم تقيّم الشبكة هذه المراسي وتختار أكثرها ترجيحًا لمزيد من التحليل. وبهذه الطريقة، يركز النموذج على المناطق الأرجح أهمية بدلًا من فحص كل موضع في الصورة.
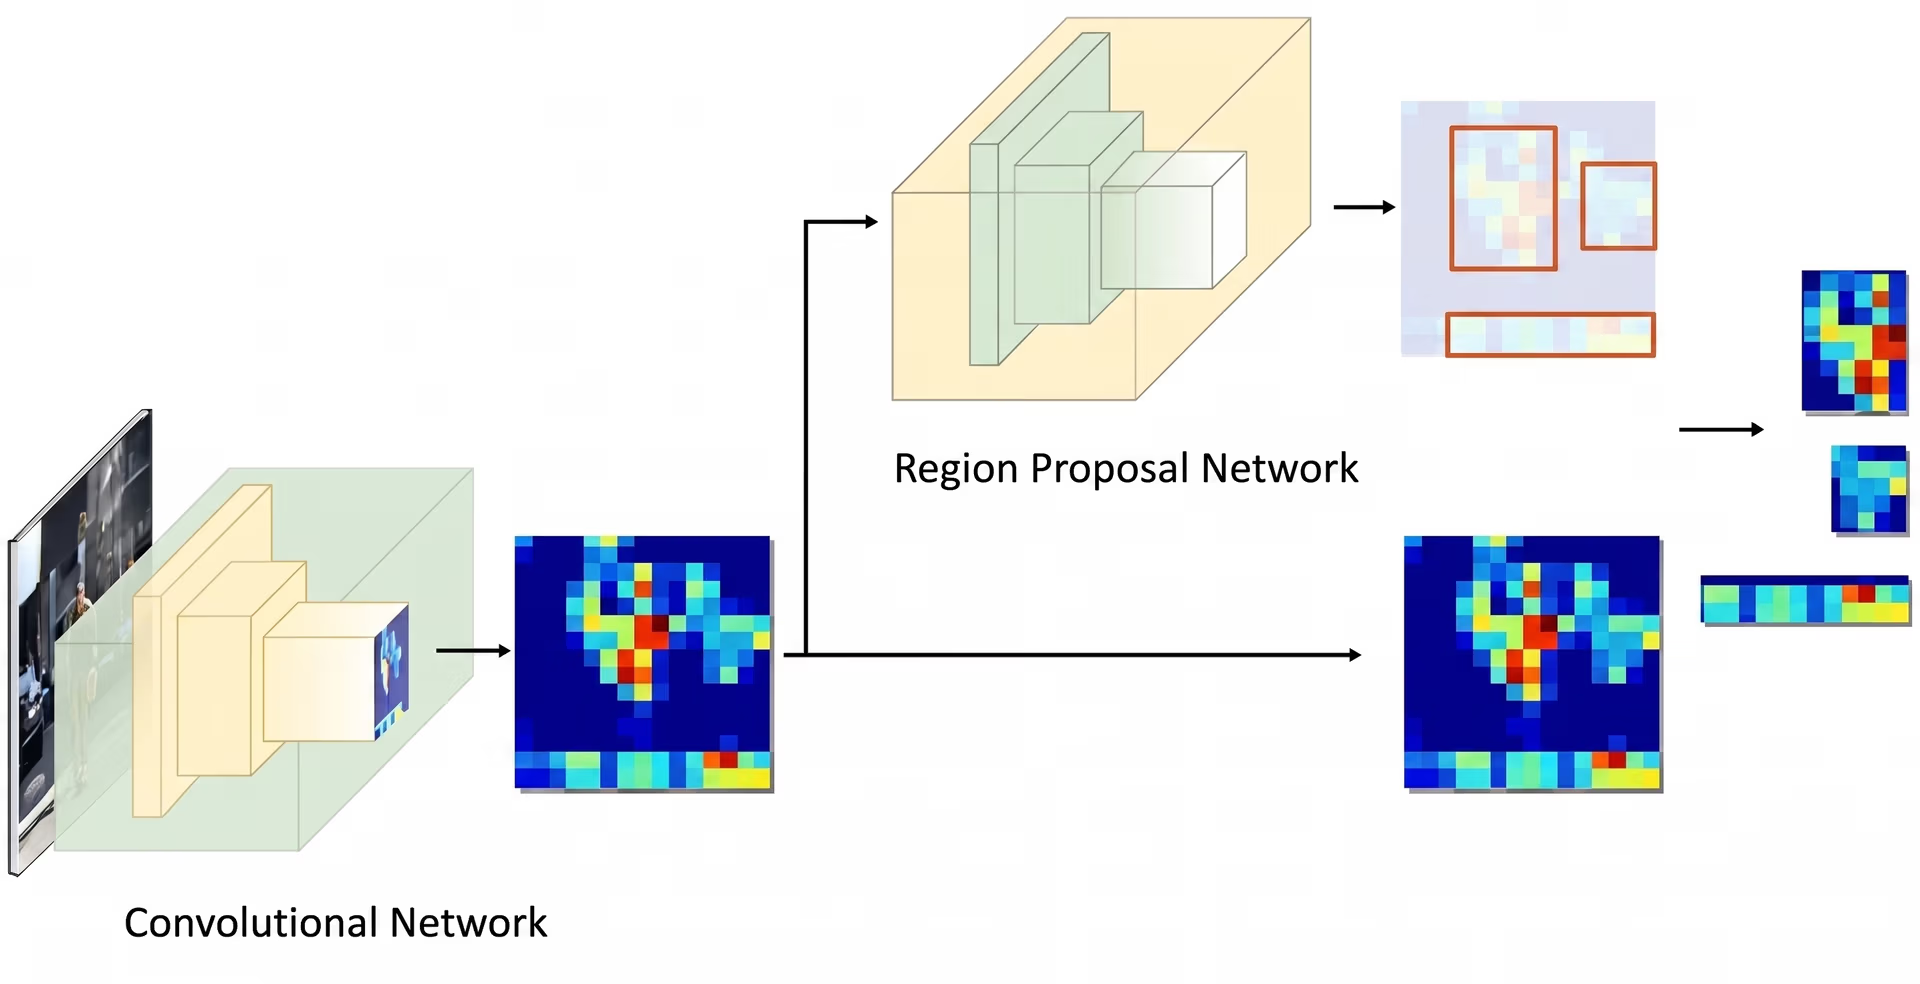
الشكل 3. مثال على شبكة اقتراح المناطق.
تحسين السمات المستخرجة#
بعد تحديد المناطق الأساسية، تتمثل الخطوة التالية في تحسين التفاصيل المستخرجة من هذه المناطق. استخدمت النماذج السابقة طريقة تُسمى تجميع منطقة الاهتمام (ROI Pooling) لاستخراج السمات من كل منطقة، لكن هذه التقنية كانت تؤدي أحيانًا إلى انحرافات طفيفة عند تغيير حجم المناطق، ما يقلل فاعليتها، خصوصًا مع الكائنات الأصغر أو المتداخلة.
يحسّن Mask R-CNN هذه العملية باستخدام تقنية تُسمى محاذاة منطقة الاهتمام (ROI Align). فبدلًا من تقريب الإحداثيات كما تفعل عملية تجميع منطقة الاهتمام (ROI Pooling)، تستخدم ROI Align الاستيفاء ثنائي الخطية لتقدير قيم البكسلات بدقة أكبر. والاستيفاء ثنائي الخطية طريقة تحسب قيمة بكسل جديدة باستخدام متوسط مرجّح لقيم أقرب أربعة بكسلات مجاورة، ما ينتج انتقالات أكثر سلاسة. ويحافظ ذلك على محاذاة السمات بشكل صحيح مع الصورة الأصلية، ما يؤدي إلى اكتشاف الأجسام وتقسيمها بدقة أكبر.
فعلى سبيل المثال، في مباراة كرة قدم، قد يختلط لاعبان يقفان متقاربين أحدهما بالآخر بسبب تداخل مربعي الإحاطة. وتساعد محاذاة منطقة الاهتمام (ROI Align) على فصلهما بالحفاظ على وضوح شكل كل منهما.
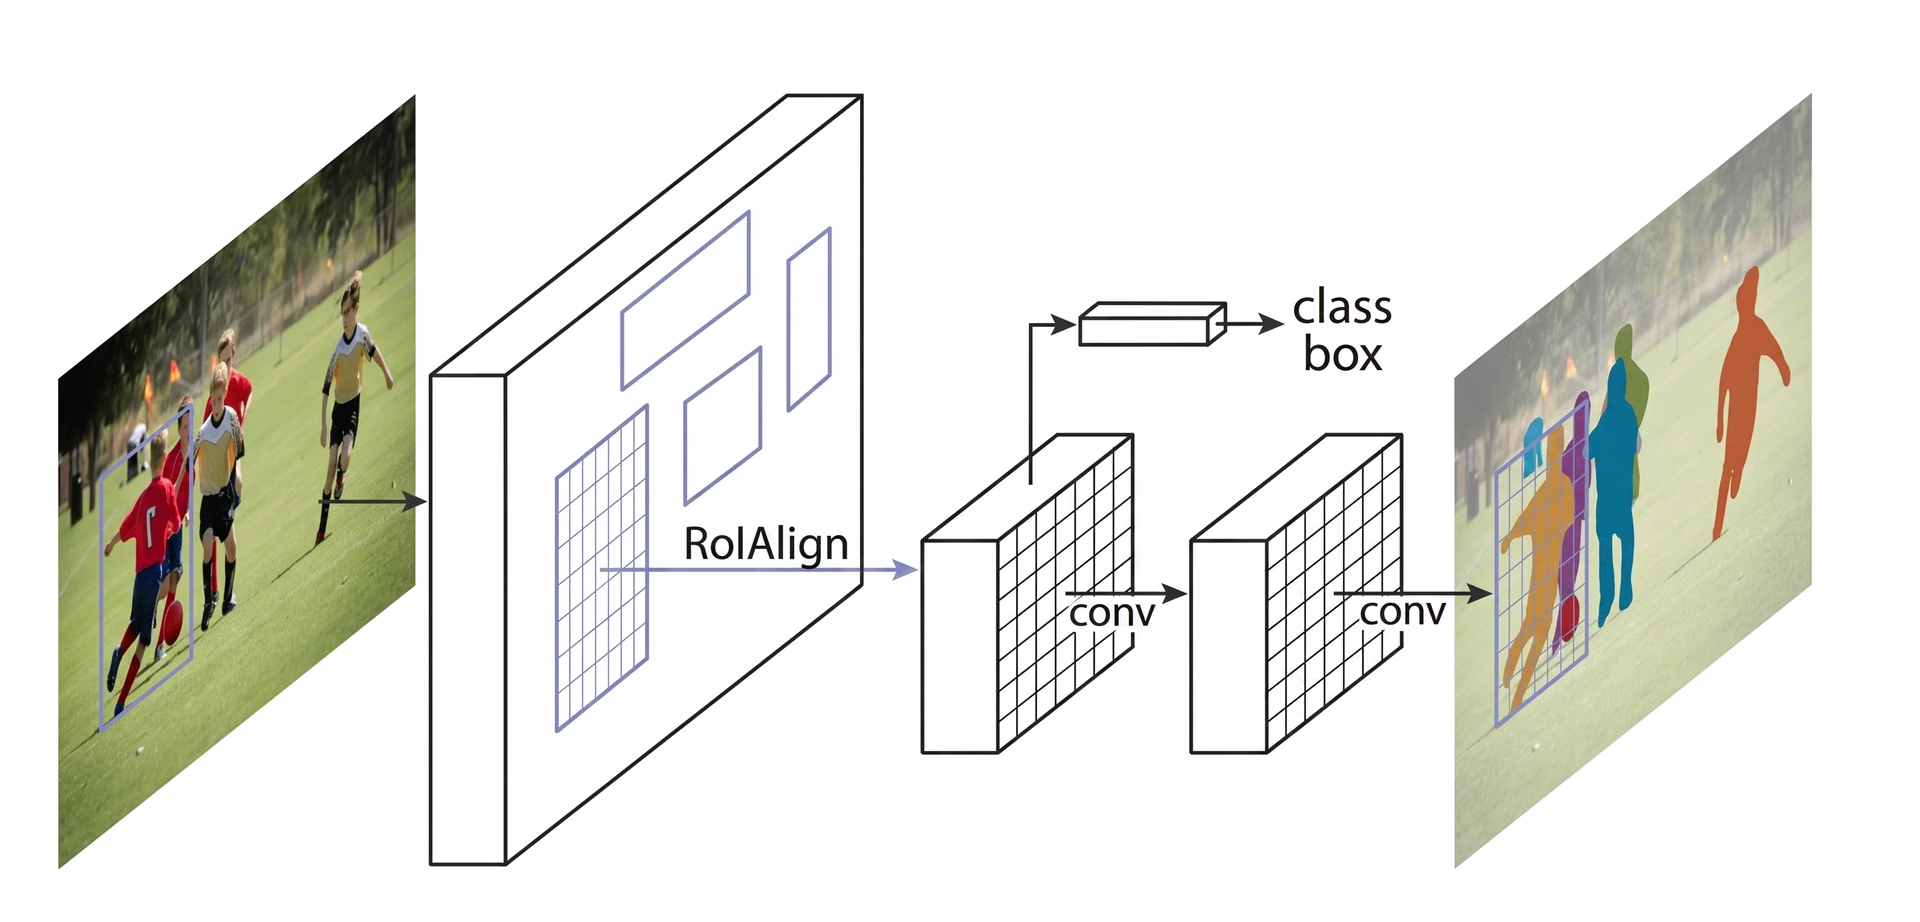
الشكل 4. يستخدم Mask R-CNN محاذاة ROI.
تصنيف الكائنات والتنبؤ بأقنعتها#
بعد أن تعالج محاذاة ROI الصورة، تتمثل الخطوة التالية في تصنيف الكائنات وضبط مواقعها بدقة. يفحص النموذج كل منطقة مستخرجة ويحدد الكائن الذي تحتوي عليه. ويُسنِد درجات احتمالية إلى فئات مختلفة، ثم يختار أفضل تطابق.
وفي الوقت نفسه، يضبط مربعات الإحاطة لتلائم الكائنات على نحو أفضل. قد لا تكون المربعات الأولية في مواضع مثالية، لذا يساعد هذا الضبط على تحسين الدقة من خلال إحاطة كل مربع بالكائن المكتشف بإحكام.
وأخيرًا، تنفذ Mask R-CNN خطوة إضافية: إذ تُنشئ قناع تجزئة مفصلًا لكل كائن بالتوازي.
Mask R-CNN وتطبيقاته في العالم الحقيقي#
عند إطلاق هذا النموذج، استقبله مجتمع الذكاء الاصطناعي بحماسة كبيرة، وسرعان ما استُخدم في تطبيقات متنوعة. وقد جعلته قدرته على اكتشاف الأجسام وتقسيمها بدقة على مستوى البكسل شائعًا في مختلف القطاعات.
على سبيل المثال، تُعد مراقبة الحيوانات المهددة بالانقراض في البرية مهمة صعبة. إذ تتنقل أنواع كثيرة عبر غابات كثيفة، ما يصعّب على المعنيين بالحفاظ على البيئة تتبعها. وتستخدم الأساليب التقليدية مصائد الكاميرات والطائرات المسيّرة وصور الأقمار الصناعية، لكن فرز كل هذه البيانات يدويًا يستغرق وقتًا طويلًا. وقد تؤدي أخطاء تحديد الهوية وعدم رصد الحيوانات إلى إبطاء جهود الحفاظ عليها.
من خلال التعرّف على السمات الفريدة، مثل خطوط النمور وبقع الزرافات وشكل آذان الفيلة، تستطيع Mask R-CNN اكتشاف الحيوانات وتجزيئها في الصور ومقاطع الفيديو بدقة أكبر. وحتى عندما تحجب الأشجار الحيوانات جزئيًا أو تكون متقاربة، يستطيع النموذج فصلها والتعرّف على كل منها على حدة، ما يجعل مراقبة الحياة البرية أسرع وأكثر موثوقية.
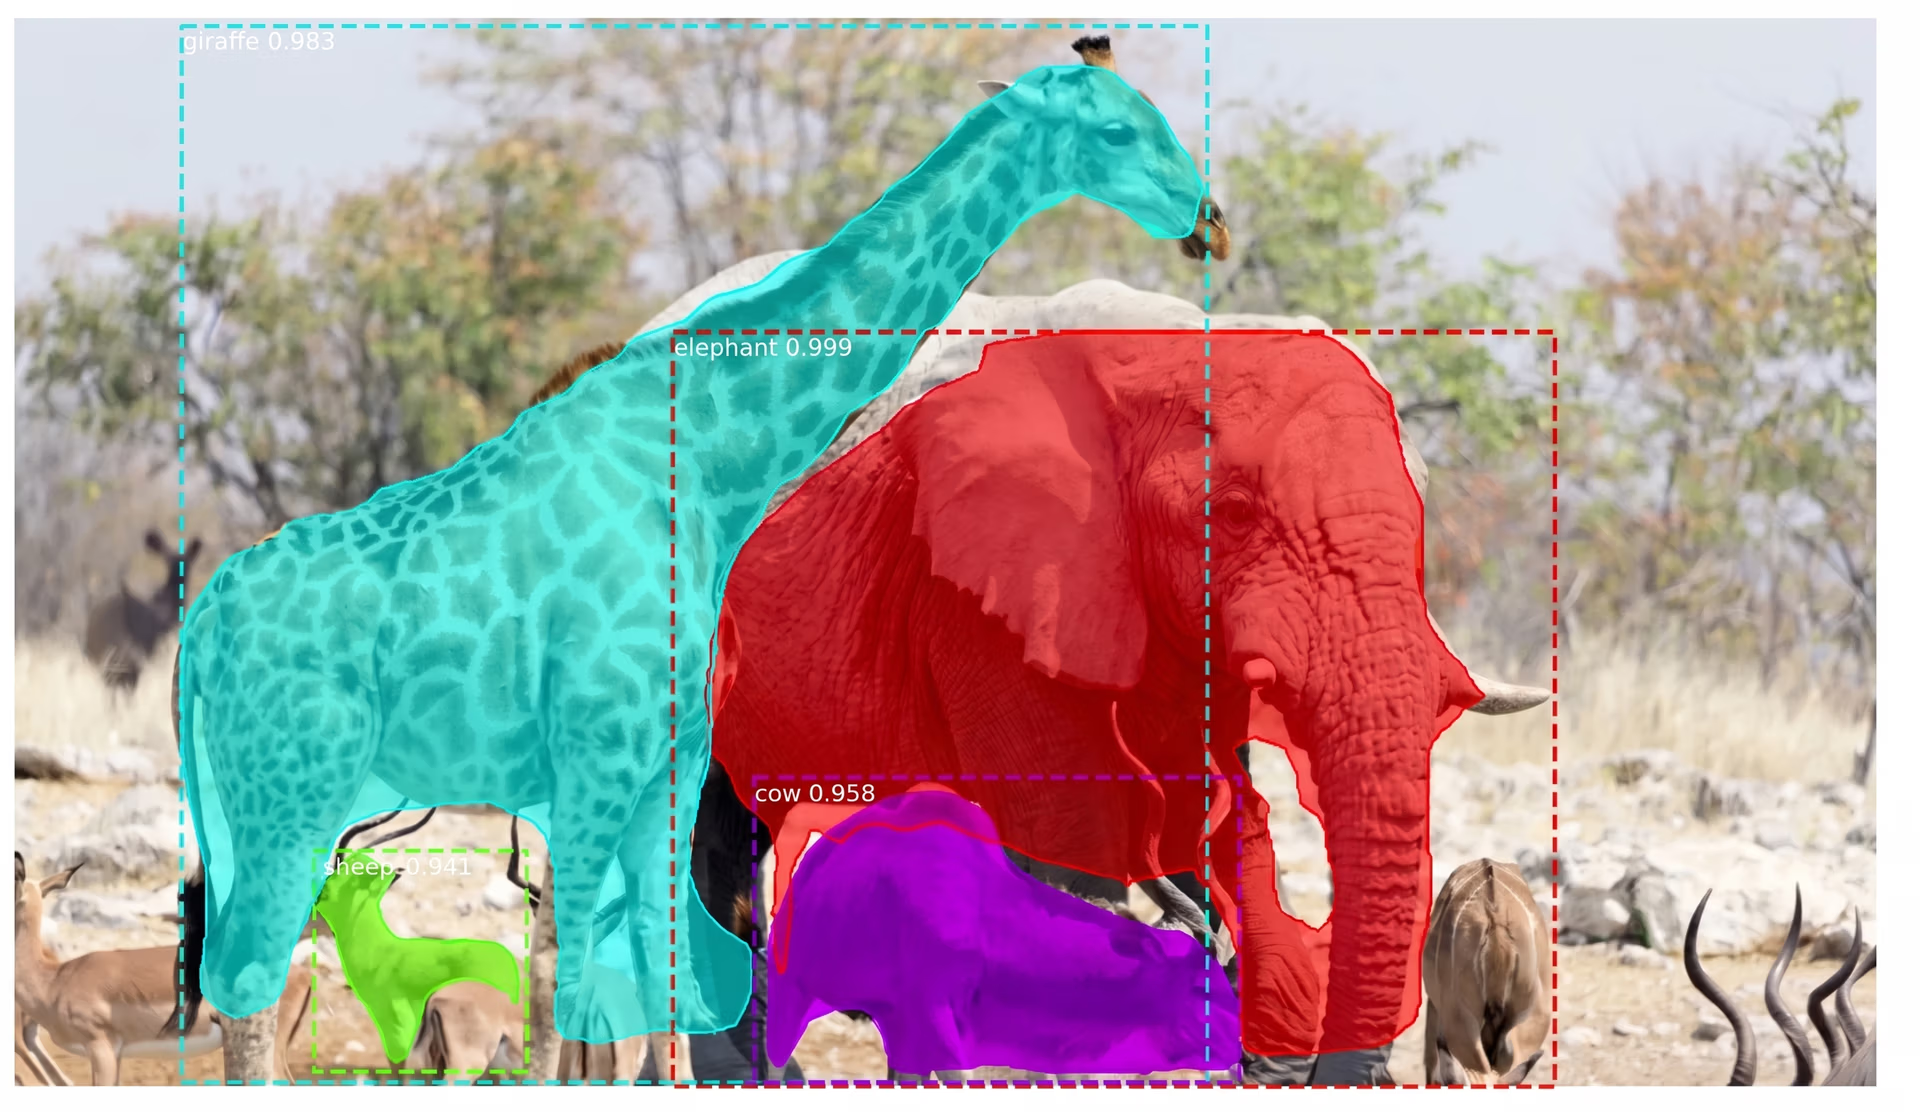
الشكل 5. اكتشاف الحيوانات وتجزيئها باستخدام Mask R-CNN.
قيود Mask R-CNN#
على الرغم من أهميتها التاريخية في اكتشاف الكائنات وتجزيئها، تنطوي Mask R-CNN أيضًا على بعض العيوب الرئيسية. إليك بعض التحديات المرتبطة بـ Mask R-CNN:
- متطلبات حوسبة عالية: يعتمد النموذج على وحدات معالجة رسومات قوية، ما قد يجعل تشغيله مكلفًا وبطيئًا عند معالجة كميات كبيرة من البيانات.
- سرعة معالجة أبطأ: تجعلها مراحل المعالجة المتعددة أبطأ مقارنةً بنماذج الوقت الفعلي الأسرع مثل YOLO، وقد لا تكون مثالية للمهام الحساسة للوقت.
- الاعتماد على بيانات عالية الجودة: يحقق النموذج أفضل أداء مع الصور الواضحة والموسومة جيدًا. وقد تؤدي الصور الضبابية أو ضعيفة الإضاءة إلى انخفاض دقته بشكل ملحوظ.
- تنفيذ معقد: قد يصعب إعداد البنية متعددة المراحل وتحسينها، لا سيما عند التعامل مع مجموعات بيانات كبيرة أو موارد محدودة.
من Mask R-CNN إلى Ultralytics YOLO11#
كان Mask R-CNN خيارًا ممتازًا لمهام التجزئة، لكن كثيرًا من القطاعات سعت إلى اعتماد الرؤية الحاسوبية مع إعطاء الأولوية للسرعة والأداء في الوقت الفعلي. وقد دفع هذا الاحتياج الباحثين إلى تطوير نماذج أحادية المرحلة تكتشف الكائنات في تمريرة واحدة، ما حسّن الكفاءة بدرجة كبيرة.
على خلاف عملية Mask R-CNN متعددة الخطوات، تركز نماذج الرؤية الحاسوبية أحادية المرحلة مثل YOLO (انظر مرة واحدة فقط) على مهام الرؤية الحاسوبية في الزمن الحقيقي. فبدلًا من معالجة الاكتشاف والتقسيم كلٌّ على حدة، تستطيع نماذج YOLO اكتشاف الأجسام وتقسيمها في تمريرة واحدة. وهذا يجعلها مثالية لتطبيقات مثل القيادة الذاتية والرعاية الصحية والتصنيع والروبوتات، حيث يُعد اتخاذ القرارات بسرعة أمرًا بالغ الأهمية.
وعلى وجه الخصوص، يخطو Ultralytics YOLO11 (الذي خلفه Ultralytics YOLO26) خطوة إضافية بفضل جمعه بين السرعة والدقة. فهو يستخدم معلمات أقل بنسبة 22% من YOLOv8m، ومع ذلك يحقق متوسط دقة أعلى (mAP) على مجموعة بيانات COCO، أي إنه يكتشف الأجسام بدقة أكبر. وتجعل سرعة المعالجة المحسنة منه خيارًا جيدًا للتطبيقات الآنية التي تهم فيها كل ميلي ثانية.
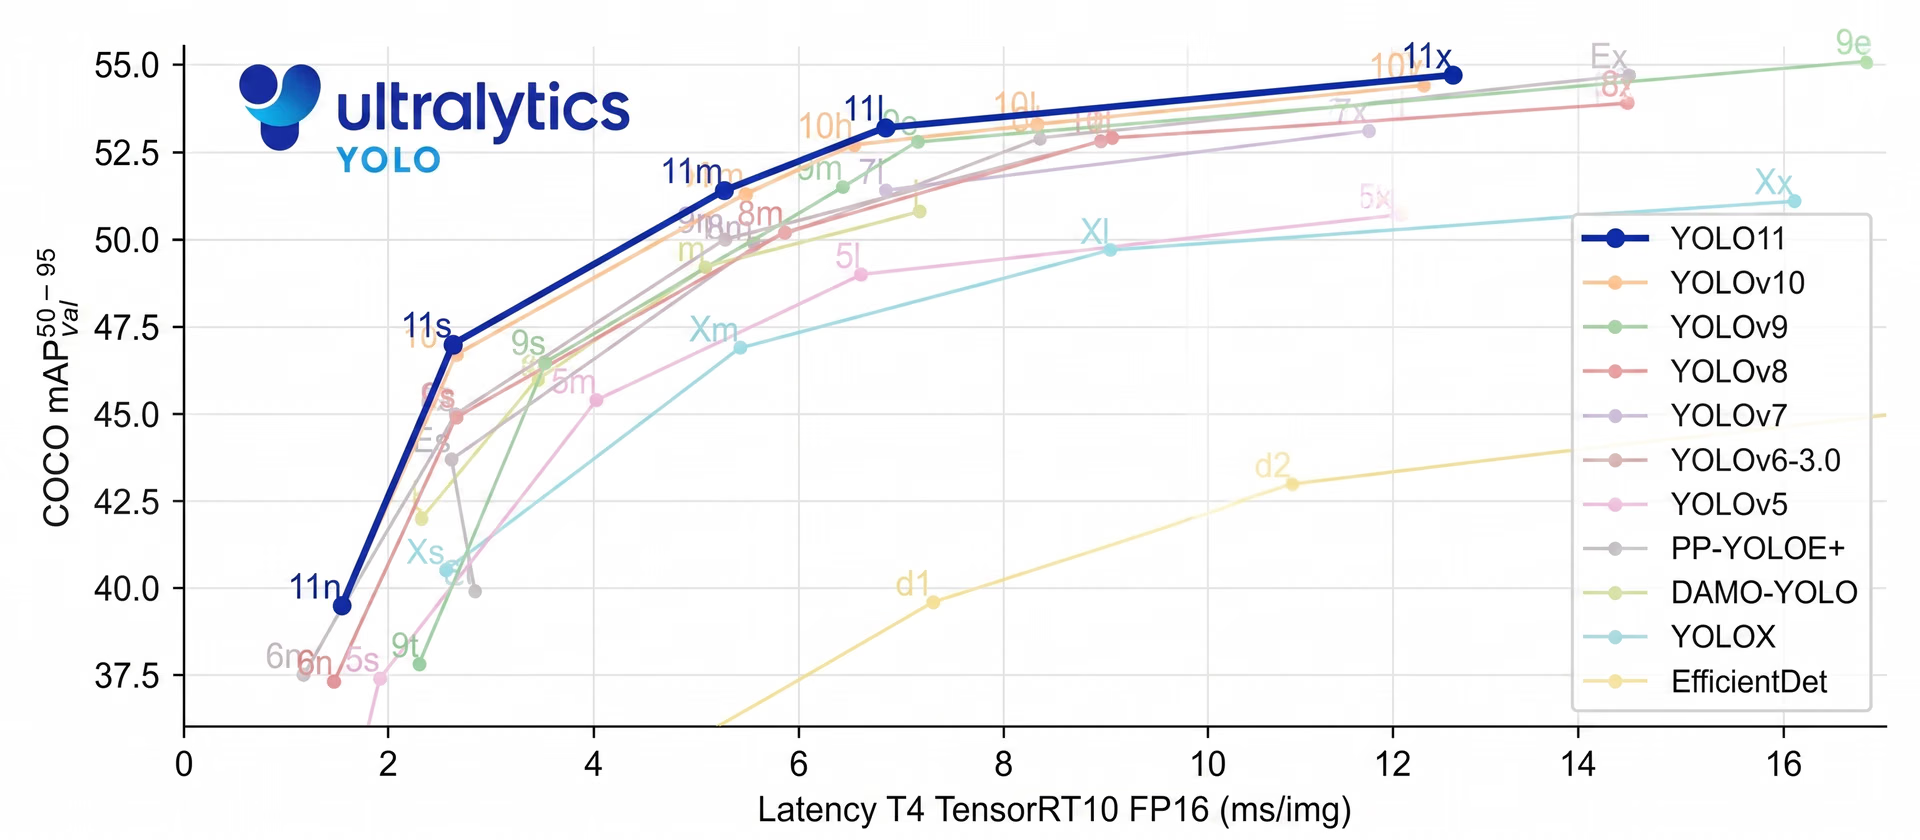
الشكل 6. أداء YOLO11 مقارنةً بالنماذج الأخرى.
أبرز النقاط#
عند استعراض تاريخ الرؤية الحاسوبية، يُعترف بـ Mask R-CNN بوصفه إنجازًا بارزًا في اكتشاف الكائنات وتجزيئها. فهو يقدم نتائج بالغة الدقة حتى في البيئات المعقدة، بفضل عملية المعالجة المفصلة متعددة الخطوات.
لكن هذه العملية نفسها تجعله أبطأ مقارنةً بالنماذج الآنية مثل YOLO. ومع تزايد الحاجة إلى السرعة والكفاءة، تستخدم تطبيقات كثيرة الآن نماذج أحادية المرحلة مثل Ultralytics YOLO11، التي توفر اكتشافًا سريعًا ودقيقًا للأجسام. ورغم أهمية Mask R-CNN لفهم تطور الرؤية الحاسوبية، يعكس التحول نحو النماذج الآنية تزايد الطلب على حلول أسرع وأكثر كفاءة.
انضم إلى مجتمعنا المتنامي! واستكشف مستودع GitHub للتعرف على المزيد عن الذكاء الاصطناعي. هل أنت مستعد لبدء مشاريعك الخاصة في الرؤية الحاسوبية؟ ألقِ نظرة على خيارات الترخيص. واكتشف الذكاء الاصطناعي في الزراعة والذكاء الاصطناعي البصري في الرعاية الصحية عبر زيارة صفحات حلولنا!
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









