Wie Ultralytics YOLO26 mit ProgLoss, STAL und MuSGD intelligenter trainiert
Erfahre, wie Ultralytics YOLO26 dank Progressiver Verlustgewichtung, Labelzuweisung mit Fokus auf kleine Objekte und dem MuSGD-Optimierer zuverlässiger trainiert.
 Abirami Vina9 Min. Lesezeit
Letzte Woche haben wir Ultralytics YOLO26 veröffentlicht, ein echtzeitfähiges Computer-Vision-Modell, das auf Edge-Geräte ausgelegt ist. Wie frühere Ultralytics-YOLO-Modelle wie Ultralytics YOLO11 unterstützt YOLO26 die zentralen Computer-Vision-Aufgaben, mit denen Nutzer vertraut sind, darunter Objekterkennung, Instanzsegmentierung und Posenschätzung.
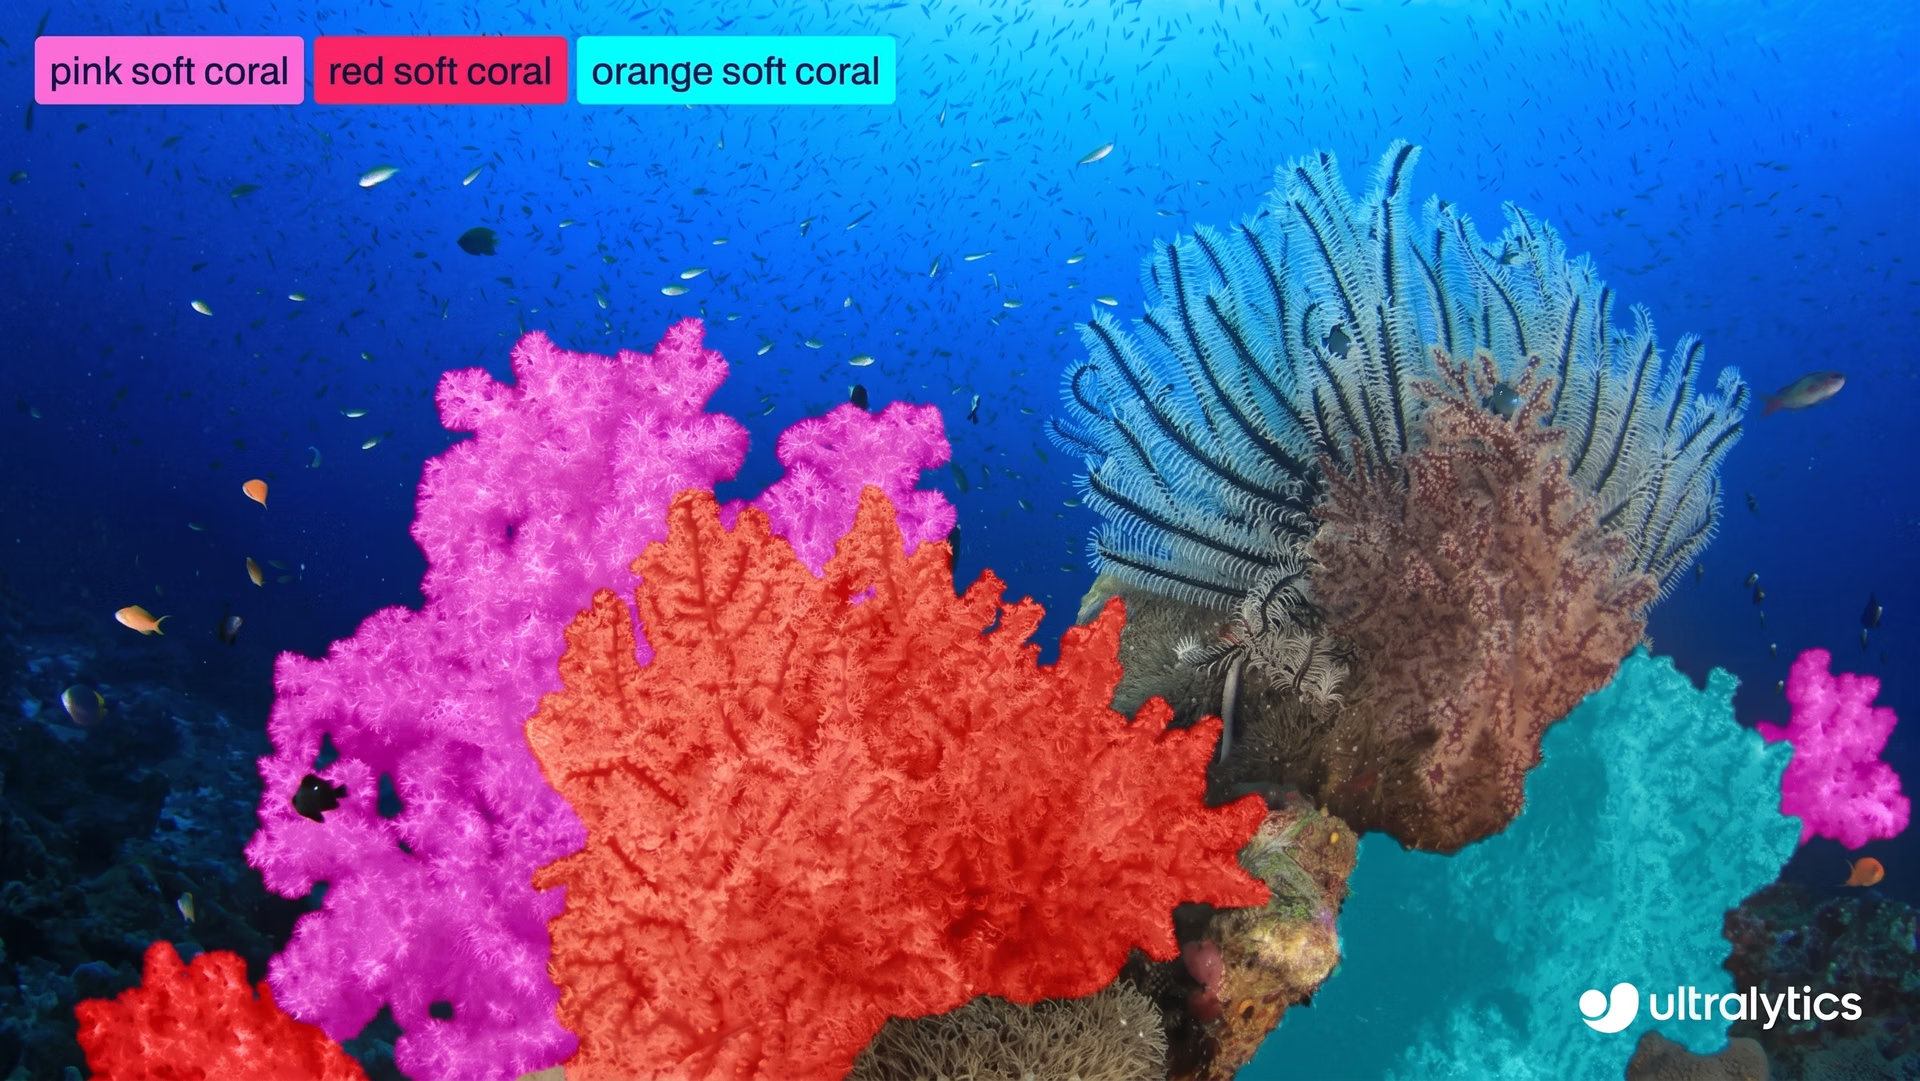
Abb. 1. Beispiel für die Verwendung von Ultralytics YOLO26 zur Segmentierung von Objekten in einem Bild.
Ultralytics YOLO26 ist jedoch nicht nur eine schrittweise Weiterentwicklung. Auch wenn die unterstützten Aufgaben vertraut erscheinen, stellt das neue Modell einen Fortschritt darin dar, wie Computer-Vision-Modelle trainiert werden. Bei YOLO26 liegt der Schwerpunkt nicht mehr nur auf der Inferenzeffizienz, sondern auch auf der Stabilisierung des Trainings.
Ultralytics YOLO26 wurde mit Blick auf den gesamten Trainingszyklus entwickelt. Das bedeutet schnellere Konvergenz, zuverlässigere Trainingsläufe und ein konsistentes Modellverhalten. Diese Verbesserungen sind besonders wichtig in realen Arbeitsabläufen, in denen die Zuverlässigkeit des Trainings direkt beeinflusst, wie schnell Modelle weiterentwickelt und bereitgestellt werden können.
Dafür führt Ultralytics YOLO26 mehrere gezielte Trainingsinnovationen ein, darunter progressiven Verlustausgleich (ProgLoss), die labelgestützte Zuweisung für kleine Ziele (STAL) und den MuSGD-Optimierer. Zusammengenommen verbessern diese Änderungen den Ausgleich der Lernverluste, die Zuweisung von Labels und das Optimierungsverhalten im Laufe der Zeit.
In diesem Artikel untersuchen wir, wie die einzelnen Mechanismen funktionieren und warum sie das Training von Ultralytics YOLO26 vereinfachen und das Modell in großem Maßstab zuverlässiger machen. Legen wir los!
Ultralytics YOLO26: Für intelligenteres Training entwickelt, nicht nur für schnellere Ausführung#
Ultralytics YOLO26 vereinfacht die gesamte Inferenzpipeline von Grund auf, indem es auf Nachbearbeitungsschritte wie Non-Maximum Suppression (NMS) verzichtet. Statt zahlreiche überlappende Vorhersagen zu erzeugen und anschließend zu filtern, liefert YOLO26 direkt die endgültigen Erkennungen aus dem Netzwerk.
Dadurch wird YOLO26 zu einem End-to-End-Modell, in dem die Vorhersage, die Auflösung von Duplikaten und die endgültigen Ausgaben direkt im Netzwerk gelernt werden. Das vereinfacht die Bereitstellung und steigert die Inferenzeffizienz, wirkt sich aber auch darauf aus, wie das Modell während des Trainings lernt.
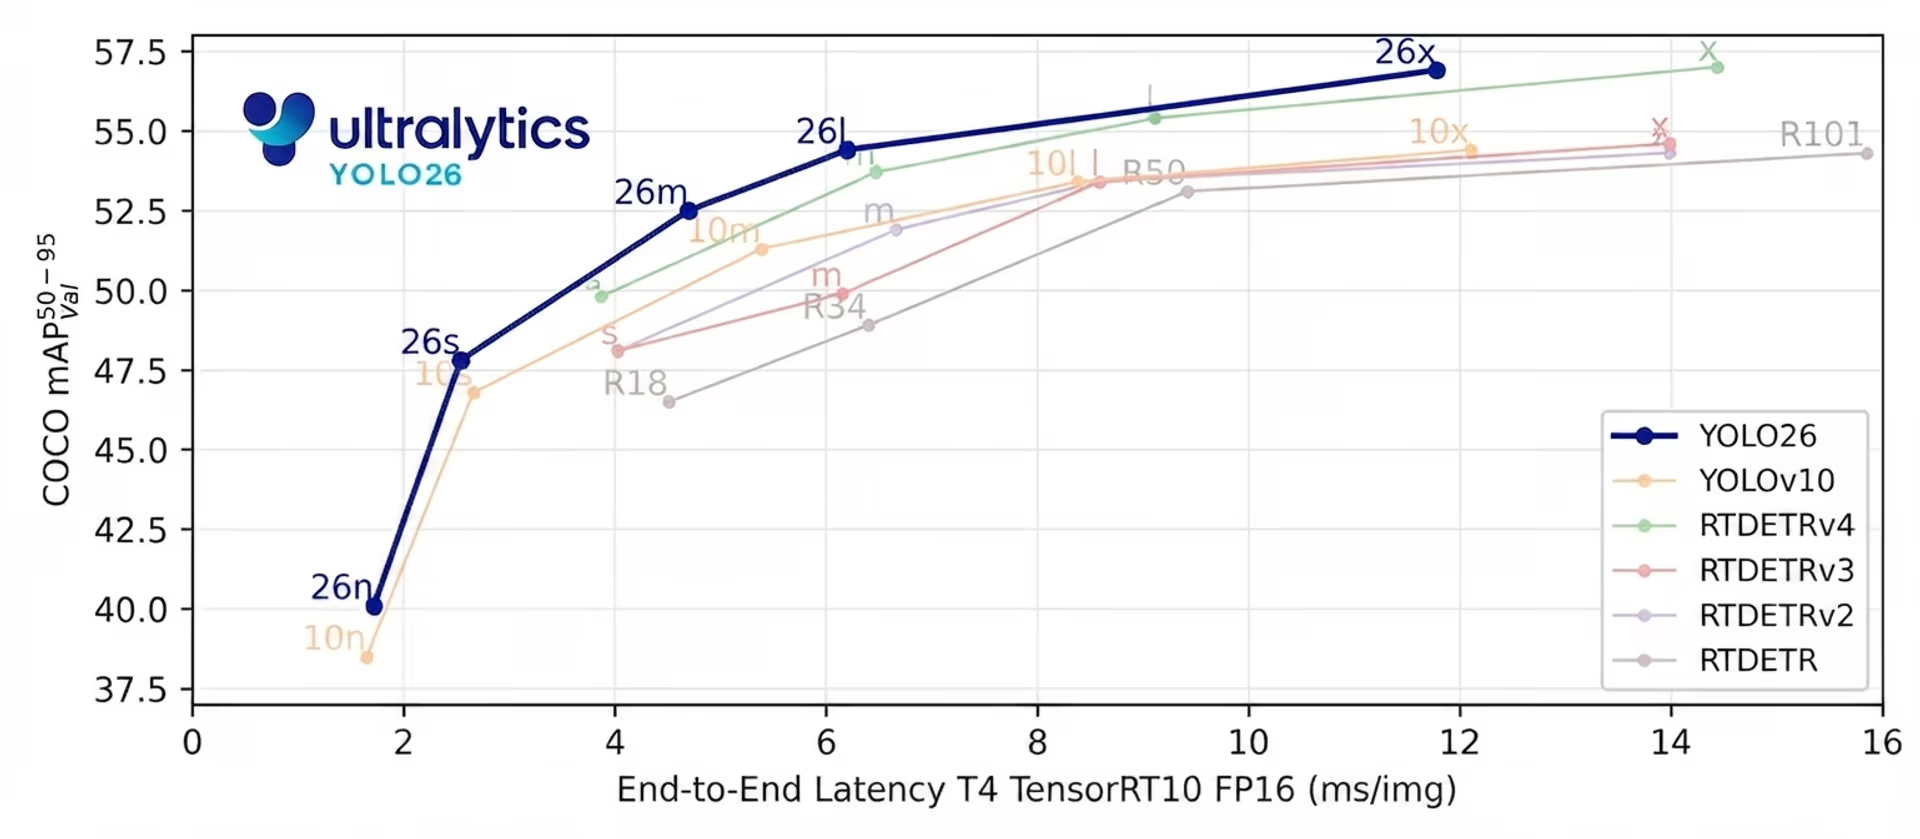
Abb. 2. YOLO26 ermöglicht eine hochmoderne End-to-End-Inferenz ohne NMS (Quelle)
In einem solchen End-to-End-System sind Training und Inferenz eng miteinander verknüpft. Da es keine externe Nachverarbeitungsstufe gibt, die Vorhersagen nachträglich korrigiert, muss das Modell bereits während des Trainings lernen, klare und zuverlässige Entscheidungen zu treffen.
Dadurch ist es besonders wichtig, dass Trainingsziele und Inferenzverhalten aufeinander abgestimmt sind. Jede Abweichung zwischen dem Training des Modells und seiner Verwendung zur Inferenz kann zu instabilem Lernen oder einer langsameren Konvergenz führen.
Ultralytics YOLO26 begegnet dieser Herausforderung, indem der Trainingsprozess von Anfang an auf den Einsatz in der Praxis ausgerichtet ist. Statt sich ausschließlich auf die Inferenzgeschwindigkeit zu konzentrieren, ist das Trainingssystem darauf ausgelegt, stabiles Lernen über lange Trainingsläufe, eine gleichmäßige Konvergenz über Modellgrößen von Nano bis Extra Large und robuste Leistung auf vielfältigen Datensätzen zu unterstützen.
Wie zwei Trainingsköpfe das Lernen in Ultralytics YOLO26 verbessern#
Eine der wichtigsten Trainingsinnovationen in Ultralytics YOLO26 baut auf einem Ansatz mit zwei Köpfen auf, der bereits in früheren YOLO-Modellen verwendet wurde. Bei Objekterkennungsmodellen bezeichnet ein Kopf den Teil des Netzwerks, der für die Erstellung von Vorhersagen zuständig ist.
Anders gesagt: Erkennungsköpfe lernen vorherzusagen, wo sich Objekte in einem Bild befinden und um welche Objekte es sich handelt. Dazu regressieren sie die Koordinaten von Begrenzungsrahmen, das heißt, sie lernen, Position und Größe jedes Objekts im Eingabebild zu schätzen.
Während des Trainings lernt das Modell, indem es einen Verlust minimiert. Dieser ist ein numerisches Maß dafür, wie stark seine Vorhersagen von den korrekten Antworten beziehungsweise den Ground-Truth-Daten abweichen. Ein niedrigerer Verlust bedeutet, dass die Vorhersagen des Modells näher an den Ground-Truth-Daten liegen, während ein höherer Verlust auf größere Fehler hindeutet. Die Verlustberechnung steuert, wie das Modell seine Parameter während des Trainings aktualisiert.
Ultralytics YOLO26 verwendet während des Trainings zwei Erkennungsköpfe, die dasselbe zugrunde liegende Modell nutzen, aber unterschiedliche Aufgaben erfüllen. Der Eins-zu-eins-Kopf kommt bei der Inferenz zum Einsatz. Er lernt, jedes Objekt mit einer einzigen, zuverlässigen Vorhersage zu verknüpfen – eine wesentliche Voraussetzung für das End-to-End-Design von YOLO26 ohne NMS.
Der Eins-zu-viele-Kopf wird dagegen nur während des Trainings verwendet. Er ermöglicht es, mehrere Vorhersagen demselben Objekt zuzuordnen, und sorgt so für eine dichtere Überwachung. Dieses reichhaltigere Lernsignal trägt zur Stabilisierung des Trainings und zu einer höheren Genauigkeit bei, insbesondere in den frühen Trainingsphasen.
In Ultralytics YOLO26 verwenden beide Köpfe dieselbe Verlustberechnung für die Boxregression und Klassifizierung. Frühere Implementierungen gewichteten diese beiden Verlustsignale während des gesamten Trainings in einem festen Verhältnis.
In der Praxis ändert sich jedoch die Bedeutung der beiden Köpfe im Laufe der Zeit. Eine dichte Überwachung ist zu Beginn am nützlichsten, während die Übereinstimmung mit dem Inferenzverhalten später im Training an Bedeutung gewinnt. Ultralytics YOLO26 wurde mit Blick auf diese Erkenntnis entwickelt, die direkt dazu führt, wie die Lernsignale im Verlauf des Trainings neu gewichtet werden.
Ultralytics YOLO26 verwendet eine progressive Verlustgewichtung#
Wie geht Ultralytics YOLO26 also während des Trainings mit diesen wechselnden Lernanforderungen um? Mit einer progressiven Verlustgewichtung, die die Gewichtung der Lernsignale im Zeitverlauf anpasst.
ProgLoss verschiebt dynamisch den Anteil, den jeder Kopf zum Gesamtverlust beiträgt, während das Training voranschreitet. Zu Beginn erhält der Eins-zu-viele-Kopf mehr Gewicht, um das Lernen zu stabilisieren und den Recall zu verbessern. Im weiteren Trainingsverlauf verschiebt sich das Verhältnis schrittweise zugunsten des Eins-zu-eins-Kopfs, sodass das Training stärker dem Inferenzverhalten entspricht.
Dieser schrittweise Übergang ermöglicht es Ultralytics YOLO26, in der richtigen Reihenfolge zu lernen. Statt das Modell zu zwingen, konkurrierende Ziele gleichzeitig zu optimieren, priorisiert die progressive Verlustgewichtung in jeder Trainingsphase das jeweils nützlichste Lernsignal. Das Ergebnis sind eine gleichmäßigere Konvergenz, weniger instabile Trainingsläufe und eine konsistentere Leistung am Ende.
Wie STAL Ultralytics YOLO26 beim Lernen mit winzigen Objekten unterstützt#
Eine weitere interessante Verbesserung beim Training von Ultralytics YOLO26 betrifft die Zuweisung von Trainingszielen zu Vorhersagen – ein Vorgang, der als Label-Zuweisung bezeichnet wird. Dabei werden Ground-Truth-Objekte passenden Vorhersagekandidaten zugeordnet, die häufig Anker genannt werden.
Diese Zuordnungen bestimmen, welche Vorhersagen eine Überwachung erhalten und zum Verlust beitragen. Ultralytics YOLO26 baut auf einem bestehenden Verfahren zur Label-Zuweisung namens Task Alignment Learning (TAL) auf, das die Abstimmung von Klassifizierung und Lokalisierung während des Trainings verbessern soll.
TAL funktioniert zwar bei den meisten Objekten gut, doch das Training offenbarte eine wichtige Einschränkung. Bei der Zuordnung konnten sehr kleine Objekte vollständig verloren gehen. In der Praxis erhielten Objekte mit einer Größe von weniger als etwa 8 Pixeln in einem 640 Pixel großen Eingabebild häufig keine Ankerzuweisungen. In solchen Fällen erhält das Modell für diese Objekte kaum oder gar keine Überwachung, sodass es schwierig ist, sie zuverlässig zu erkennen.
Um dieses Problem zu lösen, führt Ultralytics YOLO26 die Small-Target-Aware Label Assignment (STAL) ein. STAL passt die Zuweisung an, damit kleine Objekte beim Training nicht ignoriert werden. Bei der Auswahl der Kandidaten vergrößert das Verfahren insbesondere jede Box, deren Breite oder Höhe unter 8 Pixeln liegt, auf 16 Pixel. Für das Matching und die Regression wird weiterhin die ursprüngliche Box verwendet. So tragen selbst winzige Objekte zuverlässig zum Trainingsverlust bei.
Durch die stärkere Überwachung kleiner Ziele verbessert STAL die Lernstabilität und Erkennungsleistung in Szenarien, in denen kleine oder weit entfernte Objekte häufig vorkommen. Diese Verbesserung ist besonders wichtig für Anwendungen mit YOLO26 für den Einsatz am Netzwerkrand, etwa bei Luftbildern, in der Robotik und in Systemen des Internets der Dinge (IoT), in denen Objekte oft klein, weit entfernt oder teilweise verdeckt sind und eine zuverlässige Erkennung entscheidend ist.
Ultralytics YOLO26 führt den MuSGD-Optimierer ein#
Um ein stabileres und vorhersehbareres Training zu ermöglichen, führt Ultralytics YOLO26 außerdem einen neuen Optimierer namens MuSGD ein. Dieser Optimierer soll die Konvergenz und Zuverlässigkeit des Trainings bei End-to-End-Erkennungsmodellen verbessern, insbesondere bei zunehmender Modellgröße und Trainingskomplexität.
Damit ein neuronales Netz während des Trainings lernen und seine Gewichte aktualisieren kann, berechnen wir einen Fehler, der auch als Verlust bezeichnet wird. Mithilfe eines Verlustwerts ermittelt das Modell, wie stark seine Vorhersagen abweichen, berechnet Gradienten, die angeben, wie sich seine Parameter ändern sollten, und aktualisiert anschließend diese Parameter, um den Fehler zu verringern. Stochastic Gradient Descent (SGD) ist ein weit verbreiteter Optimierer, der diese Aktualisierungen durchführt und das Training dadurch effizient und skalierbar macht.
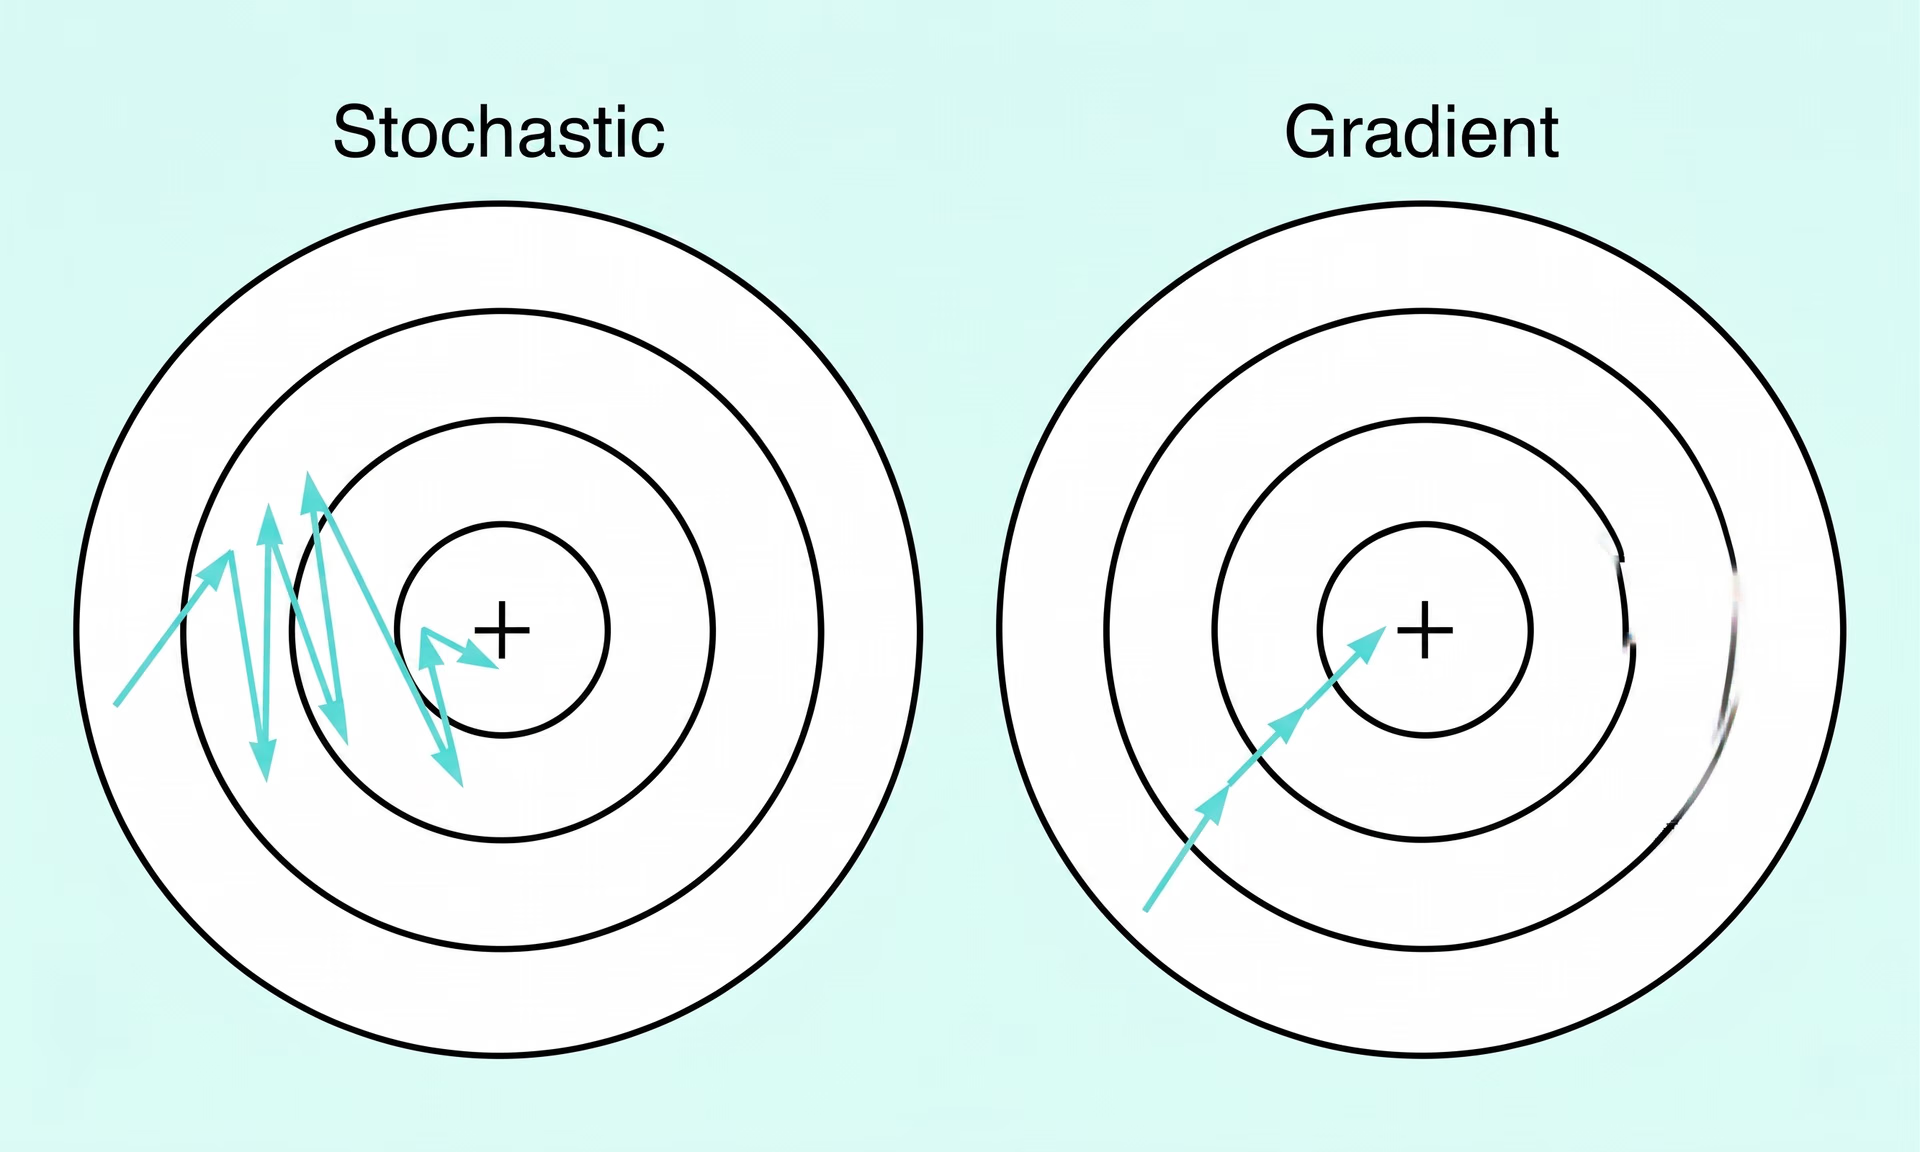
Abb. 3. Stochastischer Gradientenabstieg im Vergleich zum Gradientenabstieg (Quelle)
MuSGD baut auf dieser bekannten Grundlage auf und integriert Optimierungsideen, die von Muon inspiriert sind – einer Methode, die beim Training großer Sprachmodelle (LLM) eingesetzt wird. Diese Ideen wurden durch jüngste Fortschritte wie Kimi K2 von Moonshot AI beeinflusst, das durch stärker strukturierte Parameteraktualisierungen ein verbessertes Trainingsverhalten zeigte.
Ultralytics YOLO26 verwendet eine hybride Aktualisierungsstrategie. Einige Parameter werden mit einer Kombination aus von Muon inspirierten Aktualisierungen und SGD aktualisiert, während für andere ausschließlich SGD verwendet wird. So kann YOLO26 den Optimierungsprozess stärker strukturieren und zugleich die Robustheit und Generalisierungsfähigkeit bewahren, für die sich SGD bewährt hat.
Das Ergebnis sind eine gleichmäßigere Optimierung, eine schnellere Konvergenz und ein besser vorhersagbares Trainingsverhalten über verschiedene Modellgrößen hinweg. Damit ist MuSGD ein wichtiger Grund dafür, dass Ultralytics YOLO26 leichter zu trainieren und auch bei großen Modellen zuverlässiger ist.
Die Bedeutung der Trainingsinnovationen von Ultralytics YOLO26#
Die Trainingsinnovationen von Ultralytics YOLO26 machen das Modell zusammen mit wichtigen Merkmalen wie dem End-to-End-Design ohne NMS und der Ausrichtung auf den Einsatz am Netzwerkrand leichter trainierbar und auch bei großen Modellen zuverlässiger. Vielleicht fragst du dich, was das konkret für Computer-Vision-Anwendungen bedeutet.
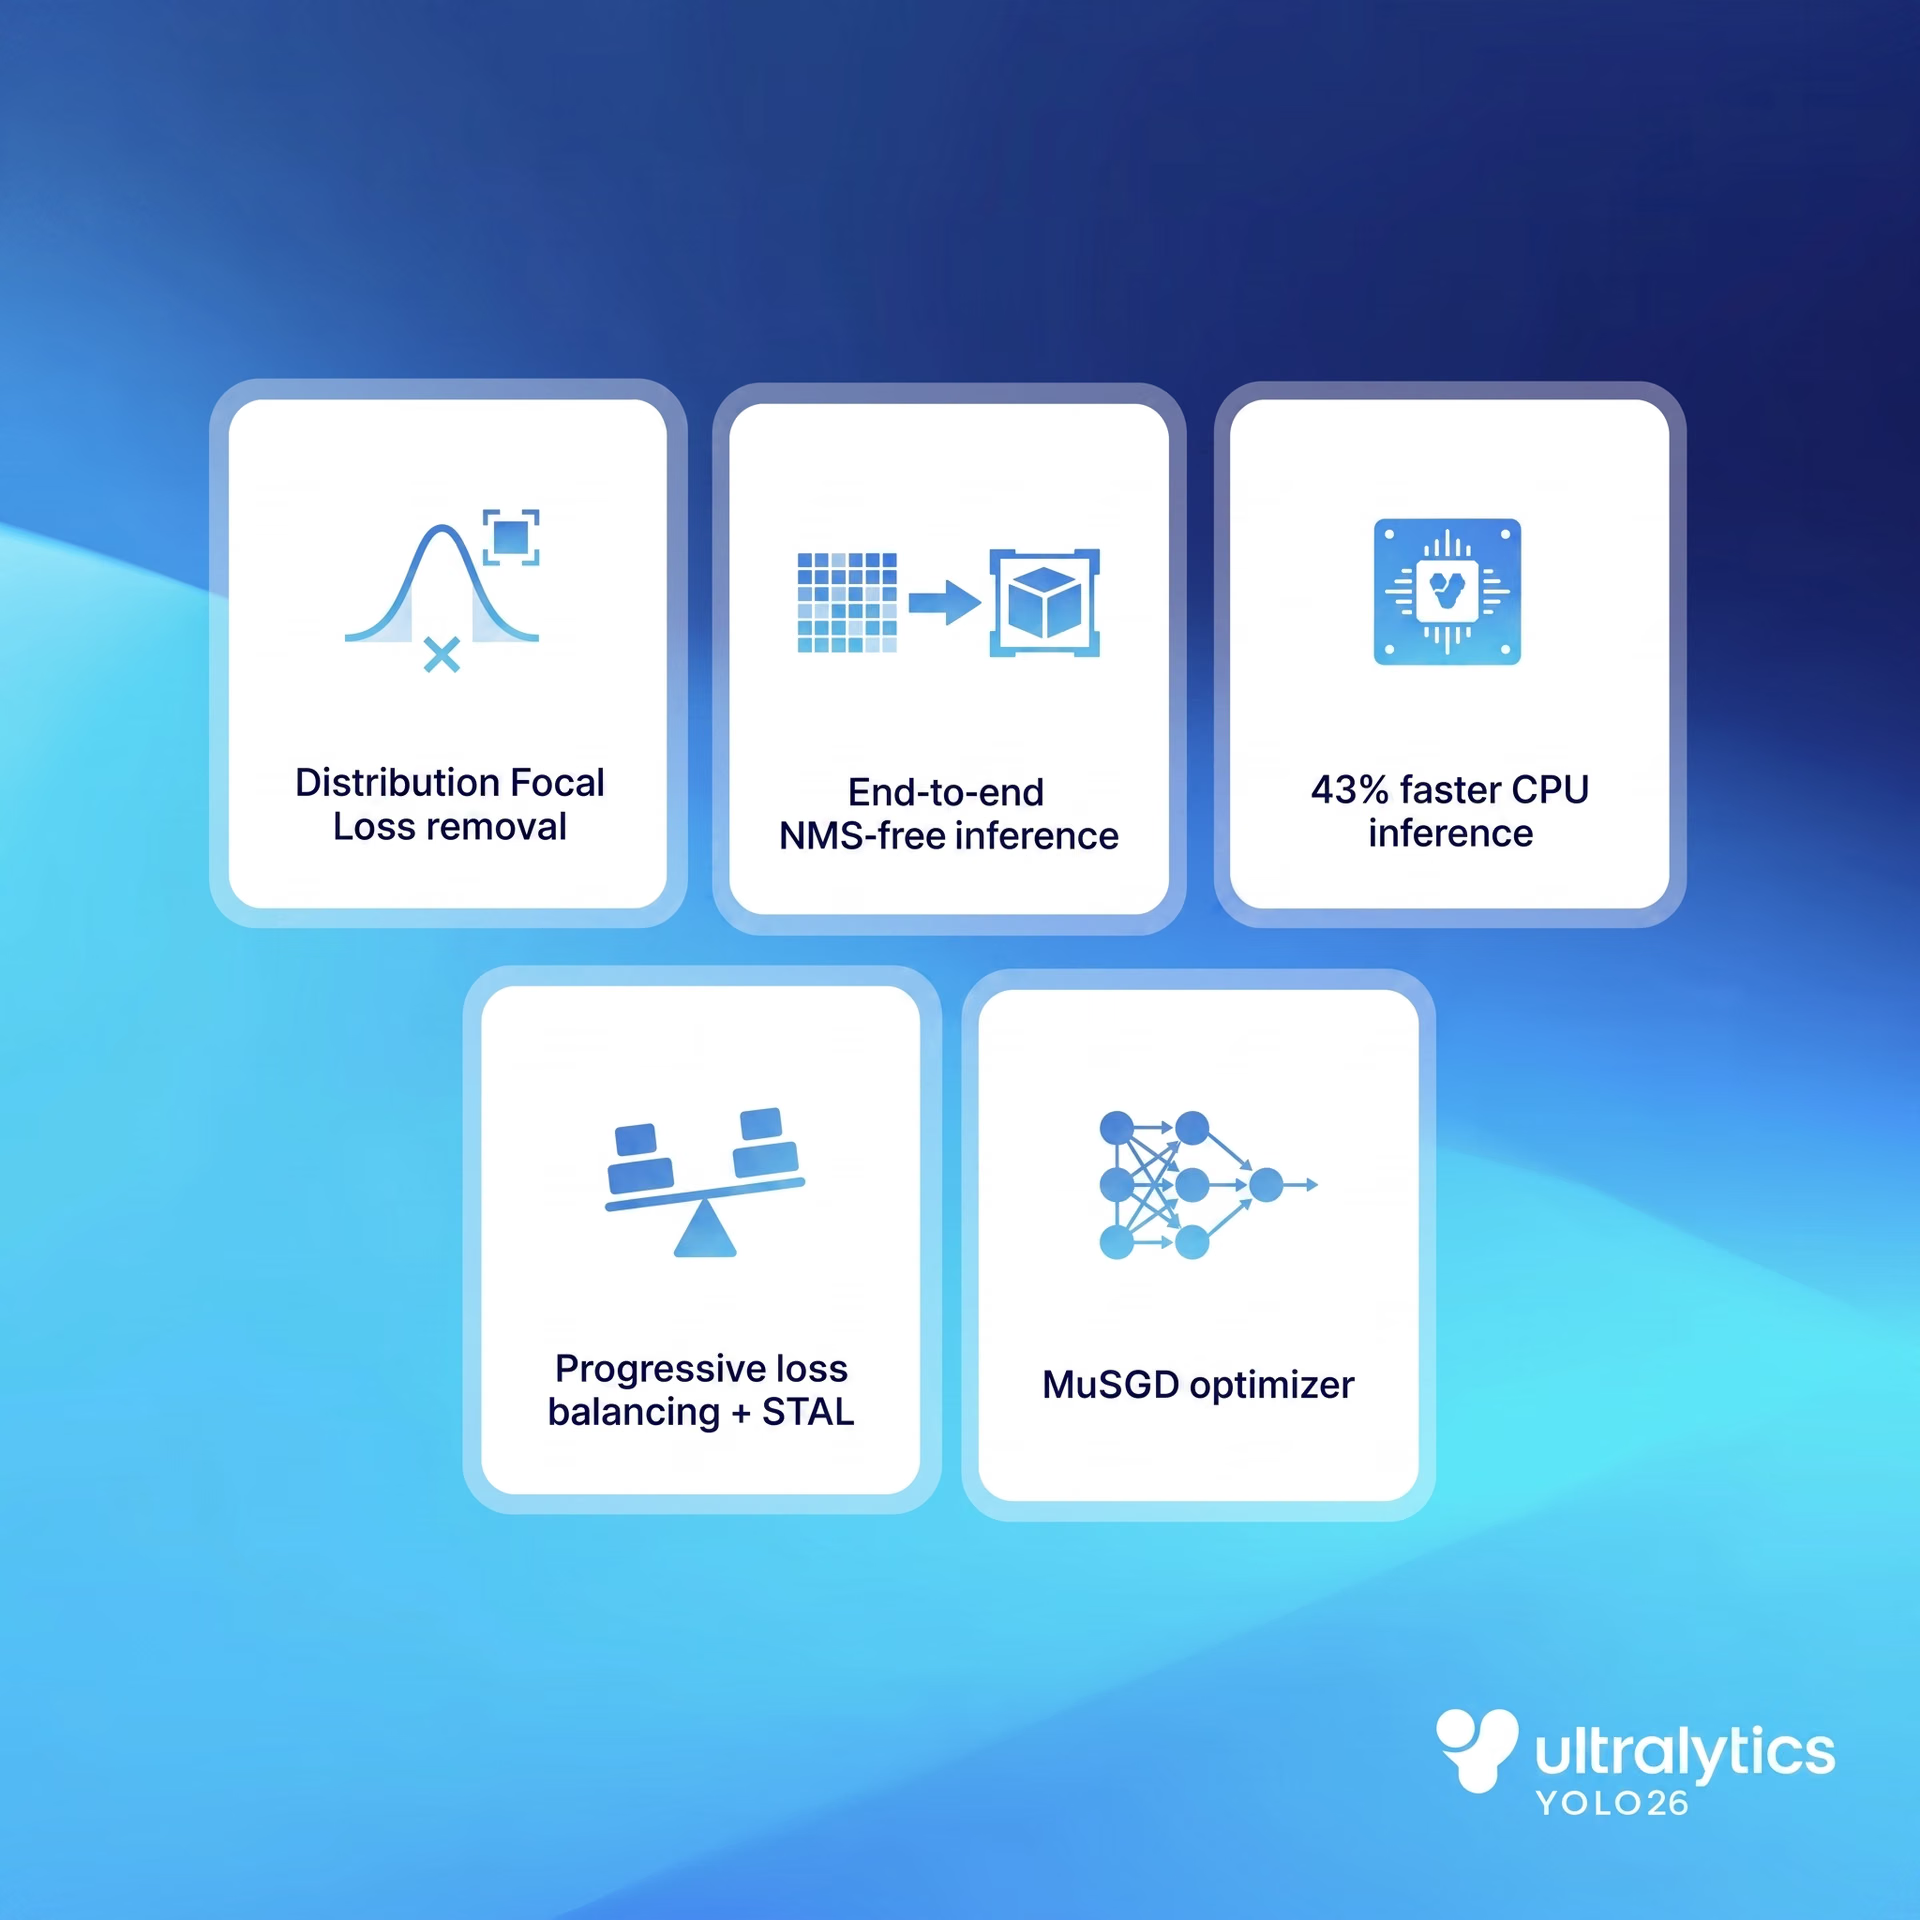
Abb. 4. Ein Überblick über die wichtigsten Funktionen von YOLO26 (Quelle)
In der Praxis wird es dadurch deutlich einfacher, Computer Vision dort einzusetzen, wo die Systeme tatsächlich laufen. Modelle lassen sich besser vorhersagbar trainieren, skalieren über verschiedene Größen hinweg gleichmäßiger und einfacher an neue Datensätze anpassen. Das verringert den Aufwand für den Übergang vom Experimentieren zur Bereitstellung, insbesondere in Umgebungen, in denen Zuverlässigkeit und Effizienz ebenso wichtig sind wie die reine Leistung.
Beispielsweise müssen Modelle in der Robotik und bei industriellen Bildverarbeitungsanwendungen oft regelmäßig neu trainiert werden, wenn sich Umgebungen, Sensoren oder Aufgaben ändern. Mit Ultralytics YOLO26 können Teams schneller iterieren, ohne sich über instabile Trainingsläufe oder uneinheitliches Verhalten bei unterschiedlichen Modellgrößen sorgen zu müssen.
Die wichtigsten Erkenntnisse#
Zuverlässige Computer-Vision-Systeme hängen ebenso davon ab, wie Modelle trainiert werden, wie davon, wie sie bei der Inferenz abschneiden. Durch eine bessere Abstimmung der Lernsignale, einen verbesserten Umgang mit kleinen Objekten und einen optimierten Trainingsverlauf macht Ultralytics YOLO26 das Training stabiler und leichter skalierbar. Das Trainingsrezept für YOLO26 dokumentiert die Einstellungen, die für die offiziellen Checkpoints verwendet wurden. Dieser Fokus auf zuverlässiges Training hilft Teams, reibungsloser von Experimenten zur Bereitstellung in der Praxis überzugehen, insbesondere bei Anwendungen, die auf Edge-Geräte ausgelegt sind.
Möchtest du mehr über KI erfahren? Besuche unser GitHub-Repository, um mehr zu entdecken. Werde Teil unserer aktiven Community und erfahre mehr über Innovationen in Bereichen wie KI in der Logistik und visuelle KI in der Automobilindustrie. Wenn du heute mit Computer Vision loslegen möchtest, sieh dir unsere Lizenzoptionen an.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









