KI-Verzerrungen und Verzerrungen in Datensätzen für visuelle KI-Systeme verstehen
Erfahre, wie Verzerrungen in Datensätzen Computer-Vision-Modelle beeinflussen und wie Ultralytics YOLO11 sie mithilfe intelligenter Augmentierung und flexibler Trainingswerkzeuge verringert.
Modelle der künstlichen Intelligenz (AI) verändern die Art und Weise, wie wir Probleme lösen, sind aber nicht perfekt. Von selbstfahrenden Autos bis hin zu Diagnosewerkzeugen im Gesundheitswesen verlassen wir uns darauf, dass KI Daten interpretiert und Entscheidungen trifft. Was passiert, wenn die Daten selbst fehlerhaft sind?
Verzerrungen in der KI bezeichnen Muster von Inkonsistenzen, die sich in Modellen entwickeln, oft ohne dass es jemand bemerkt. Diese Verzerrungen können dazu führen, dass Modelle ungenaue, widersprüchliche oder sogar schädliche Vorhersagen treffen. In der Computer Vision lassen sich Verzerrungen meist auf eine zentrale Ursache zurückführen: den Datensatz. Sind die zum Trainieren des Modells verwendeten Daten unausgewogen oder nicht repräsentativ, spiegeln sich diese Lücken im Modell wider.
Sehen wir uns genauer an, wie Verzerrungen in Datensätzen entstehen, wie sie sich auf Computer-Vision-Modelle auswirken und welche Schritte Entwickler unternehmen können, um sie zu erkennen und zu verhindern. Außerdem zeigen wir, wie Modelle wie Ultralytics YOLO11 dabei helfen können, fairere KI-Systeme zu entwickeln, die besser generalisieren – also bei neuen, zuvor nicht gesehenen Daten gut funktionieren und allen Menschen gleichermaßen dienen.
Was sind Verzerrungen in der KI und warum sind sie wichtig?#
Verzerrungen in der KI sind systematische Fehler in einem KI-System, die zu verzerrten oder ungenauen Ergebnissen führen. Einfach ausgedrückt: Das Modell bevorzugt eine Art visueller Eingabe gegenüber anderen. Das beeinträchtigt die Fairness des Modells nicht, weil es besser funktioniert, sondern aufgrund der Art und Weise, wie es trainiert wurde.
Das kommt besonders häufig bei Computer Vision vor, wo Modelle anhand visueller Daten lernen. Enthält ein Datensatz überwiegend eine bestimmte Art von Objekt, Szene oder Person, lernt das Modell Muster, die nur in diesen Fällen gut funktionieren.
Stell dir ein Modell vor, das hauptsächlich mit Verkehrsaufnahmen aus Großstädten trainiert wurde. Wird es in einer ländlichen Gegend eingesetzt, könnte es ungewöhnliche Straßenverläufe falsch klassifizieren oder bestimmte Fahrzeugtypen nicht erkennen, die es noch nie gesehen hat. Genau so wirken sich Verzerrungen in der KI aus. Sie führen zu geringerer Genauigkeit und eingeschränkter Generalisierung – also zu einer geringeren Fähigkeit des Modells, mit neuen oder vielfältigen Eingaben gut umzugehen.
In Anwendungen, bei denen Genauigkeit entscheidend ist, etwa im Gesundheitswesen oder in der Sicherheit, sind solche Fehler nicht nur ärgerlich, sondern können gefährlich sein. Der Umgang mit Verzerrungen betrifft Leistung, Zuverlässigkeit und Sicherheit.
Wie Verzerrungen in Datensätzen das Modellverhalten beeinflussen#
Wenn wir von Verzerrungen in Datensätzen sprechen, meinen wir ein Ungleichgewicht oder eine Einschränkung der Daten, mit denen ein Modell trainiert wird. Verzerrungen in Datensätzen entstehen, wenn die Trainingsdaten die Vielfalt der realen Welt, die das Modell abbilden soll, nicht angemessen widerspiegeln.
Computer-Vision-Modelle verstehen die Welt nicht. Sie verstehen Muster. Wenn die einzigen Hundebilder, die sie sehen, Golden Retriever in Hinterhöfen zeigen, erkennen sie möglicherweise keinen Husky auf einem verschneiten Wanderweg.
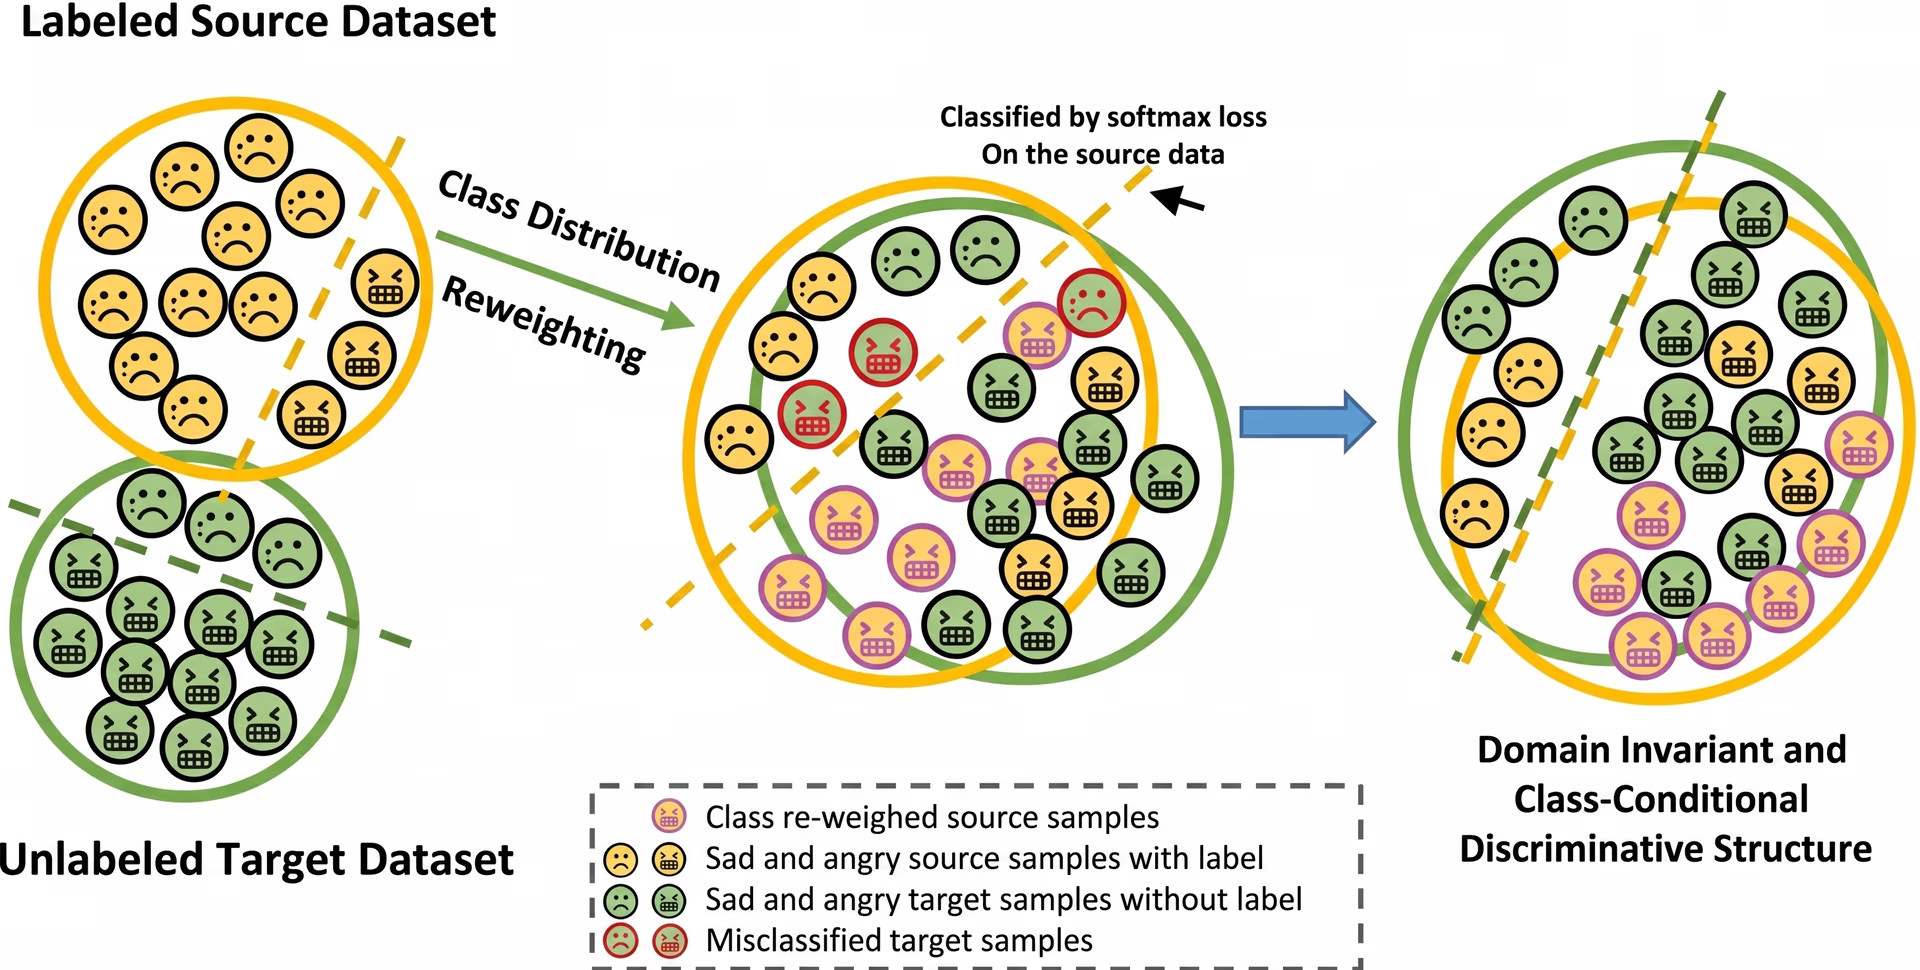
Abb. 1. Die Neugewichtung der Quelldaten trägt zu einer höheren Modellgenauigkeit bei.
Das verdeutlicht eine der größten Herausforderungen durch Verzerrungen in Datensätzen: Das Modell baut sein Verständnis auf dem auf, was ihm gezeigt wird. Spiegeln die Trainingsdaten nicht die Vielfalt der realen Welt wider, wird das Modellverhalten eingeschränkt und weniger effektiv – insbesondere unter unbekannten Bedingungen.
Bildklassifizierer schneiden bei Tests mit einem anderen Datensatz als dem Trainingsdatensatz oft deutlich schlechter ab, selbst wenn beide Datensätze für dieselbe Aufgabe erstellt wurden. Kleine Veränderungen der Beleuchtung, des Hintergrunds oder des Kamerawinkels können die Genauigkeit merklich verringern. Das zeigt, wie leicht Verzerrungen in Datensätzen die Fähigkeit eines Modells zur Generalisierung beeinträchtigen können.
Das sind keine Ausnahmefälle. Sie zeigen, dass deine Datenpipeline genauso wichtig ist wie deine Modellarchitektur.
Arten von Verzerrungen in KI-Trainingsdaten#
Verzerrungen können sich während der Entwicklung auf subtile Weise einschleichen, oft bei der Datenerfassung, Kennzeichnung oder Kuratierung. Im Folgenden sind drei wichtige Arten von Verzerrungen aufgeführt, die sich auf deine Trainingsdaten auswirken können:
Auswahlverzerrung#
Eine Auswahlverzerrung kann entstehen, wenn der Datensatz nicht die Vielfalt der realen Nutzung abbildet. Wird ein Modell zur Fußgängererkennung nur mit klaren Tageslichtaufnahmen trainiert, funktioniert es nachts oder bei Nebel nicht gut. Bei der Auswahl wurden also entscheidende Fälle übersehen.
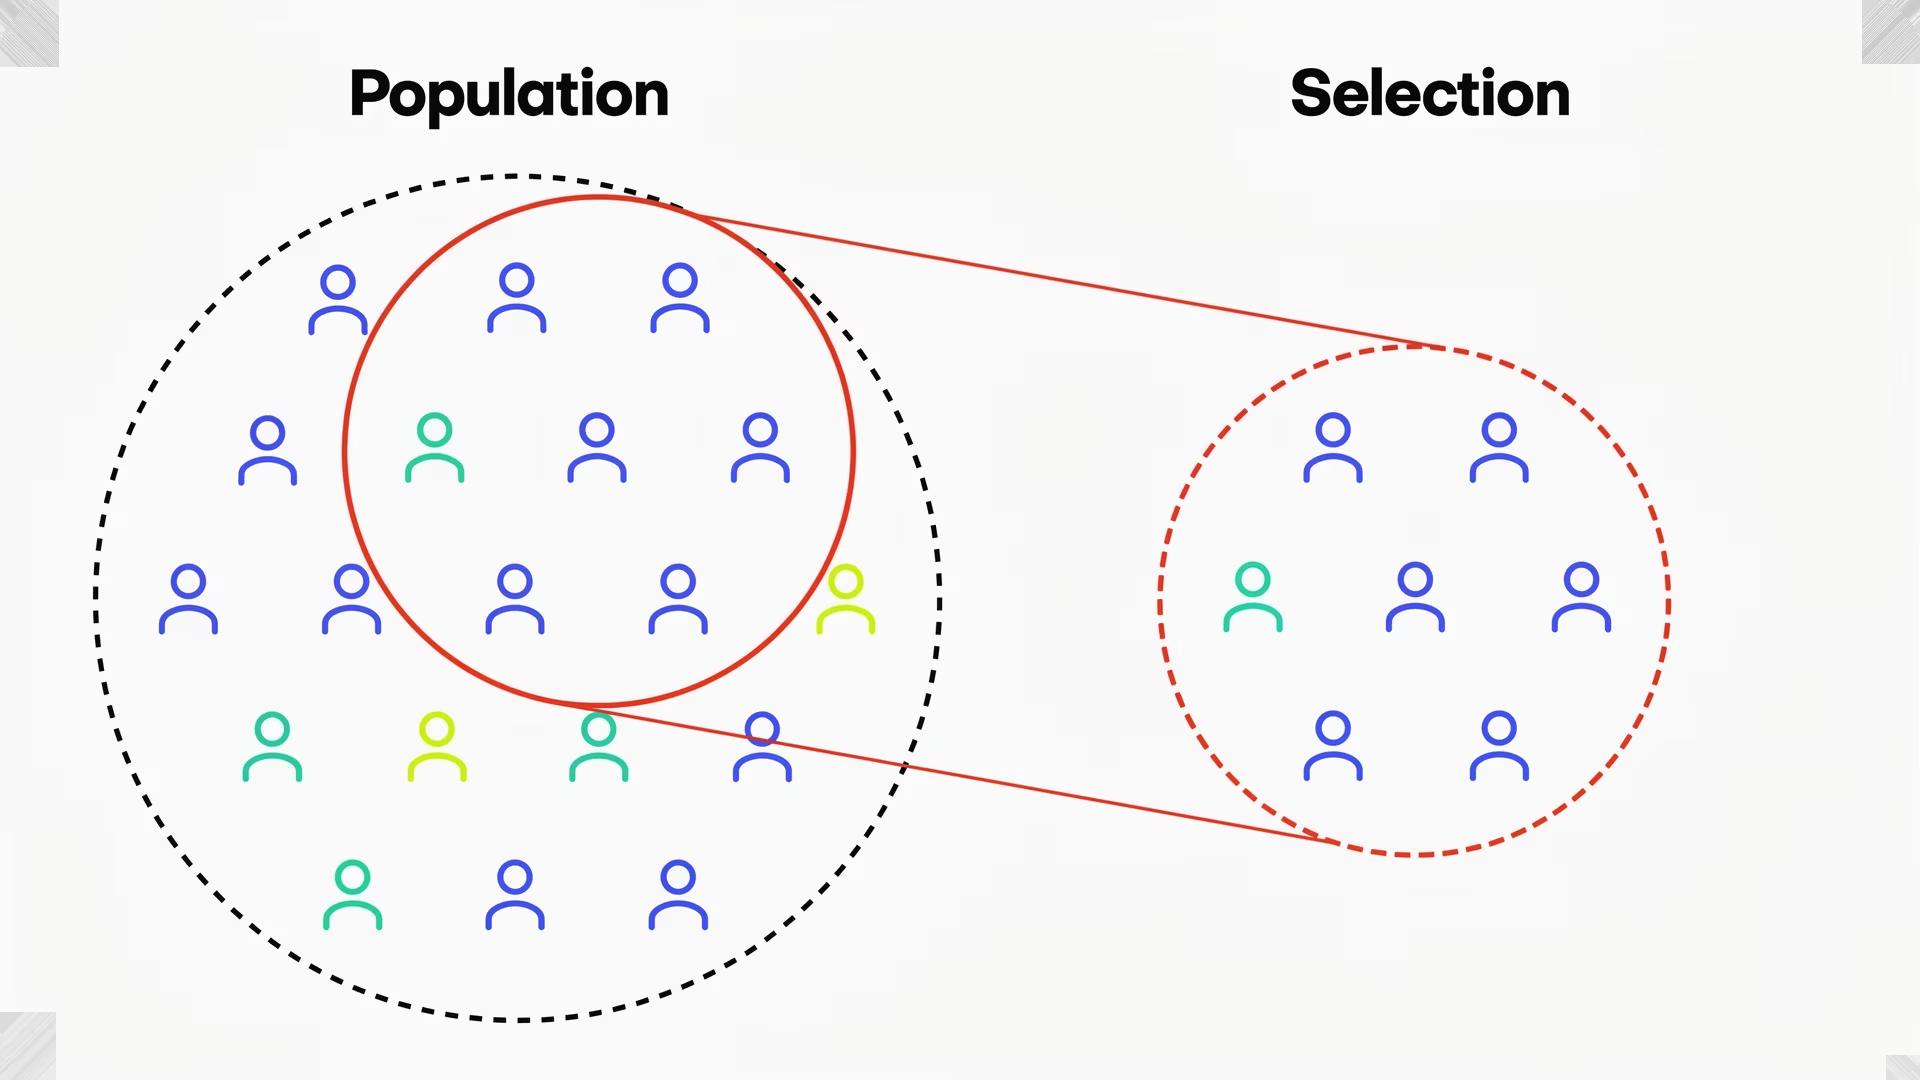
Abb. 2. Grafische Darstellung einer Auswahlverzerrung, bei der nur eine wenig vielfältige Teilmenge ausgewählt wird.
Diese Verzerrung entsteht, wenn der Datensatz aufgrund der Art der Datenerfassung nicht die ganze Bandbreite realer Szenarien abdeckt. Ein Modell zur Fußgängererkennung, das beispielsweise nur mit klaren Tageslichtaufnahmen trainiert wurde, versagt möglicherweise bei Nebel, Schnee oder schlechten Lichtverhältnissen. Das tritt häufig auf, wenn Daten unter idealen oder günstigen Bedingungen gesammelt werden, wodurch die Fähigkeit des Modells eingeschränkt wird, in vielfältigen Umgebungen zu funktionieren. Eine Ausweitung der Datenerfassung auf unterschiedlichere Situationen hilft, diese Art von Verzerrung zu verringern.
Sie kann auch bei Datensätzen auftreten, die aus Online-Quellen zusammengestellt wurden und deren Inhalte stark auf bestimmte Orte, Sprachen oder sozioökonomische Kontexte ausgerichtet sein können. Ohne gezielte Maßnahmen zur Diversifizierung des Datensatzes übernimmt das Modell diese Einschränkungen.
Kennzeichnungsverzerrung#
Eine Kennzeichnungsverzerrung entsteht, wenn menschliche Annotatoren falsche oder uneinheitliche Kennzeichnungen vergeben. Eine falsche Kennzeichnung mag harmlos erscheinen, aber wenn das oft vorkommt, lernt das Modell allmählich falsche Zusammenhänge.
Uneinheitliche Kennzeichnungen können das Modell während des Trainings verwirren, besonders bei komplexen Aufgaben wie der Objekterkennung. Beispielsweise kann eine Person ein Fahrzeug als „Auto“, eine andere ein ähnliches Fahrzeug als „Lkw“ kennzeichnen. Solche Uneinheitlichkeiten beeinträchtigen die Fähigkeit des Modells, verlässliche Muster zu erlernen, und verringern die Genauigkeit bei der Inferenz.
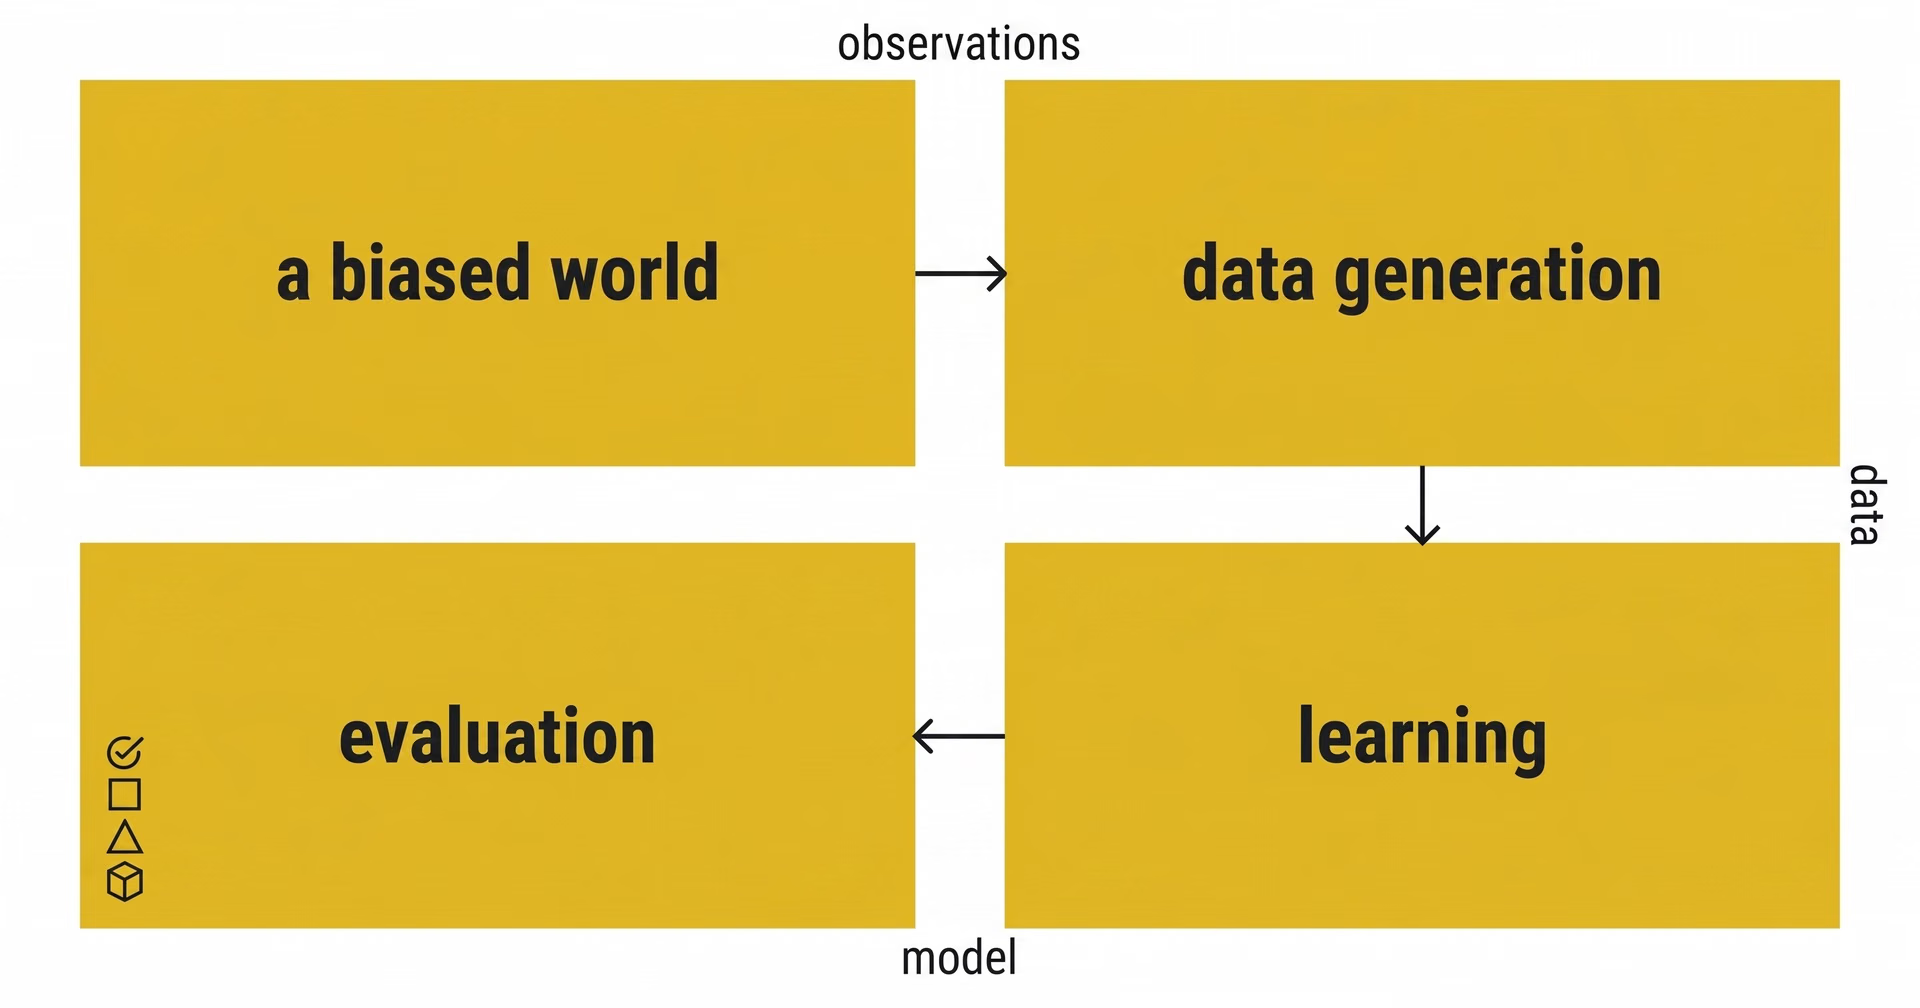
Abb. 3. Verzerrungen in Datenpipelines gehen auf Ungleichgewichte in der realen Welt zurück.
Kennzeichnungsverzerrungen können auch durch unklare Annotationsrichtlinien oder unterschiedliche Interpretationen derselben Daten entstehen. Gut dokumentierte Kennzeichnungsstandards und Qualitätskontrollen können diese Herausforderungen deutlich verringern.
Fortlaufende Schulungen für Annotatoren und konsensbasierte Kennzeichnungen, bei denen mehrere Annotatoren jede Stichprobe prüfen, sind zwei wirksame Strategien, um Kennzeichnungsverzerrungen zu minimieren und die Qualität des Datensatzes zu verbessern.
Repräsentationsverzerrung#
Eine Repräsentationsverzerrung spiegelt häufig umfassendere gesellschaftliche Ungleichheiten wider. In wohlhabenderen oder besser vernetzten Regionen erhobene Daten erfassen möglicherweise nicht die Vielfalt weniger repräsentierter Bevölkerungsgruppen oder Umgebungen. Um dieser Verzerrung entgegenzuwirken, müssen übersehene Gruppen und Kontexte gezielt einbezogen werden.
Eine Repräsentationsverzerrung entsteht, wenn bestimmte Gruppen oder Klassen im Datensatz unterrepräsentiert sind. Dazu können demografische Gruppen, Objektkategorien oder Umgebungsbedingungen gehören. Sieht ein Modell nur einen Hautton, eine Objektart oder einen Hintergrundstil, spiegeln seine Vorhersagen dieses Ungleichgewicht wider.
Diese Art von Verzerrung ist erkennbar, wenn bestimmte Gruppen oder Kategorien in deutlich geringerer Zahl vertreten sind als andere. Dadurch können die Vorhersagen des Modells zugunsten der vorherrschenden Beispiele im Datensatz verschoben werden. Ein Gesichtserkennungsmodell, das hauptsächlich mit Daten einer demografischen Gruppe trainiert wurde, könnte beispielsweise Schwierigkeiten haben, für alle Nutzer genaue Ergebnisse zu liefern. Anders als die Auswahlverzerrung, die mit der Vielfalt der Daten zusammenhängt, betrifft die Repräsentationsverzerrung das Gleichgewicht zwischen Gruppen.
Diversitätsprüfungen und gezielte Strategien zur Erweiterung der Daten können dazu beitragen, dass alle relevanten demografischen Gruppen und Kategorien im gesamten Trainingsdatensatz angemessen vertreten sind.
Verzerrungen in Datensätzen erkennen und verringern#
Beim Einsatz in der realen Welt bedeuten Verzerrungen in der KI nicht nur einige wenige falsche Vorhersagen. Sie können dazu führen, dass Systeme für manche Menschen gut funktionieren, aber nicht für alle.
Bei KI-Anwendungen im Automobilbereich können Erkennungsmodelle bei verschiedenen Fußgängergruppen uneinheitliche Ergebnisse liefern und dadurch die Sicherheit unterrepräsentierter Personen beeinträchtigen. Das Problem liegt nicht in der Absicht des Modells, sondern in den visuellen Eingaben, mit denen es trainiert wurde. Auch in der Landwirtschaft kann eine Verzerrung bei der Objekterkennung dazu führen, dass Nutzpflanzen bei unterschiedlichen Licht- oder Wetterbedingungen schlecht erkannt werden. Dies sind typische Folgen des Trainings mit begrenzten oder unausgewogenen Datensätzen.
Verzerrungen in der KI beheben beginnt damit, zu wissen, wo man suchen muss. Fehlen deinem Trainingsdatensatz wichtige Beispiele oder bildet er nur einen engen Bereich übermäßig stark ab, spiegelt dein Modell diese Lücken wider. Deshalb ist das Erkennen von Verzerrungen in der KI ein entscheidender Schritt in jeder Entwicklungspipeline.
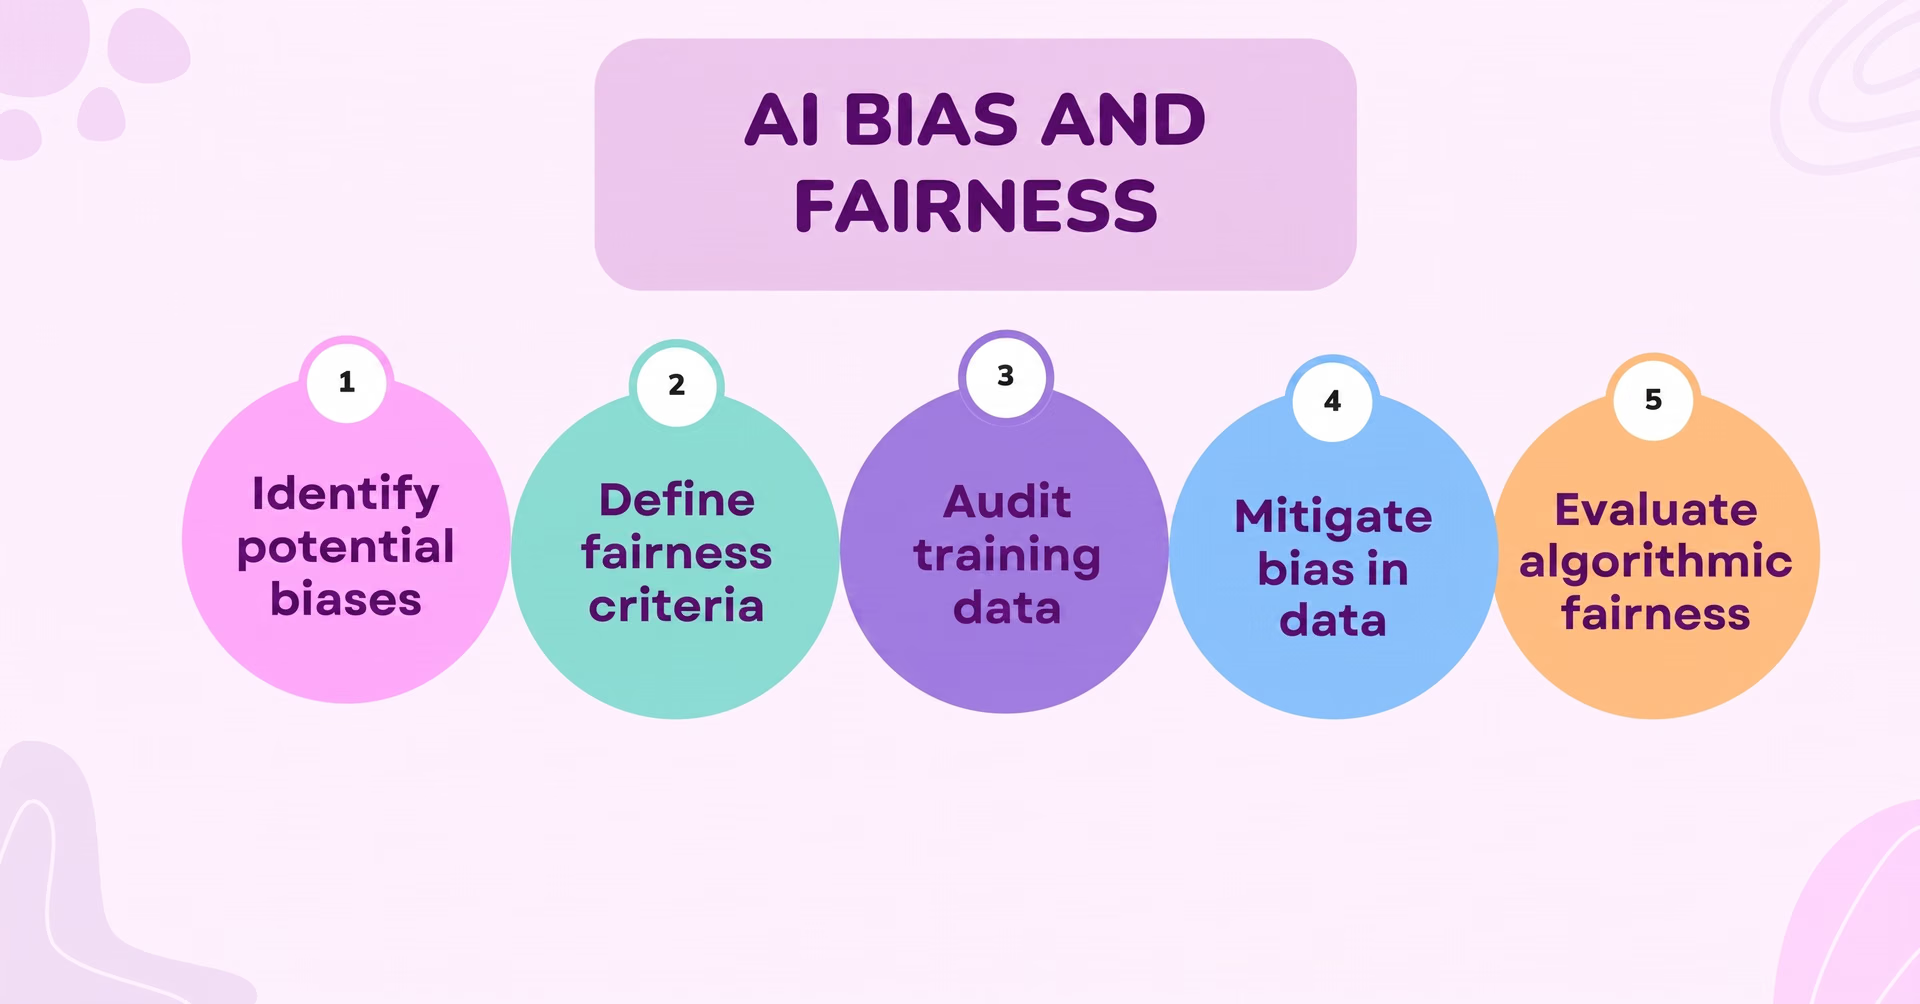
Abb. 4. Wichtige Schritte zum Verringern von Verzerrungen in der KI und zur Verbesserung der Fairness.
Beginne mit der Analyse deines Datensatzes. Untersuche die Verteilung über Klassen, Umgebungen, Lichtverhältnisse, Objektgrößen und demografische Gruppen hinweg. Dominiert eine Kategorie, wird dein Modell bei den anderen wahrscheinlich schlechter abschneiden.
Untersuche als Nächstes die Leistung. Schneidet das Modell in bestimmten Umgebungen oder bei bestimmten Objekttypen schlechter ab? Das weist auf erlernte Verzerrungen hin und lässt sich meist auf die Daten zurückführen.
Die Auswertung einzelner Teilgruppen ist entscheidend. Ein Modell kann eine durchschnittliche Genauigkeit von 90 % melden, bei einer bestimmten Gruppe oder Bedingung aber nur 60 % erreichen. Ohne diese Teilgruppen zu überprüfen, würdest du das nie erfahren.
Der Einsatz von Fairness-Metriken beim Training und bei der Auswertung ist ein weiteres leistungsstarkes Werkzeug. Diese Metriken gehen über herkömmliche Genauigkeitswerte hinaus und bewerten das Verhalten des Modells in verschiedenen Teilmengen der Daten. Sie helfen, blinde Flecken aufzudecken, die sonst möglicherweise unbemerkt blieben.
Transparenz bei der Zusammensetzung von Datensätzen und beim Testen von Modellen führt zu besseren Modellen.
Fairness durch vielfältige Daten und Augmentierung verbessern#
Nachdem du Verzerrungen erkannt hast, besteht der nächste Schritt darin, die Lücken zu schließen. Eine der wirksamsten Möglichkeiten dafür ist, die Datenvielfalt in KI-Modellen zu erhöhen. Das bedeutet, mehr Stichproben aus unterrepräsentierten Szenarien zu sammeln – etwa medizinische Bilder aus unterschiedlichen Bevölkerungsgruppen oder Aufnahmen ungewöhnlicher Umgebungsbedingungen.
Mehr Daten können wertvoll sein, vor allem, wenn dadurch die Vielfalt zunimmt. Um die Fairness zu verbessern, müssen jedoch auch die richtigen Arten von Beispielen gesammelt werden. Diese sollten die Variationen in der realen Welt widerspiegeln, mit denen dein Modell wahrscheinlich konfrontiert wird.
Datenaugmentierung ist eine weitere nützliche Strategie. Spiegeln, Drehen, Anpassen der Beleuchtung und Skalieren von Objekten können helfen, unterschiedliche Bedingungen der realen Welt zu simulieren. Augmentierung erhöht nicht nur die Vielfalt des Datensatzes, sondern macht das Modell auch robuster gegenüber Veränderungen des Erscheinungsbilds, der Beleuchtung und des Kontexts.
Die meisten modernen Trainingspipelines umfassen standardmäßig Augmentierung. Wirksam für mehr Fairness wird sie jedoch erst durch einen gezielten Einsatz, beispielsweise durch Anpassungen an die jeweiligen Aufgabenanforderungen.
Lücken mit synthetischen Daten schließen#
Synthetische Daten sind künstlich erzeugte Daten, die Beispiele aus der realen Welt nachahmen. Sie können hilfreich sein, wenn bestimmte Szenarien zu selten oder zu sensibel sind, um sie in der Praxis aufzunehmen.
Wenn du beispielsweise ein Modell zur Erkennung seltener Maschinenfehler oder seltener Verkehrsverstöße entwickelst, kannst du solche Fälle mithilfe synthetischer Daten simulieren. So kann dein Modell Ereignisse kennenlernen, denen es im Trainingsdatensatz möglicherweise nur selten begegnet.
Studien haben gezeigt, dass die Einbeziehung gezielt ausgewählter synthetischer Daten in das Training Verzerrungen in Datensätzen verringern und die Leistung über verschiedene demografische Gruppen und Umgebungen hinweg verbessern kann.
Synthetische Daten funktionieren am besten in Kombination mit realen Stichproben. Sie ergänzen deinen Datensatz, ersetzen ihn aber nicht.
Wie Ultralytics YOLO11 ethische KI unterstützt#
Die Entwicklung unverzerrter KI-Modelle hängt auch von den verwendeten Werkzeugen ab. Ultralytics YOLO11 ist flexibel, lässt sich leicht feinabstimmen und vielseitig anpassen – dadurch eignet es sich gut, um Verzerrungen in Datensätzen zu verringern.
Ultralytics YOLO11 unterstützt fortschrittliche Datenaugmentierungstechniken beim Training des Modells. Dabei kommen vielfältige Bildkontexte und gemischte Beispiele zum Einsatz, um die Generalisierung des Modells zu verbessern und Überanpassung zu verringern.
Ultralytics YOLO11 bietet außerdem eine verbesserte Backbone- und Neck-Architektur für eine effektivere Merkmalsextraktion. Diese Weiterentwicklung verbessert die Fähigkeit des Modells, feine Details zu erkennen – ein entscheidender Vorteil in unterrepräsentierten oder seltenen Szenarien, in denen herkömmliche Modelle Schwierigkeiten haben können.
Da sich Ultralytics YOLO11 einfach neu trainieren und in Edge- sowie Cloud-Umgebungen bereitstellen lässt, können Teams Leistungslücken erkennen und das Modell schnell aktualisieren, wenn Verzerrungen im praktischen Einsatz festgestellt werden.
Faire KI ist kein einmaliges Ziel. Sie erfordert einen fortlaufenden Kreislauf aus Bewertung, Lernen und Anpassung. Werkzeuge wie Ultralytics YOLO11 machen diesen Kreislauf schneller und produktiver.
Die wichtigsten Erkenntnisse#
Verzerrungen in der KI wirken sich auf alles aus – von Fairness bis Leistung. Verzerrungen in der Computer Vision entstehen häufig dadurch, wie Datensätze erfasst, gekennzeichnet und ausgewogen zusammengestellt werden. Zum Glück gibt es bewährte Möglichkeiten, sie zu erkennen und zu verringern.
Beginne mit einer Prüfung deiner Daten und teste die Modellleistung in verschiedenen Szenarien. Nutze gezielte Datenerfassung, Augmentierung und synthetische Daten, um eine bessere Abdeckung beim Training zu erreichen.
Ultralytics YOLO11 unterstützt diesen Arbeitsablauf, indem es das Training benutzerdefinierter Modelle, den Einsatz leistungsstarker Augmentierungstechniken und eine schnelle Reaktion auf erkannte Verzerrungen erleichtert.
Faire KI zu entwickeln ist nicht nur das Richtige. So entstehen auch intelligentere und zuverlässigere Systeme.
Werde Teil unserer wachsenden Community! Weitere Informationen zu KI findest du in unserem GitHub-Repository. Möchtest du eigene Projekte im Bereich Computer Vision starten? Sieh dir unsere Lizenzoptionen an. Entdecke KI in der Fertigung und visuelle KI in der Landwirtschaft auf unseren Lösungsseiten!









