Alla scoperta del rilevamento di oggetti piccoli con Ultralytics YOLO11
Scopri come Ultralytics YOLO11 rileva oggetti piccoli in modo rapido e accurato in applicazioni reali come la sorveglianza e la robotica.
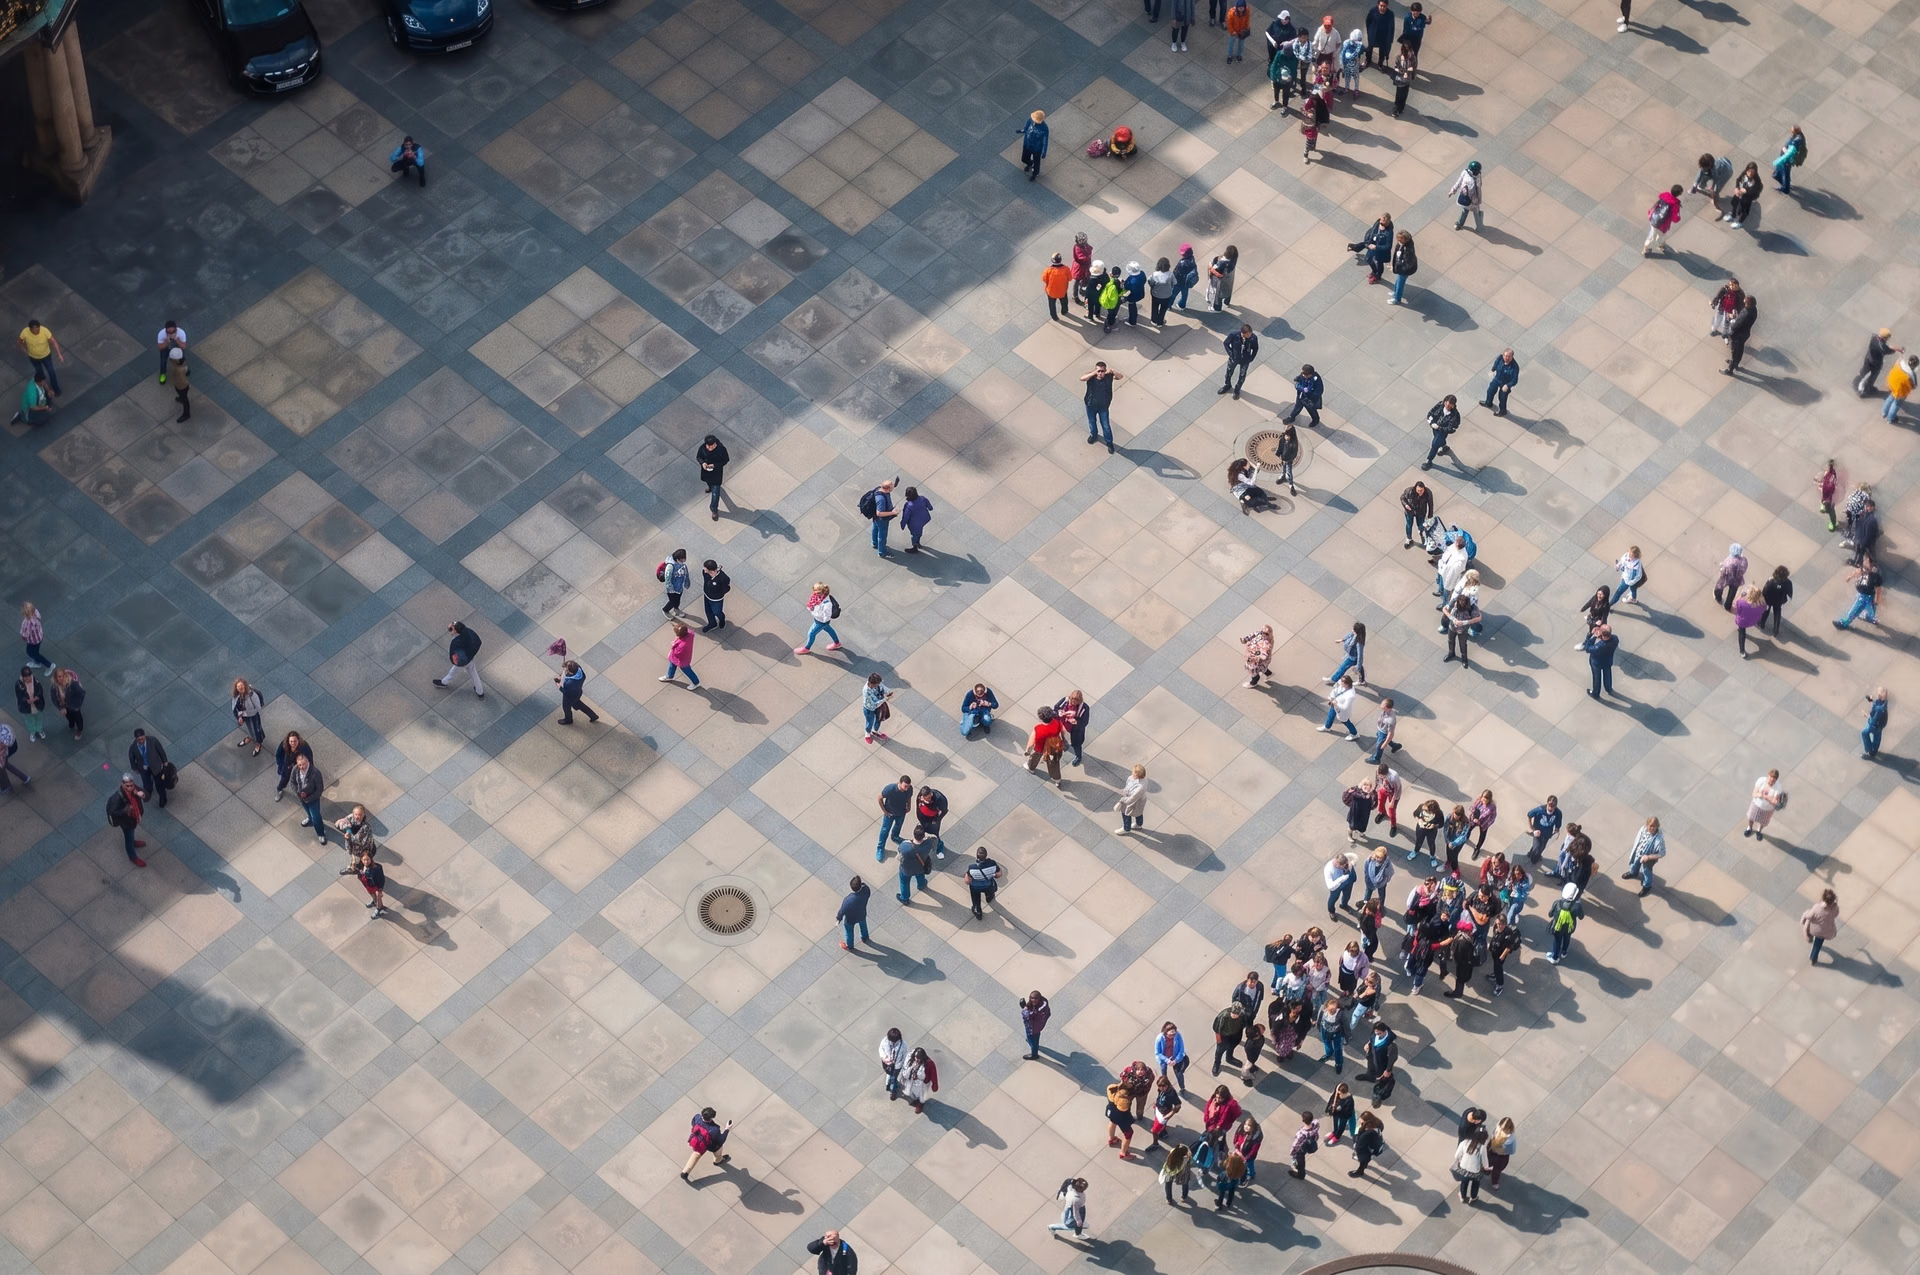
I droni integrati con l’IA visiva possono volare a centinaia di metri dal suolo e devono comunque riuscire a rilevare una persona che nel flusso video appare grande appena pochi pixel. Si tratta infatti di una sfida comune in applicazioni come la robotica, la sorveglianza e il telerilevamento, in cui i sistemi devono identificare oggetti molto piccoli all’interno di un’immagine.
Tuttavia, i modelli tradizionali di rilevamento degli oggetti possono avere difficoltà a farlo. Gli oggetti piccoli in immagini e video forniscono informazioni visive molto limitate. In parole semplici, quando un modello li osserva, ha pochi dettagli da cui apprendere o che può riconoscere.
Questi modelli si basano in genere su un’architettura basata su una rete neurale convoluzionale (CNN). Le immagini attraversano gli strati della rete e vengono trasformate in mappe di caratteristiche o rappresentazioni semplificate che mettono in evidenza gli schemi rilevanti invece dei pixel grezzi.
Man mano che l’immagine avanza nella rete, le mappe di caratteristiche diventano più piccole. Questo rende il calcolo più veloce, ma significa anche che i dettagli più fini possono scomparire.
Per gli oggetti minuscoli, questi dettagli sono fondamentali. Quando scompaiono, un modello di visione artificiale può avere difficoltà a rilevare l’oggetto, con il rischio di produrre riquadri di delimitazione meno precisi o incoerenti.
I sistemi di visione artificiale end-to-end in tempo reale rendono il problema ancora più complesso. Le immagini ad alta risoluzione aiutano a preservare i dettagli, ma rallentano l’inferenza e richiedono più potenza GPU. Le risoluzioni inferiori sono più veloci, ma rendono ancora più difficile rilevare gli oggetti piccoli.
È un continuo compromesso tra velocità, precisione e limiti hardware. Grazie ai recenti progressi tecnologici, modelli di visione artificiale come Ultralytics YOLO11 e il prossimo Ultralytics YOLO26 sono progettati per gestire questo compromesso in modo più efficace.
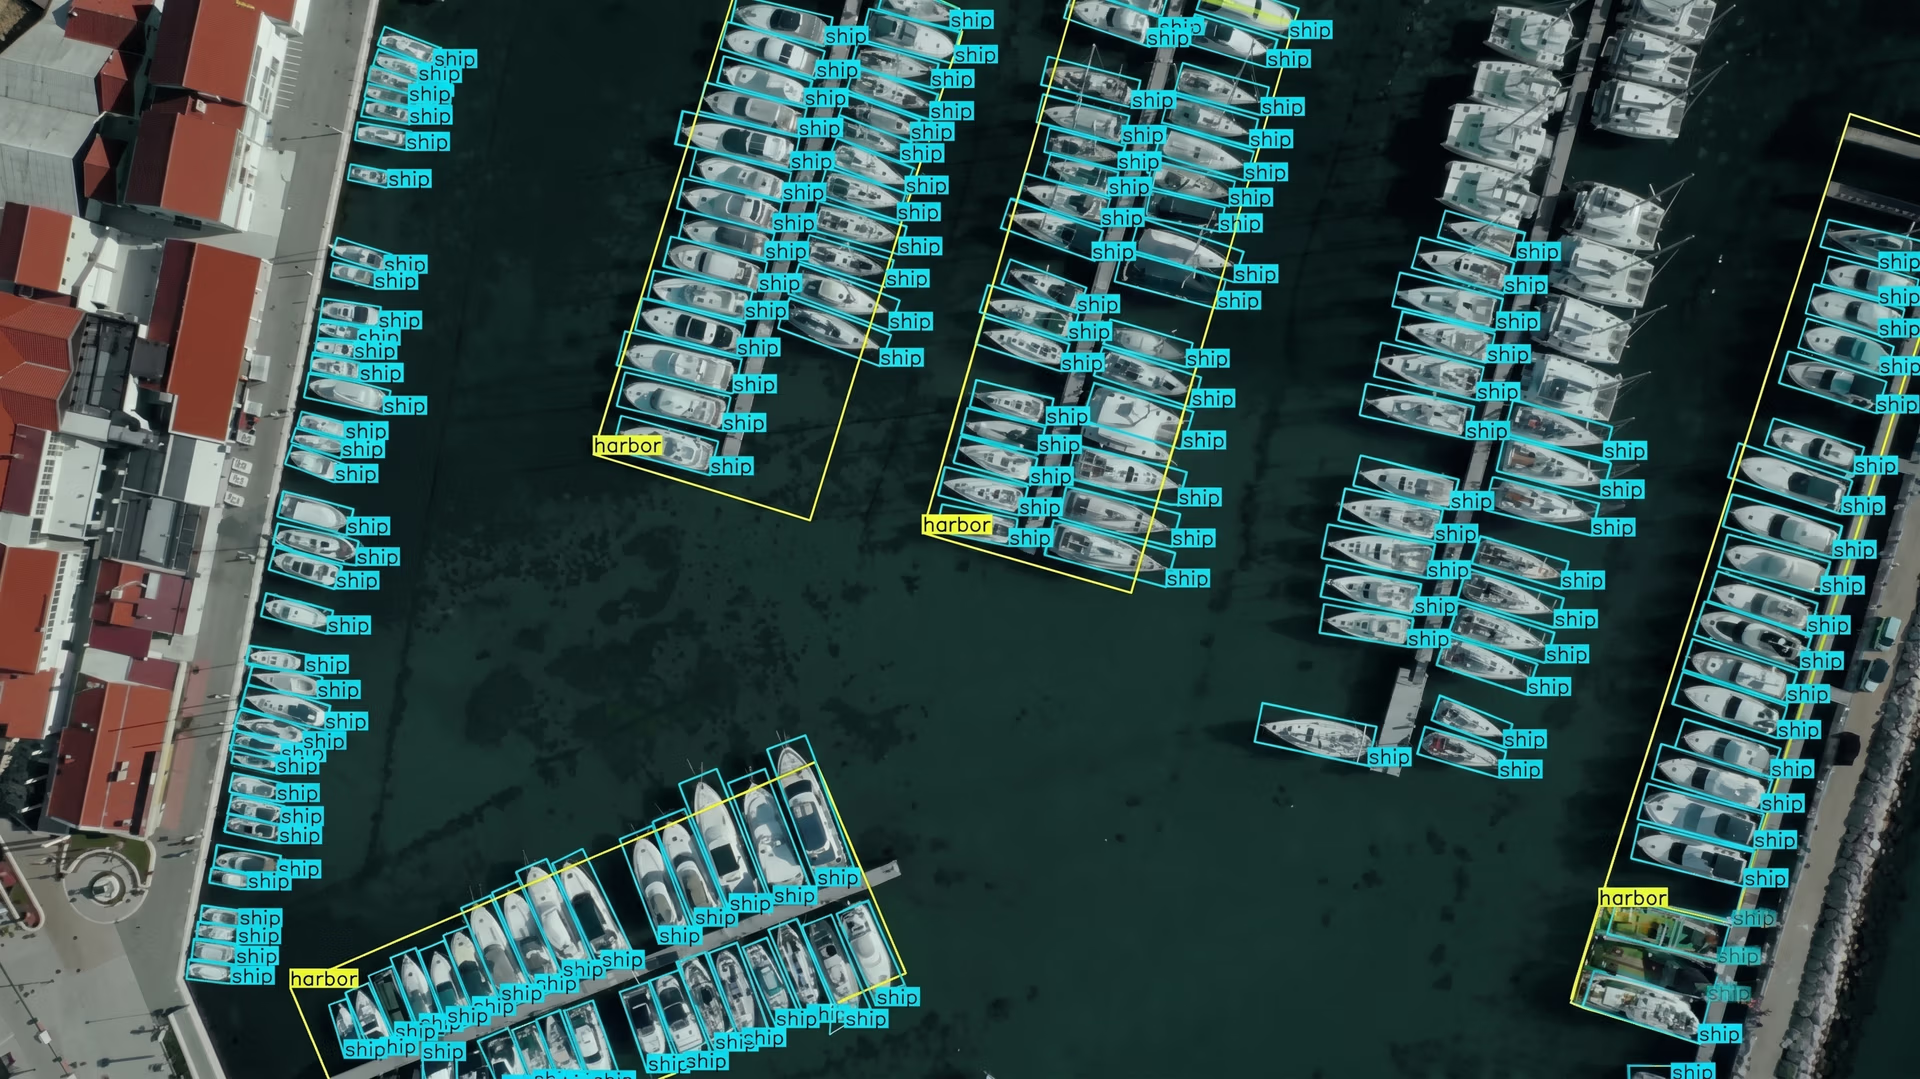
Fig. 1. Uso di YOLO11 per rilevare oggetti piccoli in immagini aeree (Fonte)
In questo articolo vedremo perché il rilevamento degli oggetti piccoli è difficile e come Ultralytics YOLO11 può semplificarlo. Iniziamo!
Che cos’è il rilevamento degli oggetti piccoli e perché è importante?#
Il rilevamento degli oggetti piccoli è un’attività di visione artificiale, un ramo dell’IA, che si concentra sull’identificazione e la localizzazione di oggetti che occupano una porzione molto ridotta di un’immagine. Questi oggetti sono spesso rappresentati nell’immagine da un numero limitato di pixel, le unità più piccole di un’immagine digitale. Per questo sono più difficili da rilevare rispetto a elementi più grandi e nitidi (che spesso contengono più pixel).
Per esempio, i veicoli nelle immagini aeree, gli utensili sul pavimento di una fabbrica o le persone riprese da telecamere di sorveglianza grandangolari possono apparire tutti come oggetti piccoli nell’immagine. Rilevarli è importante perché spesso veicolano informazioni critiche e molte applicazioni del mondo reale, come la sorveglianza, dipendono da questi rilevamenti per funzionare correttamente.
Quando gli oggetti piccoli non vengono rilevati, le prestazioni del sistema e il processo decisionale possono risentirne. Il monitoraggio dei veicoli aerei senza pilota (UAV) ne è un buon esempio: non rilevare un piccolo oggetto in movimento al suolo può compromettere la precisione della navigazione o del tracciamento.
Le sfide legate al rilevamento degli oggetti piccoli#
I primi sistemi utilizzavano caratteristiche progettate manualmente e metodi tradizionali di visione artificiale, che incontravano difficoltà nelle scene affollate o variegate. Ancora oggi, nonostante le prestazioni nettamente superiori dei modelli di deep learning, rilevare elementi piccoli è difficile quando occupano solo una minuscola parte dell’immagine.
Vediamo ora alcune delle sfide più comuni che si presentano nel rilevamento degli oggetti piccoli in diversi scenari reali.
Dimensioni, pixel e perdita di informazioni#
Gli oggetti piccoli contengono pochissimi pixel, il che limita la quantità di dettagli visivi che un modello può apprendere in fasi come l’estrazione delle caratteristiche. Di conseguenza, è più difficile rilevare schemi come bordi, forme e texture, e gli oggetti piccoli tendono maggiormente a confondersi con lo sfondo.
Man mano che le immagini attraversano gli strati convoluzionali di una rete neurale, le informazioni visive contenute nei pixel vengono gradualmente compresse in mappe di caratteristiche. Questo aiuta il modello a mantenere l’efficienza, ma comporta anche la graduale scomparsa dei dettagli più fini.
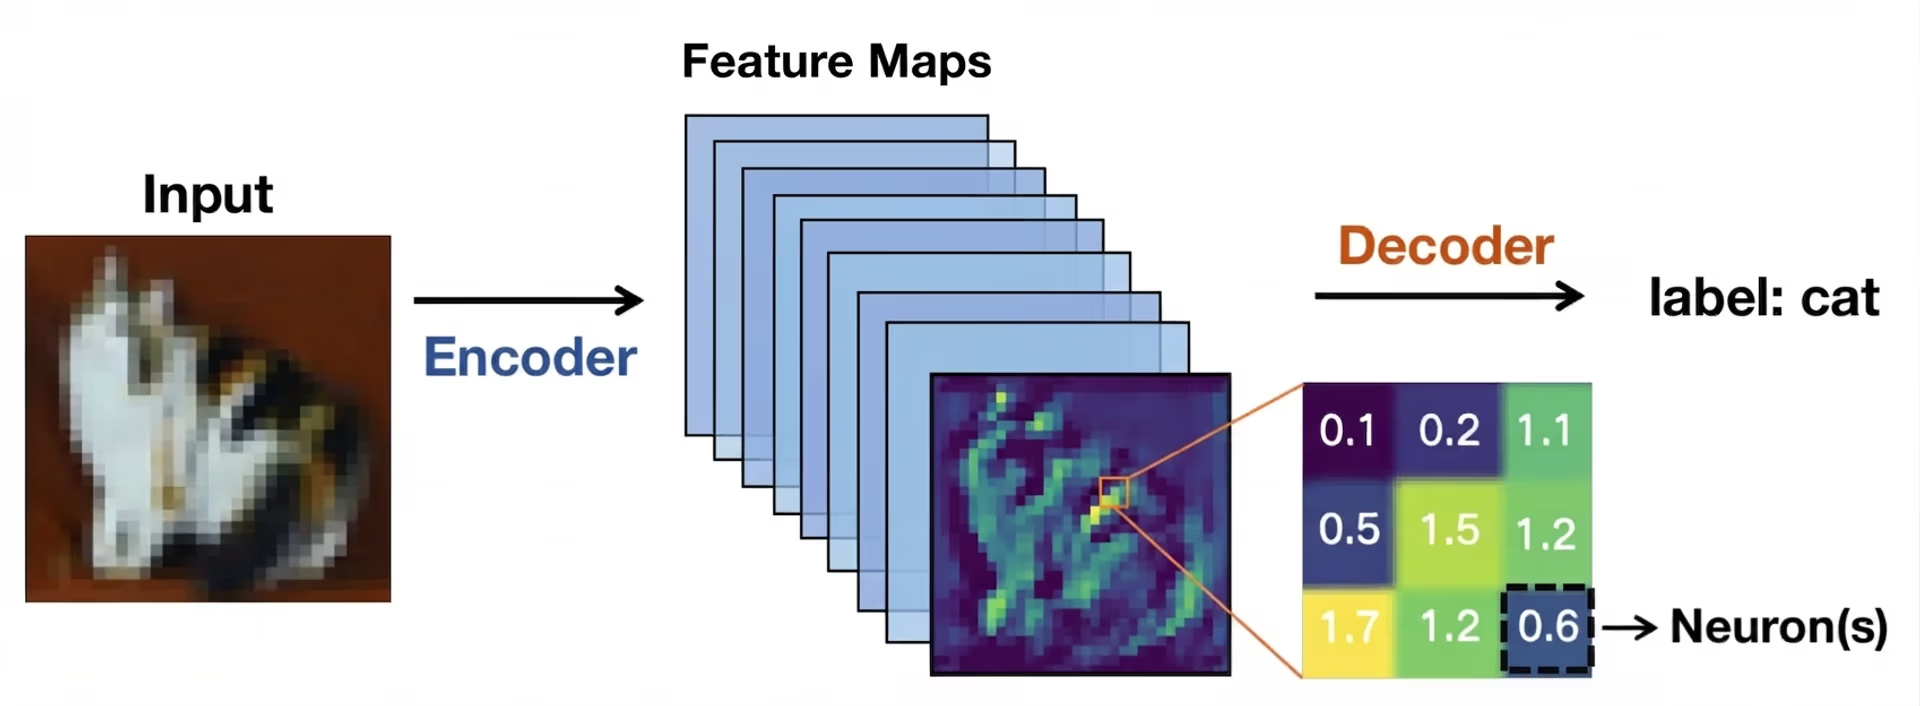
Fig. 2. Le mappe di caratteristiche rappresentano schemi visivi in un’immagine (Fonte)
Per gli elementi piccoli, gli indizi importanti possono scomparire prima che la rete di rilevamento abbia la possibilità di intervenire. In questi casi, la localizzazione diventa meno affidabile e i riquadri di delimitazione possono spostarsi, sovrapporsi o non individuare affatto gli oggetti di destinazione.
Occlusione, variazione di scala e contesto#
Le difficoltà legate alle dimensioni sono spesso aggravate anche dall’occlusione. L’occlusione si verifica quando gli oggetti, soprattutto quelli più piccoli, vengono parzialmente nascosti da altri elementi della scena.
Questo riduce l’area visibile di un elemento di destinazione e limita le informazioni disponibili per il rilevatore di oggetti. Anche una piccola occlusione può confondere le reti di rilevamento, soprattutto se combinata con un input a bassa risoluzione. Un esempio interessante si trova nei dataset UAV come VisDrone, in cui pedoni, biciclette o veicoli possono essere parzialmente nascosti da edifici, alberi o altri oggetti in movimento.
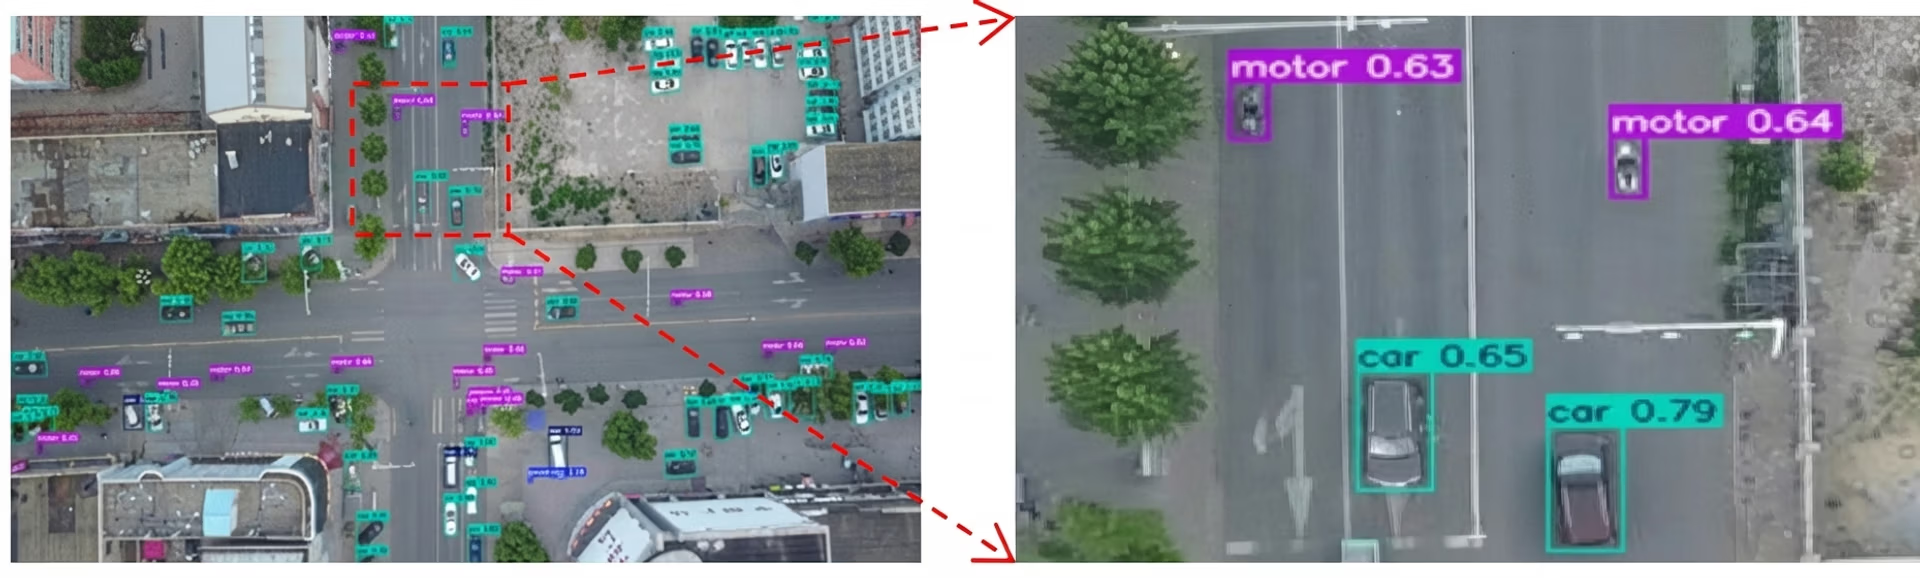
Fig. 3. Un esempio dal dataset VisDrone che mostra oggetti piccoli (Fonte)
Allo stesso modo, la variazione di scala introduce un’ulteriore difficoltà: lo stesso oggetto può apparire molto piccolo o relativamente grande a seconda della distanza e della posizione della videocamera. Nonostante queste difficoltà, gli algoritmi di rilevamento devono riconoscere gli oggetti piccoli a scale diverse senza perdere precisione.
Anche il contesto svolge un ruolo importante nel rilevamento. Per esempio, gli oggetti grandi sono solitamente circondati da elementi ben visibili che forniscono utili indizi visivi. Gli elementi piccoli, invece, spesso sono privi di queste informazioni contestuali, rendendo più difficile il riconoscimento degli schemi.
Il problema della metrica nascosta nel rilevamento degli oggetti piccoli#
Le metriche di valutazione comuni, come intersezione su unione (IoU), misurano quanto un riquadro di delimitazione previsto si sovrappone al riquadro di riferimento. Sebbene IoU funzioni bene con gli oggetti più grandi, il suo comportamento è piuttosto diverso con quelli piccoli.
Gli oggetti piccoli occupano solo pochi pixel, quindi anche un lieve spostamento del riquadro previsto può produrre un errore proporzionale elevato e ridurre drasticamente il punteggio IoU. Ciò significa che spesso gli oggetti piccoli non raggiungono la soglia IoU standard usata per considerare corretta una previsione, anche quando sono visibili nell’immagine.
Di conseguenza, è più probabile che gli errori di localizzazione vengano classificati come falsi positivi o falsi negativi. Questi limiti hanno spinto i ricercatori a ripensare il modo in cui i sistemi di rilevamento degli oggetti valutano e gestiscono gli elementi piccoli e difficili da rilevare.
Caratteristiche multiscala: la chiave per il rilevamento in tempo reale degli oggetti piccoli#
Nel tentativo di migliorare il rilevamento degli oggetti piccoli, i ricercatori hanno capito che è essenziale preservare e rappresentare le informazioni visive a più scale. Questa idea trova riscontro nelle recenti ricerche su arXiv e negli articoli presentati in sedi come le conferenze internazionali IEEE e la Conferenza europea sulla visione artificiale (ECCV).
Man mano che le immagini avanzano in una rete neurale, gli oggetti piccoli possono perdere dettagli o scomparire del tutto: per questo i moderni modelli di visione artificiale come Ultralytics YOLO11 si concentrano in modo particolare sul miglioramento dell’estrazione delle caratteristiche. Vediamo ora i concetti fondamentali alla base delle mappe di caratteristiche e delle reti piramidali di caratteristiche per capirle meglio.
Mappe di caratteristiche e rappresentazione delle scale#
Quando un’immagine di input, per esempio un’immagine di telerilevamento, entra in una rete neurale, viene gradualmente trasformata in mappe di caratteristiche. Si tratta di rappresentazioni semplificate dell’immagine che mettono in evidenza schemi visivi come bordi, forme e texture.
Man mano che la rete procede in profondità, le dimensioni spaziali di queste mappe di caratteristiche si riducono. Questa riduzione permette al modello di funzionare in modo efficiente e di concentrarsi sulle informazioni di alto livello. Tuttavia, la riduzione delle dimensioni e la maggiore profondità delle mappe di caratteristiche diminuiscono anche i dettagli spaziali.
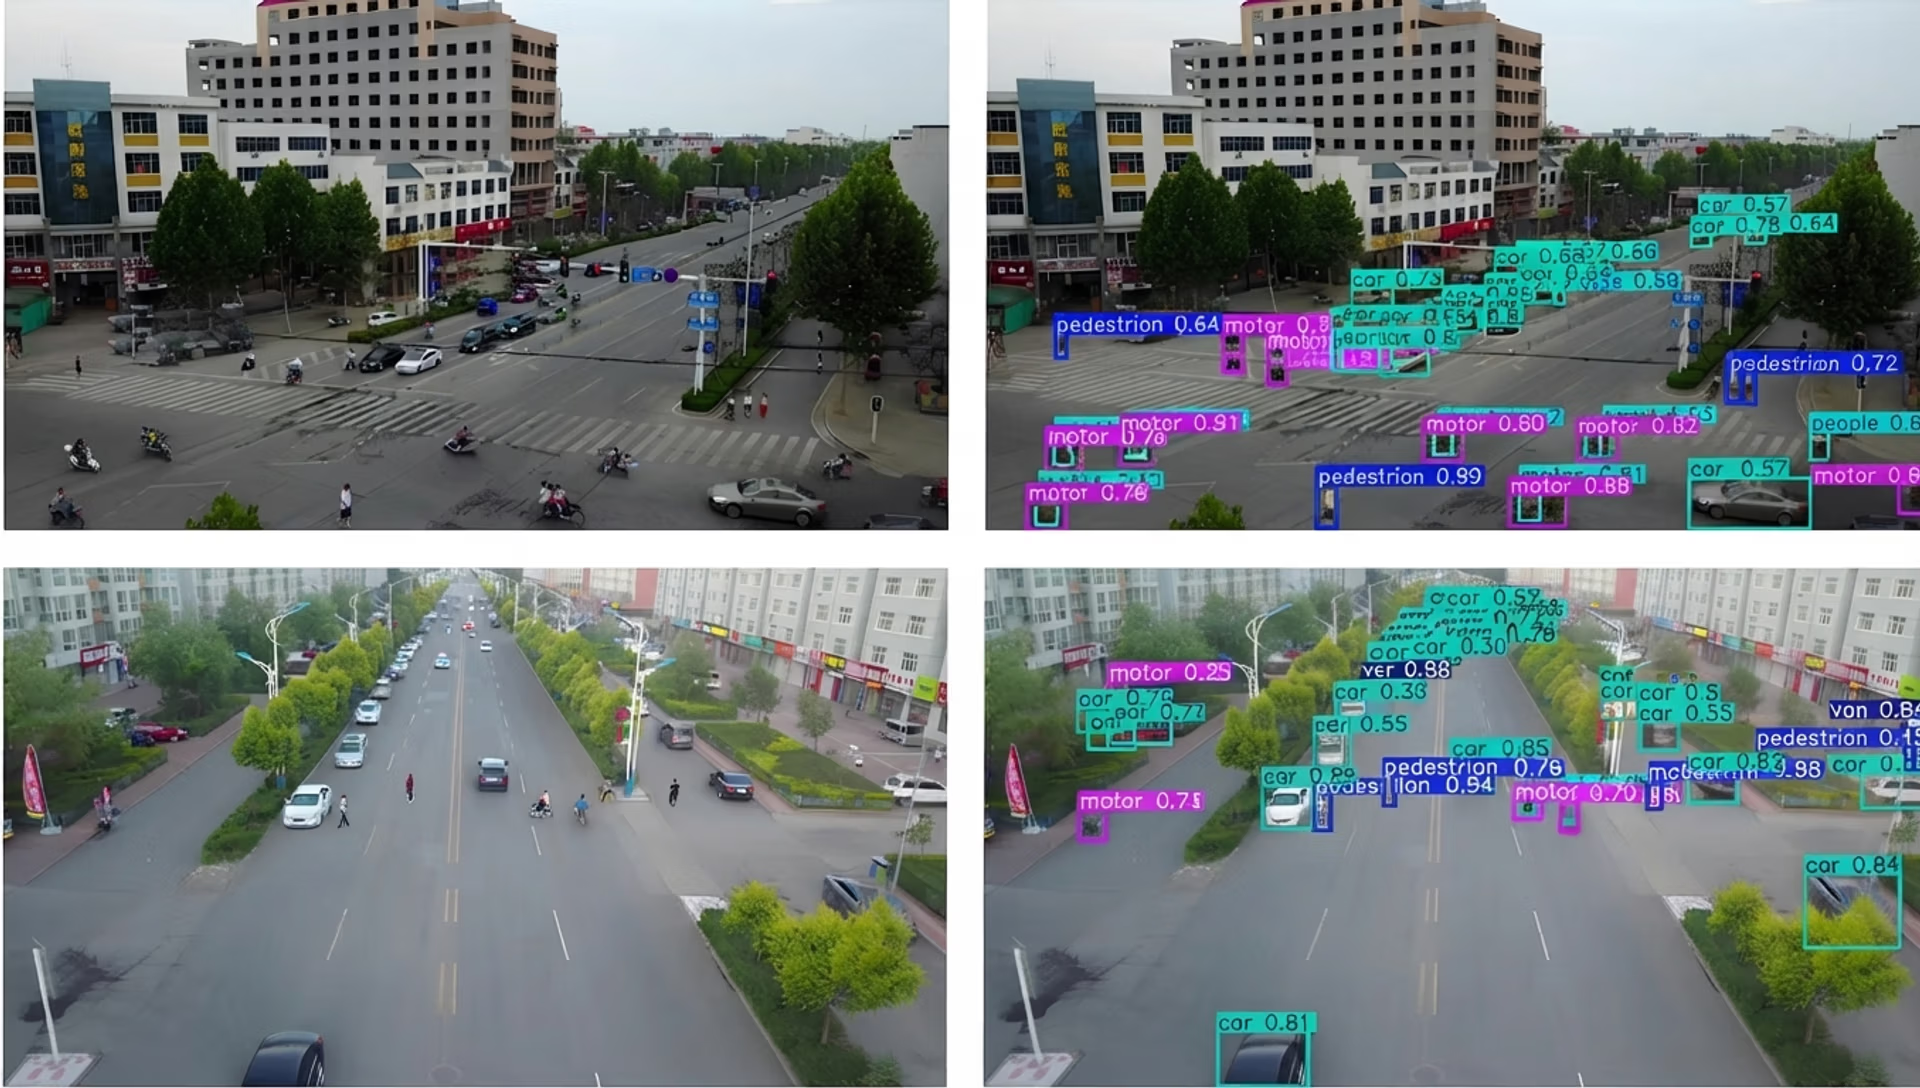
Fig. 4. L’estrazione delle caratteristiche è fondamentale per rilevare oggetti piccoli. (Fonte)
Gli oggetti grandi mantengono informazioni visive sufficienti per essere rilevati con precisione, mentre gli elementi piccoli possono perdere dettagli fondamentali dopo pochi strati della rete. In questi casi, il modello può avere difficoltà perfino a riconoscere che esiste un oggetto piccolo. Questo è uno dei motivi principali per cui gli oggetti piccoli sfuggono ai modelli profondi di rilevamento degli oggetti.
Reti piramidali di caratteristiche e apprendimento multiscala#
Le reti piramidali di caratteristiche, spesso chiamate FPN, sono state introdotte per affrontare la perdita di dettagli spaziali e fungono da modulo di supporto che combina informazioni provenienti da più strati, consentendo ai modelli di rilevare gli oggetti piccoli in modo più efficace. Questo processo è noto anche come aggregazione e fusione delle caratteristiche.
Gli strati superficiali forniscono dettagli spaziali fini, mentre quelli più profondi aggiungono contesto semantico, consentendo un efficace apprendimento delle caratteristiche multiscala. A differenza del semplice sovracampionamento, che si limita a ingrandire le mappe di caratteristiche, FPN preserva le informazioni significative e migliora il rilevamento degli oggetti piccoli.
Gli approcci moderni sviluppano questa idea usando la fusione adattiva delle caratteristiche e architetture sensibili al contesto per migliorare ulteriormente il rilevamento degli elementi piccoli. In altre parole, FPN aiuta i modelli a vedere contemporaneamente sia il quadro generale sia i dettagli minuscoli. Questa ottimizzazione è essenziale quando gli oggetti sono piccoli.
Come si sono evoluti i modelli di rilevamento degli oggetti per gestire gli oggetti piccoli#
Ecco una breve panoramica dell’evoluzione dei modelli di rilevamento degli oggetti e dei progressi compiuti nel tempo per rilevare meglio oggetti di dimensioni diverse, compresi quelli molto piccoli:
- Primi metodi di rilevamento: i primi approcci al rilevamento degli oggetti si basavano su caratteristiche progettate manualmente e algoritmi basati su regole, radicati nell’elaborazione classica delle immagini. Poiché queste caratteristiche erano fisse, le prestazioni peggioravano con immagini diverse.
- Introduzione del machine learning e del deep learning: l’adozione del machine learning e del deep learning ha segnato una svolta importante nella ricerca sul rilevamento degli oggetti. Invece di basarsi su regole predefinite, le reti neurali hanno appreso rappresentazioni visive direttamente dai dati di addestramento, migliorando l’adattabilità a oggetti di dimensioni e scene diverse.
- Reti convoluzionali: queste reti neurali imparano a riconoscere schemi nelle immagini. Ogni strato rileva dettagli diversi, partendo da bordi e colori semplici, passando per le forme e arrivando infine agli oggetti completi, il che le rende fondamentali per la visione artificiale moderna.
- Rilevatori di oggetti a due stadi: i rilevatori a due stadi, come Faster R-CNN, introdotto da Girshick e Ren, generavano prima le regioni candidate e poi le classificavano. Questo approccio migliorava la precisione sugli oggetti piccoli, ma aumentava il costo computazionale e riduceva le prestazioni in tempo reale.
- Rilevatori di oggetti a uno stadio: i rilevatori a uno stadio, come SSD (rilevatore a passaggio singolo) e la famiglia YOLO (lo vedi una sola volta), che comprende YOLOv3, Ultralytics YOLOv5 e il successivo Ultralytics YOLOv8, eseguono il rilevamento in un unico passaggio. Questa architettura migliora notevolmente la velocità di inferenza mantenendo una precisione competitiva.
- Modelli all’avanguardia più recenti: i nuovi modelli di rilevamento degli oggetti si concentrano maggiormente sulle prestazioni in tempo reale e sulla distribuzione edge. Le versioni recenti dei modelli Ultralytics YOLO, come Ultralytics YOLO11 e il prossimo Ultralytics YOLO26, sono progettate per bilanciare un’elevata precisione con un’inferenza a bassa latenza, risultando adatte a rilevare oggetti di tutte le dimensioni, compresi quelli piccoli, su dispositivi con capacità di calcolo limitate.
Uso di Ultralytics YOLO11 per i casi d’uso di rilevamento degli oggetti piccoli#
Ora che abbiamo capito meglio come funziona il rilevamento degli oggetti piccoli, vediamo alcune applicazioni reali in cui è possibile usare Ultralytics YOLO11.
UAV e immagini aeree#
Immagina un drone che vola molto in alto sopra una strada trafficata in città. Da quell’altezza, auto, biciclette e persino persone si riducono a pochi pixel sullo schermo.
I moduli UAV e per le immagini aeree acquisiscono spesso scene di questo tipo, in cui gli oggetti di interesse sono minuscoli e circondati da sfondi caotici, rendendo difficile il loro rilevamento da parte dei modelli di visione artificiale.
In scenari di questo tipo, Ultralytics YOLO11 può essere la scelta ideale. Per esempio, un drone dotato di un modello come YOLO11 potrebbe monitorare il traffico in tempo reale, rilevando veicoli, ciclisti e pedoni mentre si muovono nella scena, anche quando ciascun oggetto occupa solo una piccola porzione dell’immagine. Questo permette di prendere decisioni più rapidamente e ottenere informazioni più precise in applicazioni come la gestione del traffico, la sicurezza pubblica o la pianificazione urbana.
Robotica e automazione#
I robot vengono spesso impiegati in ambienti in cui precisione e tempistiche sono fondamentali. In contesti come magazzini, fabbriche e aziende agricole, un robot potrebbe dover riconoscere oggetti molto piccoli, come un componente su una linea di assemblaggio, un’etichetta su un pacco o una piccola gemma in un campo, e reagire rapidamente.
Il rilevamento di oggetti di queste dimensioni può essere complesso, soprattutto quando appaiono grandi appena pochi pixel nel flusso video della videocamera o sono parzialmente nascosti da altri oggetti. Trascurare questi piccoli dettagli può rallentare l’automazione o compromettere la capacità del robot di completare un’attività.
Ultralytics YOLO11 può fare la differenza in queste situazioni. La sua estrazione delle caratteristiche migliorata e la velocità di inferenza permettono ai robot di rilevare oggetti piccoli in tempo reale e di intervenire immediatamente.
Ultralytics YOLO11 supporta anche la segmentazione delle istanze, che può aiutare i robot a comprendere con maggiore precisione i contorni degli oggetti e i punti di presa, invece di limitarsi a localizzare riquadri di delimitazione generici. Per esempio, un braccio robotico integrato con YOLO11 potrebbe individuare piccoli componenti su un nastro trasportatore, segmentarne la forma esatta e prelevarli prima che escano dalla sua portata, aiutando il sistema a restare efficiente e affidabile.
Cosa rende Ultralytics YOLO11 efficace nel rilevamento degli oggetti piccoli#
Con così tanti modelli di visione artificiale disponibili oggi, potresti chiederti cosa distingue Ultralytics YOLO11.
Ecco alcuni motivi per cui Ultralytics YOLO11 è un’ottima scelta per le applicazioni che devono rilevare oggetti piccoli:
- Estrazione delle caratteristiche migliorata: YOLO11 usa un’architettura backbone e neck migliorata per potenziare l’estrazione delle caratteristiche e consentire un rilevamento degli oggetti più preciso.
- Ecosistema e facilità d’uso: il pacchetto Python di Ultralytics è una libreria che fornisce funzioni integrate per caricare, addestrare, convalidare e distribuire modelli come YOLO11. Poiché questi flussi di lavoro richiedono solo poche righe di codice, i team possono sperimentare e ottimizzare rapidamente i modelli per il rilevamento degli oggetti piccoli.
- Ottimizzato per la distribuzione edge: Ultralytics YOLO11 può funzionare in modo efficiente su dispositivi edge come NVIDIA Jetson, Raspberry Pi e sistemi di telecamere industriali. In parole semplici, consente di eseguire attività di IA visiva in tempo reale direttamente sul dispositivo.
Strategie pratiche per rilevare oggetti piccoli con Ultralytics YOLO11#
Oltre a usare un modello come Ultralytics YOLO11, il modo in cui prepari le annotazioni, il dataset complessivo e la procedura di addestramento del modello possono fare una differenza significativa nelle prestazioni di rilevamento.
Ecco una breve panoramica degli aspetti su cui concentrarsi:
- Aumento dei dati adeguato: un aumento dei dati leggero, come il ridimensionamento o il ritaglio, può aiutare il modello a generalizzare su nuove immagini. Tuttavia, un aumento su larga scala troppo aggressivo può distorcere o rimuovere gli oggetti piccoli, rendendoli più difficili da apprendere per il modello.
- Analisi dei casi di errore: analizzare i casi in cui il modello non rileva o identifica erroneamente gli oggetti aiuta a definire una baseline e a capire se i problemi dipendono dal dataset, dalla perdita di informazioni durante l’estrazione delle caratteristiche o dalla necessità di modificare le impostazioni di addestramento.
- Composizione del dataset: il tuo dataset dovrebbe contenere un numero sufficiente di esempi di oggetti piccoli, così che il modello possa apprendere schemi significativi, e dovrebbe restare bilanciato per evitare che gli oggetti più grandi mettano in ombra quelli più piccoli durante l’addestramento.
Punti chiave#
Il rilevamento degli oggetti piccoli è difficile perché gli elementi piccoli perdono dettagli man mano che le immagini attraversano un modello di visione artificiale. Ultralytics YOLO11 migliora la conservazione di questi dettagli, rendendo il rilevamento degli oggetti piccoli più affidabile senza sacrificare le prestazioni in tempo reale. Questo equilibrio consente a YOLO11 di supportare un rilevamento preciso ed efficiente nelle applicazioni del mondo reale.
Unisciti alla nostra community in crescita! Esplora il nostro repository GitHub per saperne di più sull’IA. Scopri innovazioni come la visione artificiale nel commercio al dettaglio e l’IA nel settore automobilistico visitando le nostre pagine dedicate alle soluzioni. Per iniziare oggi a sviluppare con la visione artificiale, dai un’occhiata alle nostre opzioni di licenza.









