Che cos’è Mask R-CNN e come funziona?
Scopri come funziona Mask R-CNN, dal backbone e dalla rete di proposte di regioni a ROI Align e alla predizione delle maschere, oltre agli utilizzi, ai limiti e ai successori di YOLO.
 Abirami Vina9 min di lettura
Innovazioni come i robot nei magazzini, le auto a guida autonoma che si muovono in sicurezza nel traffico, i droni che controllano le colture e i sistemi di IA che ispezionano i prodotti nelle fabbriche sono sempre più diffuse con la crescente adozione dell'IA. Una tecnologia fondamentale alla base di queste innovazioni è la visione artificiale, una branca dell'IA che consente alle macchine di comprendere e interpretare i dati visivi.
Per esempio, il rilevamento degli oggetti è un compito di visione artificiale che aiuta a identificare e localizzare gli oggetti nelle immagini usando riquadri di delimitazione. Questi riquadri forniscono informazioni utili, ma indicano soltanto in modo approssimativo la posizione di un oggetto e non ne catturano la forma o i contorni esatti. Per questo sono meno efficaci nelle applicazioni che richiedono un'identificazione precisa.
Per risolvere questo problema, i ricercatori hanno sviluppato modelli di segmentazione che catturano i contorni esatti degli oggetti e forniscono dettagli a livello di pixel per un rilevamento e un'analisi più accurati.
Mask R-CNN è uno di questi modelli. Presentato nel 2017 da Facebook AI Research (FAIR), si basa su modelli precedenti come R-CNN, Fast R-CNN e Faster R-CNN. Tappa importante nella storia della visione artificiale, Mask R-CNN ha aperto la strada a modelli più avanzati, come Ultralytics YOLO11.
In questo articolo vedremo cos'è Mask R-CNN, come funziona, quali sono le sue applicazioni e quali miglioramenti sono stati introdotti in seguito, fino ad arrivare a Ultralytics YOLO11.
Panoramica di Mask R-CNN#
Mask R-CNN, acronimo di rete neurale convoluzionale basata su regioni con maschere, è un modello di deep learning progettato per attività di visione artificiale come il rilevamento degli oggetti e la segmentazione di istanze.
La segmentazione di istanze va oltre il rilevamento tradizionale degli oggetti: non si limita a identificare gli oggetti in un'immagine, ma delinea con accuratezza ciascuno di essi. Assegna un'etichetta univoca a ogni oggetto rilevato e ne cattura la forma esatta a livello di pixel. Questo approccio dettagliato consente di distinguere chiaramente gli oggetti sovrapposti e di gestire con accuratezza le forme complesse.
Mask R-CNN si basa su Faster R-CNN, che rileva ed etichetta gli oggetti ma non ne definisce la forma esatta. Mask R-CNN migliora questo approccio identificando i pixel esatti che compongono ciascun oggetto e consentendo un'analisi delle immagini molto più dettagliata e accurata.
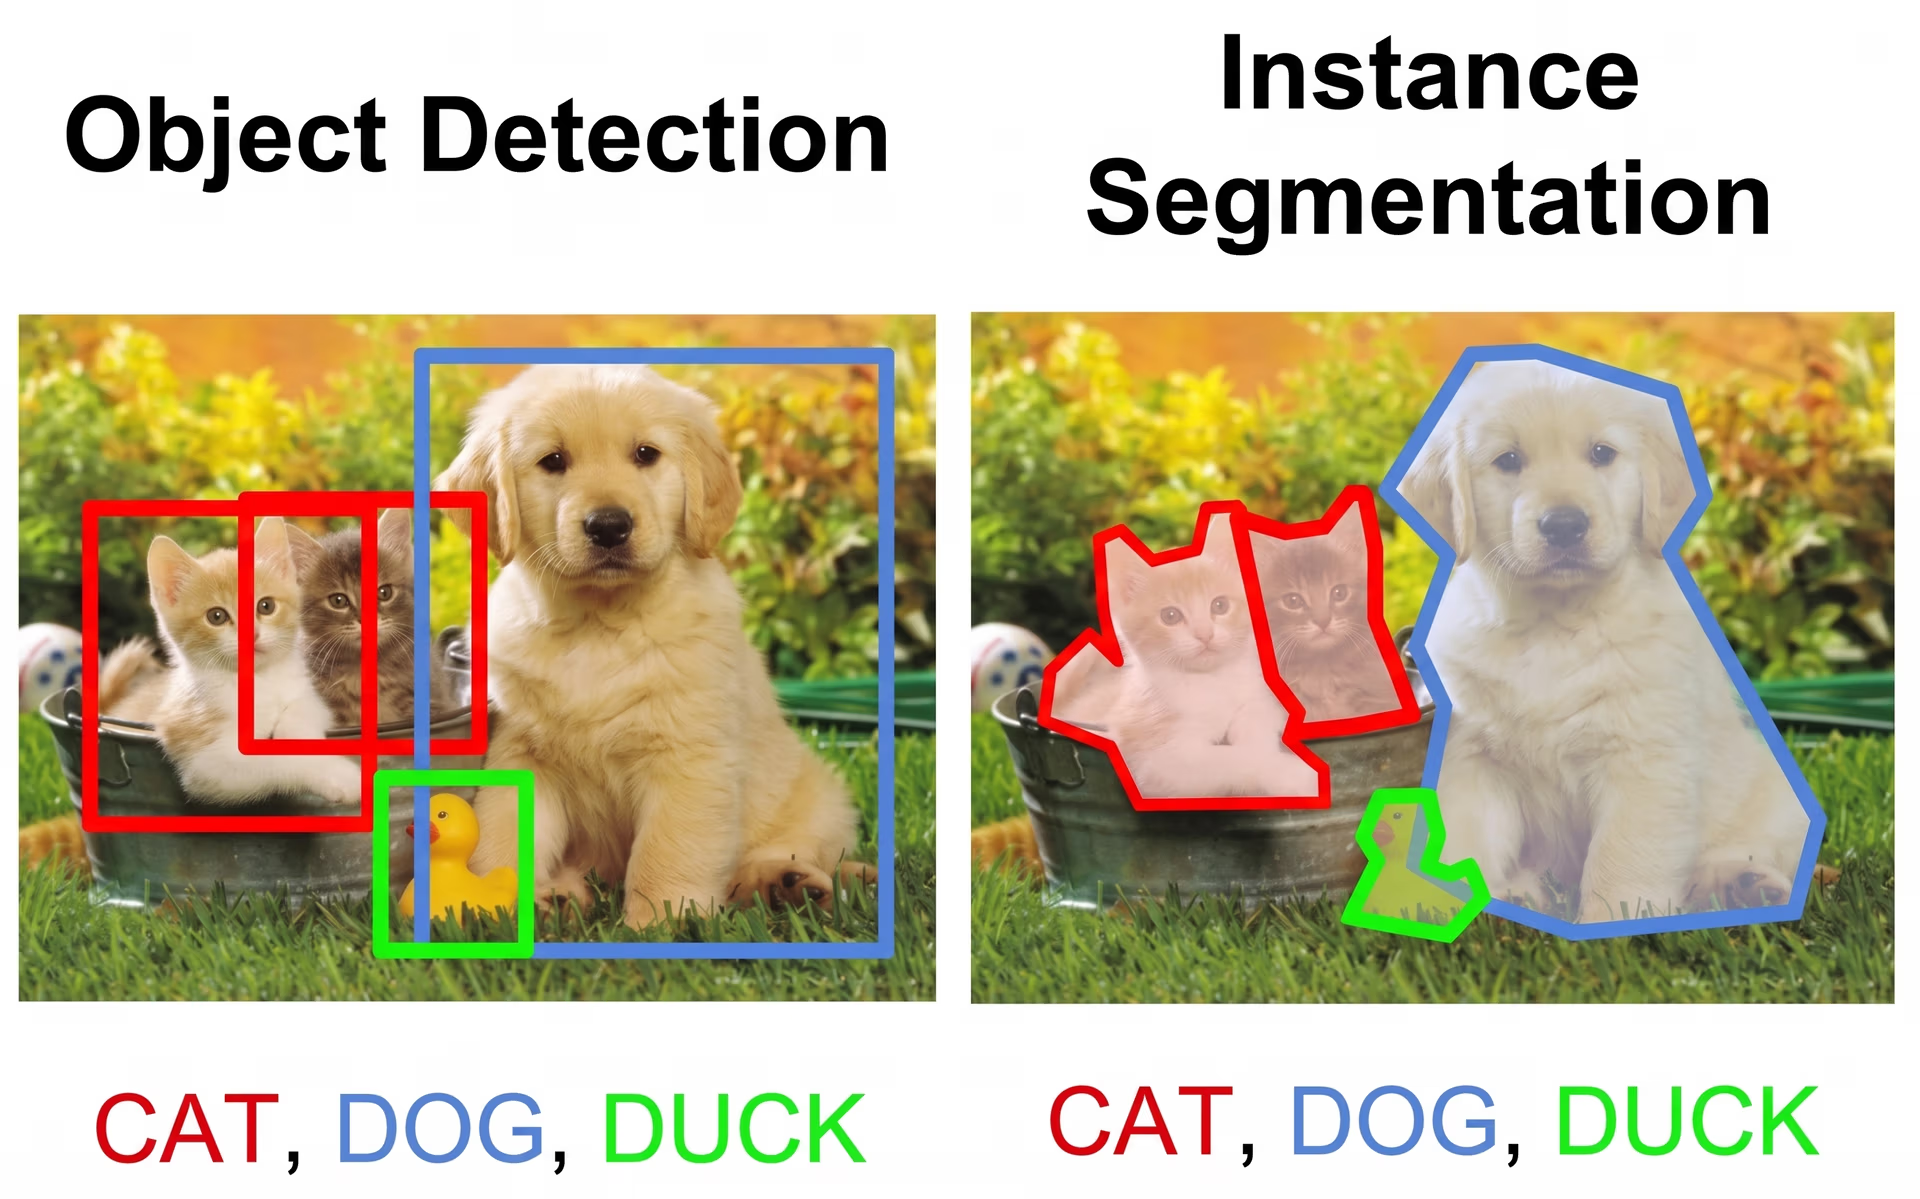
Fig. 1. Confronto tra il rilevamento degli oggetti e la segmentazione di istanze.
Architettura di Mask R-CNN e suo funzionamento#
Mask R-CNN adotta un approccio graduale per rilevare e segmentare gli oggetti con accuratezza. Inizia estraendo le caratteristiche principali con una rete neurale profonda (un modello a più livelli che apprende dai dati), poi individua le potenziali aree contenenti oggetti con una rete di proposte di regioni (un componente che suggerisce le probabili regioni degli oggetti) e, infine, perfeziona queste aree creando maschere di segmentazione dettagliate (contorni precisi degli oggetti) che catturano la forma esatta di ciascun oggetto.
Vediamo ora ogni passaggio per capire meglio come funziona Mask R-CNN.
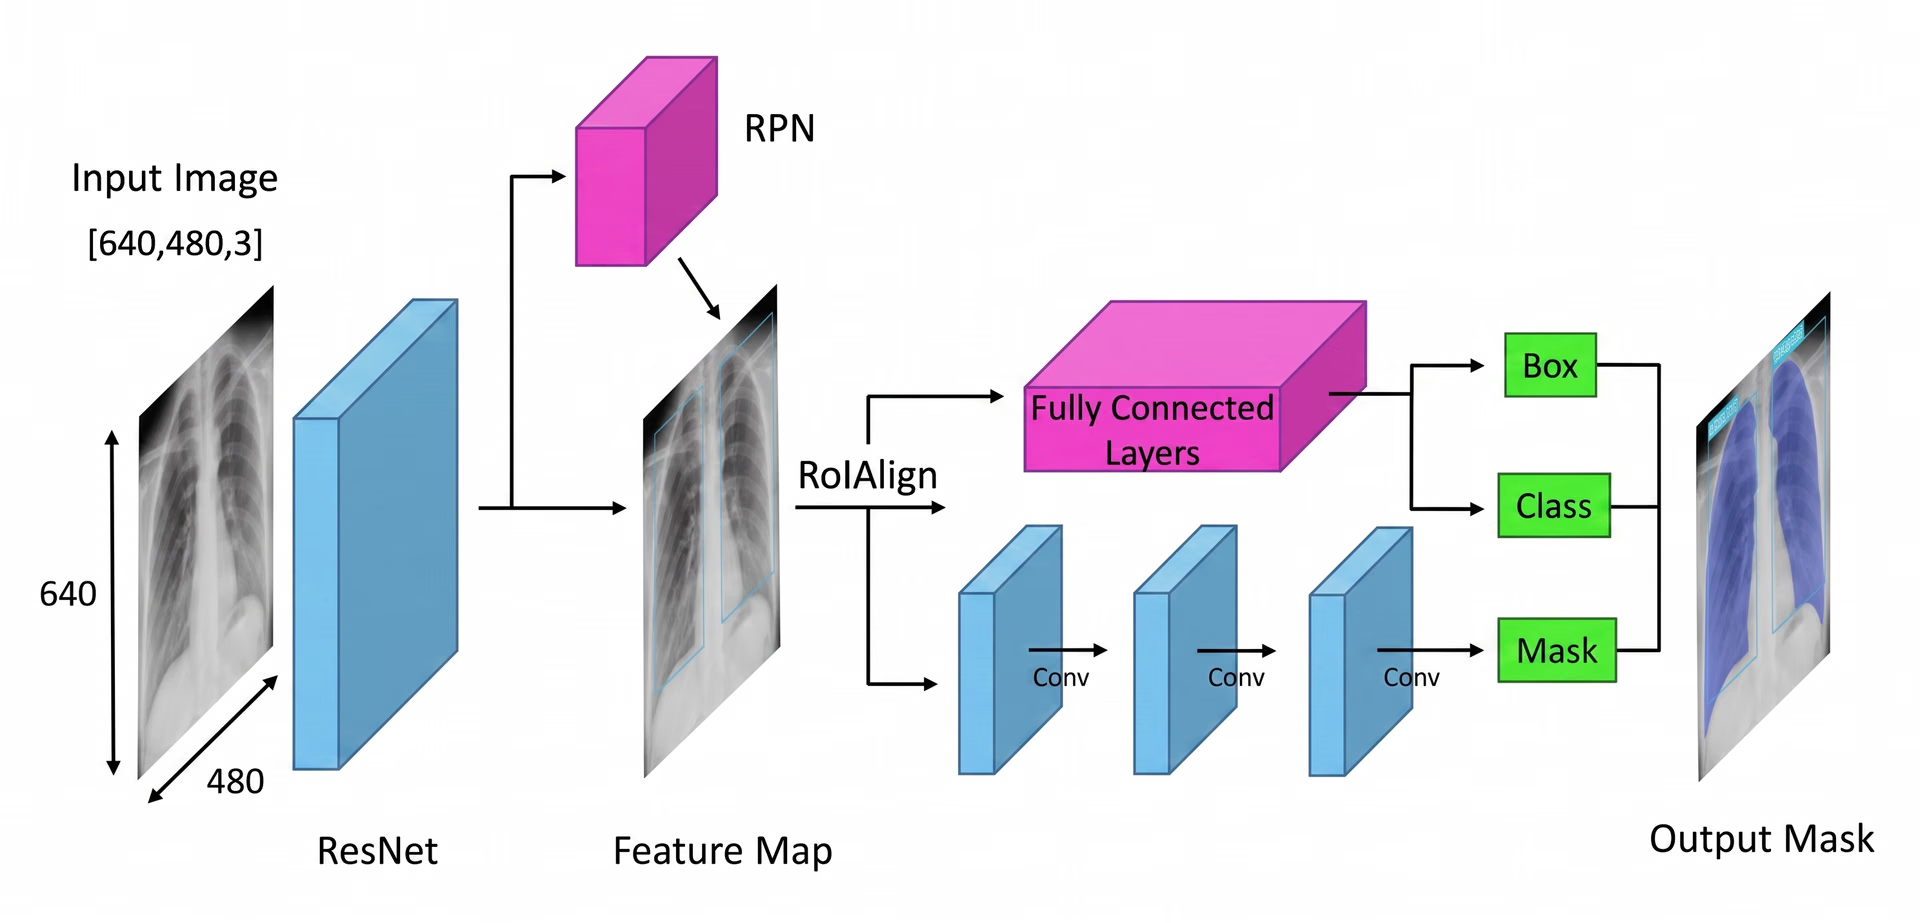
Fig. 2. Panoramica dell'architettura di Mask R-CNN (fonte: researchgate.net).
Fase iniziale: estrazione delle caratteristiche#
Il primo passaggio dell'architettura di Mask R-CNN consiste nel suddividere l'immagine nei suoi elementi principali, così che il modello possa capire cosa contiene. È un po' come quando guardi una foto e noti spontaneamente dettagli come forme, colori e bordi. Il modello fa qualcosa di simile usando una rete neurale profonda chiamata "backbone" (spesso ResNet-50 o ResNet-101), che funge da occhi per esaminare l'immagine e cogliere i dettagli principali.
Poiché gli oggetti nelle immagini possono essere molto piccoli o molto grandi, Mask R-CNN usa una rete piramidale di caratteristiche. È come avere lenti d'ingrandimento diverse che consentono al modello di vedere sia i dettagli più fini sia il quadro generale, assicurando che vengano rilevati oggetti di tutte le dimensioni.
Una volta estratte queste importanti caratteristiche, il modello passa a localizzare i potenziali oggetti nell'immagine, preparando il terreno per le analisi successive.
Individuazione delle potenziali aree dell'immagine che contengono oggetti#
Dopo che l'immagine è stata elaborata per estrarne le caratteristiche principali, entra in gioco la rete di proposte di regioni. Questa parte del modello esamina l'immagine e suggerisce le aree che probabilmente contengono oggetti.
Lo fa generando diverse possibili posizioni degli oggetti, chiamate ancore. La rete valuta quindi queste ancore e seleziona quelle più promettenti per le analisi successive. In questo modo, il modello si concentra solo sulle aree che hanno maggiori probabilità di essere interessanti, invece di esaminare ogni singolo punto dell'immagine.
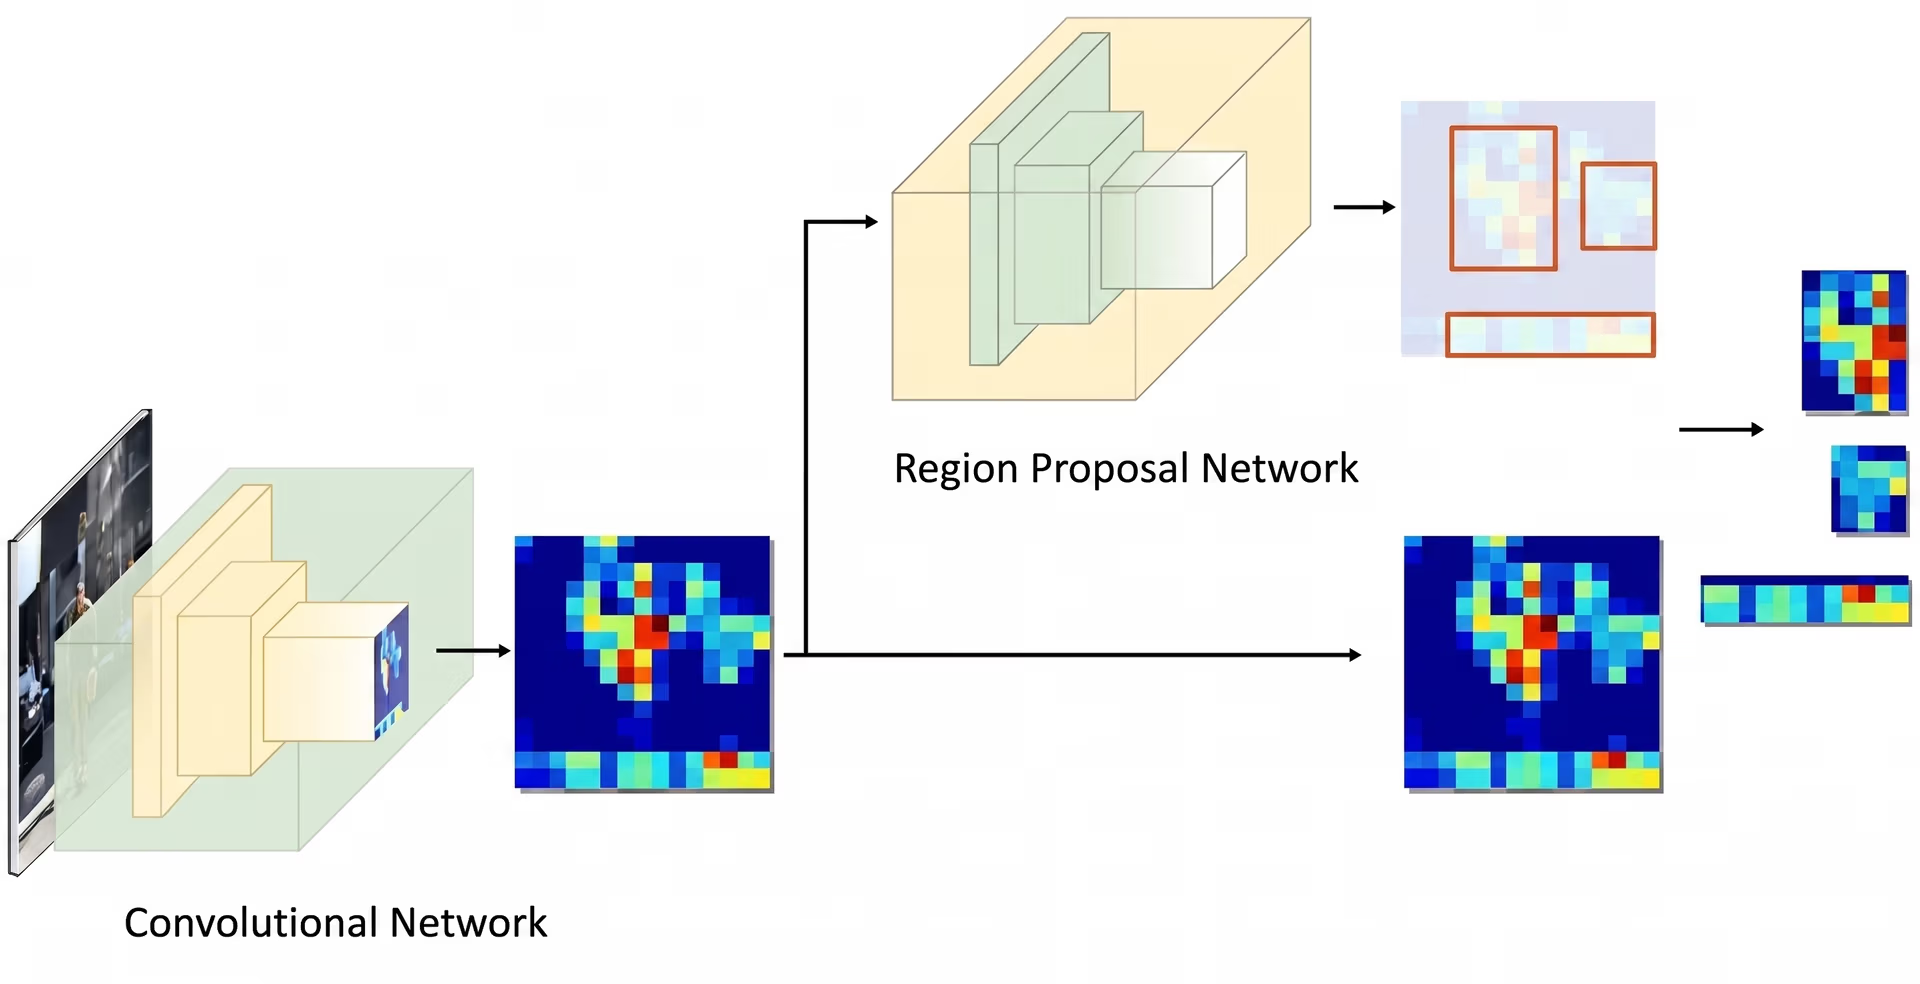
Fig. 3. Esempio di rete di proposte di regioni.
Miglioramento delle caratteristiche estratte#
Dopo aver individuato le aree principali, il passaggio successivo consiste nel perfezionare i dettagli estratti da queste regioni. I modelli precedenti usavano una tecnica chiamata ROI Pooling (pooling della regione di interesse) per acquisire le caratteristiche di ogni area, ma a volte questa tecnica causava lievi disallineamenti durante il ridimensionamento delle regioni, risultando meno efficace, soprattutto per gli oggetti più piccoli o sovrapposti.
Mask R-CNN migliora questo approccio con una tecnica chiamata ROI Align (allineamento della regione di interesse). A differenza di ROI Pooling, che arrotonda le coordinate, ROI Align usa l'interpolazione bilineare per stimare i valori dei pixel con maggiore precisione. L'interpolazione bilineare calcola il valore di un nuovo pixel usando una media ponderata dei valori dei quattro pixel vicini, creando transizioni più uniformi. In questo modo, le caratteristiche rimangono correttamente allineate all'immagine originale e il rilevamento e la segmentazione degli oggetti risultano più precisi.
Per esempio, durante una partita di calcio, due giocatori vicini potrebbero essere confusi l'uno con l'altro perché i loro riquadri di delimitazione si sovrappongono. ROI Align aiuta a distinguerli mantenendo separate le loro forme.
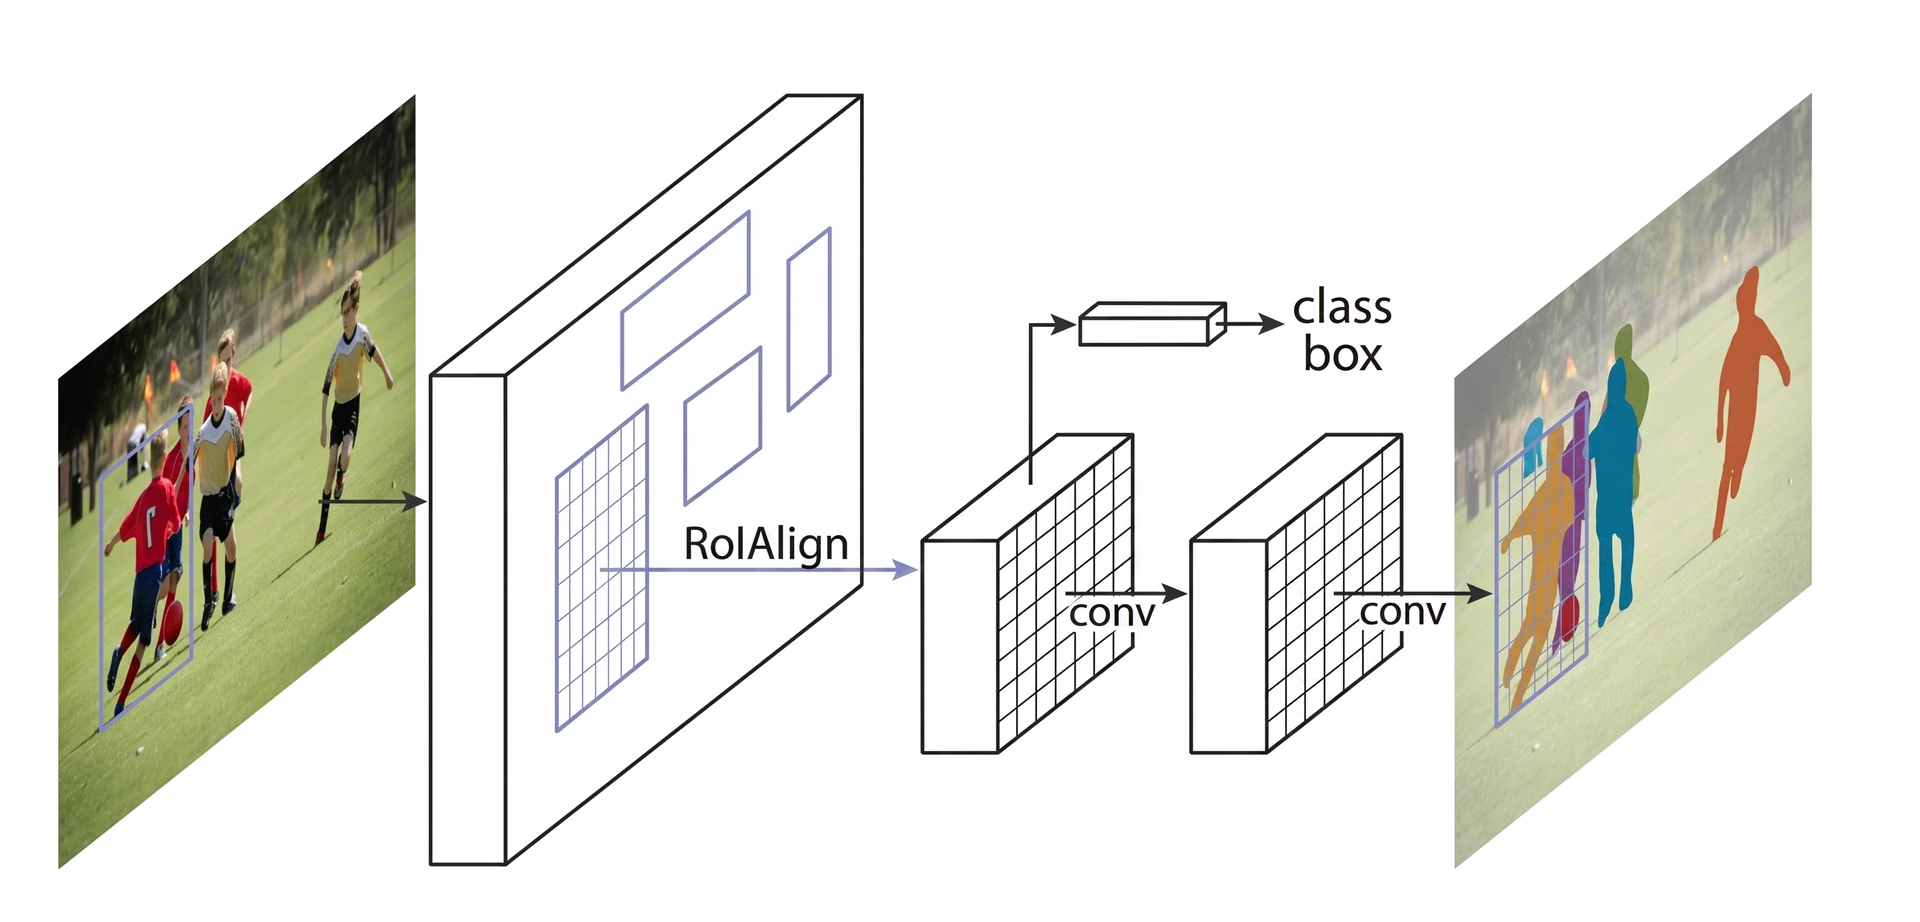
Fig 4. Mask R-CNN usa ROI Align.
Classificare gli oggetti e prevederne le maschere#
Dopo che ROI Align ha elaborato l’immagine, il passaggio successivo consiste nel classificare gli oggetti e perfezionarne la posizione. Il modello esamina ogni regione estratta e determina quale oggetto contiene. Assegna un punteggio di probabilità alle diverse categorie e seleziona la corrispondenza migliore.
Allo stesso tempo, regola i riquadri di delimitazione per adattarli meglio agli oggetti. I riquadri iniziali potrebbero non essere posizionati in modo ideale, quindi questa operazione aiuta a migliorare la precisione assicurandosi che ciascun riquadro circondi da vicino l’oggetto rilevato.
Infine, Mask R-CNN compie un ulteriore passaggio: genera in parallelo una maschera di segmentazione dettagliata per ogni oggetto.
Mask R-CNN e le sue applicazioni nel mondo reale#
Quando è stato presentato, questo modello è stato accolto con grande entusiasmo dalla comunità dell'IA e ha trovato presto impiego in diverse applicazioni. La sua capacità di rilevare e segmentare gli oggetti con precisione a livello di pixel lo ha reso popolare in vari settori.
Ad esempio, monitorare gli animali in via di estinzione in natura è un’attività impegnativa. Molte specie si spostano in fitte foreste, rendendo difficile per chi si occupa di conservazione tenerne traccia. I metodi tradizionali utilizzano fototrappole, droni e immagini satellitari, ma esaminare tutti questi dati manualmente richiede molto tempo. Le identificazioni errate e gli avvistamenti mancati possono rallentare gli interventi di conservazione.
Riconoscendo caratteristiche uniche come le strisce delle tigri, le macchie delle giraffe o la forma delle orecchie degli elefanti, Mask R-CNN può rilevare e segmentare gli animali in immagini e video con maggiore precisione. Anche quando gli animali sono parzialmente nascosti dagli alberi o si trovano vicini gli uni agli altri, il modello può separarli e identificare ciascun esemplare individualmente, rendendo il monitoraggio della fauna selvatica più rapido e affidabile.
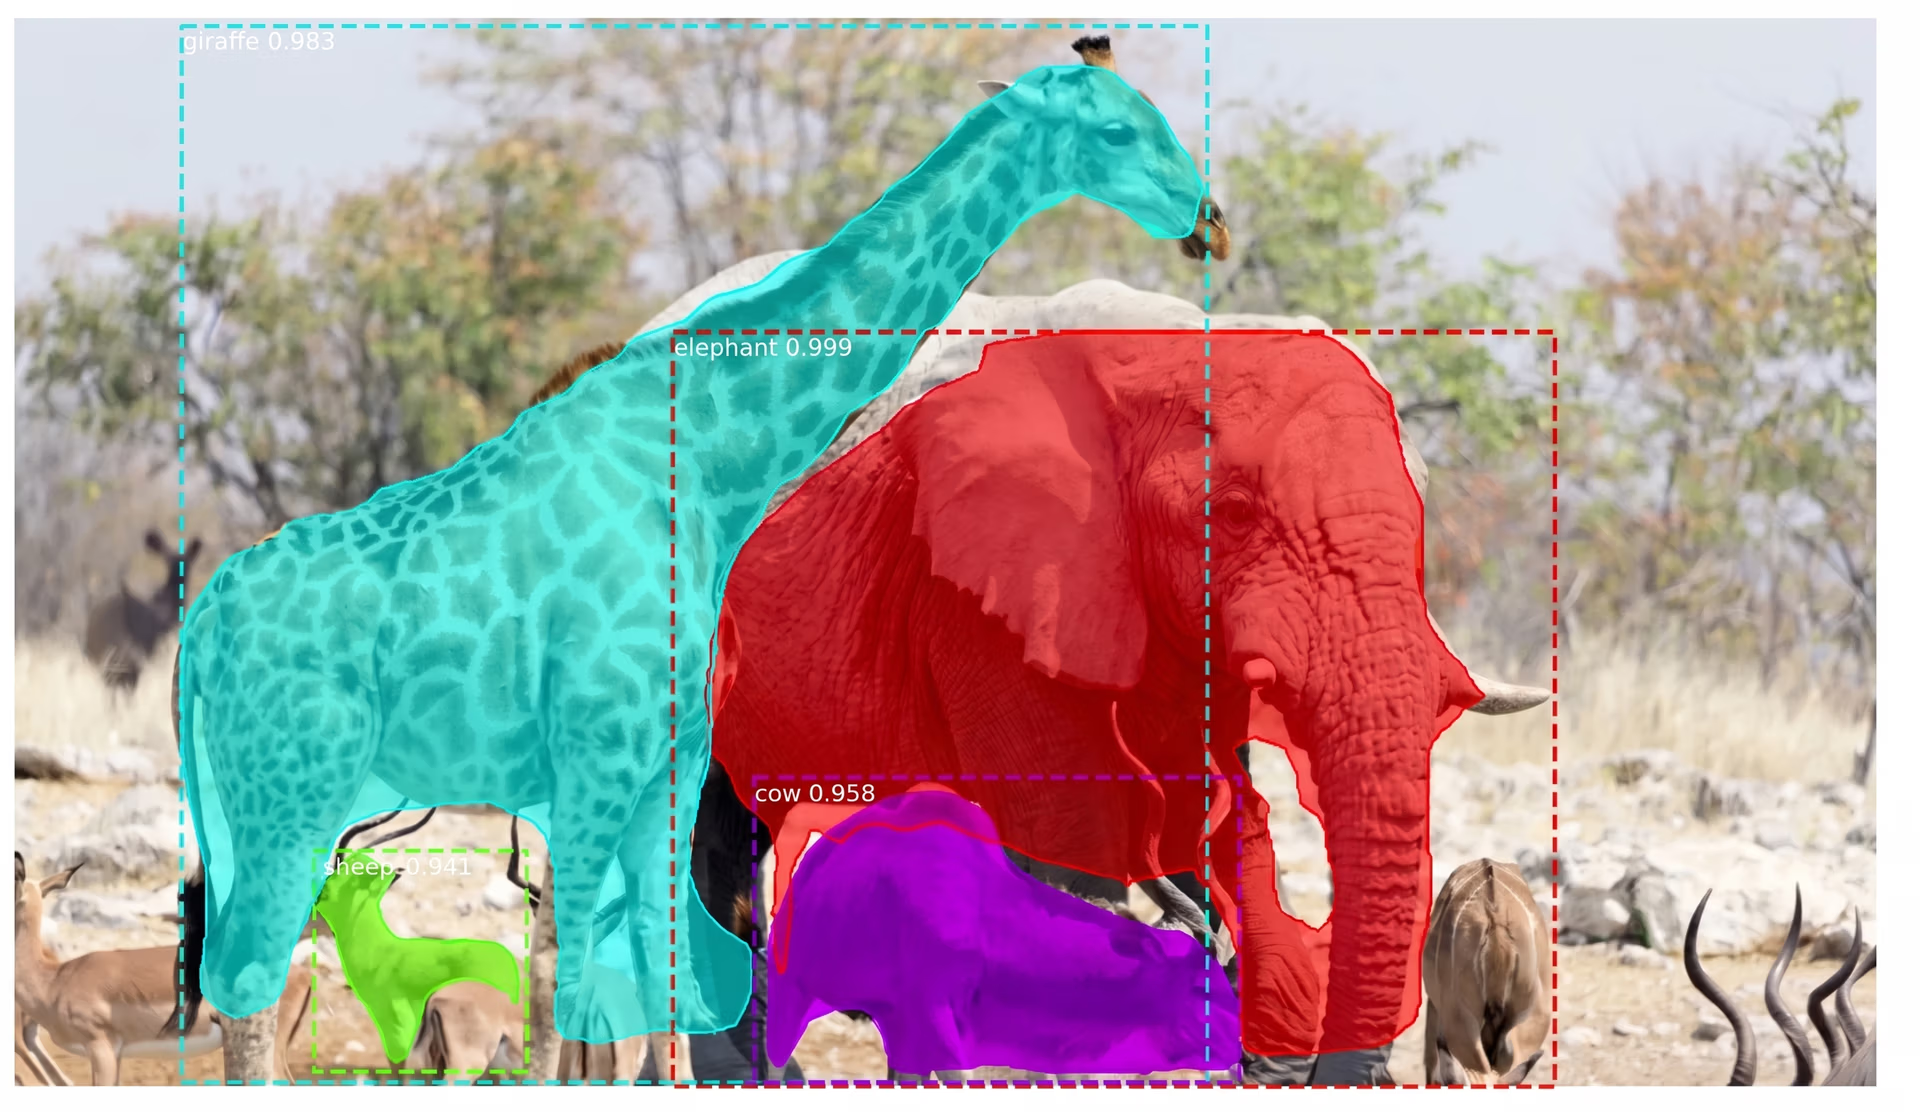
Fig 5. Rilevamento e segmentazione degli animali con Mask R-CNN.
Limiti di Mask R-CNN#
Nonostante la sua importanza storica nel rilevamento e nella segmentazione degli oggetti, Mask R-CNN presenta anche alcuni svantaggi significativi. Ecco alcune difficoltà associate a Mask R-CNN:
- Elevato fabbisogno computazionale: richiede GPU potenti, quindi può essere costoso da eseguire e lento nell'elaborazione di grandi quantità di dati.
- Velocità di elaborazione inferiore: il suo processo articolato in più fasi lo rende più lento rispetto a modelli più rapidi in tempo reale come YOLO, il che potrebbe non essere ideale per le attività che richiedono tempi ridotti.
- Dipendenza da dati di alta qualità: il modello offre le prestazioni migliori con immagini nitide e ben etichettate. Immagini sfocate o scarsamente illuminate possono ridurne notevolmente la precisione.
- Implementazione complessa: l’architettura articolata in più fasi può essere difficile da configurare e ottimizzare, soprattutto quando si lavora con grandi set di dati o risorse limitate.
Da Mask R-CNN a Ultralytics YOLO11#
Mask R-CNN era ottimo per le attività di segmentazione, ma molti settori volevano adottare la visione artificiale dando priorità alla velocità e alle prestazioni in tempo reale. Questa esigenza ha spinto i ricercatori a sviluppare modelli a una sola fase che rilevano gli oggetti in un unico passaggio, migliorando notevolmente l’efficienza.
A differenza del processo in più fasi di Mask R-CNN, i modelli di visione artificiale a singolo stadio come YOLO (You Only Look Once) si concentrano sulle attività di visione artificiale in tempo reale. Invece di gestire separatamente il rilevamento e la segmentazione, i modelli YOLO possono rilevare e segmentare gli oggetti in un unico passaggio. Questo li rende ideali per applicazioni come la guida autonoma, la sanità, la produzione e la robotica, in cui è fondamentale prendere decisioni rapidamente.
In particolare, Ultralytics YOLO11 (a cui è succeduto Ultralytics YOLO26) fa un ulteriore passo avanti combinando velocità e accuratezza. Usa il 22% di parametri in meno rispetto a YOLOv8m, ma raggiunge comunque una precisione media media (mAP) più elevata sul set di dati COCO, rilevando gli oggetti con maggiore precisione. La velocità di elaborazione migliorata lo rende una buona scelta per le applicazioni in tempo reale, in cui ogni millisecondo conta.
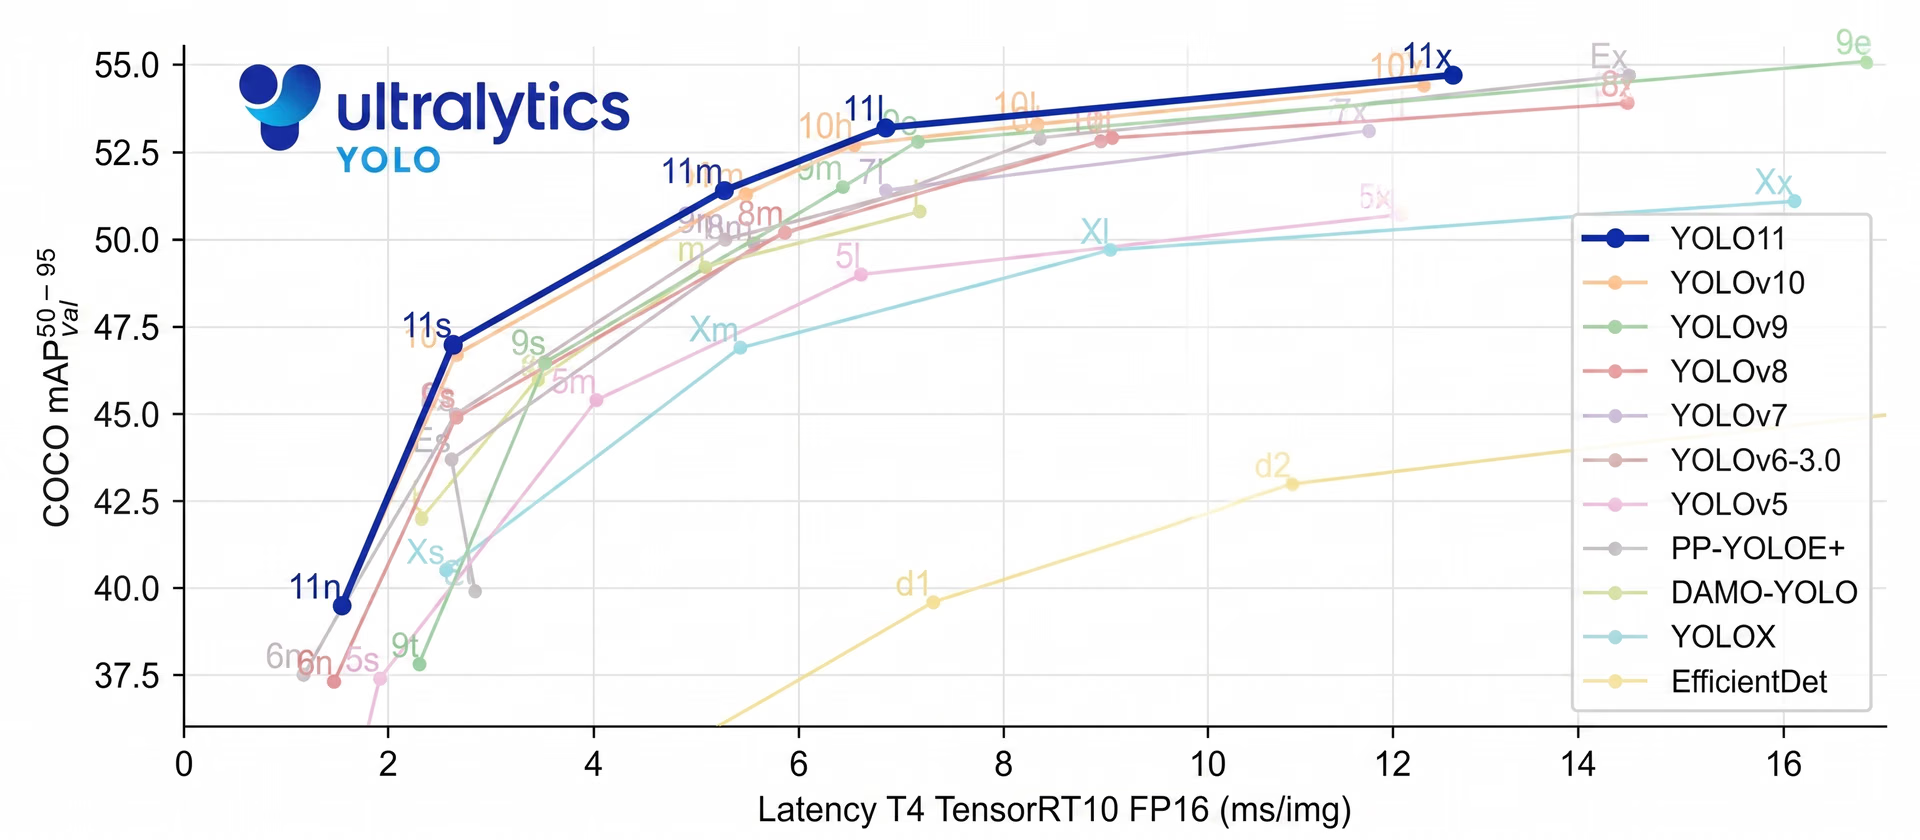
Fig 6. Prestazioni di YOLO11 a confronto con altri modelli.
Punti chiave#
Ripercorrendo la storia della visione artificiale, Mask R-CNN è considerato una svolta importante nel rilevamento e nella segmentazione degli oggetti. Fornisce risultati molto precisi anche in contesti complessi, grazie al suo processo dettagliato articolato in più fasi.
Tuttavia, questo stesso processo lo rende più lento rispetto ai modelli in tempo reale come YOLO. Con la crescente necessità di velocità ed efficienza, molte applicazioni usano ora modelli a singolo stadio come Ultralytics YOLO11, che offrono un rilevamento degli oggetti rapido e accurato. Mask R-CNN resta importante per comprendere l'evoluzione della visione artificiale, ma il passaggio ai modelli in tempo reale riflette la crescente domanda di soluzioni più rapide ed efficienti.
Unisciti alla nostra community in crescita! Esplora il nostro repository GitHub per saperne di più sull’AI. Vuoi iniziare i tuoi progetti di visione artificiale? Scopri le nostre opzioni di licenza. Scopri l’AI in agricoltura e l’AI visiva in ambito sanitario visitando le nostre pagine dedicate alle soluzioni!
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









