Aproveitando o aprendizado por reforço em projetos de visão computacional
Saiba como funciona o aprendizado por reforço e como ele se combina com a visão computacional em robôs de armazém, veículos autônomos e robótica cirúrgica, além de conhecer suas vantagens e desvantagens.
 Abirami Vina10 min de leitura
Uma forma simples de explicar a inteligência artificial (AI) é dizer que ela é uma área dedicada a reproduzir a maneira como os humanos pensam e aprendem. É daí que vem a ideia de técnicas de aprendizado em IA: diferentes métodos que permitem que as máquinas melhorem seu desempenho ao longo do tempo, assim como as pessoas.
Anteriormente, exploramos as principais técnicas de aprendizado em IA, incluindo aprendizado supervisionado, não supervisionado, por reforço e por transferência, e como cada uma delas desempenha um papel importante ao ajudar os modelos de IA a processar informações e tomar decisões.
Hoje, vamos analisar mais de perto a aprendizagem por reforço, uma técnica que ensina os sistemas de IA a aprender com a experiência, interagindo com um ambiente e melhorando com base no feedback. Em particular, vamos explorar como a aprendizagem por reforço pode ser aplicada a aplicações de visão computacional, ou seja, sistemas que permitem às máquinas interpretar e compreender informações visuais do mundo.
A combinação de conceitos como aprendizado por reforço e visão computacional está abrindo novas possibilidades empolgantes e é uma área de pesquisa ativa. Ela permite que os sistemas de IA reconheçam o que veem e tomem decisões informadas com base nessas informações visuais.
O que é aprendizado por reforço?#
O aprendizado por reforço é um ramo do aprendizado de máquina em que um agente de IA aprende realizando ações e recebendo feedback na forma de recompensas ou penalidades. O objetivo é descobrir quais ações levam aos melhores resultados ao longo do tempo.
Você pode pensar no aprendizado por reforço como o treinamento de um cachorro. Quando o cachorro se senta ao receber um comando, você lhe dá um petisco. Depois de algum tempo, ele aprende que sentar resulta em uma recompensa. No aprendizado por reforço, o agente ou modelo de IA é como o cachorro; o ambiente é o mundo ao redor dele, e a recompensa ajuda a entender se ele fez a escolha certa.
Isso é diferente do aprendizado supervisionado, em que o modelo de IA recebe muitos exemplos com as respostas corretas. Por exemplo, o modelo pode receber a imagem de um cachorro e ouvir: "Isto é um cachorro."
Por outro lado, o aprendizado por reforço não depende de dados rotulados. Em vez disso, consiste em aprender testando diferentes ações e aprendendo com os resultados, como ao jogar um jogo e descobrir quais movimentos ajudam você a vencer.
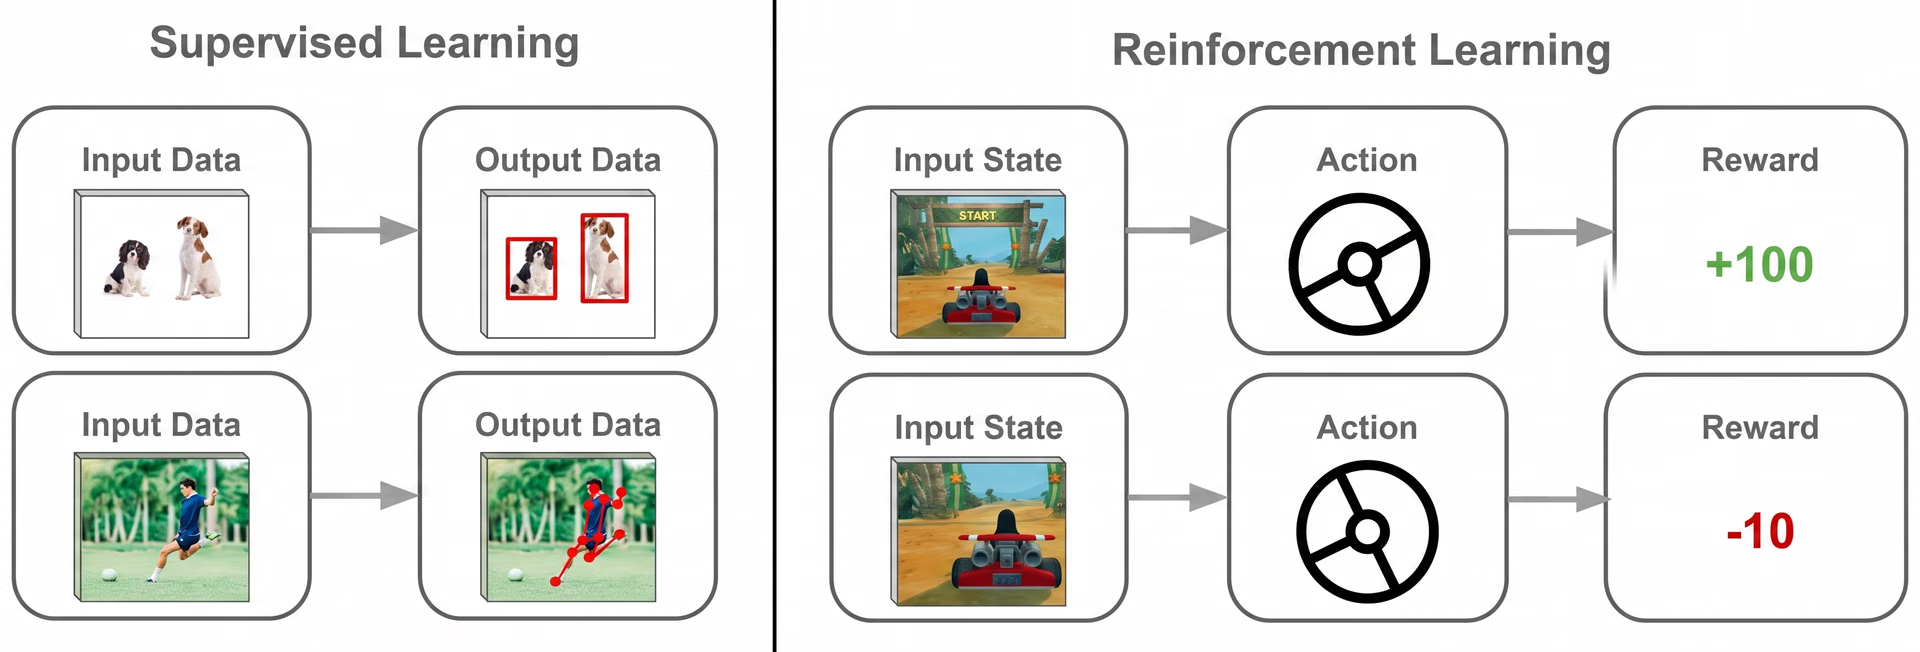
Fig 1. Aprendizado por reforço vs. aprendizado supervisionado.
O aprendizado por reforço é fundamental para tarefas em que as decisões são tomadas passo a passo e cada escolha altera o que acontece em seguida. Esse tipo de aprendizado é usado em videogames de estratégia para tornar a experiência de jogo mais desafiadora e envolvente para os jogadores.
Como o aprendizado por reforço funciona em soluções de IA#
Pense em como você aprende a andar de bicicleta. No começo, talvez você caia. Mas, com a prática, começa a descobrir o que ajuda a manter o equilíbrio. Quanto mais você pedala, melhor fica. Você aprende fazendo, não apenas recebendo instruções.
A aprendizagem por reforço funciona de forma semelhante na IA. Aprende-se com a experiência: experimentando diferentes ações, observando o que acontece e melhorando gradualmente a capacidade de fazer as escolhas certas ao longo do tempo.
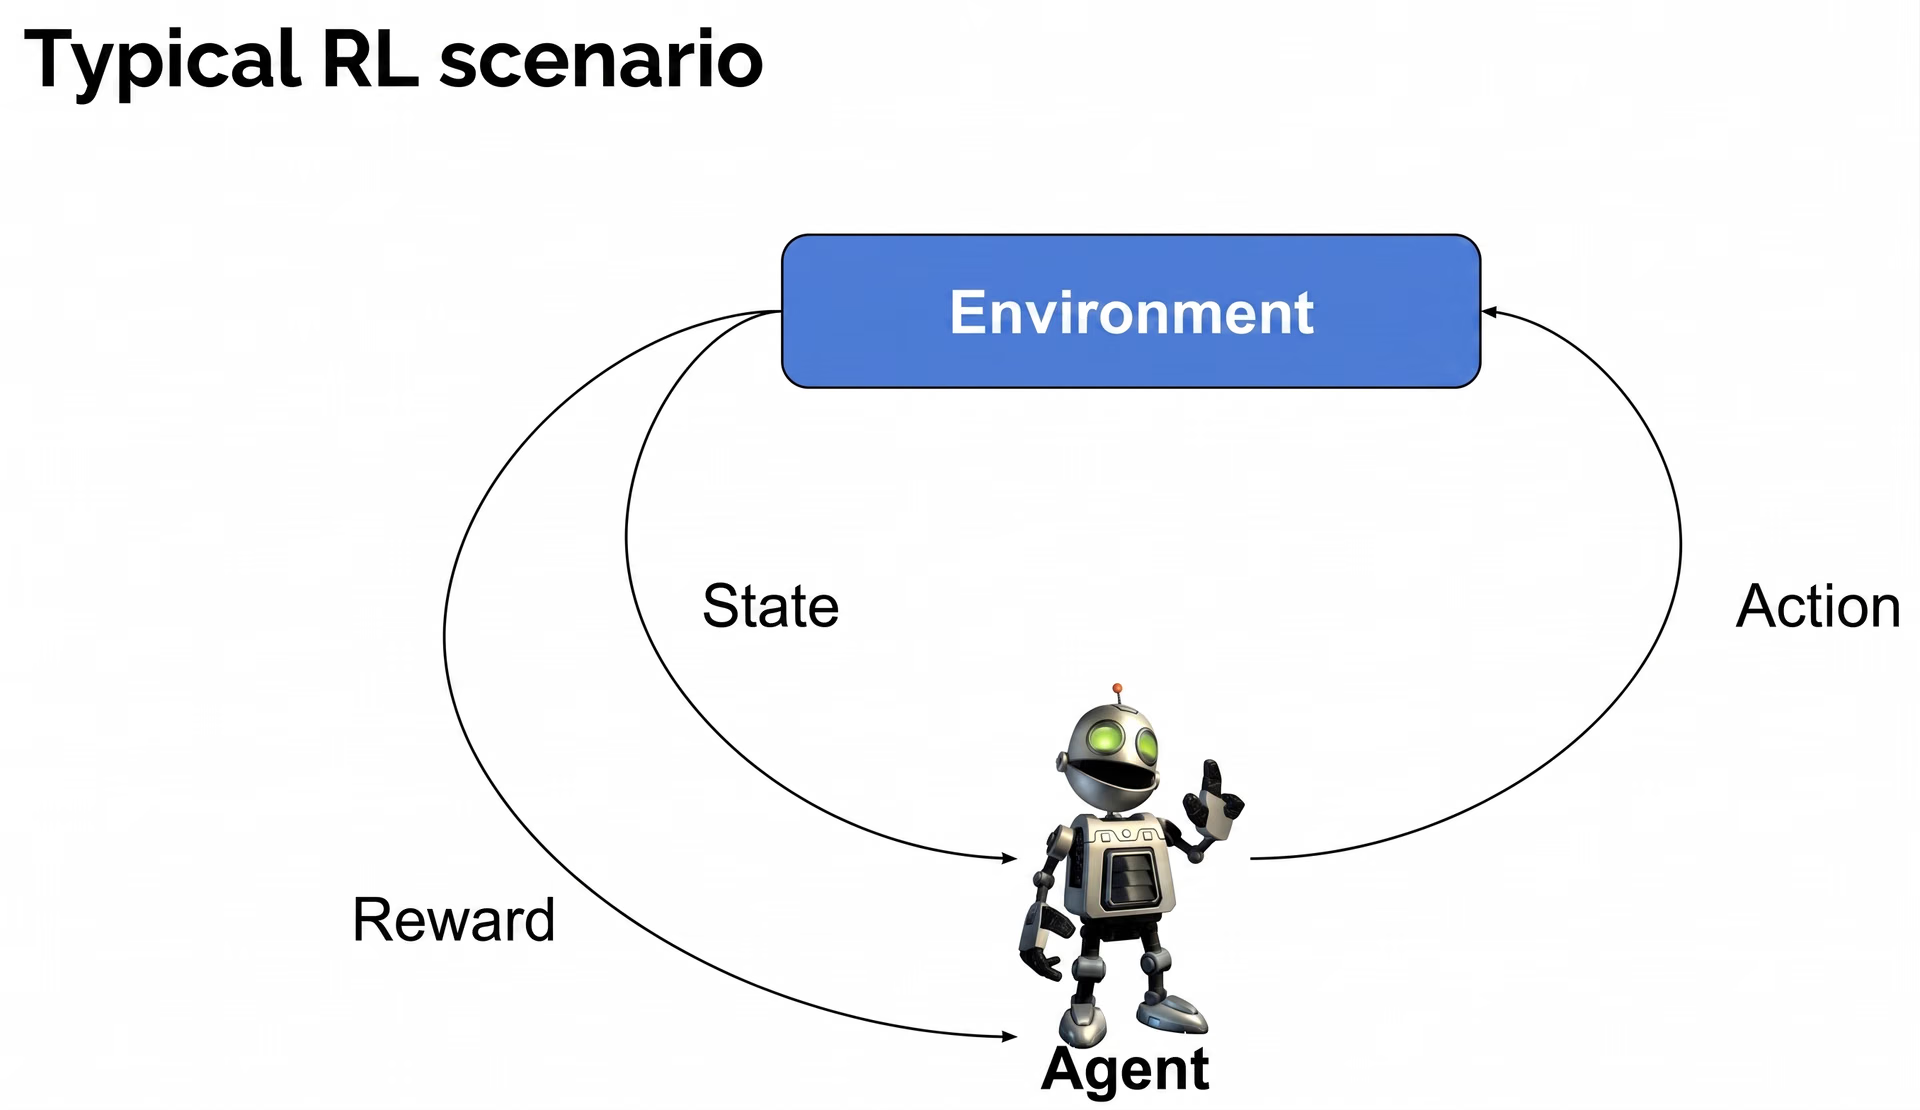
Fig 2. Entenda como funciona o aprendizado por reforço.
Veja alguns dos principais componentes da aprendizagem por reforço:
- Agente: O agente é quem aprende ou toma decisões. Ele interage com o ambiente realizando ações e busca alcançar um objetivo específico.
- Ambiente: O ambiente inclui tudo com que o agente interage. Ele muda em resposta às ações do agente e fornece feedback com base nos resultados.
- Estado: Um estado representa um retrato da situação atual no ambiente. O agente observa o estado para entender o que o cerca e determinar qual ação realizar em seguida.
- Ação: Uma ação é um movimento ou uma decisão tomada pelo agente que afeta o ambiente. Cada ação leva a um novo estado e pode influenciar recompensas futuras.
- Recompensa: Uma recompensa é simplesmente o feedback do ambiente que informa ao agente se a ação foi benéfica ou não. Recompensas positivas incentivam o agente a repetir boas ações, enquanto recompensas negativas desestimulam ações inadequadas.
- Política: Uma política é a estratégia que o agente usa para escolher ações com base no estado atual. Com o tempo, o agente aprimora sua política para maximizar o total de recompensas que pode obter.
Ao combinar estes componentes, a aprendizagem por reforço permite que os sistemas de IA aprendam comportamentos eficazes através de tentativas e erros contínuos. A cada tentativa, o agente torna-se melhor a selecionar ações que conduzem a recompensas mais elevadas e a melhores resultados.
Inovações em aprendizagem por reforço na visão computacional#
A visão computacional é usada em tarefas como detectar objetos em imagens, classificar o que há em uma foto e segmentar uma imagem em diferentes partes. Modelos de visão computacional como o Ultralytics YOLO11 dão suporte a essas tarefas e podem ser usados para criar aplicações impactantes capazes de obter informações visuais.
No entanto, quando estas tarefas de IA de visão são combinadas com a aprendizagem por reforço, o resultado é uma solução de IA que não se limita a ver: também aprende a agir com base nas informações visuais e melhora ao longo do tempo.
Um exemplo interessante de aprendizagem por reforço em aplicações de visão computacional é a utilização de robôs em armazéns. Os robôs equipados com câmaras e sistemas de visão computacional podem analisar o ambiente, detetar a localização de cada artigo, identificar a sua forma e tamanho e compreender como está posicionado na prateleira.
Sempre que o robô tenta apanhar um artigo, recebe feedback: sucesso se o artigo for apanhado corretamente ou falha se cair. Com o tempo, o robô aprende quais são as melhores ações para cada artigo. Em vez de seguir um conjunto fixo de instruções, melhora continuamente com a experiência.
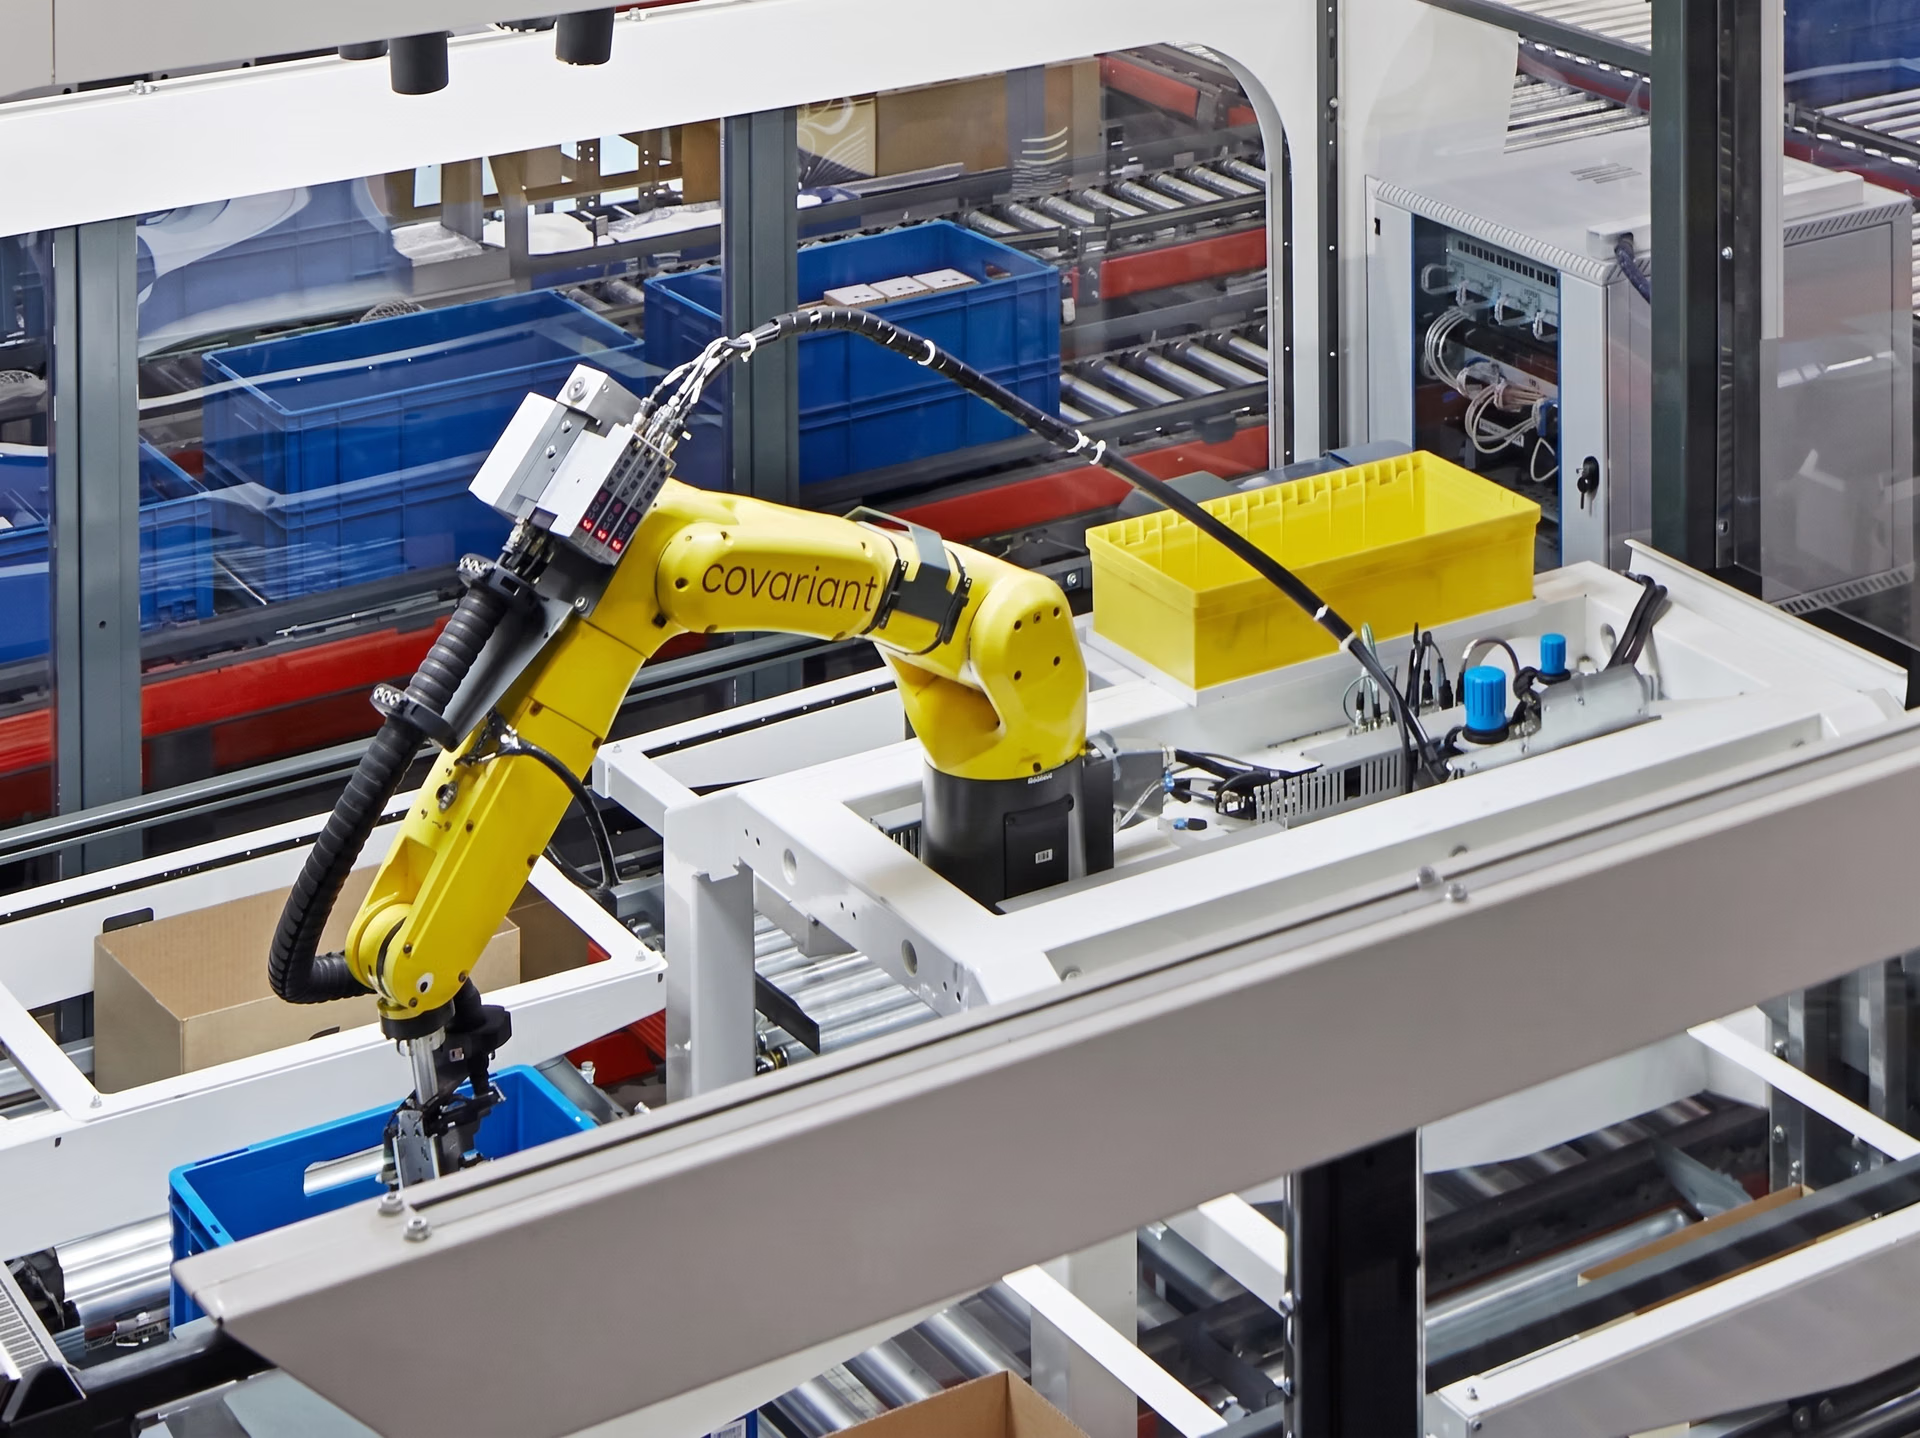
Fig. 3. Um braço robótico usa IA visual e aprendizagem por reforço para pegar objetos.
Aplicações da aprendizagem por reforço na visão computacional#
Agora que entendemos melhor o que é a aprendizagem por reforço e qual é seu papel na visão computacional, vamos analisar mais de perto alguns exemplos de uso conjunto da aprendizagem por reforço e da visão computacional.
Integração de IA visual e aprendizagem por reforço para veículos mais inteligentes#
Os veículos autónomos podem recorrer tanto à IA de visão para compreender o ambiente como à aprendizagem por reforço para tomar decisões com base no que veem. O AWS DeepRacer é um excelente exemplo desta aplicação.
O AWS DeepRacer é um carro de corrida totalmente autônomo, em escala 1:18, que aprende a dirigir usando uma câmera e aprendizagem por reforço. Em vez de receber instruções sobre o que fazer, ele descobre tudo sozinho, experimentando, cometendo erros e aprendendo com eles.
A câmera desse carrinho funciona como um par de olhos, capturando a pista à frente. Com base no que vê, o carro aprende a virar e a que velocidade andar. A cada volta, ele melhora. Por exemplo, pode aprender a fazer curvas mais abertas ou a reduzir a velocidade antes de curvas fechadas com base em tentativas anteriores.
O treinamento do DeepRacer começa em um ambiente virtual, onde o modelo pratica e aprimora suas habilidades de direção. Quando atinge determinado nível de desempenho, essas habilidades são transferidas para pistas reais com carros físicos.
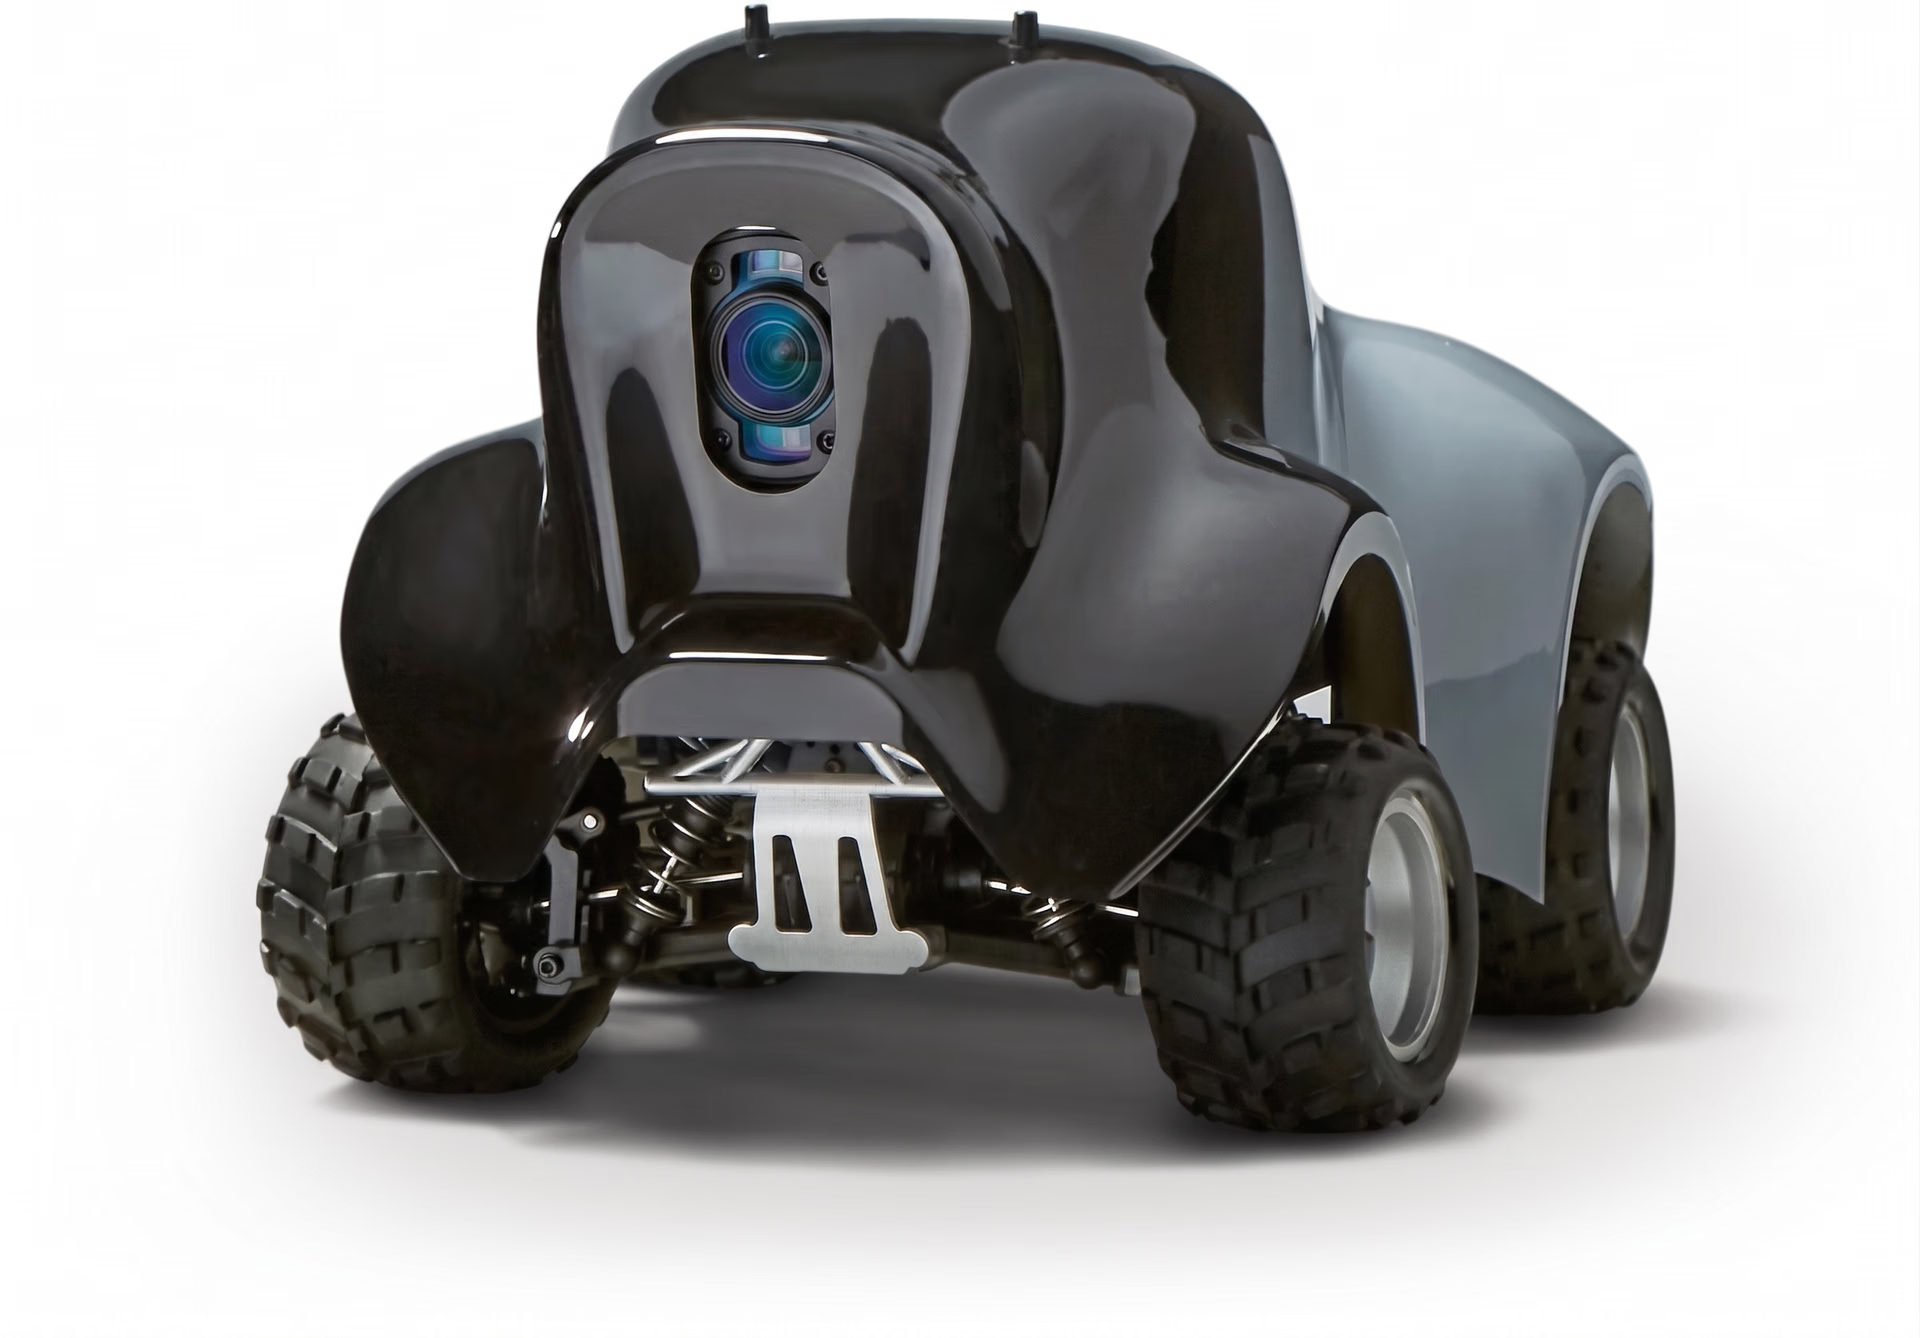
Fig. 4. O AWS DeepRacer usa visão e aprendizagem por reforço para dirigir de forma autônoma. Fonte da imagem: Amazon.
Rumo a robôs cirúrgicos autônomos#
Uma área de investigação promissora que está a ganhar atenção é a integração da IA de visão e da aprendizagem por reforço na cirurgia robótica. Atualmente, esta aplicação é ainda, em grande parte, teórica. Os investigadores estão a executar simulações em ambientes virtuais.
No entanto, os primeiros experimentos estão mostrando resultados promissores, sugerindo que robôs cirúrgicos poderão, no futuro, realizar procedimentos complexos e delicados com mais precisão, adaptabilidade e intervenção humana mínima.
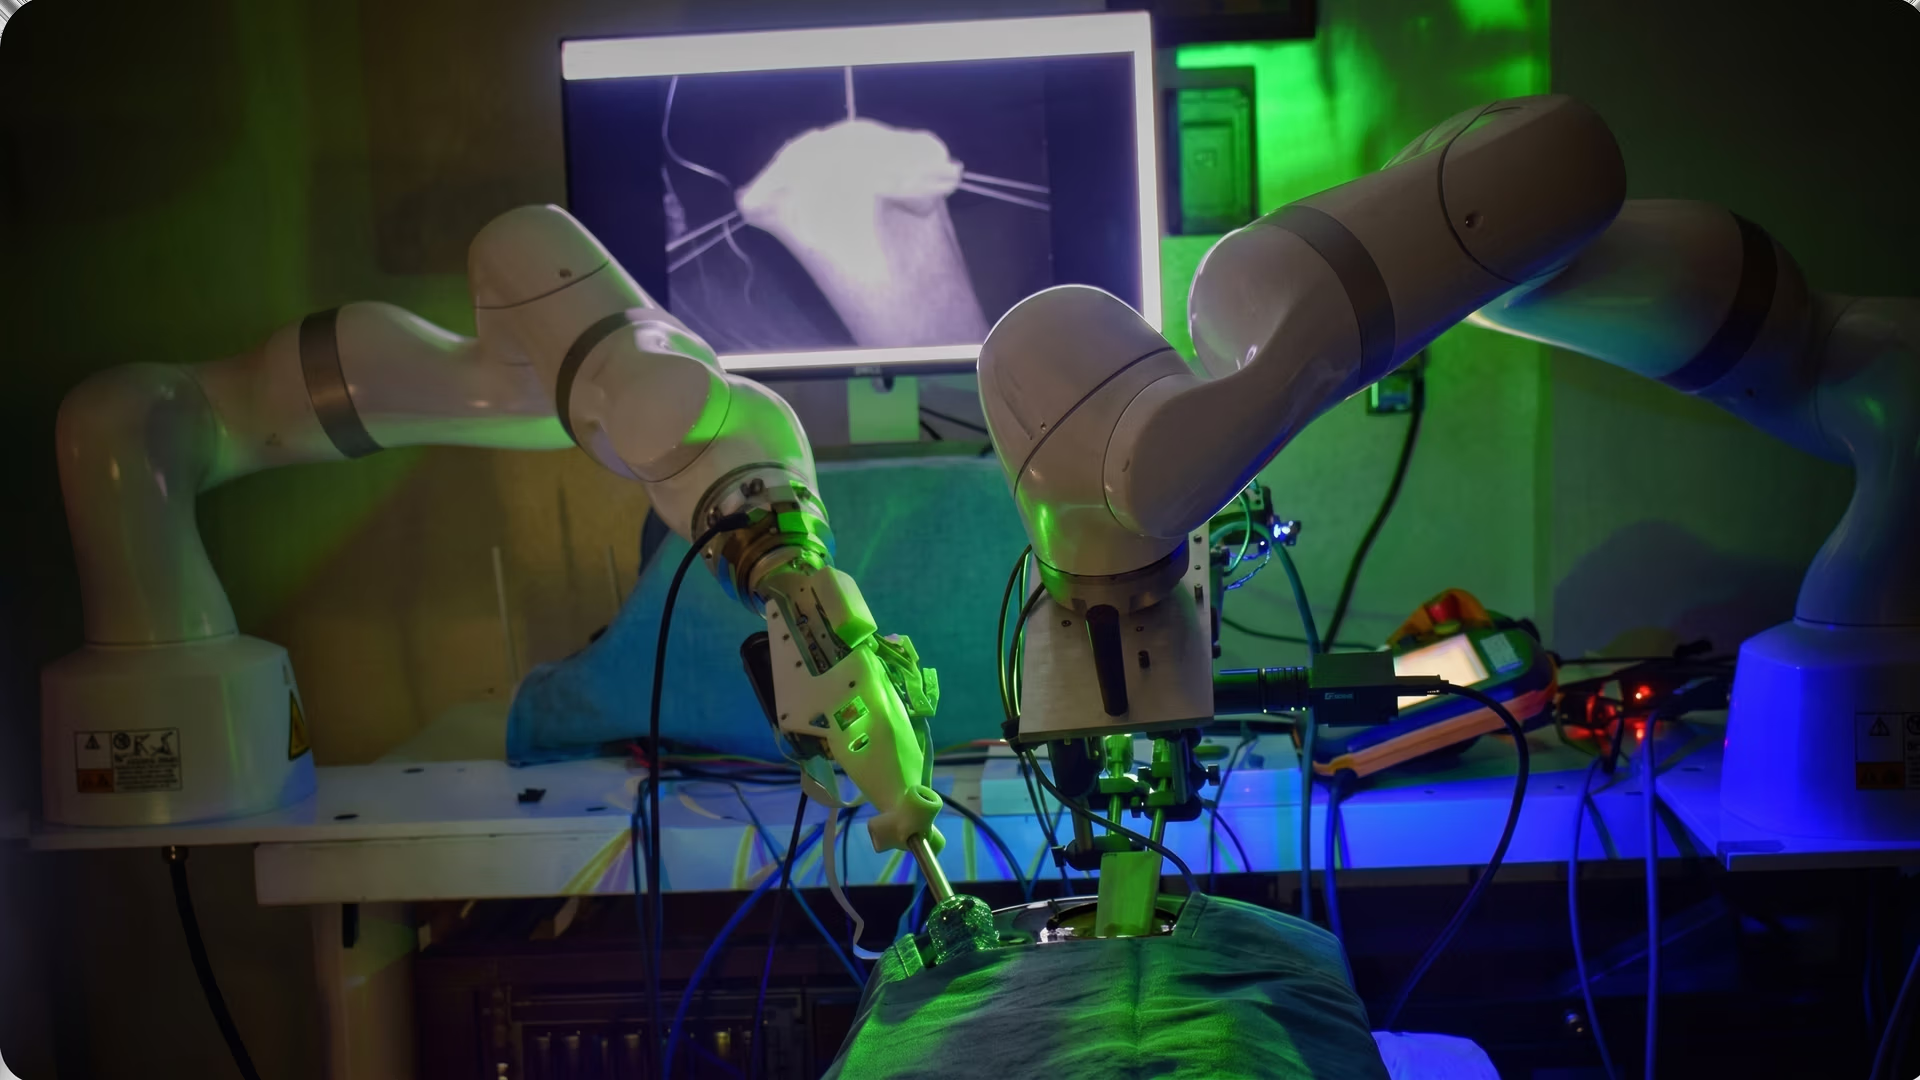
Fig. 5. Os robôs cirúrgicos estão cada vez mais avançados.
Por exemplo, imagina uma situação em que é necessário levantar cuidadosamente uma compressa do campo cirúrgico. Um robô equipado com IA de visão começaria por analisar a cena, utilizando a segmentação para identificar a compressa e os tecidos circundantes.
A aprendizagem por reforço ajudaria então o robô cirúrgico a decidir como abordar a tarefa, determinando o melhor ângulo para segurar a gaze, quanta pressão aplicar e como levantá-la sem perturbar áreas sensíveis próximas. Com o tempo e a prática repetida em ambientes simulados, o robô poderia aprender a realizar esses movimentos sutis e críticos com cada vez mais habilidade e confiança.
Vantagens e desvantagens da aprendizagem por reforço na IA visual#
A aprendizagem por reforço permite que os sistemas de IA de visão ultrapassem o simples reconhecimento e comecem a tomar decisões com base no que veem. Isto abre novas possibilidades em áreas como a robótica, a automação e a interação em tempo real.
Eis algumas das principais vantagens de integrar a aprendizagem por reforço nos fluxos de trabalho de IA de visão:
- Menor dependência de dados rotulados: Esses sistemas podem aprender por meio da interação, então não precisam de conjuntos de dados enormes e rotulados para começar.
- Lida melhor com a incerteza: A aprendizagem por reforço pode lidar com informações visuais incompletas ou ruidosas, ajustando as ações com base no feedback, em vez de depender apenas de dados perfeitos.
- Favorece a aprendizagem de longo prazo: Ajuda os modelos a melhorar com o tempo, aprendendo com sequências de ações, e não apenas com decisões de uma única etapa.
Por outro lado, veja algumas limitações da aprendizagem por reforço que devem ser consideradas:
- Problema de atribuição de crédito: Pode ser difícil para o agente descobrir quais ações específicas contribuíram para o resultado final, especialmente em sequências longas de decisões.
- Risco de exploração insegura: Durante o treinamento, o agente pode tentar ações inseguras ou indesejáveis que seriam inaceitáveis em aplicações do mundo real, como na área da saúde ou na condução autônoma.
- Convergência lenta: O modelo pode levar muito tempo para alcançar um bom desempenho, especialmente em tarefas complexas.
Principais conclusões#
A aprendizagem por reforço em projetos de visão computacional permite que sistemas de IA entendam o ambiente ao redor e aprendam a agir por meio da experiência. Com modelos como o Ultralytics YOLO11 oferecendo detecção de objetos em tempo real, o sistema pode tomar decisões informadas com base no que vê.
Esta abordagem vai além dos métodos tradicionais, permitindo que a IA melhore através de tentativas e feedback, em vez de depender exclusivamente de dados anotados. Favorece a aprendizagem contínua e ajuda a criar sistemas de IA de visão mais flexíveis, adaptáveis e inteligentes, que melhoram ao longo do tempo.
Junta-te à nossa comunidade em crescimento. Visita o nosso repositório no GitHub para aprofundares os teus conhecimentos sobre IA. Queres começar os teus próprios projetos de visão computacional? Explora as nossas opções de licenciamento. Sabe mais sobre IA na indústria transformadora e IA de visão no setor automóvel nas nossas páginas de soluções.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









