Entendendo a segmentação de conceitos guiada por prompts
Explore a segmentação de conceitos guiada por prompts, veja como ela difere dos métodos tradicionais e como modelos relacionados, como YOLOE-26, possibilitam recursos de vocabulário aberto.
 Abirami Vina15 min de leitura
A IA visual está a avançar rapidamente e é amplamente utilizada para analisar imagens e vídeos em ambientes reais. Por exemplo, aplicações que vão desde sistemas de gestão do trânsito até análises de varejo estão a ser integradas a modelos de visão computacional.
Em muitas dessas aplicações, os modelos de visão, como os modelos de deteção de objetos, são treinados para reconhecer um conjunto predefinido de objetos, incluindo veículos, pessoas e equipamentos. Durante o treinamento, são apresentados aos modelos muitos exemplos rotulados, para que aprendam a aparência de cada objeto e a distingui-lo dos demais numa cena.
Em tarefas de segmentação, os modelos vão além e produzem contornos precisos desses objetos no nível dos pixels. Isso permite que os sistemas entendam exatamente onde cada objeto está localizado em uma imagem.
Isso funciona bem desde que o sistema só precise reconhecer aquilo para que foi treinado. No entanto, nos ambientes reais, raramente é esse o caso.
As cenas visuais costumam ser dinâmicas. Surgem novos objetos e conceitos visuais, as condições mudam e os usuários frequentemente querem segmentar objetos que não faziam parte da configuração de treinamento original.
Essas limitações ficam especialmente evidentes na segmentação. À medida que a IA visual evolui, cresce a necessidade de modelos de segmentação mais flexíveis, capazes de se adaptar a novos conceitos sem retreinamento repetido. É por isso que a segmentação de conceitos guiada por prompts (PCS) está a ganhar destaque.
Em vez de depender de uma lista fixa de categorias de objetos, os usuários podem descrever o que querem segmentar usando texto, prompts visuais ou imagens de exemplo. Em seguida, esses modelos conseguem identificar e segmentar todas as regiões que correspondem ao conceito descrito, mesmo que ele não tenha sido incluído explicitamente durante o treinamento.
Neste artigo, vamos explorar como funciona a segmentação de conceitos guiada por prompts, em que ela difere das abordagens tradicionais e onde é usada atualmente.
O que é segmentação de conceitos guiada por prompts?#
Na maioria dos casos, os modelos de segmentação são treinados para reconhecer uma pequena lista de tipos de objetos. Isso funciona bem quando um sistema de IA visual precisa apenas detetar e segmentar um conjunto específico de objetos.
Nas aplicações do mundo real, porém, as cenas visuais são dinâmicas. Surgem novos objetos, os requisitos das tarefas mudam e os usuários frequentemente precisam segmentar conceitos que não estavam incluídos no conjunto original de rótulos. Para lidar com essas situações, normalmente é necessário coletar novos dados e anotações de alta qualidade e retreinar o modelo, o que aumenta os custos e atrasa a implantação.
A segmentação de conceitos guiada por prompts resolve esse problema permitindo que os usuários indiquem ao modelo o que procurar, em vez de escolherem entre uma lista fixa de rótulos. Os usuários descrevem o objeto ou a ideia que procuram, e o modelo destaca todas as áreas correspondentes na imagem. Isso facilita muito relacionar a intenção do usuário aos pixels efetivamente presentes na imagem.
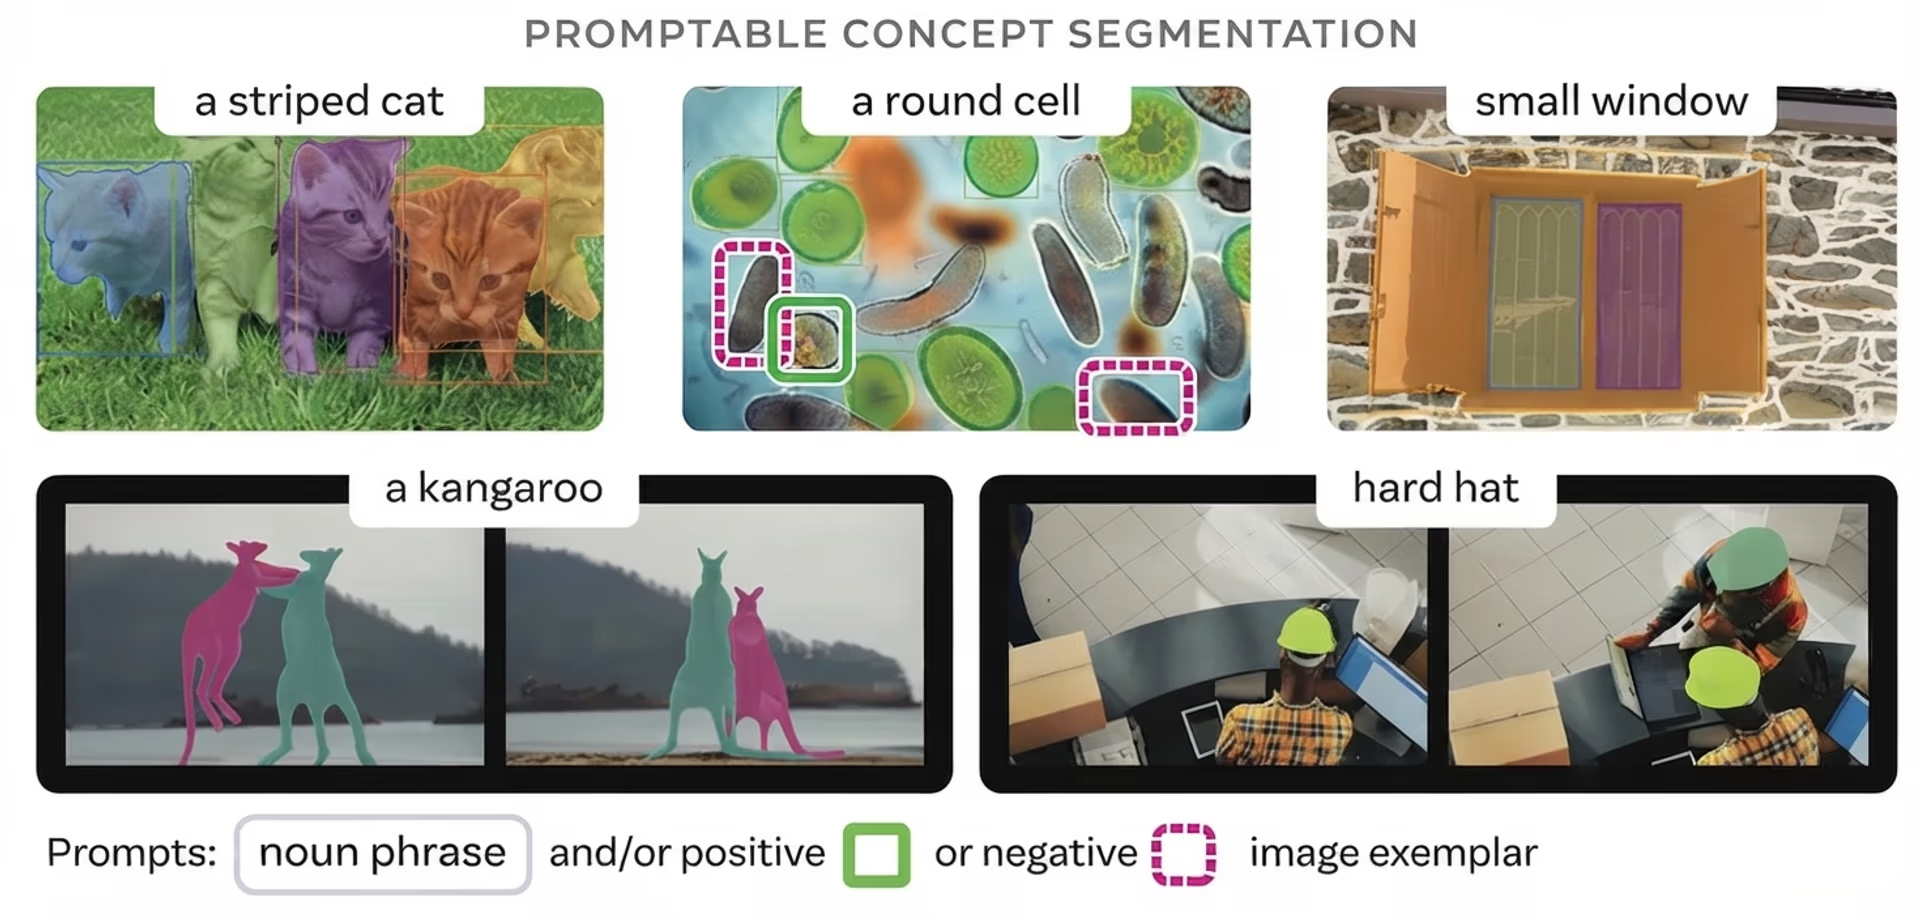
Fig. 1. Exemplo do uso de prompts de conceito para segmentação (Fonte)
Orientar a segmentação com diferentes tipos de prompts#
Os modelos compatíveis com a segmentação de conceitos guiada por prompts são flexíveis porque aceitam diferentes tipos de entrada. Ou seja, há mais de uma maneira de indicar ao modelo o que procurar, como descrições de texto, indicações visuais ou imagens de exemplo.
Veja cada abordagem mais de perto:
- Prompts de texto: Frases curtas como “ônibus escolar” ou “região tumoral” podem ser usadas para descrever o conceito a segmentar. O modelo interpreta o significado das palavras e identifica as regiões correspondentes.
- Prompts visuais: Esses prompts usam pontos, caixas ou esboços aproximados dentro da imagem como indicações. Essas pistas orientam onde procurar e ajudam a definir o contorno final.
- Imagens de referência: Imagens de referência ou pequenos recortes representam o conceito de interesse. O modelo procura regiões visualmente semelhantes e segmenta-as com base na aparência.
Diferenças entre PCS e a segmentação tradicional#
Antes de explorarmos como funciona a segmentação de conceitos guiada por prompts, vamos compará-la com vários métodos tradicionais de segmentação de objetos.
A PCS permite criar modelos de vocabulário aberto e guiados por prompts. Ela pode trabalhar com novas ideias descritas por prompts, ao contrário da segmentação tradicional. Existem vários tipos de abordagens tradicionais de segmentação, cada uma com os seus próprios pressupostos e limitações.
Veja alguns dos principais tipos de segmentação tradicional:
- Segmentação semântica: Cada pixel da imagem é rotulado como parte de uma categoria, como estrada, edifício ou pessoa. Todos os pixels com o mesmo rótulo são agrupados, por isso o modelo não separa as instâncias individuais dos objetos.
- Segmentação de instâncias: O modelo identifica e segmenta objetos individuais, tratando duas pessoas ou dois carros como elementos separados.
- Segmentação panóptica: Esta técnica combina a segmentação semântica e a segmentação de instâncias para oferecer uma visão completa da cena, incluindo tanto as regiões de fundo como os objetos individuais.
Todas essas abordagens dependem de uma lista predefinida de categorias de objetos. Funcionam bem dentro desse escopo, mas não lidam muito bem com conceitos que ficam fora dele. Quando é preciso segmentar um novo objeto específico, geralmente são necessários dados de treinamento adicionais e ajustes finos do modelo.
A PCS pretende mudar isso. Em vez de ficar limitada a categorias predefinidas, permite descrever o que queres segmentar numa imagem no momento da inferência.
A evolução dos modelos PCS#
A seguir, vamos percorrer a evolução dos modelos de segmentação até à segmentação de conceitos guiada por prompts.
Um modelo de base popular que marcou uma mudança na segmentação foi o SAM, ou Modelo Segment Anything. Foi apresentado em 2023. Em vez de depender de categorias de objetos predefinidas, o SAM permitia que os usuários orientassem a segmentação com prompts visuais simples, como pontos ou caixas delimitadoras.
Com o SAM, os usuários já não precisavam selecionar um rótulo. Bastava indicar onde estava um objeto para o modelo gerar uma máscara para ele. Isso tornou a segmentação mais flexível, mas os usuários ainda precisavam mostrar ao modelo onde procurar.
O SAM 2, lançado em 2024, desenvolveu essa ideia ao lidar com cenas mais complexas e estender a segmentação guiada por prompts a vídeos. O modelo tornou-se mais robusto diante de diferentes condições de iluminação, formatos de objetos e movimentos, mas continuou a depender sobretudo de prompts visuais para orientar a segmentação.
O modelo SAM 3 é a etapa mais recente dessa evolução. Lançado no ano passado, é um modelo unificado que combina compreensão visual e orientação por linguagem, permitindo um comportamento consistente em tarefas de segmentação de imagens e vídeos.
Com o SAM 3, os usuários não se limitam a indicar pontos ou desenhar prompts. Em vez disso, podem descrever em texto o que querem segmentar, e o modelo procura regiões que correspondam à descrição na imagem ou nos quadros do vídeo.
A segmentação é orientada por conceitos, em vez de categorias fixas de objetos, permitindo o uso de vocabulário aberto em diferentes cenas e ao longo do tempo. Na verdade, o SAM 3 opera em um amplo espaço de conceitos aprendido, fundamentado em uma ontologia derivada de fontes como o Wikidata e expandido por meio de dados de treinamento em grande escala.
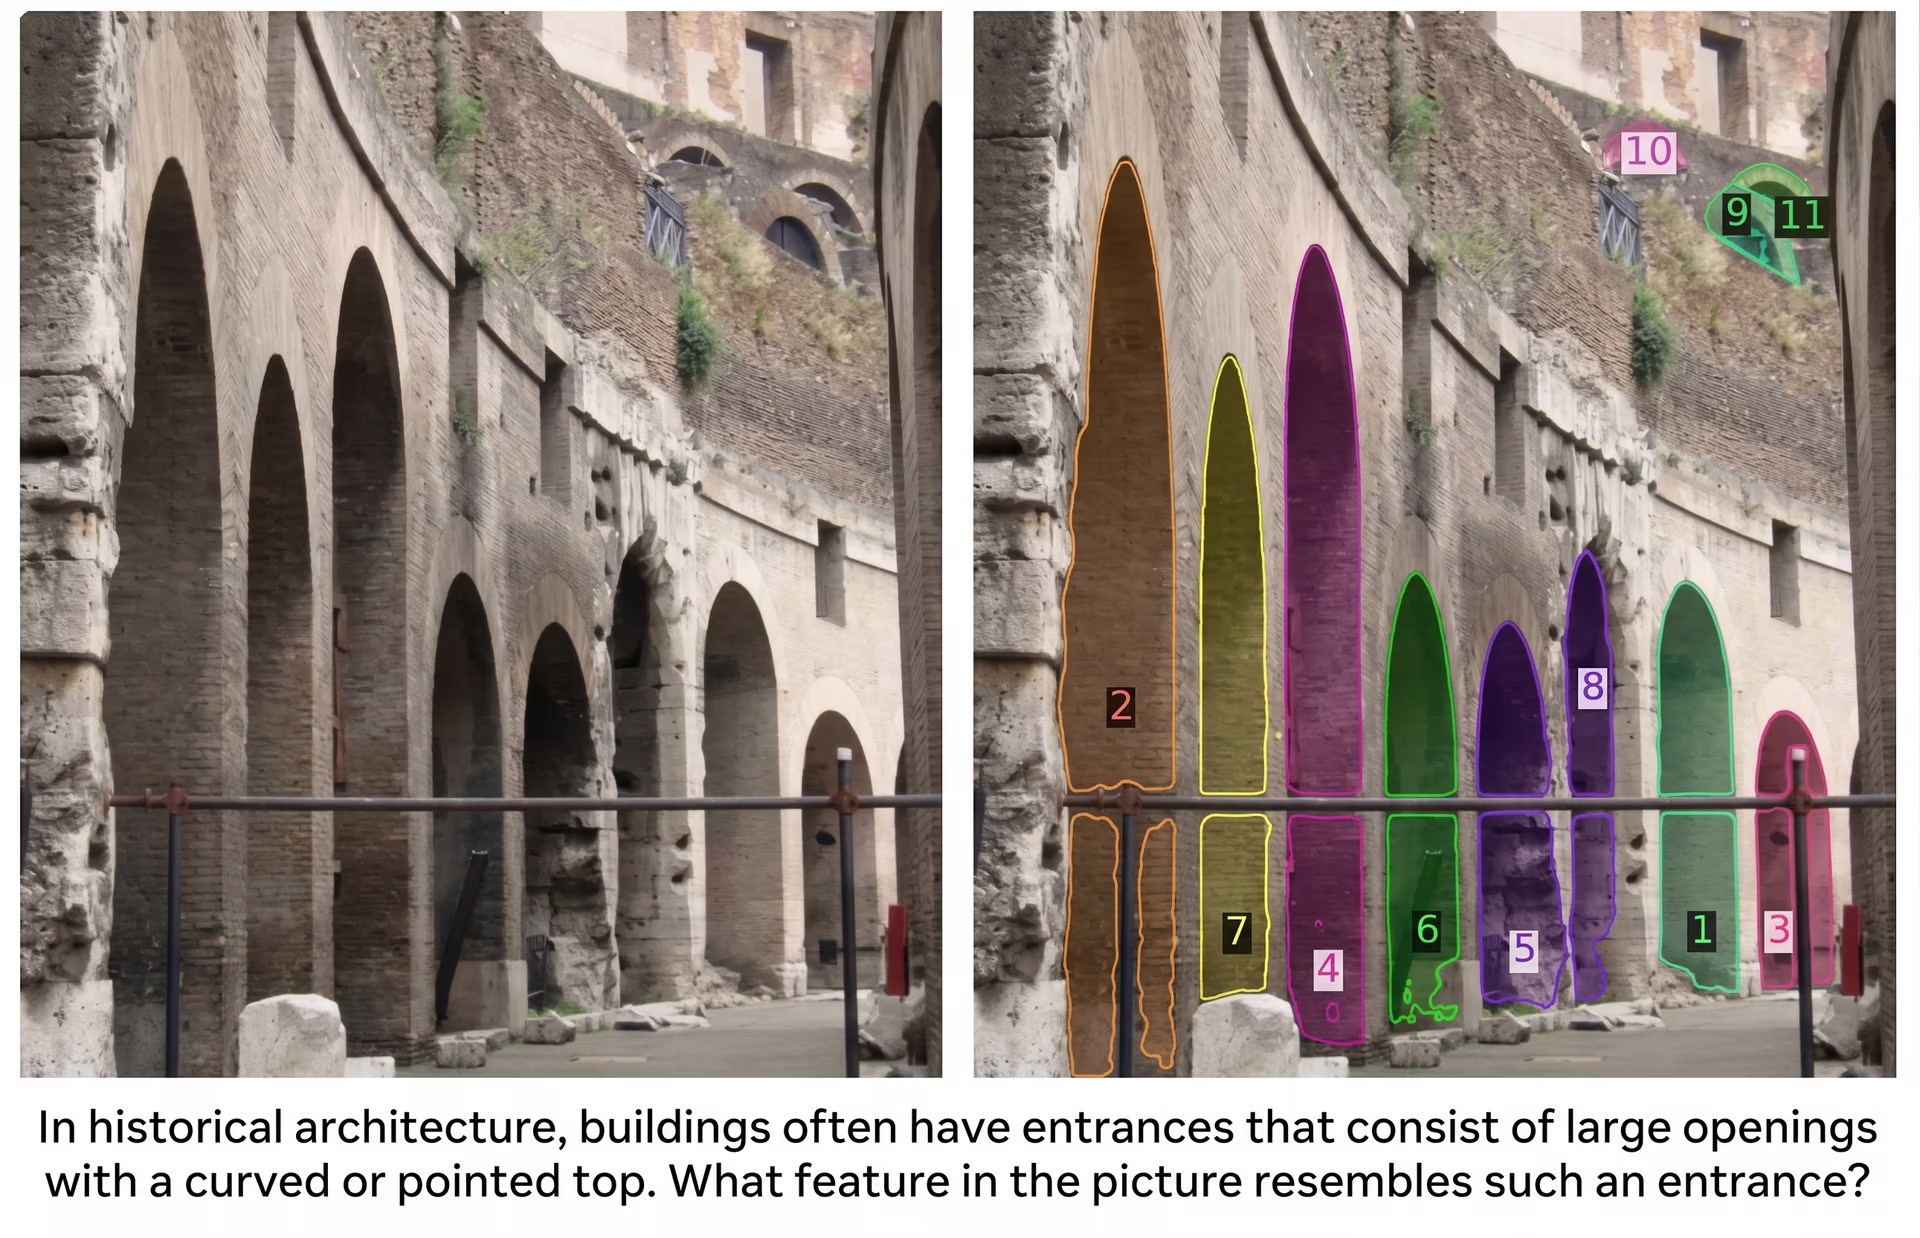
Fig. 2. Exemplo de como solicitar ao SAM 3 que segmente uma única imagem (Fonte)
Em comparação com as versões anteriores, que dependiam principalmente de prompts geométricos, o SAM 3 representa um passo rumo a uma segmentação mais flexível e orientada por conceitos. Isso o torna mais adequado para aplicações do mundo real, nas quais os objetos ou conceitos de interesse podem mudar e nem sempre podem ser definidos de antemão.
Explorando o funcionamento da segmentação de conceitos orientada por prompts#
Então, como funciona a segmentação de conceitos orientada por prompts? Ela se baseia em grandes modelos de visão e linguagem pré-treinados, treinados com enormes coleções de imagens e, em muitos casos, com textos associados. Esse treinamento permite que aprendam padrões visuais gerais e significados semânticos.
A maioria dos modelos PCS usa arquiteturas baseadas em Transformer, que processam uma imagem inteira de uma só vez para entender como as diferentes regiões se relacionam. Um Transformer de visão extrai características visuais da imagem, enquanto um codificador de texto converte palavras em representações numéricas que o modelo pode processar.
Durante o treinamento, esses modelos podem aprender com diferentes tipos de supervisão, incluindo máscaras em nível de pixel que definem limites exatos dos objetos, caixas delimitadoras que localizam os objetos aproximadamente e rótulos em nível de imagem que descrevem o que aparece em uma imagem. O treinamento com diferentes tipos de dados rotulados ajuda o modelo a capturar tanto detalhes minuciosos quanto conceitos visuais mais amplos.
No momento da inferência, ou seja, quando o modelo é realmente usado para fazer previsões, a PCS segue um processo orientado por prompts. O usuário fornece orientações por meio de descrições textuais, indicações visuais, como pontos ou caixas, ou imagens de exemplo. O modelo codifica o prompt e a imagem em uma representação interna compartilhada, ou embeddings, e identifica regiões que correspondem ao conceito descrito.
Em seguida, um decodificador de máscaras converte essa representação compartilhada em máscaras de segmentação precisas em nível de pixel. Como o modelo associa características visuais a significados semânticos, ele pode segmentar novos conceitos mesmo que eles não tenham sido incluídos explicitamente durante o treinamento.
Além disso, muitas vezes é possível refinar o resultado ajustando o prompt ou adicionando instruções, o que ajuda o modelo a lidar com cenas complexas ou ambíguas. Esse processo iterativo permite otimizações práticas durante a implantação.
Os modelos de segmentação de conceitos orientada por prompts geralmente são avaliados pela capacidade de segmentar conceitos nunca vistos e pelo desempenho robusto em diferentes cenas. Os benchmarks costumam se concentrar na qualidade das máscaras, na generalização e na eficiência computacional, refletindo os requisitos de implantação no mundo real.
Casos de uso reais da PCS#
Agora, vamos ver onde a segmentação de conceitos orientada por prompts já está sendo usada e começando a causar um impacto real.
Segmentação flexível para imagens médicas#
As imagens médicas abrangem muitas estruturas biológicas, doenças e tipos de exames, e novos casos surgem todos os dias. Os modelos tradicionais de segmentação têm dificuldade para acompanhar essa variedade.
A PCS se encaixa naturalmente nesse contexto porque permite que os profissionais de saúde descrevam o que querem encontrar, em vez de escolher entre uma lista curta e rígida. Com frases de texto ou prompts visuais, a PCS pode ser usada para segmentar órgãos ou áreas preocupantes diretamente, sem retreinar o modelo para cada nova tarefa. Isso facilita o atendimento a diversas necessidades clínicas, reduz a necessidade de desenhar máscaras manualmente e funciona com muitos tipos de exames de imagem.
Um ótimo exemplo é o MedSAM-3, que adapta a arquitetura SAM 3 para PCS orientada por prompts de texto em imagens médicas. É possível fornecer ao modelo termos anatômicos e patológicos explícitos como prompts, por exemplo, nomes de órgãos como fígado ou rim e conceitos relacionados a lesões, como tumor ou lesão. Com um prompt, o modelo segmenta diretamente a região correspondente na imagem médica.
O MedSAM-3 também integra grandes modelos multimodais de linguagem (MLLMs ou LLMs multimodais), que conseguem raciocinar tanto sobre texto quanto sobre imagens. Esses modelos operam em uma configuração com um agente no circuito, na qual os resultados são refinados iterativamente para melhorar a precisão em casos mais desafiadores.
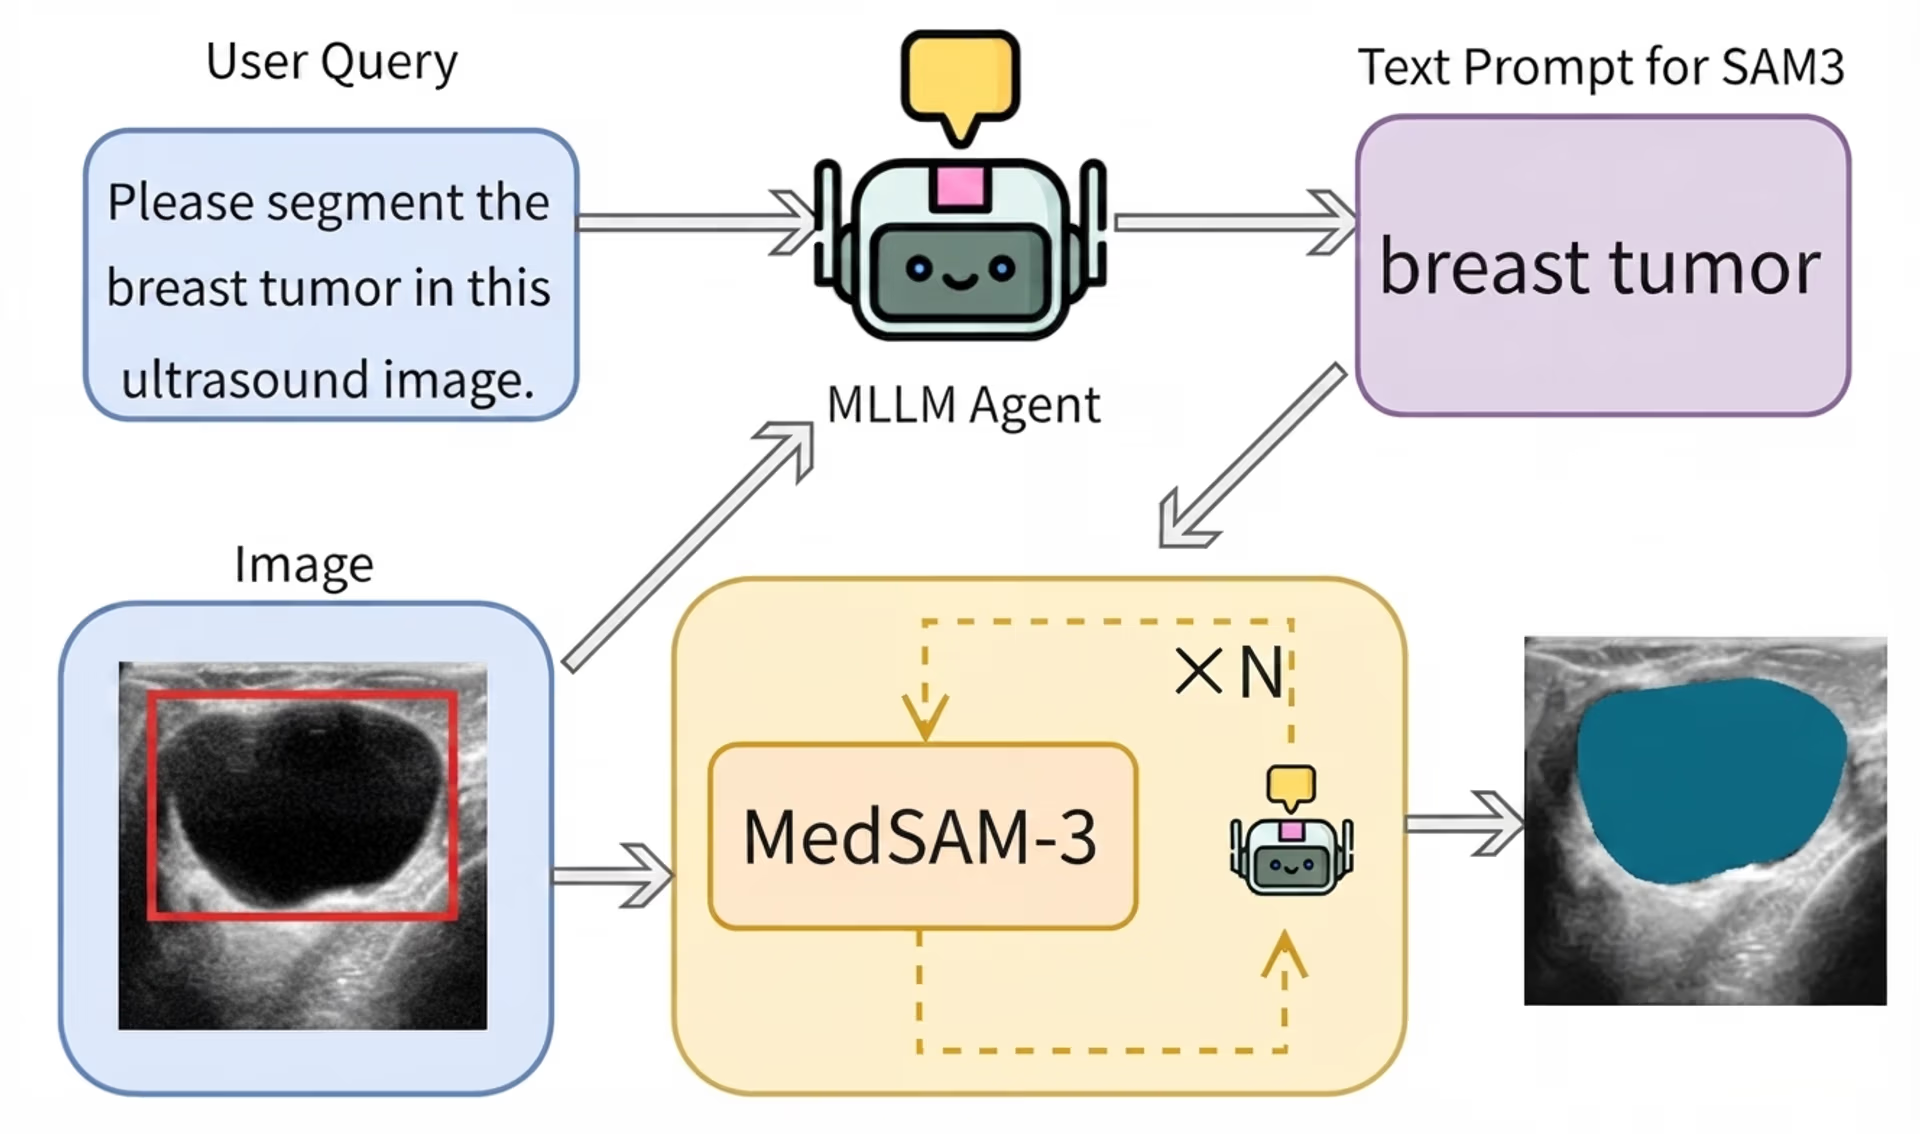
Fig. 3. Pipeline do MedSAM-3 para segmentação de tumores em imagens médicas orientada por prompts de texto (Fonte)
O MedSAM-3 apresenta bom desempenho com dados de raios X, MRI, CT, ultrassom e vídeo, demonstrando como a PCS pode viabilizar fluxos de trabalho de imagens médicas mais flexíveis e eficientes em contextos clínicos reais.
Segmentação adaptativa para cirurgia robótica e automação#
A cirurgia robótica depende de sistemas de visão para acompanhar instrumentos e entender cenas cirúrgicas em rápida transformação. Os instrumentos se movem rapidamente, a iluminação varia e novas ferramentas podem surgir a qualquer momento, o que dificulta manter sistemas de rótulos predefinidos.
Com a PCS, os robôs podem acompanhar instrumentos, orientar câmeras e seguir etapas cirúrgicas em tempo real. Isso reduz a rotulagem manual e facilita a adaptação dos sistemas a diferentes procedimentos. Cirurgiões ou sistemas automatizados podem usar prompts de texto como “pinça”, “bisturi” ou “instrumento de câmera” para indicar o que deve ser segmentado em uma imagem.
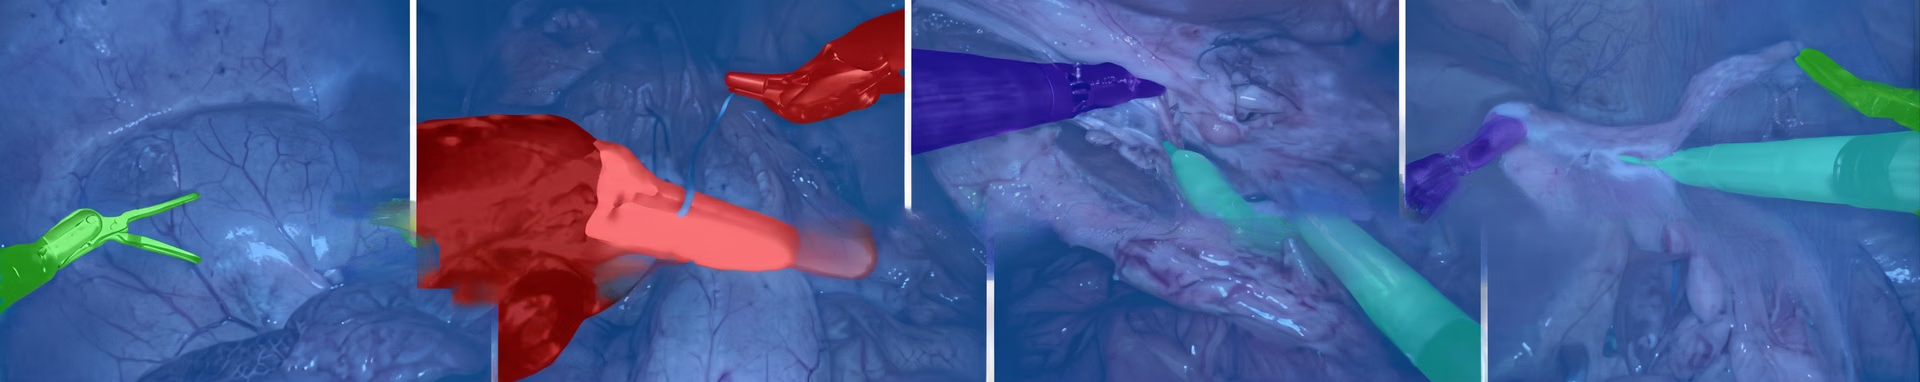
Fig. 4. Segmentação de instrumentos cirúrgicos usados durante uma cirurgia robótica (Fonte)
Segmentação de vocabulário aberto com Ultralytics YOLOE-26#
Outro modelo de ponta interessante relacionado à segmentação de conceitos orientada por prompts é o Ultralytics YOLOE-26. Ele traz a segmentação de vocabulário aberto orientada por prompts para a família de modelos Ultralytics YOLO.
O YOLOE-26 é baseado na arquitetura Ultralytics YOLO26 e oferece suporte à segmentação de instâncias com vocabulário aberto. O YOLOE-26 permite que os usuários orientem a segmentação de várias maneiras.
Ele oferece suporte a prompts de texto, nos quais frases curtas fundamentadas visualmente podem especificar o objeto-alvo, bem como a prompts visuais, que fornecem instruções adicionais com base em pistas da imagem. Além disso, o YOLOE-26 inclui um modo sem prompts para inferência zero-shot, no qual o modelo detecta e segmenta objetos a partir de um vocabulário integrado sem exigir prompts do usuário.
O YOLOE-26 é excelente para aplicações como análise de vídeo, percepção robótica e sistemas de borda, em que as categorias de objetos podem mudar, mas a baixa latência e a taxa de transferência confiável continuam sendo essenciais. Ele também é especialmente útil para rotulagem de dados e curadoria de conjuntos de dados, pois simplifica os fluxos de trabalho ao automatizar partes do processo de anotação.
Vantagens e desvantagens da segmentação de conceitos orientada por prompts#
Confira alguns dos principais benefícios de usar a segmentação de conceitos orientada por prompts:
- Iteração e prototipagem mais rápidas: novas tarefas de segmentação podem ser testadas rapidamente alterando os prompts, em vez de reconstruir conjuntos de dados ou retreinar modelos, o que acelera a experimentação e o desenvolvimento.
- Adaptabilidade entre domínios: muitas vezes, o mesmo modelo PCS pode ser aplicado a diferentes domínios, como imagens médicas, robótica ou análise de vídeo, com mudanças mínimas no fluxo de trabalho.
- Refinamento interativo: os usuários podem ajustar os prompts iterativamente ou adicionar instruções para melhorar os resultados, facilitando o tratamento de cenas ambíguas ou casos extremos sem retreinamento.
Embora a PCS tenha vantagens claras, aqui estão algumas limitações a considerar:
- Sensibilidade aos prompts: pequenas mudanças na forma como um prompt é escrito ou fornecido podem afetar o resultado. Prompts vagos ou específicos demais podem levar a uma segmentação incompleta ou incorreta.
- Comportamento menos previsível: como o modelo interpreta prompts em vez de selecionar rótulos fixos, os resultados podem variar mais entre cenas e entradas, o que pode ser um problema em pipelines rigorosamente controlados.
- Interpretação ambígua de conceitos: alguns conceitos são subjetivos ou definidos de forma imprecisa, o que pode levar a resultados de segmentação inconsistentes entre usuários ou imagens.
- Confiabilidade limitada para alvos muito específicos: em geral, os modelos baseados em prompts são menos confiáveis para tarefas específicas de instâncias definidas de forma restrita, como a detecção de defeitos, que exige a identificação precisa e consistente de características sutis.
Como escolher entre segmentação orientada por prompts e segmentação tradicional#
Ao explorar a segmentação orientada por prompts, você talvez se pergunte para quais aplicações ela é mais indicada e em que situações um modelo tradicional de visão computacional, como o Ultralytics YOLO26, é mais adequado ao problema que você quer resolver. A segmentação orientada por prompts funciona bem para objetos em geral, mas não é indicada para casos de uso que exigem resultados muito precisos e consistentes.
A detecção de defeitos é um bom exemplo. Na fabricação, os defeitos costumam ser minúsculos e sutis, como pequenos arranhões, amassados, desalinhamentos ou irregularidades na superfície. Eles também podem variar bastante dependendo dos materiais, da iluminação e das condições de produção.
É difícil descrever esses problemas com um prompt simples e ainda mais difícil para um modelo de uso geral detectá-los de forma confiável. Em geral, os modelos baseados em prompts tendem a não detectar os defeitos ou a produzir resultados instáveis, enquanto os modelos treinados especificamente com dados de defeitos são muito mais confiáveis para sistemas de inspeção no mundo real.
Principais conclusões#
A segmentação de conceitos orientada por prompts facilita a adaptação dos sistemas de visão ao mundo real, onde novos objetos e conceitos surgem o tempo todo. Em vez de ficarem limitados a rótulos fixos, os usuários podem simplesmente descrever o que querem segmentar e deixar o modelo fazer o resto, economizando tempo e reduzindo o trabalho manual. Embora ainda tenha limitações, a PCS já está mudando a forma como a segmentação é usada na prática e provavelmente se tornará uma parte essencial dos futuros sistemas de visão.
Saiba mais sobre IA visitando nosso repositório do GitHub e participando da nossa comunidade. Confira nossas páginas de soluções para saber mais sobre IA em robótica e visão computacional na fabricação. Conheça nossas opções de licenciamento e comece hoje mesmo a trabalhar com IA de visão!
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









