Entenda os modelos de visão e linguagem e suas aplicações
Saiba mais sobre os modelos de visão e linguagem, como funcionam e suas diversas aplicações em IA. Descubra como esses modelos combinam recursos visuais e linguísticos.
Num artigo anterior, explorámos como o GPT-4o consegue compreender e descrever imagens usando palavras. Também vemos esta capacidade noutros modelos recentes, como o Google Gemini e o Claude 3. Hoje, vamos aprofundar este conceito para explicar como funcionam os Modelos de Linguagem e Visão e como combinam dados visuais e textuais.
Estes modelos podem ser usados para realizar várias tarefas impressionantes, como gerar legendas detalhadas para fotografias, responder a perguntas sobre imagens e até criar novos conteúdos visuais com base em descrições textuais. Ao integrar perfeitamente informações visuais e linguísticas, os Modelos de Linguagem e Visão estão a mudar a forma como interagimos com a tecnologia e compreendemos o mundo à nossa volta.
Como funcionam os modelos de linguagem e visão#
Antes de vermos onde os Modelos de Linguagem e Visão (VLMs) podem ser usados, vamos compreender o que são e como funcionam. Os VLMs são modelos avançados de IA que combinam as capacidades dos modelos de visão e de linguagem para processar imagens e texto. Estes modelos recebem imagens juntamente com as respetivas descrições textuais e aprendem a estabelecer ligações entre ambas. A componente de visão do modelo capta detalhes das imagens, enquanto a componente de linguagem compreende o texto. Esta colaboração permite aos VLMs compreender e analisar imagens e texto.
Estas são as principais capacidades dos Modelos de Linguagem e Visão:
- Geração de legendas para imagens: Geração de texto descritivo com base no conteúdo das imagens.
- Perguntas e respostas visuais (VQA): Respostas a perguntas relacionadas com o conteúdo de uma imagem.
- Geração deimagensa partir de texto: Criação de imagens com base em descrições textuais.
- Pesquisa de imagens por texto: Encontrar imagens relevantes para uma consulta textual e vice-versa.
- Criação de conteúdos multimodais: Combinar imagens e texto para gerar novos conteúdos.
- Compreensão de cenas edeteção de objetos: Identificar e categorizar objetos e detalhes numa imagem.
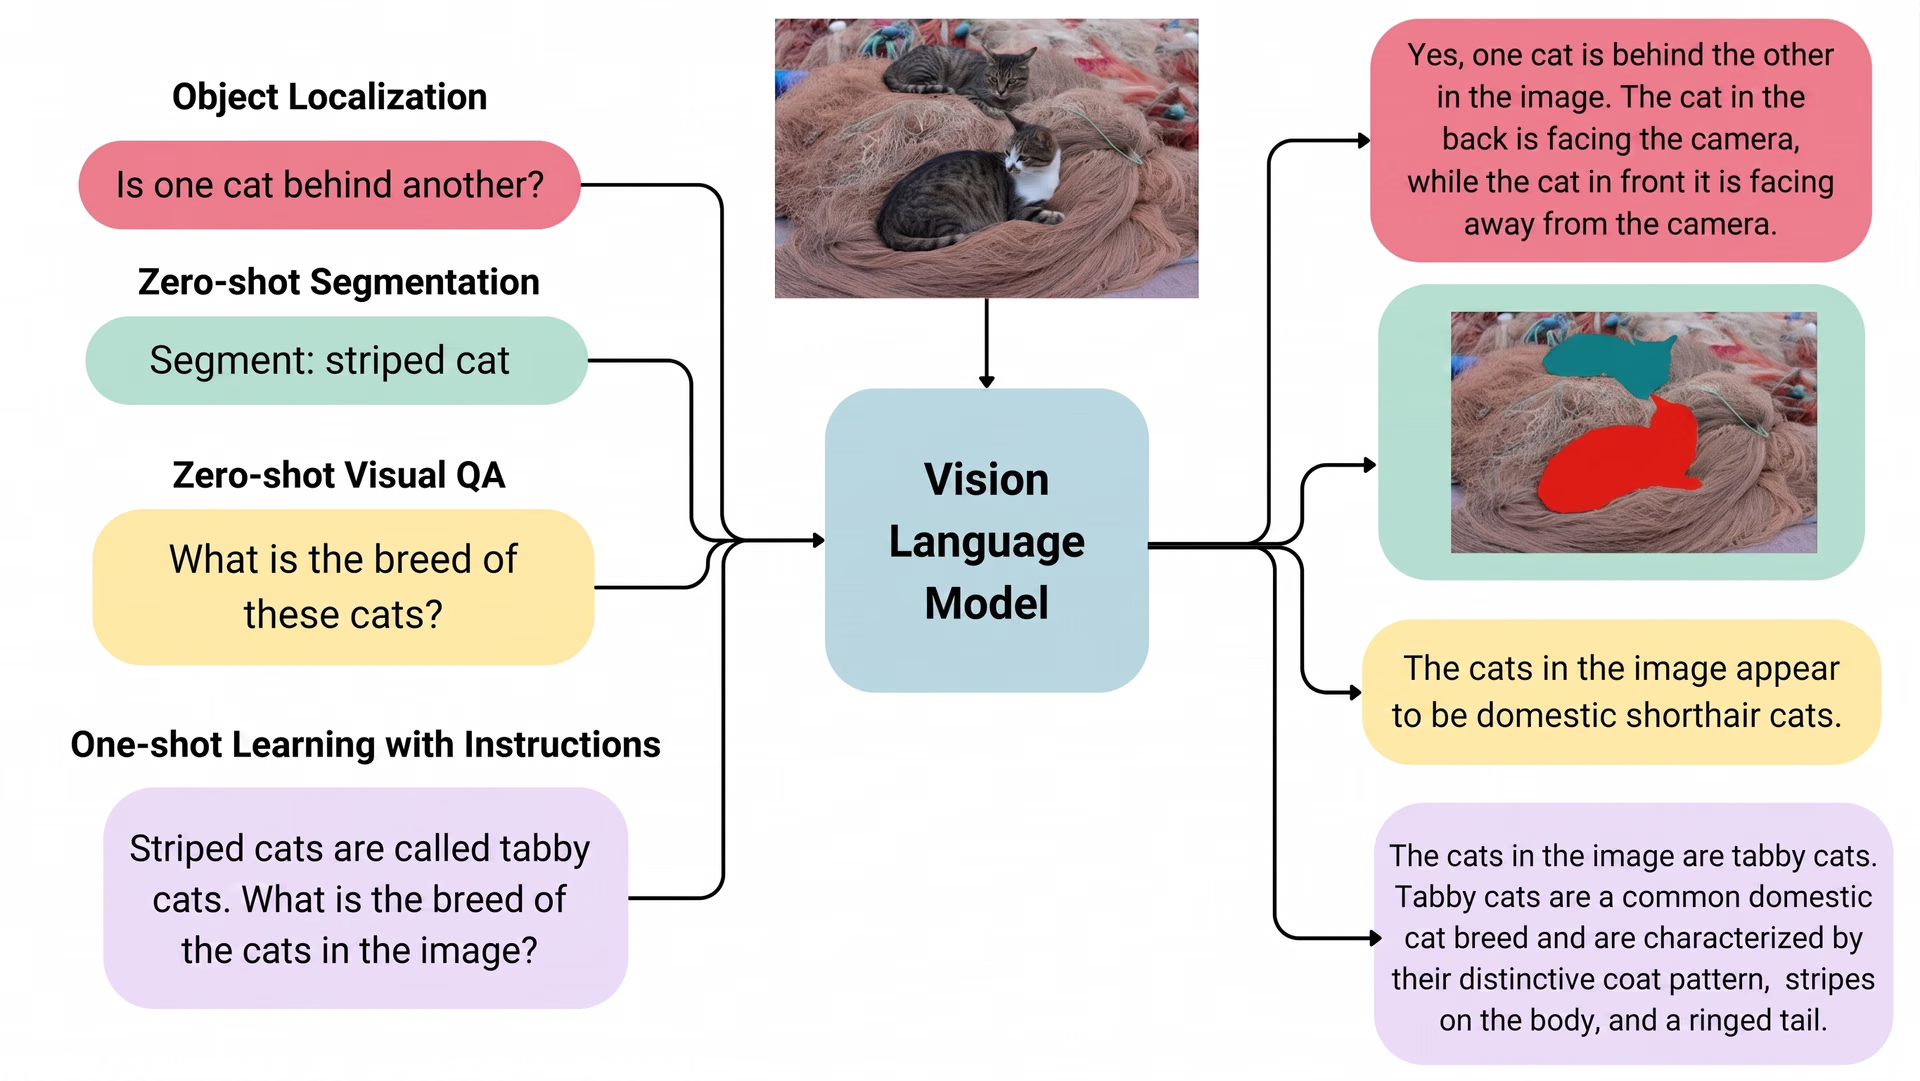
Fig. 1. Um exemplo das capacidades de um modelo de linguagem e visão.
A seguir, vamos explorar arquiteturas comuns de VLMs e técnicas de aprendizagem usadas por modelos conhecidos, como CLIP, SimVLM e VisualGPT.
Aprendizagem contrastiva#
A aprendizagem contrastiva é uma técnica que ajuda os modelos a aprender comparando as diferenças entre pontos de dados. Calcula a semelhança ou a diferença entre instâncias e procura minimizar a perda contrastiva, que mede essas diferenças. É especialmente útil na aprendizagem semissupervisionada, em que um pequeno conjunto de exemplos anotados orienta o modelo na anotação de dados novos e ainda não vistos. Por exemplo, para compreender o aspeto de um gato, o modelo compara-o com imagens de gatos semelhantes e de cães. Ao identificar características como a estrutura facial, o tamanho do corpo e o pelo, as técnicas de aprendizagem contrastiva conseguem distinguir um gato de um cão.
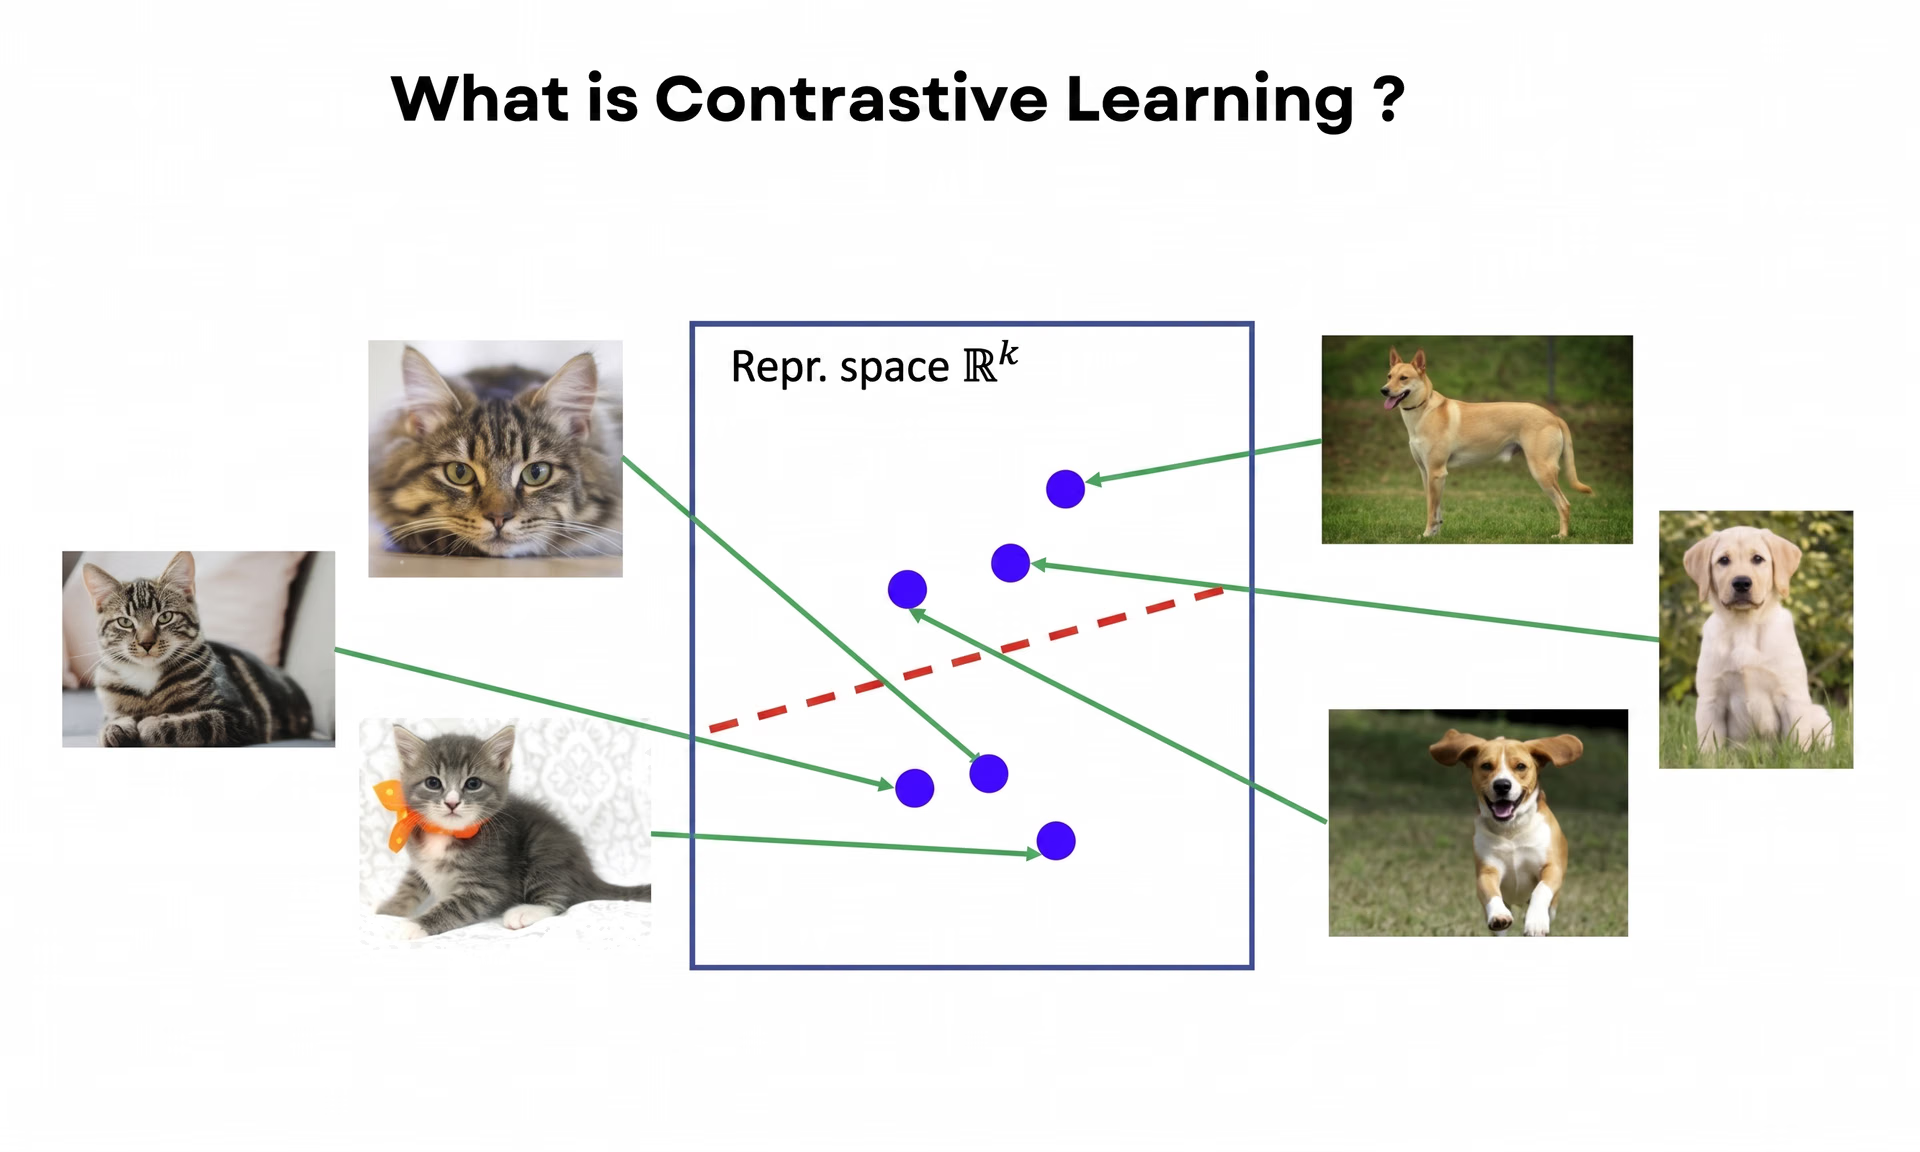
Fig. 2. Como funciona a aprendizagem contrastiva.
O CLIP é um Modelo de Linguagem e Visão que usa aprendizagem contrastiva para associar descrições textuais a imagens. Funciona em três passos simples. Primeiro, treina as partes do modelo que compreendem texto e imagens. Segundo, converte as categorias de um conjunto de dados em descrições textuais. Terceiro, identifica a descrição que melhor corresponde a uma determinada imagem. Graças a este método, o modelo CLIP consegue fazer previsões precisas até mesmo em tarefas para as quais não foi especificamente treinado.
PrefixLM#
PrefixLM é uma técnica de Processamento de Linguagem Natural (NLP) usada para treinar modelos. Começa com parte de uma frase (um prefixo) e aprende a prever a palavra seguinte. Nos Modelos de Linguagem e Visão, o PrefixLM ajuda o modelo a prever as palavras seguintes com base numa imagem e num trecho de texto fornecido. Usa um Vision Transformer (ViT), que divide uma imagem em pequenos recortes, cada um representando uma parte da imagem, e processa-os em sequência.
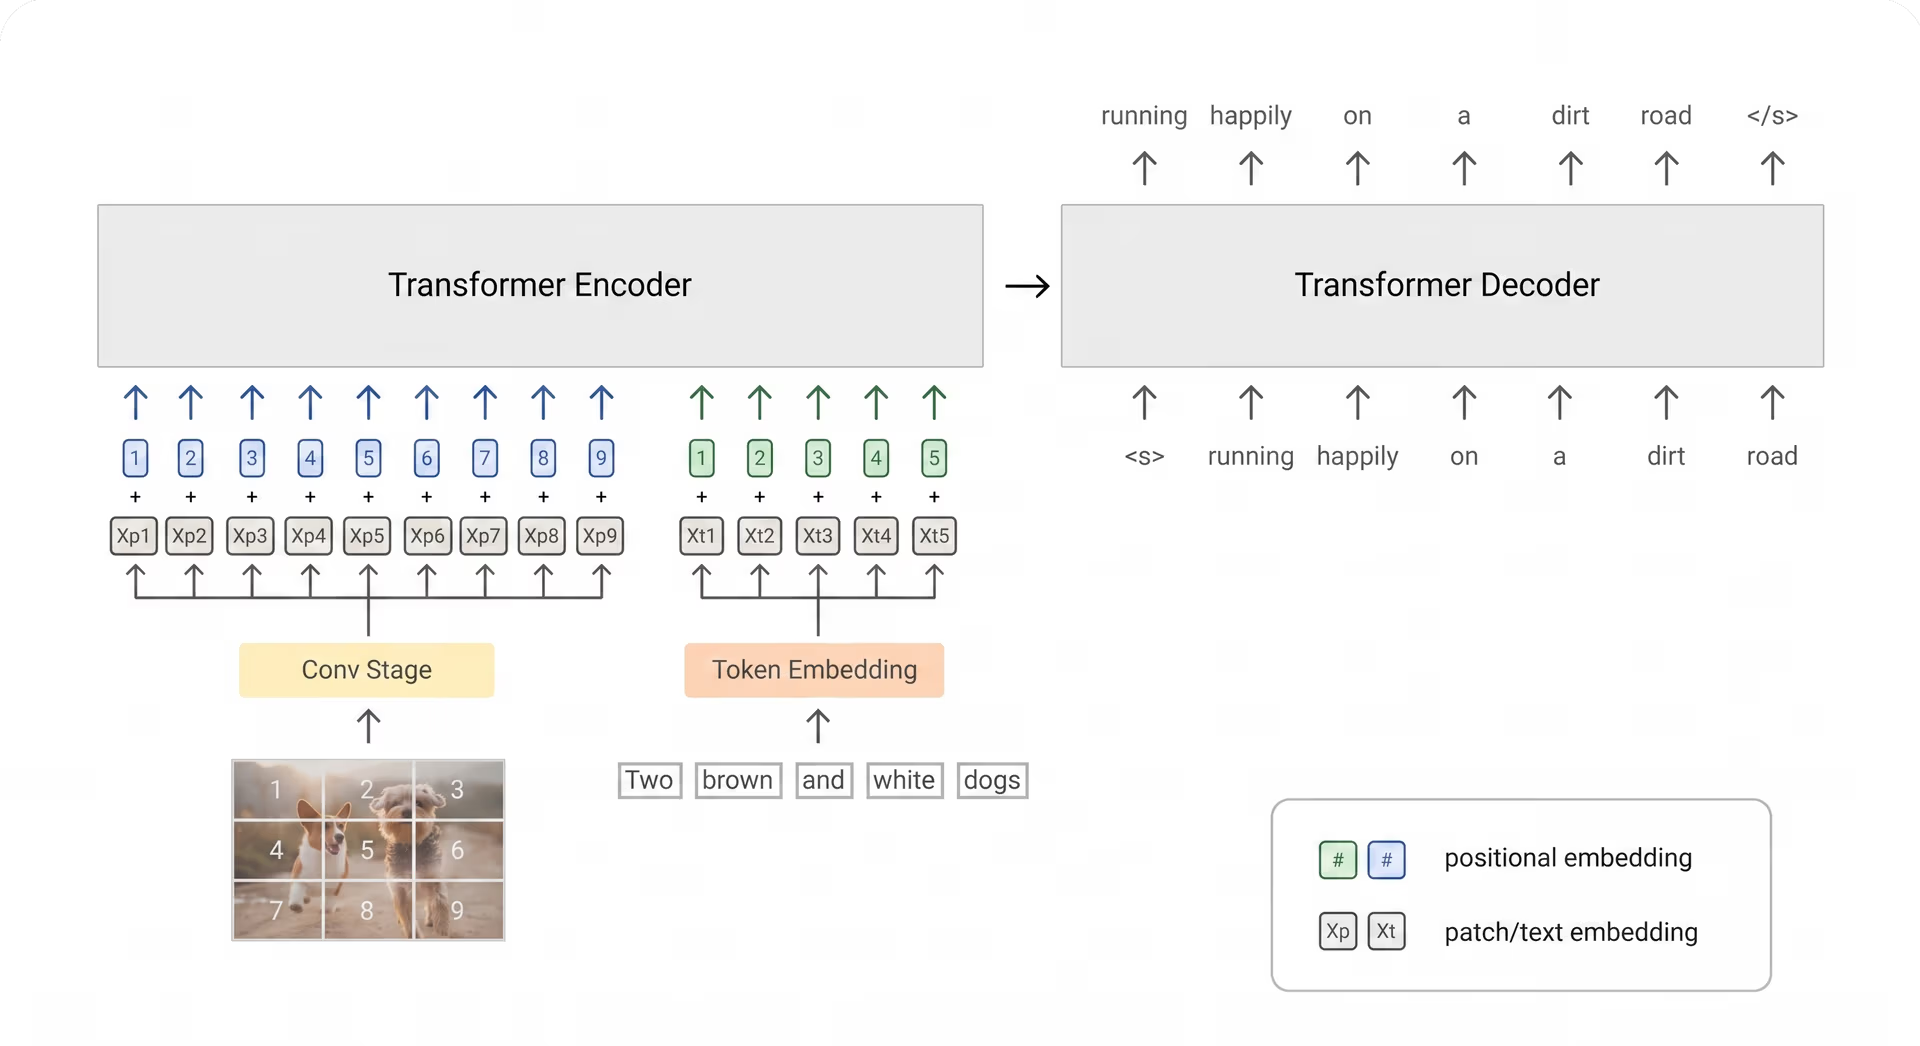
Fig. 3. Um exemplo do treino de um VLM que usa a técnica PrefixLM.
O SimVLM é um VLM que usa a técnica de aprendizagem PrefixLM. Usa uma arquitetura Transformer mais simples do que os modelos anteriores, mas alcança melhores resultados em vários testes. A arquitetura do modelo consiste em aprender a associar imagens a prefixos de texto com um codificador Transformer e, em seguida, gerar texto com um descodificador Transformer.
Fusão multimodal com atenção cruzada#
A fusão multimodal com atenção cruzada é uma técnica que melhora a capacidade de um Modelo de Linguagem e Visão pré-treinado para compreender e processar dados visuais. Funciona adicionando camadas de atenção cruzada ao modelo, o que lhe permite prestar atenção às informações visuais e textuais ao mesmo tempo.
Eis como funciona:
- Os objetos principais de uma imagem são identificados e destacados.
- Os objetos destacados são processados por um codificador visual, que converte as informações visuais num formato que o modelo consegue compreender.
- As informações visuais são transmitidas a um descodificador, que interpreta a imagem com base nos conhecimentos do modelo de linguagem pré-treinado.
O VisualGPT é um bom exemplo de modelo que usa esta técnica. Inclui uma funcionalidade especial chamada unidade de ativação autorregenerativa (SRAU), que ajuda o modelo a evitar um problema comum chamado desaparecimento do gradiente. O desaparecimento do gradiente pode fazer com que os modelos percam informações importantes durante o treino, mas a SRAU mantém o desempenho do modelo elevado.
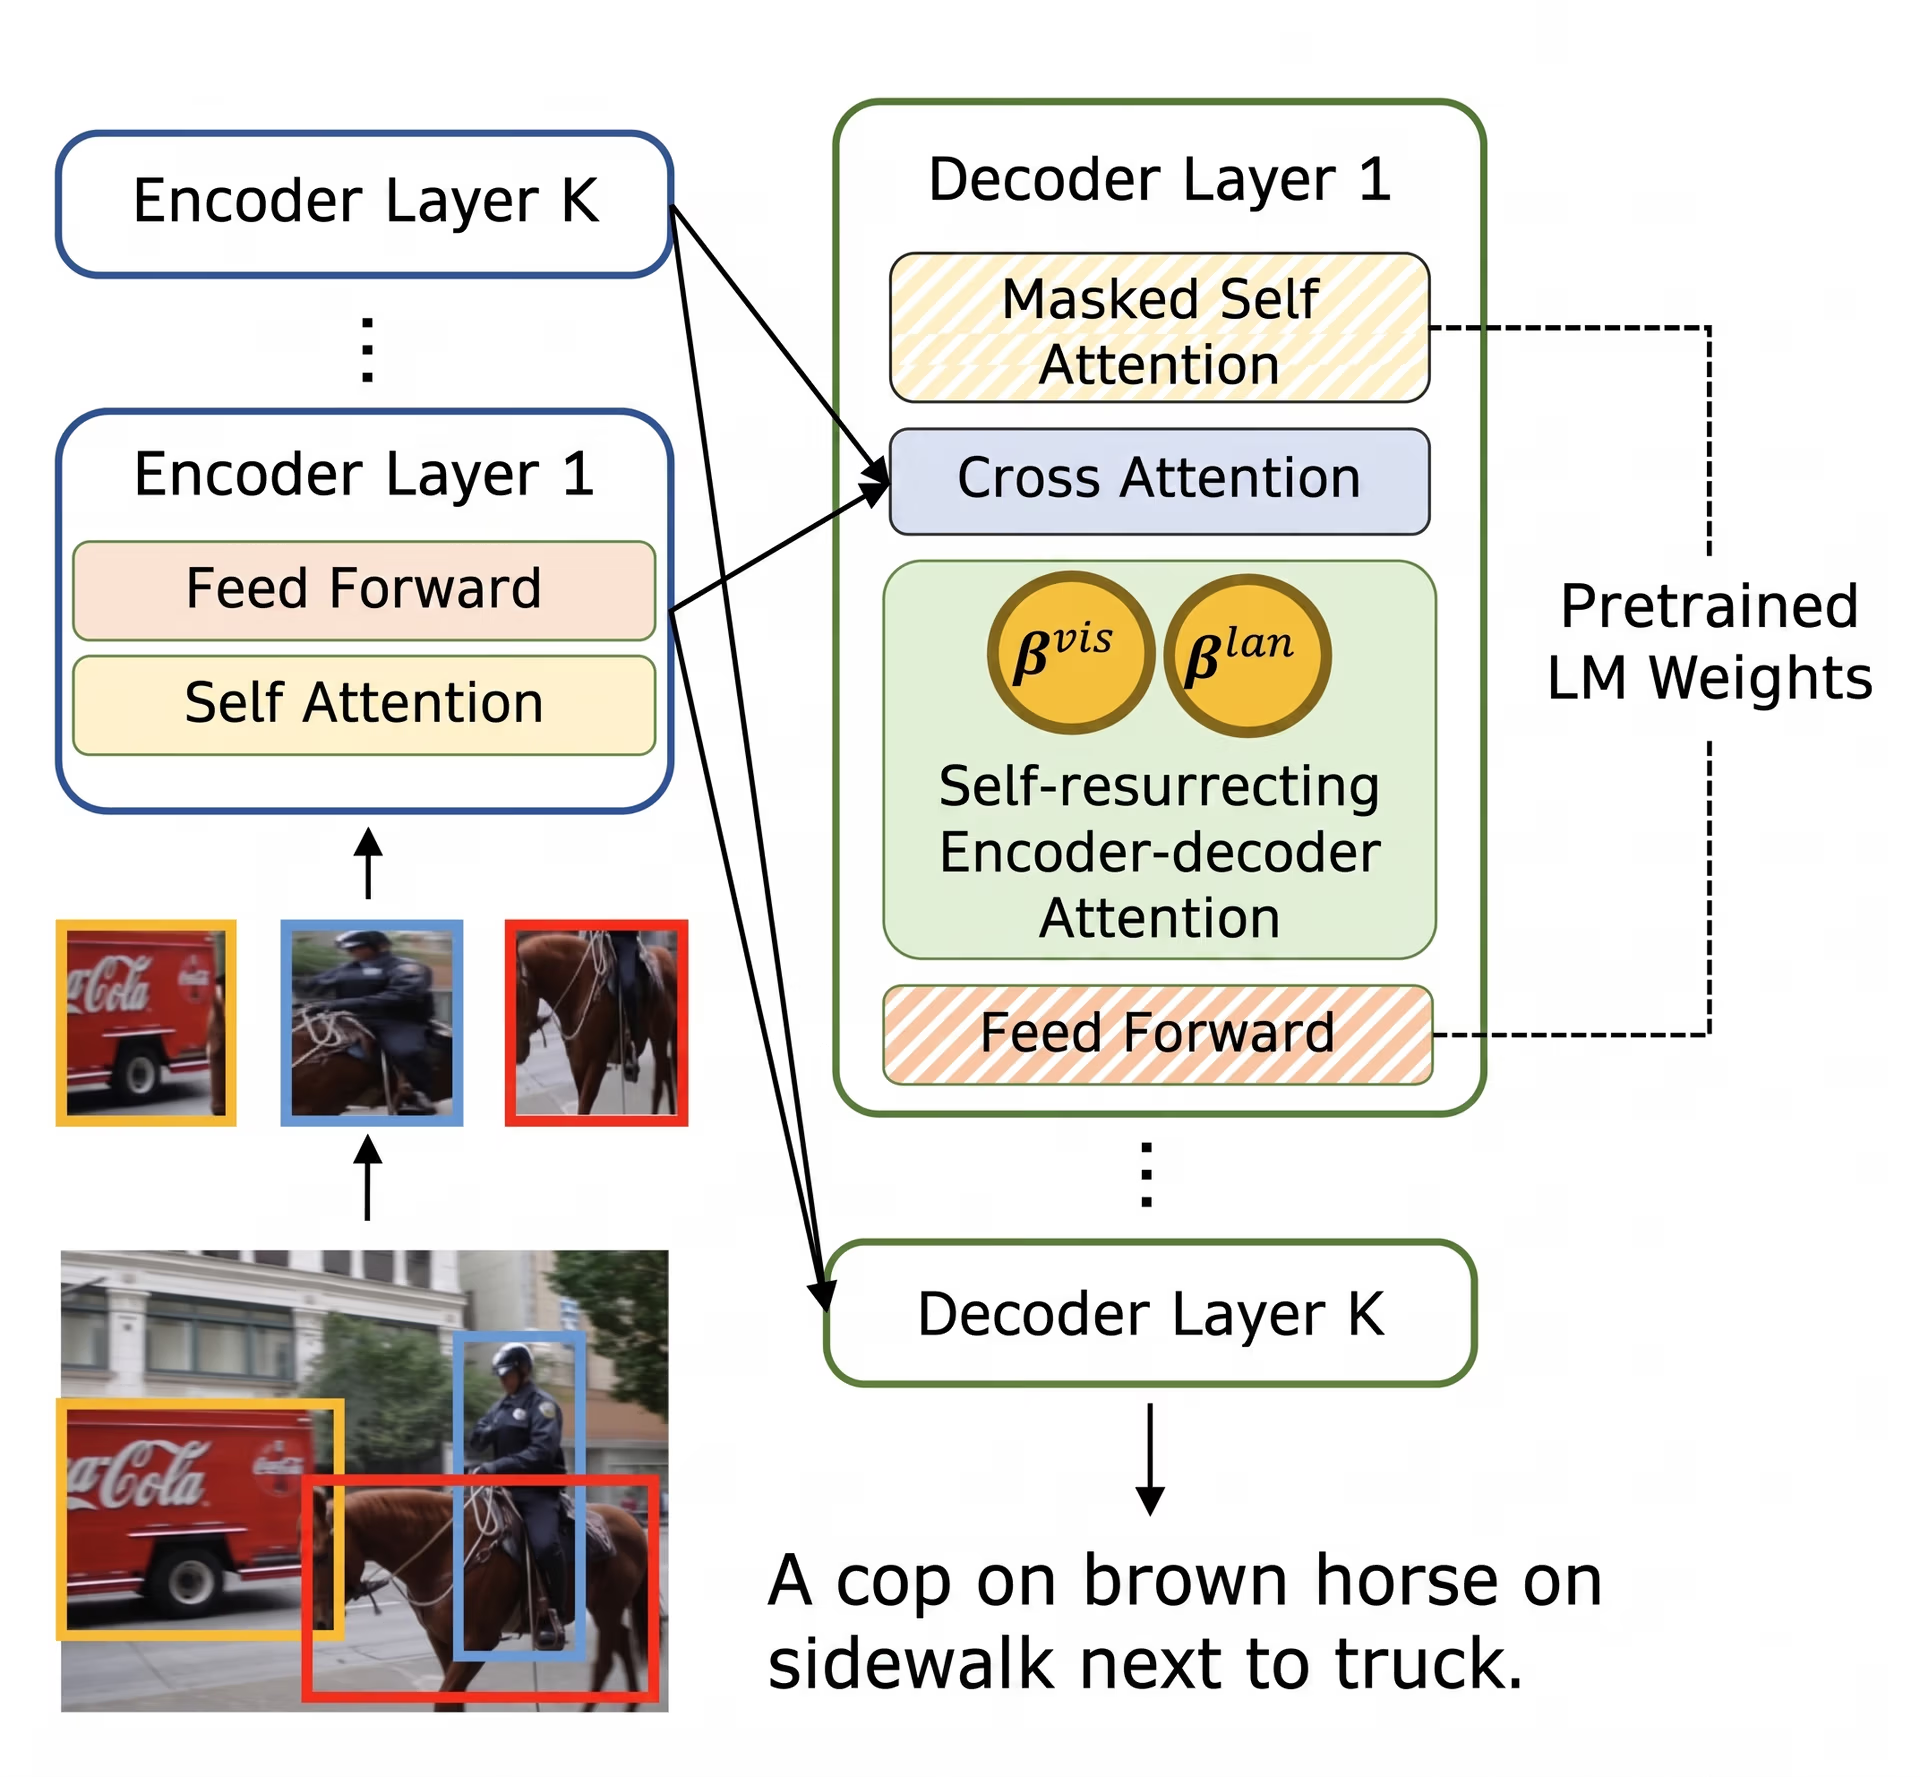
Fig. 4. Arquitetura do modelo VisualGPT.
Aplicações dos modelos de linguagem e visão#
Os Modelos de Linguagem e Visão estão a ter impacto em vários setores. Desde melhorar plataformas de comércio eletrónico até tornar a Internet mais acessível, as potenciais aplicações dos VLMs são entusiasmantes. Vamos explorar algumas delas.
Geração de descrições de produtos#
Quando fazes compras online, vês descrições detalhadas de cada produto, mas criá-las pode consumir muito tempo. Os VLMs simplificam este processo ao automatizar a geração dessas descrições. Os retalhistas online podem gerar diretamente descrições detalhadas e precisas a partir de imagens de produtos usando Modelos de Linguagem e Visão.
Descrições de produtos de alta qualidade ajudam os motores de pesquisa a identificar produtos com base em atributos específicos mencionados na descrição. Por exemplo, uma descrição que contenha «manga comprida» e «gola de algodão» ajuda os clientes a encontrar mais facilmente uma «camisa de algodão de manga comprida». Também ajuda os clientes a encontrar rapidamente o que procuram e, por sua vez, aumenta as vendas e a satisfação dos clientes.
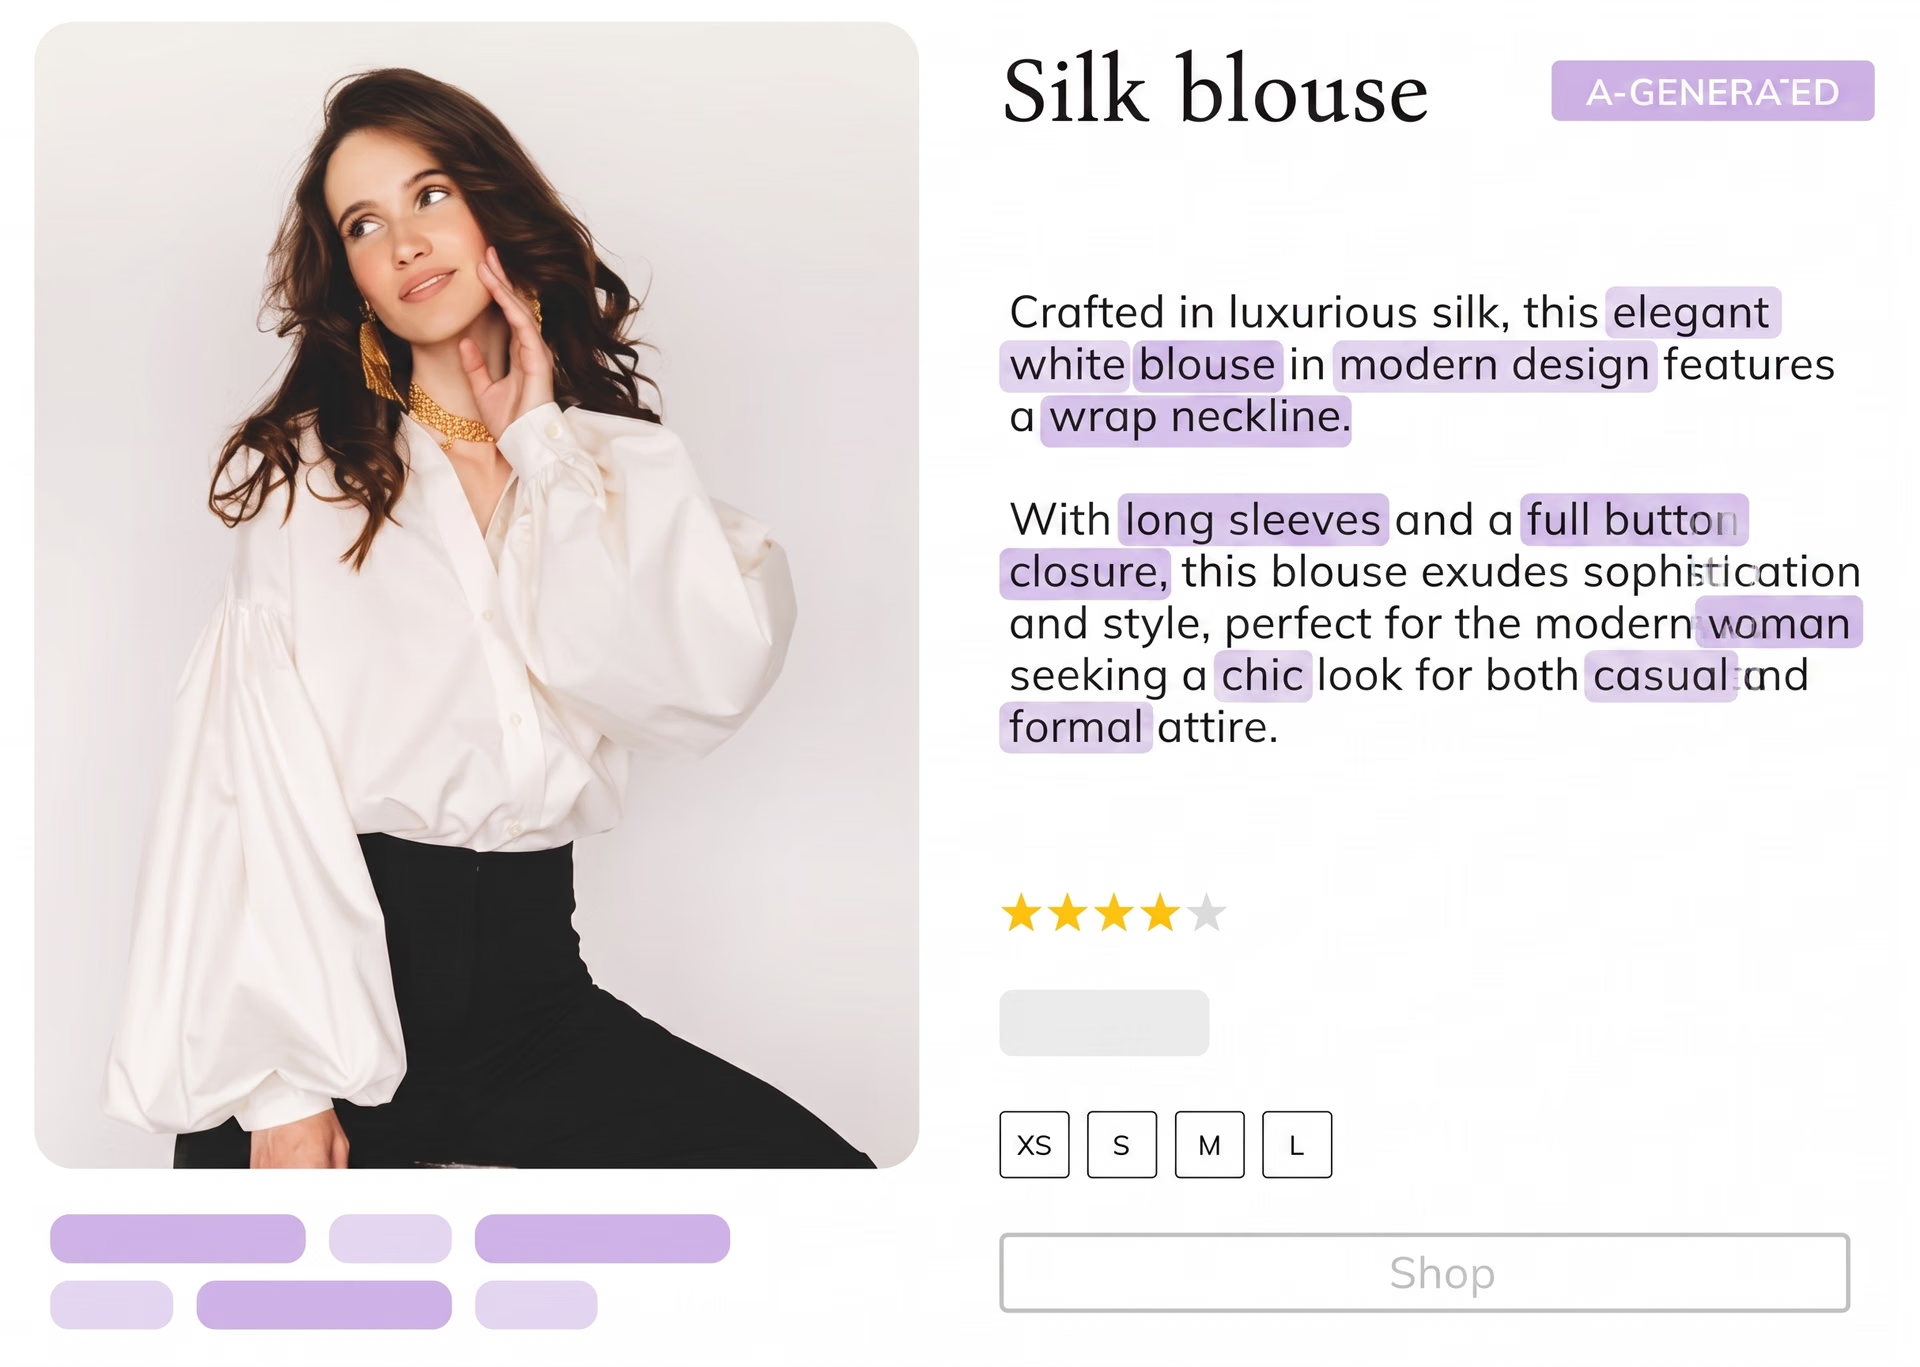
Fig. 5. Um exemplo de uma descrição de produto gerada por IA.
Os modelos de IA generativa, como o BLIP-2, são exemplos de VLMs sofisticados que conseguem prever atributos de produtos diretamente a partir de imagens. O BLIP-2 usa vários componentes para compreender e descrever produtos de comércio eletrónico com precisão. Começa por processar e compreender os aspetos visuais do produto com um codificador de imagens. Depois, um Transformer de consulta interpreta estas informações visuais no contexto de perguntas ou tarefas específicas. Por fim, um modelo de linguagem de grande dimensão gera descrições de produtos detalhadas e precisas.
Tornar a Internet mais acessível#
Os Modelos de Linguagem e Visão podem tornar a Internet mais acessível através da geração de legendas para imagens, especialmente para pessoas com deficiência visual. Tradicionalmente, os utilizadores têm de introduzir descrições do conteúdo visual em sites e redes sociais. Por exemplo, quando publicas no Instagram, podes adicionar texto alternativo para leitores de ecrã. No entanto, os VLMs podem automatizar este processo.
Quando um VLM vê a imagem de um gato sentado num sofá, pode gerar a legenda «Um gato sentado num sofá», tornando a cena clara para utilizadores com deficiência visual. Os VLMs usam técnicas como a solicitação com poucos exemplos, em que aprendem a partir de alguns pares de imagem e legenda, e a solicitação por cadeia de raciocínio, que os ajuda a decompor logicamente cenas complexas. Estas técnicas tornam as legendas geradas mais coerentes e detalhadas.
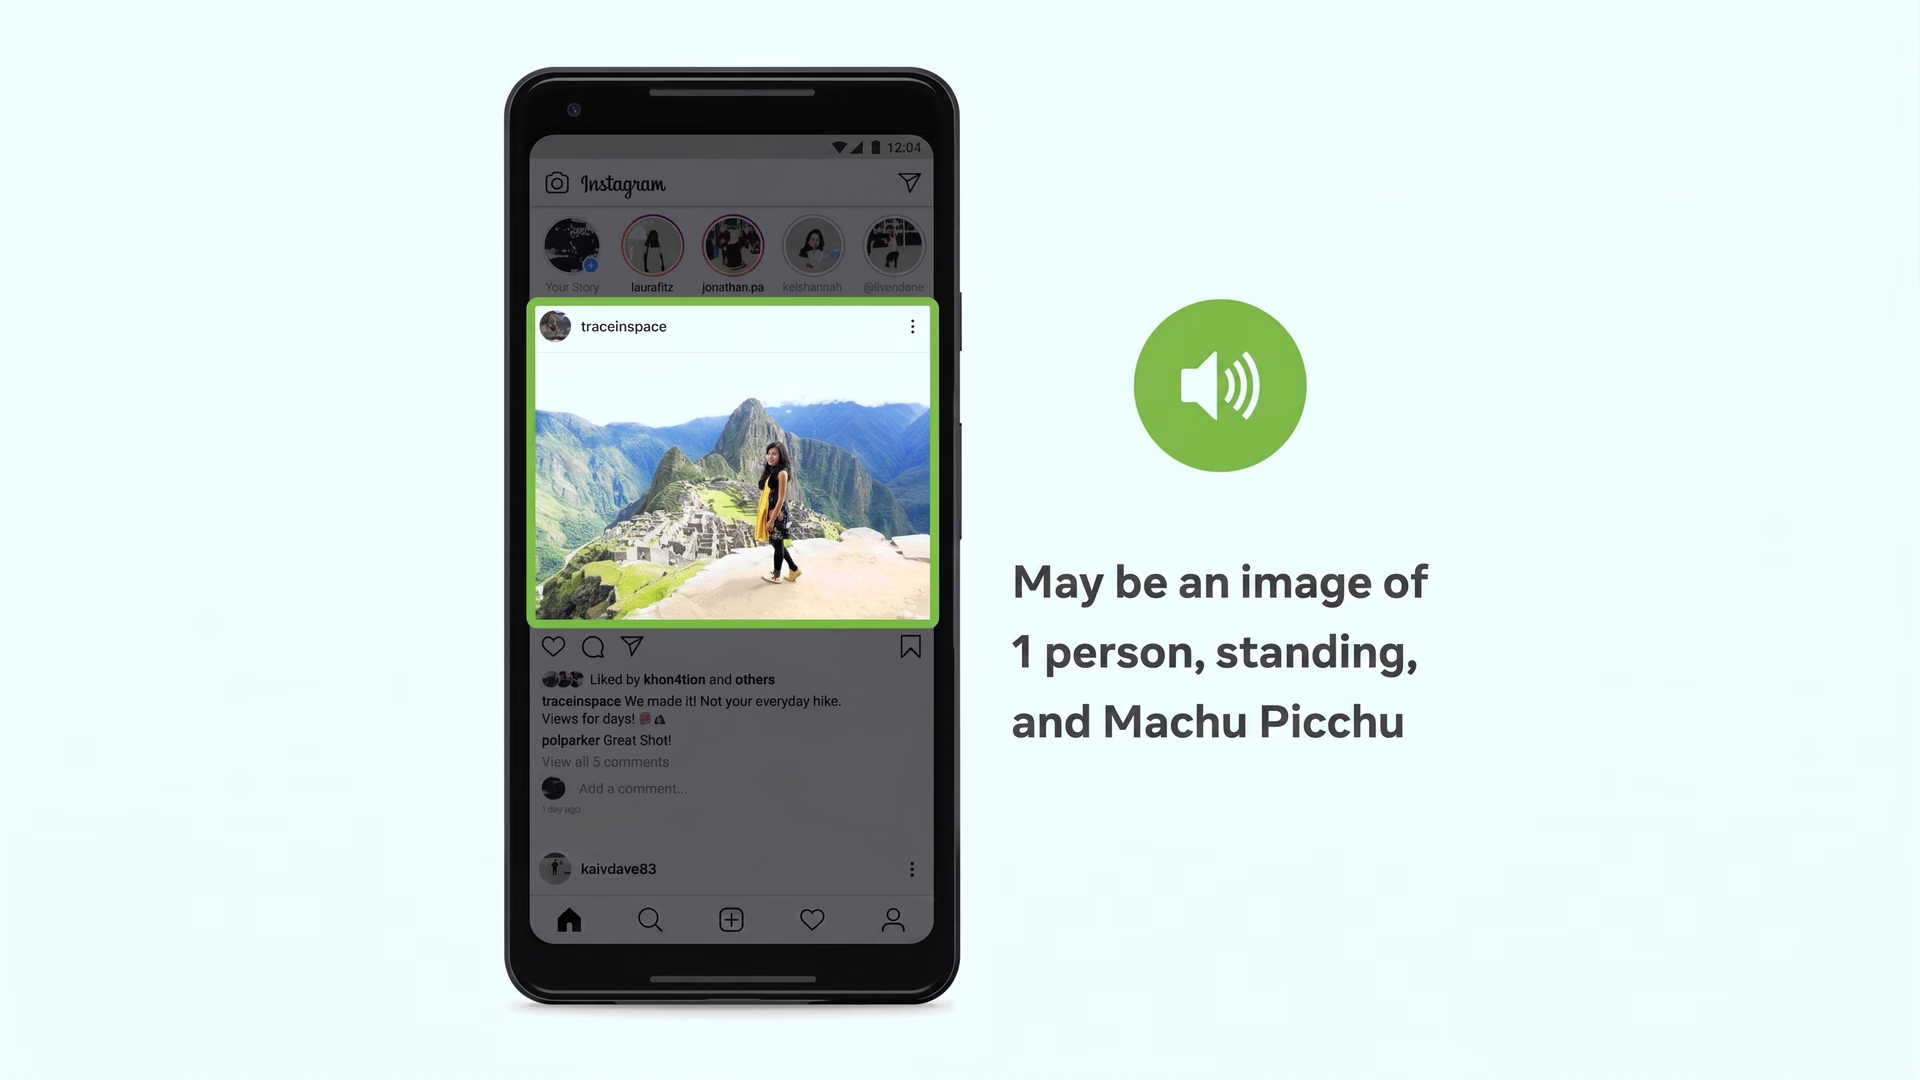
Fig. 6. Utilização de IA para gerar legendas para imagens.
Para este efeito, a funcionalidade «Obter descrições de imagens do Google» do Chrome gera automaticamente descrições para imagens sem texto alternativo. Embora estas descrições geradas por IA possam não ser tão detalhadas como as escritas por pessoas, continuam a fornecer informações valiosas.
Vantagens e limitações dos Modelos de Linguagem e Visão#
Os Modelos de Linguagem e Visão (VLMs) oferecem muitas vantagens ao combinar dados visuais e textuais. Algumas das principais vantagens incluem:
- Melhor interação entre pessoas e máquinas: Permitem que os sistemas compreendam e respondam a entradas visuais e textuais, melhorando os assistentes virtuais, os chatbots e a robótica.
- Diagnósticos e análises avançados: Ajudam na área médica, analisando imagens e gerando descrições, apoiando os profissionais de saúde com segundas opiniões e deteção de anomalias.
- Narrativas interativas e entretenimento: Geram narrativas envolventes ao combinar entradas visuais e textuais para melhorar a experiência dos utilizadores em jogos e realidade virtual.
Apesar das suas capacidades impressionantes, os Modelos de Linguagem e Visão também têm algumas limitações. Eis alguns aspetos a ter em conta relativamente aos VLMs:
- Elevadas necessidades computacionais: O treino e a implementação de VLMs exigem recursos computacionais consideráveis, o que os torna dispendiosos e menos acessíveis.
- Dependência dos dados e viés: Os VLMs podem produzir resultados enviesados se forem treinados com conjuntos de dados pouco diversificados ou enviesados, o que pode perpetuar estereótipos e desinformação.
- Compreensão limitada do contexto: Os VLMs podem ter dificuldade em compreender o panorama geral ou o contexto e gerar resultados demasiado simplificados ou incorretos.
Principais conclusões#
Os Modelos de Linguagem e Visão têm um potencial extraordinário em muitas áreas, como o comércio eletrónico e a área da saúde. Ao combinar dados visuais e textuais, podem impulsionar a inovação e transformar setores. No entanto, é essencial desenvolver estas tecnologias de forma responsável e ética para garantir que sejam usadas com equidade. À medida que os VLMs continuam a evoluir, irão melhorar tarefas como a pesquisa baseada em imagens e as tecnologias de assistência.
Continua a aprender sobre IA e liga-te à nossa comunidade! Explora o nosso repositório do GitHub para veres como estamos a usar IA para criar soluções inovadoras em setores como a indústria transformadora e a área da saúde. 🚀









