O que é destilação de conjuntos de dados? Uma visão geral rápida
Descobre como a destilação de conjuntos de dados acelera o treinamento de modelos e reduz os custos computacionais, substituindo grandes conjuntos de dados por um pequeno conjunto otimizado de amostras sintéticas.
 Abirami Vina18 min de leitura
Treinar modelos pode parecer a parte mais demorada do trabalho de um cientista de dados. Mas a maior parte do tempo, muitas vezes de 60% a 80%, é, na verdade, dedicada a preparar os dados: coletá-los, limpá-los e organizá-los para a modelagem. À medida que os conjuntos de dados crescem, o tempo de preparação também aumenta, tornando os experimentos mais lentos e dificultando as iterações.
Para enfrentar esse desafio, pesquisadores passaram anos buscando maneiras de simplificar o treinamento. Abordagens como dados sintéticos, compressão de conjuntos de dados e métodos de otimização aprimorados têm como objetivo reduzir o custo e as dificuldades de trabalhar com conjuntos de dados em grande escala e acelerar os fluxos de trabalho de machine learning.
Uma questão importante que isso levanta é se podemos reduzir drasticamente um conjunto de dados e ainda obter o mesmo desempenho que teríamos ao treinar um modelo com todos os dados. A destilação de conjuntos de dados é uma resposta promissora.
Ela cria uma versão compacta de um conjunto de dados de treinamento grande, preservando os padrões essenciais de que o modelo precisa para aprender com eficácia. Isso abre caminho para um treinamento mais rápido, menos necessidade de computação e experimentos mais eficientes. Você pode pensar nisso como uma cola de estudo para o modelo: um pequeno conjunto de exemplos de dados sintéticos criado para ensinar os mesmos padrões fundamentais que o conjunto de dados completo.
Neste artigo, vamos explorar como funciona a destilação de conjuntos de dados e como ela viabiliza o aprendizado de máquina e o aprendizado profundo escaláveis em aplicações do mundo real.
Entendendo a destilação de conjuntos de dados#
A destilação de conjuntos de dados é um processo pelo qual um grande conjunto de dados de treinamento é condensado em um conjunto muito menor que ainda ensina ao modelo quase as mesmas informações do conjunto original. Muitos pesquisadores também chamam esse processo de condensação de conjuntos de dados, pois o objetivo é capturar os padrões essenciais presentes no conjunto de dados completo.
Um conjunto de dados destilado é diferente de dados sintéticos gerados aleatoriamente ou da simples seleção de um subconjunto menor de imagens reais. Não é um conjunto de dados falso e aleatório nem uma cópia reduzida do original.
Em vez disso, ele é otimizado intencionalmente para capturar os padrões mais importantes. Durante esse processo, cada pixel e recurso é ajustado e otimizado para que uma rede neural treinada com os dados destilados aprenda quase como se tivesse sido treinada com o conjunto de dados inteiro.
Essa ideia apareceu pela primeira vez em um artigo de 2018 no arXiv, de Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba e Alexei A. Efros. Os primeiros testes usaram conjuntos de dados simples, como MNIST e CIFAR-10, o que facilitou demonstrar que algumas amostras destiladas podiam substituir milhares de imagens reais.
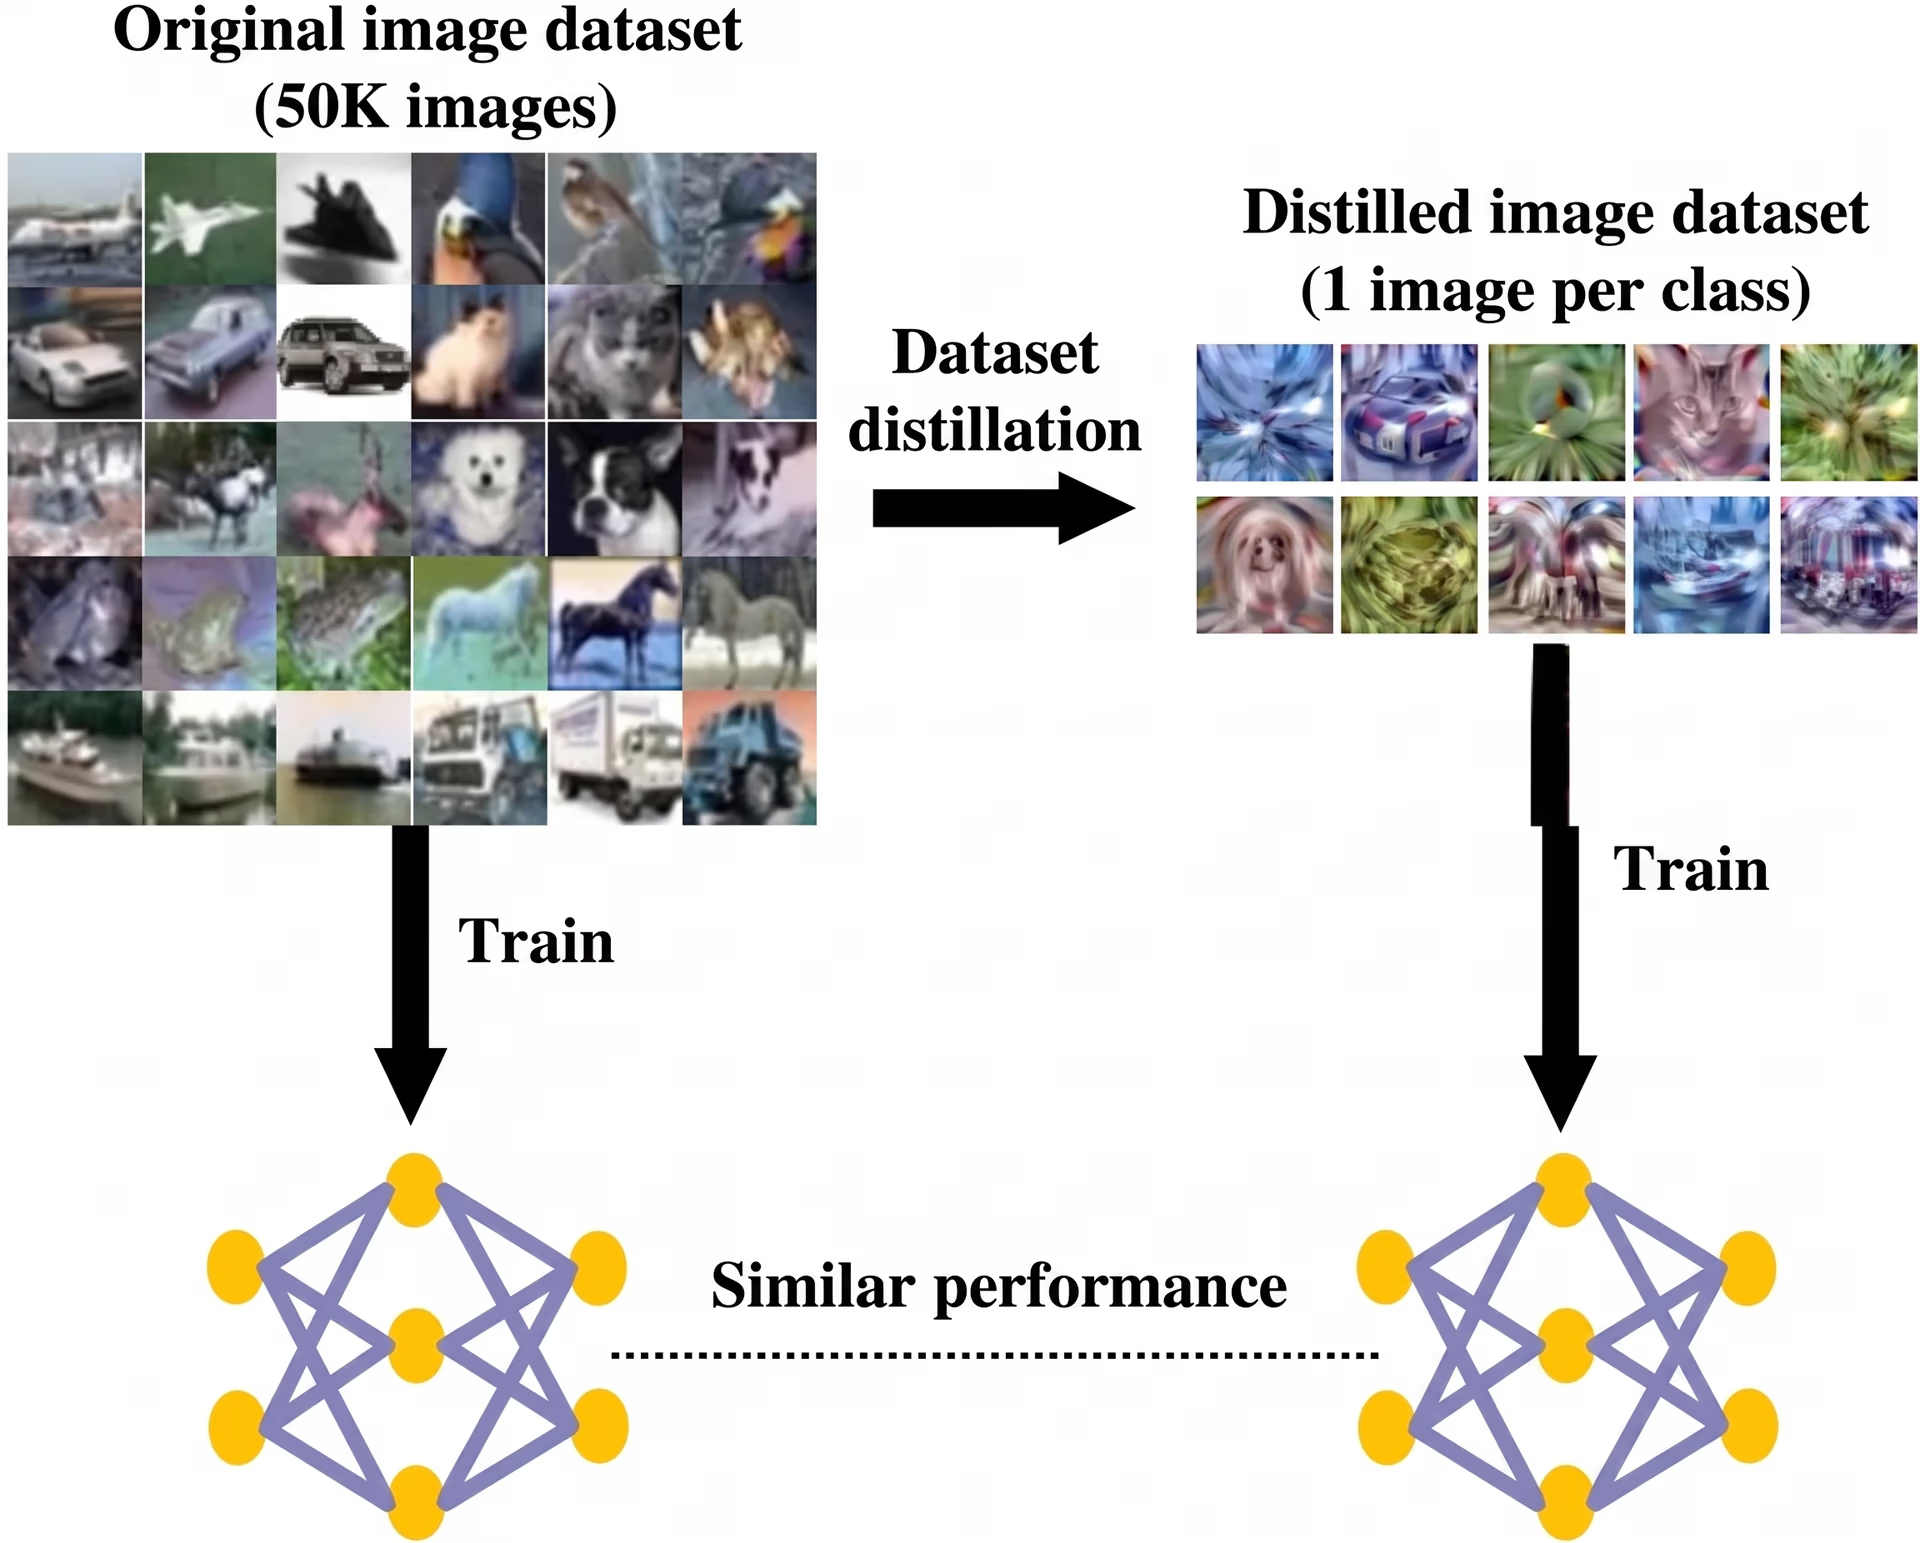
Fig. 1. Uso da destilação de conjuntos de dados em dados de imagem (Fonte)
Desde então, trabalhos subsequentes aprofundaram a destilação de conjuntos de dados, incluindo métodos publicados na ICML e na ICLR que tornam a condensação mais eficiente e escalável.
A importância da destilação de conjuntos de dados#
A destilação de conjuntos de dados melhora a eficiência do treinamento e acelera os ciclos de desenvolvimento. Ao reduzir a quantidade de dados com que um modelo precisa aprender, ela diminui os requisitos computacionais.
Isso é especialmente útil para o aprendizado contínuo, em que os modelos são atualizados ao longo do tempo; para a busca de arquitetura neural, em que muitos designs de modelos são testados; e para o treinamento na borda, em que os modelos são executados em dispositivos pequenos, com memória e energia limitadas. No geral, esses benefícios fazem da destilação de conjuntos de dados uma ótima opção para inicialização rápida, ajuste fino ágil e criação de protótipos iniciais em muitos fluxos de trabalho de machine learning.
Visão geral de como funciona a destilação de conjuntos de dados#
A destilação de conjuntos de dados cria amostras de treinamento sintéticas, ou seja, geradas artificialmente. Essas amostras ajudam o modelo a aprender de uma forma muito semelhante ao treinamento com dados reais. O processo acompanha três fatores principais durante o treinamento normal.
O primeiro é a função de perda, a medida de erro do modelo que mostra o quanto as previsões estão incorretas. O segundo são os parâmetros do modelo, os pesos internos da rede que são atualizados à medida que ela aprende.
O terceiro é a trajetória de treinamento, que descreve como o erro e os pesos mudam passo a passo ao longo do tempo. Em seguida, as amostras sintéticas são otimizadas para que, ao treinar com elas, o modelo reduza seu erro e atualize seus pesos da mesma forma que faria com o conjunto de dados completo.
Uma análise passo a passo da destilação de conjuntos de dados#
Veja mais de perto como funciona o processo de destilação de conjuntos de dados:
- Etapa 1 - Inicializar pixels sintéticos: O processo começa com imagens sintéticas que funcionam como entradas que podem ser aprendidas. No início, essas imagens têm pouca estrutura e parecem telas em branco. Com o tempo, elas são otimizadas e se transformam em exemplos informativos.
- Etapa 2 - Otimizar com correspondência de gradientes e retropropagação: À medida que o modelo é treinado com essas imagens sintéticas, ele produz gradientes que indicam como cada pixel deve mudar para corresponder melhor ao comportamento de treinamento dos dados reais. A retropropagação é o método que a rede usa para aprender com os erros. Ela envia o erro de volta pela rede para identificar quais pixels e pesos o causaram e, em seguida, os atualiza ligeiramente. Com esses gradientes, a retropropagação ajusta as imagens sintéticas passo a passo, tornando-as mais informativas para o treinamento.
- Etapa 3 - Correspondência do comportamento ao longo das etapas de treinamento: O método também faz a correspondência das trajetórias de treinamento, ou seja, das mudanças que o modelo sofre passo a passo enquanto aprende. Isso garante que o conjunto de dados destilado oriente o modelo por um caminho de aprendizado semelhante ao que ele seguiria com o conjunto de dados completo.
- Etapa 4 - Validação e generalização: Por fim, o conjunto de dados destilado é avaliado com dados reais de validação para verificar o desempenho do modelo treinado em novos exemplos. Isso permite confirmar que os dados sintéticos ensinam padrões amplos e funcionais, em vez de fazer o modelo memorizar amostras específicas.
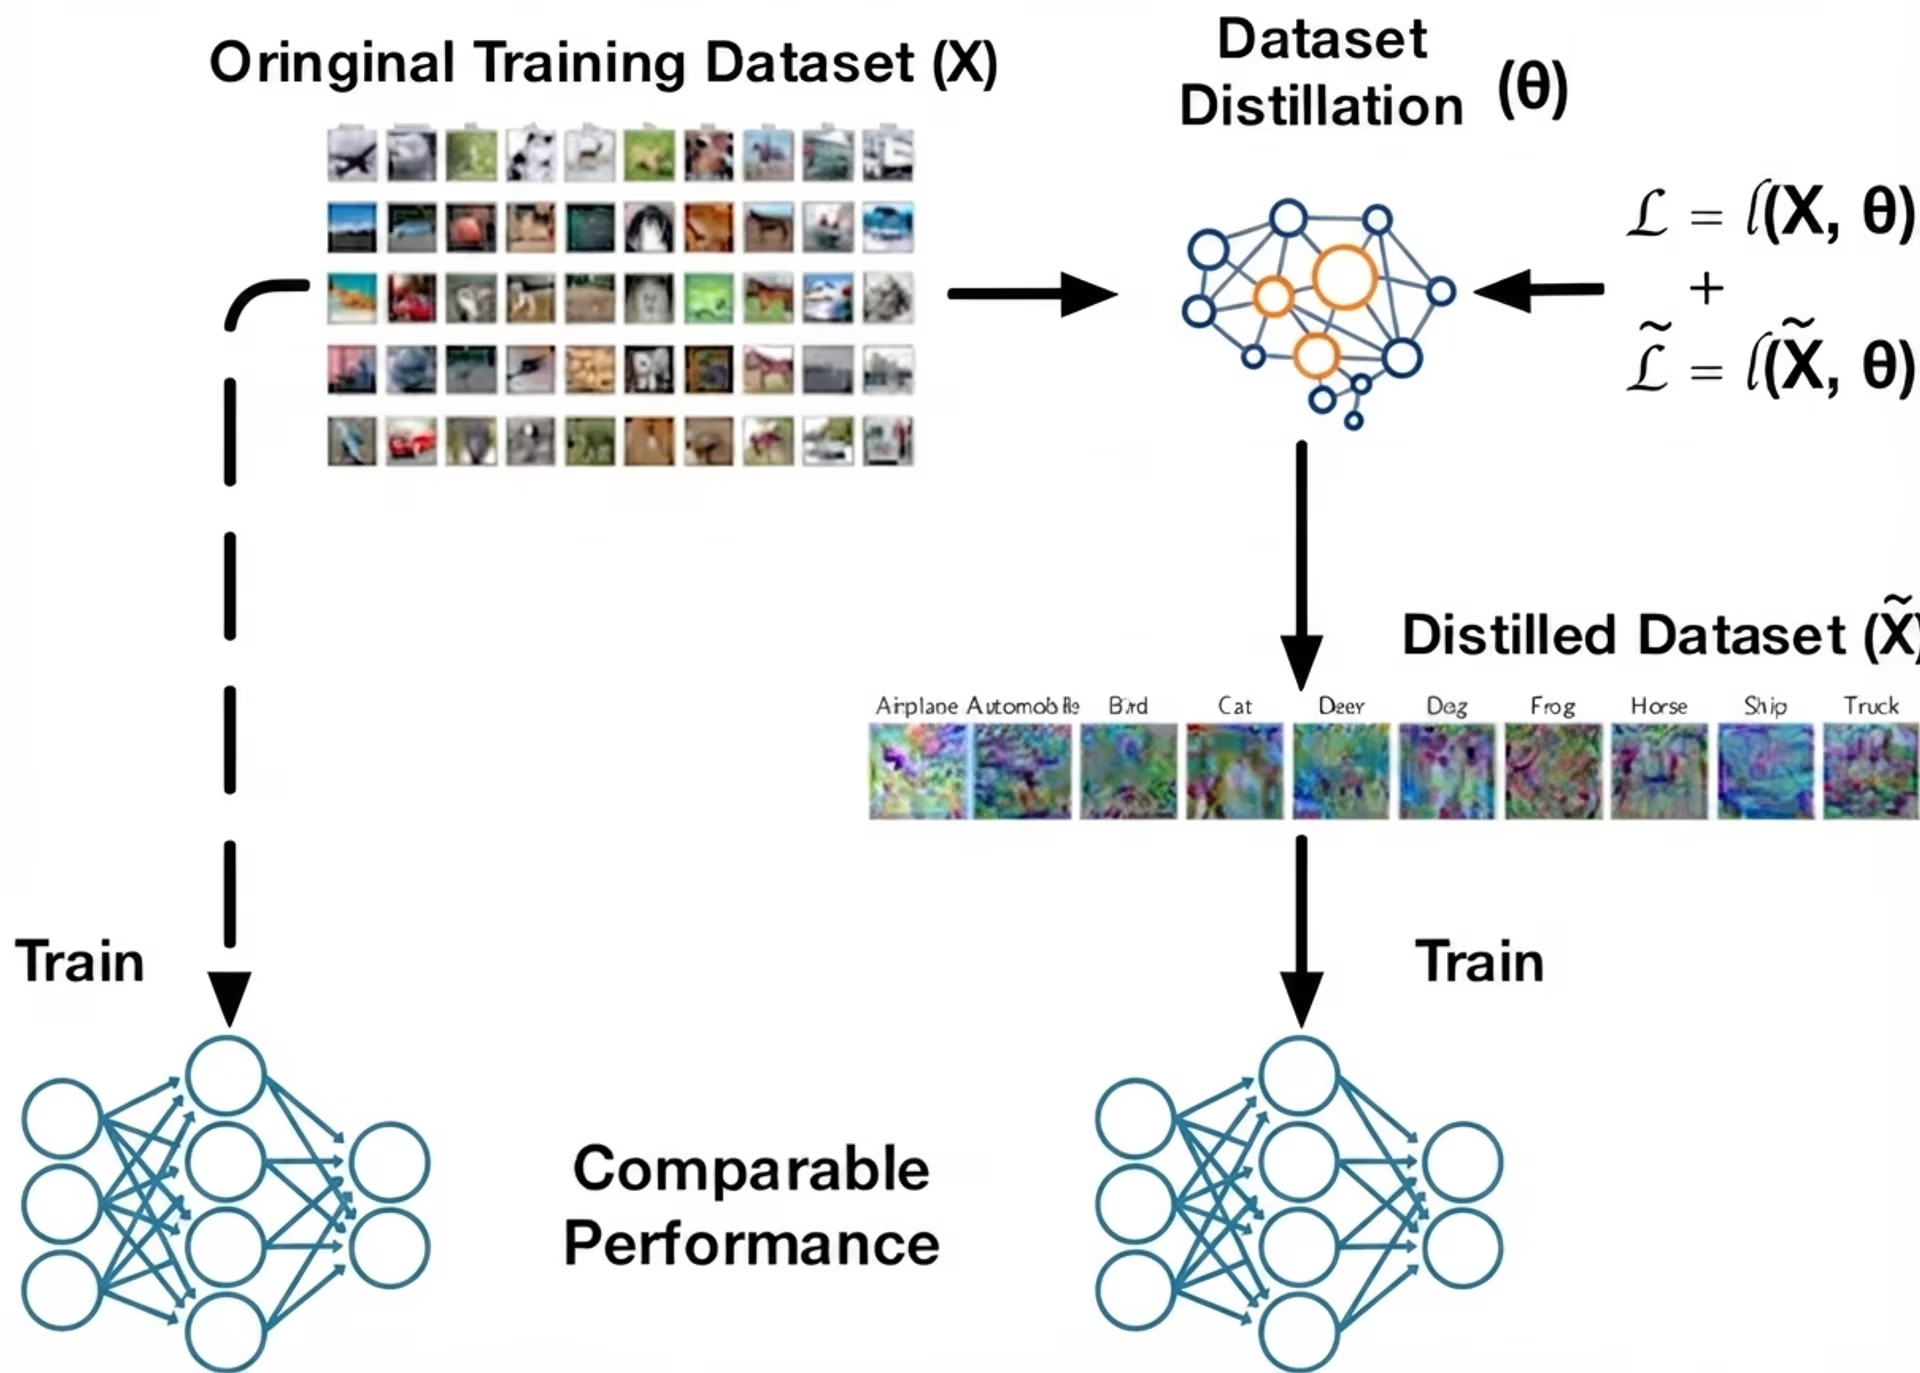
Fig. 2. Uma visão da destilação de conjuntos de dados (Fonte)
Principais metodologias de destilação de conjuntos de dados#
Todos os métodos de destilação de conjuntos de dados se baseiam na mesma ideia central, embora usem algoritmos diferentes para chegar ao resultado. A maioria das abordagens se enquadra em três categorias: correspondência de desempenho, correspondência de distribuição e correspondência de parâmetros.
Agora, vamos analisar cada uma delas e ver como funciona.
Correspondência de desempenho#
A correspondência de desempenho na destilação de conjuntos de dados se concentra na criação de um conjunto de treinamento minúsculo e otimizado que permite ao modelo alcançar quase a mesma precisão que alcançaria se fosse treinado com o conjunto de dados original completo. Em vez de escolher um subconjunto aleatório, as amostras destiladas são otimizadas para que um modelo treinado com elas produza previsões semelhantes, apresente um comportamento de perda semelhante durante o treinamento ou alcance uma precisão final semelhante à de um modelo treinado com o conjunto de dados original.
O meta-aprendizado é um método comum usado para aprimorar esse processo. O conjunto de dados destilado é atualizado por meio de episódios de treinamento repetidos, tornando-se eficaz em muitas situações possíveis.
Durante esses episódios, o método simula como um modelo aluno aprende com as amostras destiladas atuais, verifica o desempenho desse modelo com dados reais e, em seguida, ajusta as amostras destiladas para que sejam melhores professores. Com o tempo, o conjunto destilado aprende a favorecer o aprendizado rápido e a generalização robusta, mesmo quando o modelo aluno começa com pesos iniciais diferentes ou usa outra arquitetura. Isso torna o conjunto de dados destilado mais confiável e independente de uma única execução de treinamento.
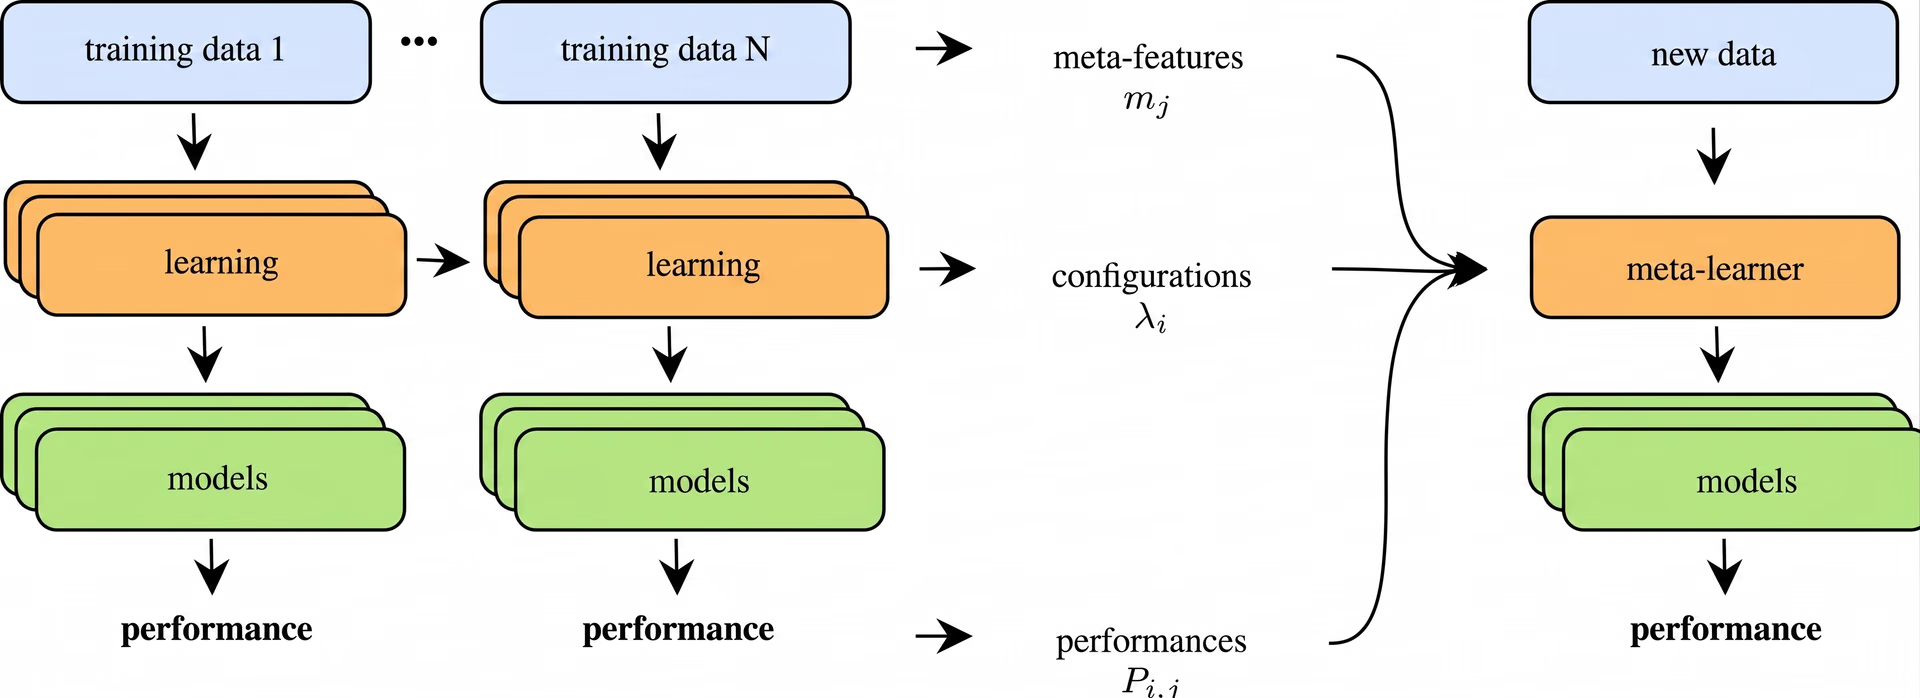
Fig. 3. O processo de meta-aprendizado (Fonte)
Técnicas de correspondência de distribuição#
Por sua vez, a correspondência de distribuição gera dados sintéticos que correspondem aos padrões estatísticos do conjunto de dados real. Em vez de se concentrar apenas na precisão final do modelo, essa abordagem se concentra nos recursos internos que uma rede neural gera durante o aprendizado.
Agora, vamos analisar as duas técnicas que orientam a correspondência de distribuição.
Correspondência de distribuição em uma única camada#
A correspondência de distribuição em uma única camada concentra-se em uma única camada de uma rede neural e compara as características que ela produz para dados reais e sintéticos. Essas características, também chamadas de ativações, capturam o que o modelo aprendeu naquele ponto da rede.
Ao fazer com que os dados sintéticos produzam ativações semelhantes, o método incentiva o conjunto de dados destilado a refletir os mesmos padrões importantes do conjunto de dados original. Na prática, as amostras sintéticas são atualizadas repetidamente até que as ativações na camada escolhida correspondam de perto às das imagens reais.
Essa abordagem é relativamente simples porque alinha apenas um nível de representação por vez. Ela pode funcionar especialmente bem em conjuntos de dados menores ou tarefas nas quais não é necessário corresponder hierarquias de características profundas e de várias etapas. Ao alinhar claramente um espaço de características, a correspondência de uma única camada fornece um sinal estável e significativo para o aprendizado com o conjunto de dados destilado.
Correspondência de distribuição em várias camadas#
A correspondência de distribuição em várias camadas amplia a ideia de comparar dados reais e sintéticos, realizando essa comparação em várias camadas de uma rede neural, em vez de apenas uma. Camadas diferentes capturam tipos diferentes de informação, desde bordas e texturas simples nas camadas iniciais até formas e padrões mais complexos nas camadas profundas.
Ao corresponder características entre essas camadas, o conjunto de dados destilado é orientado a refletir o que o modelo aprende em vários níveis. Como alinha características ao longo de toda a rede, essa abordagem ajuda os dados sintéticos a preservar sinais mais ricos, dos quais o modelo depende para distinguir as classes.
Isso é especialmente útil em visão computacional, ou seja, em tarefas nas quais os modelos aprendem a compreender imagens e vídeos, porque padrões úteis estão distribuídos por muitas camadas. Quando as distribuições de características correspondem bem em várias profundidades, o conjunto de dados destilado funciona como um substituto mais sólido e confiável dos dados de treinamento originais.
Métodos de correspondência de parâmetros#
Outra categoria importante na destilação de conjuntos de dados é a correspondência de parâmetros. Em vez de corresponder a precisão ou às distribuições de características, ela corresponde à forma como os pesos de um modelo mudam durante o treinamento. Ao fazer com que o treinamento com o conjunto de dados destilado gere atualizações de parâmetros semelhantes às do treinamento com dados reais, o modelo segue uma trajetória de aprendizado quase idêntica.
A seguir, vamos explicar os dois principais métodos de correspondência de parâmetros.
Correspondência em uma única etapa#
A correspondência em uma única etapa compara o que acontece com os pesos de um modelo após apenas uma etapa de treinamento com dados reais. Em seguida, o conjunto de dados destilado é ajustado para que um modelo treinado com ele por uma etapa produza uma atualização de pesos muito semelhante. Como se concentra apenas nessa atualização, o método é simples e rápido de executar.
A desvantagem é que uma etapa não reflete todo o processo de aprendizado, especialmente em tarefas mais difíceis, nas quais o modelo precisa de muitas atualizações para criar características mais ricas. Por isso, a correspondência em uma única etapa tende a funcionar melhor em problemas mais simples ou conjuntos de dados menores, nos quais padrões úteis podem ser aprendidos rapidamente.
Correspondência de parâmetros em várias etapas#
Em contrapartida, a correspondência de parâmetros em várias etapas analisa como os pesos de um modelo mudam ao longo de várias etapas de treinamento, e não apenas de uma. Essa sequência de atualizações é a trajetória de treinamento do modelo.
O conjunto de dados destilado é criado de modo que, quando um modelo é treinado com as amostras sintéticas, sua trajetória acompanhe de perto a que seguiria com dados reais. Ao corresponder a um trecho mais longo do aprendizado, o conjunto destilado captura mais da estrutura do processo de treinamento original.
Como reflete o desenrolar do aprendizado ao longo do tempo, a correspondência em várias etapas geralmente funciona melhor em conjuntos de dados maiores ou mais complexos, nos quais os modelos precisam de muitas atualizações para aprender padrões úteis. Ela exige mais computação, pois precisa acompanhar várias etapas, mas costuma produzir conjuntos de dados destilados que generalizam melhor e têm desempenho superior ao da correspondência em uma única etapa.
Como funcionam a geração e a otimização de conjuntos de dados sintéticos#
Com uma compreensão melhor das principais abordagens de destilação, agora podemos analisar como os dados sintéticos são criados. Na destilação de conjuntos de dados, as amostras sintéticas são otimizadas para capturar o sinal de aprendizado mais importante, de modo que um pequeno conjunto possa substituir um conjunto de dados muito maior.
A seguir, veremos como esses dados destilados são gerados e avaliados.
Criação e avaliação de imagens destiladas#
Durante a destilação de conjuntos de dados, os pixels sintéticos são atualizados ao longo de muitas etapas de treinamento. A rede neural aprende com as imagens sintéticas atuais e envia feedback baseado em gradientes, que indica como cada pixel deve mudar para corresponder melhor aos padrões do conjunto de dados real.
Isso funciona porque o processo é diferenciável (ou seja, cada etapa é suave e tem gradientes bem definidos, de modo que pequenas alterações nos pixels levam a mudanças previsíveis na perda), permitindo que o modelo ajuste suavemente os dados sintéticos durante a descida do gradiente.
À medida que a otimização continua, as imagens sintéticas começam a formar estruturas significativas, incluindo formas e texturas que o modelo reconhece. Essas imagens sintéticas refinadas costumam ser usadas em tarefas de classificação de imagens, pois capturam os principais indícios visuais de que um classificador precisa para aprender.
Os conjuntos de dados destilados são avaliados treinando modelos com eles e comparando os resultados com os de modelos treinados com dados reais. Os pesquisadores medem a precisão de validação e verificam se o conjunto sintético preserva as características discriminativas (os padrões ou sinais dos quais o modelo depende para distinguir uma classe de outra) necessárias para separar as classes. Também testam a estabilidade e a generalização em diferentes execuções ou configurações de modelo para garantir que os dados destilados não causem sobreajuste.
Aplicações práticas da destilação de dados#
A seguir, vamos analisar mais de perto exemplos que mostram como os conjuntos de dados destilados aceleram o treinamento e reduzem os custos computacionais, mantendo um desempenho sólido, mesmo quando os dados são limitados ou altamente especializados.
Uso da destilação de conjuntos de dados em aplicações de visão computacional#
Na visão computacional, o objetivo é treinar modelos para compreender dados visuais, como imagens e vídeos. Esses modelos aprendem padrões como bordas, texturas, formas e objetos e, em seguida, usam esses padrões em tarefas como classificação de imagens, detecção de objetos ou segmentação. Como os problemas de visão costumam apresentar grande variação de iluminação, planos de fundo e pontos de vista, os sistemas de visão computacional geralmente precisam de grandes conjuntos de dados para generalizar bem, o que torna o treinamento caro e demorado.
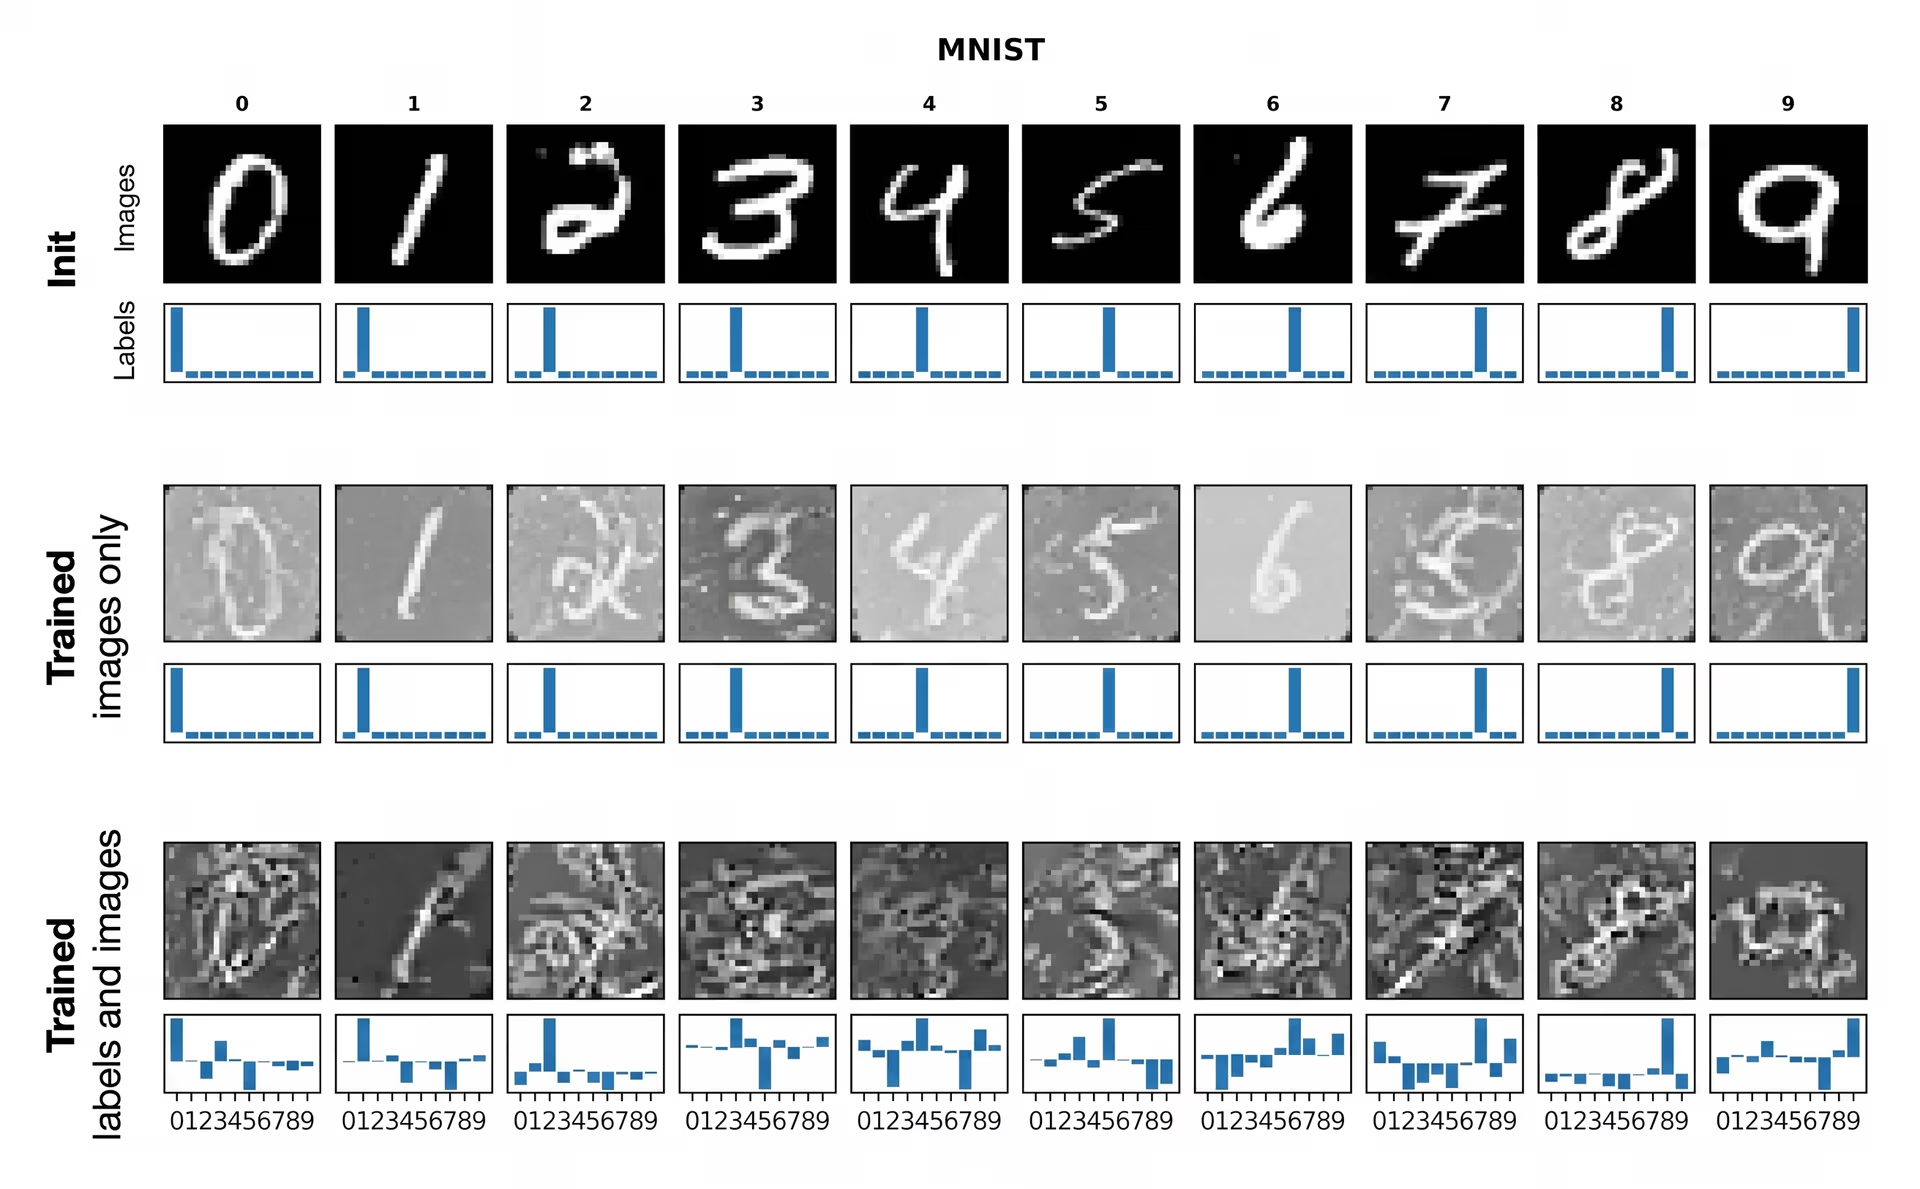
Fig. 4. Um exemplo de destilação de conjunto de dados (Fonte)
Em casos de uso de classificação de imagens, como exames médicos, monitoramento da vida selvagem ou detecção de defeitos em fábricas, os modelos costumam enfrentar uma difícil escolha entre precisão e custo de treinamento. Essas tarefas normalmente envolvem conjuntos de dados enormes.
A destilação de conjuntos de dados pode comprimir o conjunto de treinamento original em um pequeno número de imagens sintéticas que ainda contêm os indícios visuais mais importantes para o classificador. Em benchmarks grandes como o ImageNet, demonstrou-se que conjuntos destilados que usam apenas cerca de 4,2% das imagens originais mantêm uma alta precisão de classificação. Isso significa que um pequeno conjunto sintético substituto pode substituir milhões de amostras reais com muito menos computação.
Busca de arquitetura neural#
A busca de arquitetura neural, ou NAS, é uma técnica que explora automaticamente muitos projetos possíveis de redes neurais para encontrar o mais adequado a uma tarefa. Como a NAS precisa treinar e avaliar um grande número de modelos candidatos, executá-la em conjuntos de dados completos pode ser lento e exigir muitos recursos computacionais.
A destilação de conjuntos de dados ajuda ao criar um conjunto de treinamento sintético minúsculo que ainda contém o principal sinal de aprendizado dos dados originais, permitindo testar cada arquitetura candidata muito mais rapidamente. Isso permite que a NAS compare projetos com eficiência e mantenha uma confiabilidade razoável na classificação das arquiteturas boas e ruins, reduzindo o custo da busca sem sacrificar muito a qualidade do modelo final.
Aprendizado contínuo e implantação na borda#
Os sistemas de aprendizado contínuo, ou seja, modelos que continuam sendo atualizados à medida que chegam novos dados, em vez de serem treinados uma única vez, precisam de atualizações rápidas e eficientes em termos de memória. Dispositivos de borda, como câmeras, celulares e sensores, enfrentam limitações semelhantes, pois têm recursos computacionais e de armazenamento restritos.
A destilação de conjuntos de dados ajuda nos dois casos ao comprimir um grande conjunto de treinamento em um conjunto sintético minúsculo, para que os modelos possam se adaptar ou ser retreinados com um pequeno conjunto de repetição, em vez do conjunto de dados completo. Por exemplo, um estudo sobre meta-aprendizado baseado em kernel mostrou que apenas 10 amostras destiladas podem alcançar mais de 64% de precisão no CIFAR-10, um benchmark padrão de classificação de imagens. Como o conjunto de repetição é tão compacto, as atualizações ficam muito mais rápidas e práticas, especialmente quando os modelos precisam ser atualizados com frequência.
A destilação de conjuntos de dados também pode ser combinada com a destilação de conhecimento para grandes modelos de linguagem. Um pequeno conjunto de dados destilado pode preservar os sinais mais importantes da tarefa provenientes do modelo professor, permitindo treinar ou atualizar um modelo aluno compactado com mais eficiência e sem grande perda de desempenho. Como esses conjuntos de dados são minúsculos, eles são especialmente úteis para uso na borda ou no próprio dispositivo, onde o armazenamento e os recursos computacionais são limitados, mas ainda é importante manter a precisão do modelo após as atualizações.
Vantagens e desvantagens da destilação de dados#
Veja algumas vantagens do uso da destilação de conjuntos de dados:
- Ótima para experimentos rápidos. Você pode testar novas arquiteturas, funções de perda ou hiperparâmetros sem retreinar com um conjunto de dados enorme a cada vez.
- Possível vantagem para a privacidade. Compartilhar amostras sintéticas destiladas pode ser mais seguro do que compartilhar pontos de dados reais de usuários, já que os exemplos brutos não são expostos diretamente.
- Muitas vezes, melhor do que simplesmente selecionar um subconjunto. Em vez de apenas selecionar exemplos, a destilação os otimiza ativamente para que sejam o mais informativos possível.
Embora a destilação de conjuntos de dados ofereça várias vantagens, veja algumas limitações que você deve ter em mente:
- Sobreajuste. Os dados destilados costumam funcionar melhor com a arquitetura usada durante a destilação e podem não se transferir bem para modelos muito diferentes.
- Sensível a hiperparâmetros. Os resultados podem depender bastante de fatores como a taxa de aprendizado, a inicialização ou o número de etapas de destilação.
- Mais difícil de escalar para a complexidade do mundo real. Métodos que funcionam bem em benchmarks podem perder precisão em conjuntos de dados grandes, desorganizados ou de alta resolução.
Principais conclusões#
A destilação de conjuntos de dados permite que um pequeno conjunto de amostras sintéticas ensine um modelo quase tão eficazmente quanto um conjunto de dados completo. Isso torna o aprendizado de máquina mais rápido, eficiente e fácil de escalar. À medida que os modelos crescem e exigem mais dados, os conjuntos de dados destilados oferecem uma maneira prática de reduzir os custos computacionais sem sacrificar a precisão.
Junta-te à nossa comunidade e consulta o nosso repositório do GitHub para saberes mais sobre IA. Se queres criar o teu próprio projeto de IA para visão, consulta as nossas opções de licenciamento. Descobre mais sobre aplicações como IA na área da saúde e IA para visão no varejo nas nossas páginas de soluções.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









