O que é overfitting em visão computacional e como evitá-lo?
Saiba o que é overfitting em visão computacional e como evitá-lo usando aumento de dados, regularização e modelos pré-treinados.
Os modelos de visão computacional foram desenvolvidos para reconhecer padrões, detectar objetos e analisar imagens. No entanto, seu desempenho depende da capacidade de generalização para dados que ainda não viram. Generalização é a capacidade do modelo de funcionar bem em imagens novas, não apenas naquelas usadas no treinamento. Um problema comum no treinamento desses modelos é o sobreajuste, em que o modelo aprende demais com os dados de treinamento, inclusive ruídos desnecessários, em vez de identificar padrões significativos.
Quando isso acontece, o modelo tem bom desempenho nos dados de treinamento, mas encontra dificuldades com imagens novas. Por exemplo, um modelo de detecção de objetos treinado apenas com imagens de alta resolução e bem iluminadas pode falhar diante de imagens desfocadas ou com sombras em condições do mundo real. O sobreajuste limita a capacidade de adaptação do modelo e restringe seu uso em aplicações do mundo real, como direção autônoma, imagens médicas e sistemas de segurança.
Neste artigo, vamos explorar o que é sobreajuste, por que acontece e como evitá-lo. Também veremos como modelos de visão computacional como o Ultralytics YOLO11 ajudam a reduzir o sobreajuste e melhorar a generalização.
O que é sobreajuste?#
O sobreajuste acontece quando um modelo memoriza os dados de treinamento em vez de aprender padrões que se aplicam amplamente a novas entradas. O modelo fica concentrado demais nos dados de treinamento e, por isso, tem dificuldades com imagens ou situações novas que ainda não encontrou.
Na visão computacional, o sobreajuste pode afetar diferentes tarefas. Um modelo de classificação treinado apenas com imagens claras e bem iluminadas pode ter dificuldades em condições de pouca luz. Um modelo de detecção de objetos que aprende com imagens perfeitas pode falhar em cenas lotadas ou desorganizadas. Da mesma forma, um modelo de segmentação de instâncias pode funcionar bem em ambientes controlados, mas ter dificuldades com sombras ou objetos sobrepostos.
Isso se torna um problema em aplicações de IA do mundo real, nas quais os modelos precisam generalizar para além das condições controladas de treinamento. Carros autônomos, por exemplo, precisam detectar pedestres em diferentes condições de iluminação, clima e ambiente. Um modelo que apresenta sobreajuste ao conjunto de treinamento não terá um desempenho confiável em cenários tão imprevisíveis.
Quando e por que ocorre o sobreajuste?#
O sobreajuste geralmente ocorre devido a conjuntos de dados desequilibrados, complexidade excessiva do modelo e treinamento excessivo. Estas são as principais causas:
- Dados de treinamento limitados: Conjuntos de dados pequenos fazem com que os modelos memorizem padrões em vez de generalizá-los. Um modelo treinado com apenas 50 imagens de pássaros pode ter dificuldade para detectar espécies de pássaros que não aparecem nesse conjunto de dados.
- Modelos complexos com parâmetros demais: Redes profundas com camadas e neurônios em excesso tendem a memorizar detalhes minuciosos em vez de se concentrarem nas características essenciais.
- Falta de aumento de dados: Sem transformações como recorte, inversão ou rotação, o modelo pode aprender apenas com as imagens exatas do conjunto de treinamento.
- Treinamento prolongado: Se um modelo percorre os dados de treinamento muitas vezes — em ciclos conhecidos como épocas —, ele memoriza detalhes em vez de aprender padrões gerais, tornando-se menos adaptável.
- Rótulos inconsistentes ou ruidosos: Dados rotulados incorretamente fazem com que o modelo aprenda padrões errados. Isso é comum em conjuntos de dados rotulados manualmente.
Uma abordagem equilibrada à complexidade do modelo, à qualidade do conjunto de dados e às técnicas de treinamento garante uma melhor generalização.
Sobreajuste vs. subajuste#
O sobreajuste e o subajuste são problemas completamente opostos no aprendizado profundo.
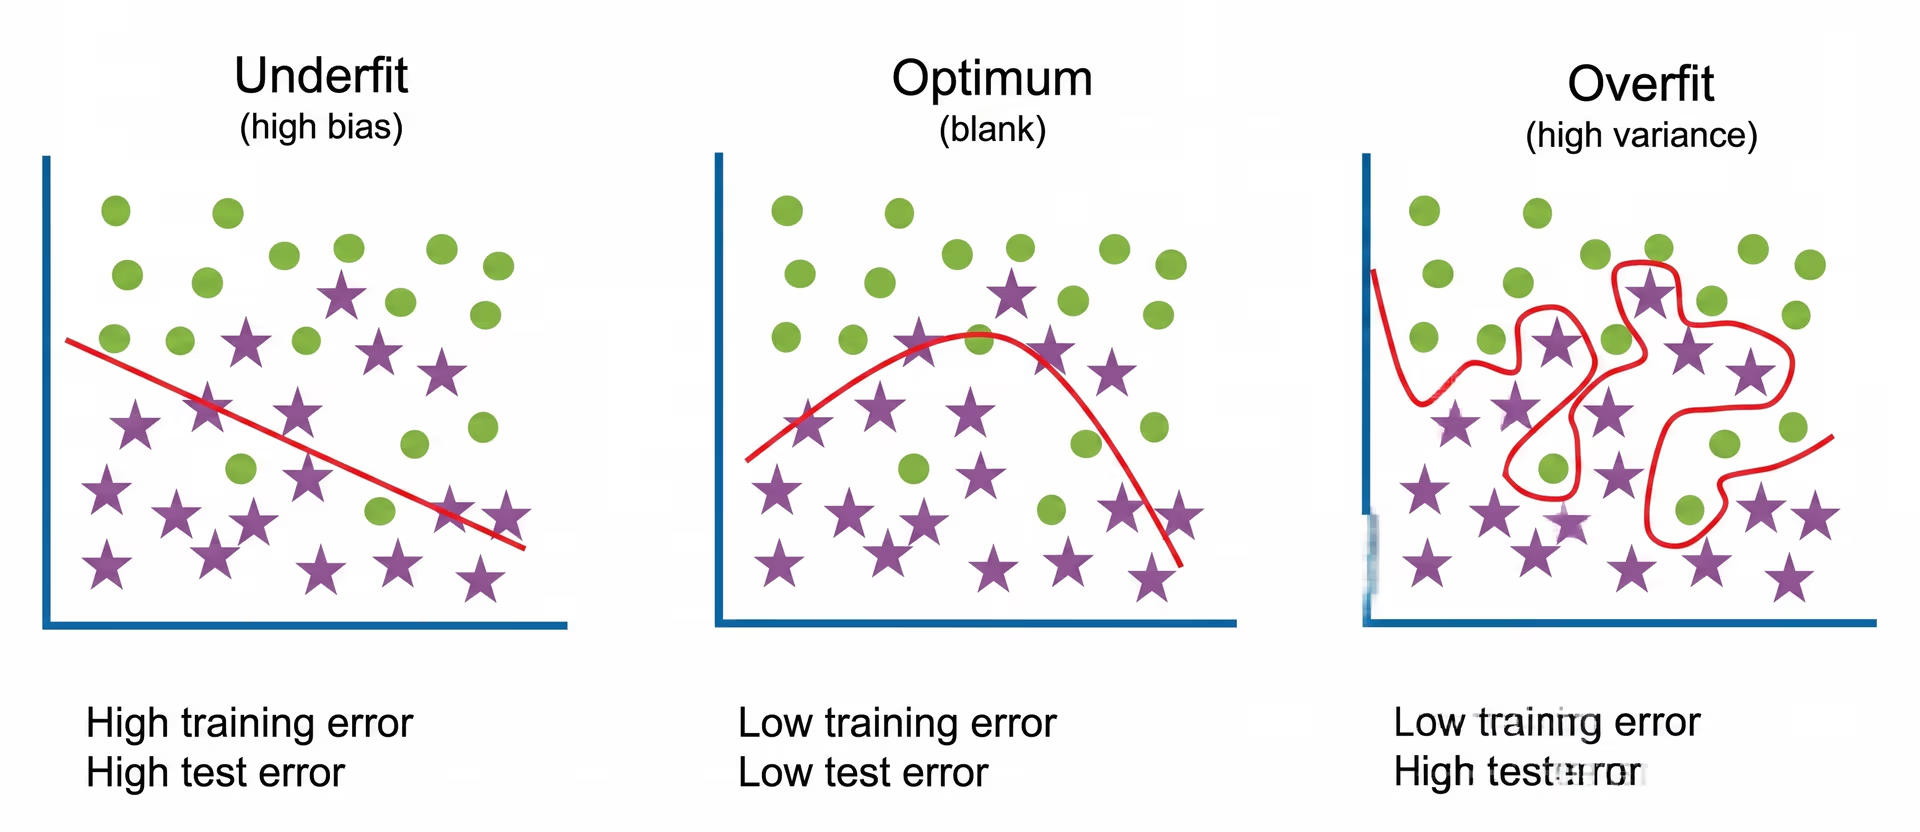
Fig. 1. Comparação entre subajuste, aprendizado ideal e sobreajuste em modelos de visão computacional.
O sobreajuste acontece quando um modelo é complexo demais e fica excessivamente concentrado nos dados de treinamento. Em vez de aprender padrões gerais, ele memoriza pequenos detalhes, até mesmo os irrelevantes, como ruído de fundo. Isso faz com que o modelo tenha bom desempenho nos dados de treinamento, mas dificuldades com imagens novas, o que significa que ele não aprendeu de fato a reconhecer padrões aplicáveis a diferentes situações.
O subajuste acontece quando um modelo é simples demais e não consegue captar padrões importantes nos dados. Isso pode ocorrer quando o modelo tem poucas camadas, não recebe tempo suficiente de treinamento ou dispõe de poucos dados. Como resultado, ele não reconhece padrões importantes e faz previsões imprecisas. Isso leva a um desempenho ruim tanto nos dados de treinamento quanto nos de teste, pois o modelo não aprendeu o suficiente para compreender a tarefa corretamente.
Um modelo bem treinado encontra o equilíbrio entre complexidade e generalização. Ele deve ser complexo o bastante para aprender padrões relevantes, mas não a ponto de memorizar os dados em vez de reconhecer as relações subjacentes.
Como identificar o sobreajuste#
Veja alguns sinais de que um modelo está apresentando sobreajuste:
- Se a precisão no treinamento for significativamente maior do que a precisão na validação, é provável que o modelo esteja apresentando sobreajuste.
- Uma diferença crescente entre a perda no treinamento e a perda na validação é outro forte indicador.
- O modelo demonstra confiança excessiva em respostas erradas, indicando que memorizou detalhes em vez de compreender padrões.
Para garantir que um modelo generalize bem, é preciso testá-lo com conjuntos de dados variados que reflitam condições do mundo real.
Como evitar o sobreajuste em visão computacional#
O sobreajuste não é inevitável e pode ser evitado. Com as técnicas certas, os modelos de visão computacional podem aprender padrões gerais em vez de memorizar os dados de treinamento, tornando-se mais confiáveis em aplicações do mundo real.
Veja cinco estratégias fundamentais para evitar o sobreajuste em visão computacional.
Aumenta a diversidade dos dados com aumento de dados e dados sintéticos#
A melhor forma de ajudar um modelo a funcionar bem com dados novos é ampliar o conjunto de dados usando aumento de dados e dados sintéticos. Os dados sintéticos são gerados por computador, em vez de serem coletados de imagens do mundo real. Eles ajudam a preencher lacunas quando não há dados reais suficientes.
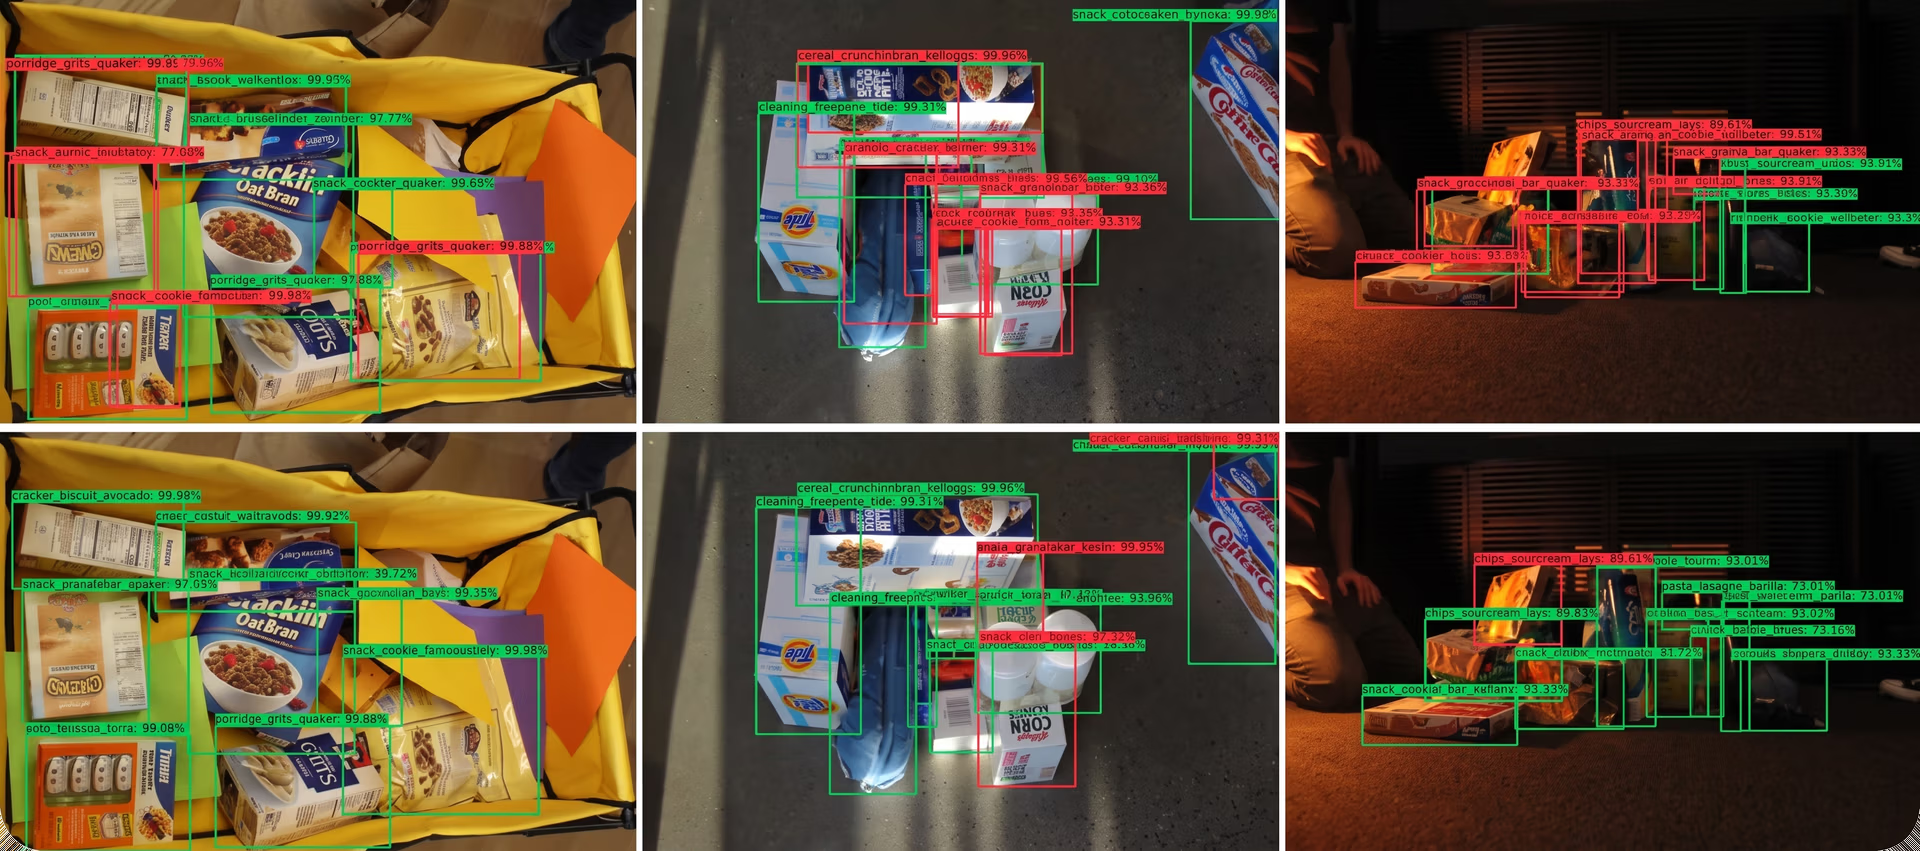
Fig. 2. A combinação de dados do mundo real e dados sintéticos reduz o sobreajuste e melhora a precisão da detecção de objetos.
O aumento de dados altera ligeiramente as imagens existentes por meio de inversões, rotações, recortes ou ajustes de brilho, para que o modelo não apenas memorize detalhes, mas aprenda a reconhecer objetos em diferentes situações.
Os dados sintéticos são úteis quando é difícil obter imagens reais. Por exemplo, modelos de carros autônomos podem ser treinados com cenas de estrada geradas por computador para aprender a detectar objetos em diferentes condições climáticas e de iluminação. Isso torna o modelo mais flexível e confiável, sem exigir milhares de imagens do mundo real.
Otimize a complexidade e a arquitetura do modelo#
Uma rede neural profunda, que é um tipo de modelo de aprendizado de máquina com muitas camadas que processam dados, em vez de uma única camada, nem sempre é melhor. Quando um modelo tem camadas ou parâmetros demais, ele memoriza os dados de treinamento em vez de reconhecer padrões mais amplos. Reduzir a complexidade desnecessária pode ajudar a evitar o sobreajuste.
Para isso, uma abordagem é a poda, que remove neurônios e conexões redundantes, deixando o modelo mais enxuto e eficiente.
Outra abordagem é simplificar a arquitetura reduzindo o número de camadas ou neurônios. Modelos pré-treinados como o Ultralytics YOLO11 foram desenvolvidos para generalizar bem entre tarefas com menos parâmetros, tornando-os mais resistentes ao sobreajuste do que treinar um modelo profundo do zero.
Encontrar o equilíbrio certo entre profundidade e eficiência do modelo ajuda-o a aprender padrões úteis sem apenas memorizar os dados de treinamento.
Aplique técnicas de regularização#
As técnicas de regularização impedem que os modelos se tornem excessivamente dependentes de características específicas dos dados de treinamento. Estas são algumas técnicas usadas com frequência:
- Dropout desativa partes aleatórias do modelo durante o treinamento para que ele aprenda a reconhecer diferentes padrões, em vez de depender demais de algumas características.
- Decaimento de pesos (regularização L2) desestimula valores extremos de pesos, mantendo a complexidade do modelo sob controle.
- Normalização em lote ajuda a estabilizar o treinamento, tornando o modelo menos sensível às variações do conjunto de dados.
Essas técnicas ajudam a manter a flexibilidade e a adaptabilidade do modelo, reduzindo o risco de sobreajuste sem prejudicar a precisão.
Monitore o treinamento com validação e parada antecipada#
Para evitar o sobreajuste, é importante acompanhar como o modelo aprende e garantir que ele generalize bem para dados novos. Estas são algumas técnicas que ajudam nesse processo:
- Parada antecipada: encerra automaticamente o treinamento quando o modelo para de melhorar, para que ele não continue aprendendo detalhes desnecessários.
- Validação cruzada: divide os dados em partes e treina o modelo com cada uma delas. Isso ajuda o modelo a aprender padrões em vez de memorizar imagens específicas.
Essas técnicas ajudam a manter o equilíbrio do modelo, para que ele aprenda o suficiente para ser preciso sem se concentrar demais apenas nos dados de treinamento.
Use modelos pré-treinados e melhore a rotulagem do conjunto de dados#
Em vez de treinar do zero, usar modelos pré-treinados como o Ultralytics YOLO11 pode reduzir o sobreajuste. O YOLO11 é treinado com conjuntos de dados em grande escala, o que permite generalizar bem em diferentes condições.
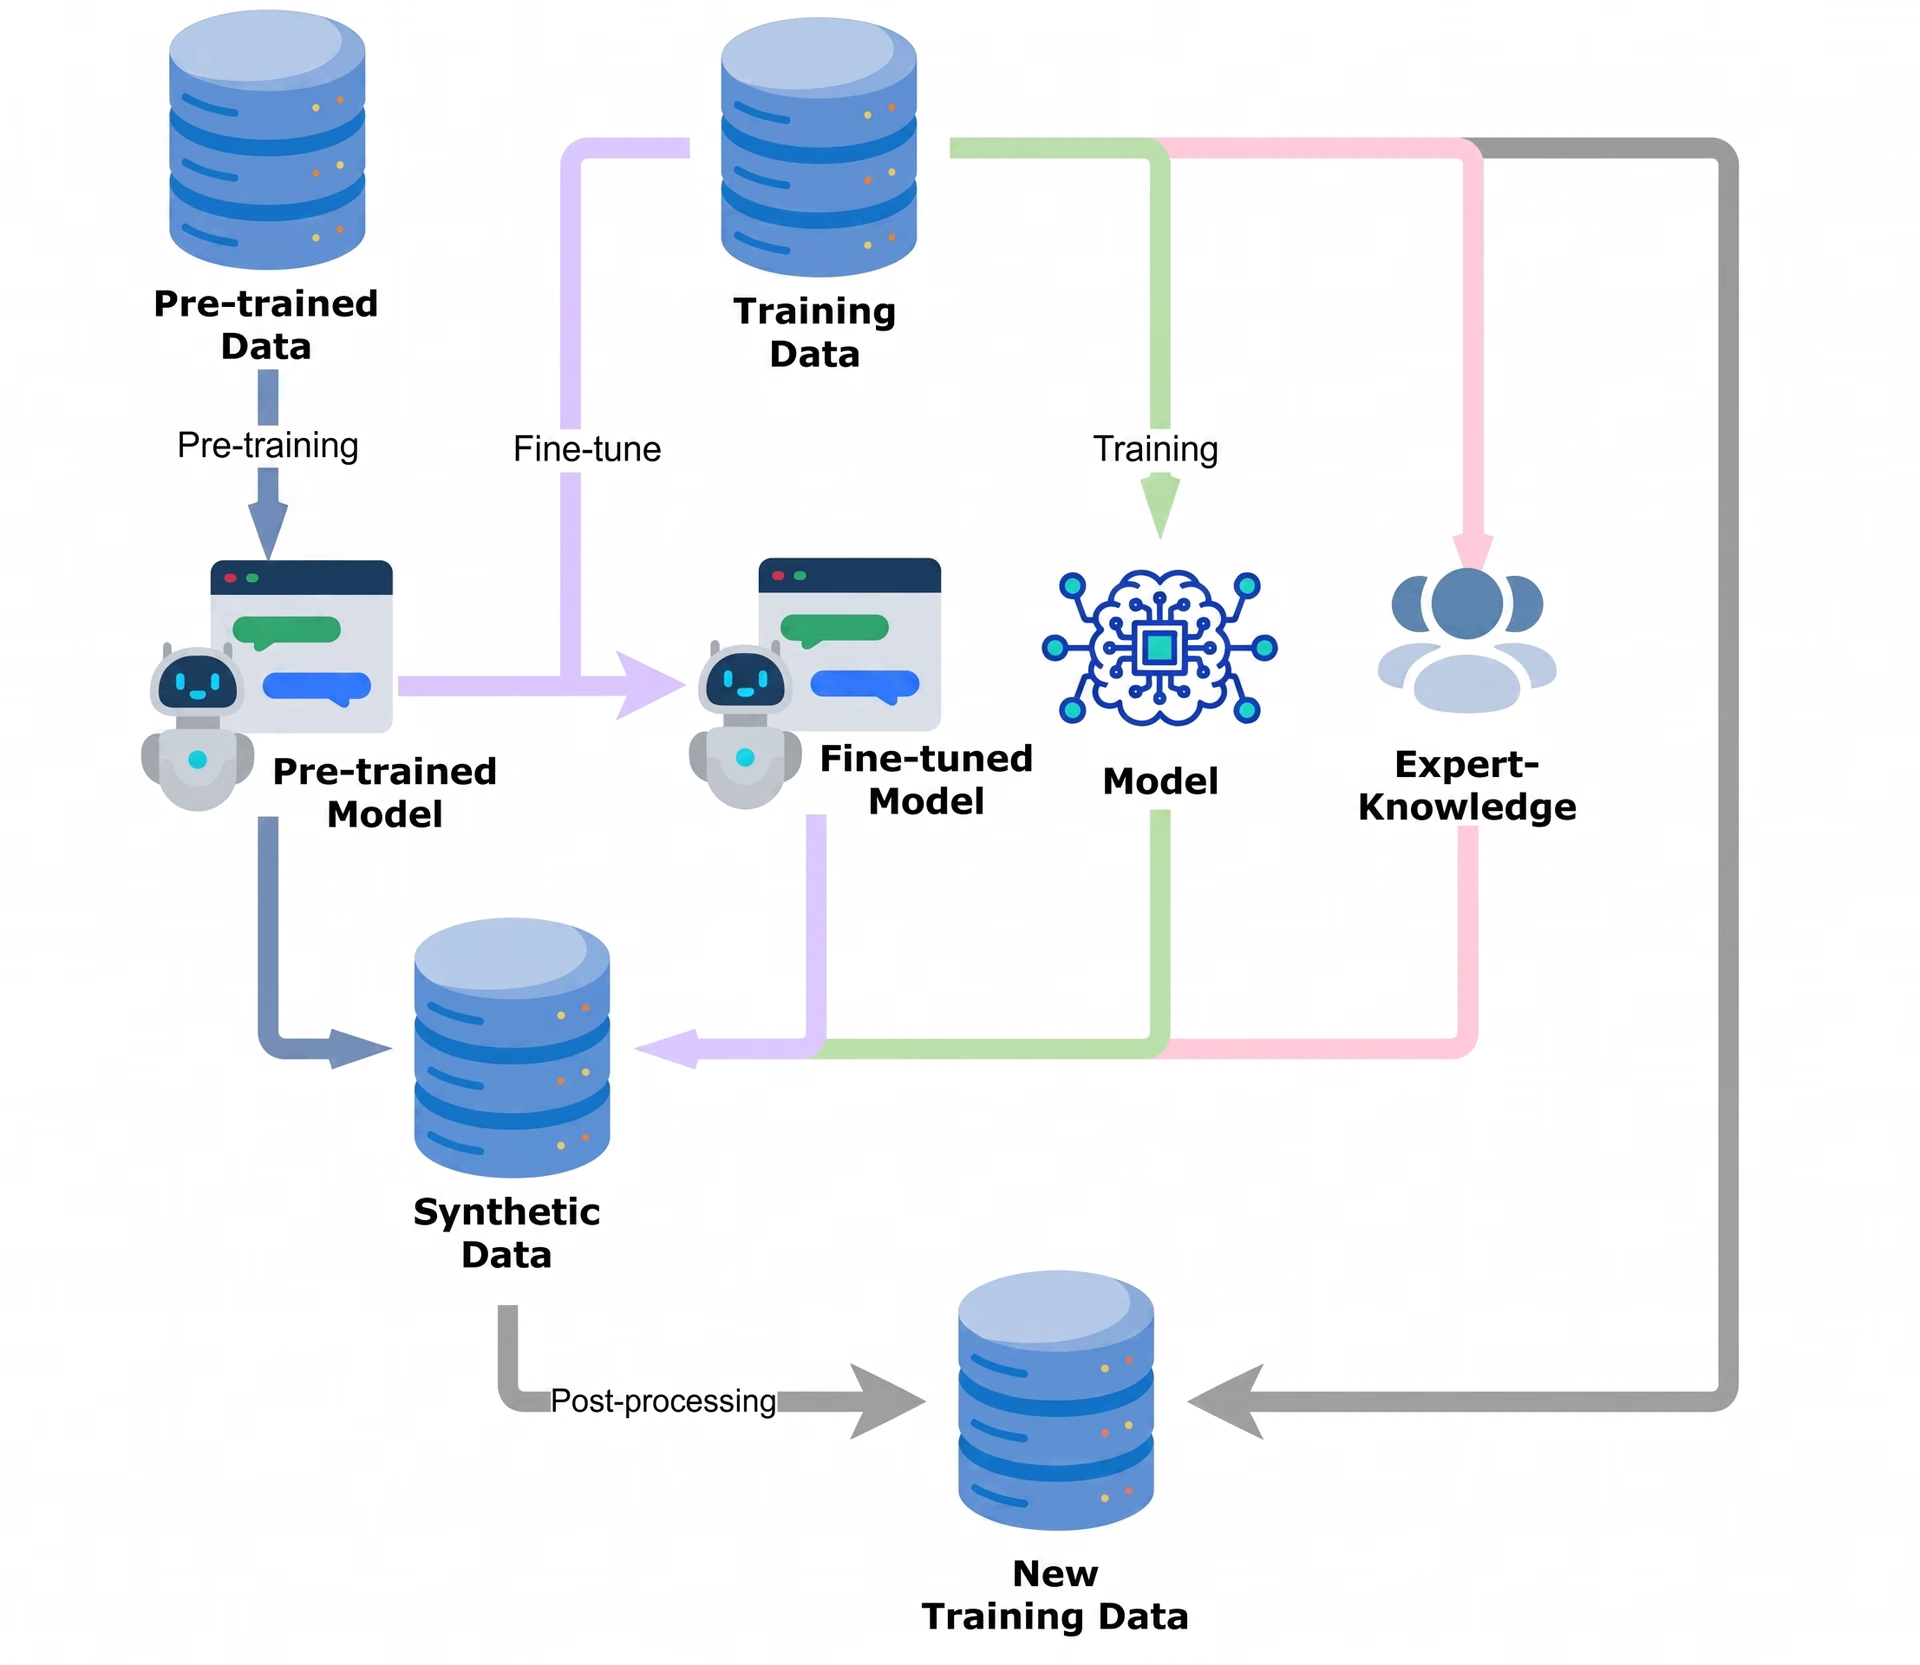
Fig. 3. Modelos pré-treinados de visão computacional melhoram a precisão e evitam o sobreajuste.
O ajuste fino de um modelo pré-treinado ajuda-o a manter o que já sabe enquanto aprende novas tarefas, para que não se limite a memorizar os dados de treinamento.
Além disso, é essencial garantir uma rotulagem de alta qualidade do conjunto de dados. Dados rotulados incorretamente ou desbalanceados podem levar os modelos a aprender padrões errados. Limpar os conjuntos de dados, corrigir imagens rotuladas incorretamente e balancear as classes melhora a precisão e reduz o risco de sobreajuste. Outra abordagem eficaz é o treinamento adversarial, no qual o modelo é exposto a exemplos ligeiramente alterados ou mais desafiadores, criados para testar seus limites.
Principais conclusões#
O sobreajuste é um problema comum em visão computacional. Um modelo pode funcionar bem com dados de treinamento, mas ter dificuldades com imagens do mundo real. Para evitar isso, técnicas como aumento de dados, regularização e uso de modelos pré-treinados como o Ultralytics YOLO11 ajudam a melhorar a precisão e a adaptabilidade.
Com a aplicação desses métodos, os modelos de IA podem continuar confiáveis e ter um bom desempenho em diferentes ambientes. À medida que o aprendizado profundo avança, garantir que os modelos generalizem corretamente será essencial para o sucesso da IA no mundo real.
Junte-se à nossa comunidade, que não para de crescer! Explore nosso repositório no GitHub para saber mais sobre IA. Quer começar seus próprios projetos de visão computacional? Confira nossas opções de licenciamento. Descubra a IA de visão em carros autônomos e a IA na área da saúde visitando nossas páginas de soluções!









