O que são dados sintéticos em visão computacional? Uma visão geral
Explore como os dados sintéticos para treinamento de modelos de IA são usados em aplicações de visão computacional em diversos setores, como saúde e robótica.
Os dados sempre foram um fator determinante em áreas como análise de dados e inteligência artificial (IA). Na verdade, a forma como coletamos, geramos e usamos dados está moldando o futuro dos sistemas inteligentes. Por exemplo, os carros autônomos dependem de milhões de imagens rotuladas e leituras de sensores — de placas de trânsito aos movimentos de pedestres — para aprender a navegar pelas ruas com segurança.
Um dos tipos de dados mais importantes para impulsionar esse progresso, especialmente em áreas como veículos autônomos e segurança, são os dados visuais, como imagens e vídeos.
Em particular, a área da IA que permite às máquinas interpretar essas informações visuais é chamada de visão computacional. Ela ajuda os sistemas a compreender e analisar dados visuais de forma semelhante aos seres humanos, possibilitando tarefas como reconhecimento facial, detecção de placas de trânsito e análise de imagens médicas.
No entanto, coletar conjuntos de dados visuais de alta qualidade e em larga escala no mundo real pode ser demorado, caro e muitas vezes suscitar preocupações com a privacidade. Por isso, os pesquisadores estão explorando ativamente o conceito de uso de dados sintéticos.
Dados sintéticos são dados visuais gerados artificialmente que imitam de perto imagens e vídeos do mundo real. Eles são criados com técnicas como modelagem 3D, simulações computacionais e métodos de IA generativa, como as redes adversárias generativas (GANs), que aprendem padrões a partir de dados reais para produzir novos exemplos realistas.
Espera-se que os dados sintéticos desempenhem em breve um papel fundamental no desenvolvimento de IA — a Gartner prevê que, até 2030, eles se tornarão mais essenciais do que os dados do mundo real. Neste artigo, vamos explorar o que são dados sintéticos no contexto da visão computacional, como são gerados e onde estão sendo aplicados em situações do mundo real. Vamos começar!
O que são dados sintéticos em visão computacional?#
Imagine que você queira treinar um modelo de IA para visão para detectar objetos em ambientes e condições variados. Confiar apenas em dados do mundo real pode ser difícil e, às vezes, parecer limitante.
Por outro lado, os dados sintéticos podem ser usados para criar o conjunto de dados ideal, com objetos em diversas condições criadas artificialmente. Com ferramentas como modelagem 3D e simulações, os desenvolvedores podem gerar imagens com controle preciso de fatores como iluminação, ângulos e posicionamento dos objetos. Isso, por sua vez, oferece mais flexibilidade para o treinamento de modelos do que os dados do mundo real.
Os dados sintéticos são especialmente úteis quando é difícil ou impossível coletar dados do mundo real. Por exemplo, treinar um modelo para reconhecer pessoas em várias poses, como correndo, agachadas ou deitadas, exigiria capturar milhares de fotos em diversos cenários, ângulos e condições de iluminação.
Por outro lado, com dados sintéticos, os desenvolvedores podem gerar facilmente essas variações com rótulos precisos, economizando tempo e esforço e melhorando o desempenho do modelo.
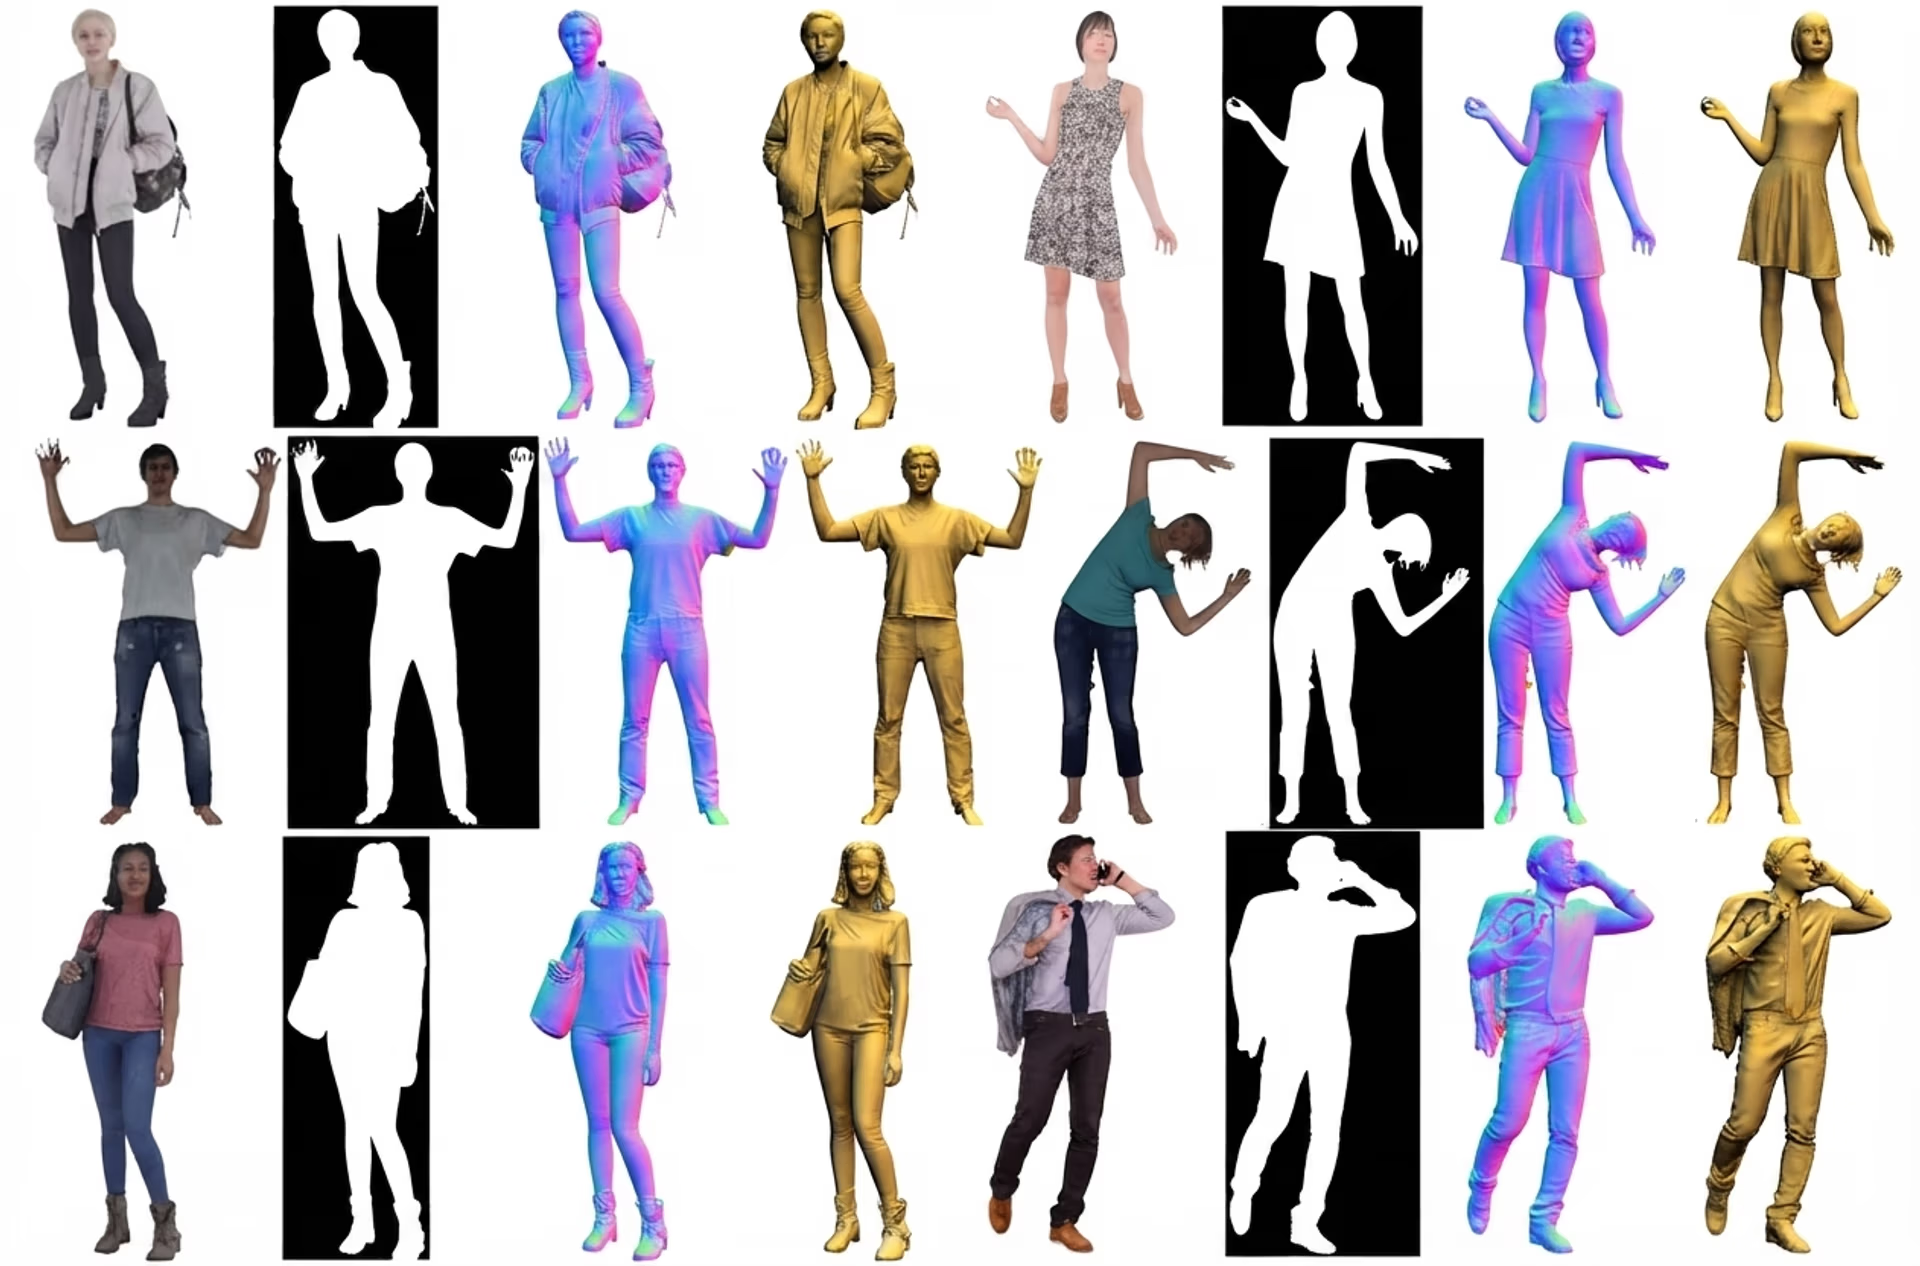
Fig. 1. Um conjunto de dados sintéticos com diferentes poses humanas e variações de iluminação (fonte).
Dados sintéticos versus dados reais em IA#
Agora, vamos analisar mais de perto as diferenças entre dados sintéticos e dados reais. Ambos têm vantagens e desvantagens quando se trata de treinar modelos de IA.
Por exemplo, os dados sintéticos são úteis quando é difícil coletar dados reais, mas talvez não capturem todos os pequenos detalhes encontrados na vida real. Ao mesmo tempo, os dados reais são mais autênticos, mas pode ser difícil obtê-los, sua rotulagem pode levar tempo e talvez não abranjam todas as situações.
Ao combinar dados sintéticos e reais, os desenvolvedores podem aproveitar o melhor dos dois tipos. Esse equilíbrio ajuda os modelos de IA a aprender com mais precisão, generalizar melhor para diferentes cenários e reduzir vieses.
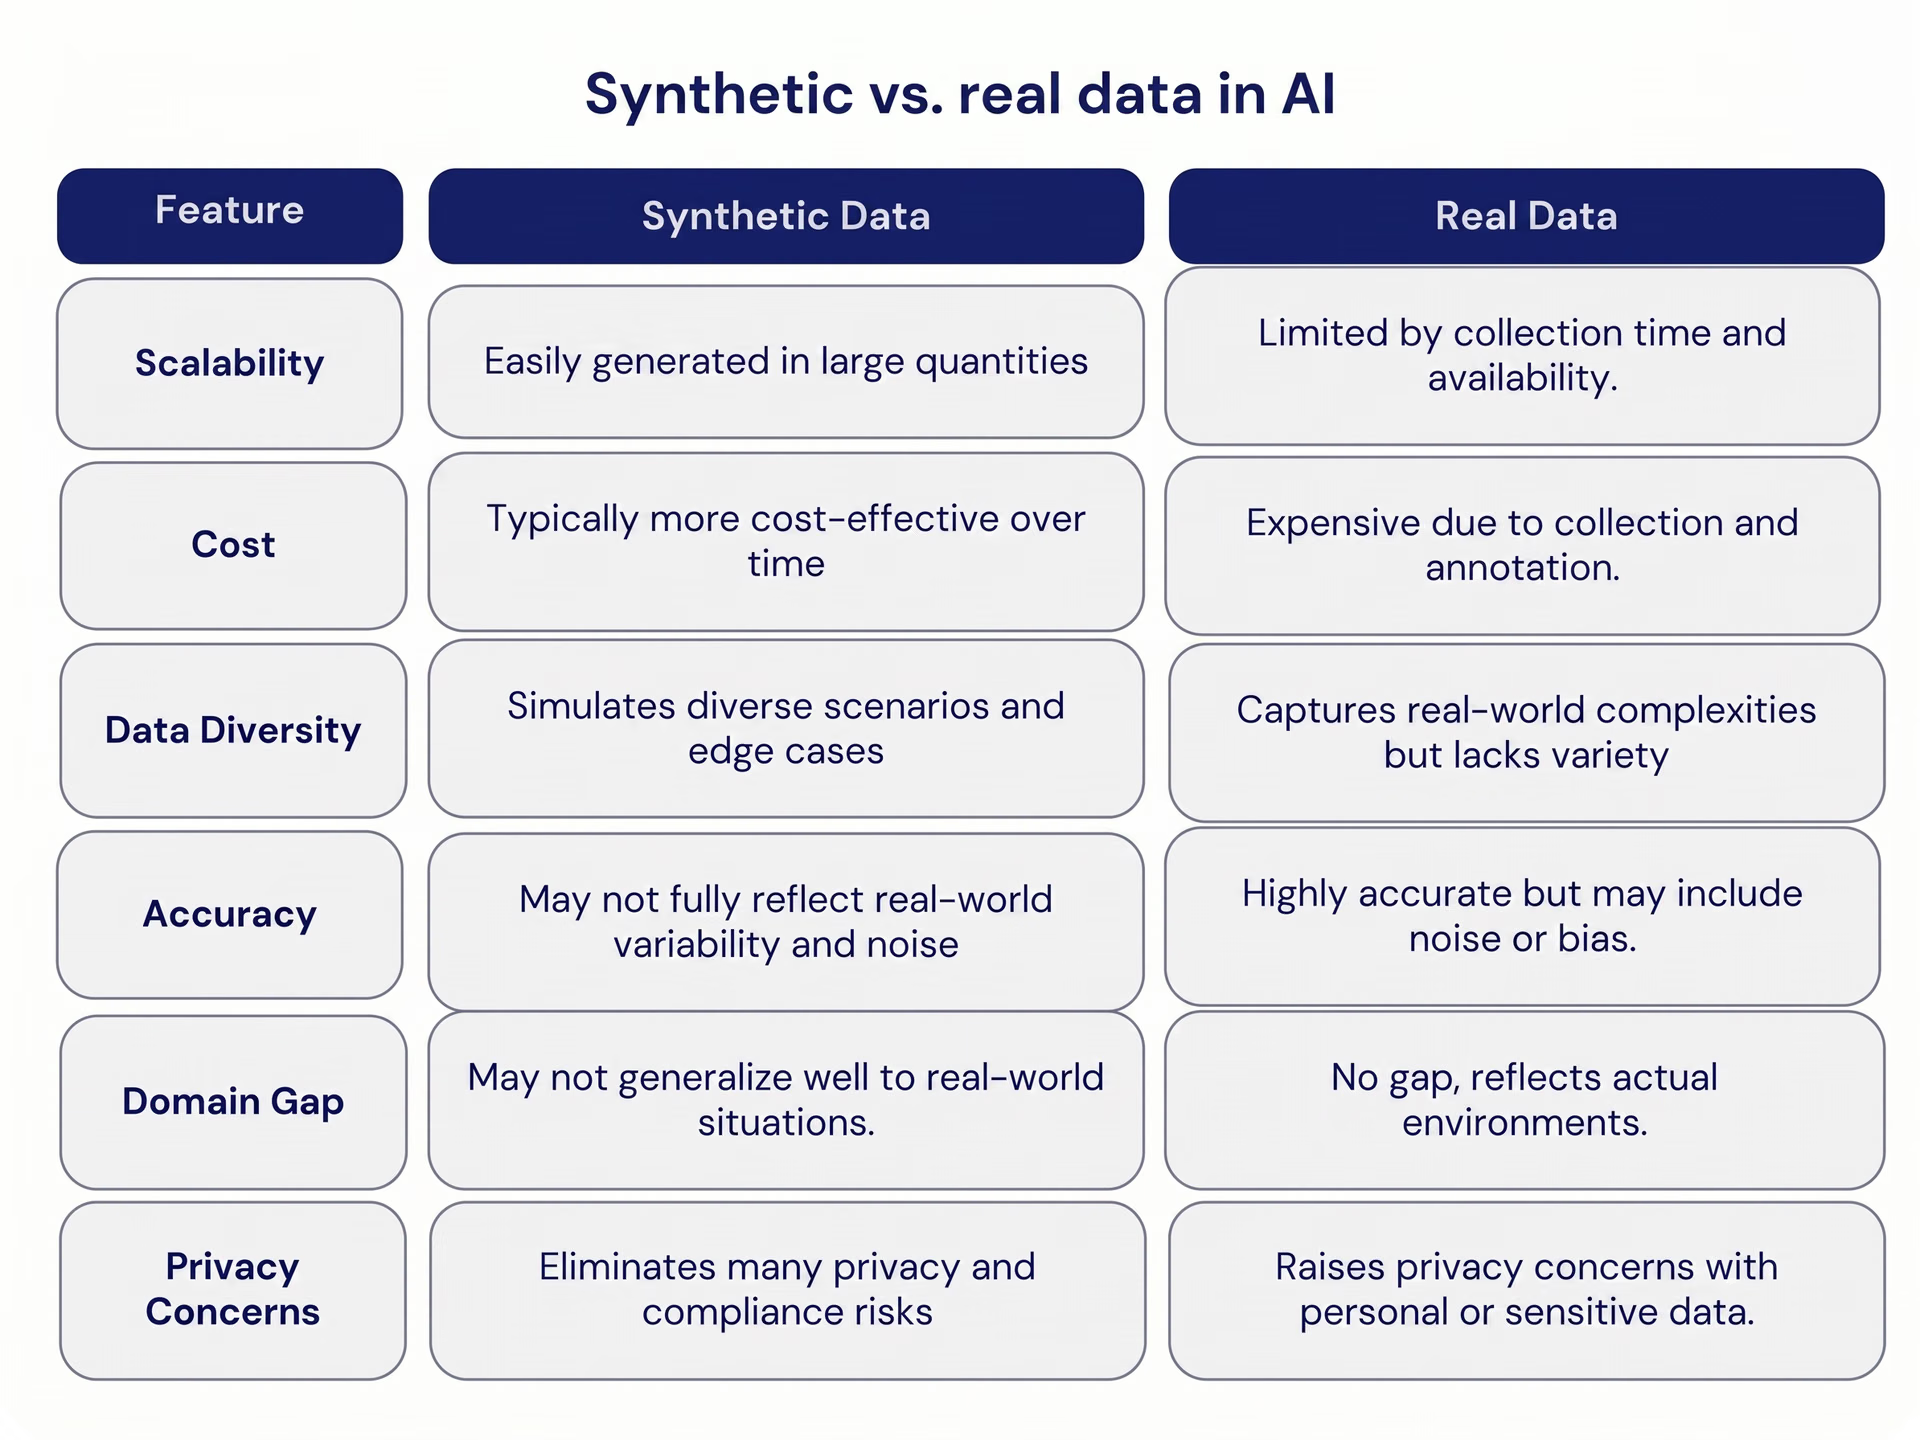
Fig. 2. Dados sintéticos versus dados reais em IA. Imagem do autor.
Uma análise da geração de dados para modelos de visão computacional#
Da criação de mundos virtuais com ferramentas 3D à geração de imagens com IA generativa, veja alguns métodos comuns para criar dados de treinamento sintéticos para modelos de visão computacional:
- Modelagem 3D: os desenvolvedores usam software 3D para criar objetos e cenas digitais. Isso permite controlar totalmente elementos como iluminação, ângulos da câmera e posicionamento dos objetos, além de ser útil para gerar imagens realistas de pessoas, veículos e ambientes.
- Simulações: elas recriam situações do mundo real, como o trânsito ou ambientes fabris, usando mecanismos baseados em física. As simulações são úteis para gerar dados de treinamento com segurança em áreas como robótica e carros autônomos.
- Redes adversárias generativas: as GANs são um tipo de modelo de aprendizagem profunda composto por duas redes: uma que cria imagens e outra que as avalia. Juntas, elas geram imagens altamente realistas, como rostos humanos ou cenas de rua, aprendendo com exemplos reais.
- Geração procedural: essa técnica usa regras predefinidas ou modelos matemáticos para gerar automaticamente estruturas visuais complexas, como terrenos, edifícios ou texturas. Ela é usada com frequência em jogos e plataformas de simulação e pode produzir conjuntos de dados diversos e em larga escala com o mínimo de intervenção humana.
- Randomização de domínio: essa técnica pode alterar aleatoriamente elementos como iluminação, cores e formas dos objetos em cenas sintéticas. O objetivo é ajudar os modelos a se concentrarem no que realmente importa, tornando-os mais adaptáveis aos ambientes do mundo real.
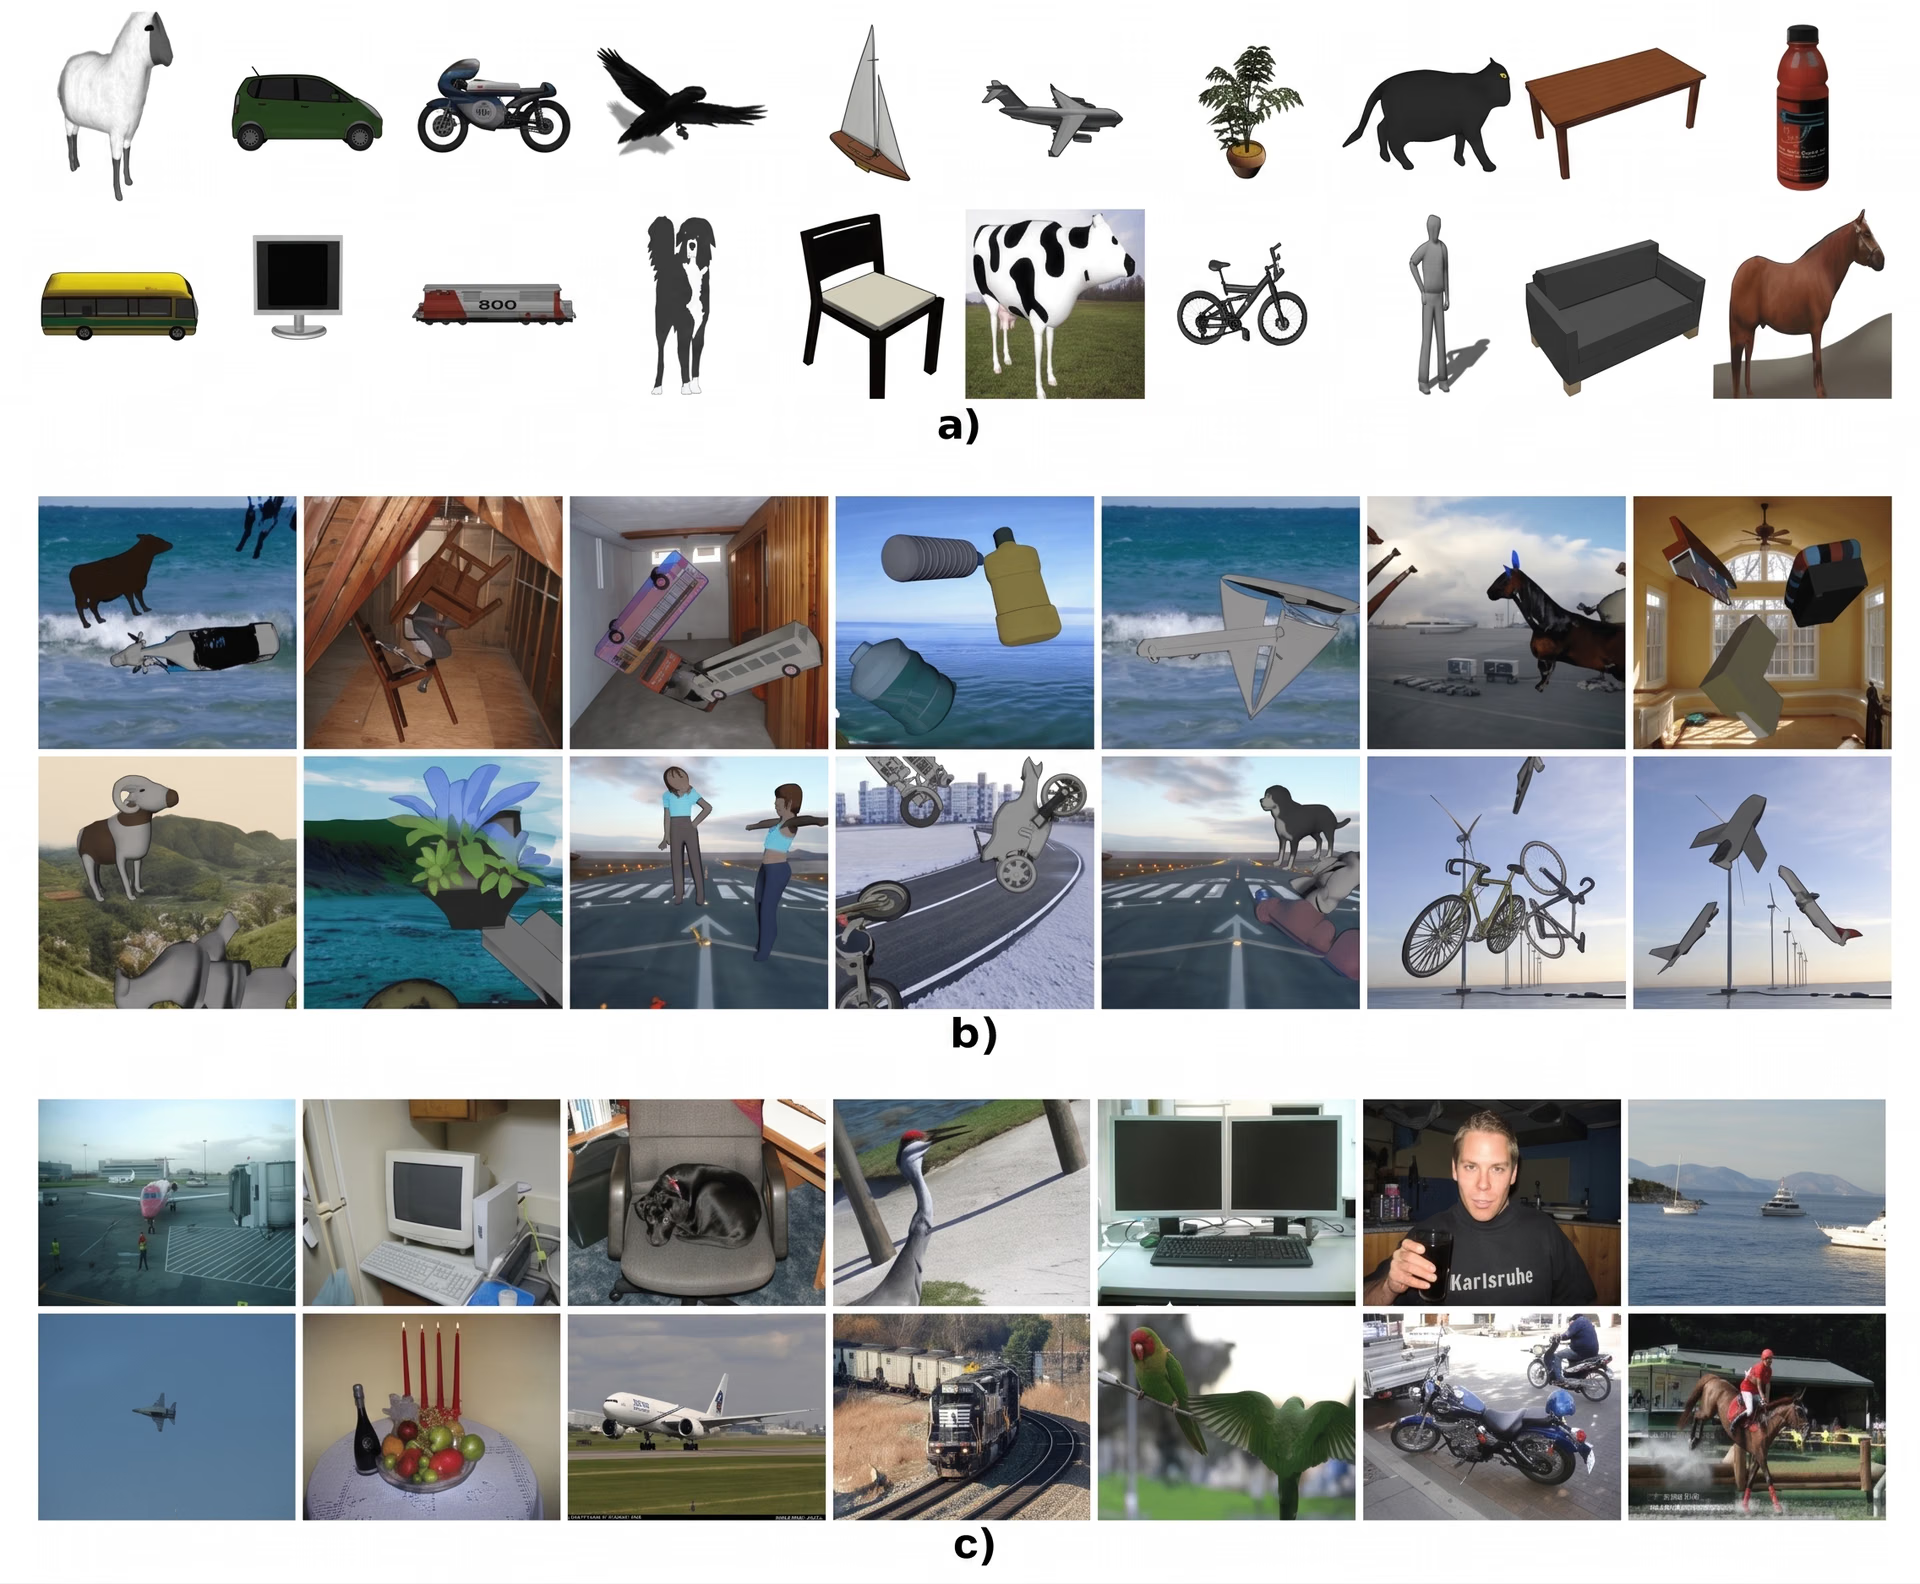
Fig. 3. Exemplos de dados: (a) baseados em modelos 3D, (b) cenas sintéticas com vários objetos e (c) imagens de conjuntos de dados reais (fonte).
Treinamento de modelos de IA para visão com dados sintéticos#
Agora que já falamos sobre alguns dos diferentes métodos usados para criar dados sintéticos, vamos explicar como eles são usados para treinar modelos de IA.
Depois de gerados, os dados sintéticos geralmente podem ser integrados diretamente ao pipeline de treinamento, da mesma forma que os dados do mundo real. Eles costumam incluir as anotações necessárias, como rótulos de objetos, caixas delimitadoras ou máscaras de segmentação, o que permite usá-los em tarefas de aprendizagem supervisionada — nas quais os modelos aprendem com pares de entrada e saída rotulados — sem a necessidade de rotulagem manual.
Durante o treinamento, o modelo processa imagens sintéticas para aprender a detectar características, reconhecer padrões e classificar objetos. Esses dados podem ser usados para criar uma versão inicial do modelo do zero ou para enriquecer um conjunto de dados existente, ajudando a melhorar o desempenho do modelo.
Em muitos fluxos de trabalho, os dados sintéticos também são usados no pré-treinamento, dando aos modelos uma compreensão ampla e fundamental antes do ajuste fino com exemplos do mundo real. Da mesma forma, são usados para aumentar conjuntos de dados por meio da introdução de variações controladas, como diferentes condições de iluminação, ângulos ou classes de objetos raras, para melhorar a generalização e reduzir o sobreajuste.
Ao combinar dados sintéticos e reais, as equipes podem treinar modelos mais robustos, que funcionam bem em uma ampla variedade de condições, reduzindo ao mesmo tempo a dependência de processos de coleta manual de dados demorados e caros.
Aplicações de dados sintéticos no mundo real em visão computacional#
À medida que os dados sintéticos se tornam mais práticos e acessíveis, começamos a vê-los sendo adotados em vários casos de uso reais de IA para visão. Vamos explorar algumas das aplicações mais impactantes em visão computacional que já os utilizam.
Uso de dados sintéticos para detecção de objetos em veículos autônomos#
Ensinar carros autônomos a dirigir com segurança exige treinar modelos com uma ampla variedade de cenários, incluindo situações raras ou perigosas. No entanto, coletar dados do mundo real para esses casos extremos pode ser difícil e, às vezes, inseguro. Os dados sintéticos podem ajudar a criar cenas nas quais os modelos aprendam a detectar objetos em situações difíceis. Eles também podem imitar diferentes configurações de sensores, o que é útil porque nem todos os carros autônomos usam o mesmo hardware.
A plataforma DRIVE Sim da NVIDIA é um ótimo exemplo. Ela cria dados sintéticos de alta qualidade usando modelos 3D fotorrealistas, ambientes virtuais e simulações de sensores. Também pode gerar imagens de vários ângulos de condução a partir de uma única imagem. O uso desses dados sintéticos ajuda a reduzir a necessidade de testes caros no mundo real, ao mesmo tempo que oferece ao modelo a variedade necessária para aprender com eficácia.
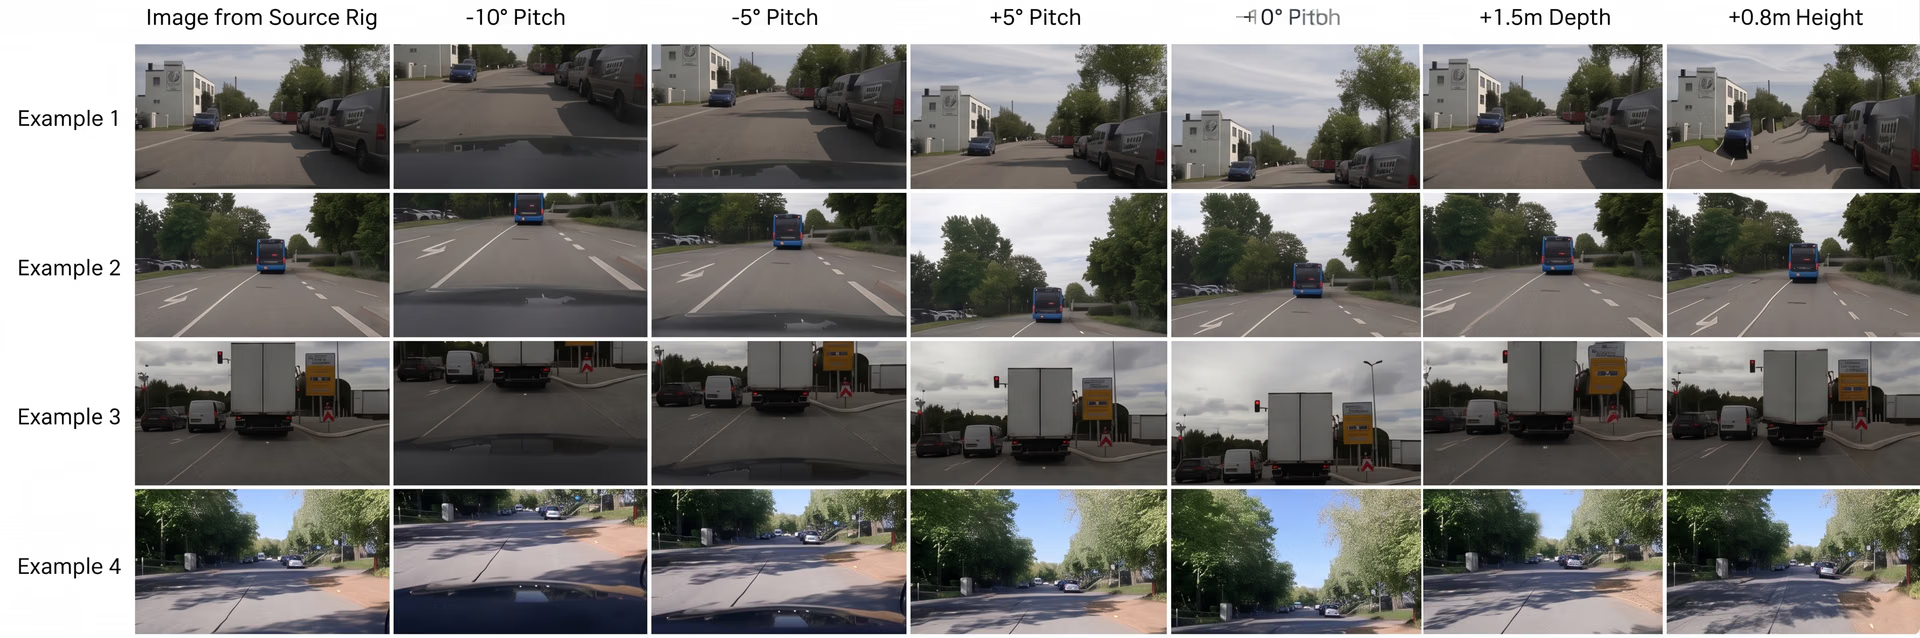
Fig. 4. Criação de várias perspectivas de condução a partir de uma imagem (fonte).
Redução de vieses em IA para imagens médicas com dados sintéticos#
Modelos de visão computacional, como o Ultralytics YOLO11, que oferecem suporte a tarefas como detecção de objetos e segmentação de instâncias, podem ser treinados de forma personalizada para aplicações de imagens médicas. No entanto, os dados de treinamento do mundo real costumam conter vieses, pois talvez não representem adequadamente pacientes de todos os grupos demográficos.
Por exemplo, o câncer de pele é diagnosticado com menos frequência em pessoas com tons de pele mais escuros, o que resulta em poucos dados para essas populações. Esse desequilíbrio pode contribuir para diagnósticos incorretos e resultados de saúde desiguais, especialmente em áreas como histopatologia, radiografias do tórax e dermatologia.
Imagens sintéticas podem ajudar a reduzir essa lacuna nos dados. Ao gerar exemplos adicionais e diversificados, como diferentes anomalias nos tecidos, uma ampla variedade de doenças pulmonares e tons de pele com tipos distintos de lesões, os dados sintéticos podem ajudar a melhorar o desempenho dos modelos em grupos sub-representados.
Atualmente, pesquisadores estão trabalhando no desenvolvimento e na validação de conjuntos de dados sintéticos para apoiar esses objetivos. Eles também estão explorando como os dados sintéticos podem ser usados para testar ferramentas médicas e estratégias de tratamento sem depender de registros de pacientes reais, ajudando a acelerar a pesquisa e proteger a privacidade dos pacientes. Com esse trabalho, os dados sintéticos estão abrindo caminho para sistemas de IA médica mais inclusivos, precisos e éticos.
Avançando a IA agrícola com dados sintéticos para a agricultura de precisão#
A criação de sistemas de IA para visão voltados a aplicações agrícolas depende do acesso a grandes quantidades de dados rotulados. No entanto, coletar e rotular imagens de culturas, doenças e condições do campo é um processo lento e caro, muitas vezes limitado por fatores como o clima, as estações de cultivo ou a dificuldade de acesso a determinadas áreas.
Esses desafios dificultam o treinamento de modelos de visão computacional para tarefas como detectar doenças de plantas, monitorar culturas ou prever safras. É aí que os dados sintéticos podem ajudar — imitando diferentes ambientes agrícolas para gerar exemplos úteis de treinamento.
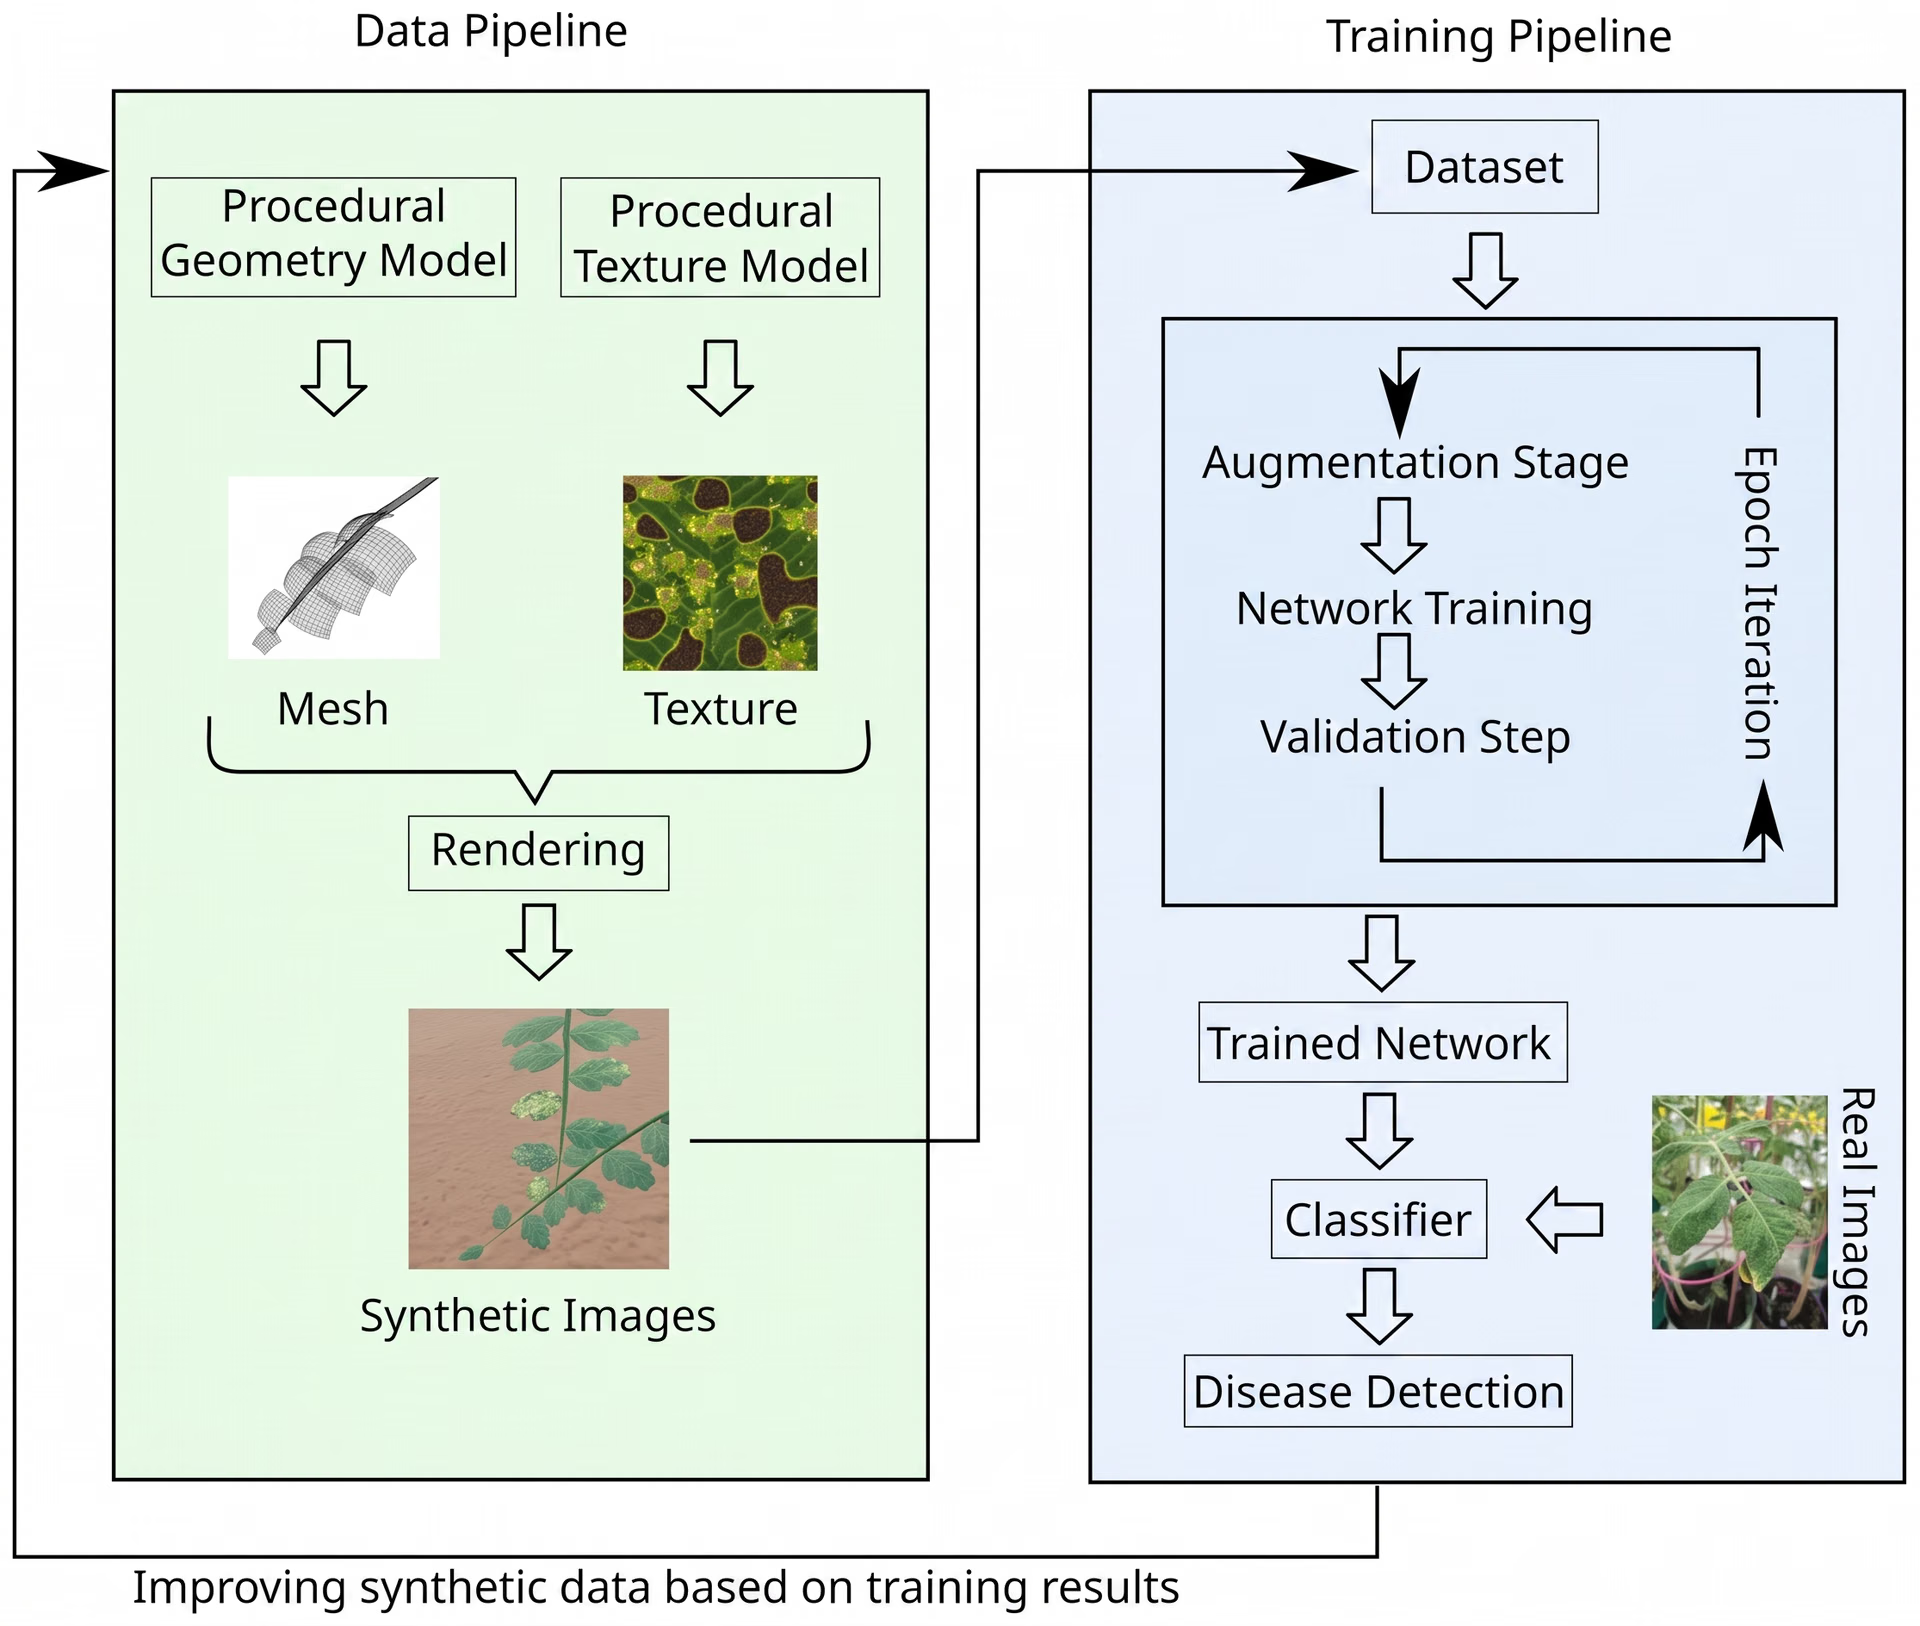
Fig. 5. Uso de imagens sintéticas para melhorar a detecção de doenças (fonte).
Principais conclusões#
O uso de dados sintéticos representa um avanço importante no treinamento de modelos de IA, especialmente para sistemas de visão computacional em áreas onde os dados do mundo real são limitados ou difíceis de obter. Em vez de depender exclusivamente de fotos ou vídeos reais, que podem ser caros, demorados ou suscitar preocupações com a privacidade, os dados sintéticos nos permitem gerar imagens realistas e rotuladas sob demanda.
Eles facilitam o treinamento de modelos de IA para visão em tarefas como direção autônoma, detecção de doenças ou monitoramento de culturas. À medida que a IA continua evoluindo, os dados sintéticos devem desempenhar um papel ainda mais importante na aceleração da inovação e na ampliação da acessibilidade em vários setores.
Saiba mais sobre IA em nosso repositório no GitHub e participe da nossa comunidade em expansão. Descubra o impacto de aplicações como IA em veículos autônomos e visão computacional na agricultura. Explore nossas opções de licenciamento e dê vida aos seus projetos de IA para visão.









