O que é Mask R-CNN e como funciona?
Saiba como funciona o Mask R-CNN, da rede backbone e da rede de propostas de regiões ao ROI Align e à previsão de máscaras, além de conhecer seus usos, limitações e sucessores YOLO.
 Abirami Vina9 min de leitura
Inovações como robôs em armazéns, carros autónomos a circular em segurança por ruas movimentadas, drones a monitorizar plantações e sistemas de IA a inspecionar produtos em fábricas estão a tornar-se mais comuns à medida que a adoção da IA aumenta. Uma tecnologia fundamental para estas inovações é a visão computacional, um ramo da IA que permite às máquinas compreender e interpretar dados visuais.
Por exemplo, a deteção de objetos é uma tarefa de visão computacional que ajuda a identificar e localizar objetos em imagens usando caixas delimitadoras. Embora forneçam informações úteis, as caixas delimitadoras apenas dão uma estimativa aproximada da posição de um objeto e não conseguem captar a sua forma ou os seus limites exatos. Por isso, são menos eficazes em aplicações que exigem uma identificação precisa.
Para resolver este problema, os investigadores desenvolveram modelos de segmentação que captam os contornos exatos dos objetos, fornecendo detalhes ao nível do píxel para uma deteção e análise mais precisas.
O Mask R-CNN é um destes modelos. Apresentado em 2017 pela Facebook AI Research (FAIR), baseia-se em modelos anteriores como o R-CNN, o Fast R-CNN e o Faster R-CNN. Como marco importante na história da visão computacional, o Mask R-CNN abriu caminho a modelos mais avançados, como o Ultralytics YOLO11.
Neste artigo, vamos explorar o que é o Mask R-CNN, como funciona, quais são as suas aplicações e que melhorias surgiram depois dele, conduzindo ao Ultralytics YOLO11.
Introdução ao Mask R-CNN#
O Mask R-CNN, sigla de rede neural convolucional baseada em regiões com máscaras, é um modelo de aprendizagem profunda concebido para tarefas de visão computacional, como a deteção de objetos e a segmentação de instâncias.
A segmentação de instâncias vai além da deteção tradicional de objetos: não só identifica objetos numa imagem, como também delineia cada um com precisão. Atribui uma etiqueta única a cada objeto detetado e capta a sua forma exata ao nível do píxel. Esta abordagem detalhada permite distinguir claramente objetos sobrepostos e lidar com precisão com formas complexas.
O Mask R-CNN baseia-se no Faster R-CNN, que deteta e etiqueta objetos, mas não define as respetivas formas exatas. O Mask R-CNN melhora este processo ao identificar os píxeis exatos que compõem cada objeto, permitindo uma análise de imagem muito mais detalhada e precisa.
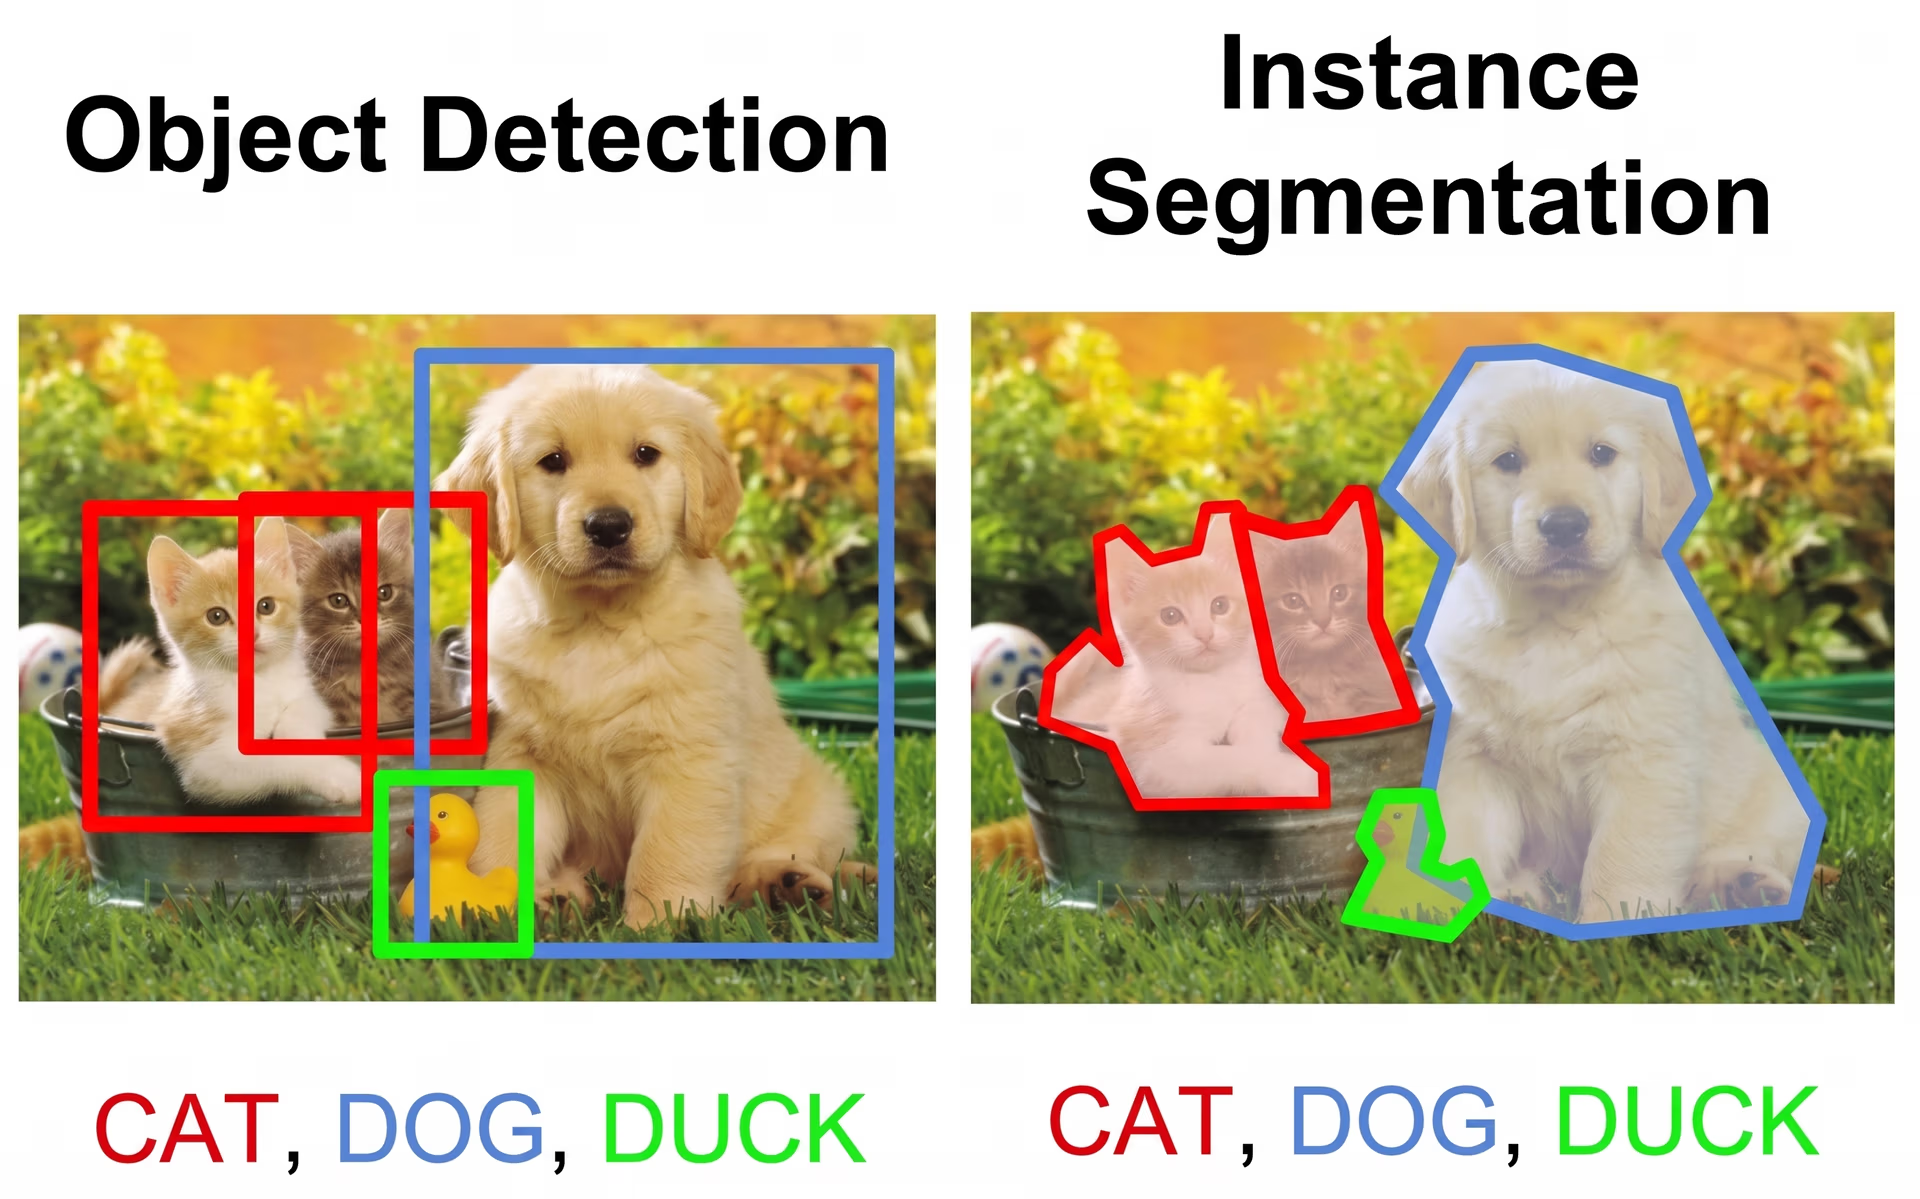
Fig. 1. Comparação entre a deteção de objetos e a segmentação de instâncias.
A arquitetura do Mask R-CNN e o seu funcionamento#
O Mask R-CNN segue uma abordagem passo a passo para detetar e segmentar objetos com precisão. Começa por extrair características importantes com uma rede neural profunda (um modelo com várias camadas que aprende a partir dos dados), identifica depois possíveis áreas com objetos através de uma rede de propostas de regiões (um componente que sugere regiões onde é provável haver objetos) e, por fim, aperfeiçoa essas áreas criando máscaras de segmentação detalhadas (contornos precisos dos objetos) que captam a forma exata de cada objeto.
A seguir, vamos percorrer cada etapa para compreender melhor como funciona o Mask R-CNN.
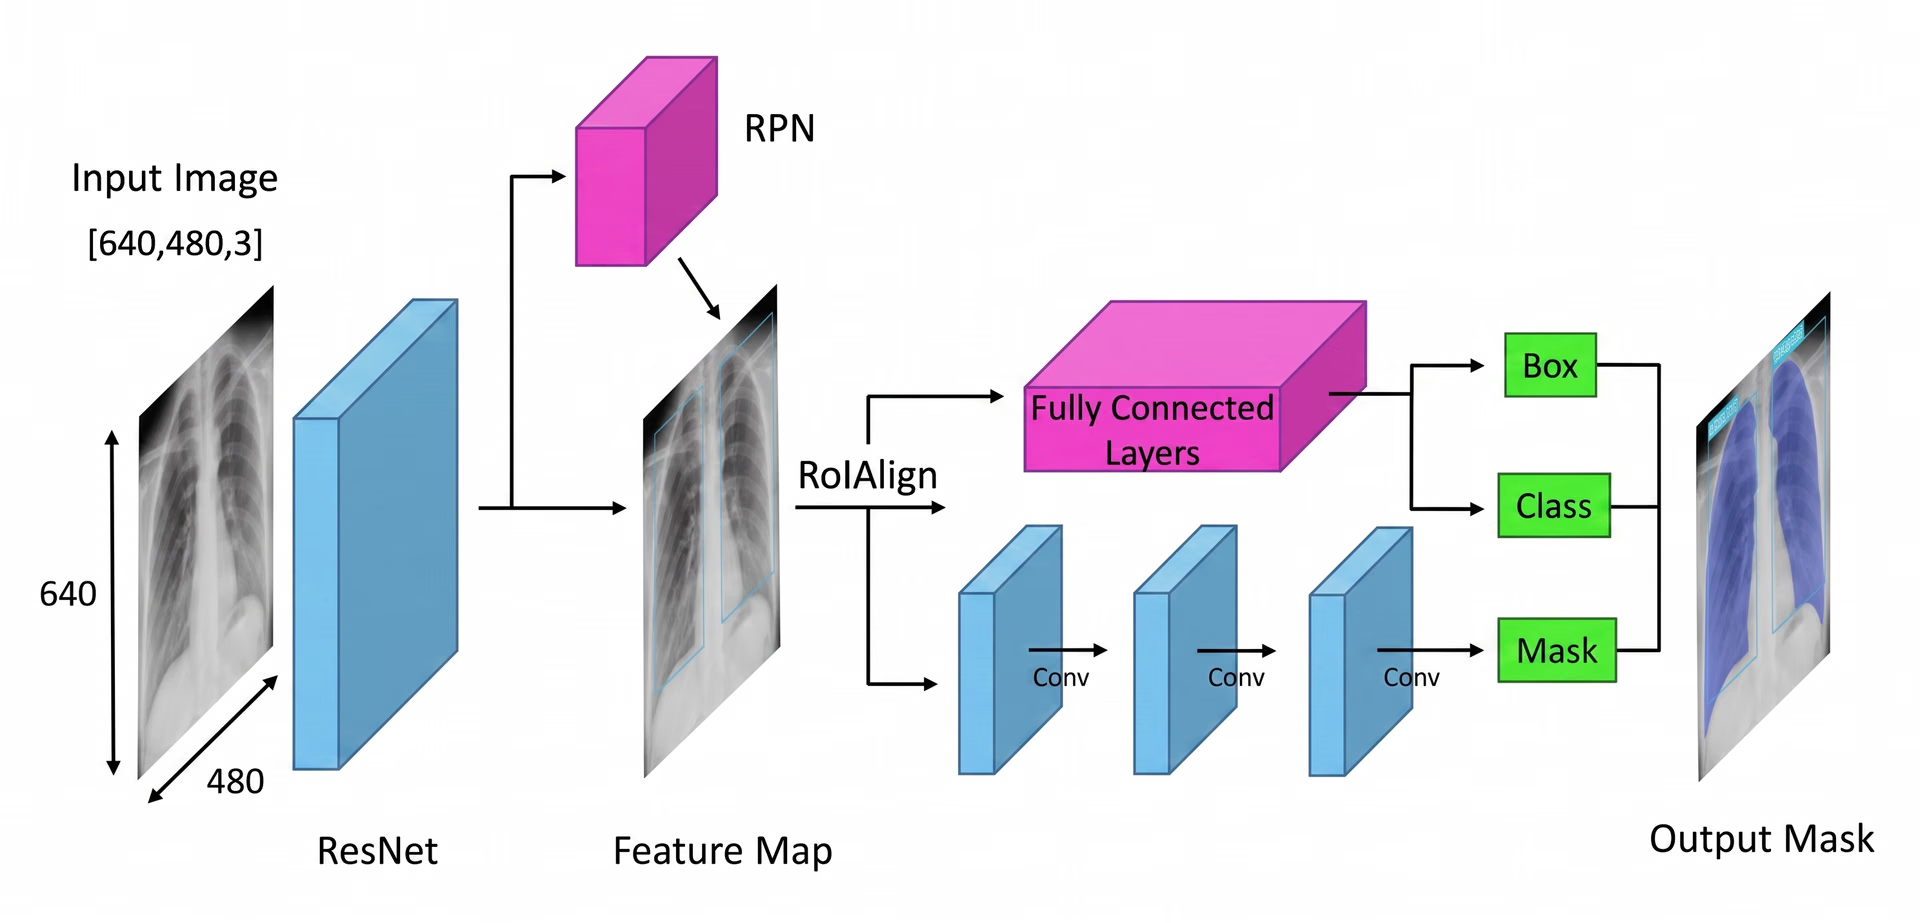
Fig. 2. Visão geral da arquitetura do Mask R-CNN (fonte: researchgate.net).
Começar pela extração de características#
A primeira etapa da arquitetura Mask R-CNN é dividir a imagem em suas partes principais para que o modelo entenda o que ela contém. Pense em como você olha para uma foto e percebe naturalmente detalhes como formas, cores e contornos. O modelo faz algo semelhante usando uma rede neural profunda chamada de “backbone” (geralmente ResNet-50 ou ResNet-101), que funciona como seus olhos para examinar a imagem e identificar os detalhes importantes.
Como os objetos nas imagens podem ser muito pequenos ou muito grandes, o Mask R-CNN usa uma Rede de Pirâmide de Características. É como ter lupas de diferentes aumentos, que permitem ao modelo enxergar tanto os detalhes finos quanto o panorama geral, garantindo que objetos de todos os tamanhos sejam detectados.
Depois de estas características serem extraídas, o modelo passa à localização dos possíveis objetos na imagem, preparando o terreno para análises posteriores.
Sugerir possíveis áreas com objetos na imagem#
Depois de a imagem ser processada para extrair as características importantes, a rede de propostas de regiões entra em ação. Esta parte do modelo analisa a imagem e sugere áreas que provavelmente contêm objetos.
Faz isso ao gerar várias localizações possíveis para os objetos, chamadas âncoras. A rede avalia depois estas âncoras e seleciona as mais promissoras para análise posterior. Desta forma, o modelo concentra-se apenas nas áreas com maior probabilidade de serem relevantes, em vez de verificar todos os pontos da imagem.
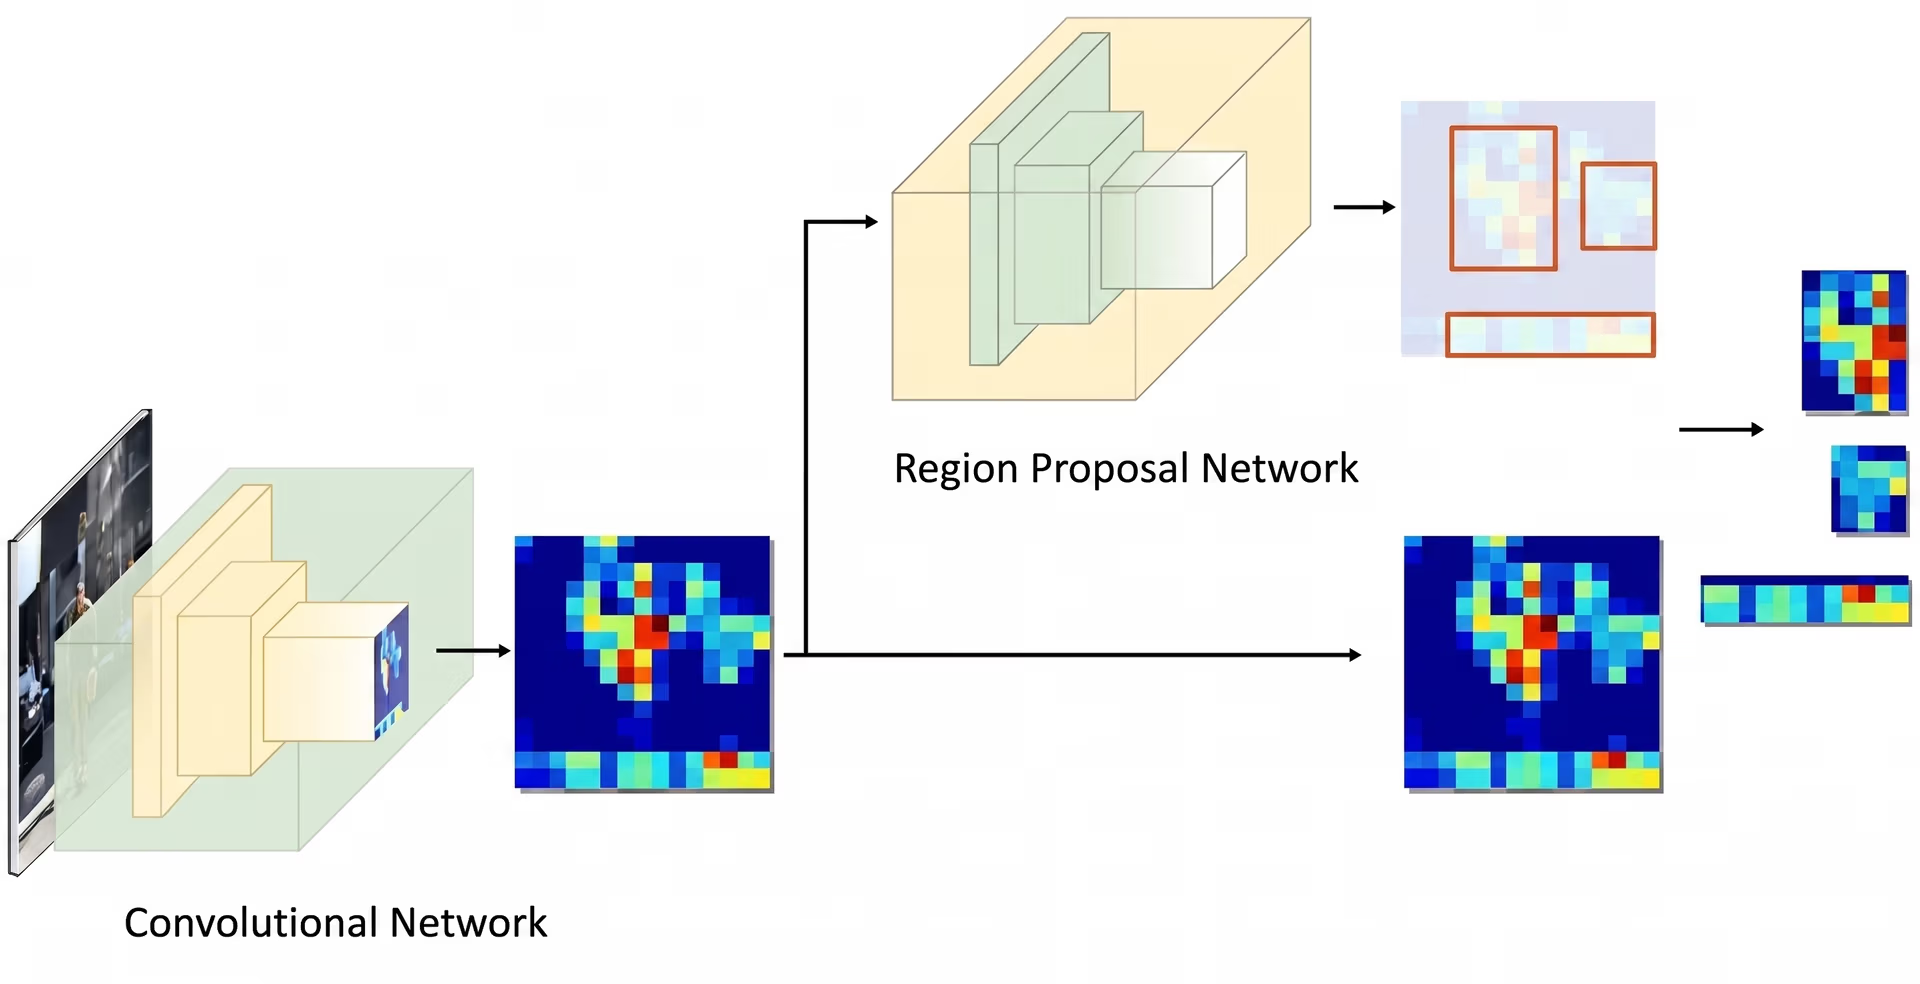
Fig. 3. Exemplo de uma rede de propostas de regiões.
Melhorar as características extraídas#
Depois de identificar as áreas importantes, a etapa seguinte consiste em aperfeiçoar os detalhes extraídos dessas regiões. Os modelos anteriores usavam um método chamado ROI Pooling (agrupamento da região de interesse) para obter características de cada área, mas esta técnica por vezes provocava pequenos desalinhamentos ao redimensionar as regiões, tornando-se menos eficaz — especialmente com objetos mais pequenos ou sobrepostos.
O Mask R-CNN aprimora esse processo com uma técnica chamada ROI Align (alinhamento da região de interesse). Em vez de arredondar as coordenadas, como faz o ROI Pooling, o ROI Align usa interpolação bilinear para estimar os valores dos pixels com mais precisão. A interpolação bilinear é um método que calcula um novo valor de pixel usando uma média ponderada dos valores dos quatro pixels vizinhos mais próximos, criando transições mais suaves. Isso mantém os recursos devidamente alinhados com a imagem original, resultando em detecção e segmentação de objetos mais precisas.
Por exemplo, num jogo de futebol, dois jogadores muito próximos podem ser confundidos um com o outro porque as respetivas caixas delimitadoras se sobrepõem. O ROI Align ajuda a separá-los ao manter distintas as formas dos jogadores.
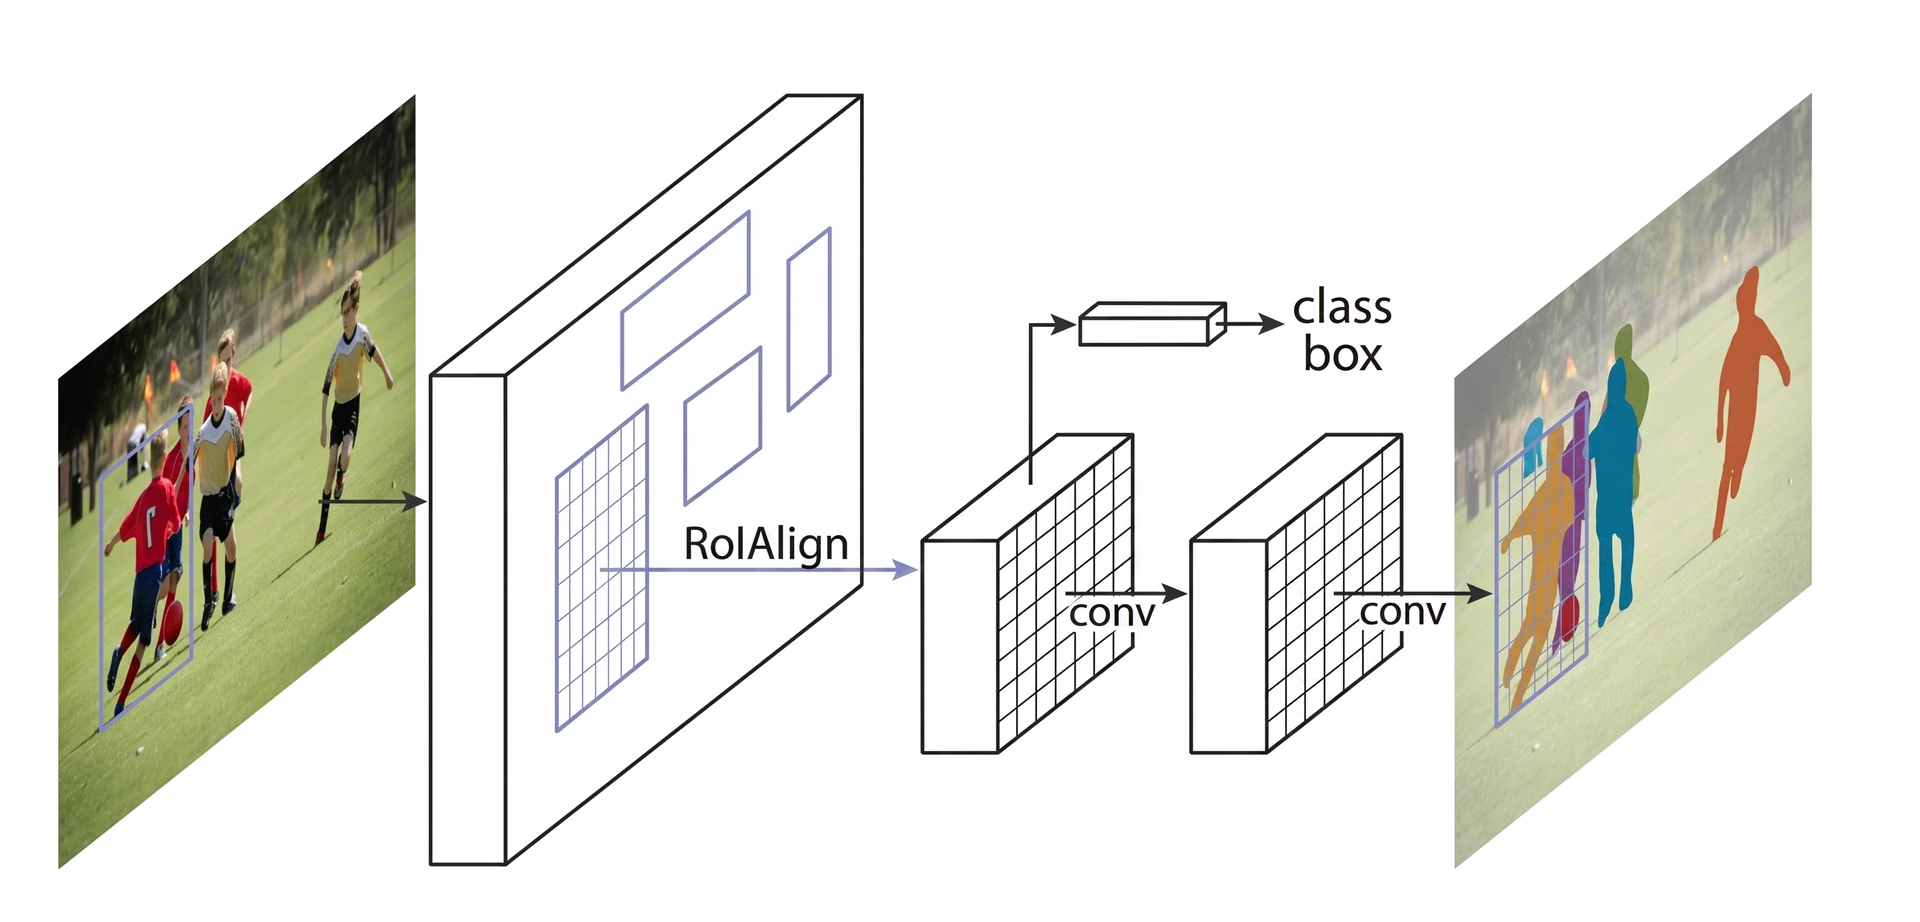
Fig. 4. O Mask R-CNN usa ROI Align.
Classificar objetos e prever as respetivas máscaras#
Depois de o ROI Align processar a imagem, o passo seguinte é classificar os objetos e aperfeiçoar as respetivas localizações. O modelo analisa cada região extraída e decide que objeto contém. Atribui uma pontuação de probabilidade às diferentes categorias e escolhe a melhor correspondência.
Ao mesmo tempo, ajusta as caixas delimitadoras para se adaptarem melhor aos objetos. As caixas iniciais podem não estar posicionadas de forma ideal, por isso este passo ajuda a melhorar a precisão, garantindo que cada caixa envolve o objeto detetado de forma ajustada.
Por fim, o Mask R-CNN dá um passo adicional: gera uma máscara de segmentação detalhada para cada objeto em paralelo.
Mask R-CNN e suas aplicações no mundo real#
Quando esse modelo foi lançado, gerou bastante entusiasmo na comunidade de IA e logo passou a ser usado em diversas aplicações. Sua capacidade de detectar e segmentar objetos com precisão em nível de pixel o tornou popular em vários setores.
Por exemplo, acompanhar animais em perigo de extinção na natureza é uma tarefa desafiante. Muitas espécies deslocam-se por florestas densas, o que dificulta o seu acompanhamento pelos conservacionistas. Os métodos tradicionais recorrem a armadilhas fotográficas, drones e imagens de satélite, mas analisar manualmente todos estes dados consome muito tempo. Identificações erradas e avistamentos não registados podem atrasar os esforços de conservação.
Ao reconhecer características únicas, como as riscas dos tigres, as manchas das girafas ou o formato das orelhas dos elefantes, o Mask R-CNN consegue detetar e segmentar animais em imagens e vídeos com maior precisão. Mesmo quando os animais estão parcialmente ocultos por árvores ou muito próximos uns dos outros, o modelo consegue separá-los e identificar cada um individualmente, tornando a monitorização da vida selvagem mais rápida e fiável.
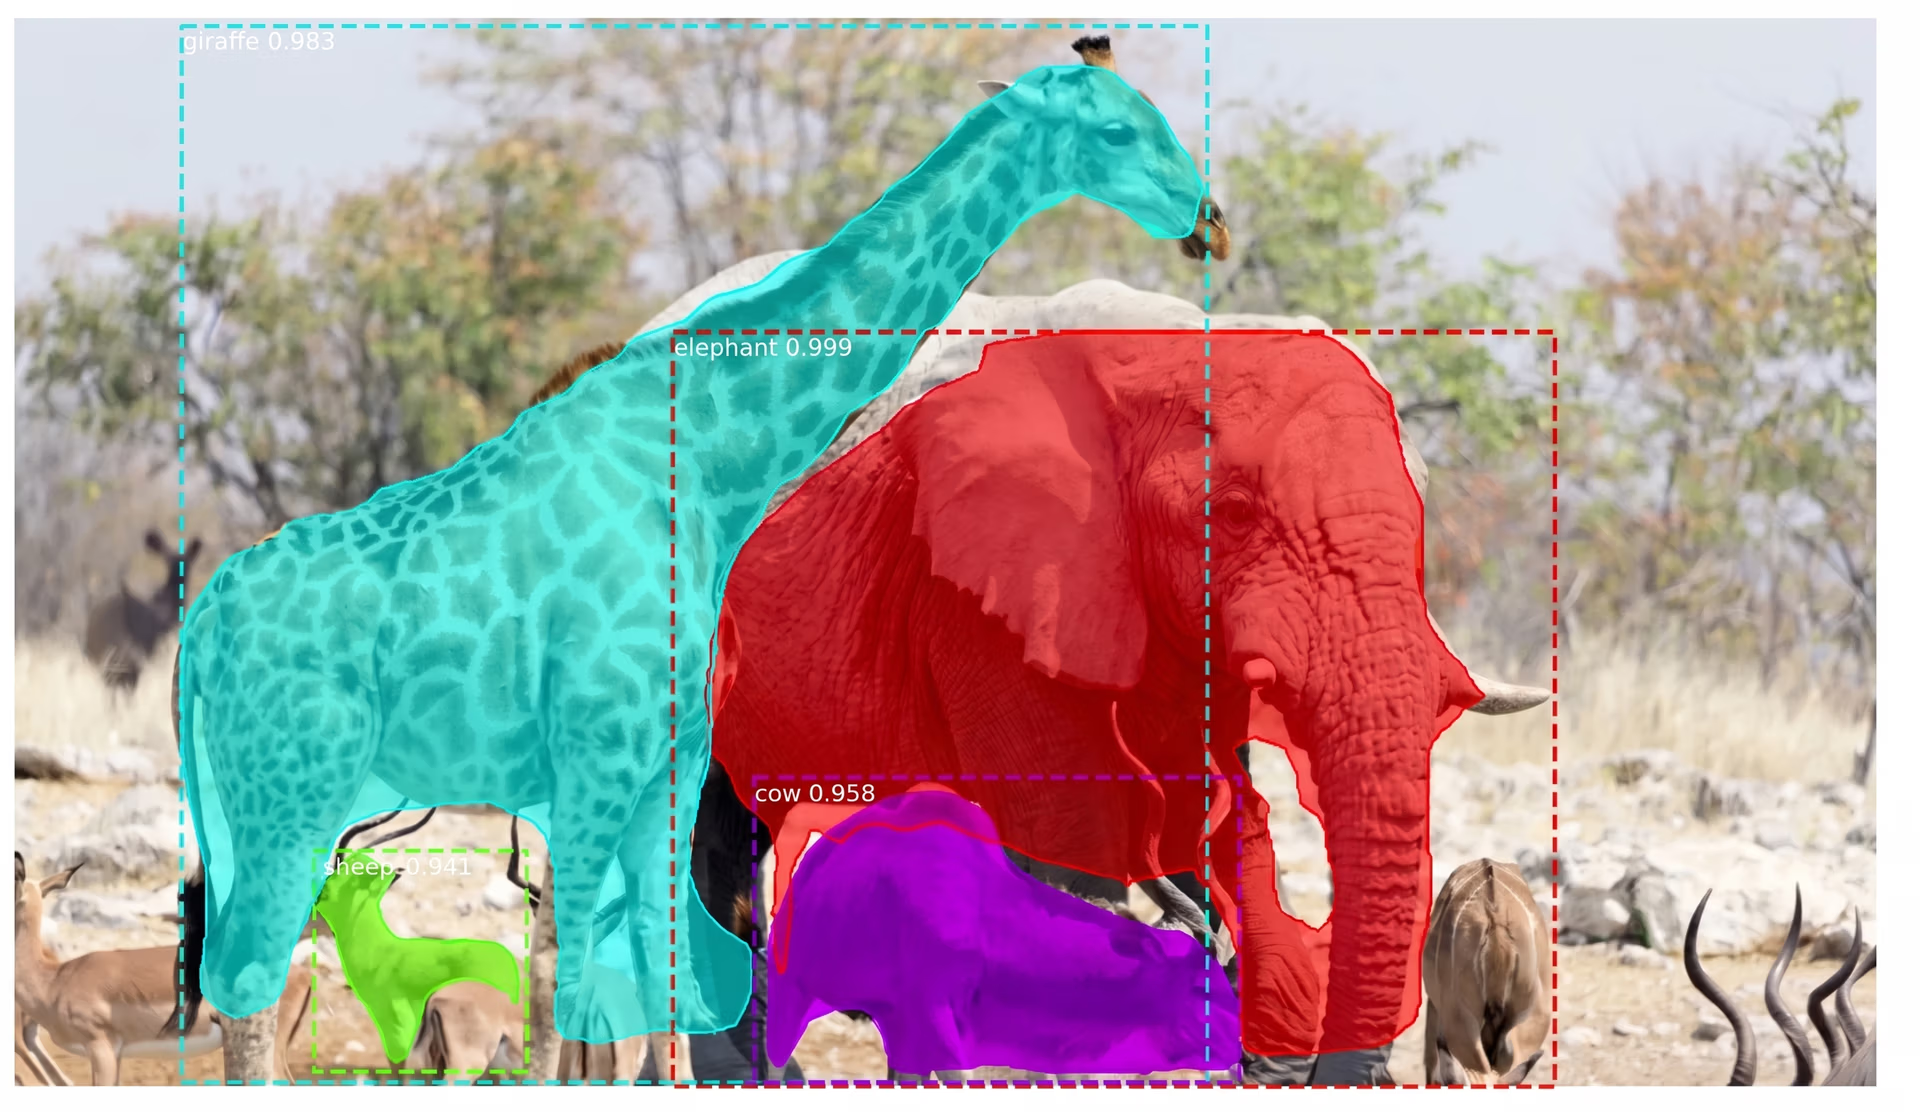
Fig. 5. Deteção e segmentação de animais com o Mask R-CNN.
Limitações do Mask R-CNN#
Apesar da sua importância histórica na deteção e segmentação de objetos, o Mask R-CNN também apresenta algumas desvantagens importantes. Eis alguns desafios associados ao Mask R-CNN:
- Alta demanda computacional: o modelo depende de GPUs potentes, o que pode tornar sua execução cara e lenta ao processar grandes volumes de dados.
- Velocidade de processamento mais lenta: o seu processo em várias etapas torna-o mais lento do que modelos mais rápidos e em tempo real, como o YOLO, o que pode não ser ideal para tarefas urgentes.
- Dependência de dados de alta qualidade: o modelo tem melhor desempenho com imagens nítidas e bem anotadas. Imagens desfocadas ou com pouca iluminação podem reduzir significativamente a sua precisão.
- Implementação complexa: a arquitetura em várias etapas pode ser difícil de configurar e otimizar, sobretudo ao trabalhar com grandes conjuntos de dados ou recursos limitados.
Do Mask R-CNN ao Ultralytics YOLO11#
O Mask R-CNN era excelente para tarefas de segmentação, mas muitos setores procuravam adotar a visão computacional, dando prioridade à velocidade e ao desempenho em tempo real. Esta necessidade levou os investigadores a desenvolver modelos de uma única etapa, que detetam objetos numa única passagem e melhoram significativamente a eficiência.
Ao contrário do processo de várias etapas do Mask R-CNN, os modelos de visão computacional de estágio único, como o YOLO (You Only Look Once), se concentram em tarefas de visão computacional em tempo real. Em vez de lidar com a detecção e a segmentação separadamente, os modelos YOLO podem detectar e segmentar objetos em uma única passagem. Isso os torna ideais para aplicações como direção autônoma, saúde, manufatura e robótica, nas quais é essencial tomar decisões rapidamente.
Em particular, o Ultralytics YOLO11 (que foi sucedido pelo Ultralytics YOLO26) vai além ao combinar velocidade e precisão. Ele usa 22% menos parâmetros que o YOLOv8m, mas ainda alcança uma precisão média média (mAP) maior no conjunto de dados COCO, o que significa que detecta objetos com mais precisão. Sua velocidade de processamento aprimorada o torna uma boa opção para aplicações em tempo real nas quais cada milissegundo importa.
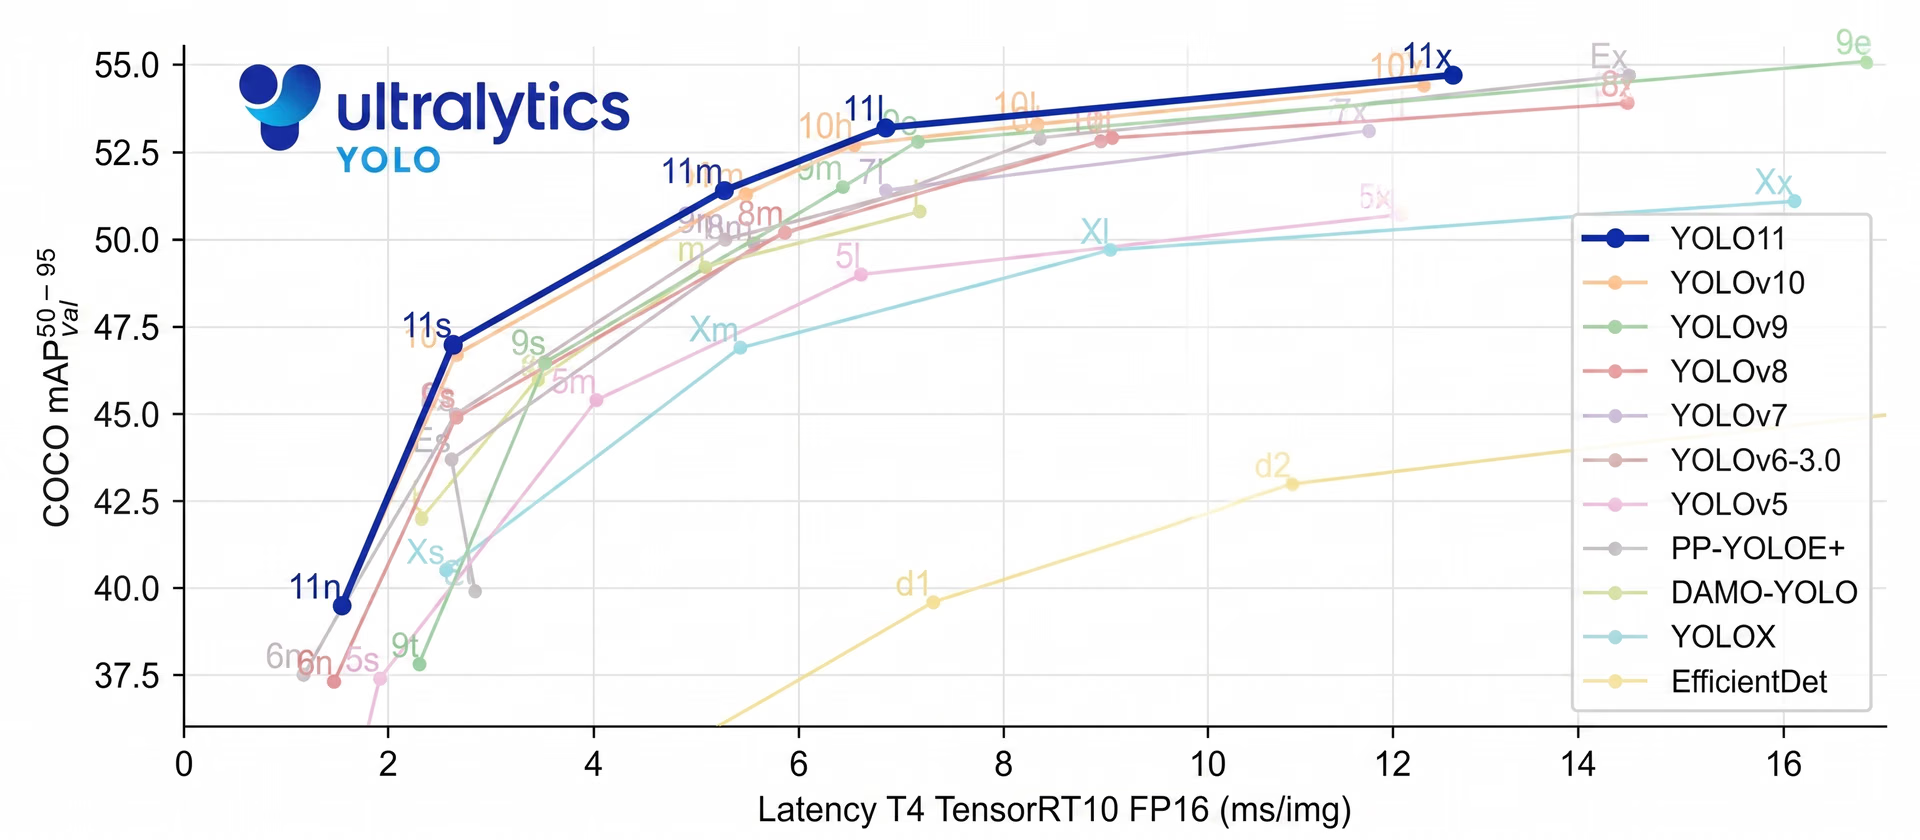
Fig. 6. Desempenho do YOLO11 em comparação com outros modelos.
Principais conclusões#
Ao olhar para a história da visão computacional, o Mask R-CNN é reconhecido como um grande avanço na deteção e segmentação de objetos. Graças ao seu processo detalhado em várias etapas, oferece resultados muito precisos, mesmo em cenários complexos.
No entanto, esse mesmo processo o torna mais lento que modelos em tempo real, como o YOLO. À medida que cresce a necessidade de velocidade e eficiência, muitas aplicações passam a usar modelos de estágio único, como o Ultralytics YOLO11, que oferecem detecção de objetos rápida e precisa. Embora o Mask R-CNN continue sendo importante para entender a evolução da visão computacional, a migração para modelos em tempo real reflete a demanda crescente por soluções mais rápidas e eficientes.
Junta-te à nossa comunidade, que não para de crescer! Explora o nosso repositório do GitHub para saberes mais sobre IA. Queres começar os teus próprios projetos de visão computacional? Consulta as nossas opções de licenciamento. Descobre a IA na agricultura e a IA de visão nos cuidados de saúde nas nossas páginas de soluções!
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









