Florence-2: новейшая визуально-языковая модель Microsoft
Познакомься с Florence-2 — визуально-языковой моделью Microsoft для обнаружения объектов, сегментации, создания подписей и визуальной привязки, которая показывает высокие результаты в режиме zero-shot.
 Abirami Vina7 мин. чтения
В июне 2024 года Microsoft представила Florence-2 — мультимодальную модель, объединяющую зрение и язык (VLM), предназначенную для решения широкого спектра задач, включая обнаружение объектов, сегментацию, создание подписей к изображениям и визуальную привязку. Florence-2 задаёт новый уровень результатов в режиме zero-shot: модель может выполнять задачи без предварительного специального обучения, а её размер меньше, чем у других передовых моделей, объединяющих зрение и язык.
Florence-2 — это не просто ещё одна модель. Её универсальность и улучшенная производительность могут существенно повлиять на разные отрасли, повысив точность и уменьшив потребность в масштабном обучении. В этой статье мы рассмотрим ключевые особенности Florence-2, сравним её производительность с другими VLM и обсудим потенциальные области применения.
Что такое Florence-2?#
Florence-2 умеет решать множество задач в рамках единой системы. Частично такие возможности модели объясняются большим обучающим набором данных FLD-5B. Он содержит 5,4 миллиарда аннотаций для 126 миллионов изображений. Этот обширный набор данных создали специально, чтобы Florence-2 могла с высокой точностью и эффективностью решать широкий спектр задач компьютерного зрения.
Рассмотрим подробнее задачи, которые поддерживает Florence-2:
- Обнаружение объектов: модель может с высокой точностью находить объекты на изображениях и определять их местоположение.
- Сегментация: эта задача заключается в разделении изображения на смысловые области для упрощения анализа и интерпретации.
- Создание подписей к изображениям: Florence-2 может генерировать описательные подписи к изображениям, добавляя контекст и детали.
- Визуальная привязка: модель может связывать отдельные фразы или слова в подписи с соответствующими областями изображения.
- Работа без предварительного обучения: модель может выполнять задачи без специального обучения.
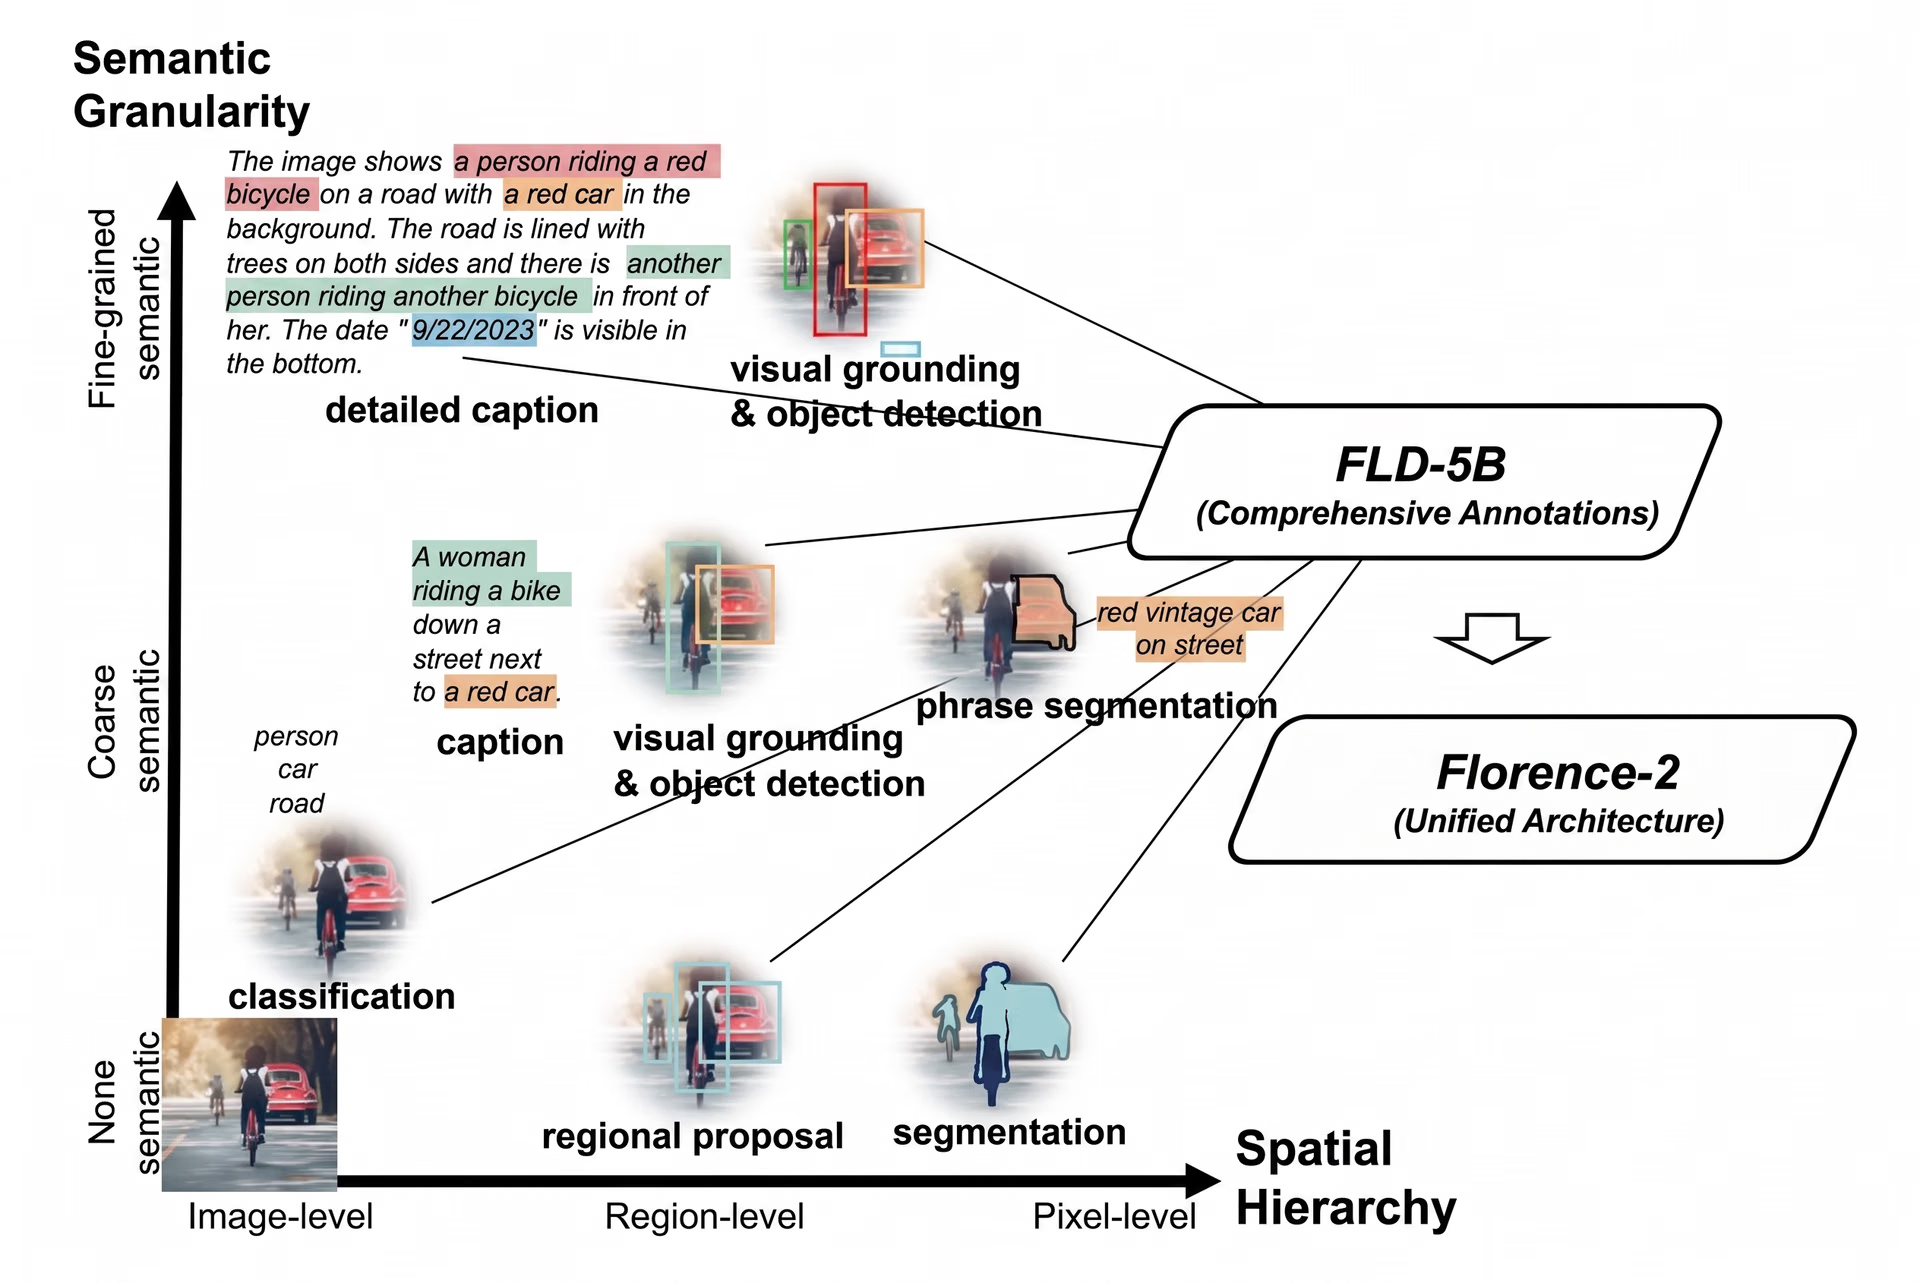
Рис. 1. Как обучали Florence-2.
Модель поддерживает задачи на основе текста и области изображения. Для задач, связанных с конкретными областями изображения, в словарь модели добавляются специальные токены местоположения. С их помощью модель понимает разные формы: прямоугольники вокруг объектов (представление рамками), четырёхугольники (представление четырёхугольными рамками) и многоугольники (представление полигонами). Модель обучается с помощью стандартной функции потерь кросс-энтропии: она сравнивает предсказания с правильными ответами и соответствующим образом корректирует внутренние параметры.
Создание набора данных FLD-5B#
Набор данных FLD-5B содержит разные типы аннотаций: текстовые описания, пары областей и текста, а также комбинации текста, фраз и областей. Его создали в два этапа, включавших сбор данных и аннотирование. Изображения взяли из популярных наборов данных, например ImageNet-22k, Objects365, Open Images, Conceptual Captions и LAION. Аннотации в FLD-5B в основном синтетические: их создавали автоматически, а не размечали вручную.
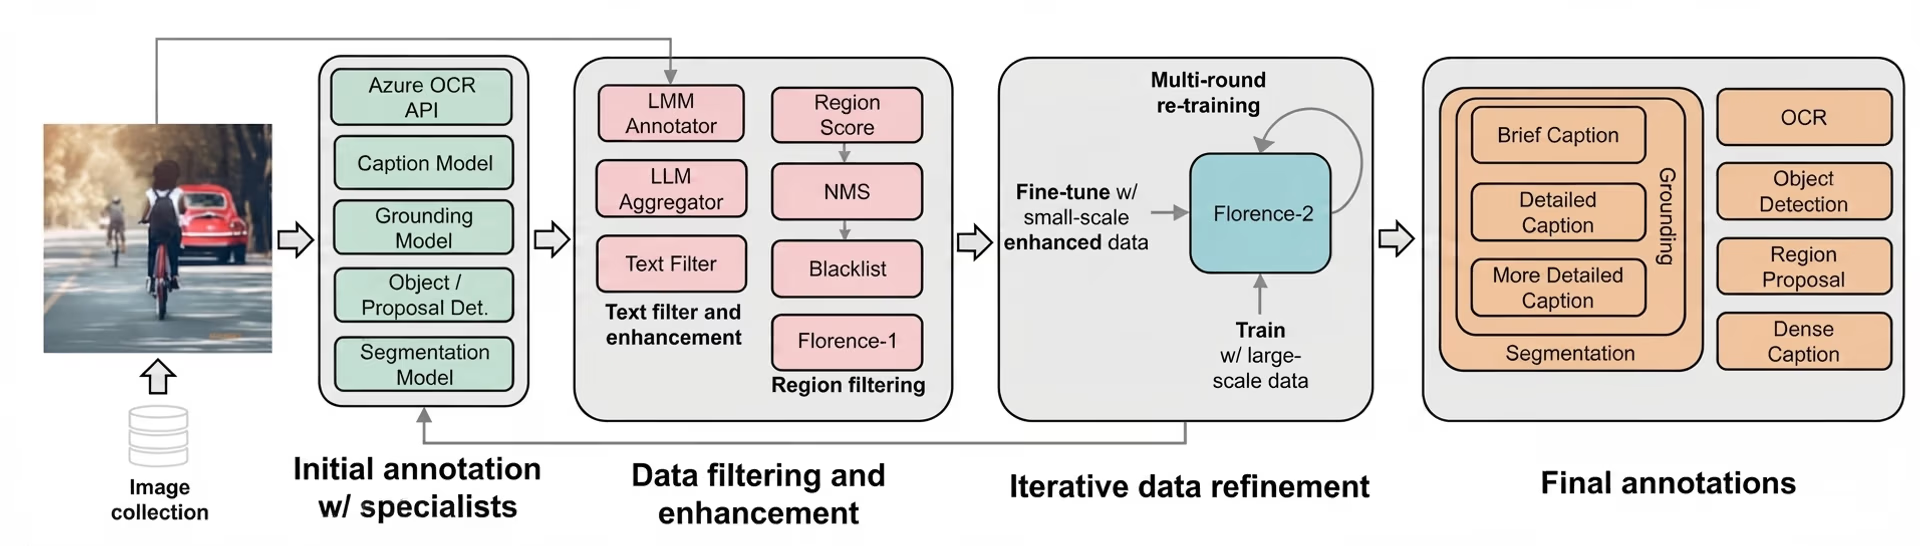
Рис. 2. Создание набора данных FLD-5B.
Сначала эти аннотации создавали специализированные модели, обученные решать конкретные задачи, например обнаружение объектов или сегментацию. Затем применялись фильтрация и доработка, чтобы аннотации были подробными и точными. После удаления шумовых данных набор проходил итеративное уточнение: результаты Florence-2 использовались для непрерывного обновления и улучшения аннотаций.
Архитектура модели Florence-2#
В архитектуре Florence-2 используется последовательный подход к обучению «последовательность в последовательность». Это означает, что модель пошагово обрабатывает входную последовательность (например, изображение с текстовым запросом) и создаёт выходную последовательность (например, описание или метку). В рамках такого подхода каждая задача рассматривается как задача перевода: модель получает изображение и запрос для конкретной задачи, а затем генерирует соответствующий результат.
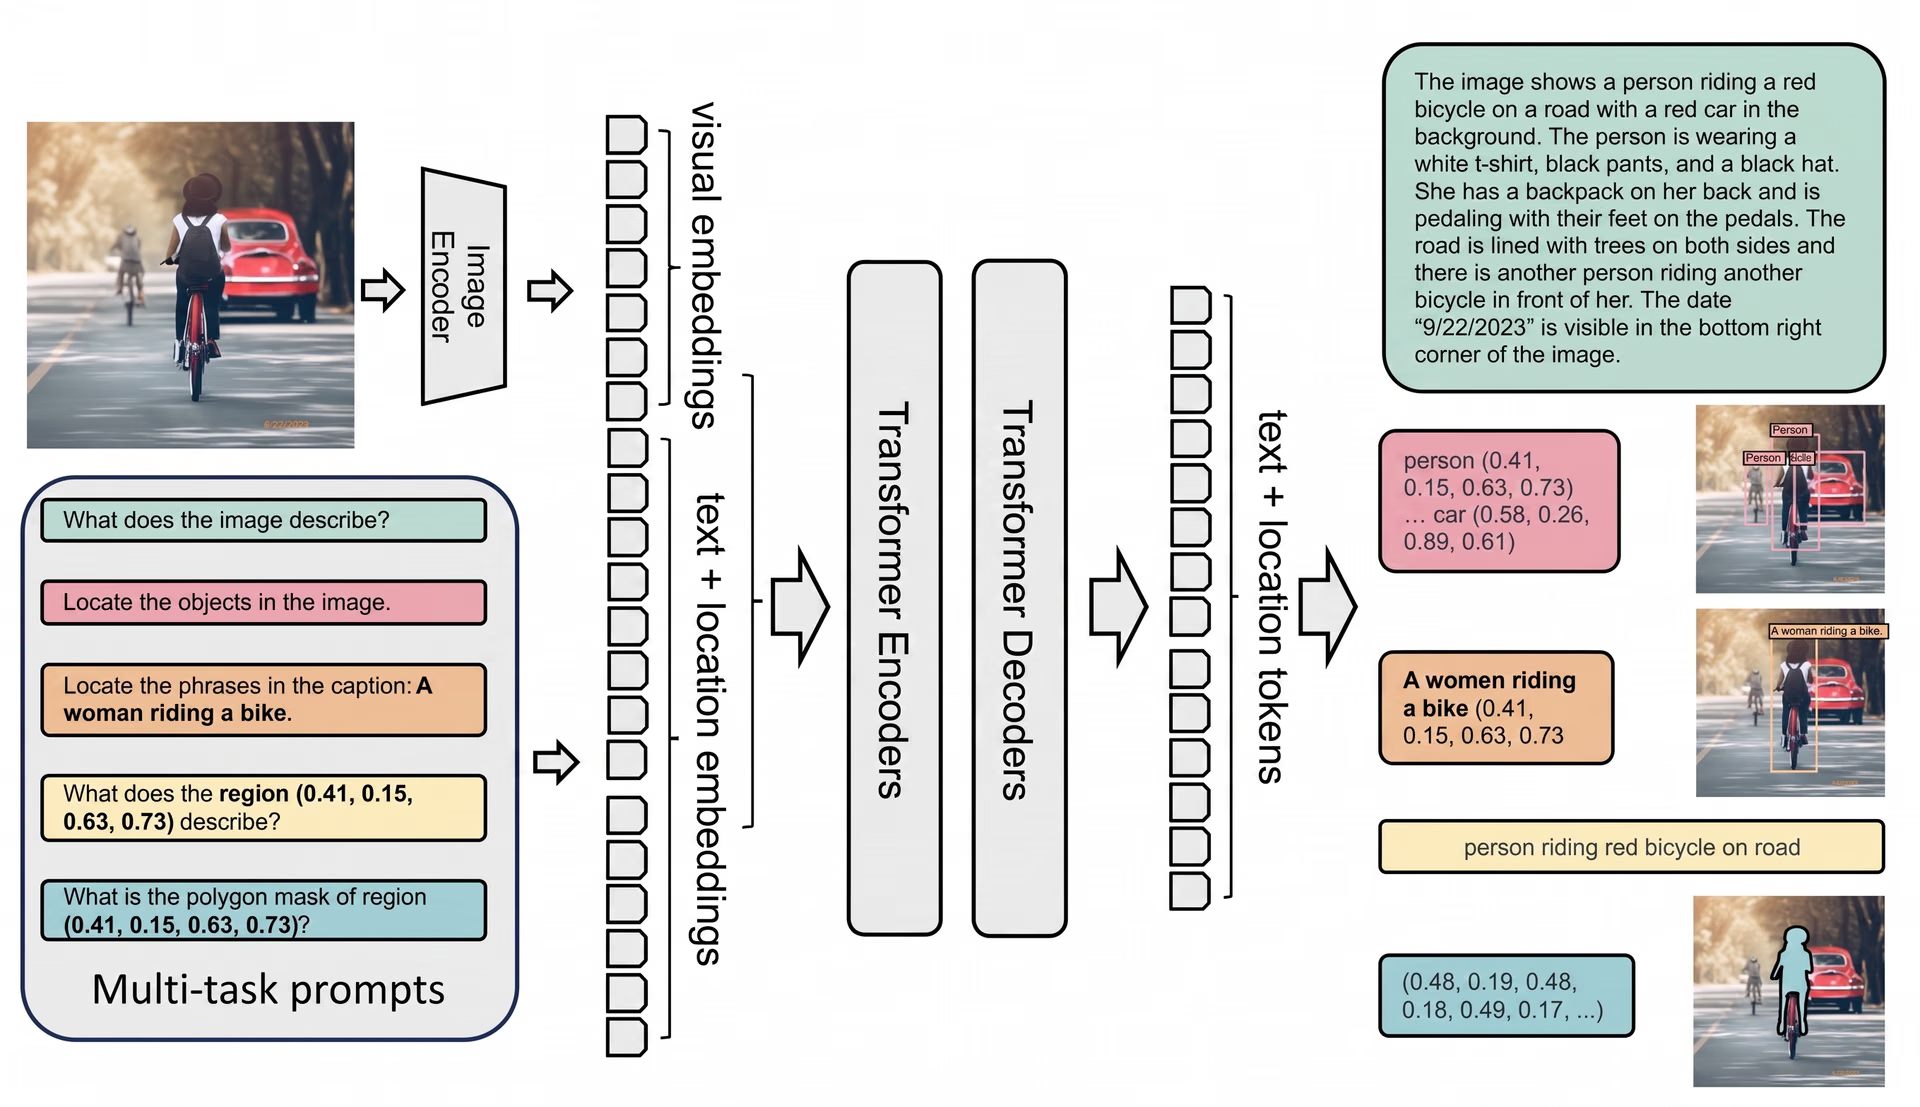
Рис. 3. Архитектура модели Florence-2, объединяющей зрение и язык.
В основе архитектуры модели лежит мультимодальный энкодер-декодер на базе Transformer, объединяющий энкодер изображений и мультимодальный энкодер-декодер. Энкодер изображений под названием DaViT (Dual Attention Vision Transformer) обрабатывает входные изображения, преобразуя их в визуальные эмбеддинги токенов — компактные представления изображения, содержащие как пространственную информацию (где расположены объекты), так и семантическую (что это за объекты). Затем эти визуальные токены объединяются с текстовыми эмбеддингами (представлениями текста), что позволяет модели соединять текстовые и визуальные данные.
Сравнение Florence-2 с другими VLM#
Florence-2 выделяется среди других моделей, объединяющих зрение и язык, благодаря высоким возможностям в режиме zero-shot. В отличие от таких моделей, как PaliGemma, которым требуется масштабное дообучение для адаптации к разным задачам, Florence-2 хорошо работает сразу после запуска. Кроме того, Florence-2 может конкурировать с более крупными моделями, такими как GPT-4V и Flamingo, у которых часто гораздо больше параметров, но результаты не всегда лучше, чем у Florence-2. Например, Florence-2 показывает лучшие результаты в режиме zero-shot, чем Kosmos-2, несмотря на то что у Kosmos-2 более чем вдвое больше параметров.
В тестах Florence-2 показала высокую производительность в таких задачах, как создание подписей к изображениям COCO и понимание выражений, указывающих на объекты. На наборе данных COCO она превзошла такие модели, как PolyFormer и UNINEXT, в задачах обнаружения объектов и сегментации. Это конкурентоспособный вариант для практических приложений, где важны и производительность, и эффективное использование ресурсов. На Ultralytics Platform можно автоматически аннотировать наборы данных для обнаружения с помощью Florence-2 и сравнить её с другими моделями, объединяющими зрение и язык, в рейтинге VLM.
Применение Florence-2#
Florence-2 можно использовать во многих отраслях, например в индустрии развлечений, для обеспечения доступности, в образовании и так далее. Давай рассмотрим несколько примеров, чтобы лучше разобраться.
Применение технологии создания подписей к изображениям#
Когда ты выбираешь, что посмотреть на стриминговой платформе, тебе может помочь краткое описание фильма. А что, если бы платформа также могла подробно описать постер фильма? Florence-2 умеет это благодаря созданию подписей к изображениям — генерации описательного текста для изображений. Florence-2 может подробно описывать постеры фильмов, делая стриминговые платформы доступнее для пользователей с нарушениями зрения. Анализируя визуальные элементы постера — например, персонажей, пейзажи и текст, — Florence-2 создаёт подробные описания, передающие содержание и настроение постера. На изображении ниже показан уровень детализации, который Florence-2 может обеспечить в описании.
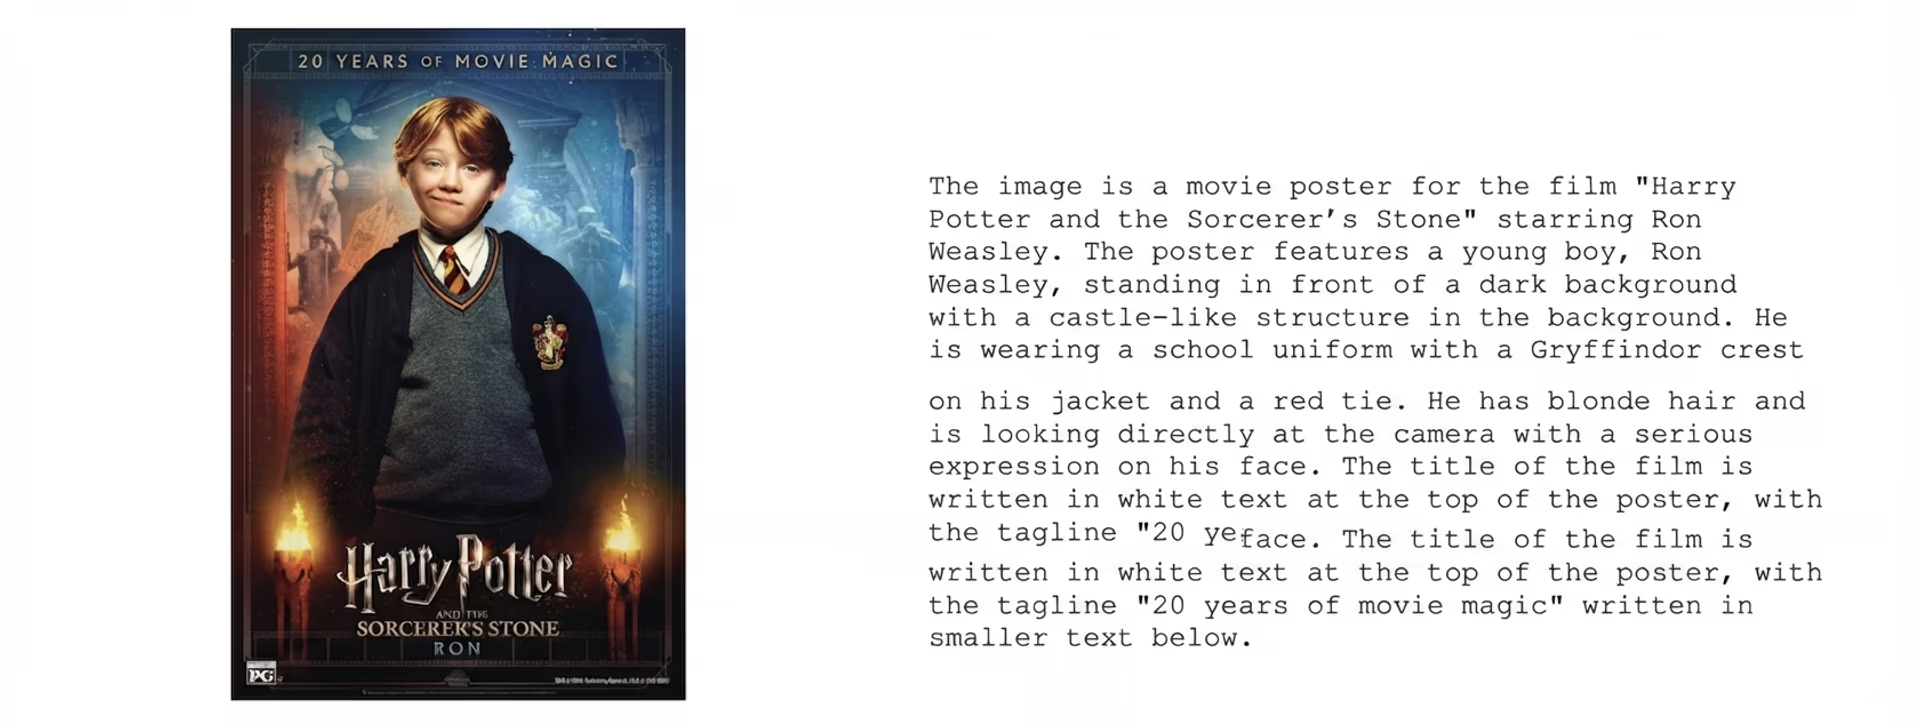
Рис. 4. Пример подписи к изображению, созданной Florence-2.
Вот ещё несколько примеров того, где могут пригодиться подписи к изображениям:
- Электронная коммерция: создание подписей к изображениям позволяет подробно описывать фотографии товаров и помогает покупателям лучше понять их особенности и характеристики.
- Путешествия и туризм: технология может создавать подробные описания достопримечательностей и туристических объектов для путеводителей и приложений.
- Образование: подписи к изображениям помогают снабжать учебные изображения и схемы метками и описаниями, облегчая преподавание и обучение.
- Недвижимость: технология может подробно описывать изображения объектов недвижимости, выделяя особенности и удобства для потенциальных покупателей.
Визуальная привязка при готовке#
Florence-2 можно также использовать, чтобы обогатить кулинарный опыт. Например, онлайн-поваренная книга может использовать Florence-2 для визуальной привязки и маркировки частей сложного изображения рецепта. Визуальная привязка связывает определённые части изображения с соответствующим описательным текстом. Каждый ингредиент и этап можно точно обозначить и описать, чтобы домашним кулинарам было проще следовать рецепту и понимать роль каждого компонента в блюде.
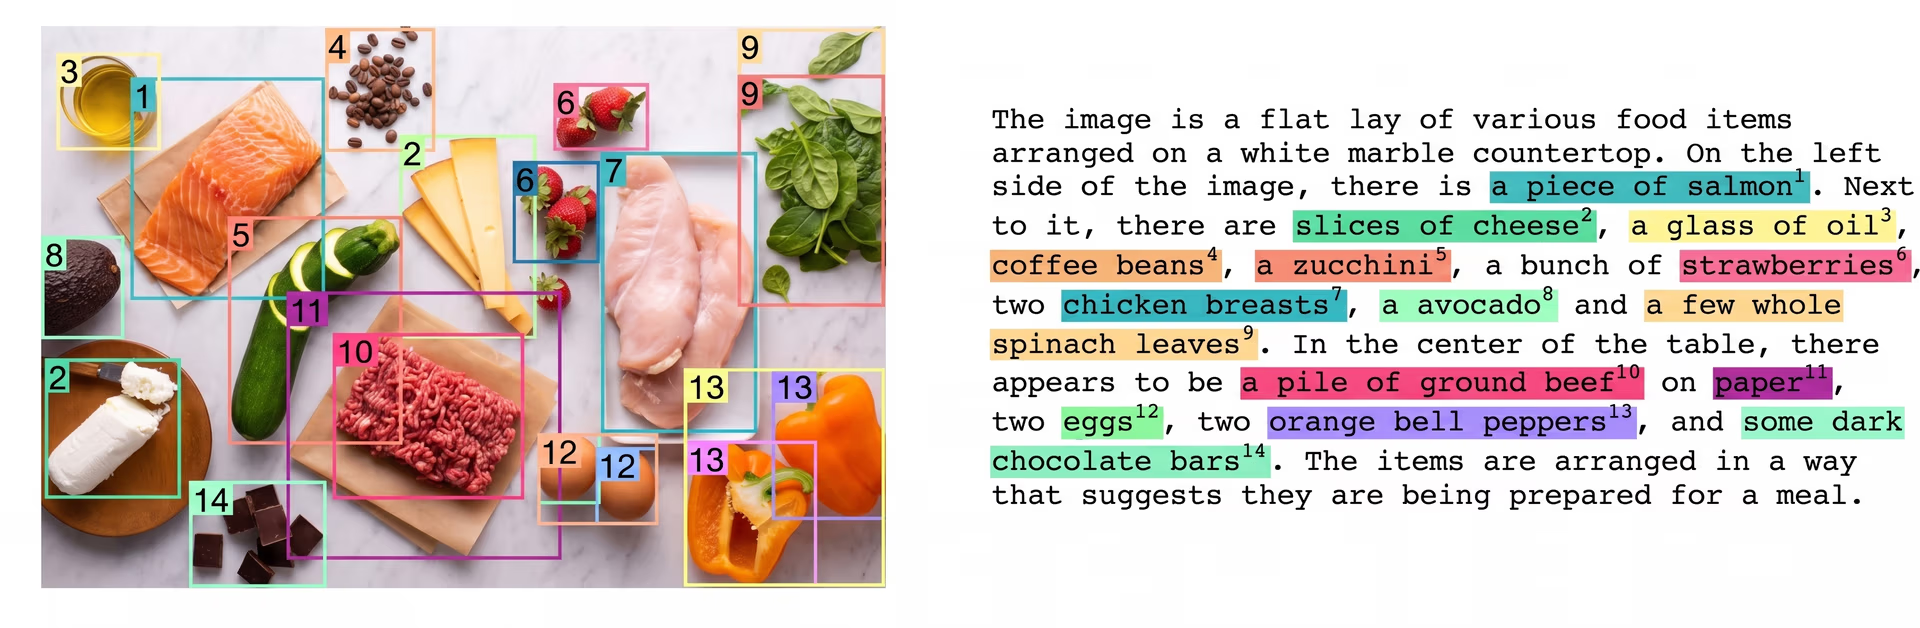
Рис. 5. Пример визуальной привязки с помощью Florence-2.
OCR финансовых документов с обработкой отдельных областей#
OCR с обработкой отдельных областей, при которой текст извлекается из конкретных частей документа, может пригодиться в таких областях, как бухгалтерский учёт. Выделенные области финансовых документов можно анализировать, чтобы автоматически извлекать важную информацию, например сведения о транзакциях, номера счетов и сроки оплаты. Сокращая объём ручного ввода данных, этот подход уменьшает количество ошибок и ускоряет обработку. Финансовые учреждения могут использовать его для оптимизации таких задач, как обработка счетов, сверка квитанций и обработка чеков. Это ускоряет транзакции и повышает качество обслуживания клиентов.
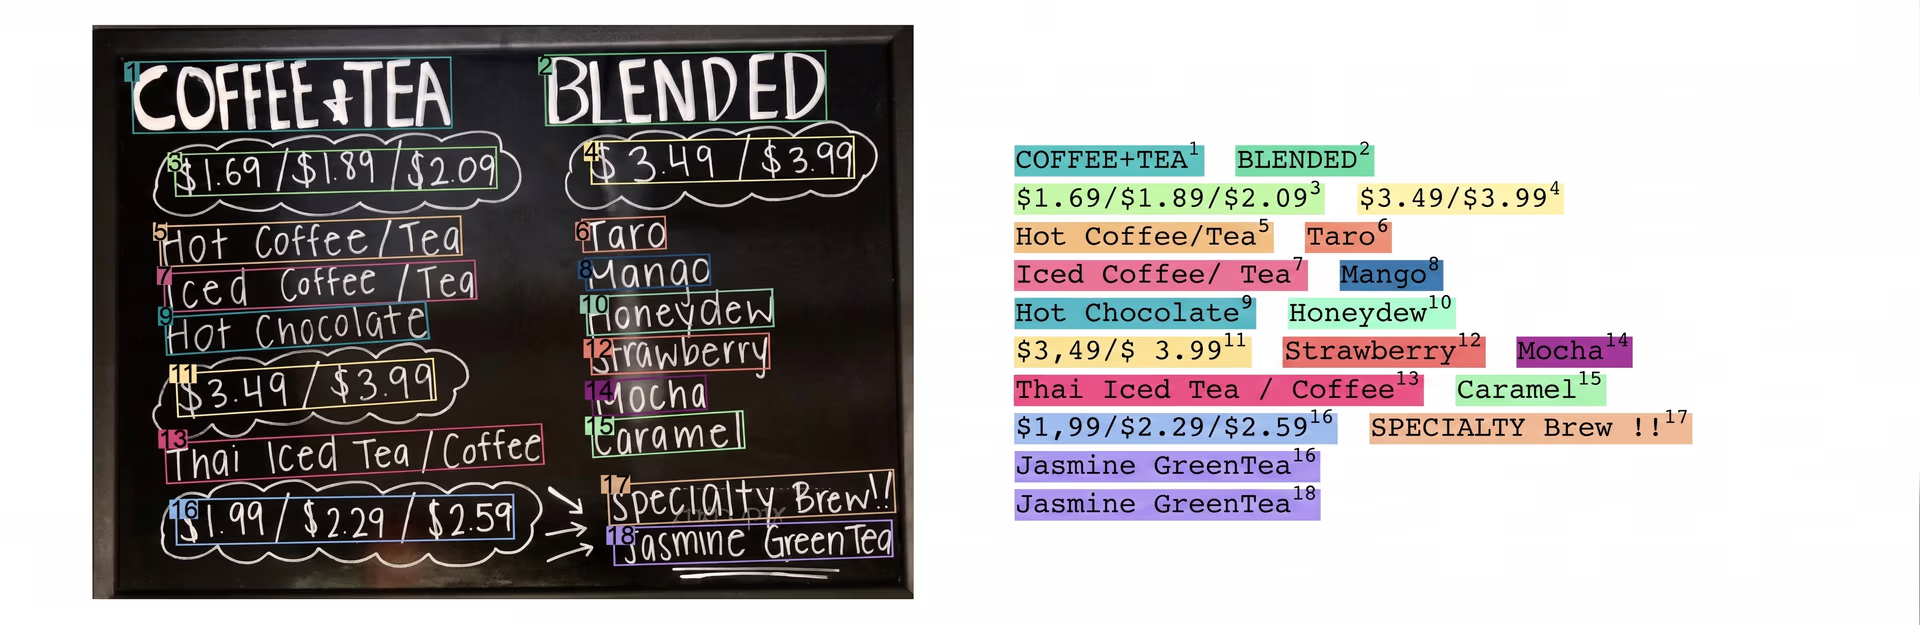
Рис. 6. Пример извлечения текста из области с помощью OCR и Florence-2.
Сегментация областей в промышленности#
Сегментация областей — разделение изображения на смысловые части для целевого анализа и подробного изучения — может поддерживать промышленные приложения, повышая точность и эффективность различных процессов. Эта технология позволяет подробно изучать и анализировать компоненты и изделия, сосредоточившись на определённых областях изображения. При контроле качества она помогает выявлять дефекты и несоответствия материалов, например трещины или смещения, гарантируя, что на рынок попадут только изделия высокого качества.
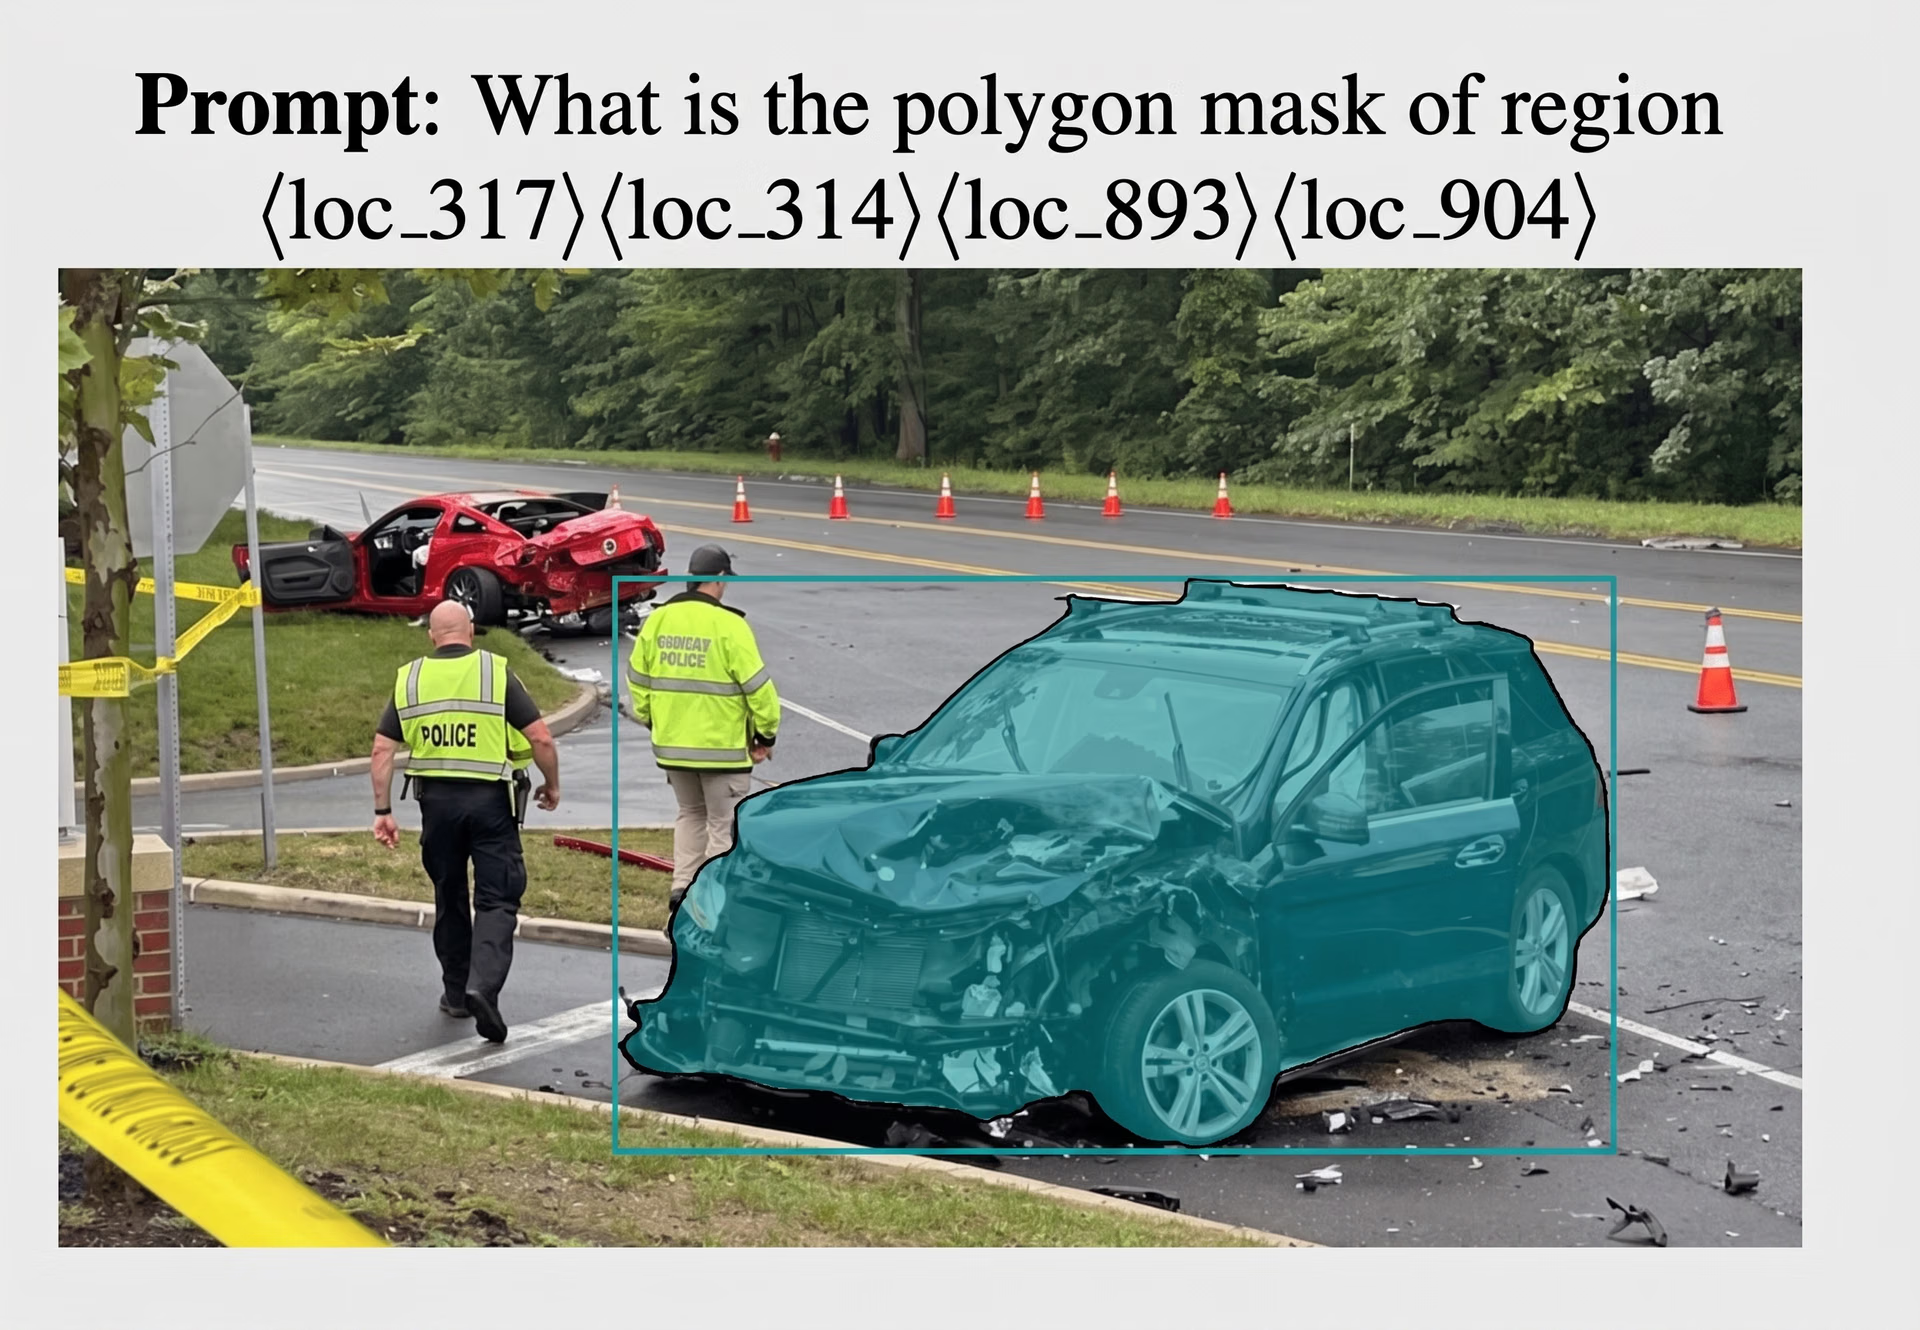
Рис. 7. Пример сегментации областей с помощью Florence-2.
Это также улучшает работу автоматизированных сборочных линий: система направляет роботизированные манипуляторы к нужным деталям и оптимизирует размещение и сборку компонентов. Аналогичным образом при управлении запасами технология помогает отслеживать состояние и местоположение товаров, повышая эффективность логистики и сокращая простои. В целом сегментация областей повышает точность и производительность, сокращая расходы и улучшая качество продукции в промышленности.
Главные выводы#
Мы начинаем замечать тенденцию: модели ИИ становятся компактнее, сохраняя при этом высокую производительность. Florence-2 — важный шаг вперёд для моделей, объединяющих зрение и язык. Она решает различные задачи, такие как обнаружение объектов, сегментация, создание подписей к изображениям и визуальная привязка, демонстрируя впечатляющие результаты в режиме zero-shot. Несмотря на компактный размер, Florence-2 эффективна и многофункциональна, поэтому её можно применять в разных отраслях. Такие модели, как Florence-2, открывают новые возможности и расширяют потенциал инноваций в области ИИ.
Узнай больше об ИИ: загляни в наш репозиторий GitHub и присоединяйся к нашему сообществу. На страницах наших решений можно узнать о применении ИИ в производстве и сельском хозяйстве.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









