Как обучить Ultralytics YOLO26 на собственных данных для сегментации экземпляров
Узнай, как обучить Ultralytics YOLO26 на собственных данных для сегментации экземпляров, при которой модель идентифицирует и разделяет каждый отдельный объект с помощью масок на уровне пикселей.
Благодаря последним достижениям в технологиях многие интеллектуальные системы, играющие незаметную, но важную роль в нашей жизни, работают на основе ИИ. Например, когда автомобиль проезжает на красный свет и камера автоматически фиксирует нарушение или когда автоматизированная система контроля качества обнаруживает производственный дефект на конвейере, за кулисами работает ИИ.
В частности, направление ИИ, известное как компьютерное зрение, позволяет машинам интерпретировать и понимать изображения и видео. Компьютерное зрение помогает системам распознавать объекты, отслеживать движение и анализировать визуальные детали в реальном времени, что делает его незаменимым для таких задач, как мониторинг дорожного движения, промышленный контроль и робототехника.
Эти возможности становятся реальностью благодаря моделям компьютерного зрения, таким как Ultralytics YOLO26, которая поддерживает различные задачи компьютерного зрения, включая обнаружение объектов и сегментацию экземпляров. Если обнаружение объектов определяет объекты с помощью простых ограничивающих рамок, то сегментация экземпляров идет дальше и обводит каждый объект на уровне пикселей, обеспечивая более точные и надежные результаты в реальных сценариях.
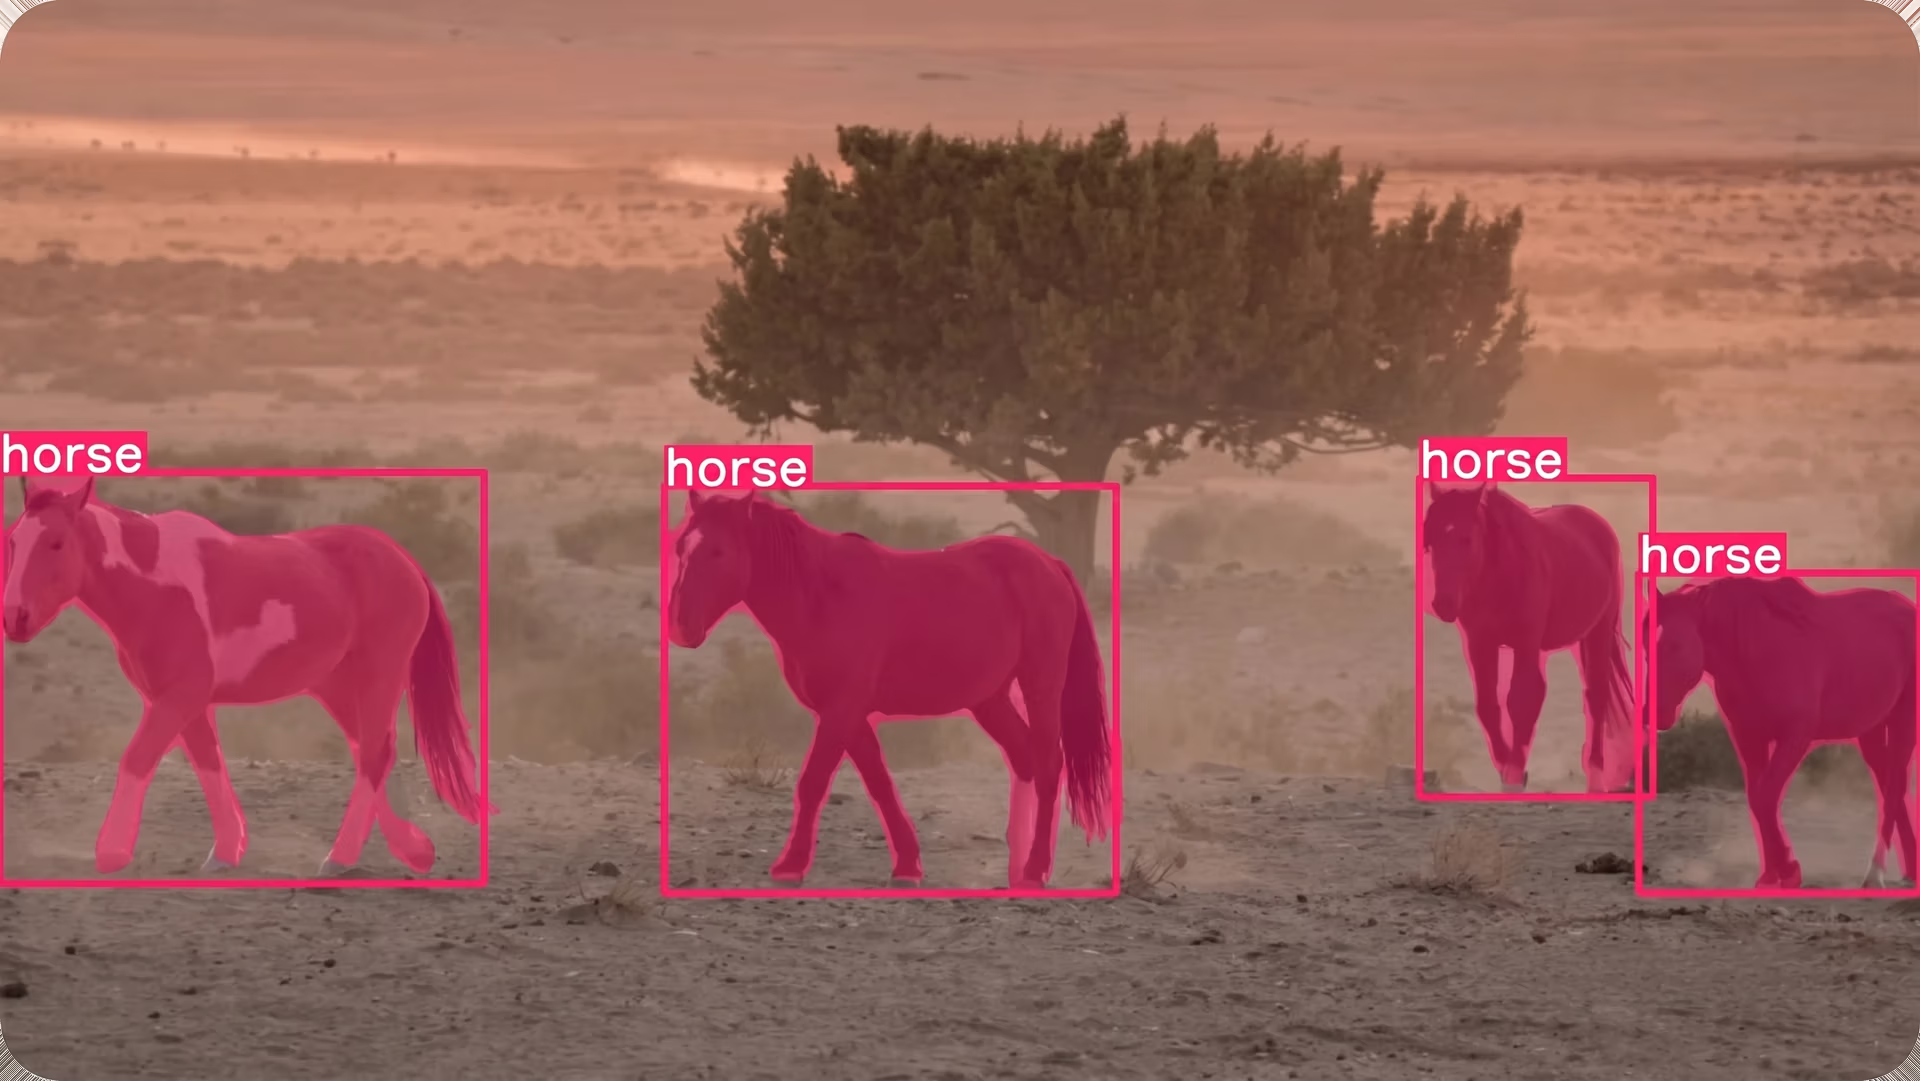
Рис. 1. Сегментация объектов на изображении с помощью Ultralytics YOLO26
Такие модели, как Ultralytics YOLO26, предварительно обучены и сразу умеют сегментировать повседневные объекты, например людей, автомобили и животных. Однако для более специфических задач их также можно обучить на собственных данных. Другими словами, модели могут научиться понимать, как выглядят объекты и как точно обводить их контуры.
В этой статье мы расскажем, как обучить Ultralytics YOLO26 на собственных данных для сегментации экземпляров. Давайте начнем!
Что такое сегментация экземпляров?#
Прежде чем перейти к обучению моделей, давай сначала разберемся, что именно означает сегментация экземпляров.
Сегментация экземпляров — это задача компьютерного зрения, которая позволяет модели находить каждый отдельный объект на изображении и обводить его точную форму. Вместо того чтобы только определять наличие объекта, модель анализирует каждый пиксель изображения и решает, принадлежит ли он конкретному объекту.
Это позволяет разделять объекты, даже если они перекрываются или находятся очень близко друг к другу. Ключевое понятие, помогающее наглядно представить сегментацию экземпляров, — маска.
Маска — это контур на уровне пикселей, покрывающий только область объекта. Можно представить ее как раскрашивание объекта маркером, при котором все остальное остается нетронутым.
Каждый объект получает собственную маску, благодаря чему модель может отличать один объект от другого, даже если они относятся к одному типу, например два автомобиля или два человека, стоящих рядом.
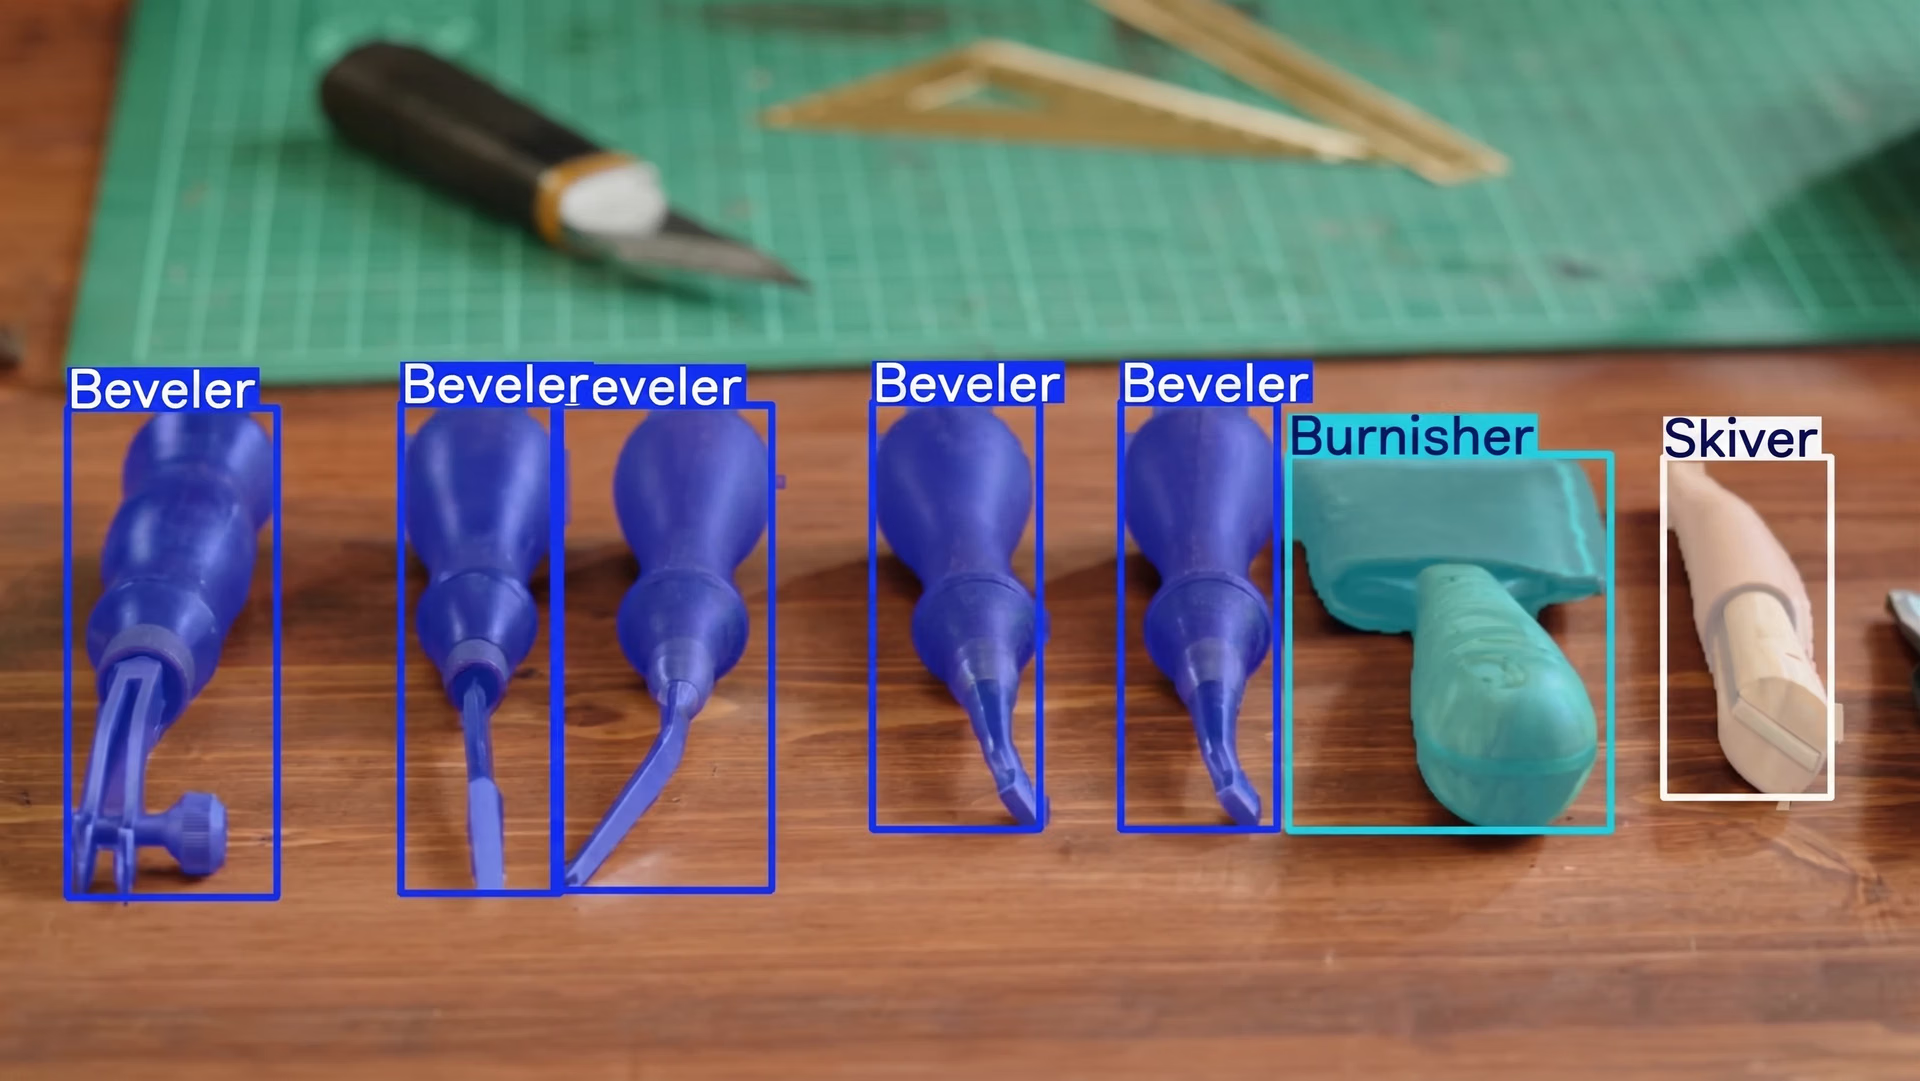
Рис. 2. Пример сегментации экземпляров
Чтобы лучше понять, что такое сегментация экземпляров, можно сравнить ее с другими распространенными задачами компьютерного зрения. При обнаружении объектов используются ограничивающие рамки — простые прямоугольники, нарисованные вокруг объектов. Ограничивающие рамки быстры и полезны, но не передают точную форму объекта.
Семантическая сегментация, напротив, присваивает каждому пикселю изображения категорию, но не различает отдельные объекты одного класса. Сегментация экземпляров объединяет преимущества обоих подходов: определяет категории объектов и назначает отдельную маску каждому объекту.
Поскольку сегментация экземпляров предоставляет настолько подробную информацию, она особенно полезна в реальных задачах, таких как автоматизированный контроль качества, анализ медицинских изображений и робототехника. Задачи, требующие точных измерений, аккуратных границ или разделения объектов, выигрывают от такого понимания на уровне пикселей.
Ultralytics YOLO26 поддерживает сегментацию экземпляров#
Ultralytics YOLO26 — это сквозная современная модель компьютерного зрения без подавления немаксимумов (NMS), предназначенная для быстрой и эффективной обработки реальных задач компьютерного зрения. Она относится к семейству моделей обнаружения Ultralytics YOLO, которые могут обрабатывать изображения и видео в реальном времени, обеспечивая точные результаты.
Ultralytics YOLO26 поддерживает несколько задач компьютерного зрения в рамках одной платформы, включая обнаружение объектов, оценку позы, классификацию изображений, обнаружение ориентированных ограничивающих рамок (обнаружение obb) и сегментацию экземпляров.
Ultralytics YOLO26 поставляется предварительно обученной: это означает, что она уже научилась распознавать распространенные объекты, такие как люди, транспортные средства и повседневные предметы, на больших широко используемых наборах данных, например COCO и ImageNet. Ты можешь сразу начать использовать модель без дополнительного обучения.
Однако если твое приложение работает с уникальными объектами, специфическими условиями или необычным освещением, обучение собственной модели может значительно улучшить результаты. Обучив Ultralytics YOLO26 на собственных размеченных изображениях, ты можешь научить модель точно понимать, что искать и как аккуратнее обводить объекты для конкретного варианта использования.
Этот процесс также называют дообучением. Вместо обучения модели с нуля дообучение начинается с предварительно обученной модели Ultralytics YOLO26 и постепенно адаптирует ее с помощью твоих данных. Поскольку модель уже понимает общие визуальные закономерности, такие как границы, формы и текстуры, ей требуется гораздо меньше размеченных изображений и времени, чтобы научиться распознавать твои конкретные объекты.
Проще говоря, дообучение быстрее, эффективнее и доступнее, чем обучение модели с нуля. Обучение Ultralytics YOLO26 на собственных данных — практичный вариант даже для новичков и команд с ограниченными данными и вычислительными ресурсами.
Изучаем применения сегментации экземпляров Ultralytics YOLO26#
Итак, где сегментация экземпляров может быть особенно полезна? В ситуациях, когда важно различать объекты и понимать их точные формы, особенно если объекты находятся близко друг к другу или перекрываются.
Вот несколько распространенных рабочих процессов, в которых сегментация экземпляров действительно меняет результат:
- Аэрофотосъемка и съемка с дронов: эта задача позволяет дронам разделять такие объекты, как здания, транспортные средства и растительность, на аэрофотоснимках для картографирования, инспекций и геодезических работ.
- Спортивная аналитика: сегментация экземпляров помогает анализировать перемещения и взаимодействия игроков, отделяя отдельных спортсменов от фона во время матчей или тренировок.
- Мониторинг строительства и инфраструктуры: помогает обнаруживать конструктивные элементы, трещины и поврежденные участки в зданиях, мостах и дорогах для планирования технического обслуживания.
- Здравоохранение и анализ медицинских изображений: сегментация экземпляров позволяет точно обводить клетки, ткани и медицинские инструменты, обеспечивая более точный анализ и диагностику.
- Сельское хозяйство и экологический мониторинг: помогает обнаруживать и разделять сельскохозяйственные культуры, фрукты и болезни растений, упрощая оценку урожайности и применение целевых обработок.
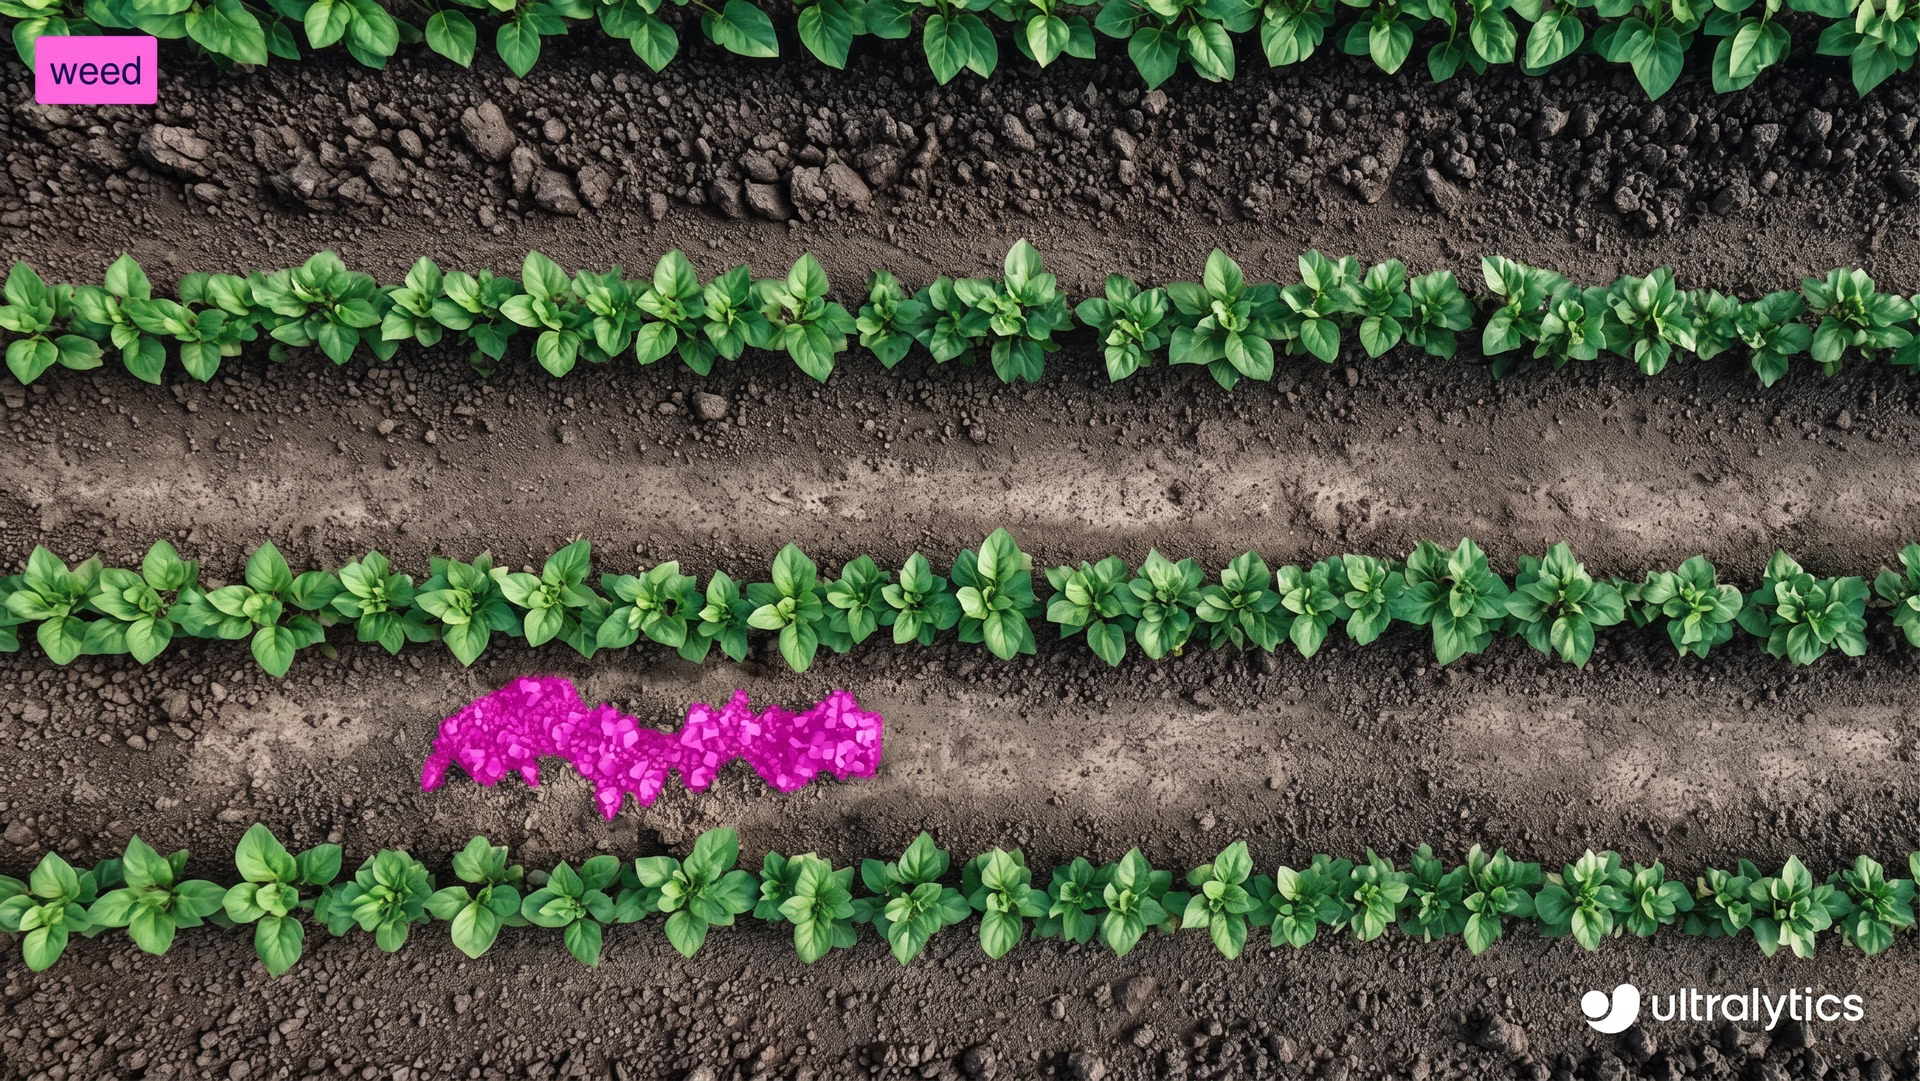
Рис. 3. Пример сегментации сорняков с помощью YOLO26 (Источник)
Как работает обучение Ultralytics YOLO26 на собственных данных для сегментации экземпляров#
Теперь обсудим, как работает обучение на собственных данных. Хотя обучение модели может звучать технически сложно, общий процесс достаточно прост.
Ты можешь подготовить изображения, разметить объекты, которым модель должна научиться, настроить небольшой файл параметров, а затем обучить YOLO26 с помощью пакета Ultralytics для Python. Пакет Ultralytics для Python — это библиотека программного обеспечения, предоставляющая готовые инструменты для обучения, тестирования и развертывания моделей YOLO без необходимости создавать все с нуля.
Шаг 1. Подготовь собственный набор данных#
Первый шаг — подготовить собственный набор данных для сегментации. Набор данных — это просто коллекция изображений, на которых представлены объекты, которым ты хочешь обучить модель.
Старайся включать изображения, отражающие реальные условия: разные ракурсы, освещение, фоны и размеры объектов. Чем разнообразнее изображения, тем лучше будет работать модель.
Для сегментации экземпляров изображения также должны содержать аннотации. Аннотирование заключается в разметке объектов на каждом изображении, чтобы модель понимала, чему учиться. Вместо простых рамок ты рисуешь подробные контуры (полигоны) вокруг каждого объекта, отмечая его точную форму. Эти контуры становятся масками, которые модель учится предсказывать.
Для создания такой разметки можно использовать несколько инструментов аннотирования с открытым исходным кодом. Многие из них предоставляют удобные интерфейсы, в которых можно загружать изображения и непосредственно рисовать на них контуры объектов.
Когда изображения и аннотации готовы, организуй их в папки для обучения и валидации. Обычно 80% изображений используют для обучения, а 20% — для валидации, хотя в зависимости от размера набора данных также часто применяют соотношение 70% к 30%. Обучающая выборка обучает модель, а валидационная используется для оценки ее работы на ранее не виденных изображениях.
Важно сохранить сбалансированное разделение и убедиться, что в обеих папках есть разнообразные примеры. Чистый, хорошо размеченный набор данных с правильным разделением на обучающую и валидационную выборки формирует основу сильной модели сегментации экземпляров.
Шаг 2. Создай YAML-файл набора данных#
После подготовки изображений и аннотаций нужно создать YAML-файл набора данных. В этом файле указывается расположение набора данных и классы объектов, которым модель должна научиться во время обучения.
В этом файле можно определить корневой каталог набора данных, пути к папкам с обучающими и валидационными изображениями, а также список названий классов. Названия классов должны быть указаны в том же порядке, что и номера классов в файлах аннотаций, чтобы все корректно совпадало.
Если у тебя есть вопросы о точном формате, обратись к официальной документации Ultralytics, где приведена дополнительная информация.
Шаг 3. Установи пакет Ultralytics для Python#
Теперь, когда набор данных и YAML-файл готовы, нужно установить пакет Ultralytics для Python.
Этот пакет включает инструменты, необходимые для обучения, валидации, выполнения инференса и экспорта моделей Ultralytics YOLO26. Он предоставляет удобный способ работы с моделями YOLO без создания сложных конвейеров обучения с нуля.
Перед установкой пакета Ultralytics для Python также важно выбрать среду, в которой ты будешь запускать код. Работать с пакетом Ultralytics можно в нескольких средах разработки, например:
- Интерфейс командной строки (CLI): текстовая среда, в которой ты взаимодействуешь с компьютером, вводя команды. Вместо нажатия кнопок или навигации по меню, как в графическом интерфейсе, ты вводишь текстовые инструкции для непосредственного запуска программ и выполнения задач.
- Jupyter Notebooks: интерактивная среда, в которой ты пишешь и запускаешь код небольшими фрагментами и сразу видишь результат. Это удобно для экспериментов и обучения.
- Google Colab: облачная платформа для работы с ноутбуками, не требующая локальной установки и предоставляющая опциональный доступ к графическим процессорам (GPUs). Для новичков это часто самый простой вариант.
После выбора среды можно установить пакет Ultralytics для Python. Для этого выполни следующую команду:
pip install ultralytics
Если ты используешь среду на основе ноутбуков, например Google Colab или Jupyter Notebook, добавь восклицательный знак в начало команды. Если возникнут проблемы с установкой, обратись к документации Ultralytics или руководству по устранению неполадок, где приведены распространенные решения и советы по настройке среды.
После установки ты будешь готов загрузить предварительно обученную модель сегментации Ultralytics YOLO26 и начать обучение.
Шаг 4. Обучи Ultralytics YOLO26 для сегментации экземпляров#
Перед началом обучения нужно выбрать размер модели. Модели Ultralytics YOLO26 доступны в разных размерах: Nano (n), Small (s), Medium (m), Large (l) и Extra Large (x).
Меньшие модели обучаются быстрее и эффективнее работают на центральных процессорах (CPUs) или периферийных устройствах, тогда как более крупные модели обычно обеспечивают более высокую точность, но требуют больше памяти и выигрывают от ускорения на GPU. Если ты только начинаешь или работаешь на ограниченном оборудовании, практичным выбором будет версия Nano (YOLO26n).
После выбора размера модели нужно загрузить предварительно обученную модель сегментации и начать ее обучение на собственном наборе данных. Для этого укажи файл предварительно обученной модели, путь к YAML-файлу набора данных, количество эпох и размер изображения, как показано ниже.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
results = model.train(data="path/to/file.yaml", epochs=100, imgsz=640)
Количество эпох определяет, сколько раз модель пройдет по всему обучающему набору данных. На каждой эпохе модель делает предсказания, сравнивает их с правильными аннотациями, вычисляет ошибки и обновляет внутренние параметры для повышения качества.
Если обучение началось корректно, в терминале или ноутбуке будут отображаться конфигурация модели, сканирование набора данных и ход обучения. По мере обучения значения функции потерь и метрики оценки будут обновляться после каждой эпохи, показывая, как модель постепенно улучшается.
Шаг 5. Оцени производительность модели, обученной на собственных данных#
После завершения обучения можно просмотреть и проверить метрики производительности модели. В Google Colab перейди в папку “runs”, затем в папку “segment” и, наконец, в папку “train”, где находятся журналы с ключевыми показателями производительности.
Для пользователей, работающих в среде Python, результаты обучения по умолчанию сохраняются в каталоге “runs/train/” внутри текущего рабочего каталога. Каждый запуск обучения создает новый подкаталог, например runs/train/exp или runs/train/exp2, где находятся журналы, сохраненные веса и другие результаты этого эксперимента.
Если ты используешь CLI, получить доступ к этим результатам и управлять ими можно с помощью команды “yolo settings”. Эта команда позволяет просматривать или изменять пути и конфигурации, связанные с журналами обучения и сведениями об экспериментах.
Среди сохраненных результатов также будут графики, созданные во время обучения. Они показывают, как модель улучшалась со временем. Например, на них отображается снижение функции потерь по мере обучения модели и рост таких метрик оценки, как точность, полнота и средняя точность по эпохам.
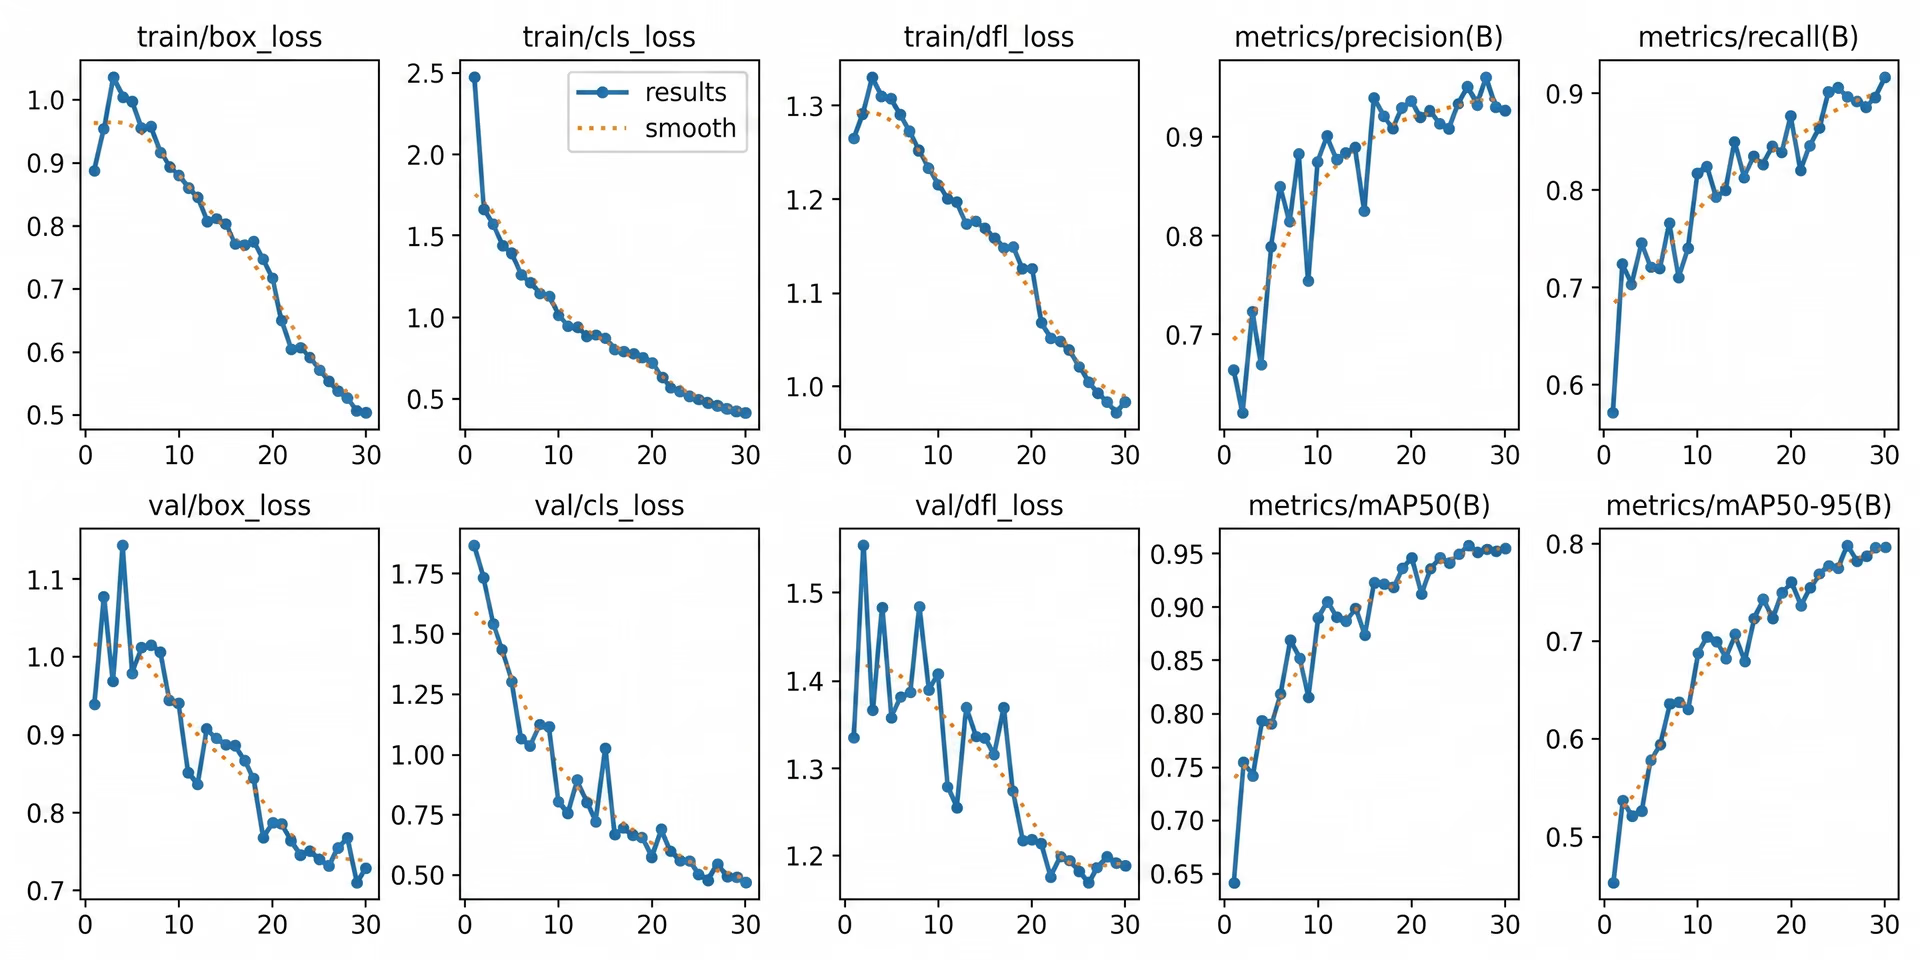
Рис. 4. Типы графиков, которые можно анализировать для оценки модели (Источник)
Эти визуальные тенденции помогают понять, успешно ли обучилась модель и насколько она улучшилась от начала до конца обучения. Анализ числовых метрик и графиков дает более ясное представление о качестве работы модели сегментации экземпляров перед переходом к тестированию на новых изображениях.
Шаг 6. Протестируй модель и выполни инференс#
После валидации модели последний шаг — протестировать ее на новых изображениях. Этот процесс называется инференсом и означает использование обученной модели для создания предсказаний на ранее не виденных данных.
Выполнить инференс в Python можно следующим образом:
results = model.predict("path/to/image.jpg", save=True, conf=0.3)В этом примере "path/to/image.jpg" можно заменить путем к изображению, которое ты хочешь протестировать.
Параметр “save=True” указывает модели создать и сохранить новое изображение с предсказанными масками сегментации, наложенными на исходное изображение.
Параметр “conf=0.3” задает порог уверенности: модель будет показывать только те предсказания, в правильности которых она уверена как минимум на 30%. Уменьшение этого значения может увеличить количество обнаружений, а его повышение сделает модель более избирательной.
После выполнения команды модель создаст новую папку внутри каталога runs и сохранит в ней выходное изображение. Открой сохраненное изображение, чтобы визуально проверить, насколько хорошо маски сегментации повторяют границы объектов и правильно ли разделены перекрывающиеся объекты.
Тестирование модели на изображениях с разными фонами и условиями освещения поможет лучше понять, как она работает за пределами обучающего набора данных. Когда результаты станут стабильными и точными, модель будет готова к экспорту и развертыванию.
Шаг 7. Экспортируй и разверни модель#
После тестирования модели и подтверждения ее хорошей производительности последний шаг — экспорт и развертывание. Экспорт преобразует обученную модель Ultralytics YOLO26 в формат, который может работать в разных средах, например на производственных серверах, периферийных устройствах или в мобильных приложениях.
Ultralytics поддерживает несколько форматов экспорта, поэтому ты можешь выбрать наиболее подходящий для своей конфигурации развертывания. Например, можно экспортировать модель в ONNX для широкой совместимости между платформами, в TensorRT для оптимизированной производительности GPU на оборудовании NVIDIA или в OpenVINO для эффективного развертывания на CPU-устройствах Intel. Эти интеграции упрощают запуск модели за пределами среды обучения и помогают добиться высокой производительности в реальном времени.
Экспортировать модель в Python можно следующей командой:
model.export(format="onnx")Эта команда преобразует обученную модель в формат ONNX. В зависимости от требований к развертыванию можно заменить "onnx" на другой поддерживаемый формат.
После экспорта модель можно интегрировать в такие приложения, как веб-сервисы, встроенные системы компьютерного зрения, робототехнические платформы или системы промышленного контроля. На этом этапе твоя модель сегментации экземпляров Ultralytics YOLO26, обученная на собственных данных, может перейти от экспериментов к реальному развертыванию.
Основные выводы#
Обучение Ultralytics YOLO26 на собственных данных для сегментации экземпляров дает гибкость при создании модели, действительно соответствующей конкретной задаче. Подготовив понятный набор данных, настроив YAML-файл, обучив модель с предварительно обученными весами сегментации и проанализировав результаты, ты можешь научить модель точно обводить каждый объект на уровне пикселей. После тестирования и экспорта модель YOLO26 может перейти из разработки к реальным приложениям разного масштаба.
Присоединяйся к нашему сообществу и загляни в наш репозиторий на GitHub, чтобы узнать больше об ИИ. Если ты хочешь создать собственный проект в области ИИ для компьютерного зрения, ознакомься с нашими вариантами лицензирования. Узнай больше о таких применениях, как ИИ в здравоохранении и ИИ для компьютерного зрения в розничной торговле, на страницах наших решений.








