Повышай устойчивость моделей ИИ с помощью аугментации данных
Узнай, как аугментация данных помогает повысить устойчивость моделей ИИ и их эффективность в реальных условиях, добавляя реалистичные вариации в обучающие данные.
 Abirami Vina8 мин. чтения
Тестирование — важнейшая часть разработки любого технологического решения. Оно показывает командам, как система работает на самом деле, ещё до запуска, и позволяет заранее устранить проблемы. Это относится ко многим областям, включая ИИ, где после развёртывания модели должны справляться с непредсказуемыми условиями реального мира.
Например, компьютерное зрение — это направление ИИ, которое учит машины понимать изображения и видео. Модели компьютерного зрения, такие как Ultralytics YOLO26, поддерживают такие задачи, как обнаружение объектов, сегментация экземпляров и классификация изображений.
Их можно применять во многих отраслях: например, для наблюдения за пациентами, анализа дорожного движения, автоматизации касс и контроля качества на производстве. Однако даже передовые модели и качественные обучающие данные не гарантируют, что решения на основе ИИ для компьютерного зрения не столкнутся с трудностями в реальных условиях — например, из-за смены освещения, движения или частично закрытых объектов.
Это происходит потому, что модели учатся на примерах, полученных при обучении. Если раньше модели не встречали бликов, размытия в движении или частично видимых объектов, они с меньшей вероятностью распознают объекты в таких условиях правильно.
Один из способов повысить устойчивость модели — использовать аугментацию данных. Вместо сбора большого объёма новых данных инженеры могут вносить небольшие, но значимые изменения в существующие изображения: корректировать освещение, кадрировать или смешивать изображения. Это помогает модели учиться распознавать одни и те же объекты в более широком диапазоне ситуаций.
В этой статье мы расскажем, как аугментация данных повышает устойчивость моделей и надёжность систем ИИ для компьютерного зрения при развёртывании вне контролируемых условий. Начнём!
Как проверить устойчивость модели#
Прежде чем перейти к аугментации данных, давай обсудим, как понять, готова ли модель компьютерного зрения к реальному использованию.
Устойчивая модель продолжает хорошо работать даже при изменении условий, а не только на чистых, идеально размеченных изображениях. Вот несколько практических факторов, которые следует учитывать при оценке устойчивости модели ИИ:
- Изменение освещения: модели могут вести себя по-разному при ярком и слабом освещении, бликах или тенях, что влияет на уверенность обнаружения объектов.
- Частичное перекрытие: в повседневных сценах другие предметы часто закрывают объекты, или объекты видны лишь частично. Более устойчивая модель способна распознавать их даже при нехватке визуальной информации.
- Загруженные сцены: множество перекрывающихся объектов усложняет обнаружение. Модели, хорошо работающие в таких случаях, обычно надёжнее в сложных условиях.
Высокие результаты на чистых, идеально снятых изображениях не всегда означают хорошую работу в реальном мире. Регулярное тестирование в различных условиях показывает, насколько хорошо модель справляется после развёртывания.
Что такое аугментация данных?#
Вид объекта на фотографии меняется в зависимости от освещения, угла съёмки, расстояния или фона. При обучении модели компьютерного зрения набор данных должен включать такие вариации, чтобы модель хорошо работала в непредсказуемой среде.
Аугментация данных расширяет обучающий набор, создавая дополнительные примеры на основе уже имеющихся изображений. Для этого применяют преднамеренные изменения: поворачивают или отражают изображение, корректируют яркость либо обрезают его часть.
Представь, что у тебя есть только одна фотография кошки. Повернув изображение или изменив его яркость, ты можешь создать несколько новых вариантов из одной фотографии. Каждый вариант немного отличается, но на всех изображена та же кошка. Такие вариации помогают научить модель тому, что объект может выглядеть по-разному, оставаясь тем же самым.
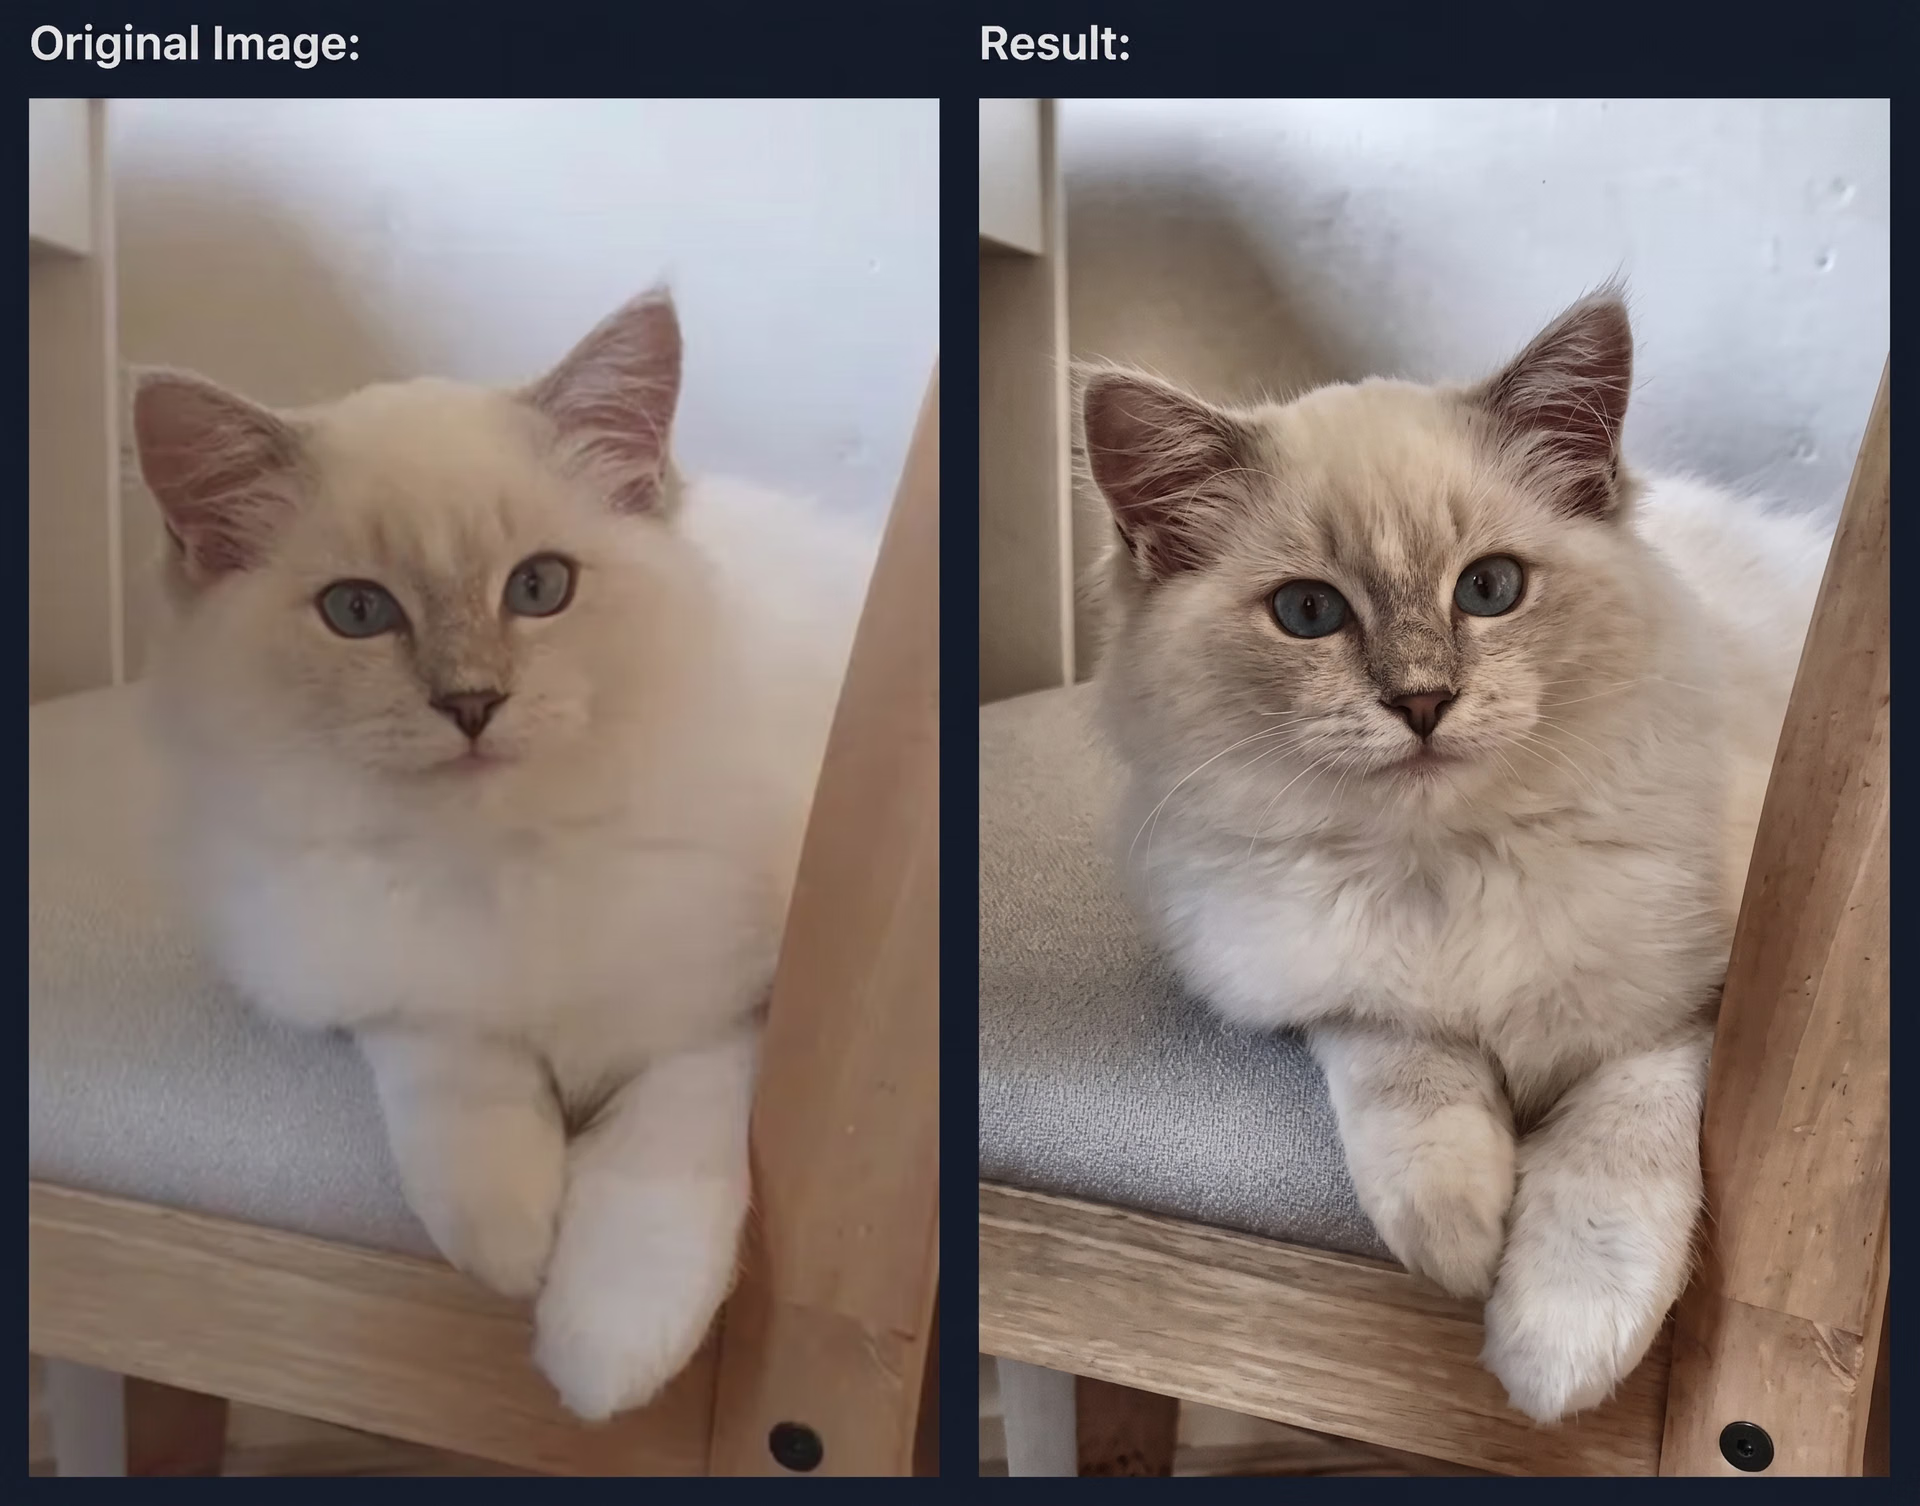
Рис. 1. Пример аугментации изображения кошки (Источник)
Как аугментация данных повышает производительность модели#
Во время обучения модели аугментацию данных можно встроить непосредственно в конвейер обучения. Вместо ручного создания и хранения новых копий изображений можно применять случайные преобразования при загрузке каждого изображения.
Это означает, что каждый раз модель видит немного изменённую версию изображения: более яркую, отражённую или частично скрытую. Такие методы, как случайное стирание, могут даже удалять небольшие области изображения, имитируя реальные ситуации, когда объект перекрыт или виден лишь частично.
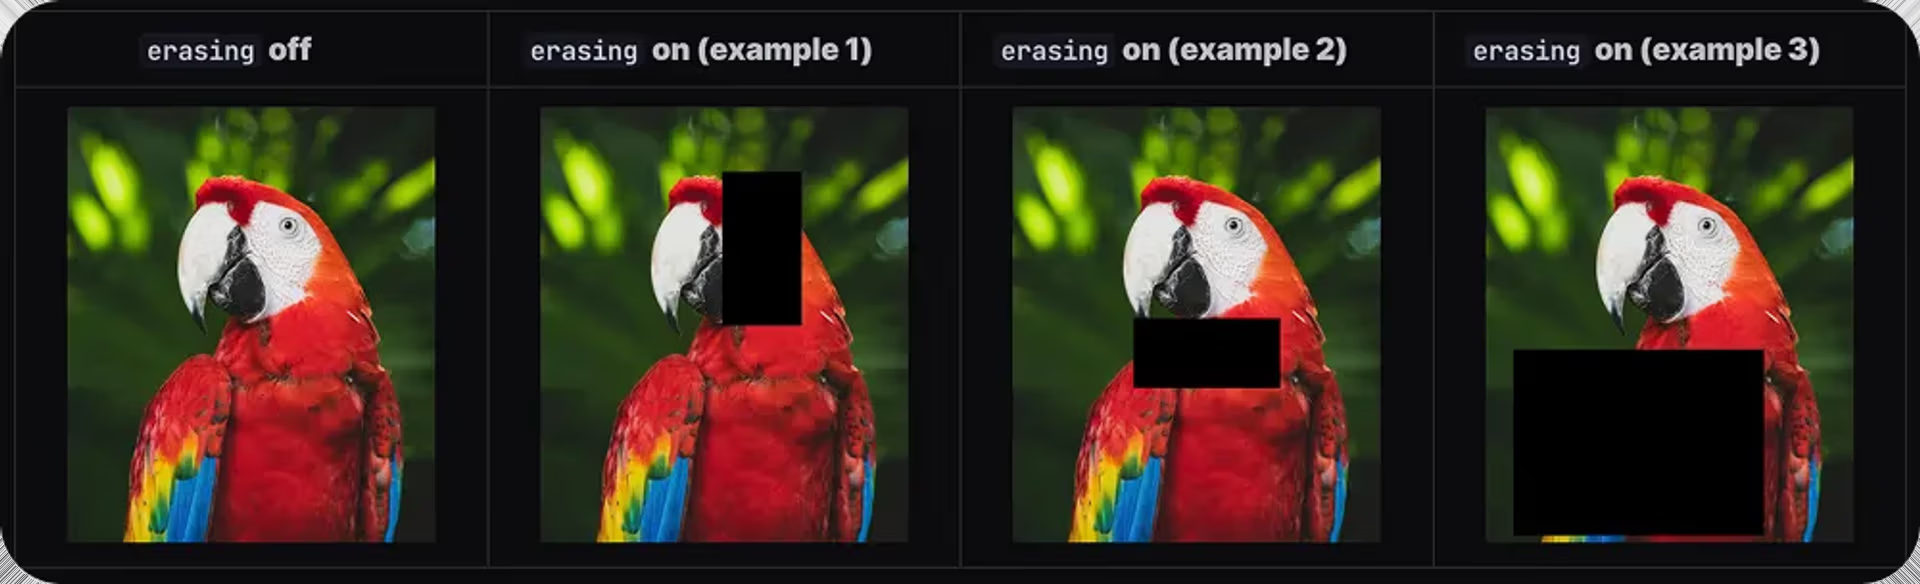
Рис. 2. Примеры аугментации со случайным стиранием (Источник)
Просмотр множества различных вариантов одного и того же изображения позволяет модели учиться выделять важные признаки, а не полагаться на один идеальный пример. Такое разнообразие повышает устойчивость модели ИИ и помогает ей надежнее работать в реальных условиях.
Распространенные методы аугментации данных#
Вот несколько методов аугментации данных, которые помогают разнообразить обучающие изображения:
- Геометрические преобразования: Эти методы изменяют пространственное положение объекта на изображении. Поворот, отражение, изменение размера, кадрирование или сдвиг изображения помогают модели понимать, как объект выглядит под разными углами и с разных расстояний.
- Коррекция цвета и освещения: В реальных условиях освещение редко бывает одинаковым. В зависимости от окружения или используемой камеры изображения могут быть слишком яркими, слишком темными или иметь немного искаженные цвета. Коррекция яркости, контрастности, оттенка и насыщенности позволяет моделям справляться с такими визуальными изменениями и хорошо работать в разных сценах.
- Изменение качества изображения: Размытость и визуальный шум могут снижать четкость изображений. Добавление размытия или шума во время обучения помогает модели справляться со смазом в движении, изображениями при слабом освещении и низким качеством снимков камеры, делая ее менее чувствительной к несовершенствам изображения.
- Аугментации на основе окклюзии: в реальных условиях объекты часто частично заслонены другими объектами. Это явление называют окклюзией. Скрытие или маскирование небольших областей изображения во время обучения помогает модели научиться обнаруживать объекты, даже когда видна только их часть.
- Аугментации с несколькими изображениями: Эти методы объединяют фрагменты нескольких изображений в один обучающий пример. Благодаря этому в кадре может оказаться больше объектов, а модель лучше справляется со сложными или перегруженными сценами.
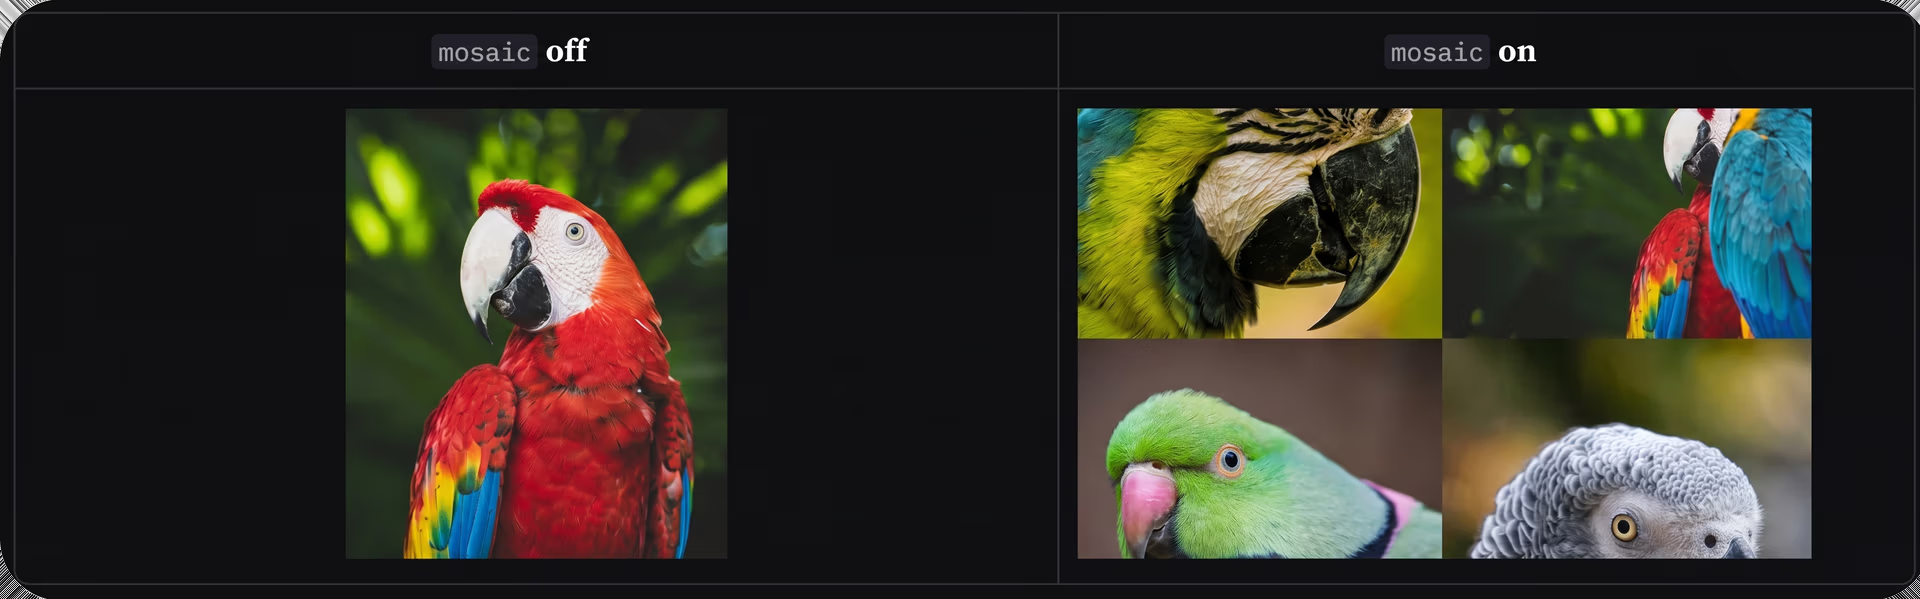
Рис. 3. Пример аугментации с несколькими изображениями (Источник)
Простая аугментация данных с помощью пакета Ultralytics Python#
Управление наборами данных, создание вариантов изображений и написание кода преобразований добавляют лишние шаги при разработке приложения компьютерного зрения. Пакет Ultralytics Python упрощает эту работу, предоставляя единый интерфейс для обучения, запуска и развертывания моделей Ultralytics YOLO, таких как YOLO26. Чтобы упростить рабочие процессы обучения, пакет включает встроенные аугментации данных, протестированные Ultralytics и оптимизированные для моделей YOLO.
Пакет также поддерживает полезные интеграции, избавляющие от необходимости использовать отдельные инструменты или писать собственный код. В частности, для аугментации данных пакет интегрируется с библиотекой Albumentations, широко используемой для аугментации изображений. Благодаря этой интеграции аугментации автоматически применяются во время обучения, без дополнительных скриптов или собственного кода.
Управление аннотациями и аугментированными наборами данных#
На устойчивость модели также влияет качество аннотаций. Точные и чистые метки, созданные и упорядоченные с помощью таких инструментов аннотирования, как Ultralytics Platform или Roboflow, помогают модели понять, где находятся объекты и как они выглядят.
Во время обучения аугментации данных, такие как отражения, кадрирование и повороты, применяются динамически, а аннотации автоматически корректируются в соответствии с этими изменениями. Если метки точны, этот процесс проходит без проблем и предоставляет модели множество реалистичных примеров одной и той же сцены.
Если аннотации неточны или непоследовательны, эти ошибки могут повторяться на аугментированных изображениях, снижая эффективность обучения. Точные аннотации на начальном этапе предотвращают распространение таких ошибок и повышают устойчивость модели.
Улучшение приложений визуального ИИ с помощью аугментации данных#
Далее разберем примеры того, как аугментация данных повышает устойчивость моделей ИИ в реальных приложениях.
Повышение точности обнаружения объектов в реальных условиях#
Синтетические изображения часто используют для обучения систем обнаружения объектов, когда реальные данные ограничены, конфиденциальны или их сложно собрать. С их помощью команды могут быстро создавать примеры товаров, окружения и ракурсов камеры, не снимая каждый сценарий в реальной жизни.
Однако синтетические наборы данных иногда выглядят слишком идеальными по сравнению с реальными видеозаписями, где меняется освещение, объекты перекрывают друг друга, а сцены содержат множество фоновых деталей. Аугментация данных помогает сократить этот разрыв, добавляя реалистичные вариации, например изменения освещения, шум или перемещение объектов, чтобы модель научилась справляться с условиями, в которых ей предстоит работать после развертывания.
Например, в недавнем исследовании модель Ultralytics YOLO11 обучали исключительно на синтетических изображениях, а с помощью аугментации данных добавили разнообразия. Это помогло модели научиться распознавать объекты в более широком диапазоне условий. Она показала хорошие результаты на реальных изображениях, хотя во время обучения ни разу не видела данные из реального мира.
Повышение надежности решений для медицинской визуализации#
Наборы данных для медицинской визуализации часто ограничены, а сами снимки могут различаться в зависимости от типа оборудования, настроек визуализации и клинических условий. Различия в анатомии пациентов, ракурсах, освещении или визуальном шуме затрудняют обучение моделей компьютерного зрения закономерностям, которые хорошо обобщаются на разных пациентов и больницы.
Аугментация данных помогает решить эту проблему, создавая во время обучения несколько вариантов одного и того же снимка, например добавляя шум, слегка смещая изображение или применяя небольшие искажения. Благодаря этим изменениям обучающие данные лучше отражают реальные клинические условия.
Например, в исследовании детской медицинской визуализации исследователи использовали Ultralytics YOLO11 для сегментации анатомических структур и обучали модель на аугментированных медицинских данных. Чтобы сделать изображения реалистичнее, они добавляли шум, слегка смещали их и вносили небольшие искажения.
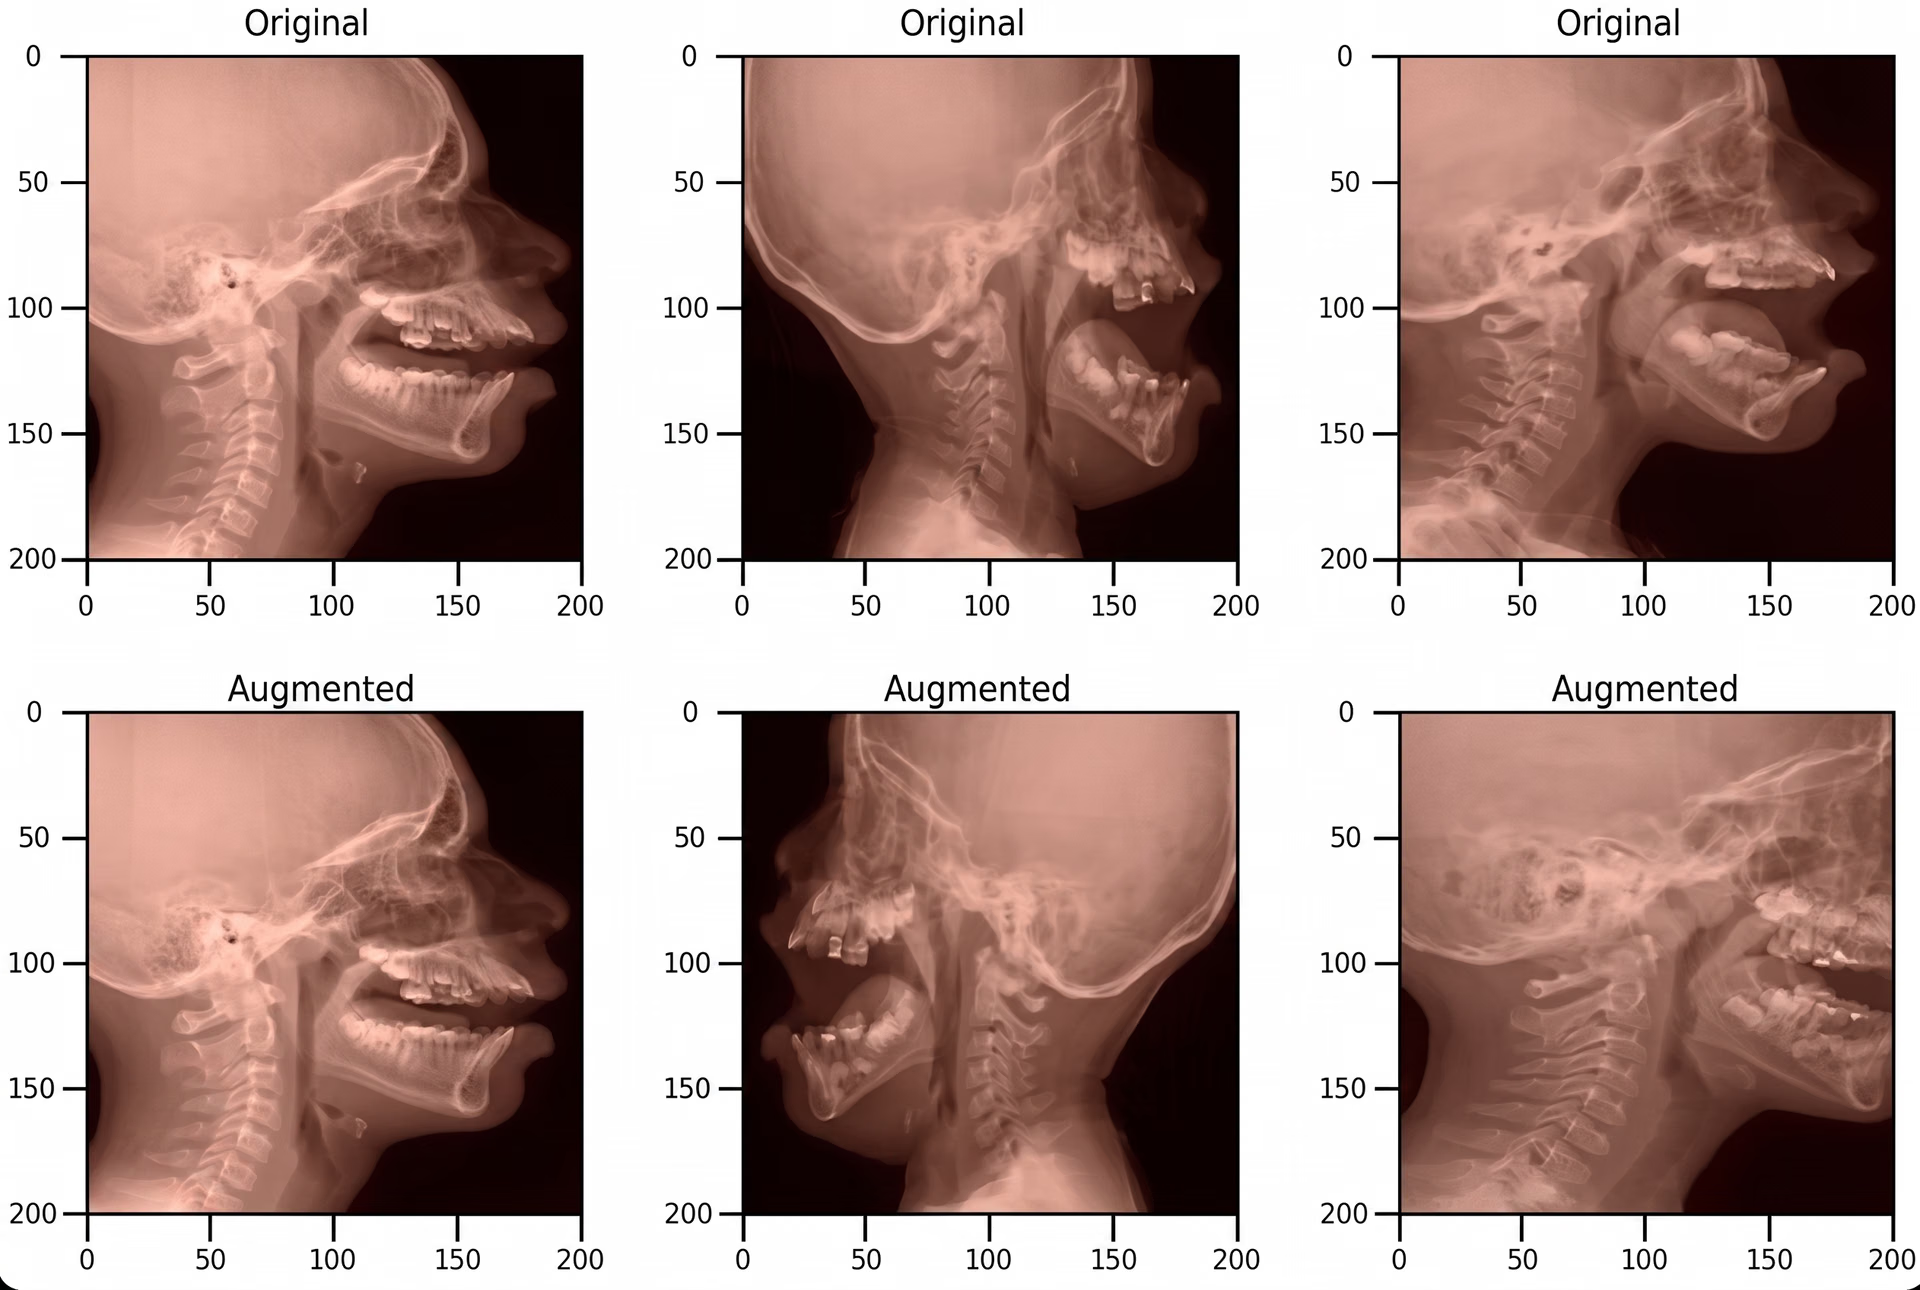
Рис. 4. Исходные и аугментированные медицинские изображения детей (Источник)
Обучаясь на таких вариациях, модель сосредоточилась на значимых анатомических признаках, а не на поверхностных различиях. Благодаря этому результаты сегментации стали стабильнее на разных снимках и примерах пациентов.
Главные выводы#
Собирать разнообразные данные сложно, но аугментация позволяет моделям обучаться на более широком спектре визуальных условий. Благодаря этому модели становятся устойчивее при работе с окклюзиями, изменениями освещения и перегруженными сценами. В целом это помогает им надежнее работать за пределами контролируемых условий обучения.
Присоединяйся к нашему сообществу и узнавай о новейших достижениях в области визуального ИИ в нашем репозитории GitHub. Посети страницы наших решений, чтобы узнать, как такие приложения, как ИИ в производстве и компьютерное зрение в здравоохранении, способствуют прогрессу, и ознакомься с вариантами лицензирования, чтобы реализовать свое следующее решение на основе ИИ.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









