Что такое оценка глубины по монокулярному изображению? Обзор
Узнай, как работает оценка глубины по монокулярному изображению, чем она отличается от методов на основе датчиков и как помогает масштабировать 3D-восприятие в системах компьютерного зрения.
Беспилотные автомобили должны понимать, что происходит вокруг, чтобы безопасно передвигаться. Для этого недостаточно просто распознавать объекты, например пешеходов и другие транспортные средства.
Им также нужно знать, насколько далеко находятся эти объекты, чтобы правильно реагировать. Однако научить машины определять расстояние непросто. В отличие от людей, они не воспринимают глубину по изображениям естественным образом — этому их нужно специально обучать.
Одна из причин в том, что большинство камер фиксирует мир в виде плоских двумерных изображений. Преобразовать такие изображения в представление, отражающее реальную глубину и трёхмерную структуру, непросто, особенно если системы должны надёжно работать в повседневных условиях.
Интересно, что компьютерное зрение — область AI, посвящённая интерпретации и пониманию визуальных данных, — позволяет машинам лучше понимать мир по изображениям. Например, монокулярная оценка глубины — это метод компьютерного зрения, который определяет расстояние до объектов, используя только изображение с одной камеры.
Обучаясь распознавать визуальные признаки, такие как размер объекта, перспектива, текстура и затенение, эти модели могут предсказывать глубину без дополнительных датчиков, например LiDAR (дальномер на основе обнаружения и определения дальности света) или стереокамер. В этой статье мы рассмотрим, что такое монокулярная оценка глубины, как она работает и где применяется в реальных условиях.
Краткое введение в монокулярную оценку глубины#
Монокулярная оценка глубины позволяет машине определять расстояние до объектов, используя всего одно изображение. Поскольку для этого нужна только одна камера, у такого подхода есть несколько преимуществ, включая более низкую стоимость и менее строгие требования к оборудованию.
Например, этот метод можно использовать в недорогих домашних роботах с одной камерой. Даже по одному изображению роботизированная система может определить, какие стены расположены ближе, а какие двери — дальше, и оценить общую глубину пространства.
Зачастую одного изображения недостаточно, чтобы определить расстояния в правильном масштабе, поэтому монокулярная оценка глубины обычно ориентирована на относительную глубину. Иными словами, она может определить, какие объекты находятся ближе, а какие дальше, даже если точное расстояние неизвестно.
Если модель обучают на данных с истинными или абсолютными значениями глубины, например на измерениях датчиков вроде LiDAR, она может научиться предсказывать расстояния в реальных единицах, например в метрах. Без таких эталонных данных модель всё ещё может оценивать относительную глубину, но не сможет надёжно определять абсолютные расстояния.
Результатом монокулярной оценки глубины обычно становится карта глубины — изображение, в котором каждый пиксель показывает, насколько близко или далеко находится соответствующая часть сцены. Карта глубины даёт системам компьютерного зрения базовое представление о трёхмерной структуре окружения.
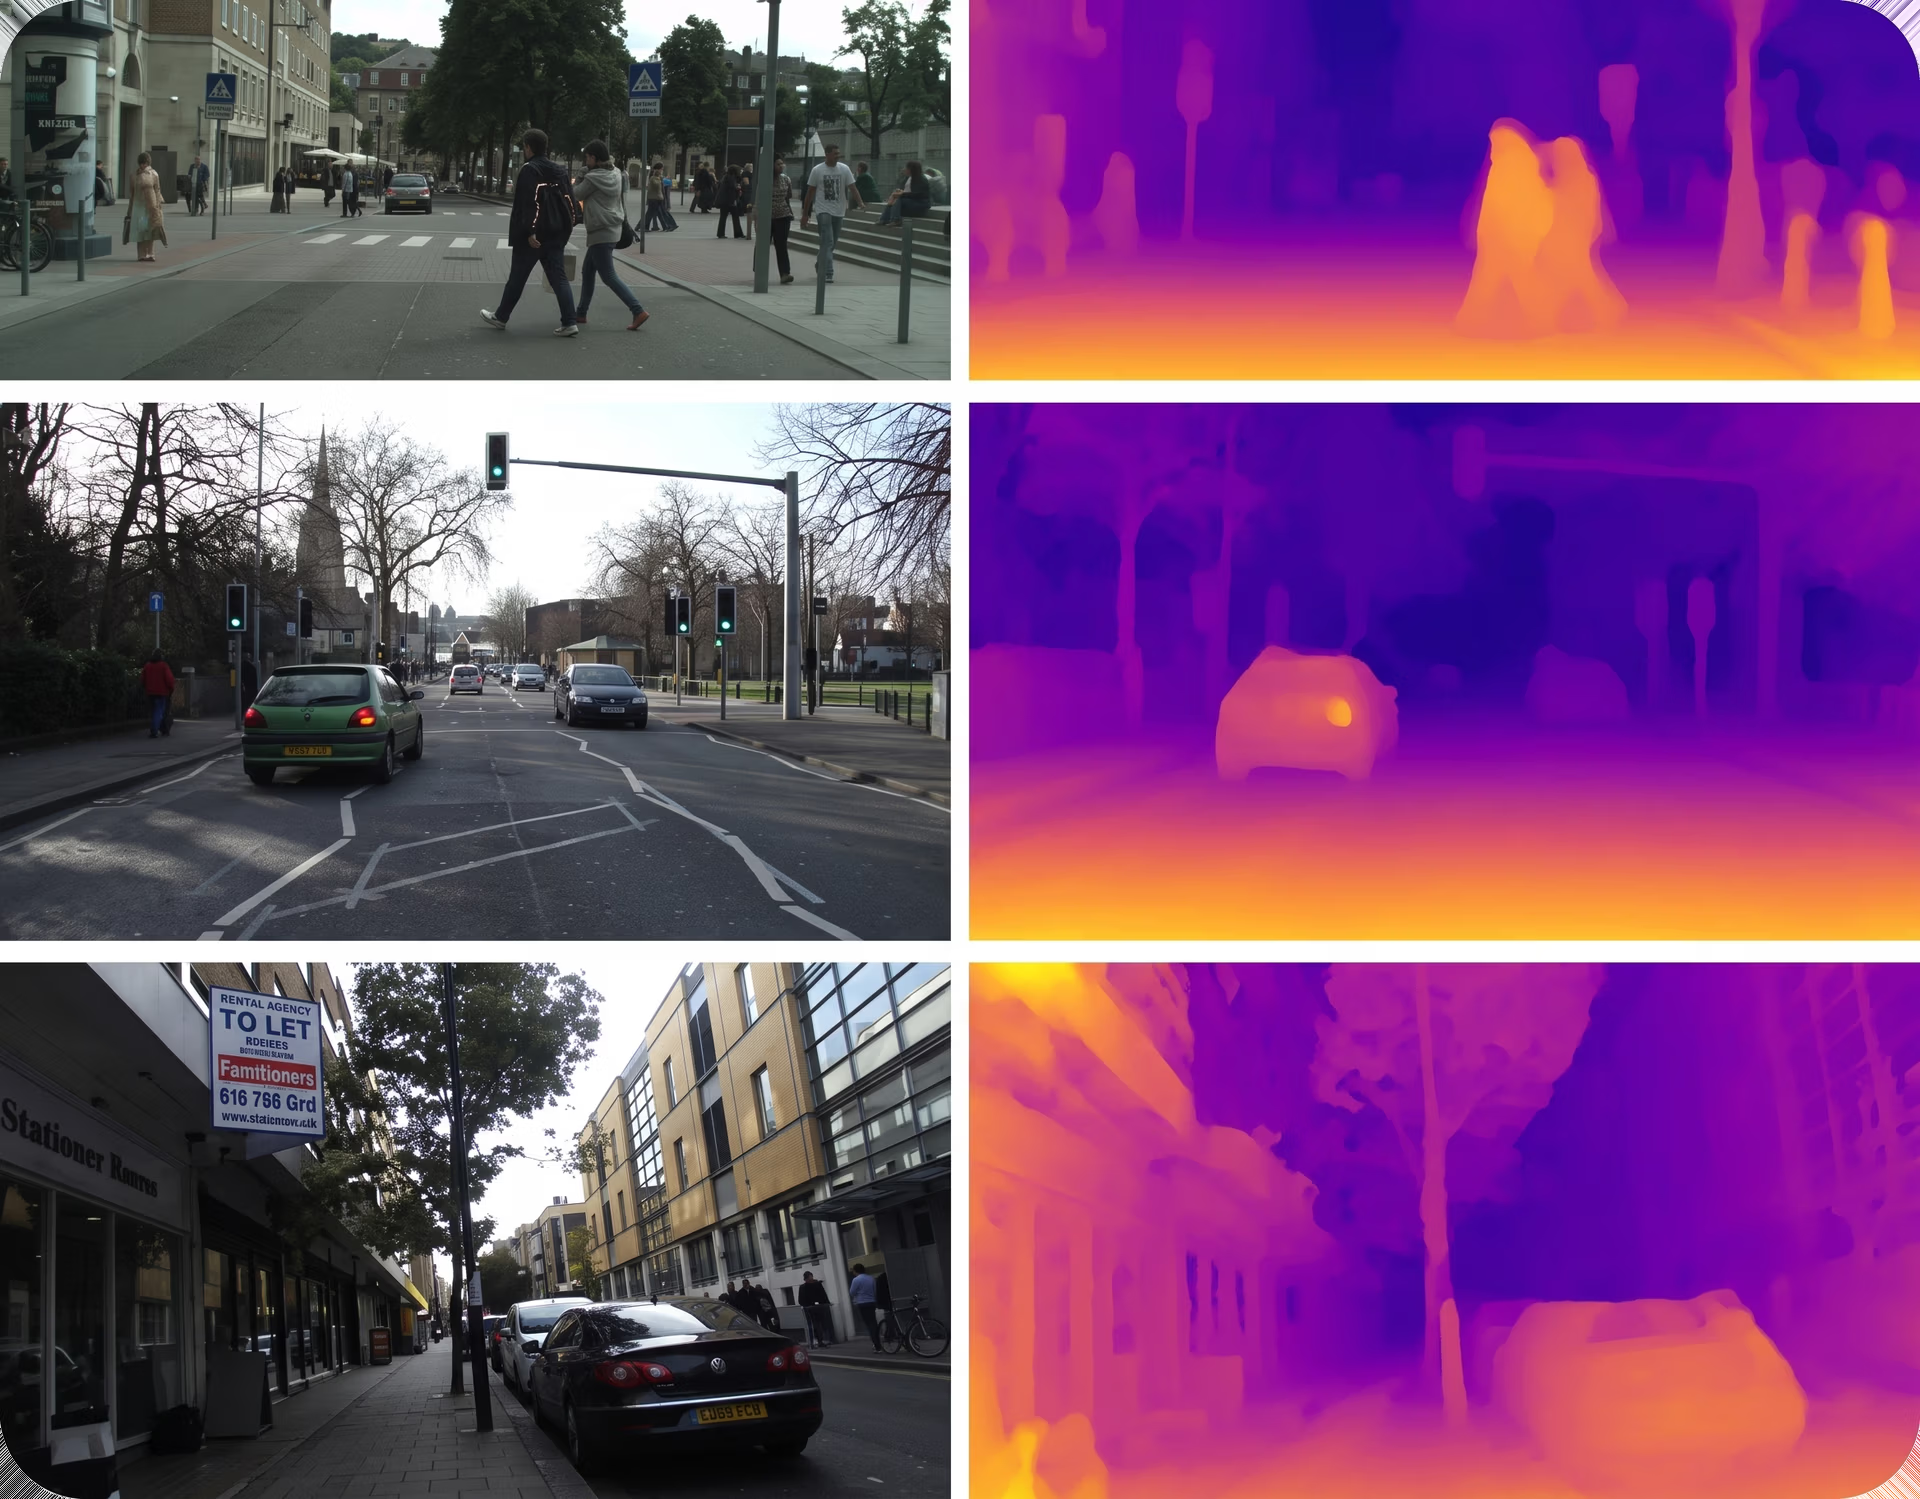
Рис. 1. Пример предсказанной карты глубины, созданной с помощью монокулярной оценки глубины (Источник)
От датчиков к изображениям: оценка глубины#
Оценивать глубину можно разными способами — выбор зависит от доступных датчиков, аппаратных ограничений и требований к точности. Традиционные методы часто используют несколько ракурсов или специализированные датчики для прямого измерения расстояния.
Один из распространённых подходов — стереозрение, которое оценивает глубину, сравнивая два синхронизированных изображения, снятых с немного отличающихся ракурсов. Измеряя разницу между соответствующими точками на двух изображениях, система может определить, насколько далеко объекты находятся от камеры.
Другой подход — системы RGB-D (красный, зелёный, синий и глубина), в которых активные датчики глубины напрямую измеряют расстояние для каждого пикселя. Такие системы могут обеспечивать точные данные о глубине в контролируемых условиях, но требуют дополнительного оборудования.
Методы на основе LiDAR используют лазерные импульсы для создания точных трёхмерных представлений сцены. Хотя датчики LiDAR отличаются высокой точностью, они часто стоят дорого и значительно усложняют аппаратную часть.
В отличие от них, монокулярная оценка глубины определяет глубину, используя только одно RGB-изображение. Поскольку этому подходу не нужны несколько камер или специализированные датчики, его проще внедрять в больших масштабах, и он хорошо подходит для случаев с ограниченным бюджетом и аппаратными ресурсами.
Оценка глубины по одному изображению#
При оценке глубины по одному изображению монокулярные модели глубины учатся распознавать визуальные признаки, которые люди интуитивно используют для оценки расстояния. К ним относятся линии перспективы, размер объектов, плотность текстур, перекрытие объектов и затенение — все эти признаки помогают определить, насколько далеко объекты находятся от камеры.
Эти признаки вместе формируют ощущение глубины. Объекты, которые кажутся меньше или частично перекрыты, обычно находятся дальше, а более чёткие детали и более крупный вид объектов чаще указывают на то, что объект расположен ближе.
Чтобы изучить эти закономерности, монокулярные модели глубины обучают на больших наборах изображений, часто сопоставленных с данными о глубине, полученными из других источников, например LiDAR или стереосистем. Во время обучения модели изучают связь между визуальными признаками и глубиной, что позволяет им оценивать расстояние по одному изображению на этапе инференса.
Благодаря разнообразным обучающим данным современные модели компьютерного зрения могут применять полученные знания в самых разных условиях, в том числе в помещениях и на открытом воздухе, а также справляться с незнакомыми ракурсами.
Обзор методов монокулярной оценки глубины#
Далее мы рассмотрим основные подходы к оценке глубины по одному изображению и то, как эти методы развивались со временем.
Классические и геометрические подходы#
Ранние методы оценки глубины опирались на простые визуальные правила, связанные с геометрией камеры. Для оценки расстояния использовались такие признаки, как перспектива, размер объекта и перекрытие одного объекта другим.
Например, если два похожих объекта имели разный размер, считалось, что меньший находится дальше. Эти подходы достаточно хорошо работали в контролируемых условиях, где такие факторы, как освещение, положение камеры и композиция сцены, оставались неизменными.
Однако в реальных сценах эти предположения часто не работают. Изменения освещения и ракурса, а также повышение сложности сцены могут приводить к ненадёжным оценкам глубины, ограничивая эффективность классических методов в неконтролируемых условиях.
Ранние методы машинного обучения#
Ранние методы машинного обучения сделали оценку глубины более гибкой, научившись выявлять закономерности непосредственно в данных. Вместо того чтобы полагаться только на фиксированные геометрические правила, эти модели пытались изучить связь между визуальной информацией и расстоянием, рассматривая предсказание глубины как задачу регрессии на основе таких признаков, как края, текстуры и изменения цвета.
Выбор этих признаков был важной частью процесса. Инженерам приходилось решать, какие визуальные сигналы извлекать и как их представлять, а производительность модели во многом зависела от этих решений.
Хотя этот подход работал лучше предыдущих методов, у него всё ещё были ограничения. Если выбранным признакам не хватало важного контекста, точность предсказания глубины снижалась. По мере роста сложности и разнообразия сцен этим моделям часто становилось трудно получать надёжные результаты.
Алгоритмы глубокого обучения#
В большинстве современных систем монокулярной оценки глубины используется глубокое обучение — нейронные сети со множеством слоёв, способные извлекать сложные закономерности из данных. Такие модели учатся напрямую предсказывать глубину по изображениям и строить карты глубины.
Многие подходы основаны на свёрточных нейронных сетях (CNN) — типе нейронных сетей, предназначенных для обработки изображений и обнаружения таких закономерностей, как края и формы. В этих моделях часто используется схема «энкодер–декодер»: энкодер извлекает визуальные признаки из изображения, а декодер преобразует их в карту глубины. Обработка изображения в нескольких масштабах помогает модели учитывать общую структуру сцены и при этом чётко выделять границы объектов.
Более новые модели сосредоточены на понимании взаимосвязей между разными частями изображения. Модели на основе Transformer и Vision Transformer (ViT) используют механизмы внимания, позволяющие модели определять наиболее важные области изображения и связывать друг с другом удалённые области. Это помогает модели выстроить более целостное представление о глубине всей сцены.
Некоторые системы объединяют оба подхода. Гибридные модели CNN–Transformer используют CNN для выделения мелких локальных деталей, а Transformer — для моделирования глобального контекста сцены. Хотя такой подход часто повышает точность, обычно он требует больше вычислительных ресурсов, например дополнительной памяти и вычислительной мощности.
Зачем системам Vision AI нужно понимание глубины#
Изучая монокулярную оценку глубины, ты можешь задаться вопросом, почему понимание глубины так важно для систем AI на основе компьютерного зрения.
Когда система может оценивать расстояние до объектов и поверхностей, она лучше понимает устройство сцены и взаимосвязи между её элементами. Такое пространственное восприятие необходимо для принятия надёжных решений, особенно в реальных приложениях, например в автономном вождении.
Информация о глубине также добавляет полезный контекст другим задачам компьютерного зрения. Например, обнаружение объектов с помощью таких моделей, как Ultralytics YOLO26, позволяет системе определить, что присутствует в сцене, а оценка глубины помогает понять, где эти объекты расположены относительно камеры и друг друга.
Вместе эти возможности открывают путь к широкому спектру приложений Vision AI, например к построению трёхмерных карт, навигации в сложных условиях и комплексному пониманию сцены.
Роботы и беспилотные автомобили используют эту информацию, чтобы безопасно перемещаться, избегать препятствий и реагировать на изменения в реальном времени. Например, подход Tesla к вождению только с помощью камер опирается на изображения с камер и оценку глубины, а не на LiDAR, чтобы определять расстояние до объектов и их положение на дороге.
Как работают модели монокулярной оценки глубины#
Хотя архитектуры моделей различаются, большинство моделей монокулярной оценки глубины используют похожий процесс преобразования одного изображения в карту глубины. Кратко рассмотрим основные этапы:
- Ввод и предварительная обработка: процесс начинается с входного изображения. Перед подачей в модель исходное изображение обычно изменяют по размеру, нормализуют и преобразуют в тензор — формат, который нейронные сети используют для эффективной обработки данных изображения.
- Извлечение признаков: сеть-энкодер анализирует изображение и извлекает значимые визуальные признаки. Они содержат информацию о текстурах, границах объектов и общей структуре сцены. Большинство моделей работает в нескольких масштабах, чтобы понимать и мелкие детали, и общую структуру.
- Анализ глубины: используя извлечённые признаки, модель объединяет локальные детали с глобальным контекстом, чтобы анализировать пространственные взаимосвязи в сцене. На этом этапе она учится определять, какие области изображения находятся ближе к камере, а какие — дальше.
- Построение карты глубины: затем декодер преобразует эту информацию в плотную карту глубины. Каждому пикселю изображения присваивается значение глубины; часто для повышения точности и согласованности объединяются предсказания на разных масштабах.
Как обучают модели монокулярной оценки глубины#
В описанном выше процессе предполагается, что у нас уже есть обученная или предварительно обученная модель. Но как на самом деле обучают модель монокулярной оценки глубины?
Обучение начинается с подготовки изображений, чтобы сеть могла эффективно их обрабатывать. Входные изображения приводятся к единому размеру и нормализуются, а затем подаются в модель для построения карты глубины, предсказывающей расстояние для каждого пикселя.
Затем предсказанную карту глубины сравнивают с эталонными данными о глубине с помощью функции потерь, которая измеряет, насколько предсказание модели отличается от истинного значения глубины. Значение потерь отражает текущую ошибку модели и даёт сигнал для её улучшения.
Оптимизатор использует этот сигнал для обновления модели, корректируя её внутренние веса. Для этого оптимизатор вычисляет градиент, который показывает, как меняются потери в зависимости от каждого параметра модели, и многократно применяет эти обновления в течение нескольких эпох — полных проходов по обучающему набору данных.
Этот итеративный процесс обучения с учителем регулируется гиперпараметрами, такими как скорость обучения, определяющая размер каждого шага обновления, и размер пакета, задающий количество изображений, обрабатываемых за раз. Поскольку обучение включает множество математических операций, его обычно ускоряют с помощью графического процессора (GPU), который хорошо справляется с параллельными вычислениями.
После завершения обучения модель оценивают на валидационном наборе с помощью стандартных метрик. Этот набор состоит из изображений, которые не использовались при обучении. Такая оценка помогает определить, насколько хорошо модель обобщает знания на новые данные.
Затем обученную модель можно повторно использовать или дообучить для новых сценариев. В целом этот процесс обучения позволяет моделям монокулярной оценки глубины получать стабильные оценки глубины, необходимые для последующих задач, таких как трёхмерная реконструкция и внедрение в реальных условиях.
Обзор передовых моделей и тенденций исследований#
Качество монокулярной оценки глубины быстро улучшалось по мере того, как модели учились понимать сцену целиком, а не только отдельные мелкие детали. Ранние подходы часто строили неоднородные карты глубины, особенно в сложных условиях.
Более новые модели, представленные в недавних исследованиях на arXiv, уделяют больше внимания глобальному контексту, благодаря чему прогнозы глубины выглядят стабильнее и реалистичнее. Известные модели, такие как MiDaS и DPT, помогли закрепить эту тенденцию: они обучались оценивать глубину по разнообразным наборам данных высокого разрешения и хорошо обобщают результаты для множества сцен.
Более новые модели, включая ZoeDepth и Depth Anything V2, развивают эти идеи: они повышают согласованность масштаба и сохраняют высокую производительность в самых разных условиях. Этот прогресс часто оценивают на стандартных наборах данных, таких как KITTI и NYU Depth V2, охватывающих как уличные, так и внутренние сцены.
Еще одна явная тенденция — поиск баланса между точностью и практичностью. Небольшие модели оптимизированы для скорости и могут работать в реальном времени на периферийных или мобильных устройствах, тогда как более крупные модели рассчитаны на высокое разрешение и точную оценку глубины на больших расстояниях. Например, модели Ultralytics YOLO26 для оценки глубины варьируются от легковесной YOLO26n-depth для периферийных устройств реального времени до более крупной и точной YOLO26x-depth.
Применение монокулярной оценки глубины#
Теперь рассмотрим несколько примеров из реальной жизни, которые показывают, как монокулярная оценка глубины помогает анализировать трёхмерную структуру сцены по одному изображению.
Во всех этих случаях важно помнить, что информация о глубине — это оценка, полученная по визуальным признакам, а не точное измерение. Поэтому монокулярная оценка глубины полезна для понимания относительного расположения объектов и пространственных взаимосвязей, но не заменяет датчики, предназначенные для точного измерения расстояния, например LiDAR или стереосистемы.
Картографирование местности и навигация с помощью дронов#
Дроны часто работают там, где сигналы GPS ненадёжны: в лесах, на строительных площадках, в зонах бедствий или густонаселённых городских районах. Чтобы безопасно летать в таких условиях, они должны понимать окружающий рельеф и определять расстояние до препятствий. Раньше для этого обычно приходилось устанавливать дополнительные датчики, например LiDAR или стереокамеры, которые увеличивают вес, энергопотребление и общую стоимость.
Монокулярная оценка глубины — более простой вариант. Используя всего одну RGB-камеру, дроны могут оценивать глубину по изображениям и составлять базовое трёхмерное представление об окружении. Это позволяет им обнаруживать препятствия, например здания и деревья, а также резкие перепады рельефа и в реальном времени корректировать траекторию полёта.
Такие оценки глубины помогают решать ключевые навигационные задачи, включая обход препятствий, контроль высоты и безопасную посадку. Благодаря этому лёгкие дроны могут выполнять картографирование, инспекцию и навигацию без специализированных датчиков глубины.
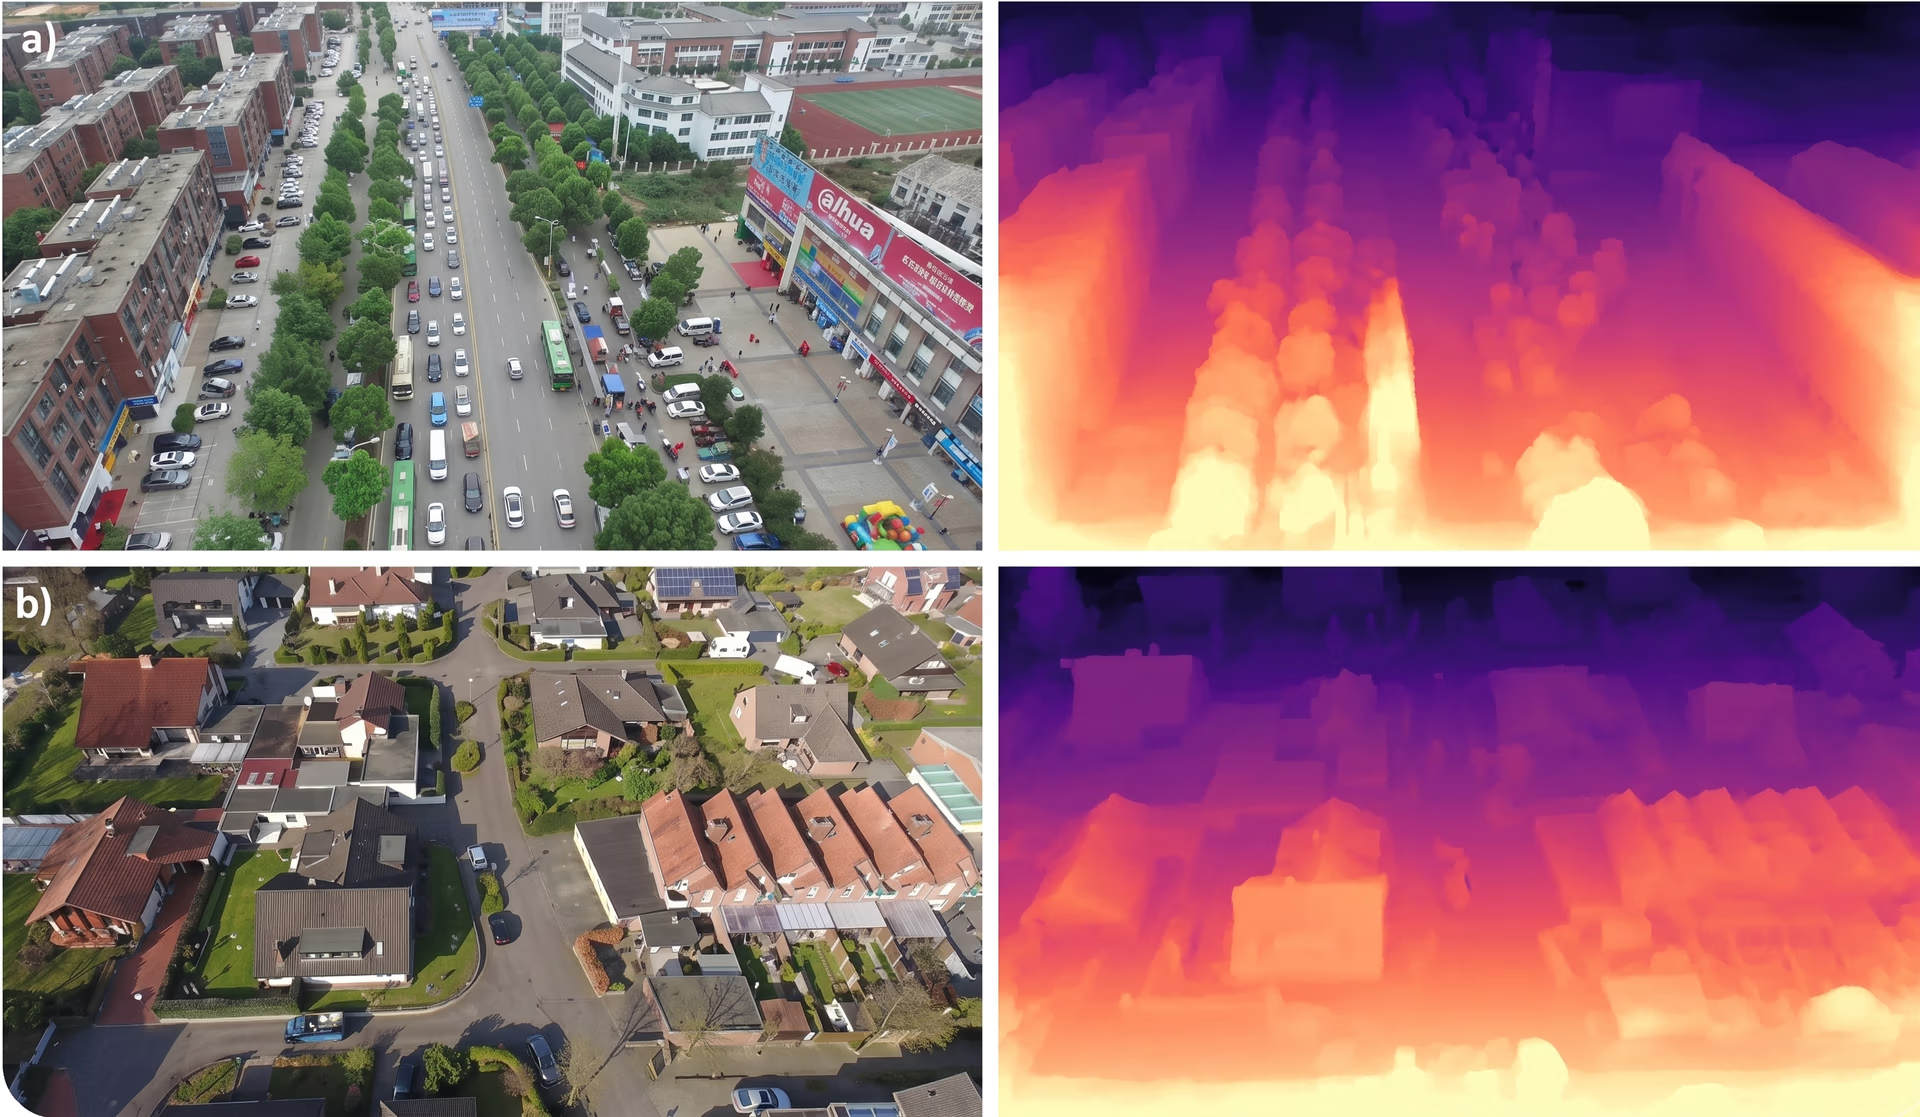
Рис. 2. Монокулярную оценку глубины можно использовать для анализа изображений с дрона (Источник)
Устранение слепых зон беспилотных гоночных автомобилей#
Беспилотные автомобили обычно во многом полагаются на датчики LiDAR, использующие лазерные импульсы для измерения расстояния и построения трёхмерного изображения дороги. Несмотря на высокую точность, LiDAR может плохо справляться с резкими перегибами дороги, крутыми склонами, перекрытиями обзора или внезапным наклоном автомобиля, из-за чего данные о глубине иногда оказываются разреженными или отсутствуют.
Оценка глубины по одному изображению помогает восполнить эти пробелы, предоставляя плотную информацию о глубине даже при неполных данных LiDAR. Представь ситуацию: беспилотный автомобиль на скорости приближается к вершине холма. Лазерные лучи LiDAR могут проходить дальше дороги за вершиной, оставляя неясным, что находится впереди.
Однако оценка глубины по изображению с камеры всё ещё позволяет определить форму дороги по визуальным признакам, например перспективе и текстуре. Это помогает автомобилю сохранять надёжное восприятие, пока данные LiDAR не стабилизируются. Совместное использование LiDAR и оценки глубины по одному изображению обеспечивает более стабильное восприятие и безопасное управление в сложных дорожных условиях.
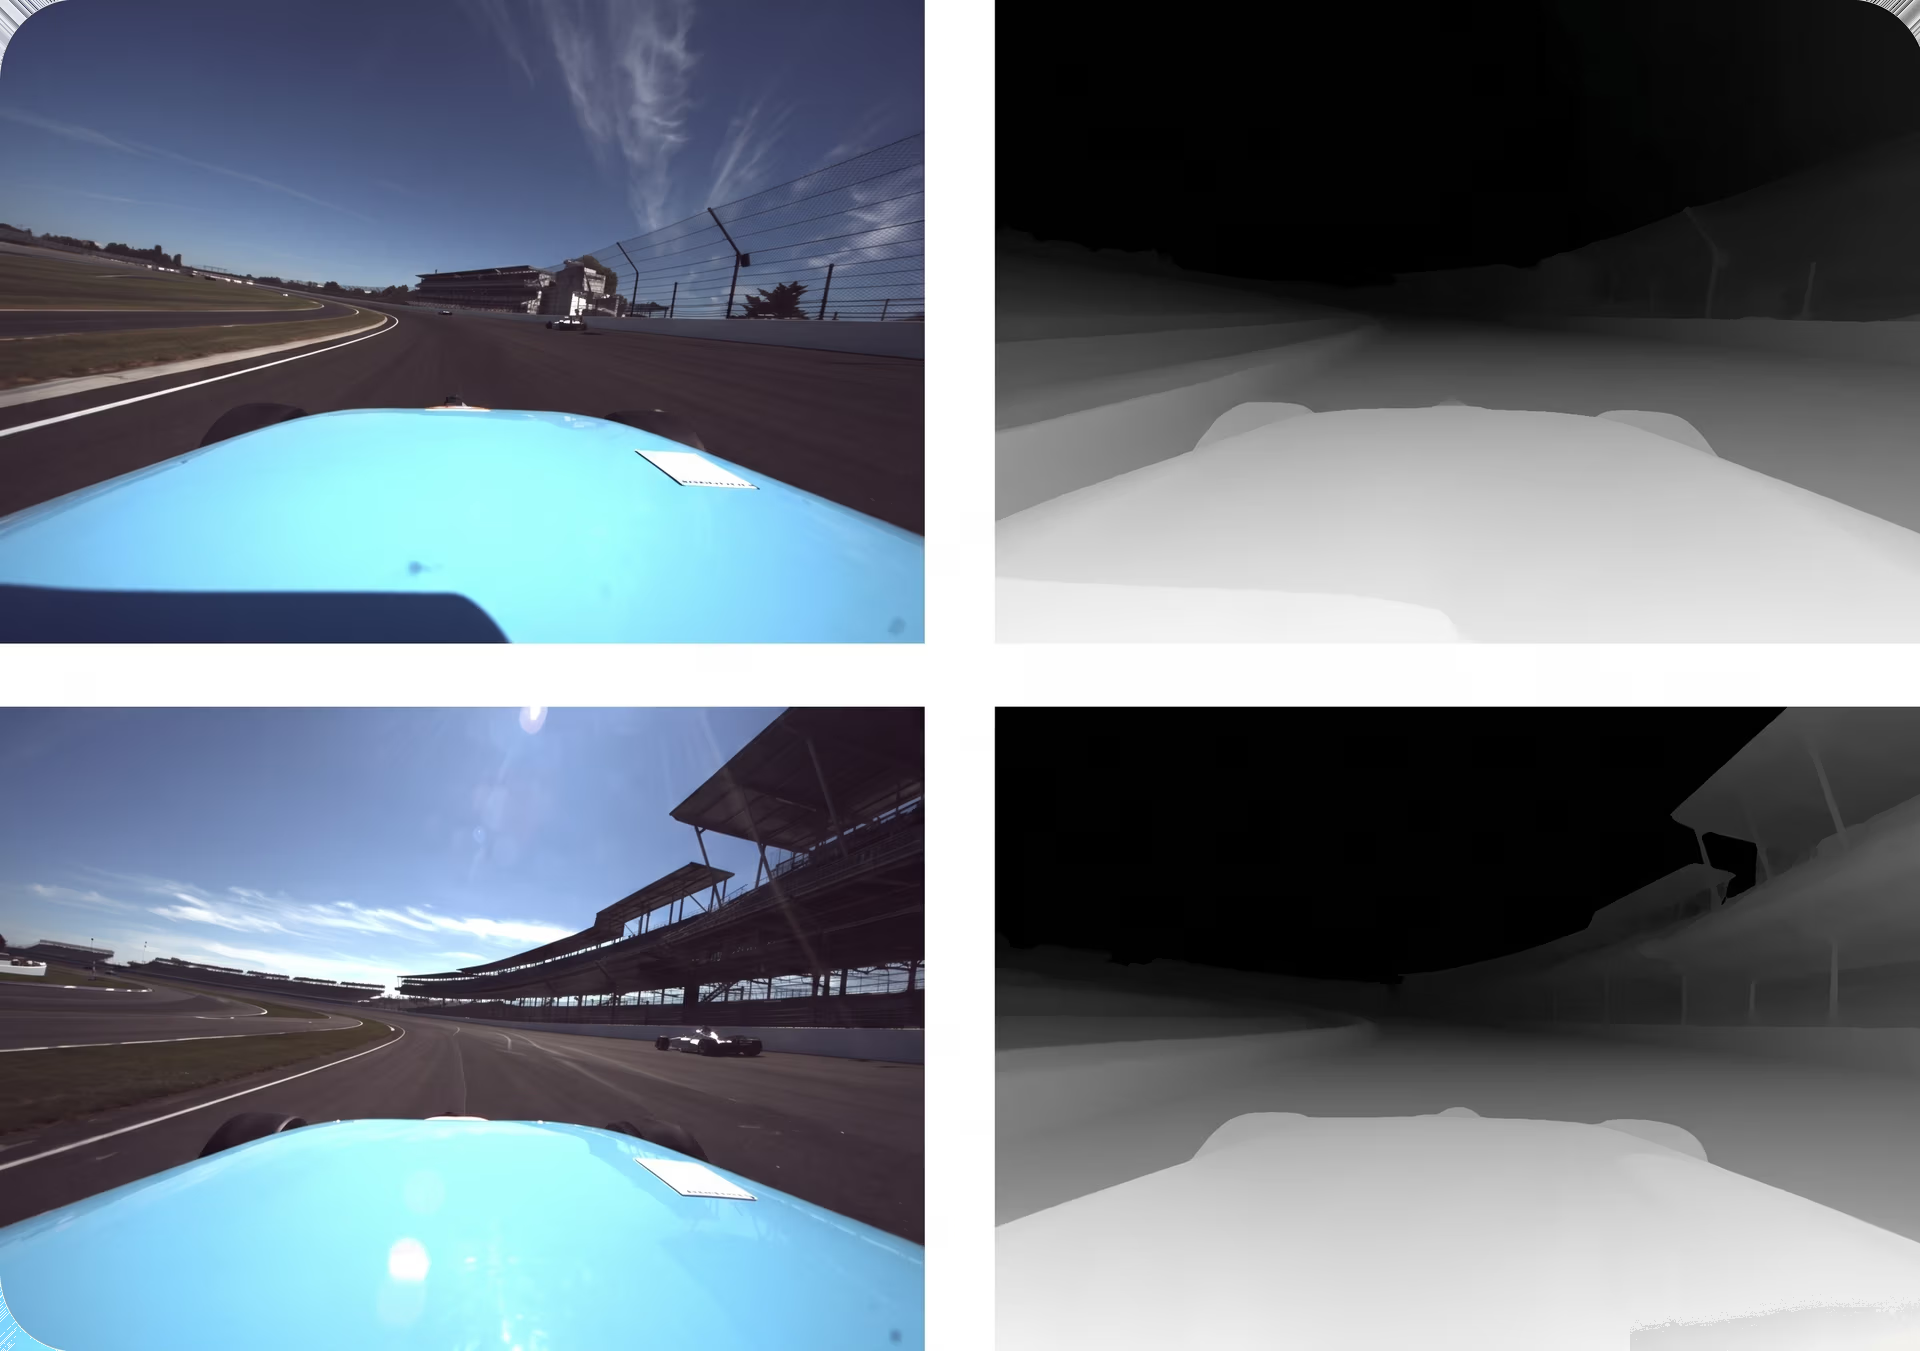
Рис. 3. Визуализация оценки глубины по одному изображению для автономных гонок (Источник)
Навигация роботов и объезд препятствий#
Роботы часто работают там, где нет подробных карт, а условия постоянно меняются. Чтобы безопасно передвигаться, им нужно надёжно определять, сколько вокруг свободного пространства и где находятся препятствия.
Оценка глубины по одному изображению обеспечивает такое пространственное восприятие с помощью одной RGB-камеры, без тяжёлого или дорогого оборудования. Обучаясь распознавать визуальные признаки, например масштаб и перспективу, модели оценки глубины могут строить плотные карты глубины окружения. Благодаря этому роботы чётко видят расстояние до поверхностей и объектов.
В частности, когда данные о глубине сочетаются с задачами компьютерного зрения, такими как обнаружение объектов и семантическая сегментация, роботы могут лучше понимать окружающую среду. Они способны распознавать объекты, оценивать расстояние до них и определять безопасное направление движения. Это помогает обходить препятствия, обнаруживать свободное пространство и планировать маршруты в реальном времени.
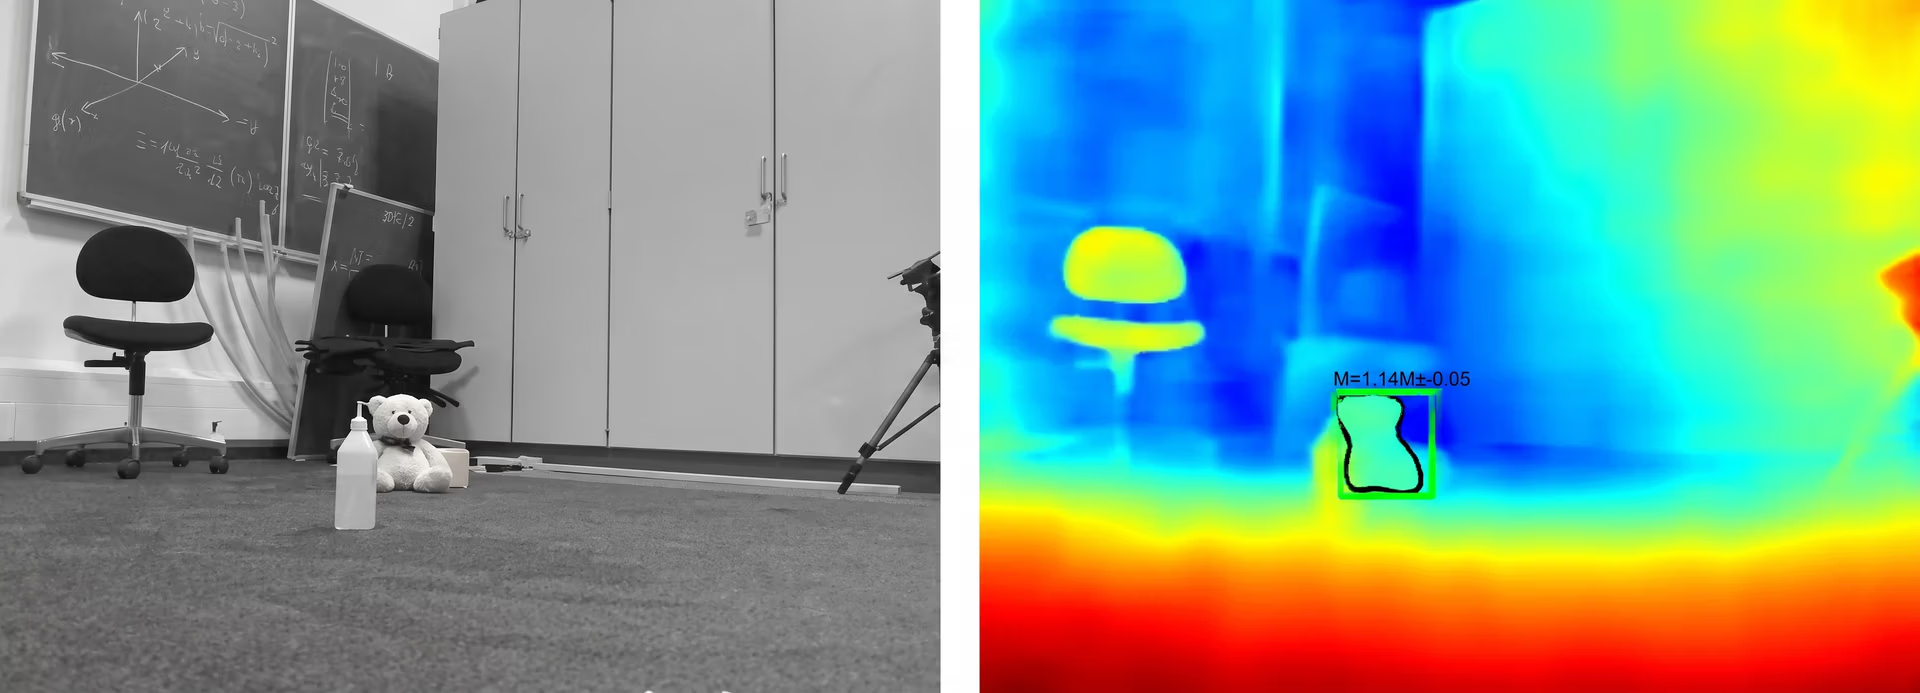
Рис. 4. Обнаружение объектов с помощью оценки глубины по одному изображению и обнаружения объектов (Источник)
Преимущества и недостатки оценки глубины по одному изображению#
Вот основные преимущества оценки глубины по одному изображению:
- Компактность и энергоэффективность: Одна камера снижает вес системы и энергопотребление. Это особенно важно для мобильных роботов, дронов и встраиваемых систем.
- Удобство объединения данных с другими датчиками: Оценка глубины по одному изображению дополняет другие датчики, например LiDAR или радар, восполняя пробелы в данных или обеспечивая резервирование.
- Работа в самых разных условиях: Один и тот же подход с камерой можно использовать в помещении, на улице и на разных платформах без замены оборудования.
Несмотря на очевидные преимущества оценки глубины по одному изображению, стоит учитывать и её ограничения:
- Точность ниже, чем у активных датчиков: Хотя точность быстро растёт, в контролируемых условиях оценка глубины по одному изображению обычно уступает по абсолютной точности LiDAR и датчикам со структурированным светом.
- Чувствительность к освещению: Производительность может снижаться при слабом освещении, резких тенях, бликах или недостаточной текстуре сцены.
- Трудности с обобщением: Без адаптации или дообучения модель, обученная в одной среде, не всегда надёжно работает в незнакомых предметных областях.
Когда не стоит полагаться на оценку глубины по одному изображению#
Оценка глубины по одному изображению — интересное направление исследований, но важно понимать, где её можно применять на практике, а где нельзя. Рассчитанные расстояния — это оценки, основанные на изображении, которое видит модель, а не точные измерения реального мира.
Поэтому качество результатов может меняться в зависимости от освещения, сложности сцены и её сходства с данными, на которых обучалась модель. Оценка глубины по одному изображению обычно хорошо показывает, что находится ближе, а что дальше, но ненадёжна, когда нужны точные расстояния.
В ситуациях, где точность действительно важна, например в критически важных для безопасности системах, при промышленном контроле или при взаимодействии роботов с объектами с высокой точностью, глубину нужно измерять напрямую. Для этого предназначены такие датчики, как LiDAR, радар, стереокамеры и системы со структурированным светом; они предоставляют гораздо более надёжные данные о расстоянии.
Оценка глубины по одному изображению также может давать сбои в сложных визуальных условиях. Плохое освещение, резкие тени, отражающие или прозрачные поверхности, туман, дым и сцены с очень низкой текстурной детализацией могут снизить надёжность оценки глубины. Ещё один случай, когда специализированные датчики обычно работают лучше, — оценка глубины на больших расстояниях.
В решениях для реального мира оценка глубины по одному изображению лучше всего работает как вспомогательный инструмент, а не как самостоятельное решение. Она может добавить полезный пространственный контекст, восполнить пробелы при ограниченных возможностях других датчиков и улучшить общее понимание сцены. Однако не стоит использовать её как единственный источник информации о глубине, если важны точность, безопасность или строгие требования к надёжности.
Главные выводы#
Оценка глубины по одному изображению — это метод компьютерного зрения, с помощью которого машины определяют расстояние до объектов, используя только изображение с одной камеры. Обучаясь распознавать визуальные признаки, например перспективу, размер объектов, текстуру и затенение, эти модели ИИ могут выводить трёхмерную структуру сцены без датчиков вроде LiDAR и стереокамер. Благодаря этому оценка глубины по одному изображению становится экономичным и масштабируемым решением для автономного вождения, робототехники и понимания трёхмерных сцен.
Чтобы узнать больше о визуальном ИИ, загляни в наш репозиторий GitHub и присоединяйся к нашему сообществу. Посмотри страницы наших решений, чтобы узнать об ИИ в робототехнике и компьютерном зрении в производстве. Изучи варианты лицензирования, чтобы уже сегодня начать работу с компьютерным зрением!
Автор
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









