Самообучение без учителя для шумоподавления: пошаговый разбор
Узнай, как работает самообучение без учителя для шумоподавления, почему на изображениях появляется шум и какие методы и этапы помогают восстановить чёткие детали.
 Abirami Vina12 мин. чтения
Камеры не всегда передают мир таким, каким мы его видим. Портрет, снятый при слабом освещении, или фотография быстро движущегося автомобиля могут получиться зернистыми, размытыми или искажёнными.
Медленные датчики, темнота и движение могут создавать мелкие шумовые точки, смягчая контуры и скрывая важные детали. Когда чёткость изображения теряется, даже продвинутые системы ИИ и машинного обучения могут испытывать трудности с пониманием его содержимого, поскольку многие интеллектуальные системы зависят от этих мелких деталей.
Например, компьютерное зрение — это область искусственного интеллекта, которая позволяет машинам интерпретировать изображения и видео. Чтобы делать это точно, моделям ИИ для компьютерного зрения нужны чистые визуальные данные высокого качества для обучения.
В частности, такие модели, как Ultralytics YOLO11 и Ultralytics YOLO26 (выпущенная в январе 2026 года), поддерживают такие задачи, как обнаружение объектов, сегментация экземпляров и оценка позы, и могут дообучаться для различных сценариев применения. Эти задачи используют чёткие визуальные признаки, например края, текстуры, цвета и мелкие структурные детали.
Когда шум скрывает эти признаки, модель получает менее информативные обучающие сигналы, и ей становится сложнее усваивать точные закономерности. Поэтому даже небольшое количество шума может снизить качество работы модели в реальных приложениях.
Ранее мы рассмотрели, как самообучение без учителя помогает устранять шум на изображениях. В этой статье мы подробнее разберём, как работают методы шумоподавления с самообучением и как они помогают восстановить значимую визуальную информацию.
Распространённые типы шума на реальных изображениях#
Прежде чем разбирать, как самообучение без учителя применяется для шумоподавления изображений, давай сначала вспомним, почему на изображениях вообще появляется шум.
Изображения реальных объектов и сцен редко бывают идеальными. Недостаточное освещение, низкое качество датчика и быстрое движение могут создавать случайные помехи в отдельных пикселях изображения. Эти помехи на уровне пикселей, называемые шумом, снижают общую чёткость и затрудняют распознавание важных деталей.
Когда шум скрывает контуры, текстуры и малозаметные закономерности, системам компьютерного зрения становится труднее точно распознавать объекты и интерпретировать сцены. Разные условия создают разные типы шума, каждый из которых по-своему влияет на изображение.
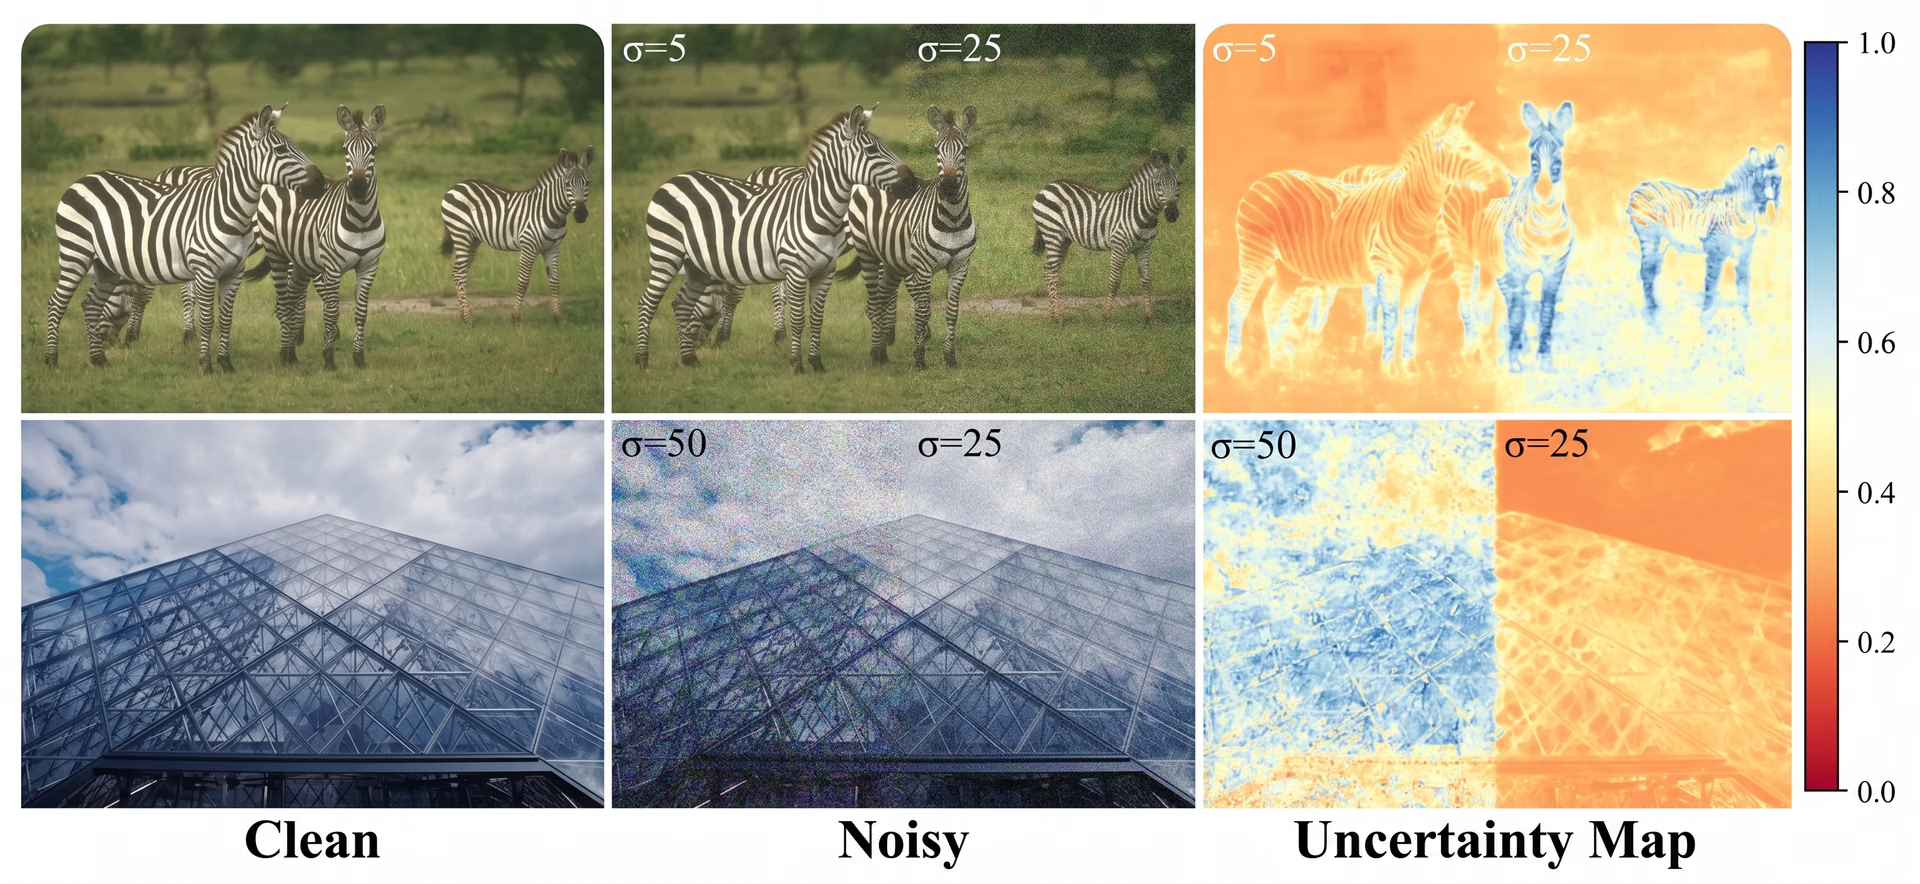
Рис. 1. Пример того, как шум может повысить неопределённость изображения. (Источник)
Вот несколько наиболее распространённых типов шума на изображениях:
- Гауссов шум: Этот тип шума выглядит как мягкое случайное зерно, возникающее из-за помех в электронном датчике или колебаний температуры. Он подчиняется гауссовскому (нормальному) распределению: небольшие отклонения значений пикселей размывают мелкие детали и снижают общую резкость.
- Пуассоновский шум: Этот тип шума, также называемый фотонным, возникает при слабом освещении или короткой выдержке. Его дисперсия увеличивается с яркостью, однако чаще он заметен в тёмных областях, поскольку там улавливается меньше фотонов и отношение сигнал/шум ниже.
- Импульсный шум: Этот тип шума выглядит как резкие чёрные или белые всплески отдельных пикселей. Обычно он возникает из-за ошибок передачи данных, повреждения битов или неисправности датчиков камеры и часто приводит к отсутствующим или искажённым значениям пикселей.
- Спекл-шум: Этот тип шума проявляется в виде зернистых пятнистых узоров и часто встречается на медицинских, радиолокационных и ультразвуковых изображениях. Он возникает из-за помех и рассеяния сигнала, снижает контрастность и затрудняет обнаружение контуров.
Когда стоит использовать шумоподавление на основе самообучения?#
В чём особенность шумоподавления на основе самообучения? Оно особенно эффективно в ситуациях, когда чистых эталонных изображений просто нет или их слишком сложно получить.
Такое часто случается при съёмке при слабом освещении, получении изображений с высоким ISO, медицинской и научной визуализации или в любых условиях, где шум неизбежен, а получение идеальных эталонных данных нереалистично. Вместо чистых примеров модель обучается непосредственно на имеющихся шумных изображениях и адаптируется к характерным для твоей камеры или датчика типам шума.
Шумоподавление на основе самообучения также отлично подходит, если ты хочешь повысить качество последующих задач компьютерного зрения, но в наборе данных много неоднородных или зашумлённых изображений. Восстанавливая более чёткие контуры, текстуры и структуры, такие методы помогают моделям вроде YOLO надёжнее обнаруживать объекты, сегментировать изображения и интерпретировать сцены. Иными словами, если ты работаешь с зашумлёнными данными и у тебя нет чистых обучающих изображений, шумоподавление на основе самообучения часто оказывается самым практичным и эффективным решением.
Основные методы шумоподавления на основе самообучения#
Как мы уже отмечали, шумоподавление с самообучением — это подход в ИИ на основе глубокого обучения, который позволяет моделям учиться непосредственно на зашумлённых изображениях без чистых размеченных данных. Он опирается на принципы самообучения без учителя, при котором модели сами создают сигналы для обучения на основе данных.
Иными словами, модель может обучаться самостоятельно, используя зашумлённые изображения и как входные данные, и как источник обучающего сигнала. Сравнивая разные искажённые версии одного изображения или предсказывая замаскированные пиксели, модель учится распознавать, какие закономерности отражают реальные структуры, а какие являются лишь шумом. Благодаря итеративной оптимизации и распознаванию закономерностей сеть постепенно лучше отличает значимое содержимое изображения от случайных искажений.
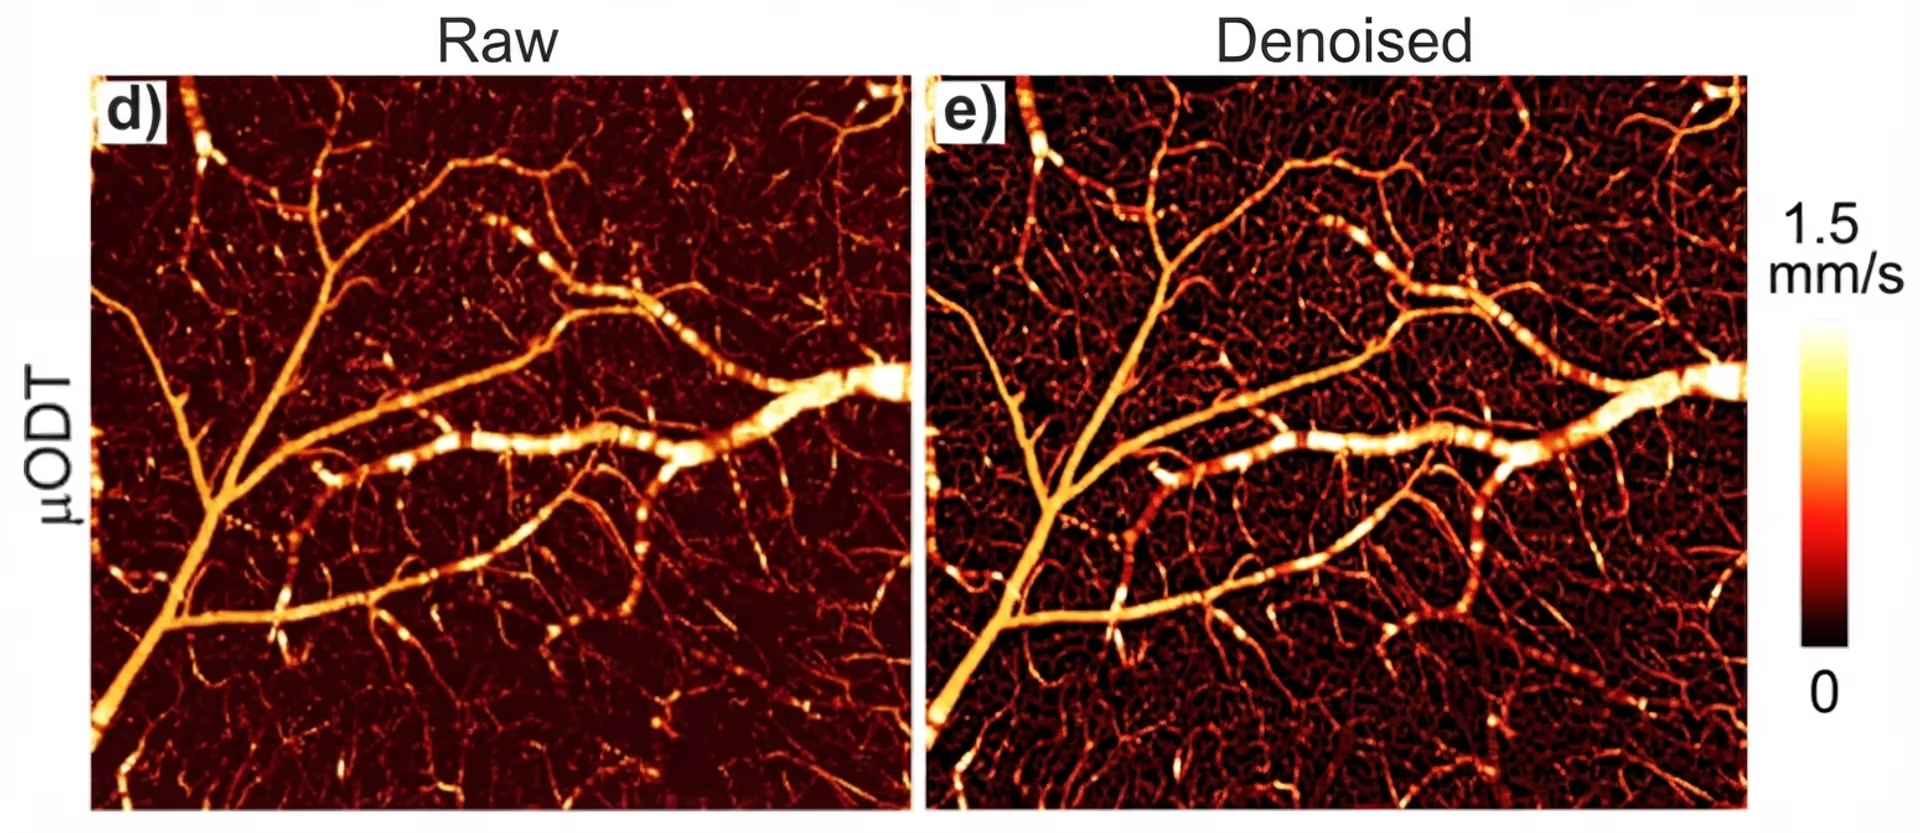
Рис. 2. Исходное изображение и изображение после шумоподавления. (Источник)
Это стало возможным благодаря специальным стратегиям обучения, которые помогают модели отделять устойчивые структуры изображения от случайного шума. Теперь подробнее рассмотрим основные методы и алгоритмы, упрощающие этот процесс, и то, как каждый из подходов помогает моделям восстанавливать более чистые и достоверные изображения.
Попарные методы шумоподавления изображений#
Во многих ранних методах самообучения без учителя для шумоподавления сравнивались две зашумлённые версии одного изображения. Поскольку шум меняется случайным образом при каждом захвате или искажении изображения, а реальная структура остаётся неизменной, эти различия можно использовать как обучающий сигнал для модели.
Такие подходы обычно называют попарными методами шумоподавления изображений, поскольку во время обучения они используют или создают пары зашумлённых изображений. Например, подход Noise2Noise, предложенный Яакко Лехтиненом и его командой, обучает модель на двух независимо зашумлённых изображениях одной сцены. Поскольку на этих версиях шум проявляется по-разному, модель учится выявлять неизменные детали, отражающие исходное изображение.
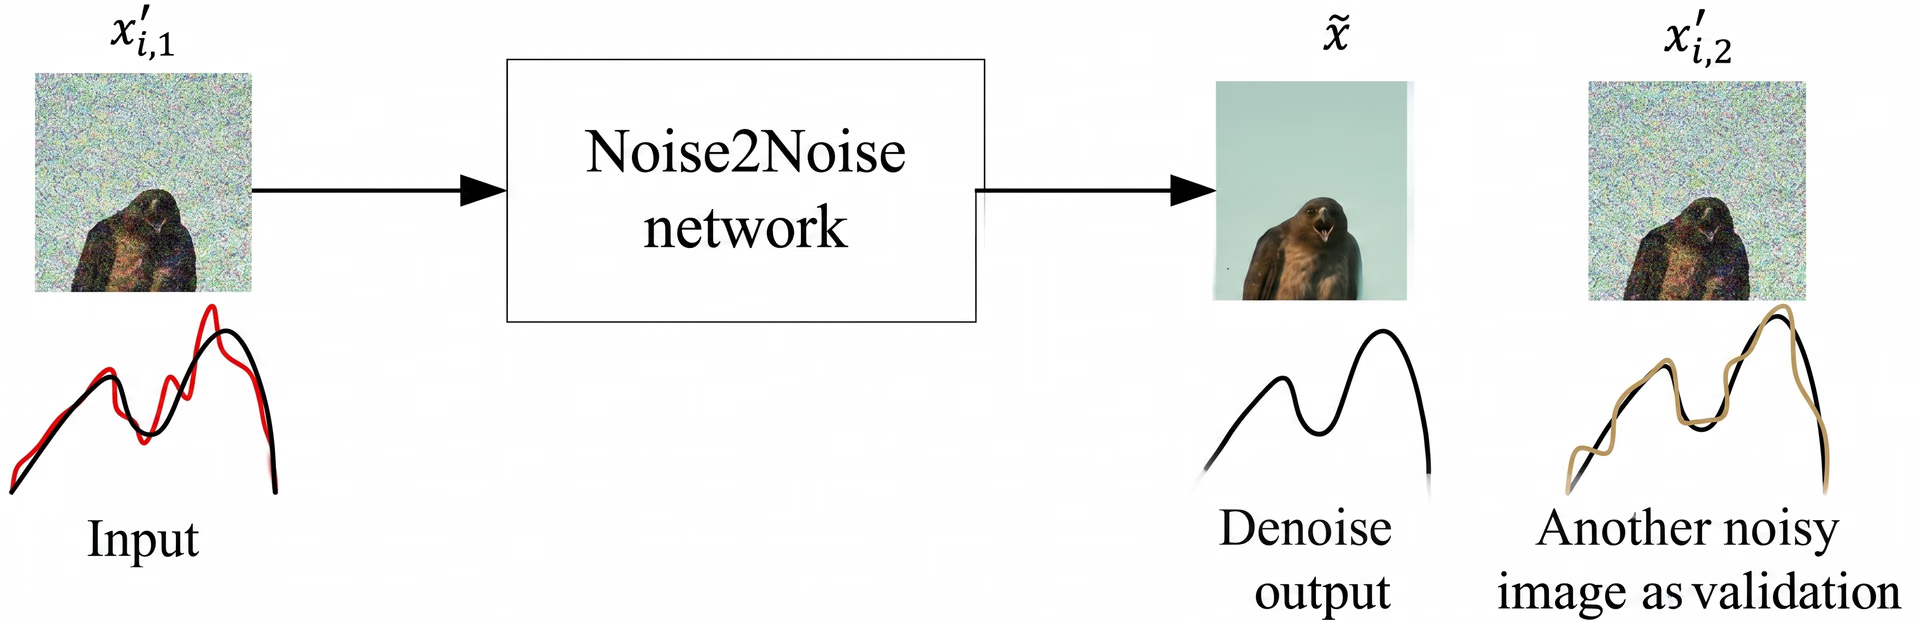
Рис. 3. Как работает Noise2Noise (Источник)
Со временем сеть учится подавлять случайный шум и сохранять реальные структуры, хотя ни разу не видит чистого эталонного изображения. Представь простой пример: ты фотографируешь одну и ту же тёмную улицу ночью дважды.
На обоих снимках видны одни и те же здания, источники света и тени, но зернистый шум появляется в разных местах. Сравнивая два зашумлённых снимка во время обучения, модель, обучающаяся без учителя, может определить, какие визуальные закономерности устойчивы, а какие вызваны шумом, и в итоге лучше восстанавливать чистые изображения.
Методы самообучения без учителя с «слепыми зонами» для шумоподавления#
Если попарные методы сравнивают две по-разному искажённые версии одного изображения, то методы со «слепыми зонами» работают иначе. Они позволяют модели обучаться на одном зашумлённом изображении, скрывая выбранные пиксели, чтобы сеть не видела их искажённые значения.
Затем модель должна предсказать скрытые пиксели, используя только окружающий контекст. Основная идея заключается в том, что шум случаен, а лежащая в основе изображения структура — нет.
Не давая модели копировать зашумлённое значение пикселя, методы со «слепыми зонами» побуждают её предсказывать его по устойчивым закономерностям изображения, таким как соседние контуры, текстуры или цветовые градиенты. Методы Noise2Void, предложенный Александром Круллом и его командой, и Noise2Self, разработанный Джошуа Бэтсоном и Лоиком Ройером, реализуют этот принцип, маскируя отдельные пиксели или небольшие области и обучая модель их восстанавливать.
Более продвинутые подходы, включая Noise2Same и PN2V, повышают устойчивость, обеспечивая согласованность предсказаний для нескольких версий с разными масками или явно моделируя распределение шума для оценки неопределённости. Поскольку этим методам достаточно одного зашумлённого изображения, они особенно полезны в областях, где получение чистых или парных изображений непрактично либо невозможно, например в микроскопии, астрономии, биомедицинской визуализации и при съёмке при слабом освещении.
Методы шумоподавления на основе Transformer#
В большинстве парных методов шумоподавления с самообучением и методов с маскированием отдельных областей изображения используются свёрточные нейронные сети (CNNs) или сети для шумоподавления. CNNs отлично подходят для таких подходов, поскольку фокусируются на локальных закономерностях: краях, текстурах и мелких деталях.
Архитектуры вроде U-Net широко применяются, поскольку объединяют детализированные признаки с информацией разных масштабов. Однако CNNs в основном работают в пределах ограниченных окрестностей, поэтому могут упускать важные взаимосвязи между удалёнными областями изображения.
Передовые методы шумоподавления на основе Transformer появились, чтобы устранить это ограничение. Вместо анализа только соседних пикселей в этих методах используются механизмы внимания, которые определяют взаимосвязи между разными частями изображения.
Одни модели используют полное глобальное внимание, другие — оконное или иерархическое, чтобы снизить вычислительные затраты. В целом такие модели способны улавливать дальние структурные связи, недоступные одним лишь CNNs. Более широкий контекст помогает модели восстанавливать повторяющиеся текстуры, гладкие поверхности или крупные объекты, для которых нужна информация со всего изображения.
Другие методы шумоподавления изображений#
Помимо методов самообучения без учителя, есть и другие способы очистить изображения от шума. Традиционные методы, такие как двусторонняя фильтрация, вейвлет-шумоподавление и нелокальное усреднение, используют простые математические правила для сглаживания шума с попыткой сохранить важные детали.
Существуют и методы глубокого обучения, в том числе модели с учителем, обучающиеся на парах чистых и зашумлённых изображений, а также генеративно-состязательные сети (GANs), создающие более чёткие и реалистичные результаты. Однако для обучения таким методам обычно нужны изображения более высокого качества.
Пошаговый разбор работы самообучения без учителя для шумоподавления изображений#
Мы только что рассмотрели несколько разных методов, и ты можешь задуматься, работает ли каждый из них совершенно иначе из-за собственной архитектуры. Однако все они следуют схожему конвейеру: от подготовки данных до оценки модели.
Теперь давай пошагово рассмотрим, как устроен общий процесс шумоподавления изображений с самообучением.
Шаг 1. Предварительная обработка и нормализация#
Прежде чем модель начнёт обучаться на зашумлённых изображениях, нужно привести все изображения к единообразному виду. Реальные фотографии могут сильно различаться.
Одни изображения могут быть слишком яркими, другие — слишком тёмными, а на некоторых цвета могут быть немного искажены. Если напрямую подать такие изображения модели, ей будет сложнее сосредоточиться на изучении того, как выглядит шум.
Для этого каждое изображение проходит нормализацию и предварительную обработку. Они могут включать приведение значений пикселей к стандартному диапазону, коррекцию изменений интенсивности, кадрирование и изменение размера. Важно, чтобы модель получала единообразные данные, которые можно использовать как стабильные и сопоставимые входные данные.
Шаг 2. Создание обучающего сигнала для самообучения#
После нормализации изображений нужно создать обучающий сигнал, который позволит модели учиться, ни разу не видя чистого изображения. Методы шумоподавления на основе самообучения делают это, не позволяя модели просто копировать полученные зашумлённые значения пикселей.
Вместо этого они создают условия, в которых модель должна опираться на окружающий контекст изображения, содержащий устойчивые структуры, а не на непредсказуемый шум. Разные методы делают это немного по-разному, но основная идея у них одна.
В одних подходах определённые пиксели временно скрываются или маскируются, чтобы модель предсказала их значения по соседним пикселям. В других создаётся отдельная искажённая версия того же зашумлённого изображения, поэтому входные и целевые данные содержат независимый шум. В обоих случаях целевое изображение содержит значимую структурную информацию, но не позволяет сети получить исходное зашумлённое значение пикселя, который ей нужно предсказать.
Поскольку шум меняется случайным образом, а исходное изображение остаётся неизменным, в таких условиях модель естественным образом учится распознавать настоящую структуру и игнорировать шум, различающийся в разных версиях.
Шаг 3. Обучение шумоподавлению для восстановления структуры изображения#
Когда обучающий сигнал готов, модель может начать учиться отделять значимую структуру изображения от шума. Каждый раз, когда она предсказывает значение замаскированного или повторно искажённого пикселя, ей приходится опираться на окружающий контекст, а не на шумное значение, которое изначально занимало это место.
За множество итераций или эпох сеть учится распознавать закономерности, которые остаются устойчивыми на изображении, например контуры, текстуры и гладкие поверхности. Она также учится игнорировать случайные колебания, характерные для шума.
Например, представь фотографию, снятую при слабом освещении, на которой поверхность выглядит очень зернистой. Хотя шум меняется от пикселя к пикселю, сама поверхность остаётся гладкой. Многократно предсказывая скрытые пиксели в таких областях, модель постепенно учится лучше распознавать устойчивую закономерность, скрытую под шумом, и чище её восстанавливать.
В процессе обучения сеть формирует внутреннее представление о структуре изображения. Благодаря этому модель может восстанавливать связные детали, даже если входное изображение сильно искажено.
Шаг 4. Проверка и оценка результатов шумоподавления#
После того как модель научится предсказывать скрытые или повторно искажённые пиксели, нужно оценить, насколько хорошо она работает с целыми изображениями. Во время тестирования модель получает полностью зашумлённое изображение и на основе усвоенных знаний о структуре изображения создаёт его версию без шума. Чтобы оценить эффективность процесса, полученный результат сравнивают с чистыми эталонными изображениями или стандартными тестовыми наборами данных.
Часто используют две метрики: PSNR (пиковое отношение сигнал/шум), измеряющую близость восстановленного изображения к чистому эталону, и SSIM (индекс структурного сходства), оценивающую сохранность важных признаков, таких как контуры и текстуры. Более высокие значения обычно указывают на более точное и визуально достоверное шумоподавление.
Наборы изображений для обучения и тестирования#
В исследованиях шумоподавления с самообучением, публикуемых в журналах IEEE, на конференциях CVF, таких как CVPR, ICCV и ECCV, и на arXiv, часто используются комбинации синтетических и реальных наборов данных. Это позволяет оценивать качество моделей глубокого обучения в контролируемых и практических условиях. С одной стороны, синтетические наборы данных создаются на основе чистых изображений с добавлением искусственного шума, что упрощает сравнение методов по таким метрикам, как PSNR и SSIM.
Вот несколько популярных наборов данных, которые часто используют с добавлением синтетического шума для сравнения результатов:
- Kodak24: Этот набор данных содержит высококачественные фотографии природных сцен, которые часто используют для визуального сравнения результатов шумоподавления.
- DIV2K: Этот набор данных высокого разрешения содержит разнообразные детализированные изображения, используемые для оценки точности передачи текстур и общего качества восстановления.
С другой стороны, наборы данных с реальным шумом содержат изображения, напрямую полученные с сенсоров камер при слабом освещении, высоком ISO или в других сложных условиях. Такие наборы данных проверяют, способен ли модель справляться со сложным негауссовским шумом, который трудно реалистично смоделировать.
Вот несколько популярных наборов данных с реальным шумом:
- SIDD: Этот набор данных содержит пары зашумлённых и чистых изображений, снятых сенсорами смартфонов в различных условиях освещения.
- DND: В него входят фотографии с высоким ISO, на которых запечатлены реалистичные шумовые паттерны сенсоров потребительских камер.
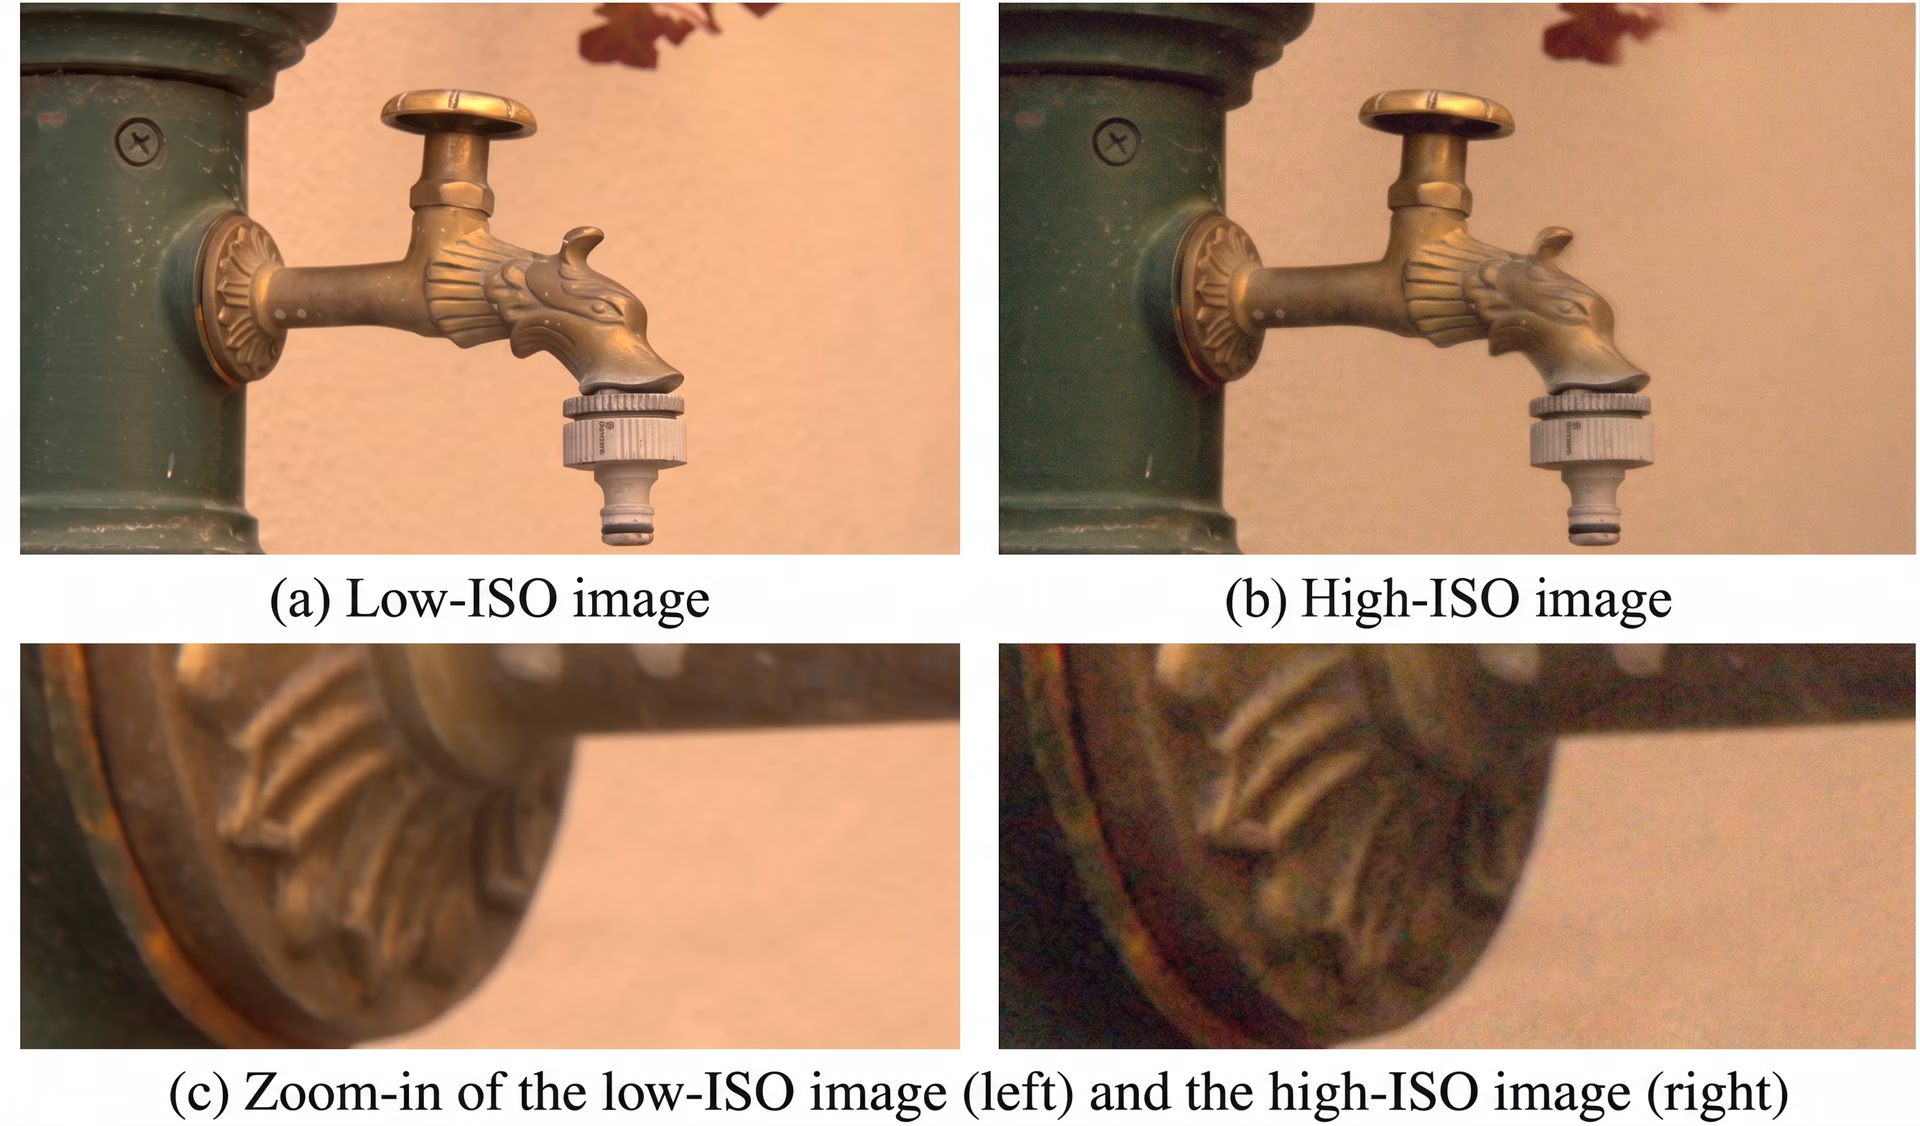
Рис. 4. Пример из набора данных DND. (Источник)
Факторы, которые следует учитывать при обучении модели шумоподавления с самоконтролем#
Вот некоторые факторы и ограничения, которые стоит учитывать, если ты собираешься обучать модель шумоподавления на основе глубокого обучения с самоконтролем:
- Соответствие распределения шума: Зашумлённые изображения для обучения должны отражать тот же шум, с которым модель столкнётся при реальном использовании; несоответствие шума приводит к плохой обобщающей способности.
- Разнообразие обучающих данных: Недостаток разнообразия может привести к переобучению или чрезмерному сглаживанию сложных текстур.
- Ограничения по типу шума: Методы с самоконтролем хуже справляются со структурированным, коррелированным или случайным шумом.
- Проверка на разных устройствах и сенсорах: Качество шумоподавления может сильно различаться в зависимости от камеры или системы формирования изображений.
Главные выводы#
Шумоподавление с самоконтролем даёт энтузиастам ИИ практичный способ очищать изображения, используя только уже имеющиеся зашумлённые данные. Научившись распознавать реальную структуру под шумом, такие методы помогают восстановить важные визуальные детали. По мере совершенствования технологий шумоподавления они, вероятно, сделают множество задач компьютерного зрения надёжнее в повседневных условиях.
Стань частью нашего растущего сообщества! Загляни в наш репозиторий на GitHub, чтобы узнать больше об ИИ. Если ты хочешь создавать решения для компьютерного зрения, ознакомься с нашими вариантами лицензирования. Узнай о преимуществах компьютерного зрения в розничной торговле и о том, как ИИ в производстве меняет отрасль!
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









