Что такое переобучение в компьютерном зрении и как его предотвратить?
Узнай, что такое переобучение в компьютерном зрении, как его выявить и предотвратить с помощью аугментации, регуляризации, ранней остановки и предварительно обученных моделей.
 Abdelrahman Elgendy8 мин. чтения
Модели компьютерного зрения предназначены для распознавания закономерностей, обнаружения объектов и анализа изображений. Однако их производительность зависит от того, насколько хорошо они обобщают данные, которых не было при обучении. Обобщение — это способность модели хорошо работать с новыми изображениями, а не только с теми, на которых она обучалась. Одна из распространённых проблем при обучении таких моделей — переобучение, при котором модель слишком сильно подстраивается под обучающие данные, включая ненужный шум, вместо того чтобы выявлять значимые закономерности.
В этом случае модель хорошо работает на обучающих данных, но плохо справляется с новыми изображениями. Например, модель обнаружения объектов, обученная только на изображениях высокого разрешения при хорошем освещении, может не справиться с размытыми или затенёнными изображениями в реальных условиях. Переобучение снижает адаптивность модели и ограничивает её применение в таких реальных задачах, как автономное вождение, медицинская визуализация и системы безопасности.
В этой статье мы расскажем, что такое переобучение, почему оно возникает и как его предотвратить. Также рассмотрим, как модели компьютерного зрения, такие как Ultralytics YOLO11, помогают уменьшить переобучение и улучшить обобщающую способность.
Что такое переобучение?#
Переобучение возникает, когда модель запоминает обучающие данные вместо того, чтобы усваивать закономерности, применимые к новым входным данным. Модель слишком сильно подстраивается под обучающие данные, поэтому ей трудно работать с новыми изображениями и ситуациями, с которыми она раньше не сталкивалась.
В компьютерном зрении переобучение может влиять на разные задачи. Модель классификации, обученная только на ярких и чётких изображениях, может плохо работать при слабом освещении. Модель обнаружения объектов, обученная на безупречных изображениях, может не справиться со сценами, где много объектов или беспорядка. Аналогично, модель сегментации экземпляров может хорошо работать в контролируемых условиях, но испытывать трудности с тенями и перекрывающимися объектами.
Это становится проблемой в реальных приложениях ИИ, где модели должны обобщать данные за пределами контролируемых условий обучения. Например, беспилотные автомобили должны обнаруживать пешеходов при разном освещении, погоде и в разных условиях. Модель, переобученная на обучающем наборе, не будет надёжно работать в таких непредсказуемых ситуациях.
Когда и почему возникает переобучение?#
Переобучение обычно возникает из-за несбалансированных наборов данных, чрезмерной сложности модели и слишком долгого обучения. Вот основные причины:
- Мало обучающих данных: на небольших наборах данных модели запоминают закономерности, а не учатся обобщать их. Модель, обученная всего на 50 изображениях птиц, может плохо распознавать виды птиц, не представленные в этом наборе.
- Слишком сложные модели с большим количеством параметров: глубокие сети с чрезмерным числом слоёв и нейронов склонны запоминать мелкие детали вместо того, чтобы сосредоточиться на важных признаках.
- Недостаток аугментации данных: без таких преобразований, как кадрирование, отражение и поворот, модель может обучиться только на исходных обучающих изображениях.
- Слишком долгое обучение: если модель многократно проходит обучающие данные — такие проходы называются эпохами, — она запоминает детали вместо усвоения общих закономерностей и хуже адаптируется.
- Несогласованные или зашумлённые метки: неверная разметка данных заставляет модель усваивать ошибочные закономерности. Это часто встречается в наборах данных, размеченных вручную.
Сбалансированный подход к сложности модели, качеству набора данных и методам обучения обеспечивает лучшее обобщение.
Переобучение и недообучение#
Переобучение и недообучение — две противоположные проблемы глубокого обучения.
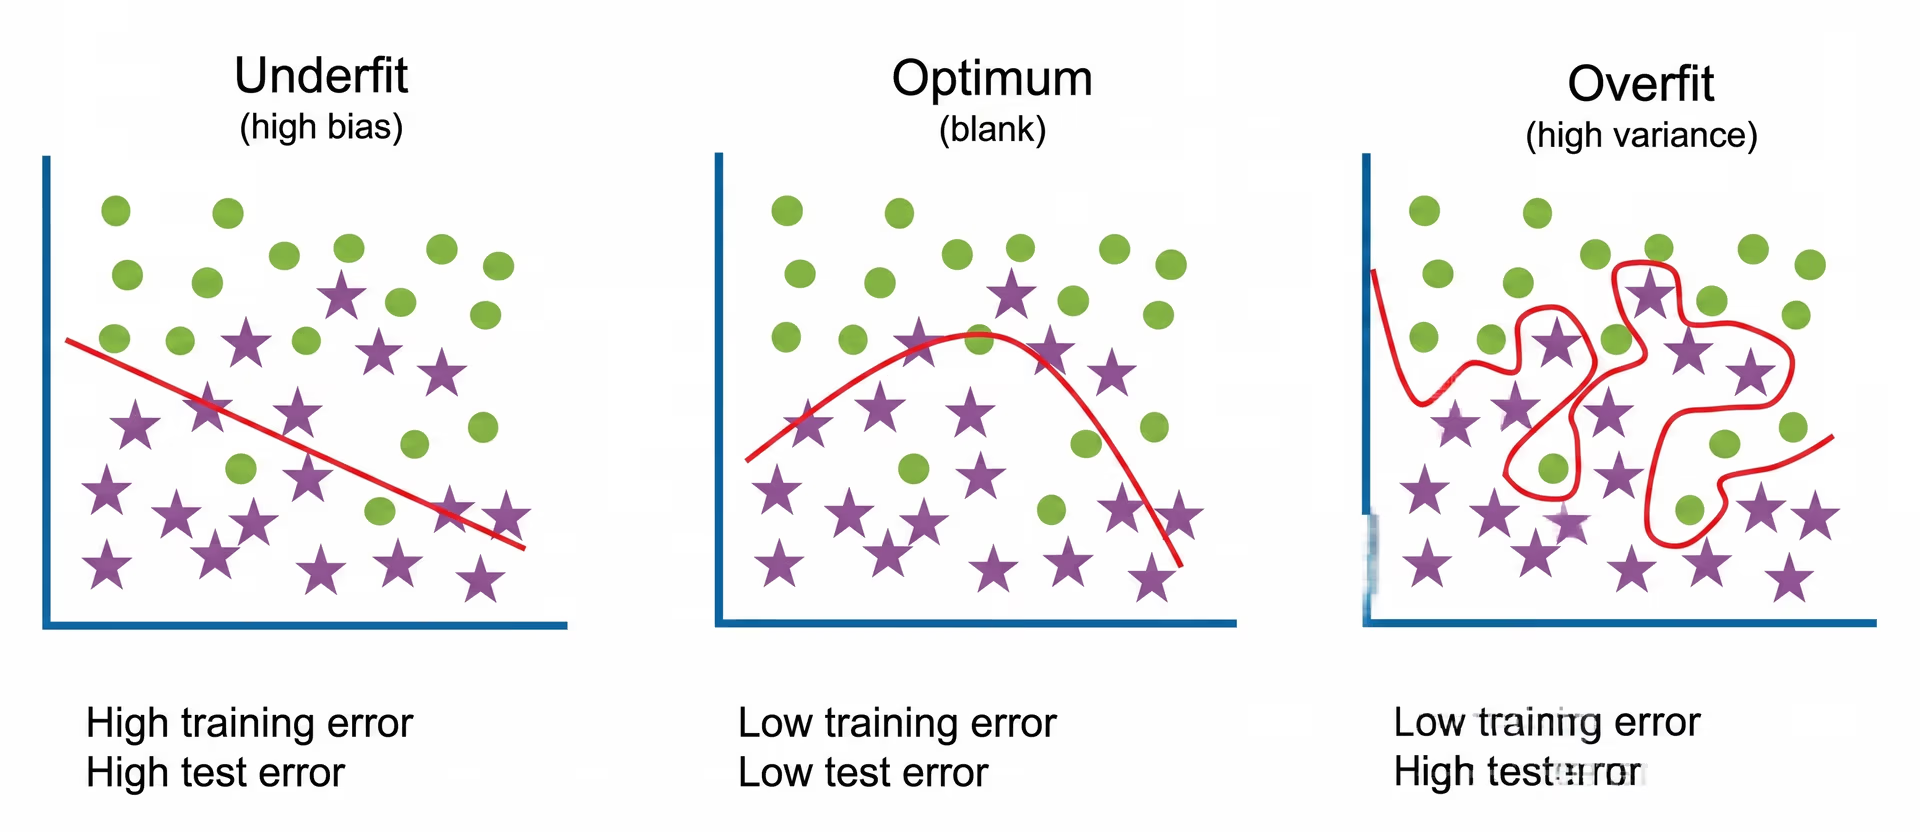
Рис. 1. Сравнение недообучения, оптимального обучения и переобучения моделей компьютерного зрения.
Переобучение возникает, когда модель слишком сложна и чрезмерно подстраивается под обучающие данные. Вместо усвоения общих закономерностей она запоминает мелкие детали, в том числе несущественные, например фоновый шум. Поэтому модель хорошо работает на обучающих данных, но испытывает трудности с новыми изображениями: она так и не научилась по-настоящему распознавать закономерности, применимые в разных ситуациях.
Недообучение возникает, когда модель слишком проста и не улавливает важные закономерности в данных. Это может происходить, если у модели слишком мало слоёв, ей не хватило времени на обучение или данных недостаточно. В результате она не распознаёт важные закономерности и делает неточные предсказания. Качество модели остаётся низким и на обучающих, и на тестовых данных, потому что она не усвоила достаточно, чтобы правильно понять задачу.
Хорошо обученная модель находит баланс между сложностью и обобщением. Она должна быть достаточно сложной, чтобы усваивать важные закономерности, но не настолько, чтобы запоминать данные вместо выявления лежащих в их основе взаимосвязей.
Как выявить переобучение#
Вот несколько признаков переобучения модели:
- Если точность на обучающих данных значительно выше, чем на валидационных, вероятно, модель переобучена.
- Ещё один явный признак — растущий разрыв между потерями на обучающих и валидационных данных.
- Модель слишком уверенно выдаёт неправильные ответы — это говорит о том, что она запомнила детали, а не усвоила закономерности.
Чтобы убедиться, что модель хорошо обобщает данные, её нужно проверять на разнообразных наборах, отражающих реальные условия.
Как предотвратить переобучение в компьютерном зрении#
Переобучение не неизбежно — его можно предотвратить. С помощью правильных методов модели компьютерного зрения учатся усваивать общие закономерности вместо запоминания обучающих данных, благодаря чему становятся надёжнее в реальных приложениях.
Вот пять основных способов предотвратить переобучение в компьютерном зрении.
Повышай разнообразие данных с помощью аугментации и синтетических данных#
Лучший способ помочь модели хорошо работать с новыми данными — расширить набор данных с помощью аугментации и синтетических данных. Синтетические данные создаются компьютером, а не собираются по реальным изображениям. Они помогают восполнить пробелы, когда реальных данных недостаточно.
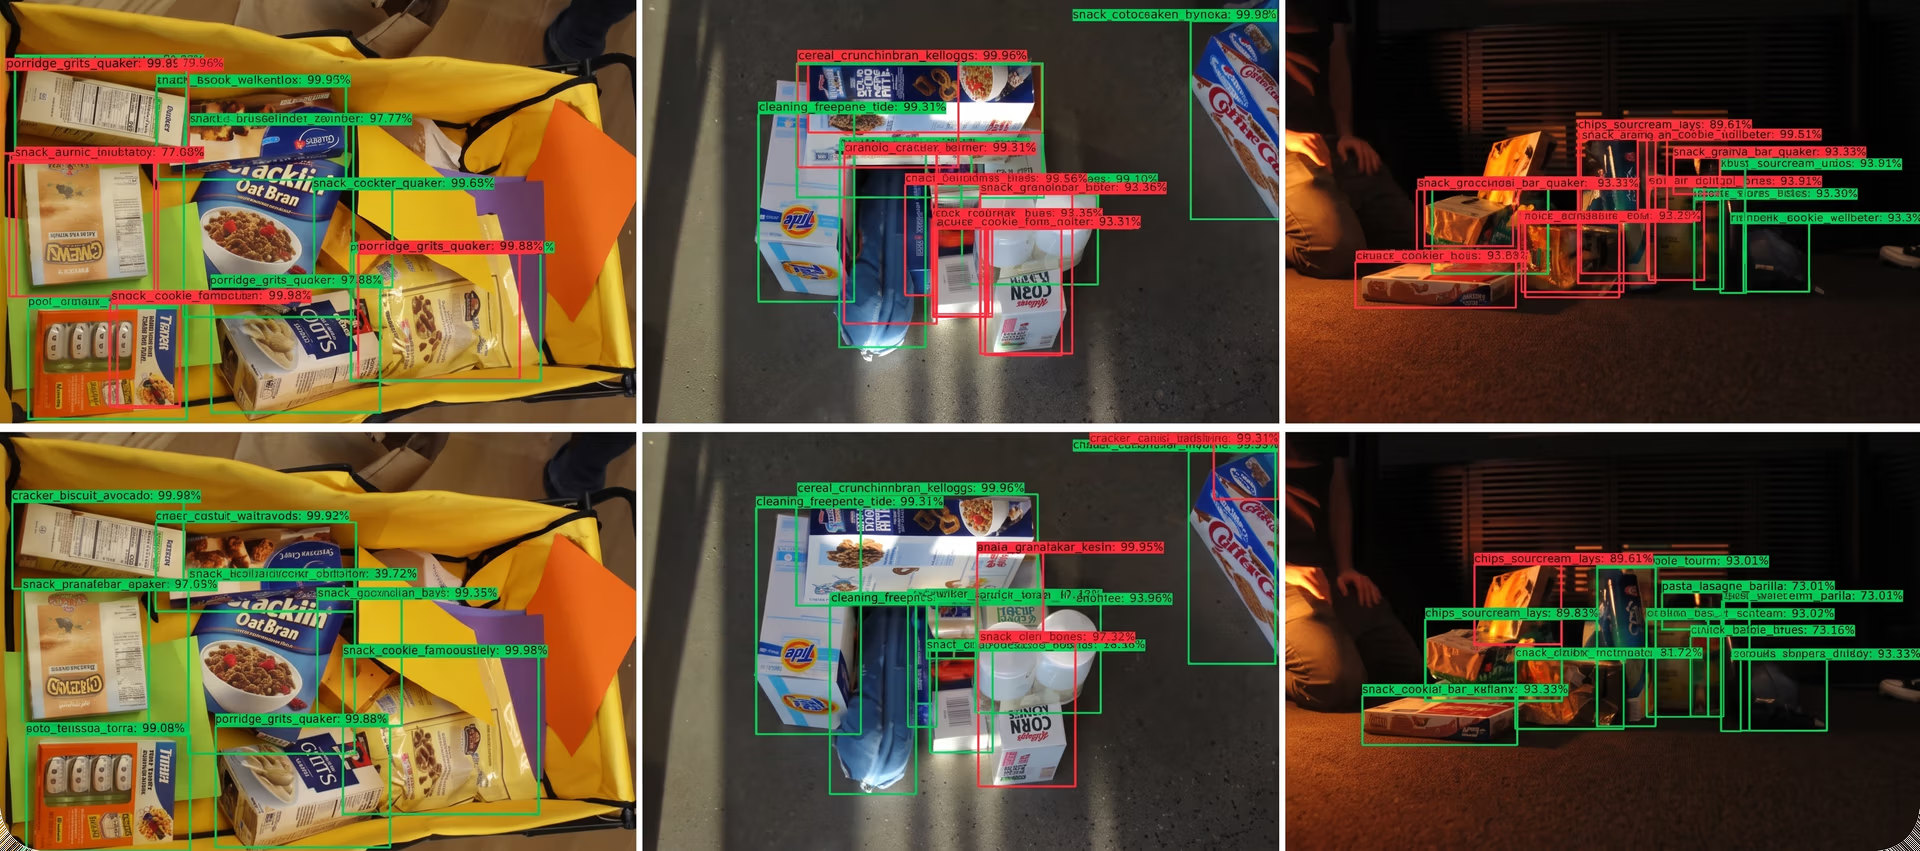
Рис. 2. Объединение реальных и синтетических данных снижает переобучение и повышает точность обнаружения объектов.
Аугментация данных слегка изменяет исходные изображения — отражает, поворачивает, обрезает их или меняет яркость, — чтобы модель не просто запоминала детали, а училась распознавать объекты в разных ситуациях.
Синтетические данные полезны, когда трудно получить реальные изображения. Например, модели для беспилотных автомобилей можно обучать на созданных компьютером дорожных сценах, чтобы научить их обнаруживать объекты при разной погоде и освещении. Благодаря этому модель становится более гибкой и надежной без необходимости собирать тысячи реальных изображений.
Оптимизируй сложность и архитектуру модели#
Глубокая нейронная сеть — разновидность модели машинного обучения с множеством слоев, обрабатывающих данные, а не одним слоем — не всегда лучше. Если в модели слишком много слоев или параметров, она запоминает обучающие данные вместо того, чтобы распознавать общие закономерности. Снижение ненужной сложности помогает предотвратить переобучение.
Для этого можно использовать прунинг, который удаляет избыточные нейроны и связи, делая модель компактнее и эффективнее.
Другой способ — упростить архитектуру, уменьшив число слоев или нейронов. Предварительно обученные модели, например Ultralytics YOLO11, рассчитаны на хорошее обобщение в разных задачах при меньшем числе параметров, поэтому они устойчивее к переобучению, чем глубокие модели, обученные с нуля.
Правильный баланс между глубиной и эффективностью модели помогает ей усваивать полезные закономерности, а не просто запоминать обучающие данные.
Применяй методы регуляризации#
Методы регуляризации не дают моделям чрезмерно зависеть от конкретных признаков обучающих данных. Вот несколько распространенных методов:
- Dropout отключает случайные части модели во время обучения, чтобы она училась распознавать разные закономерности, а не слишком полагалась на несколько признаков.
- Затухание весов (L2-регуляризация) препятствует появлению чрезмерно больших значений весов и помогает контролировать сложность модели.
- Пакетная нормализация помогает стабилизировать обучение, снижая чувствительность модели к вариациям в наборе данных.
Эти методы помогают сохранять гибкость и адаптивность модели, снижая риск переобучения без потери точности.
Контролируй обучение с помощью валидации и ранней остановки#
Чтобы предотвратить переобучение, важно отслеживать, как обучается модель, и проверять, хорошо ли она обобщает новые данные. Вот несколько методов, которые помогут в этом:
- Ранняя остановка: автоматически останавливает обучение, когда качество на валидационной выборке перестаёт улучшаться, чтобы модель не продолжала усваивать ненужные детали.
- Кросс-валидация: разделяет данные на несколько частей, затем многократно обучает модель на всех частях, кроме одной, и проверяет её на оставшейся части. Это позволяет надёжнее оценить, насколько хорошо модель обобщает данные за пределами конкретных изображений.
Эти методы помогают сохранить баланс: модель усваивает достаточно, чтобы обеспечивать точность, но не зацикливается на обучающих данных.
Используй предварительно обученные модели и улучшай разметку набора данных#
Использование предварительно обученных моделей, например Ultralytics YOLO11, вместо обучения с нуля может снизить переобучение. YOLO11 обучена на крупномасштабных наборах данных, что позволяет ей хорошо обобщать информацию в разных условиях.
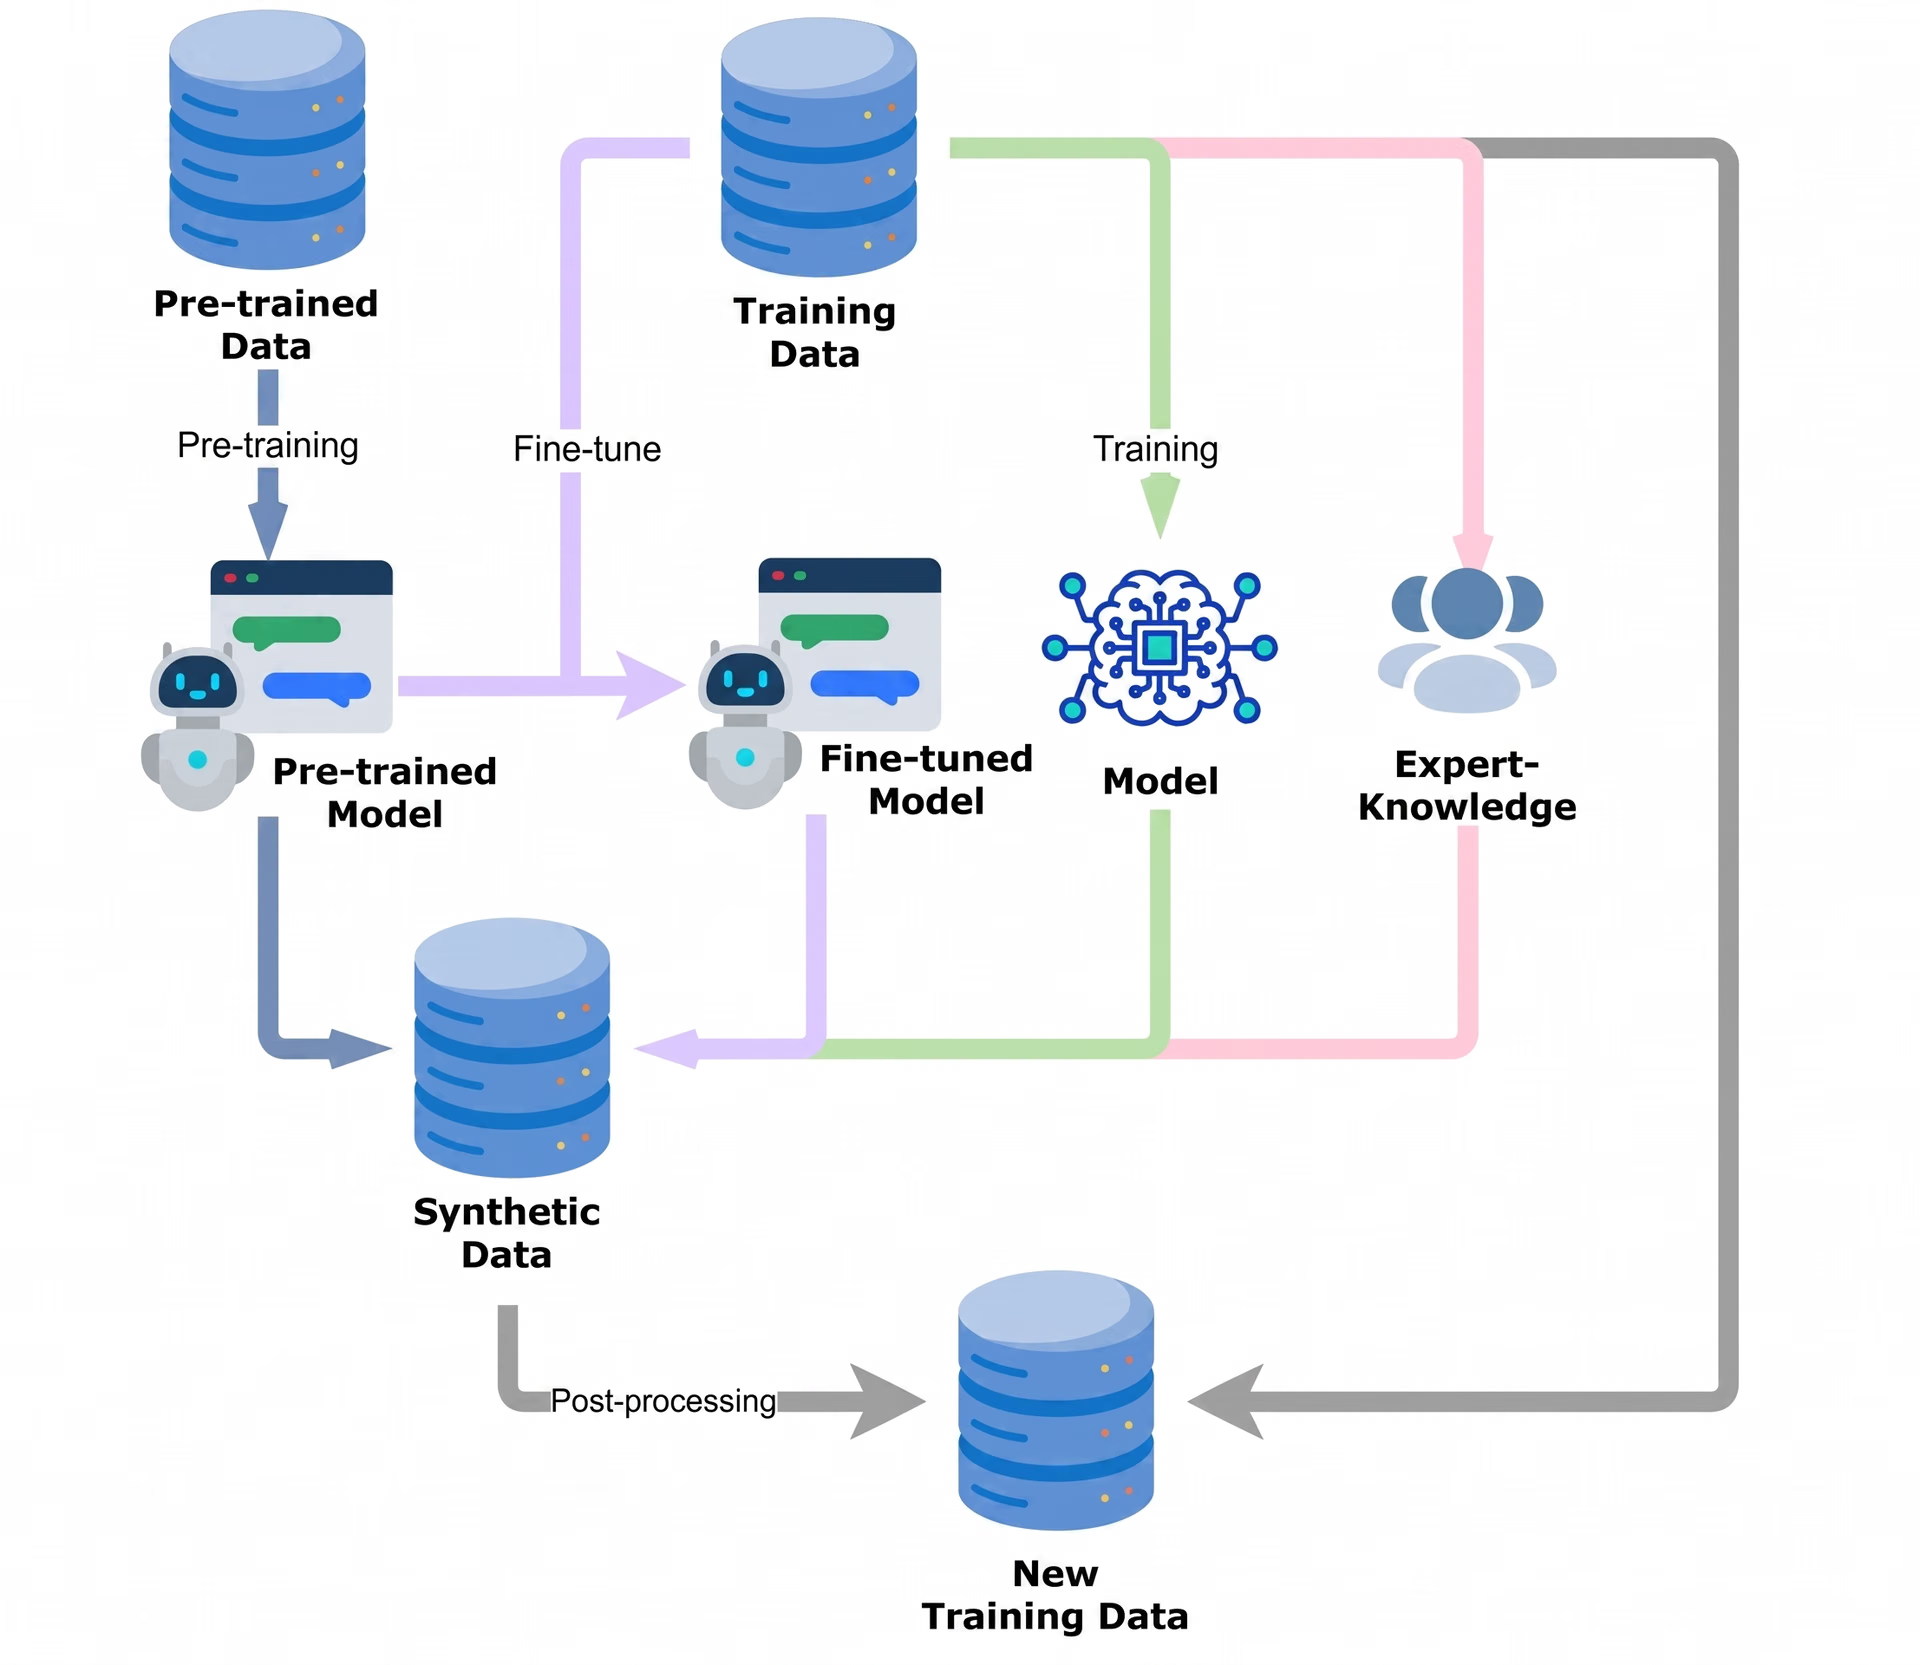
Рис. 3. Предварительно обученные модели компьютерного зрения повышают точность и предотвращают переобучение.
Дообучение предварительно обученной модели помогает ей сохранить уже усвоенные знания и освоить новые задачи, не сводя обучение к простому запоминанию данных.
Кроме того, важно обеспечить высокое качество разметки набора данных. Неверно размеченные или несбалансированные данные могут привести к тому, что модели усвоят ошибочные закономерности. Очистка наборов данных, исправление ошибок в разметке изображений и балансировка классов повышают точность и снижают риск переобучения. Еще один эффективный подход — состязательное обучение, при котором модель получает слегка измененные или более сложные примеры, призванные проверить ее возможности.
Главные выводы#
Переобучение — распространенная проблема в компьютерном зрении. Модель может хорошо работать на обучающих данных, но испытывать трудности с реальными изображениями. Избежать этого и повысить точность и адаптивность помогают такие методы, как аугментация данных, регуляризация и использование предварительно обученных моделей, например Ultralytics YOLO11.
Применение этих методов позволяет моделям ИИ оставаться надежными и хорошо работать в разных условиях. По мере развития глубокого обучения правильное обобщение станет ключевым фактором успеха ИИ в реальных задачах.
Присоединяйся к нашему растущему сообществу! Загляни в наш репозиторий GitHub, чтобы узнать больше об ИИ. Готов начать собственные проекты в области компьютерного зрения? Ознакомься с вариантами лицензирования. Узнай больше о визуальном ИИ в беспилотных автомобилях и ИИ в здравоохранении на страницах наших решений!
Автор
Автор · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









