Computer Vision (CV)
Компьютерное зрение (CV) — область ИИ, которая позволяет машинам интерпретировать изображения и видео. Разбираем принципы работы, основные задачи, области применения и сложности.
Компьютерное зрение (CV) — это область искусственного интеллекта (AI), которая позволяет компьютерам извлекать смысл из изображений, видео и других визуальных данных: определять присутствующие объекты и их расположение, отслеживать их движение и понимать происходящее в сцене. Современные системы учатся этому на примерах. Модель, обученная на тысячах размеченных изображений, усваивает визуальные признаки автомобиля, трещины или опухоли и применяет их к невиданным ранее изображениям. Поэтому сегодня в основе этой области лежат машинное обучение (ML) и, прежде всего, глубокое обучение (DL).
Как работает компьютерное зрение#
Для компьютера цветное изображение — это сетка чисел. Фотография размером 640×480 содержит 921 600 значений: по одному на пиксель для каждого из трёх цветовых каналов, каждое — интенсивность от 0 до 255. Конвейер компьютерного зрения преобразует эту сетку в решение за пять этапов.
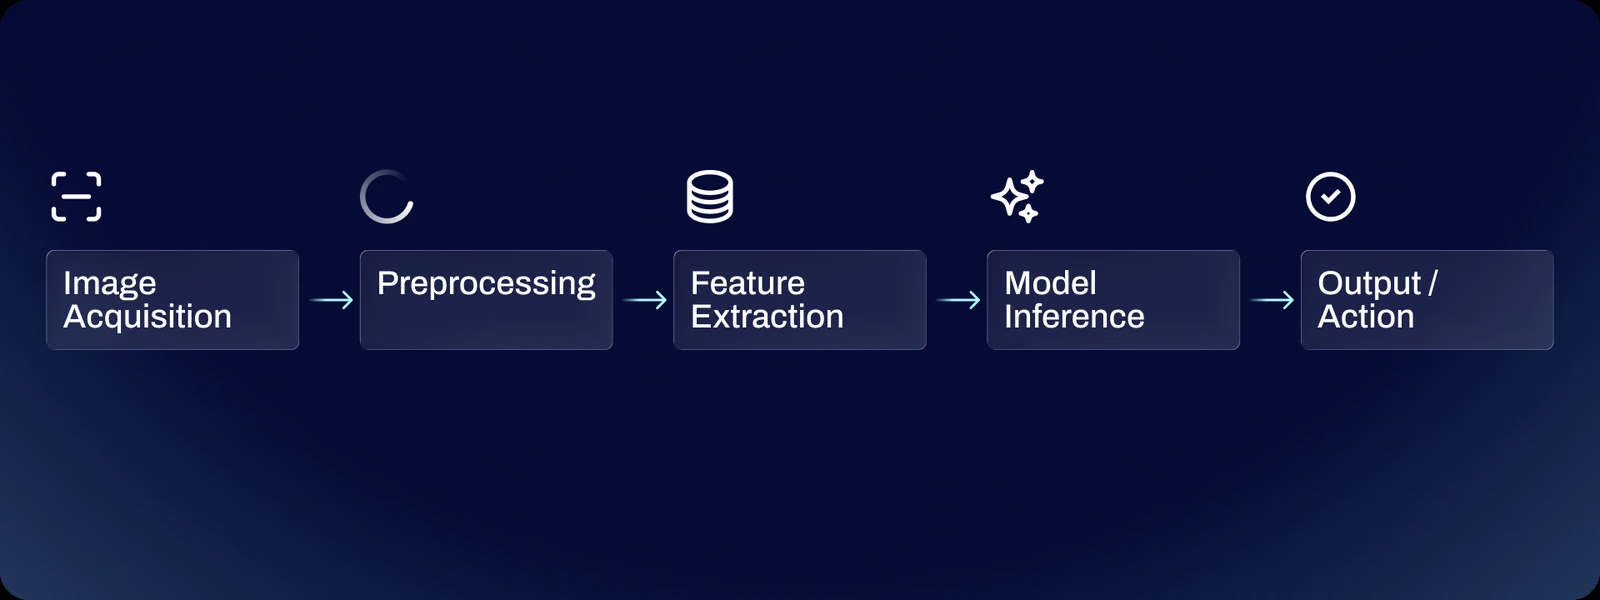
Камера или датчик захватывает изображение, а предварительная обработка, часто выполняемая с помощью OpenCV, изменяет его размер и нормализует, чтобы модель всегда получала входные данные в одном формате. Затем модель выполняет извлечение признаков: ранние слои свёрточной нейронной сети (CNN) реагируют на границы и цветовые градиенты, средние слои объединяют их в текстуры и части объектов, а глубокие слои распознают целые объекты. Визуальные трансформеры (ViT) получают похожие представления, разбивая изображение на фрагменты и связывая каждый фрагмент со всеми остальными с помощью механизма самовнимания. Специализированная выходная головка преобразует признаки в результат — например, метку класса, набор ограничивающих рамок или маску пикселей, — а окружающая система реагирует на него: отбраковывает дефектную деталь, тормозит автомобиль или подаёт сигнал тревоги.
Модели учатся выделять эти признаки с помощью обучения с учителем. Во время обучения модель делает предсказания по размеченным изображениям, функция потерь измеряет отклонение каждого предсказания от эталонного значения, а обратное распространение ошибки корректирует веса, уменьшая ошибку. Крупные общедоступные наборы данных, такие как ImageNet с более чем 14 миллионами размеченных изображений и COCO с 80 категориями повседневных объектов, используются для предварительного обучения, с которого начинается настройка большинства пользовательских моделей посредством переноса обучения.
От признаков, созданных вручную, к глубокому обучению#
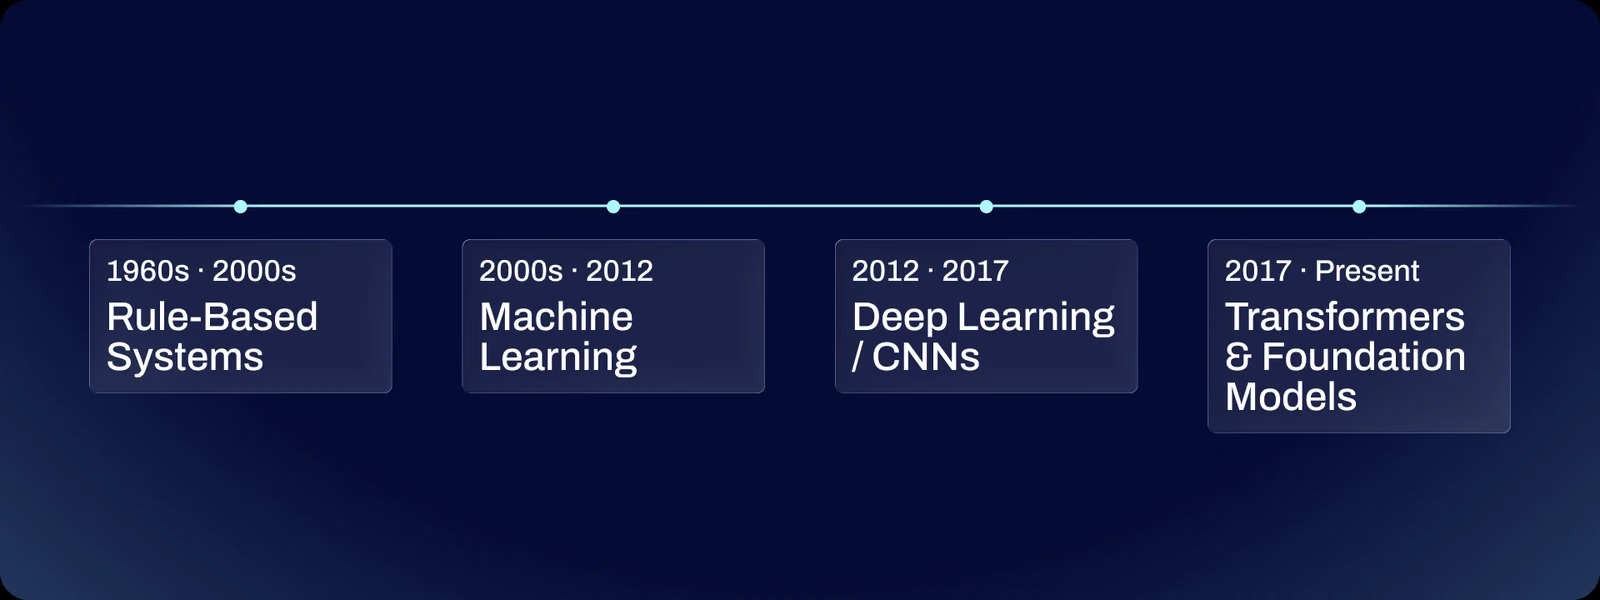
В ранних системах компьютерного зрения использовались созданные вручную признаки. Инженеры писали детекторы краев, углов и градиентных шаблонов, таких как SIFT и HOG, а затем передавали эти признаки классификатору. Такие системы переставали работать при изменении освещения, ракурса или фона. Переломный момент наступил в 2012 году, когда AlexNet выиграла конкурс ImageNet с долей ошибок top-5 в 15,3% против 26,2% у следующего участника. С тех пор CNN, а начиная с 2020 года и визуальные Transformer, научились извлекать признаки непосредственно из данных. Визуально-языковые модели (VLM) теперь объединяют изображения и текст, поэтому одна модель может отвечать на открытые вопросы о фотографии или находить объекты, описанные обычным языком. Таблица лидеров VLM измеряет точность обнаружения объектов этими моделями на реальных наборах данных.
Основные задачи компьютерного зрения#
Каждая задача отвечает на свой вопрос об изображении:
- Обнаружение объектов: находит каждый объект и обводит его рамкой с указанием класса и оценки уверенности, что позволяет подсчитывать объекты и определять их расположение.
- Сегментация экземпляров: создаёт отдельную маску пикселей для каждого объекта, поэтому два стоящих рядом человека остаются разными объектами.
- Семантическая сегментация: присваивает каждому пикселю класс, например «дорога», «тротуар» или «небо».
- Оценка глубины: по одному изображению предсказывает расстояние от камеры до каждого пикселя.
- Классификация изображений: присваивает всему изображению одну метку, например «дефект» или «ОК».
- Оценка позы: определяет ключевые точки, например суставы тела, чтобы измерять позу и движения.
- Поворачиваемые ограничивающие рамки (OBB): подбирает повёрнутые рамки для объектов под любым углом, например кораблей и самолётов на спутниковых снимках.
- Отслеживание объектов: связывает обнаруженные объекты между видеокадрами, чтобы у каждого сохранялся постоянный идентификатор.
Выбор задачи начинается с определения результата, который нужен приложению:
Ultralytics YOLO26 поддерживает семь из этих задач через единый API Python: один и тот же вызов YOLO() загружает модель детекции, сегментации экземпляров, семантической сегментации, глубины, классификации, позы или OBB, а model.track() добавляет трекинг на видео. В этом примере выполняется детекция объектов на тестовом изображении:
from ultralytics import YOLO

# Загружаем предварительно обученную модель обнаружения YOLO26 nano
model = YOLO("yolo26n.pt")

# Запускаем инференс на тестовом изображении улицы
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]

# Выводим количество обнаруженных объектов каждого класса и сохраняем изображение с аннотациями
print(result.verbose())
result.save(filename="bus_detections.jpg")
Выведенная строка показывает число обнаружений для каждого класса, а на сохранённом изображении для каждого объекта нарисованы рамка, метка и оценка уверенности.
Компьютерное зрение и смежные области#
- Обработка изображений: преобразует изображение в другое изображение: повышает резкость, устраняет шум, изменяет размер или регулирует контрастность. Конвейеры компьютерного зрения используют такие операции для предварительной обработки перед интерпретацией сцены.
- Техническое зрение: применение компьютерного зрения в промышленности для контроля качества и наведения роботов, обычно с фиксированными камерами, контролируемым освещением и специализированным оборудованием на производственной линии.
- Распознавание изображений: распространённый синоним классификации изображений, иногда употребляемый в широком смысле для любой задачи определения содержимого изображения.
Примеры применения в реальных условиях#
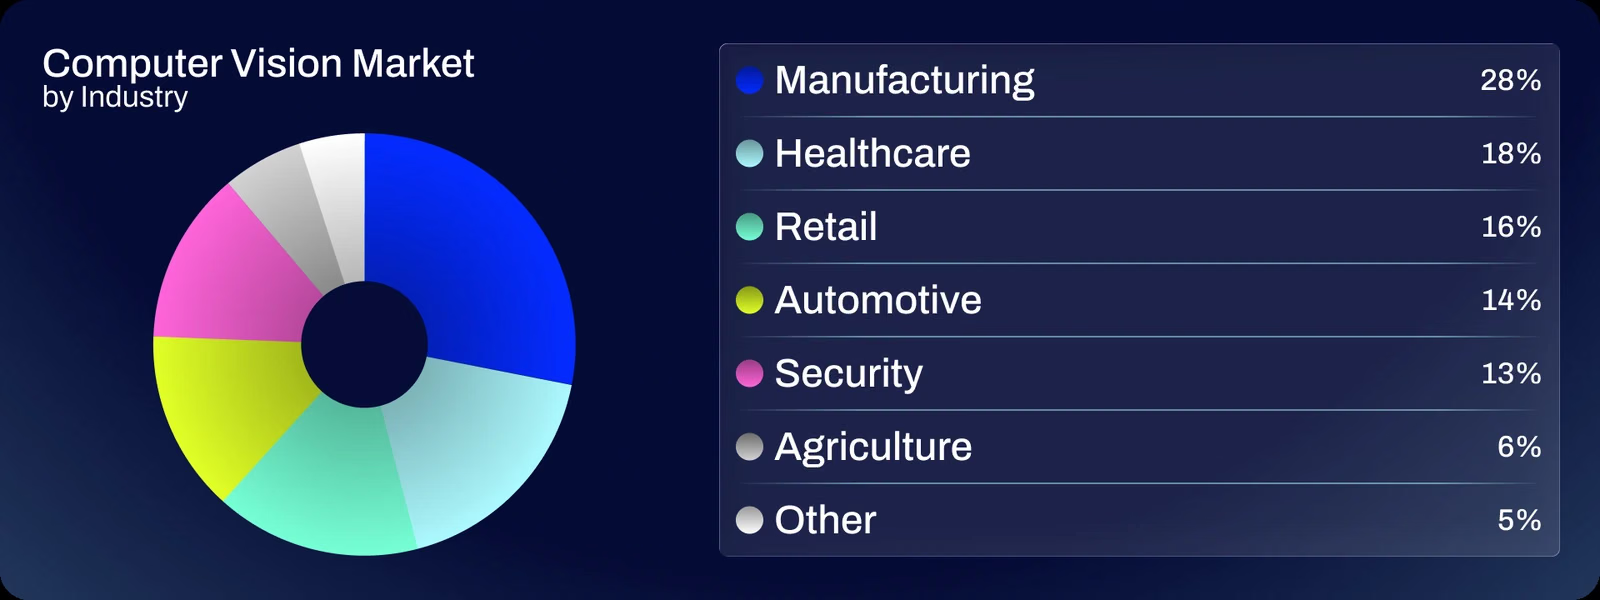
- Производство: камеры на скорости производственной линии осматривают каждую деталь, выявляя трещины, царапины и перекосы компонентов, а также отслеживают износ оборудования до его поломки.
- Медицинская визуализация: модели выявляют опухоли, переломы и заболевания сетчатки на рентгеновских снимках, КТ и фотографиях сетчатки, чтобы радиологи могли их проверить.
- Автономные автомобили: автомобили в реальном времени распознают полосы движения, знаки, пешеходов и другие транспортные средства и объединяют данные камер с радаром и LiDAR в трёхмерную модель окружающей обстановки.
- Розничная торговля: камеры на полках обнаруживают пустые места и товары не на своих местах, а магазины без касс отслеживают, какие товары берёт каждый покупатель.
- Сельское хозяйство: дроны и опрыскиватели отличают культурные растения от сорняков по отдельности, поэтому гербициды и удобрения попадают только туда, где они нужны.
- Безопасность и умные города: системы считают людей и транспортные средства, отслеживают транспортный поток и с помощью обнаружения аномалий выявляют необычные события в зонах ограниченного доступа.
Проблемы и ограничения#
Качество модели зависит от качества её обучающей выборки, а разметка данных — нанесение рамок или масок на тысячи изображений — часто требует больше усилий, чем само обучение модели. После развёртывания условия также меняются: дождь, блики, ночное освещение, перекрытия объектов или перемещение камеры изменяют входные данные по сравнению с теми, что модель видела при обучении. Аугментация данных имитирует такие условия во время обучения, а валидация на отложенных изображениях помогает выявить переобучение до выпуска модели.
Следующее ограничение — вычислительные ресурсы. Камеры, дроны и телефоны запускают модели при жёстких ограничениях по энергопотреблению и памяти, поэтому при развёртывании периферийного ИИ предпочтение отдают компактным моделям и квантованию моделей, чтобы достичь скорости реального времени, не отправляя видео в облако.
Системы, анализирующие людей, вызывают опасения по поводу смещения и конфиденциальности. Если некоторые группы недостаточно представлены в наборе данных, модель будет показывать на них неодинаковые результаты; во многих законах о конфиденциальности данные о лице и теле считаются чувствительными персональными данными. С февраля 2025 года Закон ЕС об ИИ запрещает правоохранительным органам использовать дистанционную биометрическую идентификацию в реальном времени в общедоступных местах, за исключением узко определённых случаев, например поиска похищенных людей или предотвращения непосредственной террористической угрозы.









