Что такое дистилляция датасета? Краткий обзор
Узнай, как дистилляция датасета ускоряет обучение моделей и снижает вычислительные затраты, заменяя большие наборы данных небольшим оптимизированным набором синтетических примеров.
 Abirami Vina14 мин. чтения
Обучение моделей может показаться самой трудоёмкой частью работы специалиста по анализу данных. Но на подготовку данных — их сбор, очистку и систематизацию для моделирования — на самом деле уходит большая часть времени, часто от 60% до 80%: подготовка данных. По мере увеличения наборов данных растёт и время на подготовку, что замедляет эксперименты и затрудняет итерации.
Чтобы решить эту проблему, исследователи годами искали способы упростить обучение. Такие подходы, как синтетические данные, сжатие наборов данных и улучшенные методы оптимизации, призваны сократить затраты и сложности при работе с большими наборами данных, а также ускорить процессы машинного обучения.
Отсюда возникает важный вопрос: можно ли значительно сократить набор данных и при этом добиться таких же результатов, как при обучении модели на полных данных? Один из перспективных ответов — дистилляция наборов данных.
Она создаёт компактную версию большого обучающего набора данных, сохраняя важные закономерности, которые нужны модели для эффективного обучения. Такой подход позволяет ускорить обучение, снизить потребность в вычислительных ресурсах и проводить эксперименты эффективнее. Можно представить это как шпаргалку для модели — крошечный набор примеров синтетических данных, созданных для обучения тем же основным закономерностям, что и полный набор данных.
В этой статье мы разберём, как работает дистилляция наборов данных и как она помогает масштабировать машинное обучение и глубокое обучение для практических задач.
Что такое дистилляция наборов данных#
Дистилляция набора данных — это процесс сжатия большого обучающего набора до значительно меньшего объёма данных, который при этом передаёт модели почти ту же информацию, что и исходный набор. Многие исследователи также называют этот процесс конденсацией набора данных, поскольку его цель — сохранить ключевые закономерности, присутствующие во всём наборе данных.
Дистиллированный набор данных отличается от случайно сгенерированных синтетических данных и простого отбора небольшой подвыборки реальных изображений. Это не случайный искусственный набор данных и не уменьшенная копия исходного.
Вместо этого его целенаправленно оптимизируют, чтобы сохранить наиболее важные закономерности. В ходе процесса корректируют и оптимизируют каждый пиксель и признак, чтобы нейронная сеть, обученная на дистиллированных данных, усваивала информацию почти так же, как при обучении на всём наборе данных.
Эта идея впервые появилась в статье на arXiv 2018 года авторства Тунчжоу Вана, Цзюнь-Яня Чжу, Антонио Торральбы и Алексея А. Ефроса. В первых экспериментах использовали простые наборы данных, такие как MNIST и CIFAR-10. На них легко было показать, что несколько дистиллированных примеров могут заменить тысячи реальных изображений.
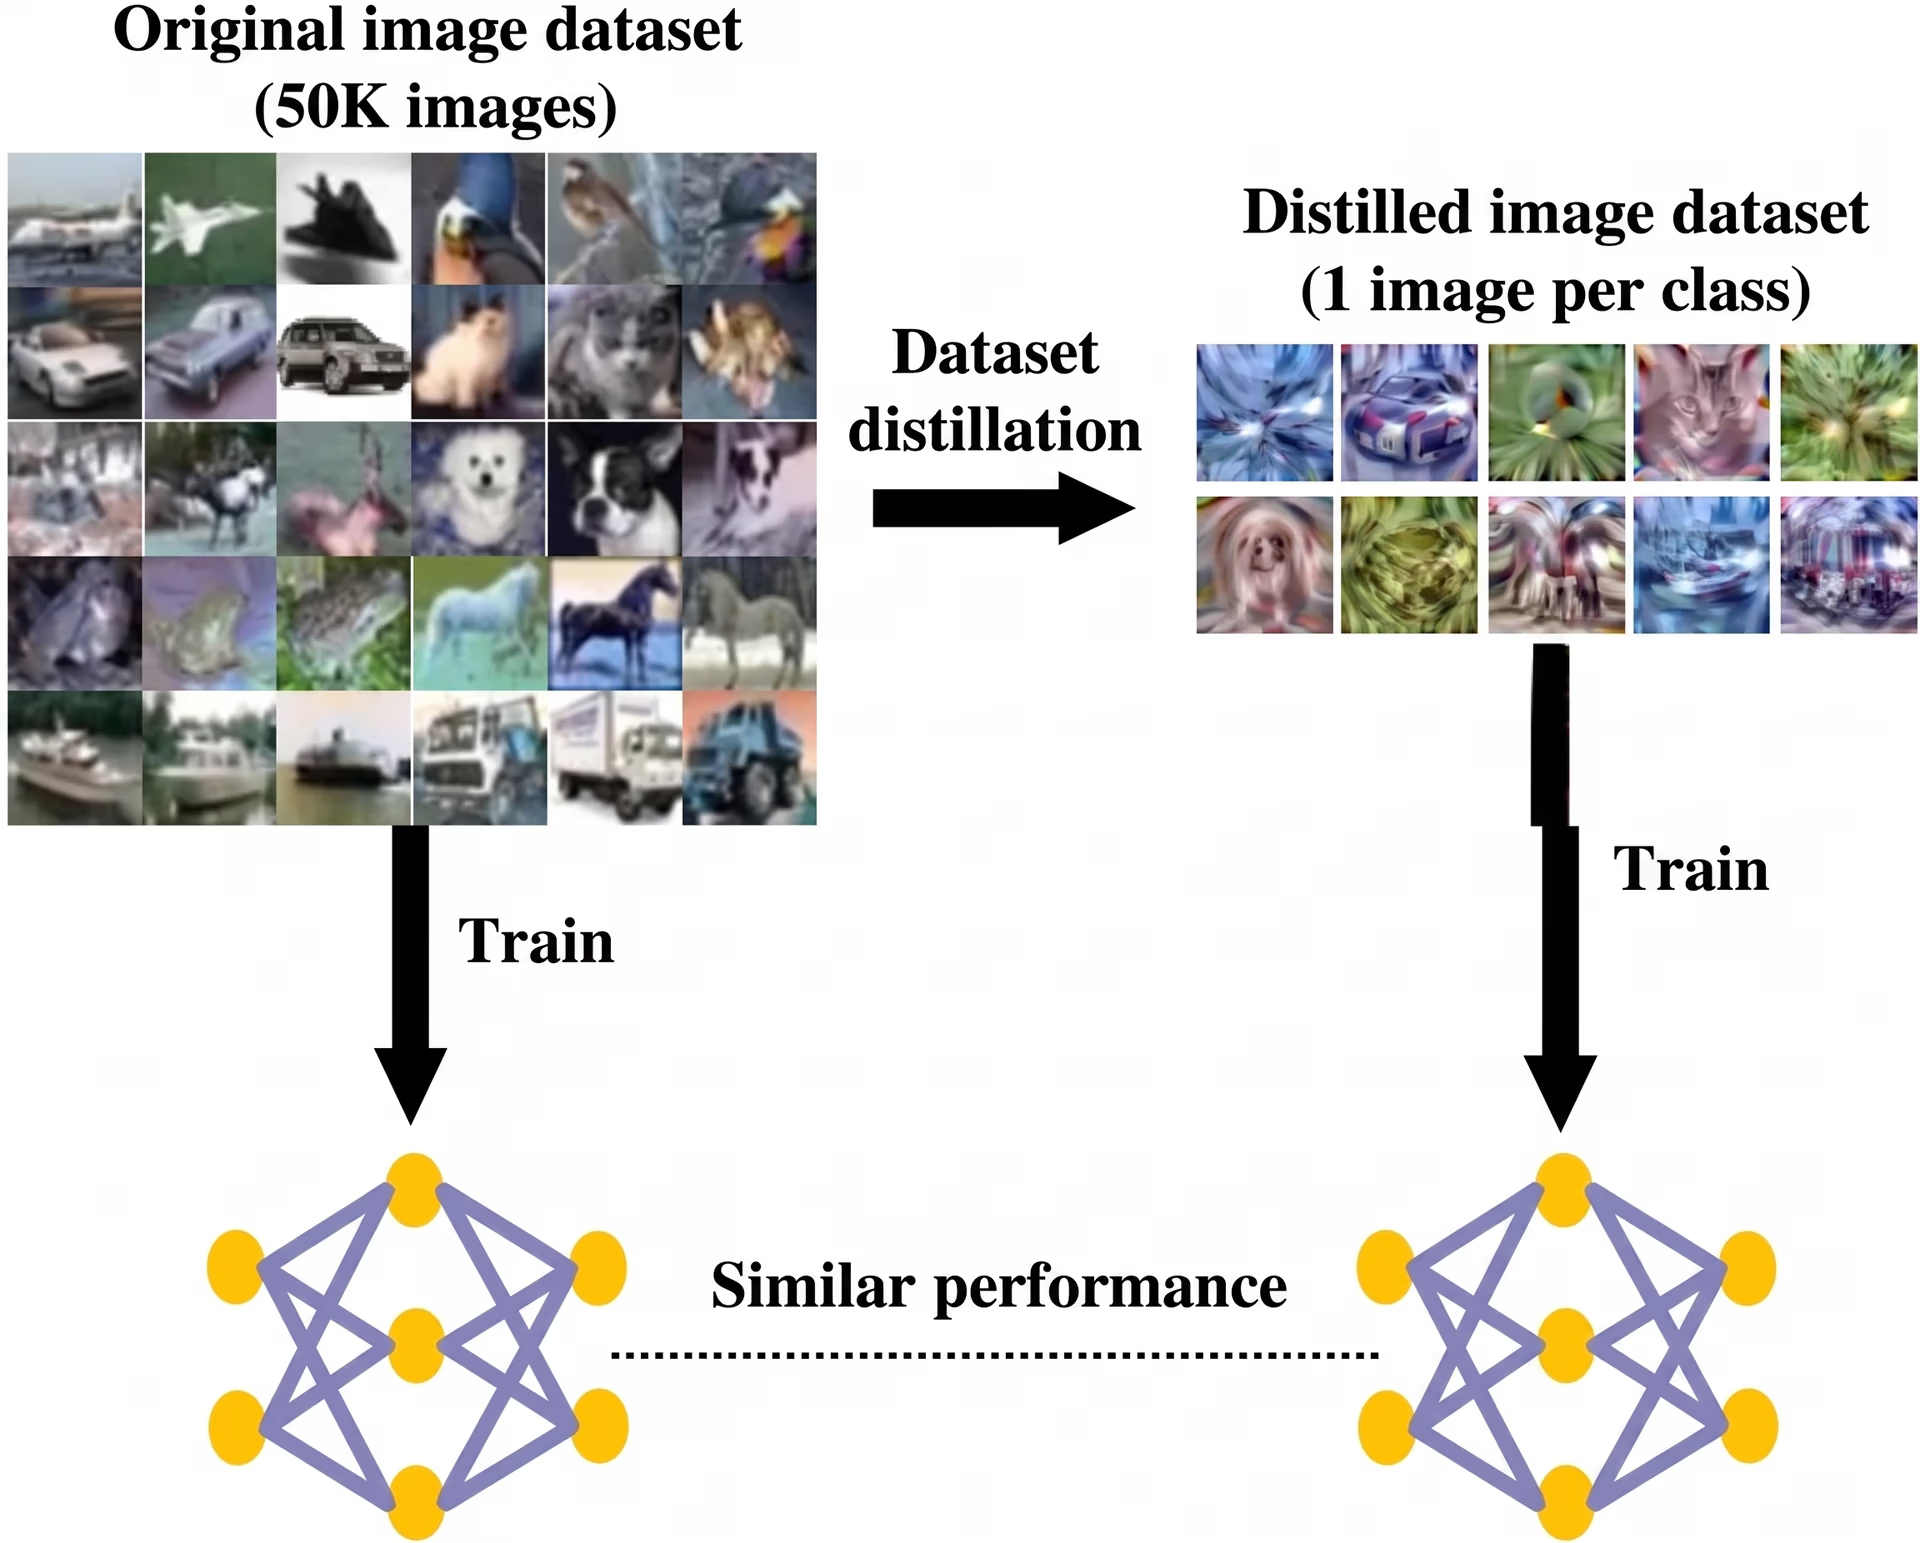
Рис. 1. Дистилляция набора данных изображений (источник)
С тех пор дальнейшие исследования развили методы дистилляции наборов данных. В том числе на конференциях ICML и ICLR были представлены методы, повышающие эффективность и масштабируемость конденсации.
Значение дистилляции наборов данных#
Дистилляция наборов данных повышает эффективность обучения и ускоряет циклы разработки. Сокращая объём данных, на которых должна учиться модель, она снижает требования к вычислительным ресурсам.
Это особенно полезно для непрерывного обучения, при котором модели обновляются со временем; поиска нейронной архитектуры, в ходе которого проверяется множество вариантов моделей; и обучения на периферийных устройствах с ограниченными памятью и мощностью. В целом эти преимущества делают дистилляцию наборов данных отличным решением для быстрой инициализации, оперативной тонкой настройки и создания ранних прототипов в самых разных процессах машинного обучения.
Как работает дистилляция наборов данных#
При дистилляции наборов данных создаются синтетические, то есть искусственно сгенерированные, обучающие примеры. Они помогают модели учиться почти так же, как при обучении на реальных данных. Для этого во время обычного обучения отслеживают три ключевых фактора.
Первый фактор — функция потерь, которая показывает величину ошибки модели и насколько неверны её предсказания. Второй — параметры модели, то есть внутренние веса сети, которые обновляются по мере обучения.
Третий фактор — траектория обучения, описывающая пошаговые изменения ошибки и весов с течением времени. Затем синтетические примеры оптимизируют так, чтобы при обучении модели на них ошибка снижалась, а веса обновлялись так же, как при использовании полного набора данных.
Дистилляция набора данных: пошаговый разбор#
Рассмотрим подробнее, как работает процесс дистилляции набора данных:
- Шаг 1 — инициализация синтетических пикселей: процесс начинается с синтетических изображений, которые служат обучаемыми входными данными. Сначала в этих изображениях почти нет структуры, и они похожи на чистый лист. Со временем их оптимизируют, превращая в информативные примеры.
- Шаг 2 — оптимизация с помощью сопоставления градиентов и обратного распространения ошибки: обучаясь на синтетических изображениях, модель вычисляет градиенты, которые показывают, как изменить каждый пиксель, чтобы лучше воспроизвести поведение при обучении на реальных данных. Обратное распространение ошибки — это метод, с помощью которого сеть учится на своих ошибках. Он передаёт ошибку назад по модели, чтобы определить, какие пиксели и веса её вызвали, а затем немного корректирует их. Используя эти градиенты, обратное распространение ошибки шаг за шагом изменяет синтетические изображения, делая их более информативными для обучения.
- Шаг 3 — сопоставление поведения на этапах обучения: метод также сопоставляет траектории обучения, то есть пошаговые изменения, которые происходят в модели в процессе обучения. Благодаря этому дистиллированный набор данных направляет модель по траектории обучения, похожей на ту, по которой она шла бы при работе с полным набором данных.
- Шаг 4 — проверка и обобщающая способность: наконец, дистиллированный набор данных оценивают на реальных проверочных данных, чтобы выяснить, насколько хорошо обученная модель справляется с новыми примерами. Это позволяет убедиться, что синтетические данные обучают общим функциональным закономерностям, а не заставляют модель запоминать конкретные примеры.
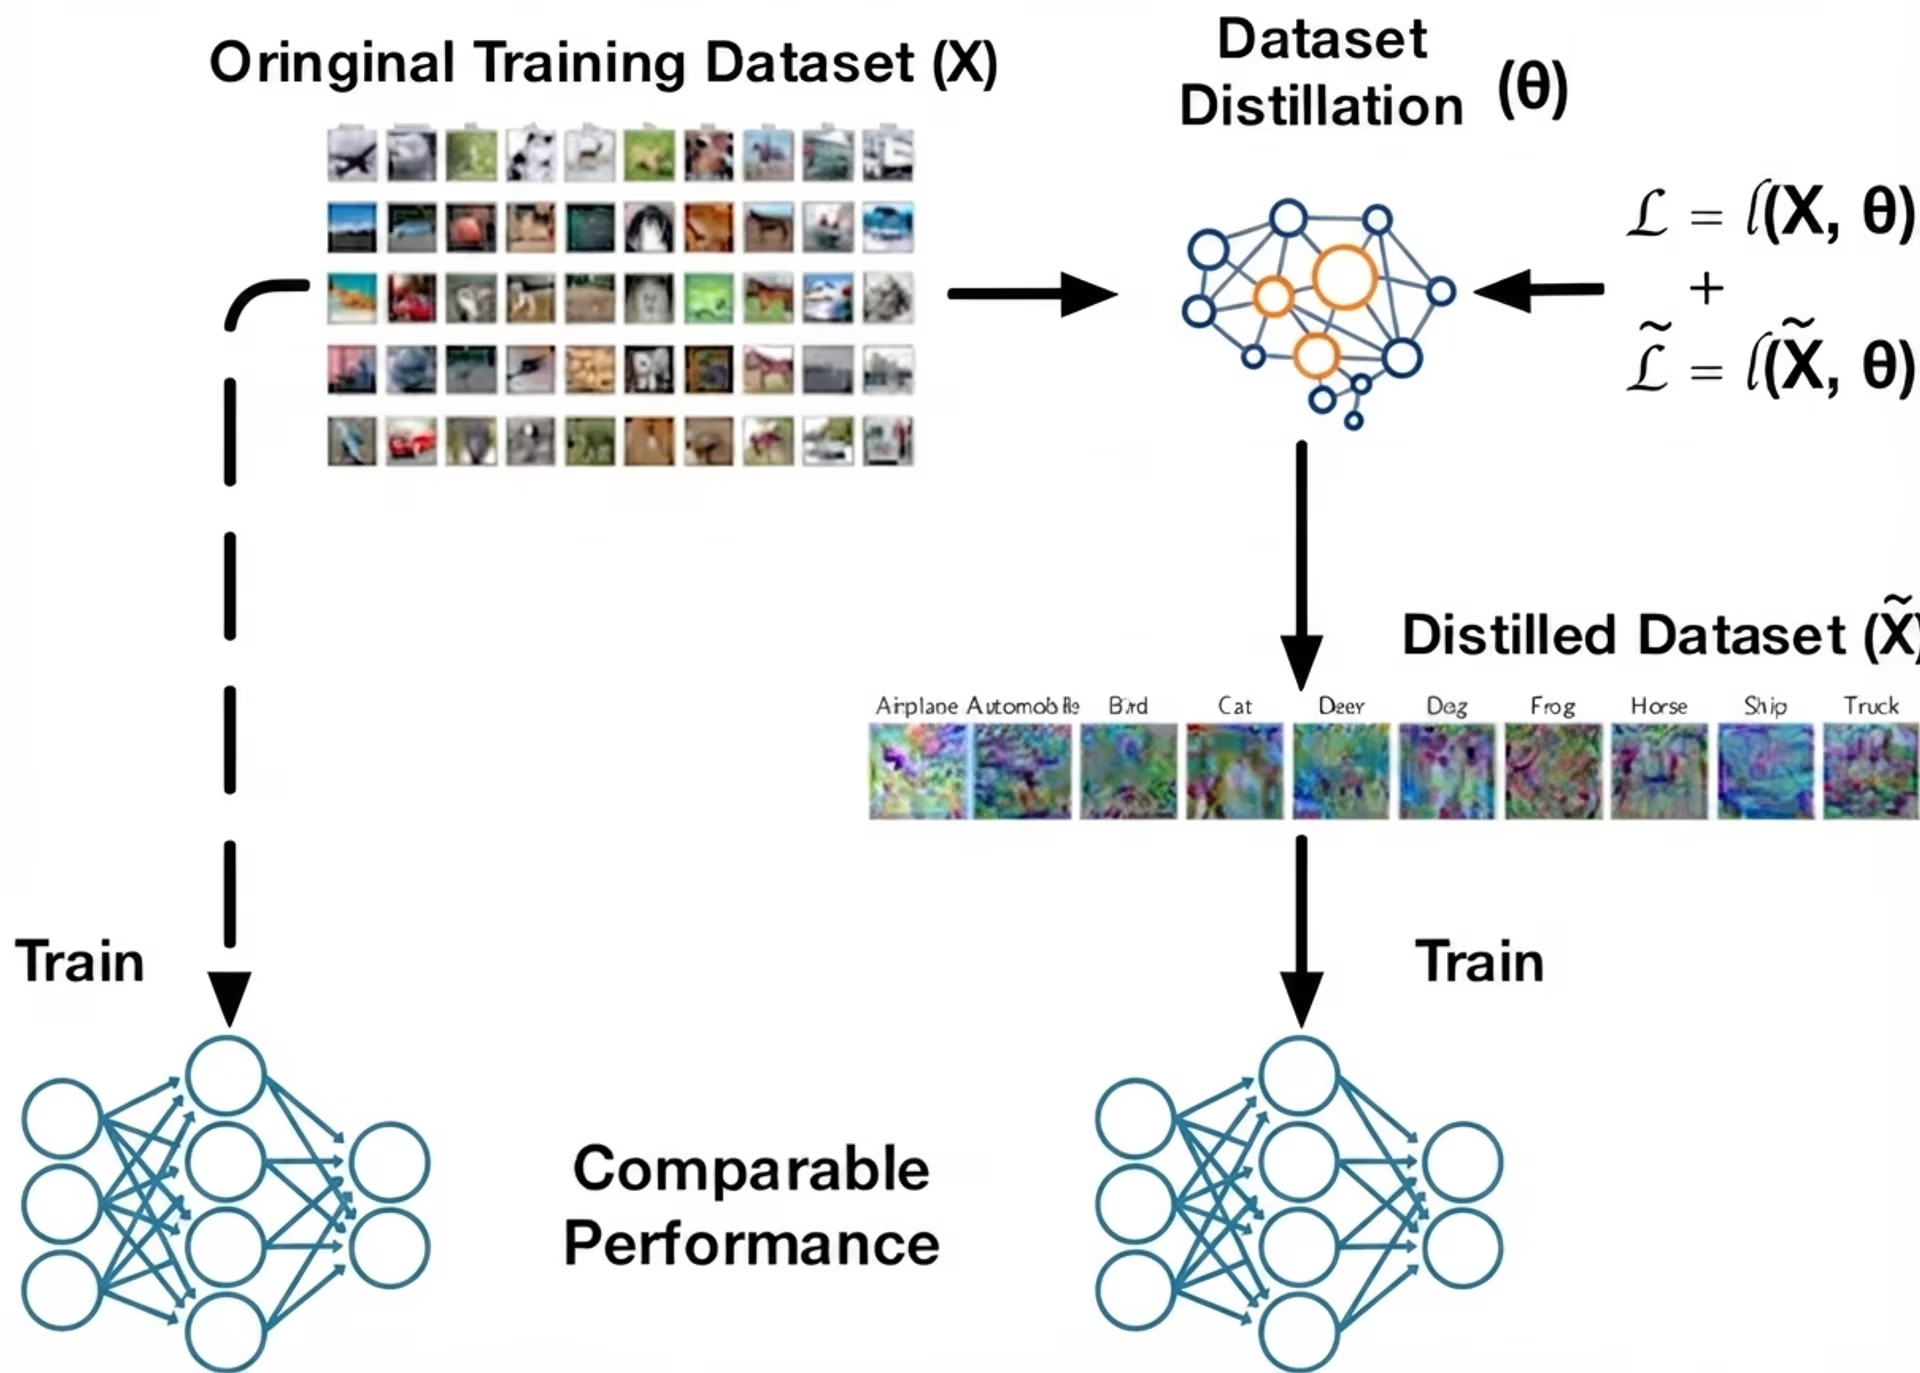
Рис. 2. Дистилляция набора данных (источник)
Основные методы дистилляции наборов данных#
В основе всех методов дистилляции наборов данных лежит одна идея, хотя алгоритмы могут быть разными. Большинство подходов относятся к одной из трёх категорий: сопоставление производительности, сопоставление распределений и сопоставление параметров.
Теперь рассмотрим каждый из них и разберёмся, как они работают.
Сопоставление производительности#
При сопоставлении производительности в дистилляции наборов данных создают крошечный оптимизированный обучающий набор, который позволяет модели добиться почти такой же точности, как при обучении на полном исходном наборе данных. Вместо случайной подвыборки оптимизируют дистиллированные примеры так, чтобы обученная на них модель выдавала схожие предсказания, демонстрировала похожее поведение функции потерь во время обучения или достигала близкой итоговой точности по сравнению с моделью, обученной на исходном наборе данных.
Для улучшения этого процесса часто используют метаобучение. Дистиллированный набор данных обновляется в ходе повторяющихся циклов обучения, чтобы эффективно работать в самых разных ситуациях.
В каждом цикле метод имитирует обучение модели-ученика на текущих дистиллированных примерах, проверяет её результаты на реальных данных, а затем корректирует примеры, чтобы они лучше обучали модель. Со временем дистиллированный набор учится обеспечивать быстрое обучение и хорошую обобщающую способность, даже если модель-ученик начинает с других начальных весов или использует другую архитектуру. Благодаря этому дистиллированный набор данных становится надёжнее и не привязан к одному запуску обучения.
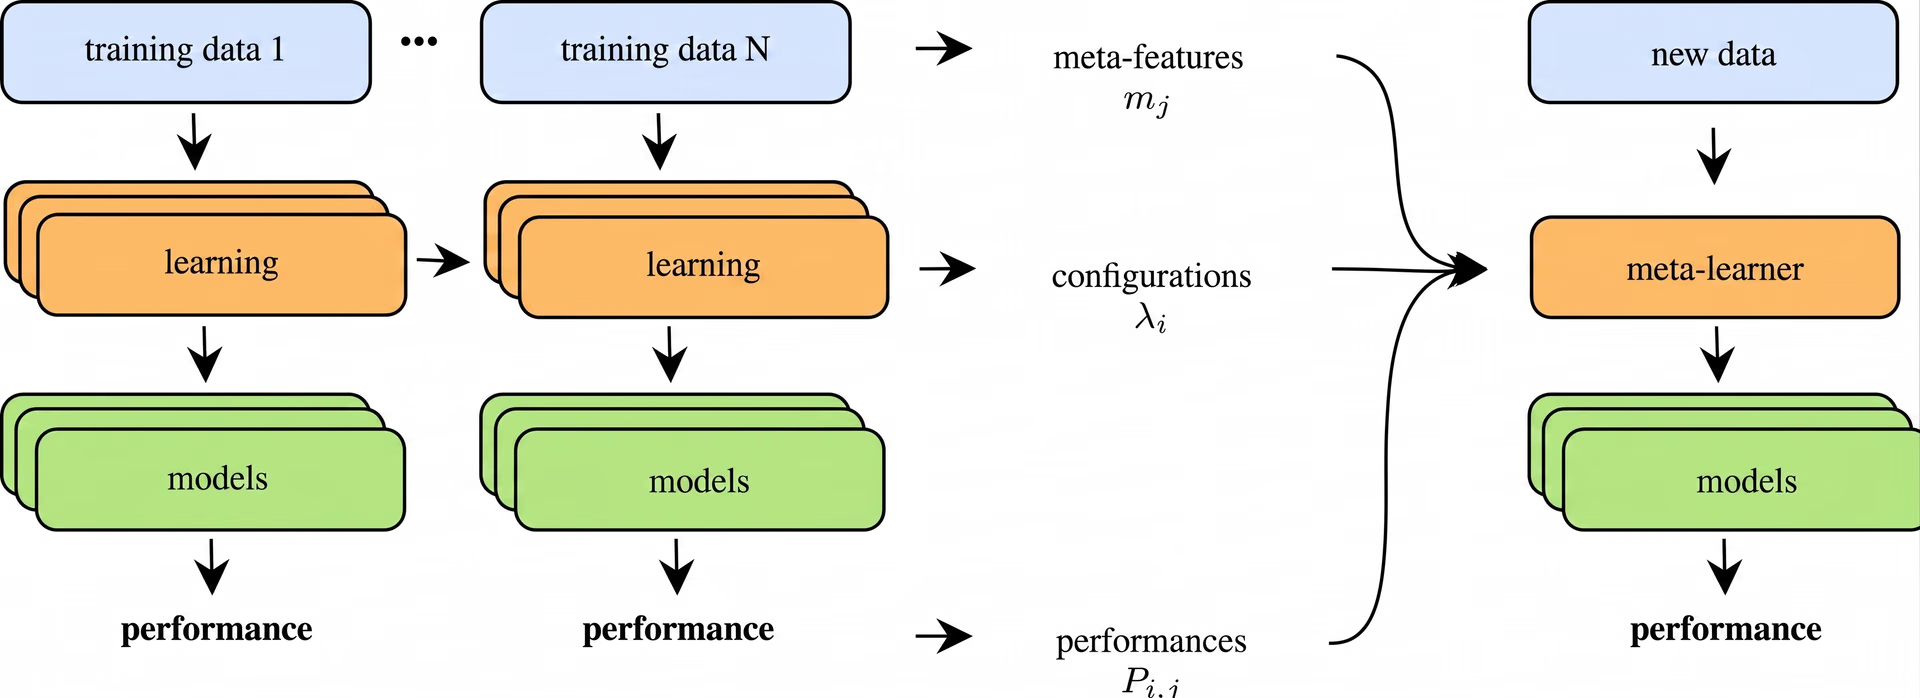
Рис. 3. Процесс метаобучения (источник)
Методы сопоставления распределений#
Сопоставление распределений, в свою очередь, позволяет генерировать синтетические данные, соответствующие статистическим закономерностям реального набора данных. Вместо того чтобы учитывать только итоговую точность модели, этот подход сосредоточен на внутренних признаках, которые нейронная сеть формирует в процессе обучения.
Теперь рассмотрим два метода, лежащих в основе сопоставления распределений.
Сопоставление распределений на одном слое#
Сопоставление распределений на одном слое сосредоточено на одном слое нейронной сети и сравнивает признаки, которые сеть формирует для реальных и синтетических данных. Эти признаки, также называемые активациями, отражают то, чему модель научилась на данном этапе работы сети.
Создавая синтетические данные, которые формируют похожие активации, метод побуждает дистиллированный набор данных отражать те же важные закономерности, что и исходный набор. На практике синтетические примеры многократно обновляются, пока активации на выбранном слое не начнут близко соответствовать активациям, полученным на реальных изображениях.
Этот подход сравнительно прост, поскольку за раз выравнивает представления только на одном уровне. Он особенно хорошо подходит для небольших наборов данных и задач, где нет необходимости сопоставлять глубокие многоэтапные иерархии признаков. Чёткое выравнивание одного пространства признаков даёт при обучении на дистиллированном наборе данных стабильный и значимый сигнал.
Сопоставление распределений на нескольких слоях#
Сопоставление распределений на нескольких слоях развивает идею сравнения реальных и синтетических данных: сравнение проводится на нескольких слоях нейронной сети, а не только на одном. Разные слои улавливают разные типы информации: от простых границ и текстур на ранних слоях до форм и более сложных закономерностей на глубоких слоях.
Сопоставляя признаки на этих слоях, метод побуждает дистиллированный набор данных отражать то, чему модель учится на разных уровнях. Поскольку признаки выравниваются по всей сети, синтетические данные сохраняют более богатые сигналы, на которые модель опирается, чтобы различать классы.
Это особенно полезно в задачах компьютерного зрения, то есть в задачах, где модели учатся понимать изображения и видео, поскольку важные закономерности распределены по многим слоям. Когда распределения признаков хорошо совпадают на нескольких уровнях глубины, дистиллированный набор данных становится более надёжной и эффективной заменой исходным обучающим данным.
Методы сопоставления параметров#
Ещё одна важная категория методов дистилляции данных — сопоставление параметров. Вместо точности или распределений признаков здесь сопоставляется то, как меняются веса модели во время обучения. Если обучение на дистиллированном наборе данных приводит к обновлениям параметров, похожим на обновления при обучении на реальных данных, модель проходит почти идентичный путь обучения.
Далее мы рассмотрим два основных метода сопоставления параметров.
Сопоставление за один шаг#
При сопоставлении за один шаг сравнивается, как меняются веса модели после единственного шага обучения на реальных данных. Затем дистиллированный набор данных настраивается так, чтобы модель после одного шага обучения на нём обновила веса похожим образом. Поскольку метод учитывает только это единственное обновление, он прост и быстр в применении.
Недостаток в том, что одного шага недостаточно, чтобы отразить весь процесс обучения, особенно при решении сложных задач, где модели нужно много обновлений, чтобы сформировать более богатые признаки. Поэтому сопоставление за один шаг обычно лучше работает на простых задачах или небольших наборах данных, где полезные закономерности можно усвоить быстро.
Сопоставление параметров на нескольких шагах#
В отличие от сопоставления за один шаг, сопоставление параметров на нескольких шагах учитывает, как меняются веса модели на протяжении нескольких шагов обучения. Эта последовательность обновлений называется траекторией обучения модели.
Дистиллированный набор данных формируется так, чтобы траектория модели, обучаемой на синтетических примерах, близко следовала той траектории, которую модель прошла бы на реальных данных. Сопоставляя более длительный отрезок обучения, дистиллированный набор лучше сохраняет структуру исходного процесса обучения.
Поскольку этот метод отражает развитие обучения во времени, сопоставление на нескольких шагах обычно лучше подходит для крупных и сложных наборов данных, где модели нужно много обновлений, чтобы усвоить полезные закономерности. На отслеживание нескольких шагов требуется больше вычислений, но зачастую такой подход позволяет получить дистиллированные наборы данных с лучшей обобщающей способностью и более высокой производительностью, чем при сопоставлении за один шаг.
Как работают генерация и оптимизация синтетических наборов данных#
Теперь, когда мы разобрались с основными подходами к дистилляции, посмотрим, как создаются синтетические данные. При дистилляции набора данных синтетические примеры оптимизируются так, чтобы сохранить наиболее важный обучающий сигнал. Благодаря этому небольшой набор может заменить гораздо более крупный.
Далее мы рассмотрим, как генерируются и оцениваются такие дистиллированные данные.
Создание и оценка дистиллированных изображений#
Во время дистилляции набора данных синтетические пиксели обновляются на протяжении многих шагов обучения. Нейронная сеть обучается на текущих синтетических изображениях и передаёт обратную связь на основе градиентов, которая показывает, как нужно изменить каждый пиксель, чтобы лучше соответствовать закономерностям реального набора данных.
Это работает благодаря дифференцируемости процесса: каждый шаг является плавным и имеет определённые градиенты, поэтому небольшие изменения пикселей приводят к предсказуемым изменениям функции потерь. Это позволяет модели плавно корректировать синтетические данные во время градиентного спуска.
По мере продолжения оптимизации синтетические изображения начинают приобретать осмысленную структуру, включая формы и текстуры, распознаваемые моделью. Такие уточнённые синтетические изображения часто используют в задачах классификации изображений, поскольку они содержат ключевые визуальные признаки, необходимые классификатору для обучения.
Дистиллированные наборы данных оценивают, обучая на них модели и сравнивая результаты с результатами моделей, обученных на реальных данных. Исследователи измеряют точность на валидационной выборке и проверяют, сохраняет ли синтетический набор дискриминативные признаки — закономерности или сигналы, на которые модель опирается, чтобы различать классы. Также проверяются стабильность и обобщающая способность при разных запусках и конфигурациях моделей, чтобы убедиться, что дистиллированные данные не приводят к переобучению.
Практическое применение дистилляции данных#
Далее мы подробнее рассмотрим примеры того, как дистиллированные наборы данных ускоряют обучение и снижают вычислительные затраты, сохраняя высокую производительность даже при ограниченном объёме данных или узкой специализации задачи.
Применение дистилляции наборов данных в компьютерном зрении#
В компьютерном зрении цель состоит в том, чтобы обучить модели понимать визуальные данные, например изображения и видео. Модели учатся распознавать закономерности — границы, текстуры, формы и объекты — и используют их для таких задач, как классификация изображений, обнаружение объектов и сегментация. Поскольку в задачах компьютерного зрения часто сильно различаются освещение, фон и ракурс, системам обычно нужны большие наборы данных, чтобы хорошо обобщать знания. Из-за этого обучение становится дорогим и долгим.
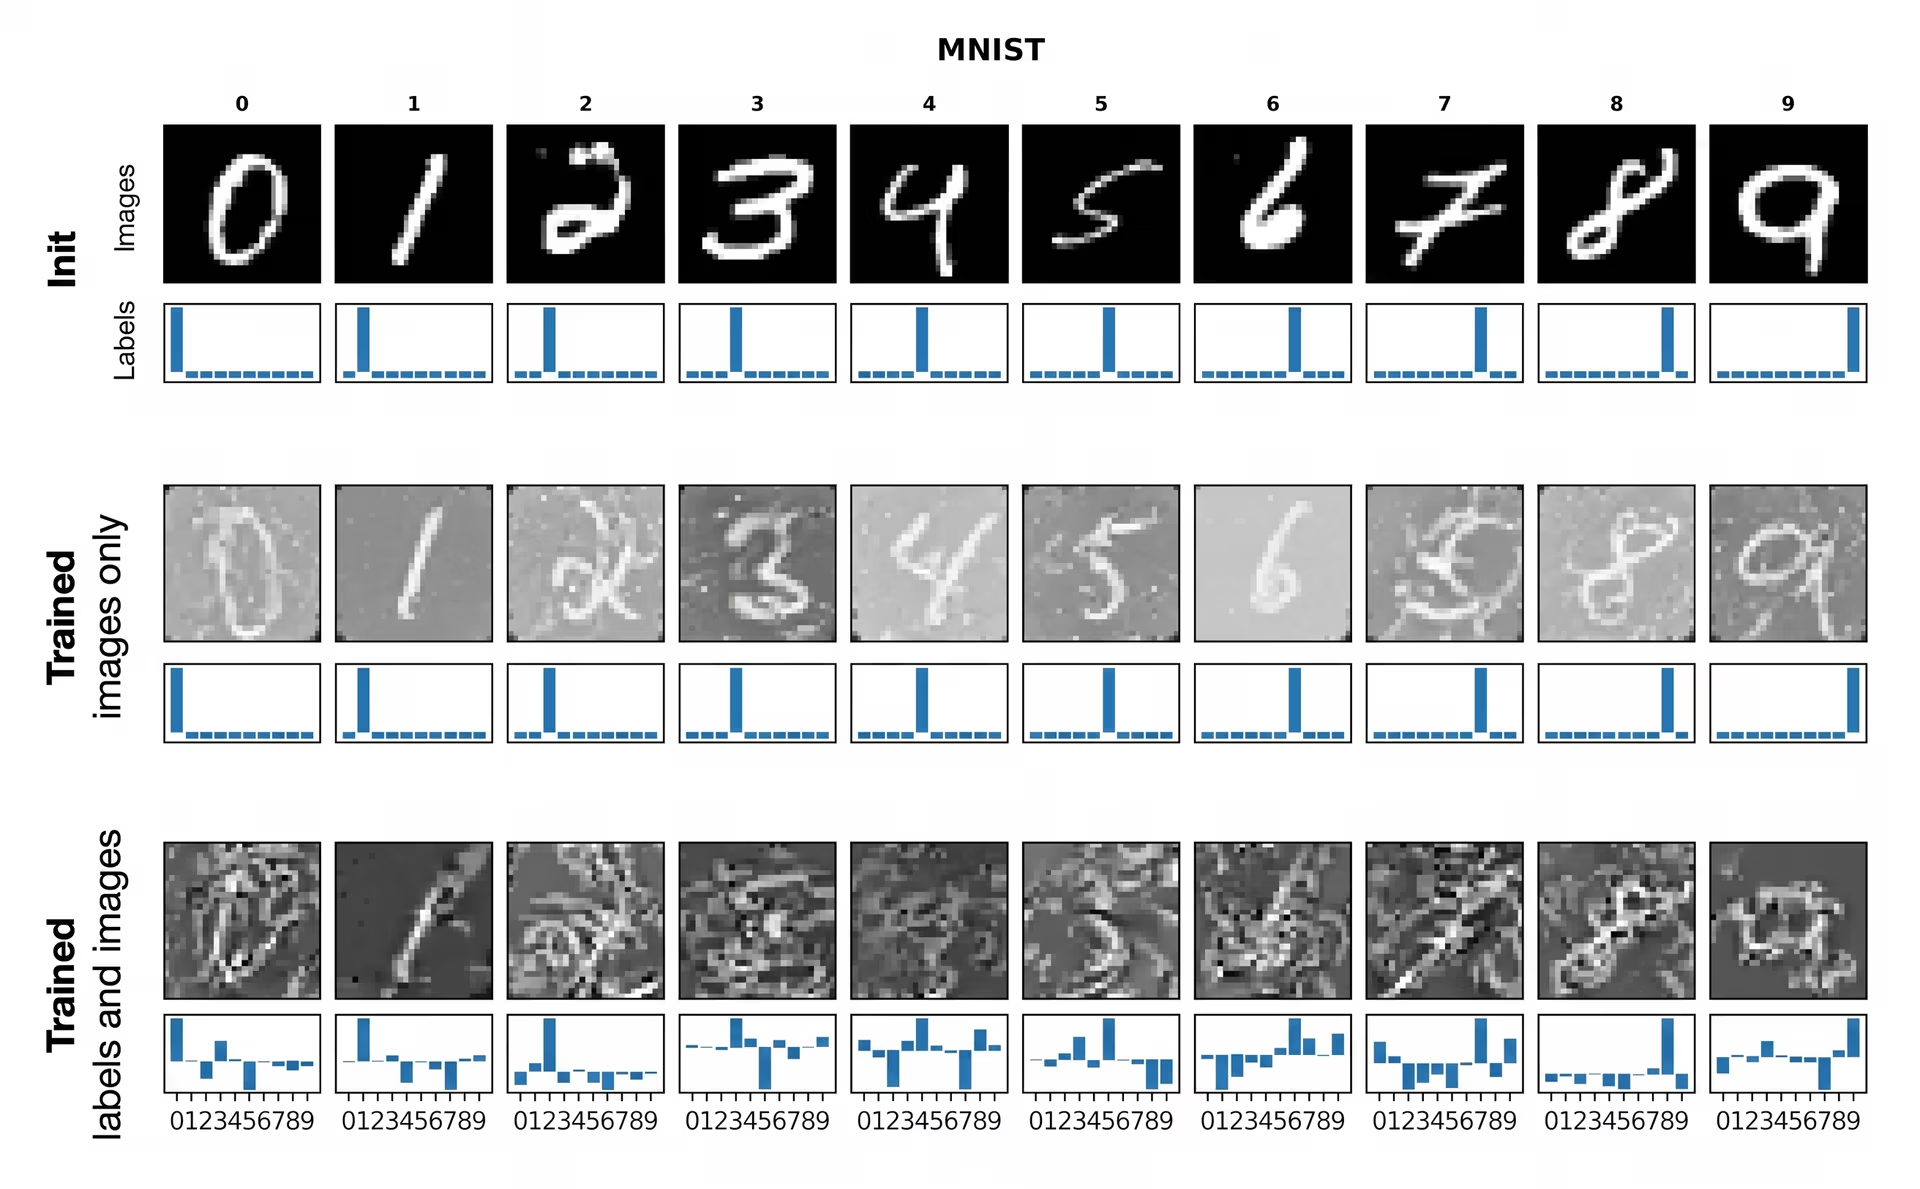
Рис. 4. Пример дистилляции набора данных (Источник)
При решении задач классификации изображений, например при анализе медицинских снимков, мониторинге дикой природы или обнаружении дефектов на производстве, моделям часто приходится искать компромисс между точностью и стоимостью обучения. Для таких задач обычно требуются огромные наборы данных.
Дистилляция набора данных позволяет сжать исходную обучающую выборку до небольшого количества синтетических изображений, в которых сохраняются самые важные визуальные признаки для классификатора. На крупных бенчмарках, таких как ImageNet, было показано, что дистиллированные наборы, содержащие лишь около 4,2% исходных изображений, сохраняют высокую точность классификации. Это значит, что крошечный синтетический набор может заменить миллионы реальных примеров, требуя гораздо меньше вычислений.
Поиск архитектуры нейронной сети#
Поиск нейросетевых архитектур, или NAS, — это метод автоматического исследования множества возможных архитектур нейронных сетей для поиска оптимальной для конкретной задачи. Поскольку NAS необходимо обучать и оценивать большое количество моделей-кандидатов, работа с полными наборами данных может быть медленной и требовать значительных вычислительных ресурсов.
Дистилляция набора данных помогает создать небольшой синтетический обучающий набор, который сохраняет основной обучающий сигнал исходных данных. Благодаря этому каждую архитектуру-кандидата можно проверить гораздо быстрее. Так NAS может эффективно сравнивать архитектуры и при этом достаточно надёжно ранжировать удачные и неудачные варианты. Это снижает стоимость поиска, практически не ухудшая итоговое качество модели.
Непрерывное обучение и развёртывание на периферийных устройствах#
Системы непрерывного обучения, то есть модели, которые обновляются по мере поступления новых данных, а не обучаются один раз, нуждаются в быстрых обновлениях с эффективным использованием памяти. У периферийных устройств, таких как камеры, телефоны и датчики, похожие ограничения: их вычислительные ресурсы и объём хранилища строго ограничены.
Дистилляция наборов данных помогает в обоих случаях: большой обучающий набор сжимается до крошечного синтетического, поэтому модели можно адаптировать или переобучать на небольшом реплей-наборе, а не на полном наборе данных. Например, исследование метаобучения на основе ядер показало, что всего 10 дистиллированных примеров позволяют добиться точности выше 64% на CIFAR-10 — стандартном бенчмарке классификации изображений. Благодаря компактности реплей-набора обновления выполняются намного быстрее и становятся практичнее, особенно когда модели нужно часто обновлять.
Дистилляцию наборов данных также можно сочетать с дистилляцией знаний для больших языковых моделей. Небольшой дистиллированный набор данных сохраняет наиболее важные сигналы задачи из модели-учителя, поэтому сжатую модель-ученика можно эффективнее обучать или обновлять почти без потери качества. Такие компактные наборы данных особенно полезны для периферийных устройств и запуска непосредственно на устройстве, где ресурсы хранения и вычислений ограничены, но после обновлений важно сохранить точность модели.
Преимущества и недостатки дистилляции данных#
Вот несколько преимуществ дистилляции наборов данных:
- Отлично подходит для быстрых экспериментов. Ты можешь проверять новые архитектуры, функции потерь или гиперпараметры, не переобучая каждый раз модель на огромном наборе данных.
- Потенциальное преимущество с точки зрения конфиденциальности. Передавать дистиллированные синтетические примеры может быть безопаснее, чем реальные пользовательские данные, поскольку исходные примеры не раскрываются напрямую.
- Часто эффективнее простого отбора подмножества. Вместо того чтобы просто выбирать примеры, дистилляция активно оптимизирует их, чтобы получить максимально информативные данные.
У дистилляции наборов данных есть несколько преимуществ, но важно учитывать и её ограничения:
- Переобучение. Дистиллированные данные часто лучше всего подходят для архитектуры, использованной при дистилляции, и могут плохо переноситься на сильно отличающиеся модели.
- Чувствительность к гиперпараметрам. Результаты могут сильно зависеть от таких факторов, как скорость обучения, инициализация или количество шагов дистилляции.
- Сложности при масштабировании для реальных задач. Методы, хорошо работающие на бенчмарках, могут терять точность на крупных, неструктурированных наборах данных или наборах с изображениями высокого разрешения.
Главные выводы#
Дистилляция набора данных позволяет небольшому набору синтетических примеров обучать модель почти так же эффективно, как полный набор данных. Это ускоряет машинное обучение, повышает его эффективность и упрощает масштабирование. По мере роста моделей и увеличения потребности в данных дистиллированные наборы данных становятся практичным способом снизить вычислительные затраты без потери точности.
Присоединяйся к нашему сообществу и загляни в наш репозиторий на GitHub, чтобы узнать больше об искусственном интеллекте. Если ты хочешь создать собственный проект в области компьютерного зрения и ИИ, ознакомься с нашими вариантами лицензирования. Узнай больше о таких направлениях, как ИИ в здравоохранении и компьютерное зрение и ИИ в розничной торговле, на страницах наших решений.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









