Bilgisayarlı görü projelerinde pekiştirmeli öğrenmeden yararlanma
Takviyeli öğrenmenin nasıl çalıştığını ve depo robotlarında, otonom araçlarda ve cerrahi robotikte bilgisayarlı görüyle nasıl eşleştiğini, ayrıca ödünleşimlerini öğren.
 Abirami Vina7 dakikalık okuma
Yapay zekâyı (AI) açıklamanın basit bir yolu, onu insanların düşünme ve öğrenme biçimini yeniden oluşturmaya odaklanan bir alan olarak tanımlamaktır. Yapay zekâdaki öğrenme teknikleri fikri buradan gelir: Bu teknikler, tıpkı insanlar gibi makinelerin de zaman içinde performanslarını iyileştirmesini sağlayan farklı yöntemlerdir.
Daha önce gözetimli, gözetimsiz, pekiştirmeli ve aktarım öğrenmesi dâhil olmak üzere temel yapay zekâ öğrenme tekniklerini ve her birinin yapay zekâ modellerinin bilgiyi işleyip karar vermesine nasıl önemli katkılar sağladığını inceledik.
Bugün, yapay zekâ sistemlerine bir ortamla etkileşime girerek deneyim yoluyla öğrenmeyi ve geri bildirimlere göre gelişmeyi öğreten bir teknik olan pekiştirmeli öğrenmeyi daha yakından inceleyeceğiz. Özellikle, pekiştirmeli öğrenmenin makinelerin dünyadaki görsel bilgileri yorumlamasını ve anlamasını sağlayan bilgisayarlı görü uygulamalarında nasıl kullanılabileceğine bakacağız.
Pekiştirmeli öğrenme ve bilgisayarlı görü gibi kavramları bir araya getirmek, heyecan verici yeni olanakların kapısını açıyor ve aktif bir araştırma alanı oluşturuyor. Bu yaklaşım, yapay zekâ sistemlerinin gördüklerini tanımasını ve görsel bilgilere dayanarak bilinçli kararlar vermesini sağlıyor.
Pekiştirmeli öğrenme nedir?#
Pekiştirmeli öğrenme, bir yapay zekâ aracısının eylemlerde bulunup ödül veya ceza biçiminde geri bildirim alarak öğrendiği bir makine öğrenmesi dalıdır. Amaç, hangi eylemlerin zaman içinde en iyi sonuçları verdiğini bulmaktır.
Pekiştirmeli öğrenmeyi bir köpeği eğitmeye benzetebilirsin. Köpek komut üzerine oturduğunda ona ödül maması verirsin. Bir süre sonra köpek, oturmanın ödül getirdiğini öğrenir. Pekiştirmeli öğrenmede yapay zekâ aracısı veya modeli köpek gibidir; çevre, etrafındaki dünyadır ve ödül, doğru bir hamle yapıp yapmadığını anlamasına yardımcı olur.
Bu, yapay zekâ modeline doğru yanıtların birçok örneğinin gösterildiği gözetimli öğrenmeden farklıdır. Örneğin modele bir köpek resmi gösterilebilir ve "Bu bir köpek." denebilir.
Öte yandan pekiştirmeli öğrenme, etiketlenmiş verilere dayanmaz. Bunun yerine farklı eylemleri deneyerek ve sonuçlardan öğrenerek ilerler; tıpkı bir oyun oynarken hangi hamlelerin kazanmana yardımcı olduğunu bulmak gibi.
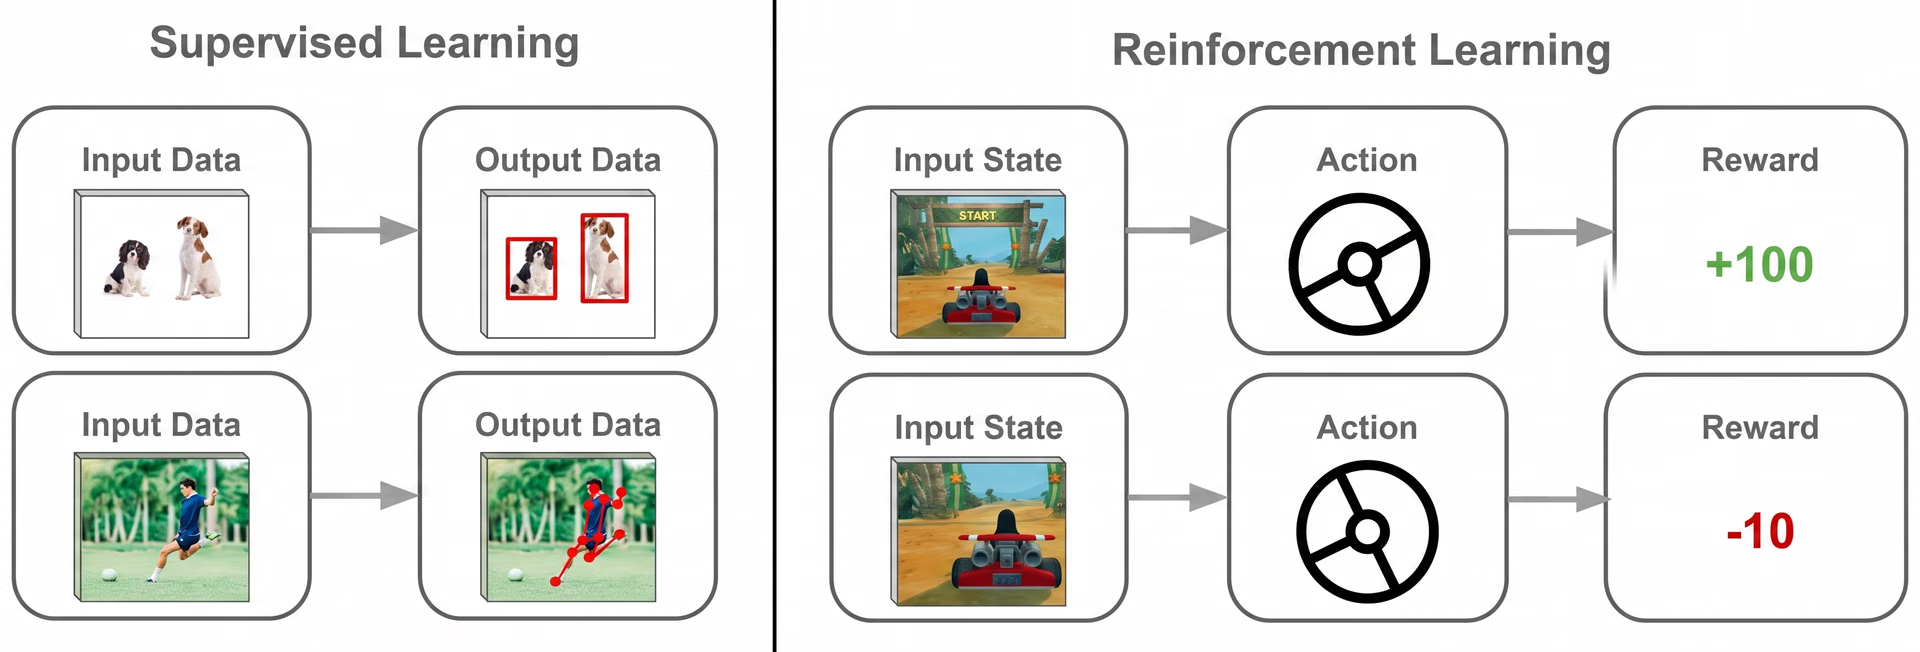
Şekil 1. Pekiştirmeli öğrenme ve gözetimli öğrenme karşılaştırması.
Pekiştirmeli öğrenme, kararların adım adım verildiği ve her seçimin sonraki gelişmeleri etkilediği görevlerde kritik öneme sahiptir. Bu öğrenme türü, oyuncular için oynanışı daha zorlu ve ilgi çekici hâle getirmek amacıyla strateji video oyunlarında kullanılır.
Yapay zekâ çözümlerinde pekiştirmeli öğrenme nasıl çalışır?#
Bisiklet sürmeyi nasıl öğrendiğini düşün. İlk başta düşebilirsin. Ancak pratik yaptıkça dengede kalmana neyin yardımcı olduğunu anlamaya başlarsın. Ne kadar çok sürersen o kadar iyi olursun. Sana ne yapman gerektiğinin söylenmesiyle değil, yaparak öğrenirsin.
Pekiştirmeli öğrenme, yapay zekâda da benzer şekilde çalışır. Deneyim yoluyla öğrenir: Farklı eylemleri dener, sonuçları gözlemler ve zaman içinde doğru seçimleri yapma becerisini kademeli olarak geliştirir.
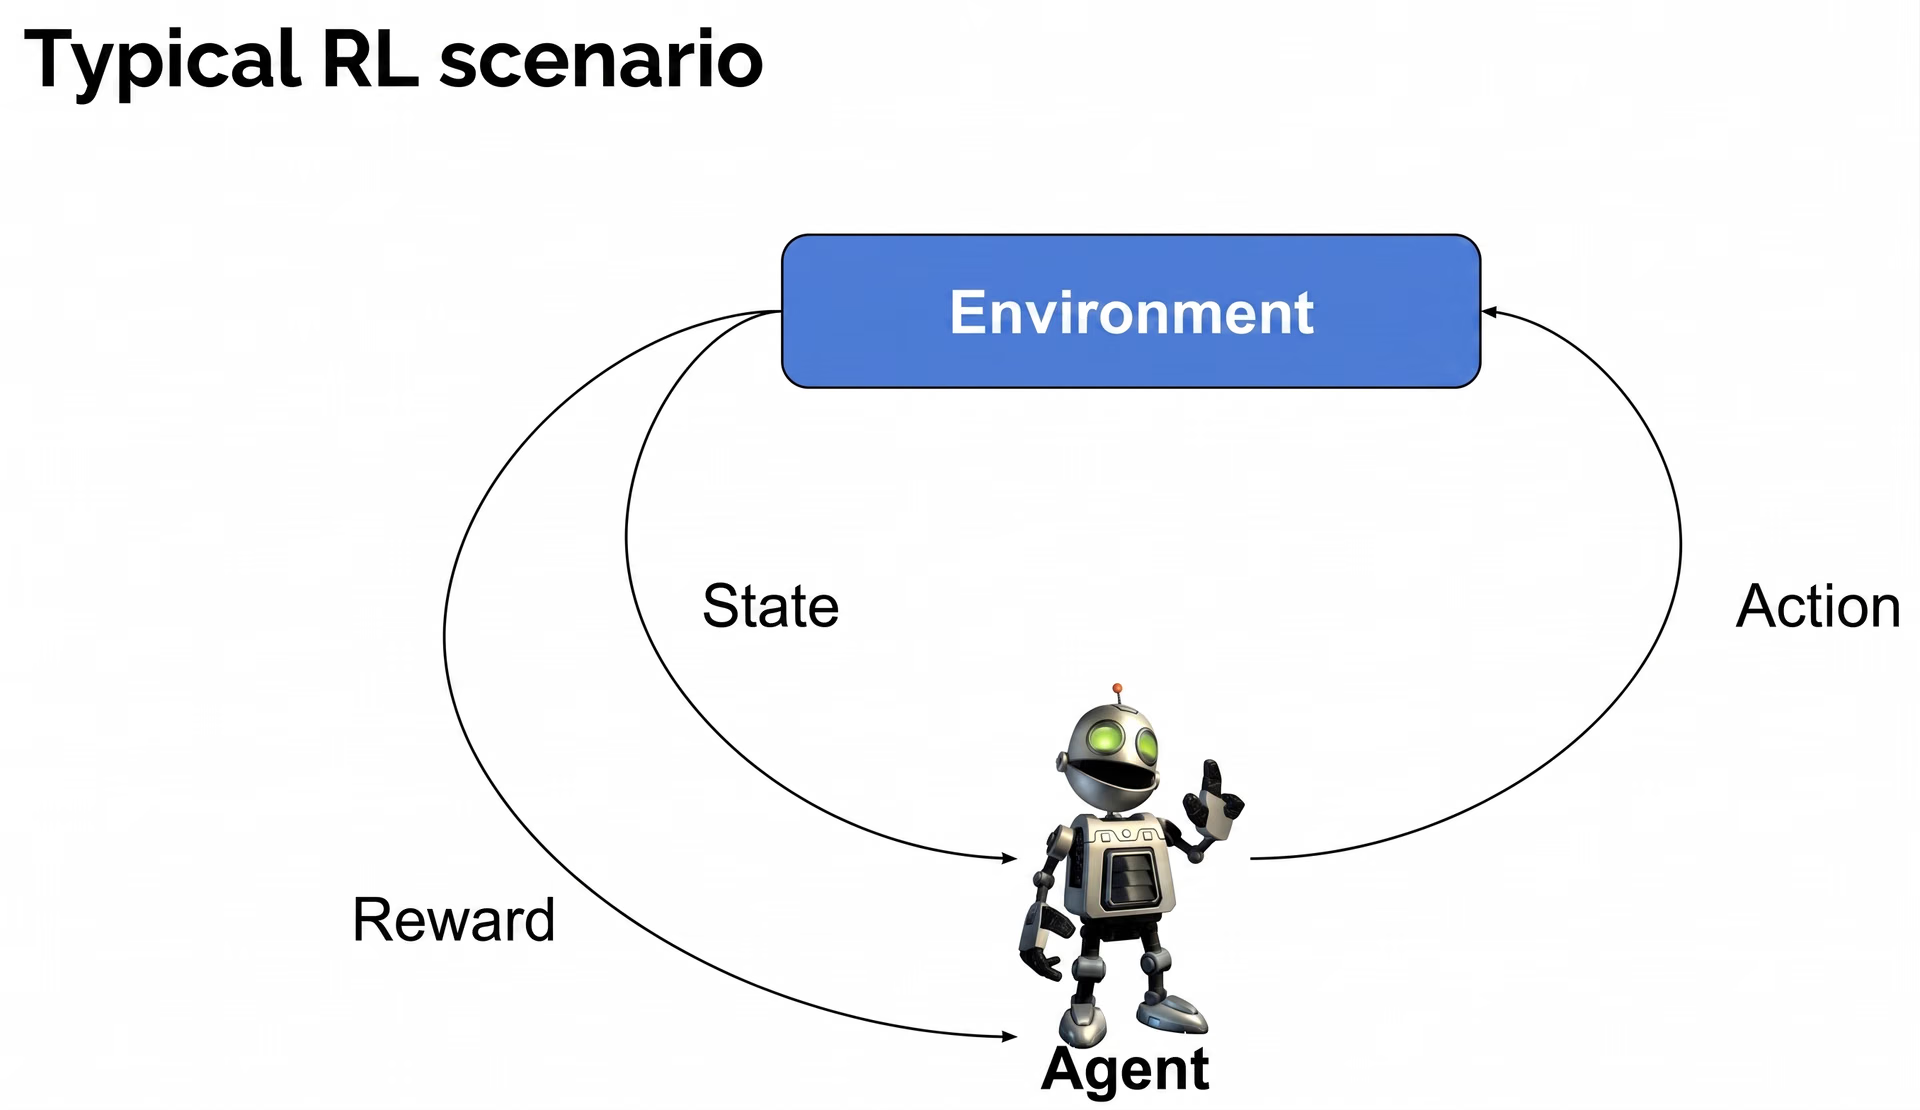
Şekil 2. Pekiştirmeli öğrenmenin nasıl çalıştığını anlama.
İşte pekiştirmeli öğrenmenin bazı temel bileşenlerine bir göz atalım:
- Ajan: Ajan, öğrenen ya da karar veren birimdir. Eylemlerde bulunarak ortamla etkileşime girer ve belirli bir hedefe ulaşmayı amaçlar.
- Ortam: Ortam, ajanın etkileşimde bulunduğu her şeyi kapsar. Ajanın eylemlerine tepki olarak değişir ve sonuçlara göre geri bildirim sağlar.
- Durum: Durum, ortamdaki mevcut koşulların anlık bir görüntüsünü temsil eder. Ajan, çevresini anlamak ve bir sonraki eylemine karar vermek için durumu gözlemler.
- Eylem: Eylem, ajan tarafından gerçekleştirilen ve ortamı etkileyen bir hareket ya da karardır. Her eylem yeni bir duruma yol açar ve gelecekteki ödülleri etkileyebilir.
- Ödül: Ödül, ajana eyleminin yararlı olup olmadığını bildiren ortam geri bildirimidir. Olumlu ödüller ajanı iyi eylemleri tekrarlamaya teşvik ederken olumsuz ödüller kötü eylemlerden kaçınmasını sağlar.
- Politika: Politika, ajanın mevcut duruma göre eylem seçme stratejisidir. Ajan, zaman içinde kazanabileceği toplam ödülü en üst düzeye çıkarmak için politikasını geliştirir.
Bu bileşenleri birlikte kullanmak, yapay zekâ sistemlerinin sürekli deneme yanılma yoluyla etkili davranışlar öğrenmesini mümkün kılar. Her denemede ajan, daha yüksek ödüllere ve daha iyi sonuçlara götüren eylemleri seçme konusunda gelişir.
Bilgisayarlı görüde pekiştirmeli öğrenme yenilikleri#
Bilgisayarlı görü; görüntülerde nesneleri algılama, bir resimde ne olduğunu sınıflandırma ve görüntüyü farklı bölümlere ayırma gibi görevlerde kullanılır. Ultralytics YOLO11 gibi bilgisayarlı görü modelleri bu görevleri destekler ve görsel içgörüler elde edebilen etkili uygulamalar geliştirmek için kullanılabilir.
Ancak bu görsel yapay zekâ görevleri pekiştirmeli öğrenmeyle birleştirildiğinde ortaya yalnızca gören değil, görsel içgörülere dayanarak nasıl davranacağını da öğrenen ve zaman içinde gelişen bir yapay zekâ çözümü çıkar.
Bilgisayarlı görü uygulamalarında pekiştirmeli öğrenmenin ilginç bir örneği, depolardaki robotların kullanılmasıdır. Kamera ve bilgisayarlı görü sistemleriyle donatılan robotlar çevrelerini analiz edebilir, her bir öğenin konumunu algılayabilir, şeklini ve boyutunu belirleyebilir ve rafta nasıl durduğunu anlayabilir.
Robot bir öğeyi her almaya çalıştığında geri bildirim alır: Öğe doğru şekilde alınırsa başarılı, düşürülürse başarısız olur. Zamanla robot, farklı öğeler için hangi eylemlerin en iyi sonucu verdiğini öğrenir. Sabit bir talimat kümesini izlemek yerine deneyim yoluyla sürekli gelişir.
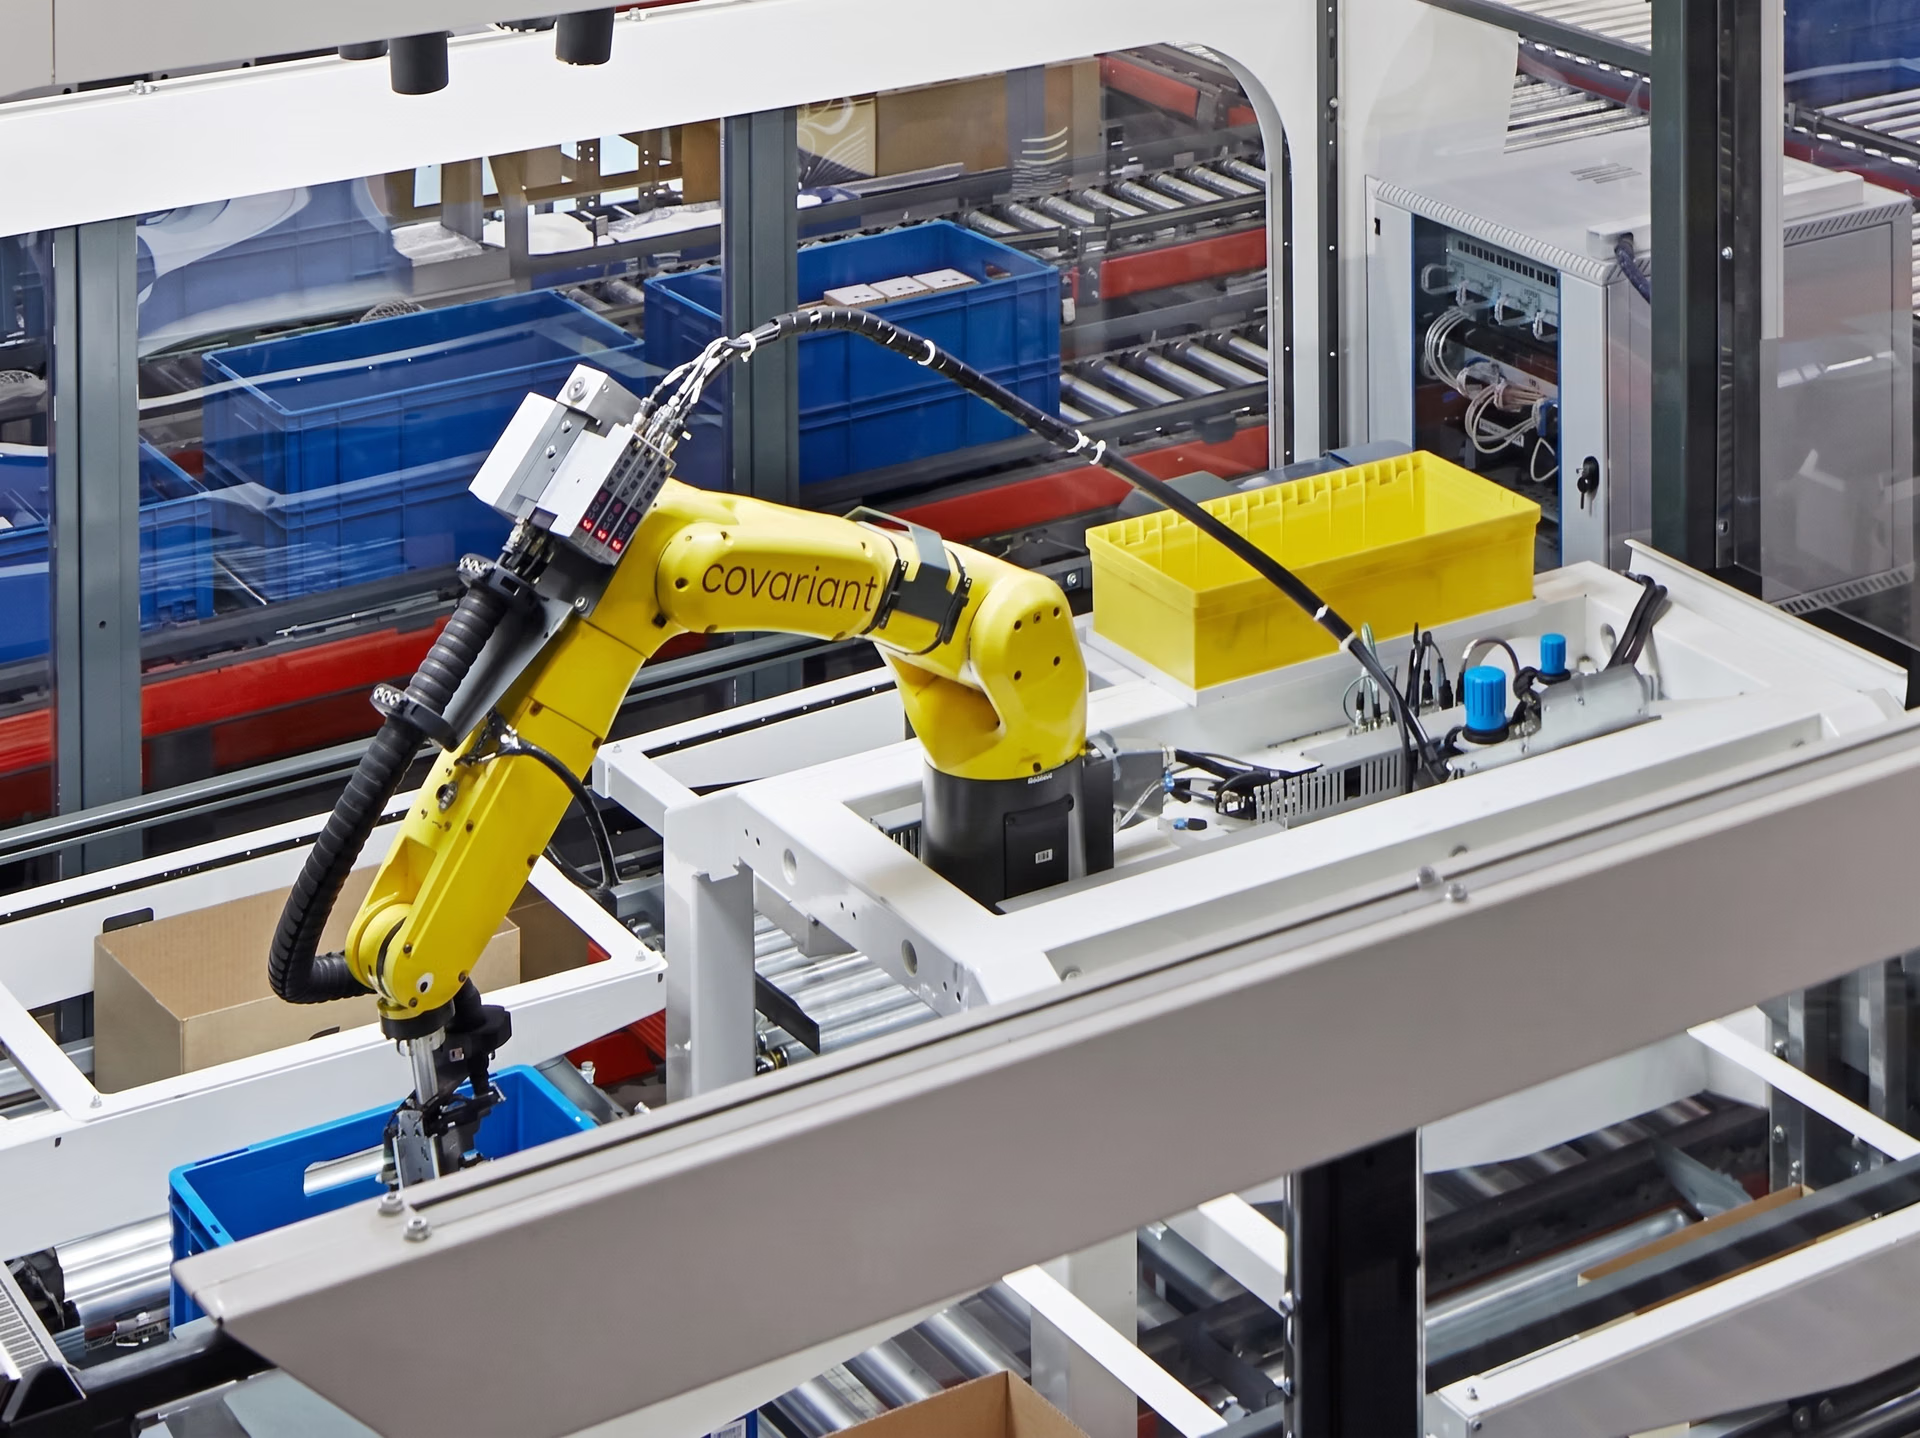
Şekil 3. Nesneleri almak için görsel AI ve pekiştirmeli öğrenme kullanan robotik kol.
Bilgisayarlı görüde pekiştirmeli öğrenme uygulamaları#
Pekiştirmeli öğrenmenin ne olduğunu ve bilgisayarlı görüdeki rolünü artık daha iyi anladığımıza göre, pekiştirmeli öğrenme ile bilgisayarlı görünün birlikte kullanıldığı örneklere daha yakından bakalım.
Daha akıllı araçlar için Görsel AI ve pekiştirmeli öğrenmeyi bir araya getirmek#
Otonom araçlar, çevrelerini anlamak için görsel yapay zekâya ve gördüklerine dayanarak karar vermek için pekiştirmeli öğrenmeye başvurabilir. Bunun uygulamadaki harika bir örneği AWS DeepRacer'dır.
AWS DeepRacer, kamera ve pekiştirmeli öğrenme kullanarak sürüş yapmayı öğrenen, 1/18 ölçekli tamamen otonom bir yarış arabasıdır. Kendisine ne yapacağının söylenmesi yerine deneyerek, hata yaparak ve bu hatalardan öğrenerek kendi başına çözüm bulur.
Bu minik arabanın kamerası bir çift göz gibi çalışır ve önündeki pisti görüntüler. Araba, gördüklerine dayanarak nasıl yönlendireceğini ve ne kadar hızlı gideceğini öğrenir. Her turda daha iyi hale gelir. Örneğin, geçmiş denemelerinden öğrenerek daha geniş dönüşler yapmayı ya da keskin virajlardan önce yavaşlamayı öğrenebilir.
DeepRacer eğitimi, modelin sürüş becerilerini uyguladığı ve geliştirdiği sanal bir ortamda başlar. Belirli bir performans düzeyine ulaştığında bu beceriler, fiziksel arabaların kullanıldığı gerçek pistlere aktarılır.
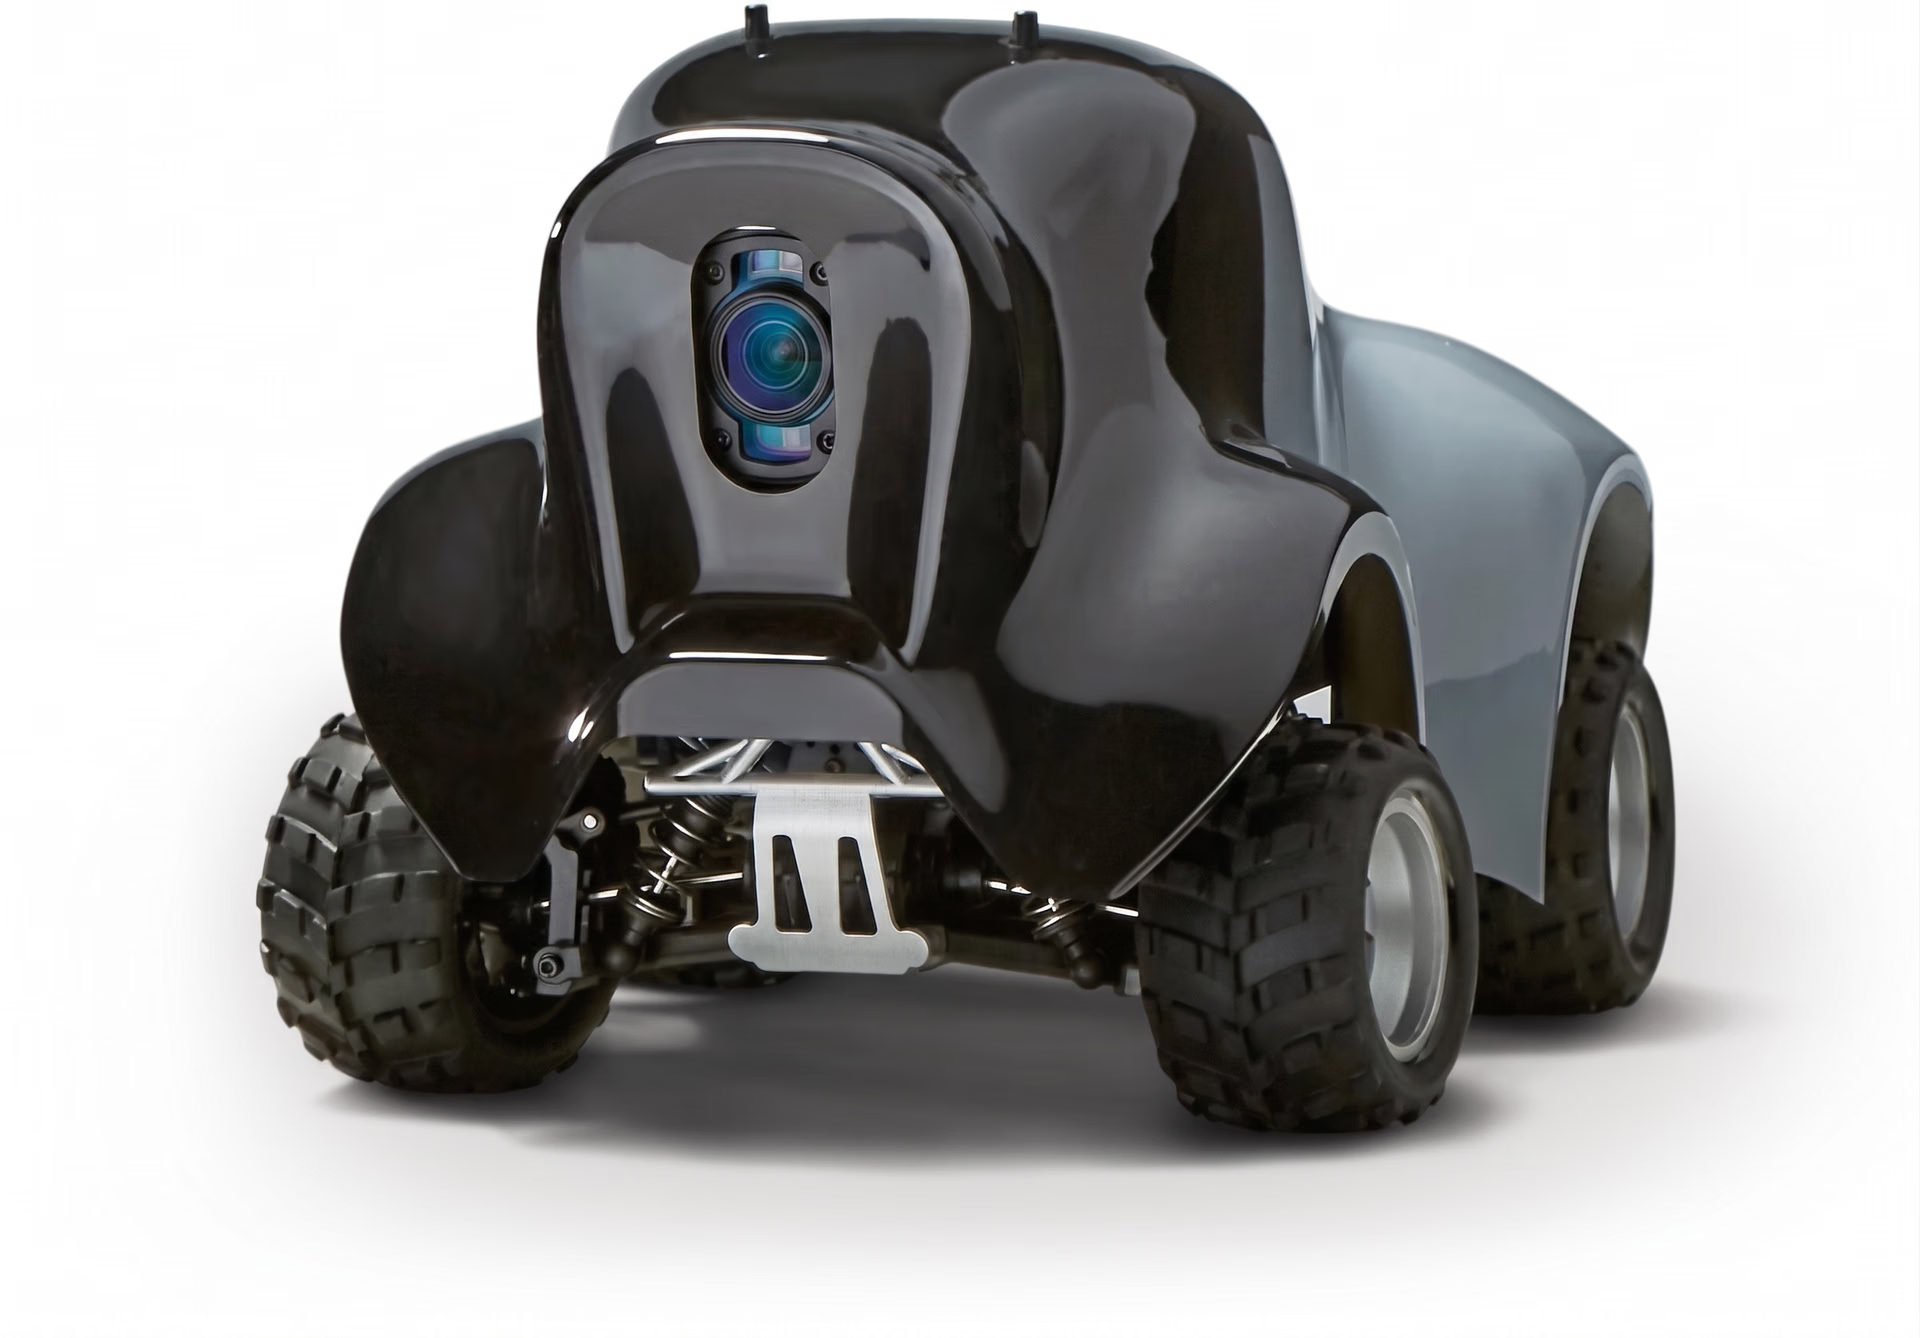
Şekil 4. AWS DeepRacer otonom sürüş için görsel ve pekiştirmeli öğrenme kullanıyor. Görsel kaynağı: Amazon.
Otonom cerrahi robotlara doğru#
Dikkat çeken heyecan verici araştırma alanlarından biri, görsel yapay zekâ ile pekiştirmeli öğrenmenin robotik cerrahide birleştirilmesidir. Şu anda bu uygulama büyük ölçüde teorik aşamadadır. Araştırmacılar sanal ortamlarda simülasyonlar yürütüyor.
Ancak ilk deneyler umut verici sonuçlar gösteriyor. Bu sonuçlar, cerrahi robotların zamanla daha yüksek hassasiyetle, uyum sağlama becerisiyle ve en az düzeyde insan müdahalesiyle karmaşık, hassas işlemler gerçekleştirebileceğine işaret ediyor.
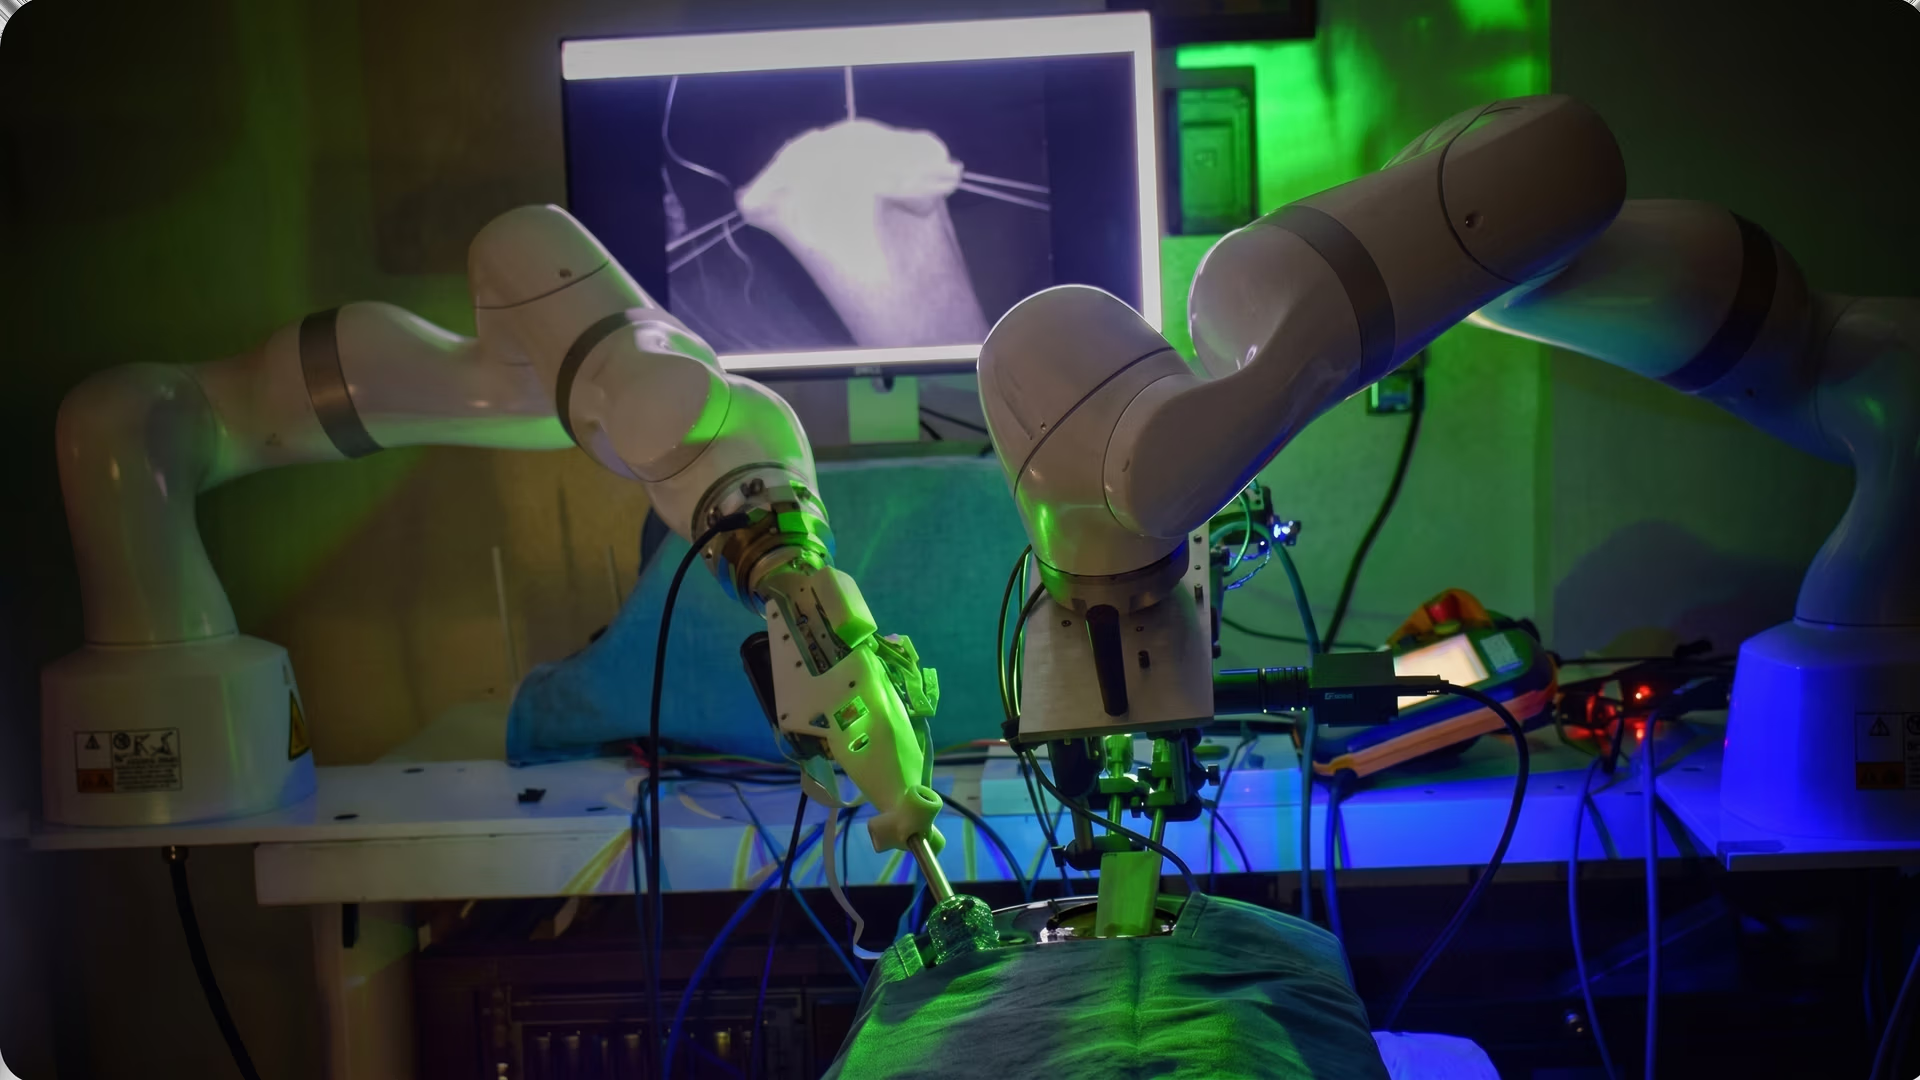
Şekil 5. Cerrahi robotlar giderek daha da gelişmiş hale geliyor.
Örneğin, bir cerrahi bölgeden gazlı bez parçasının dikkatlice kaldırılması gerektiğini düşün. Görsel yapay zekâyla donatılmış bir robot, önce sahneyi analiz ederek gazlı bezi ve çevresindeki dokuları bölütleme yoluyla belirler.
Pekiştirmeli öğrenme, cerrahi robotun göreve nasıl yaklaşacağına karar vermesine yardımcı olur; gazlı bezi kavramak için en uygun açıyı, ne kadar basınç uygulayacağını ve yakındaki hassas bölgelere dokunmadan nasıl kaldıracağını belirler. Zamanla ve simülasyon ortamlarında tekrarlanan alıştırmalarla robot, bu ince ve kritik hareketleri giderek daha yetkin ve güvenli biçimde gerçekleştirmeyi öğrenebilir.
Görsel AI'da pekiştirmeli öğrenmenin artıları ve eksileri#
Pekiştirmeli öğrenme, görsel yapay zekâ sistemlerinin basit tanımanın ötesine geçip gördüklerine dayanarak karar vermeye başlamasını sağlar. Bu da robotik, otomasyon ve gerçek zamanlı etkileşim gibi alanlarda yeni olanaklar sunar.
Pekiştirmeli öğrenmeyi görsel yapay zekâ iş akışlarına entegre etmenin temel avantajlarından bazıları şunlardır:
- Etiketli verilere daha az bağımlılık: Bu sistemler etkileşim yoluyla öğrenebilir; dolayısıyla işe başlamak için çok büyük etiketli veri kümelerine ihtiyaç duymaz.
- Belirsizliği daha iyi yönetir: Pekiştirmeli öğrenme, yalnızca kusursuz verilere güvenmek yerine geri bildirime göre eylemleri ayarlayarak eksik ya da gürültülü görsel bilgilerle başa çıkabilir.
- Uzun vadeli öğrenmeyi destekler: Modellerin yalnızca tek adımlı kararlardan değil, eylem dizilerinden öğrenerek zaman içinde gelişmesine yardımcı olur.
Öte yandan, pekiştirmeli öğrenmenin göz önünde bulundurman gereken bazı sınırlamaları şunlardır:
- Katkı atama problemi: Özellikle uzun karar dizilerinde, ajanın nihai sonuca hangi belirli eylemlerin katkıda bulunduğunu anlaması zor olabilir.
- Güvenli olmayan keşif riski: Eğitim sırasında ajan, sağlık hizmetleri ya da otonom sürüş gibi gerçek dünya uygulamalarında kabul edilemeyecek güvenli olmayan veya istenmeyen eylemleri deneyebilir.
- Yavaş yakınsama: Modelin iyi bir performansa gerçekten ulaşması uzun zaman alabilir; bu, özellikle karmaşık görevler için geçerlidir.
Önemli çıkarımlar#
Bilgisayarlı görü projelerinde pekiştirmeli öğrenme, AI sistemlerinin çevrelerini anlamasını ve deneyim yoluyla nasıl hareket edeceklerini öğrenmesini sağlar. Gerçek zamanlı nesne algılama sağlayan Ultralytics YOLO11 gibi modellerle sistem, gördüklerine dayanarak bilinçli kararlar verebilir.
Bu yaklaşım, yapay zekânın yalnızca etiketli verilere güvenmek yerine deneme ve geri bildirim yoluyla gelişmesini sağlayarak geleneksel yöntemlerin ötesine geçer. Sürekli öğrenmeyi destekler ve zaman içinde gelişen daha esnek, uyarlanabilir ve akıllı görsel yapay zekâ sistemleri oluşturmaya yardımcı olur.
Büyüyen topluluğumuza katıl. Yapay zekâyı daha derinlemesine incelemek için GitHub depomuzu ziyaret et. Kendi bilgisayarlı görü projelerine başlamak mı istiyorsun? Lisans seçeneklerimizi keşfet. Çözümler sayfalarımızda üretimde yapay zekâ ve otomotiv sektöründe görsel yapay zekâ hakkında daha fazla bilgi edin.
Yazan
İçerik Üreticisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









