如何针对实例分割自定义训练 Ultralytics YOLO26
了解如何针对实例分割自定义训练 Ultralytics YOLO26:模型使用像素级掩码识别并分离每个独立目标。
得益于近期的技术进步,许多在生活中默默发挥重要作用的智能系统都由 AI 驱动。例如,汽车闯红灯时摄像头会自动记录违章,或者生产线上的自动化质量检测系统发现制造缺陷,背后都有 AI 在发挥作用。
其中,称为计算机视觉的 AI 分支让机器能够解读并理解图像和视频。计算机视觉使系统能够实时识别目标、跟踪运动并分析视觉细节,因此对于交通监控、工业检测和机器人等应用至关重要。
这些能力得益于计算机视觉模型,例如支持多种视觉任务(包括目标检测和实例分割)的 Ultralytics YOLO26。目标检测使用简单的边界框识别目标,而实例分割更进一步,能够在像素级勾勒每个目标的轮廓,从而在真实场景中实现更准确、可靠的结果。
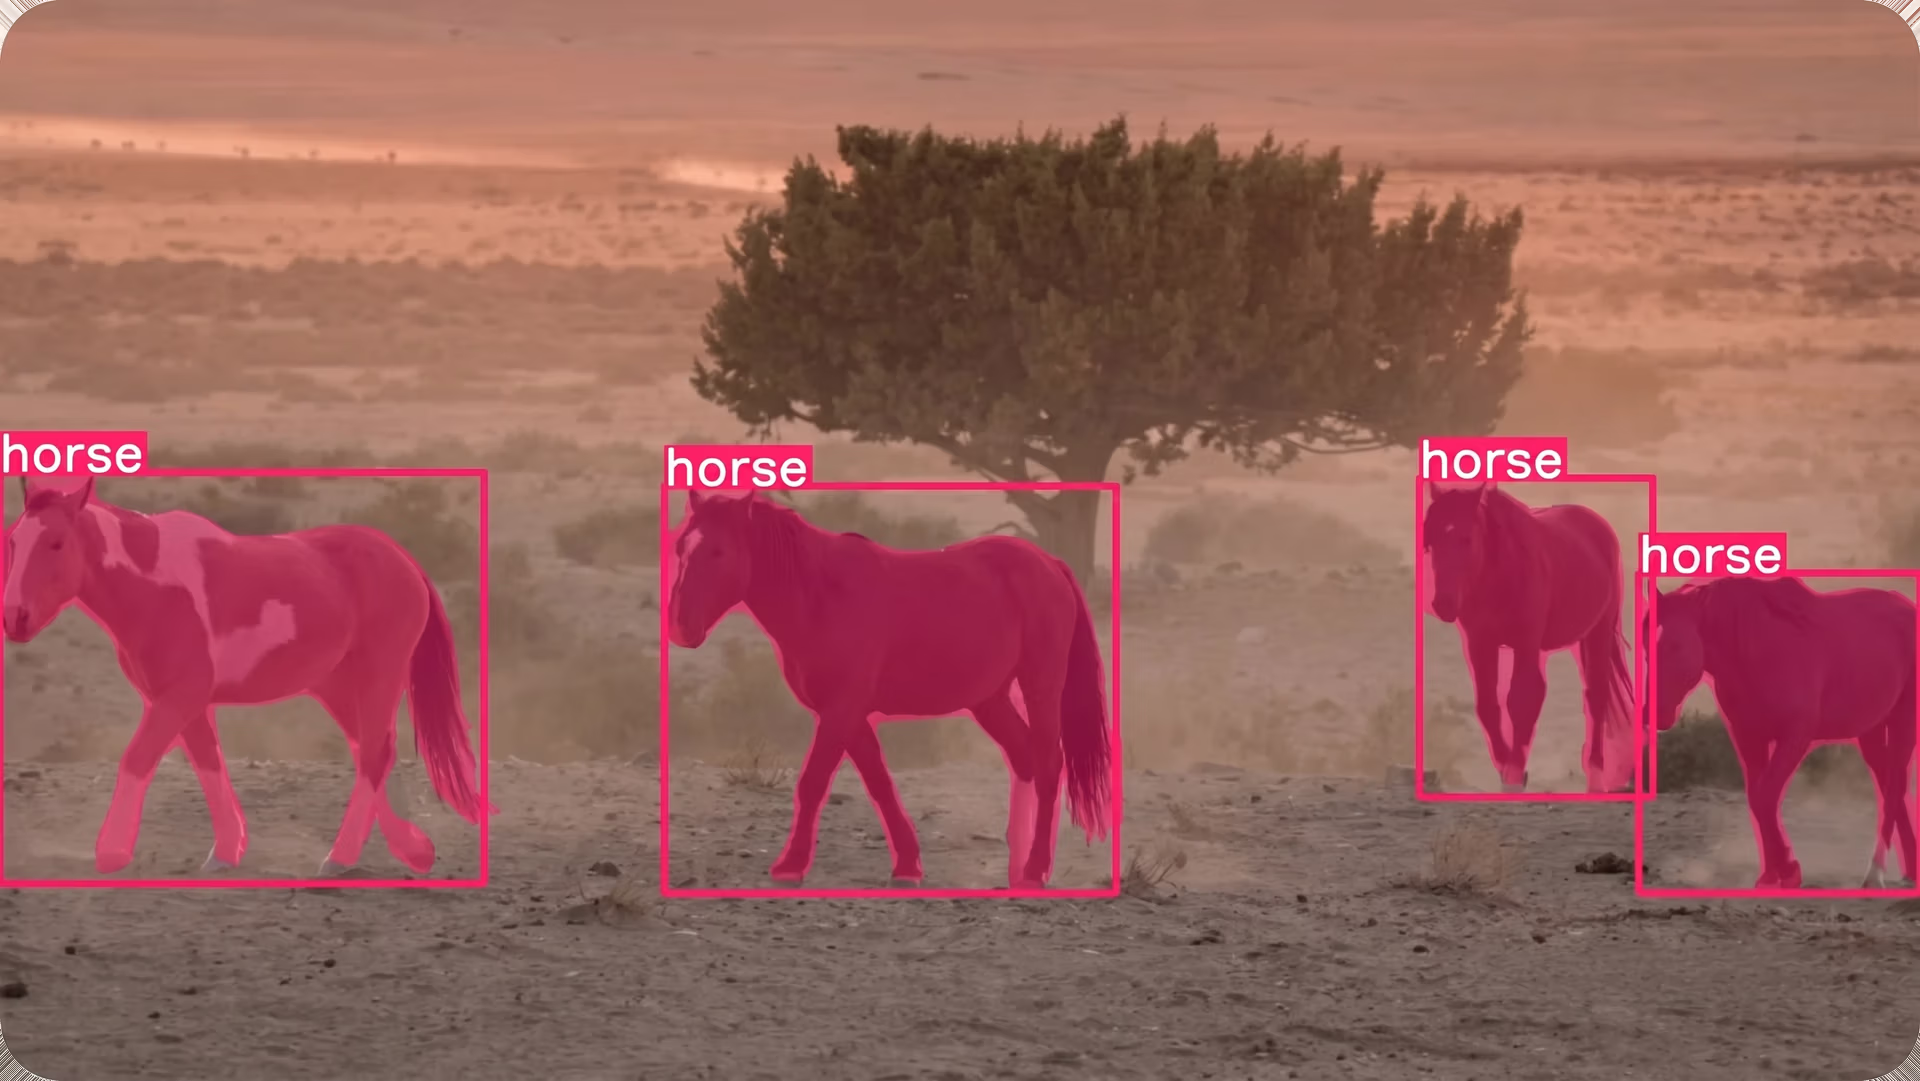
图 1. 使用 Ultralytics YOLO26 分割图像中的目标
Ultralytics YOLO26 等模型经过预训练,可以开箱即用地分割人物、汽车和动物等常见目标。不过,针对更具体的应用,你也可以对模型进行自定义训练。换句话说,模型可以学习识别目标的外观,并准确勾勒其轮廓。
本文将介绍如何针对实例分割对 Ultralytics YOLO26 进行自定义训练。现在开始吧!
什么是实例分割?#
在深入了解模型训练之前,我们先退一步,了解实例分割究竟是什么。
实例分割是一项计算机视觉任务,可让模型找到图像中的每个独立目标,并勾勒出其精确形状。模型不仅要识别目标是否存在,还会检查图像中的每个像素,并判断该像素是否属于某个特定目标。
这意味着,即使目标彼此重叠或距离很近,模型也能将它们区分开来。帮助我们直观理解实例分割的一个关键概念是掩码。
掩码是一个像素级轮廓,只覆盖目标所在的区域。你可以把它想象成用荧光笔给目标涂色,同时让其他部分保持原样。
每个目标都有自己的掩码,因此模型能够区分不同目标,即使它们属于同一类别,例如两辆汽车或站在一起的两个人。
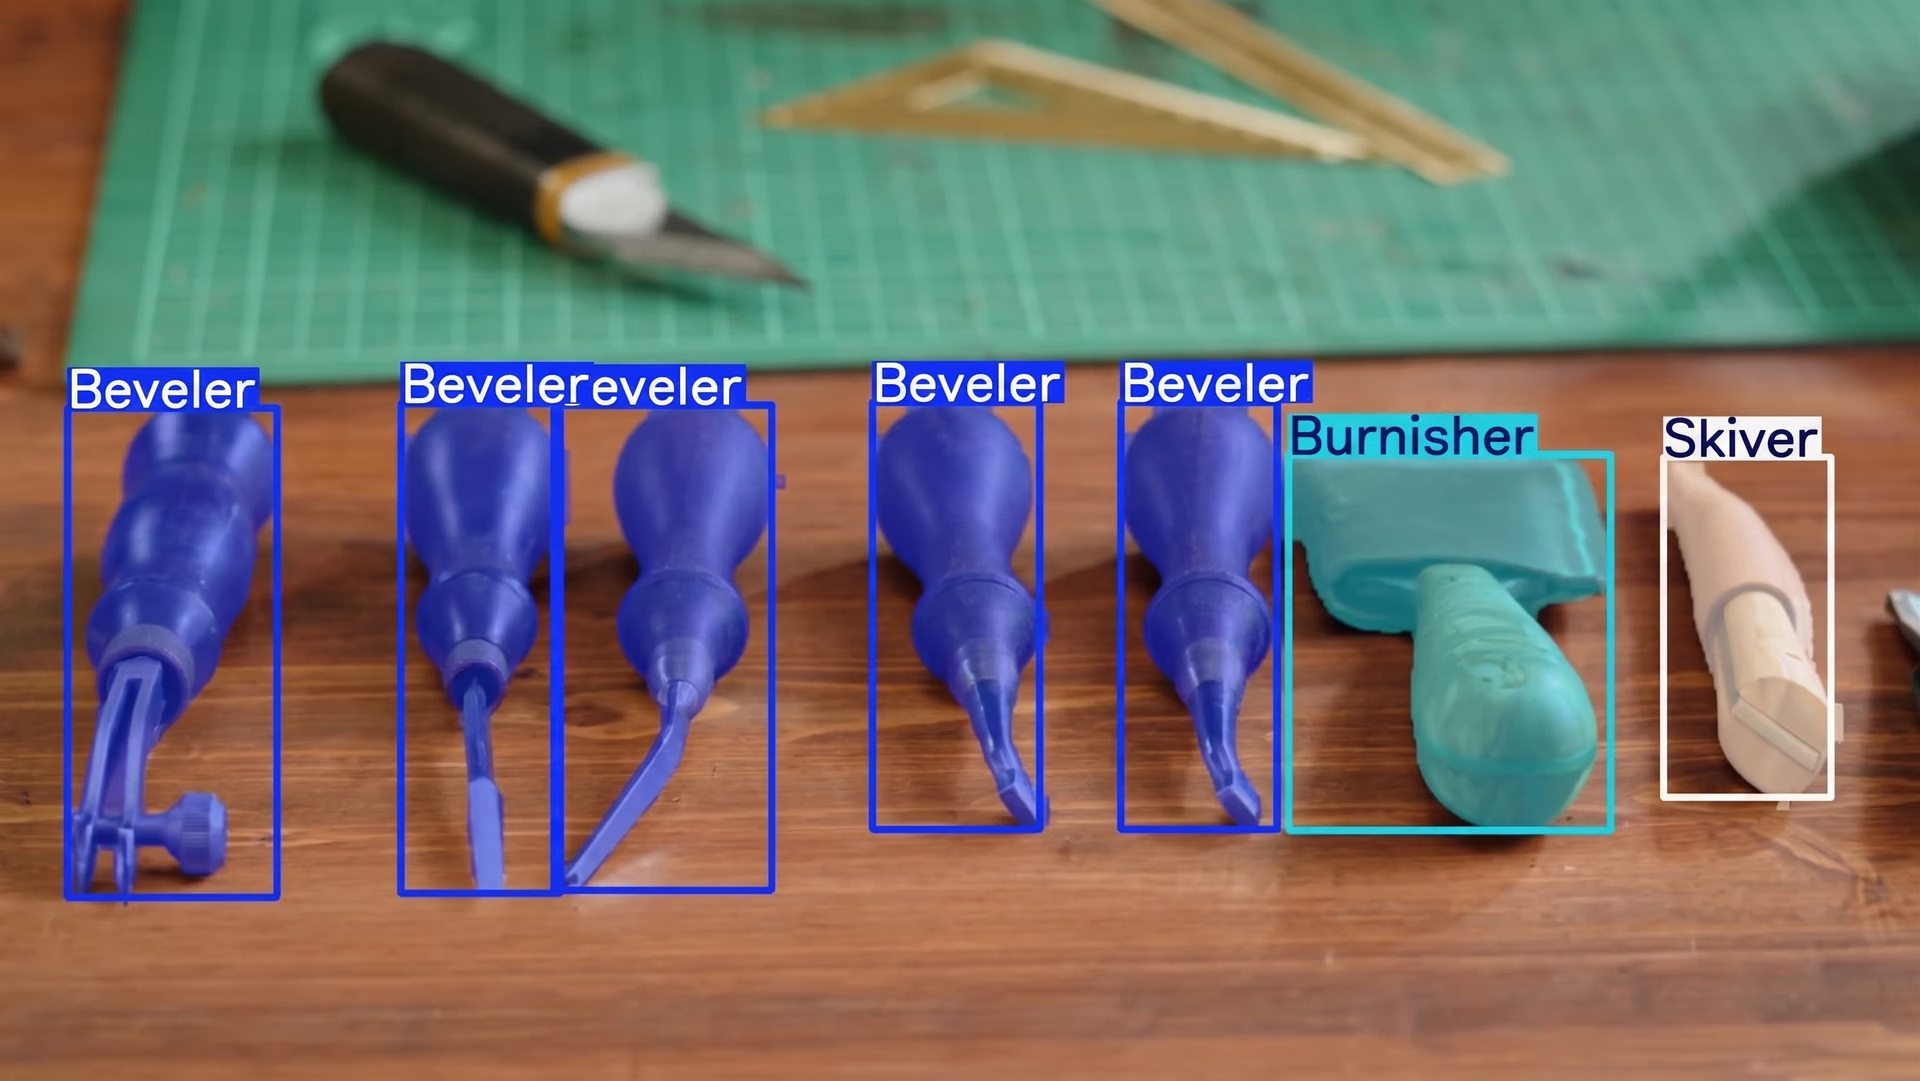
图 2. 实例分割一览
为了更好地理解实例分割,我们可以将它与其他常见的计算机视觉任务进行比较。目标检测使用边界框,也就是绘制在目标周围的简单矩形。边界框速度快、实用,但无法呈现目标的精确形状。
语义分割则会按类别标注图像中的每个像素,但无法区分同一类别中的不同目标。实例分割结合了这两种方法的优点:既能识别目标类别,又能为每个独立目标分配单独的掩码。
实例分割能提供如此详细的信息,因此在自动化质量检测、医学影像和机器人等真实应用场景中特别有用。需要精确测量、准确边界或区分目标的任务,都能受益于这种像素级理解能力。
Ultralytics YOLO26 支持实例分割#
Ultralytics YOLO26 是一款端到端、无需非极大值抑制 (NMS) 的先进计算机视觉模型,专为快速、高效地处理真实场景中的视觉任务而设计。它属于 Ultralytics YOLO 检测模型系列,可实时处理图像和视频,同时提供准确结果。
Ultralytics YOLO26 在单一框架中支持多种视觉任务,包括目标检测、姿态估计、图像分类、有向边界框检测 (obb detection) 和实例分割。
Ultralytics YOLO26 开箱即用,已经过预训练,这意味着它已从 COCO 和 ImageNet 等大型、广泛使用的数据集中学会识别人物、车辆和日常用品等常见目标。你无需额外训练即可立即使用该模型。
不过,如果你的应用涉及独特目标、特定环境或特殊光照条件,自定义模型训练可以显著提升效果。使用你自己标注的图像训练 Ultralytics YOLO26,可以教会模型准确识别需要关注的内容,并针对特定用例更精确地勾勒目标轮廓。
这个过程也称为微调。微调并非从头开始训练模型,而是以预训练的 Ultralytics YOLO26 模型为基础,使用你自己的数据对其进行适度调整。由于模型已经理解边缘、形状和纹理等通用视觉模式,因此只需少量标注图像和更短的时间,就能学会识别你的特定目标。
简单来说,与从头开始训练模型相比,微调速度更快、效率更高,也更易上手。即使是初学者,或数据和计算资源有限的团队,对 Ultralytics YOLO26 进行自定义训练也很实用。
探索 Ultralytics YOLO26 实例分割的应用#
那么,实例分割在哪些场景中能发挥作用?当区分目标并理解其精确形状十分重要时,尤其是在目标密集或彼此重叠的情况下,它就很有用。
以下是实例分割能带来显著效果的一些常见工作流:
- 航拍和无人机成像:这项任务使无人机能够在航拍图像中区分建筑物、车辆和植被等目标,用于制图、检查和测绘。
- 体育分析:实例分割可以在比赛或训练期间将运动员与背景区分开来,帮助分析运动员的移动和互动。
- 建筑与基础设施监控:它有助于识别建筑物、桥梁和道路中的结构构件、裂缝或受损区域,为维护规划提供支持。
- 医疗保健与医学影像:实例分割可以精确勾勒细胞、组织或医疗器械的轮廓,帮助提高分析和诊断的准确性。
- 农业与环境监测:它可以识别并区分作物、水果或植物病害,从而更轻松地估算产量并实施有针对性的处理。
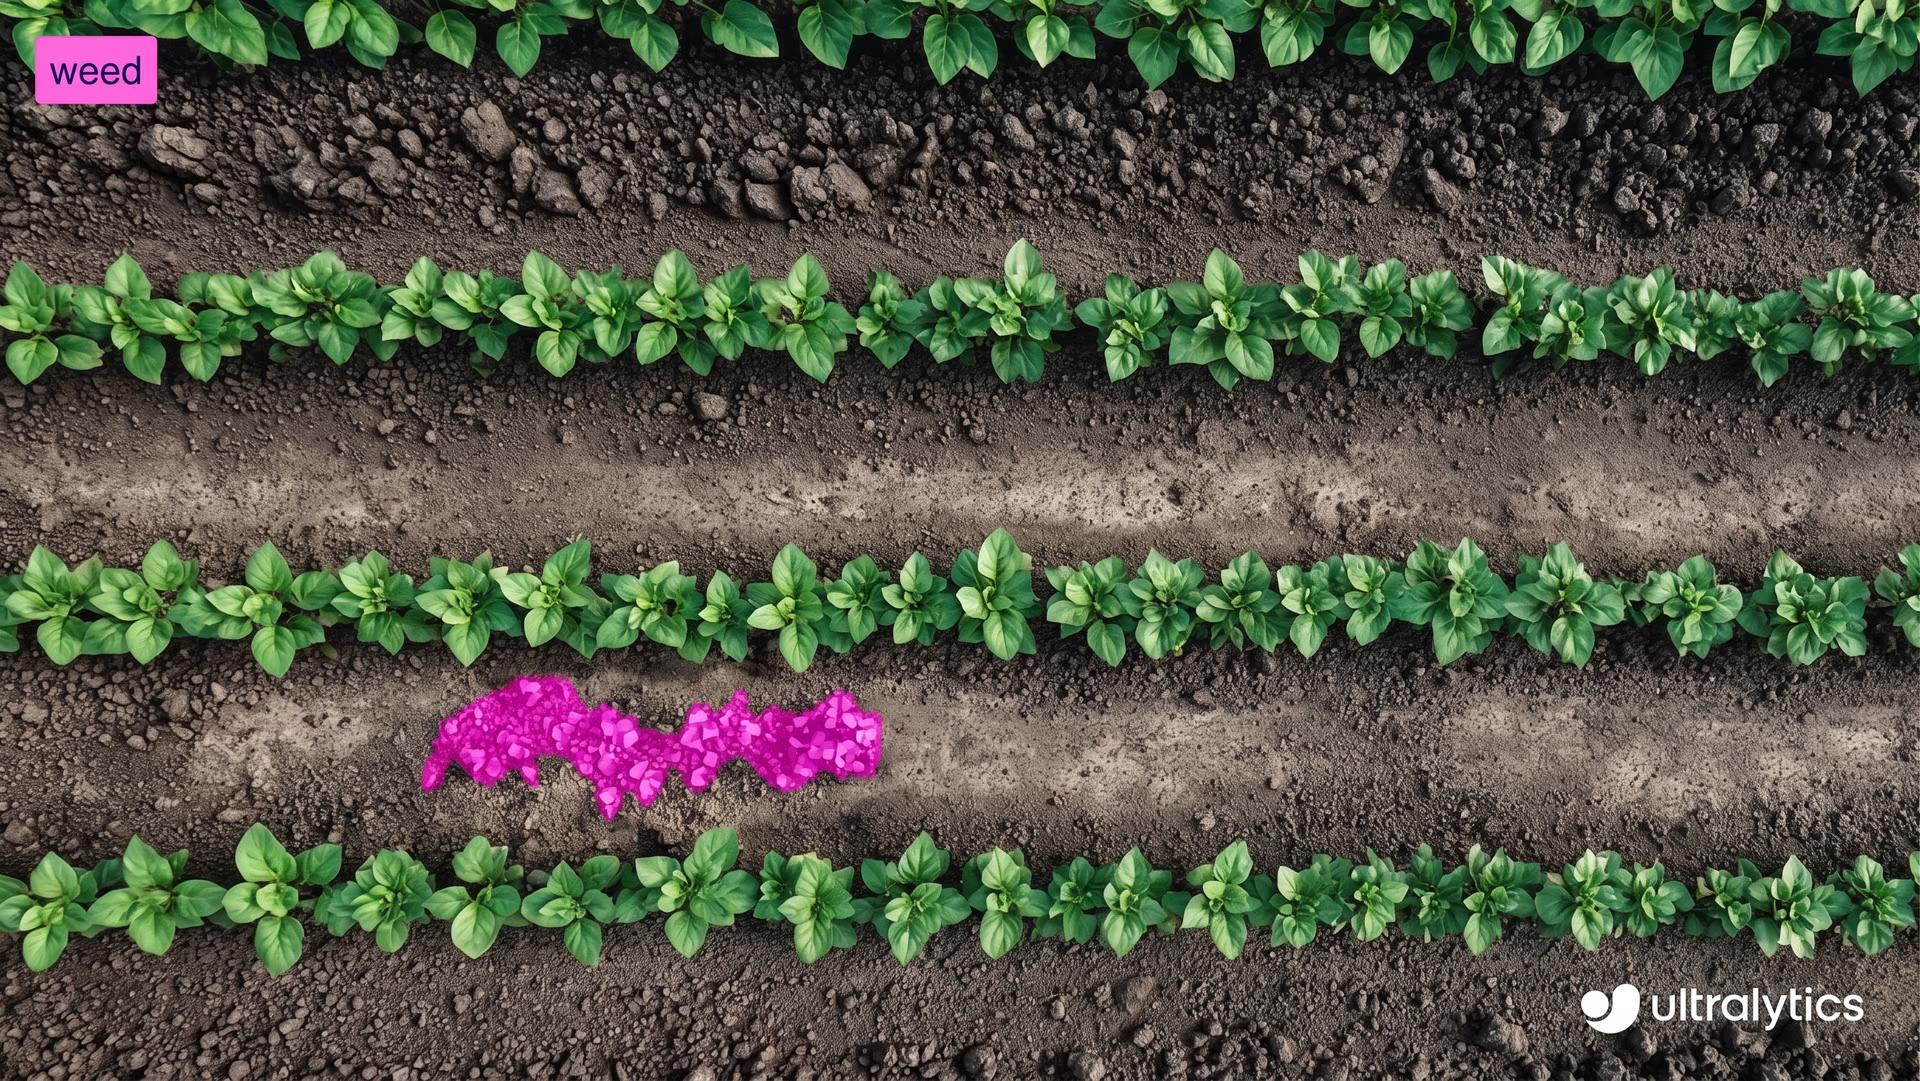
图 3. 使用 YOLO26 分割杂草的示例(来源)
Ultralytics YOLO26 实例分割自定义训练的工作原理#
接下来,我们来看看自定义训练的工作原理。模型训练听起来可能很专业,但整个过程其实很简单。
你可以准备图像、标注希望模型学习的目标、配置一个小型设置文件,然后使用 Ultralytics Python 软件包训练 YOLO26。Ultralytics Python 软件包是一个软件库,提供开箱即用的工具,用于训练、测试和部署 YOLO 模型,无需从头开始构建所有内容。
第 1 步:准备自定义数据集#
第一步是准备你的自定义分割数据集。数据集就是一组图像,用来展示你希望模型学习识别的对象。
尽量纳入能反映真实世界情况的图像,例如不同角度、光照、背景和对象尺寸。图像越多样,模型的表现就越好。
实例分割还需要为图像添加标注。标注是指为每张图像中的对象添加标签,让模型知道要学习什么。你需要围绕每个对象绘制详细的轮廓(多边形),标出对象的精确形状,而不是只画简单的框。这些轮廓会成为模型学习预测的掩码。
你可以使用多种开源标注工具来创建这些标签。许多工具都提供易于使用的界面,你可以在其中上传图像并直接绘制对象轮廓。
图像和标注准备就绪后,你可以将它们整理到训练和验证文件夹中。常见的划分方式是将 80% 的图像用于训练,20% 用于验证;根据数据集大小,也常采用 70% 用于训练、30% 用于验证的方式。训练集用于教会模型,验证集则用于衡量模型在未见过的图像上的表现。
保持这种划分均衡,并确保两个文件夹都包含多种示例,这一点很重要。干净、标注完善的数据集,以及合理划分的训练集和验证集,是构建强大实例分割模型的基础。
步骤 2:创建数据集 YAML 文件#
准备好图像和标注后,下一步是创建数据集 YAML 文件。该文件会说明数据集的位置,以及模型在训练期间需要学习哪些对象类别。
在此文件中,你可以定义数据集根目录、训练和验证图像文件夹的路径,以及类别名称列表。类别名称的排列顺序必须与标注文件中使用的类别编号一致,这样才能正确对应。
如果你对具体格式有任何疑问,可以参阅Ultralytics 官方文档了解详情。
步骤 3:安装 Ultralytics Python 包#
现在,数据集和 YAML 文件都已准备就绪,下一步是安装 Ultralytics Python 包。
此软件包包含训练、验证、运行推理以及导出 Ultralytics YOLO26 模型所需的工具。它让你无需从头搭建复杂的训练流水线,就能轻松使用 YOLO 模型。
安装 Ultralytics Python 包之前,还需要选择运行代码的环境。你可以在多种不同的开发环境中使用 Ultralytics 包,例如:
- 命令行界面 (CLI):这是一种基于文本的环境,你可以通过输入命令与计算机交互。与在图形界面中点击按钮或浏览菜单不同,你可以输入指令,直接运行程序和执行任务。
- Jupyter Notebooks:这是一种交互式环境,你可以分段编写并运行代码,并立即查看输出结果。这有助于开展实验和学习。
- Google Colab:这是一种基于云的笔记本平台,无需在本地安装,并可选择使用图形处理器 (GPUs)。这通常是初学者最容易上手的选择。
选好环境后,就可以安装 Ultralytics Python 包了。运行以下命令即可安装:
pip install ultralytics
如果你使用 Google Colab 或 Jupyter Notebook 等基于笔记本的环境,请在命令开头加上感叹号。如果遇到安装问题,可以参阅 Ultralytics 文档或故障排除指南,了解常见问题的解决方法和环境配置建议。
安装完成后,你就可以加载预训练的 Ultralytics YOLO26 分割模型并开始训练了。
步骤 4:训练 Ultralytics YOLO26 进行实例分割#
开始训练前,你需要选择模型尺寸。Ultralytics YOLO26 模型有多种尺寸:Nano (n)、Small (s)、Medium (m)、Large (l) 和 Extra Large (x)。
较小的模型训练速度更快,在中央处理器 (CPUs) 或边缘设备上运行也更高效;较大的模型通常精度更高,但需要更多内存,并且能从 GPU 加速中获益。如果你刚开始使用或硬件资源有限,Nano 版本 (YOLO26n) 是个实用的选择。
选好模型尺寸后,下一步是加载预训练分割模型,并在自定义数据集上开始训练。为此,你需要指定预训练模型文件、数据集 YAML 文件的路径、训练轮数以及图像尺寸,如下所示。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
results = model.train(data="path/to/file.yaml", epochs=100, imgsz=640)
训练轮数决定模型会遍历整个训练数据集多少次。每一轮中,模型都会进行预测,将预测结果与正确标注进行比较,计算误差,并更新内部参数以提升性能。
如果训练正常启动,你会在终端或笔记本中看到模型配置、数据集扫描结果和训练进度。训练继续进行时,每轮结束后都会更新损失值和评估指标,展示模型如何逐步提升。
步骤 5:评估自定义训练模型的性能#
训练完成后,你可以查看并验证模型的性能指标。在 Google Colab 中,你可以依次打开“runs”文件夹、“segment”文件夹和“train”文件夹,查看其中显示关键性能指标的日志。
如果你在 Python 环境中工作,训练结果默认保存在当前工作目录下的“runs/train/”目录中。每次训练都会创建一个新的子目录,例如 runs/train/exp 或 runs/train/exp2,其中包含与该实验相关的日志、保存的权重和其他输出。
如果你使用 CLI,可以通过“yolo settings”命令访问和管理这些结果。此命令可让你查看或修改与训练日志和实验详情相关的路径及配置。
保存的输出中还会包含训练期间生成的图表。这些图表展示了模型随时间的改进情况。例如,它们会显示模型学习过程中损失如何下降,以及精确率、召回率和平均精度均值等评估指标如何随着训练轮数增加。
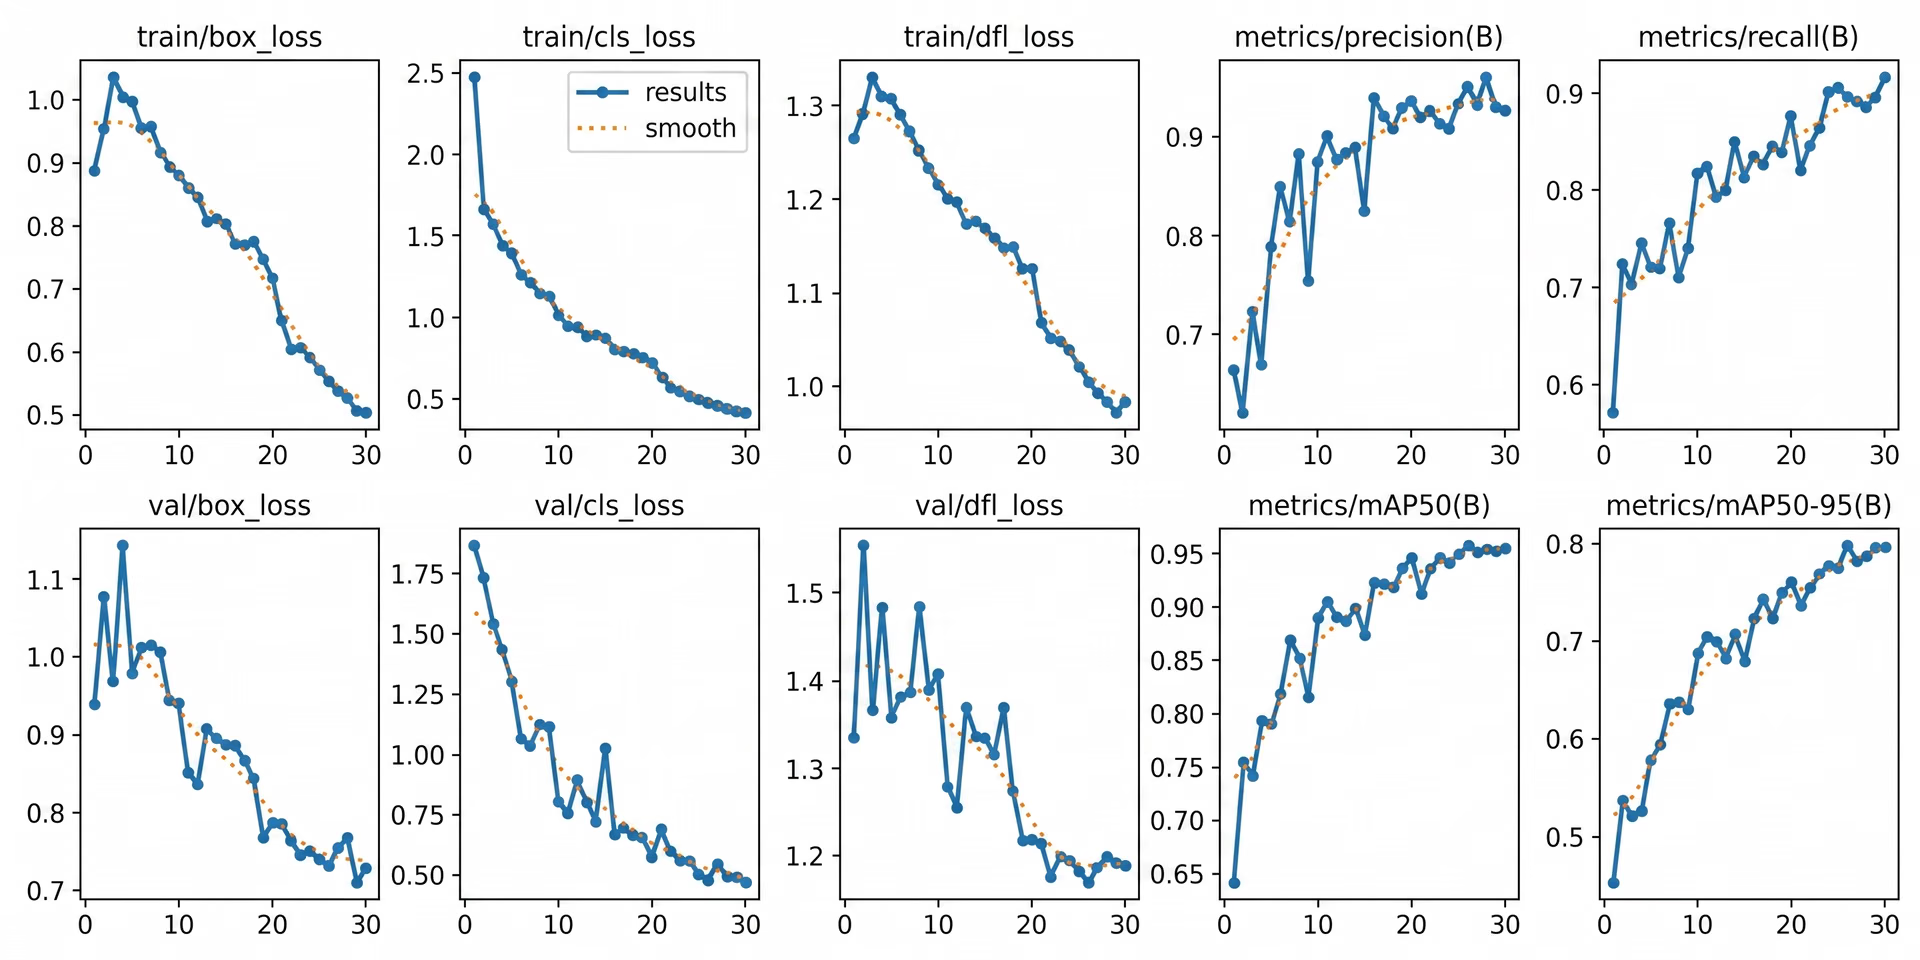
图 4. 可用于分析和评估模型的图表类型(来源)
这些趋势图可以帮助你了解模型是否训练成功,以及从训练开始到结束提升了多少。在开始使用新图像进行测试之前,同时查看数值指标和图表,可以让你更清楚地了解实例分割模型的表现。
步骤 6:测试模型并运行推理#
验证模型后,最后一步是在新图像上测试模型。这个过程称为推理,简单来说,就是使用训练好的模型对未见过的数据进行预测。
你可以在 Python 中按如下方式运行推理:
results = model.predict("path/to/image.jpg", save=True, conf=0.3)在此示例中,你可以将 "path/to/image.jpg" 替换为要测试的图像路径。
“save=True”设置会指示模型生成并保存一张新图像,其中会在原始图像上绘制预测出的分割掩码。
“conf=0.3”设置用于控制置信度阈值,这意味着模型只会显示它认为至少有 30% 把握正确的预测结果。降低此值可能会显示更多检测结果;提高此值则会让模型的筛选更严格。
运行命令后,模型会在 runs 目录中创建一个新文件夹,并将输出图像保存在其中。你可以打开保存的图像,直观检查分割掩码是否贴合对象边界,以及重叠对象是否被正确区分。
在不同图像、背景和光照条件下测试模型,可以让你更清楚地了解模型在训练数据集之外的表现。如果结果稳定且准确,模型就可以导出并部署了。
步骤 7:导出并部署模型#
测试模型并确认其表现良好后,最后一步就是导出并部署模型。导出会将训练好的 Ultralytics YOLO26 模型转换为可在不同环境中运行的格式,例如生产服务器、边缘设备或移动应用。
Ultralytics 支持多种导出格式,你可以根据部署环境选择最合适的格式。例如,你可以导出为 ONNX,以便在不同平台上广泛兼容;导出为 TensorRT,以便在 NVIDIA 硬件上优化 GPU 性能;或者导出为 OpenVINO,以便在 Intel 设备上高效地通过 CPU 部署。这些集成让你更轻松地在训练环境之外运行模型,并实现出色的实时性能。
你可以在 Python 中使用以下命令导出模型:
model.export(format="onnx")此命令会将训练好的模型转换为 ONNX 格式。根据部署需求,你可以将 "onnx" 替换为其他受支持的格式。
导出后,你可以将模型集成到 Web 服务、嵌入式视觉系统、机器人平台或工业检测系统等应用中。至此,你自定义训练的 Ultralytics YOLO26 实例分割模型就可以从实验阶段进入实际部署。
要点#
针对实例分割自定义训练 Ultralytics YOLO26,让你可以灵活构建真正适合特定应用场景的模型。通过准备清晰的数据集、设置 YAML 文件、使用预训练分割权重进行训练并检查结果,你可以教会模型在像素级别准确描绘每个对象。经过测试和导出后,你的 YOLO26 模型就能从开发阶段迈向各种真实世界应用。
加入我们的社区,并查看我们的 GitHub 仓库,了解更多 AI 相关内容。如果你想构建自己的视觉 AI 项目,可以了解我们的许可选项。访问我们的解决方案页面,进一步了解医疗保健领域的 AI和零售领域的视觉 AI等应用。








