在计算机视觉项目中运用强化学习
了解计算机视觉应用中的强化学习如何帮助系统进行视觉感知、做出决策,并在各行业的真实应用中不断改进。
一种简单直接的人工智能(AI)解释方式是:它是一个专注于重现人类思考和学习方式的领域。人工智能中的学习技术理念正是由此而来,它们是让机器随着时间推移不断提升性能的不同方法,就像人类一样。
此前,我们探讨过各种重要的 AI 学习技术,包括监督学习、无监督学习、强化学习和迁移学习,以及每种技术如何在帮助 AI 模型处理信息和做出决策方面发挥重要作用。
今天,我们将进一步了解强化学习。这是一种通过与环境交互并根据反馈不断改进,让 AI 系统从经验中学习的技术。具体来说,我们将探讨如何将强化学习应用于计算机视觉应用,也就是让机器解读和理解现实世界视觉信息的系统。
将强化学习和计算机视觉等概念结合起来,正在开辟令人兴奋的新可能性,也是一个活跃的研究领域。它使 AI 系统能够识别所看到的内容,并根据这些视觉信息做出明智的决策。
什么是强化学习?#
强化学习是机器学习的一个分支,其中的 AI 智能体通过采取行动并接收奖励或惩罚形式的反馈来学习。其目标是找出随着时间推移能够带来最佳结果的行动。
你可以把强化学习想象成训练狗。当狗听从指令坐下时,你会给它一份奖励。过一段时间后,狗就会学到坐下会带来奖励。在强化学习中,AI 智能体或模型就像狗;环境是它周围的世界,而奖励则帮助它判断自己是否采取了正确的行动。
这与监督学习不同。在监督学习中,AI 模型会看到许多正确答案的示例。例如,模型可能会看到一张狗的图片,并被告知:“这是一只狗。”
另一方面,强化学习不依赖标注数据。相反,它通过尝试不同的行动并从结果中学习,就像玩游戏时摸索哪些操作能帮助你获胜一样。
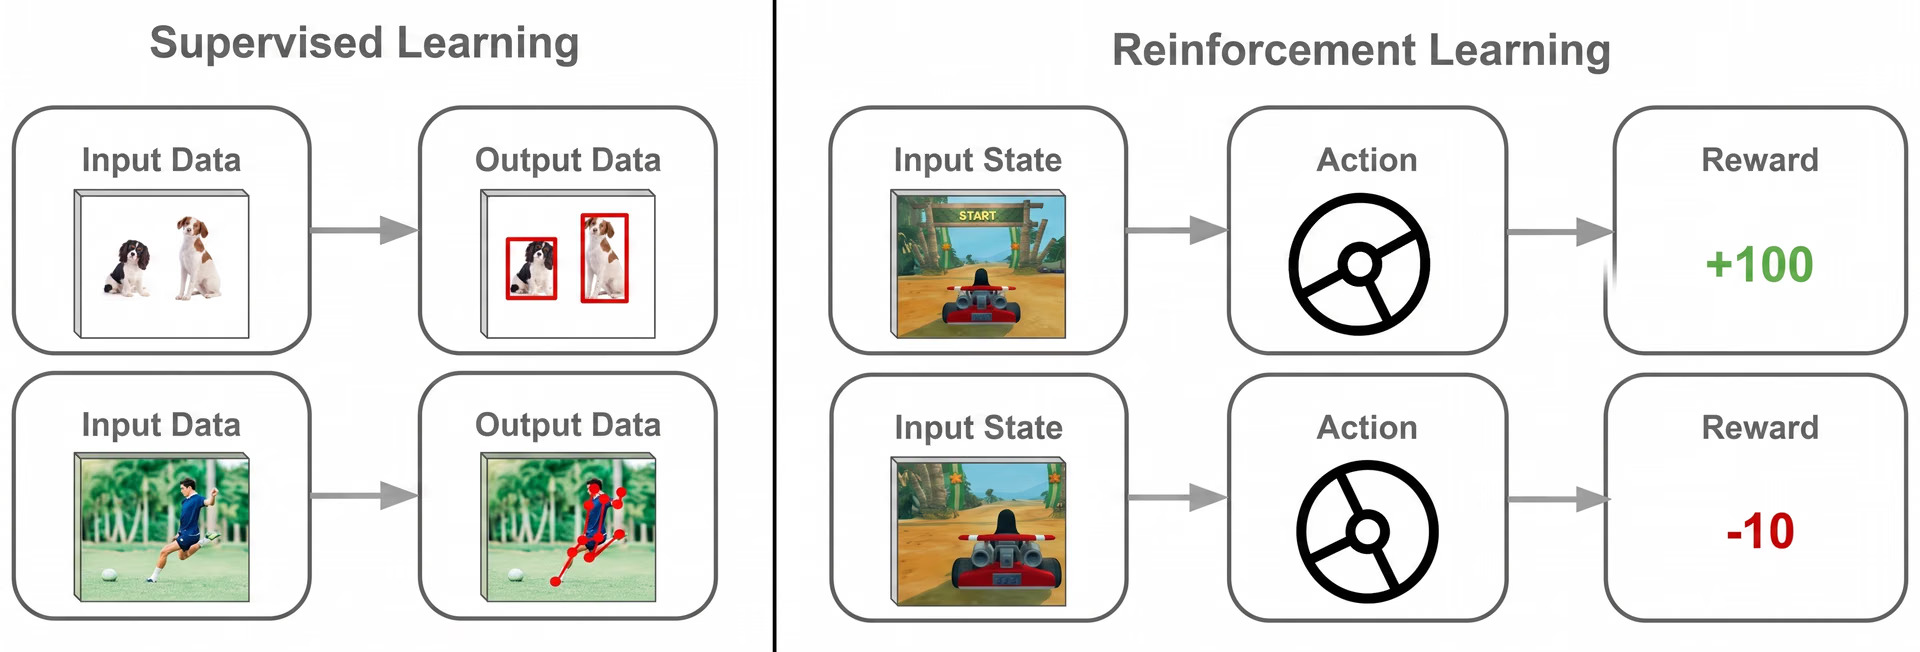
图 1. 强化学习与监督学习对比。
强化学习对于需要逐步做出决策的任务至关重要,因为每个选择都会改变接下来发生的事情。这类学习被用于策略类电子游戏,让游戏过程对玩家更具挑战性和吸引力。
强化学习在 AI 解决方案中的工作原理#
想想你学习骑自行车的过程。刚开始时,你可能会摔倒。但经过练习,你会逐渐找出哪些方法能帮助自己保持平衡。骑得越多,你的水平就越高。你是通过实践来学习,而不只是被告知该怎么做。
强化学习对 AI 的作用方式与此类似。它通过经验学习——尝试不同的行动、观察结果,并逐渐提升自己随着时间推移做出正确选择的能力。
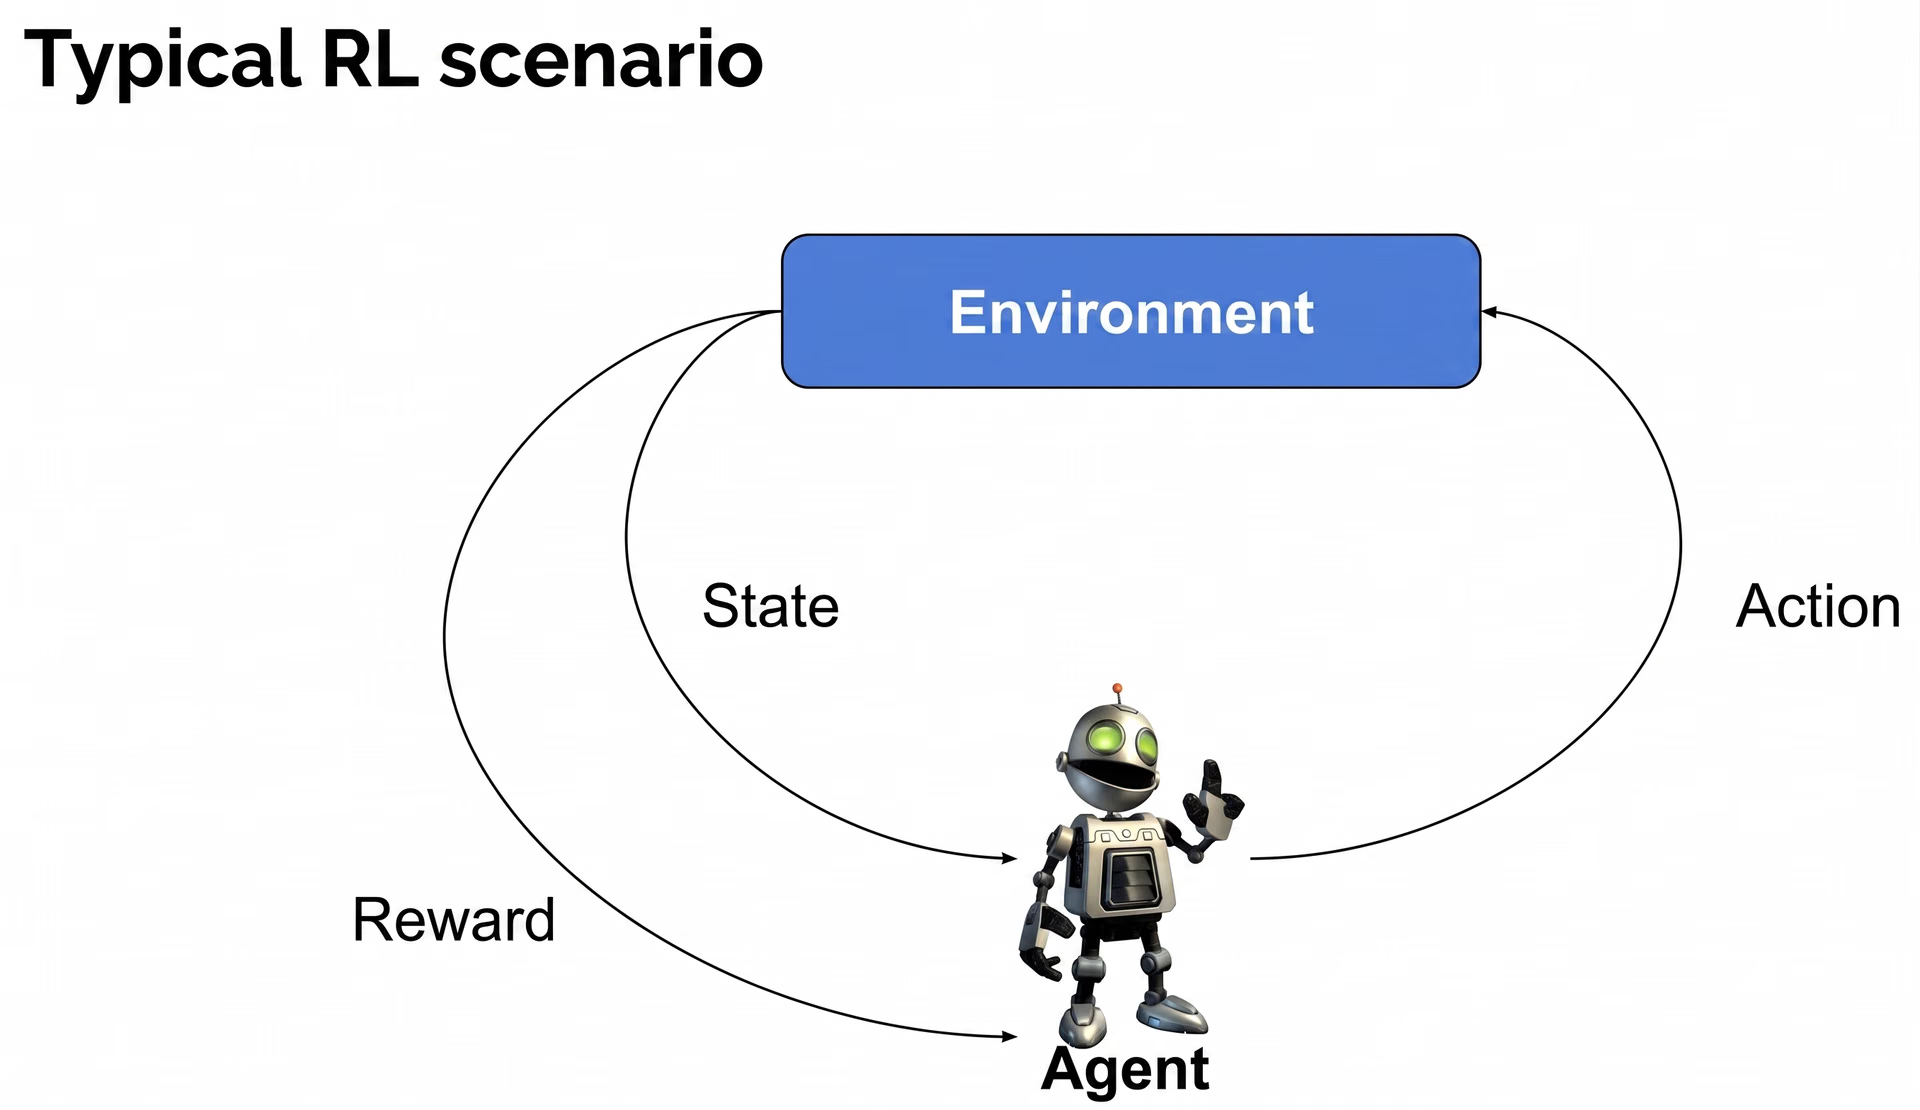
图 2. 了解强化学习的工作原理。
下面介绍强化学习的一些关键组成部分:
- 智能体:智能体是学习者或决策者。它通过采取行动与环境交互,并以实现特定目标为目的。
- 环境:环境包括智能体与之交互的一切事物。它会响应智能体的行动而变化,并根据结果提供反馈。
- 状态:状态代表环境当前情况的一个快照。智能体通过观察状态来了解周围环境,并确定下一步要采取的行动。
- 行动:行动是智能体做出的、会影响环境的操作或决策。每个行动都会导致新的状态,并可能影响未来的奖励。
- 奖励:奖励就是环境提供的反馈,用于告知智能体其行动是否有益。正奖励会鼓励智能体重复良好行动,而负奖励则会抑制不佳行动。
- 策略:策略是智能体根据当前状态选择行动的方法。随着时间推移,智能体会不断优化策略,以最大化能够获得的总奖励。
将这些组成部分结合起来,强化学习就能让 AI 系统通过持续试错来学习有效行为。每次尝试都会让智能体变得更好,从而更善于选择能够带来更高奖励和更好结果的行动。
强化学习推动计算机视觉创新#
计算机视觉可用于图像中的目标检测、图片内容分类,以及将图像分割成不同部分等任务。像 Ultralytics YOLO11 这样的计算机视觉模型支持这些任务,并可用于构建能够收集视觉洞察的高影响力应用。
然而,当这些视觉 AI 任务与强化学习结合时,得到的 AI 解决方案就不只是看见内容,还能根据视觉洞察学习如何采取行动,并随着时间推移不断改进。
强化学习在计算机视觉应用中的一个有趣例子,是将机器人用于仓库。配备摄像头和计算机视觉系统的机器人可以分析周围环境,检测每件物品的位置,识别其形状和大小,并理解它在货架上的摆放方式。
机器人每次尝试拾取物品时,都会收到反馈——如果成功正确拾取物品,就会得到成功反馈;如果物品掉落,则会得到失败反馈。随着时间推移,机器人会学到针对不同物品哪些行动最有效。它不再遵循一套固定指令,而是通过经验持续改进。
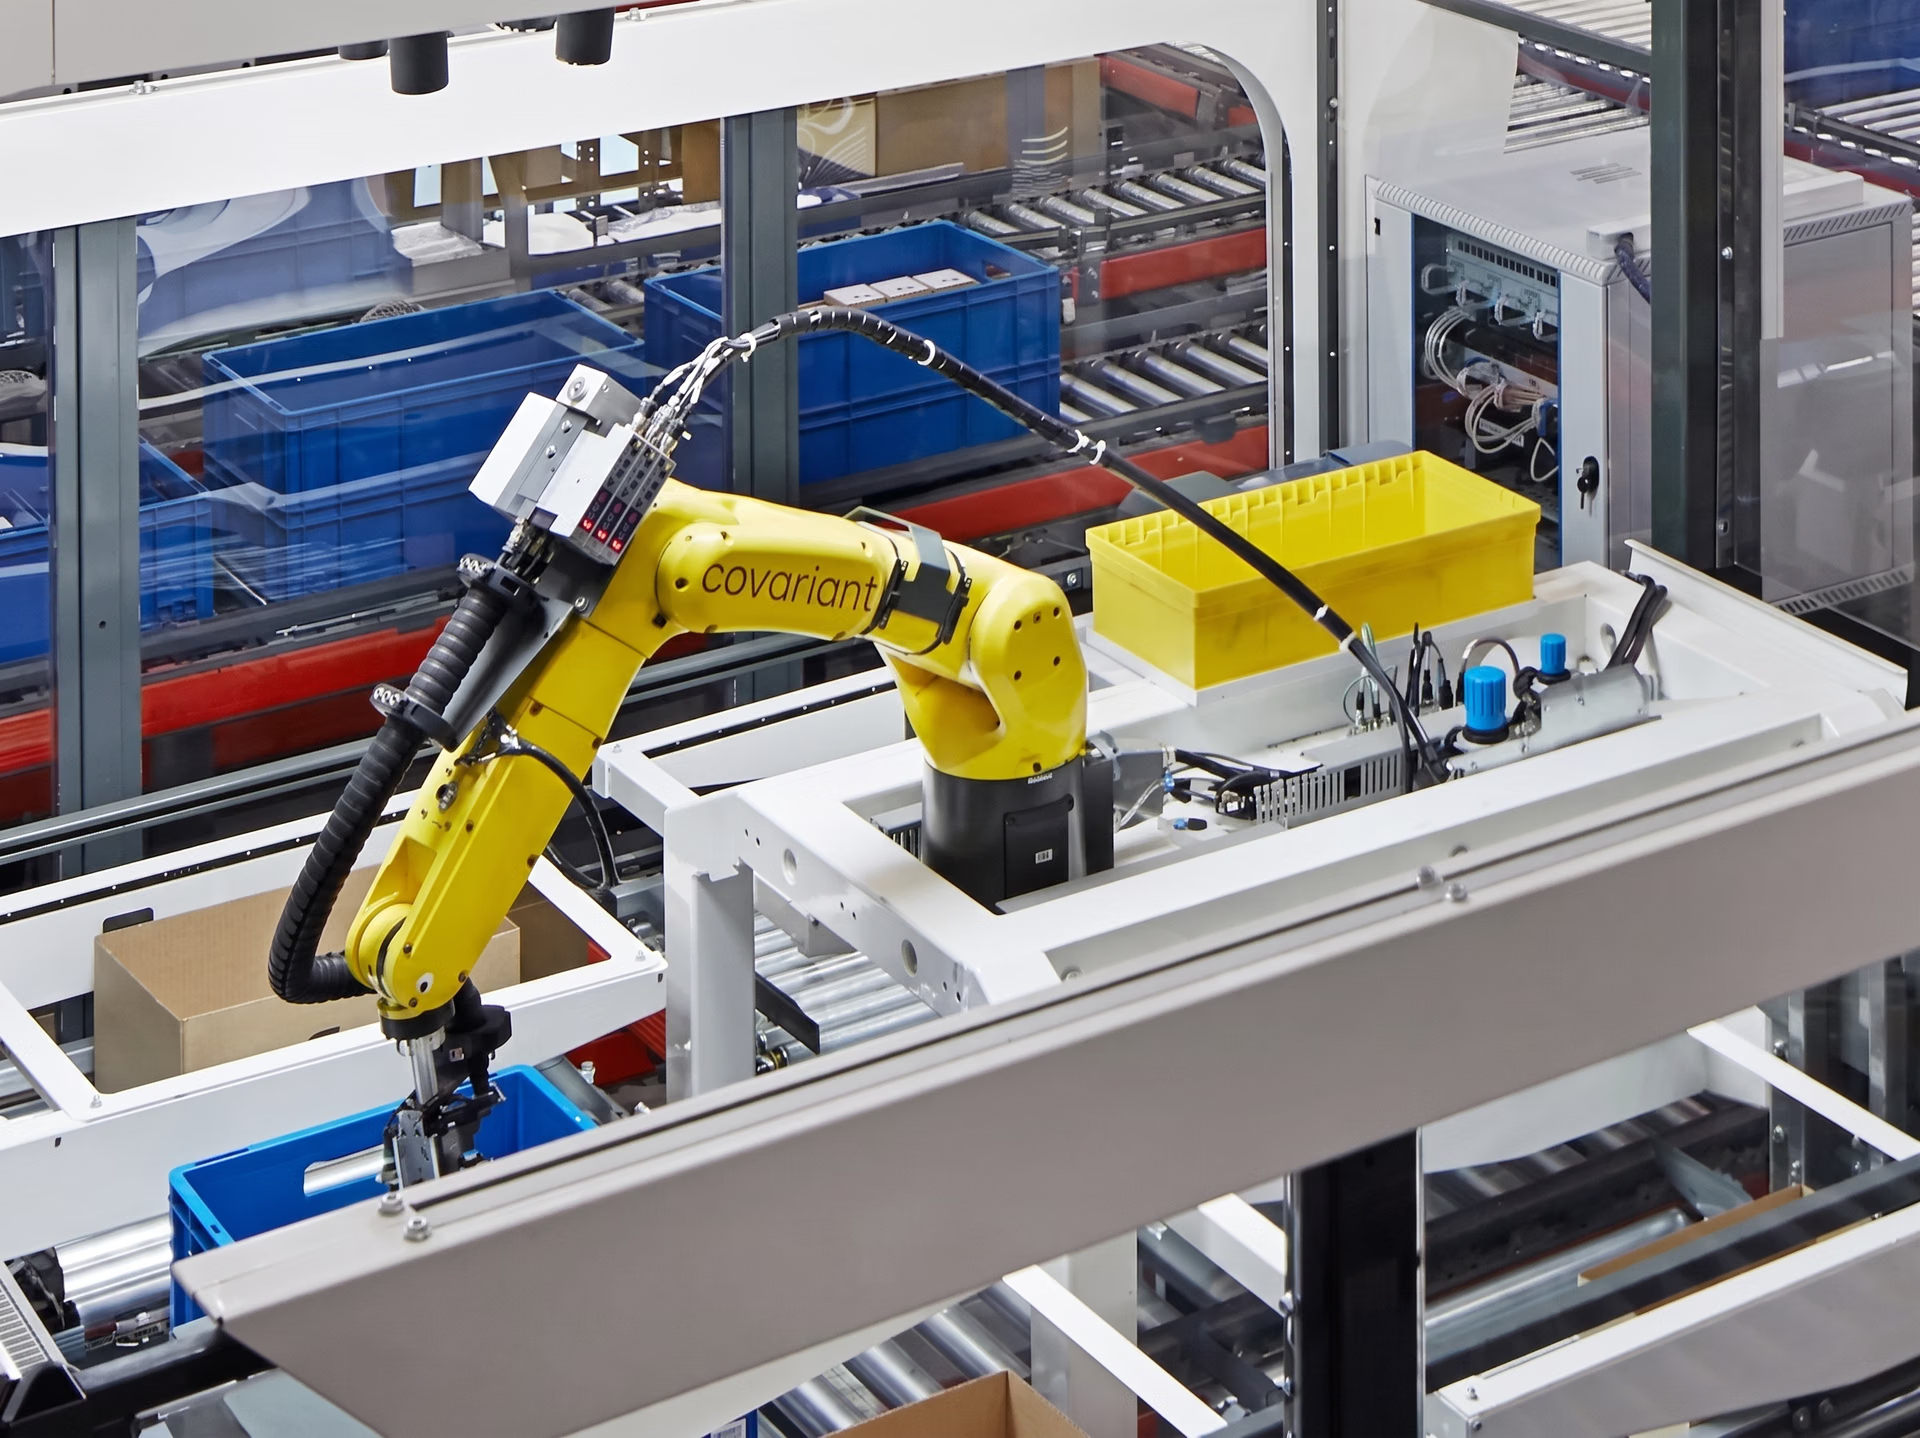
图 3. 使用视觉 AI 和强化学习拾取物体的机械臂。
强化学习在计算机视觉中的应用#
现在我们已经更好地了解了强化学习及其在计算机视觉中的作用,接下来进一步看看强化学习和计算机视觉结合使用的一些场景。
将视觉 AI 和强化学习结合,打造更智能的车辆#
自动驾驶汽车可以同时依靠视觉 AI 了解周围环境,并利用强化学习根据所看到的内容做出决策。AWS DeepRacer 就是一个很好的实践案例。
AWS DeepRacer 是一款 1/18 比例的全自动驾驶赛车,它利用摄像头和强化学习学习驾驶。它不会被告知该怎么做,而是通过尝试、犯错并从错误中学习,自主摸索出解决方法。
这辆小车的摄像头就像一双眼睛,能够捕捉前方的赛道。小车根据看到的内容学习如何转向以及应以多快的速度行驶。每完成一圈,它都会有所进步。例如,它可能会通过从过去的尝试中学习,逐渐学会采取更宽的转弯路线,或在急转弯前减速。
DeepRacer 的训练从虚拟环境开始,模型会在其中练习并改进驾驶技能。当达到一定的性能水平后,这些技能会被迁移到由实体赛车组成的现实赛道中。
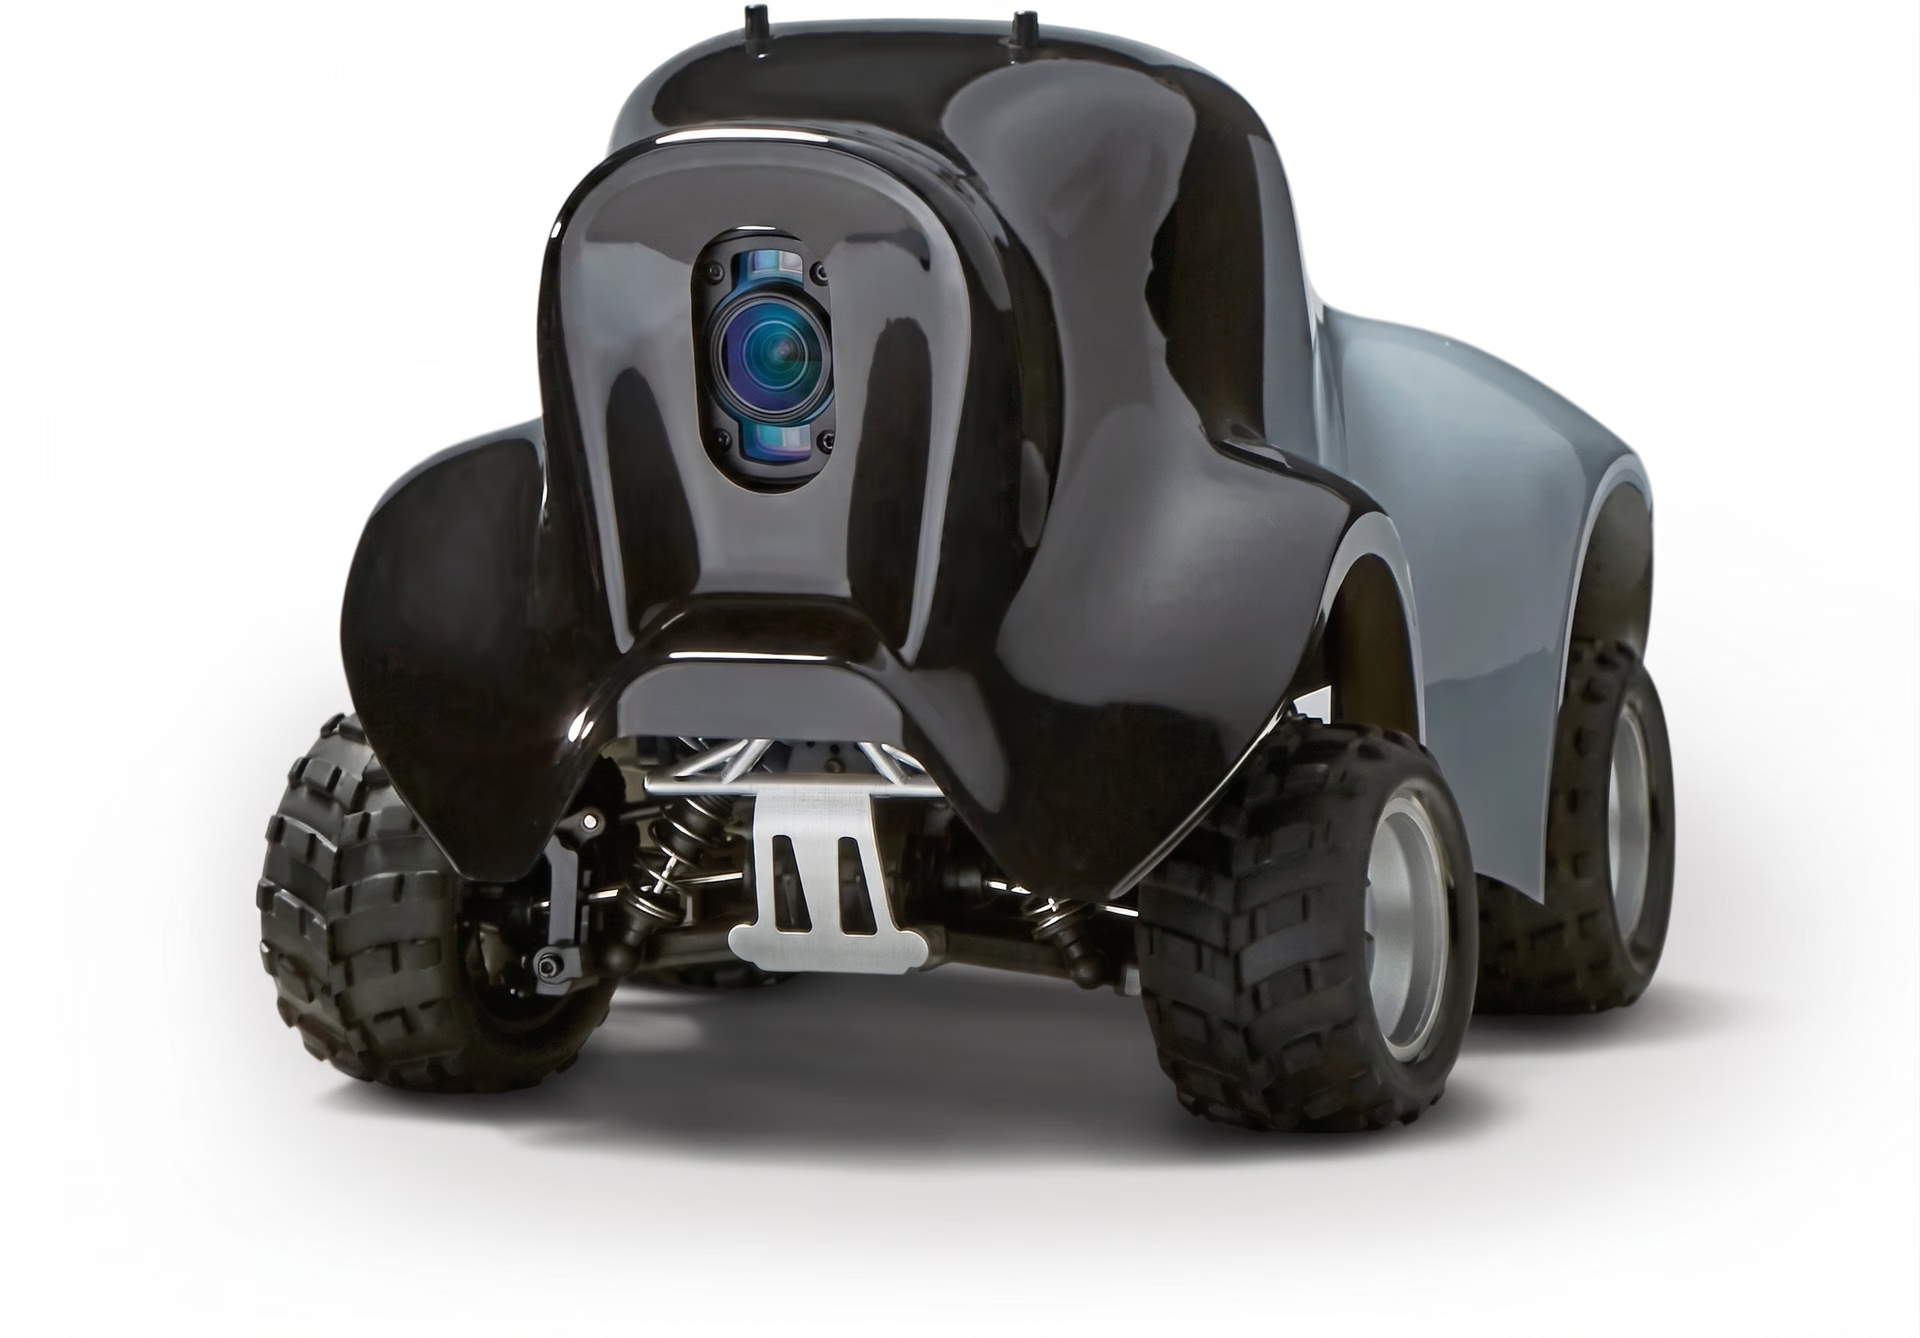
图 4. AWS DeepRacer 利用视觉和强化学习实现自动驾驶。图片来源:Amazon。
迈向自动驾驶手术机器人#
一个正日益受到关注的令人兴奋的研究领域,是将视觉 AI 和强化学习应用于机器人手术。目前,这种应用在很大程度上仍停留在理论阶段。研究人员正在虚拟环境中运行模拟实验。
然而,早期实验正显示出令人鼓舞的结果,表明手术机器人最终有望以更高的精度和适应性执行复杂、精细的操作,同时最大限度地减少人为干预。
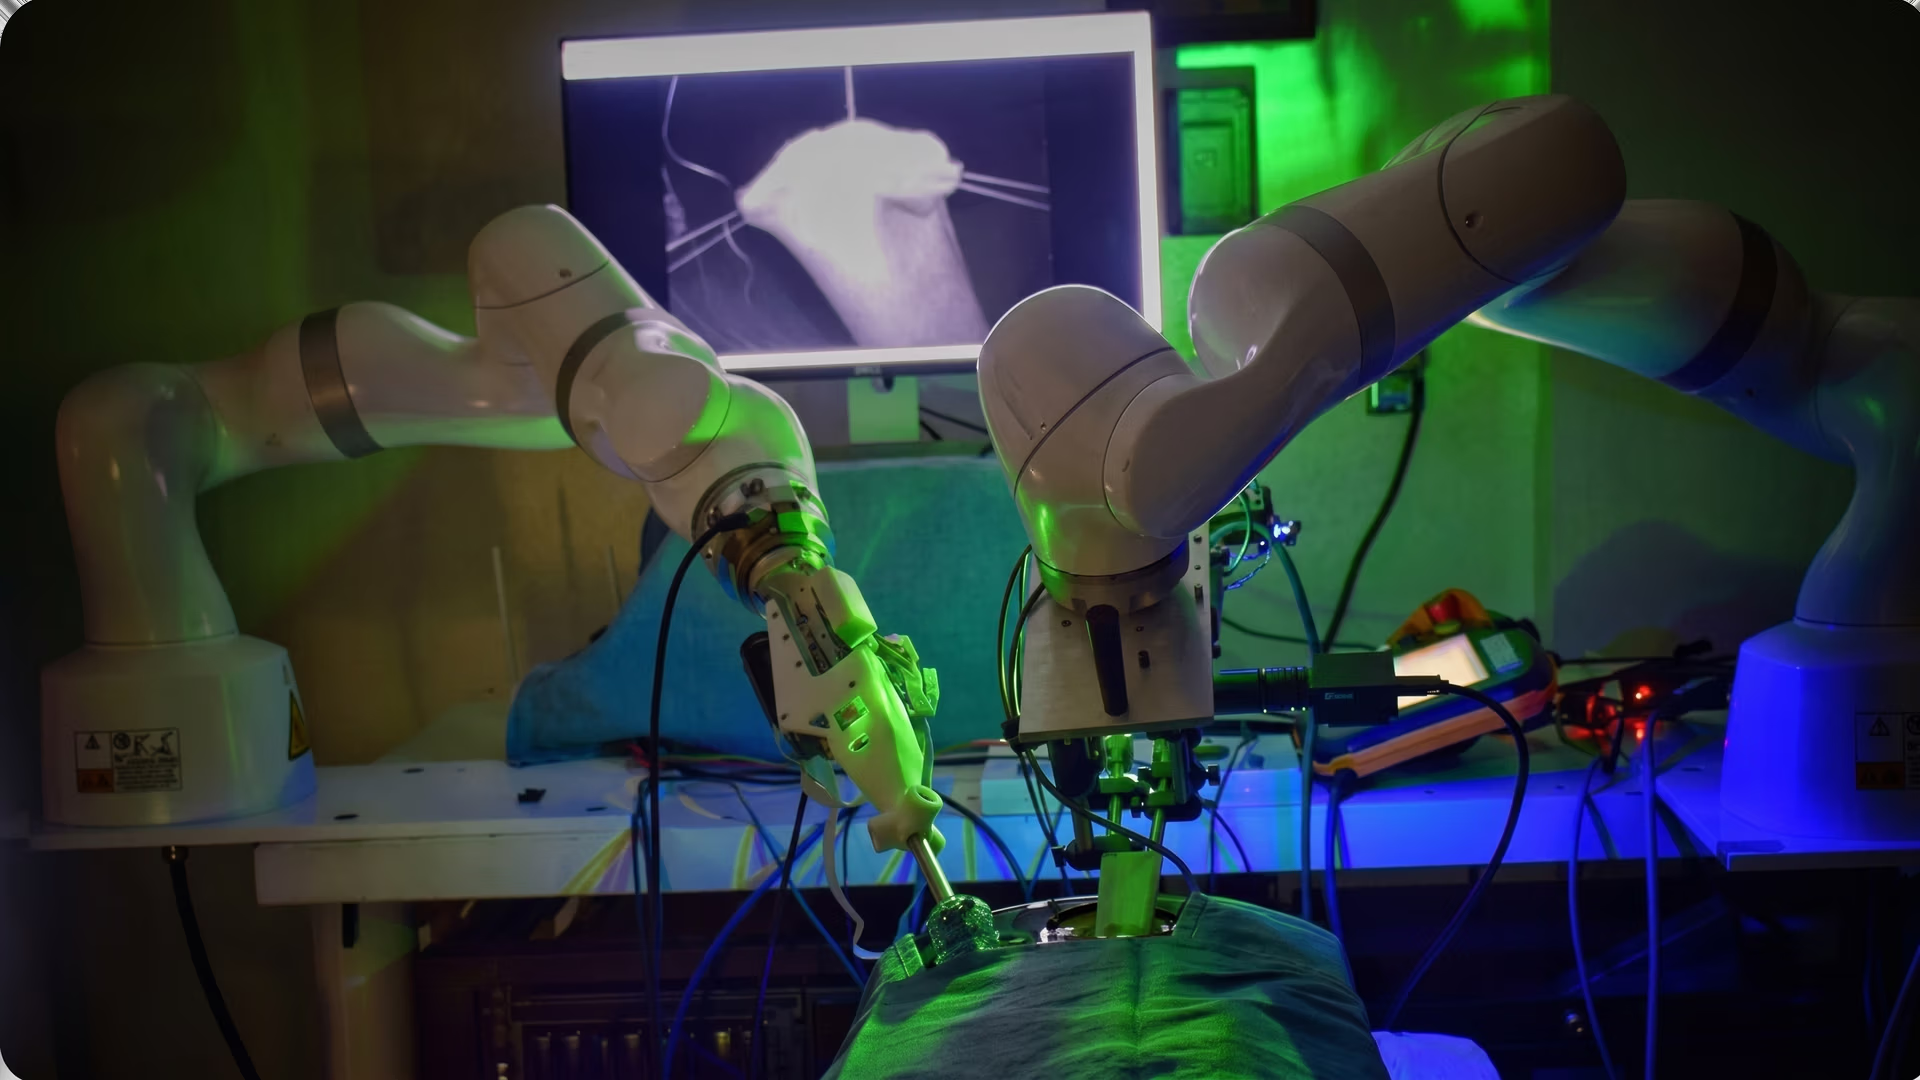
图 5. 手术机器人正变得越来越先进。
例如,想象一下需要从手术部位小心地提起一块纱布的场景。配备视觉 AI 的机器人首先会分析场景,并使用分割来识别纱布和周围组织。
随后,强化学习会帮助手术机器人决定如何处理这项任务,包括确定抓取纱布的最佳角度、施加多大压力,以及如何提起纱布而不干扰附近的敏感区域。随着时间推移,并在模拟环境中反复练习,机器人可以逐渐学会以越来越高的熟练度和信心完成这些细微而关键的动作。
强化学习在视觉 AI 中的优缺点#
强化学习让视觉 AI 系统能够超越简单识别,开始根据所看到的内容做出决策。这为机器人技术、自动化和实时交互等领域带来了新的可能性。
下面是将强化学习整合到视觉 AI 工作流程中的一些主要优势:
- **更少依赖标注数据:**这些系统可以从交互中学习,因此不需要庞大的标注数据集就能开始运行。
- **更好地处理不确定性:**强化学习可以通过根据反馈调整行动,处理不完整或含噪的视觉信息,而不是仅依赖完美数据。
- 支持长期学习:它通过从一系列行动中学习,而不只是做出单步决策,帮助模型随着时间推移不断改进。
另一方面,下面是需要考虑的强化学习局限性:
- 信用分配问题:智能体可能很难判断哪些具体行动促成了最终结果,尤其是在包含一长串决策的情况下。
- **不安全探索风险:**在训练期间,智能体可能会尝试不安全或不理想的行动,而这些行动在医疗保健或自动驾驶等现实应用中是不可接受的。
- 收敛速度慢:模型可能需要很长时间才能真正达到良好的性能,尤其是在处理复杂任务时。
要点总结#
计算机视觉项目中的强化学习让 AI 系统能够了解周围环境,并通过经验学习如何采取行动。借助 Ultralytics YOLO11 等模型提供的实时目标检测能力,系统可以根据所看到的内容做出明智的决策。
这种方法不再局限于传统方式,而是让 AI 通过试错和反馈进行改进,而不是完全依赖标注数据。它支持持续学习,有助于构建更灵活、更具适应性和更智能的视觉 AI 系统,使其随着时间推移不断变得更好。
加入我们不断壮大的社区。访问我们的 GitHub 仓库,深入了解 AI。想开始自己的计算机视觉项目?探索我们的许可选项。在我们的解决方案页面上,进一步了解制造业中的 AI和汽车行业中的视觉 AI。








