Ultralytics YOLO26 现已支持单目深度估计
了解 Ultralytics YOLO26 全新的深度估计任务如何从单张 RGB 图像预测逐像素、具有度量尺度的深度,无需立体相机或 LiDAR。
过去,要在 YOLO 流程中加入深度信息,你必须自行组装方案。常见做法是使用 YOLO 进行检测,再搭配其他项目中的独立深度模型,例如 MiDaS 或 Depth Anything。这意味着要增加第二项依赖、第二套框架,以及两套需要协调的输入和输出格式。
单目深度估计现已成为Ultralytics YOLO26的原生任务。只需一张 RGB 图像,就能为每个像素生成距离值;使用的包、工作流和导出路径都与检测、分割和姿态估计相同。
什么是深度估计?#
深度估计根据单张 RGB 图像预测逐像素深度图,无需使用第二台相机或其他传感器。每个输出像素都包含一个以米为单位的深度值,表示从相机到该表面点的估计距离。
输出是一个密集的浮点图,形状为 (H, W),并与输入对齐;每个像素都携带一个以米为单位的绝对距离,表示它距相机的距离,而不是描述物体远近顺序的相对值。
深度估计是一项独立任务,有自己的检查点,输出也只有深度图;它不会返回边界框或分割掩码。因此,将检测与深度估计结合起来需要运行两个模型并进行两次前向传递。与以往做法不同的是,现在这两项任务都位于同一个包中,共用一次安装、同一套训练和预测接口、同一条导出路径,并且只需跟踪一个版本,而不必在第一套框架之外再维护第二套框架。
这种逐像素输出适用于障碍物和自由空间检测、间隙检查、场景布局分析,以及理解物体之间的前后关系。
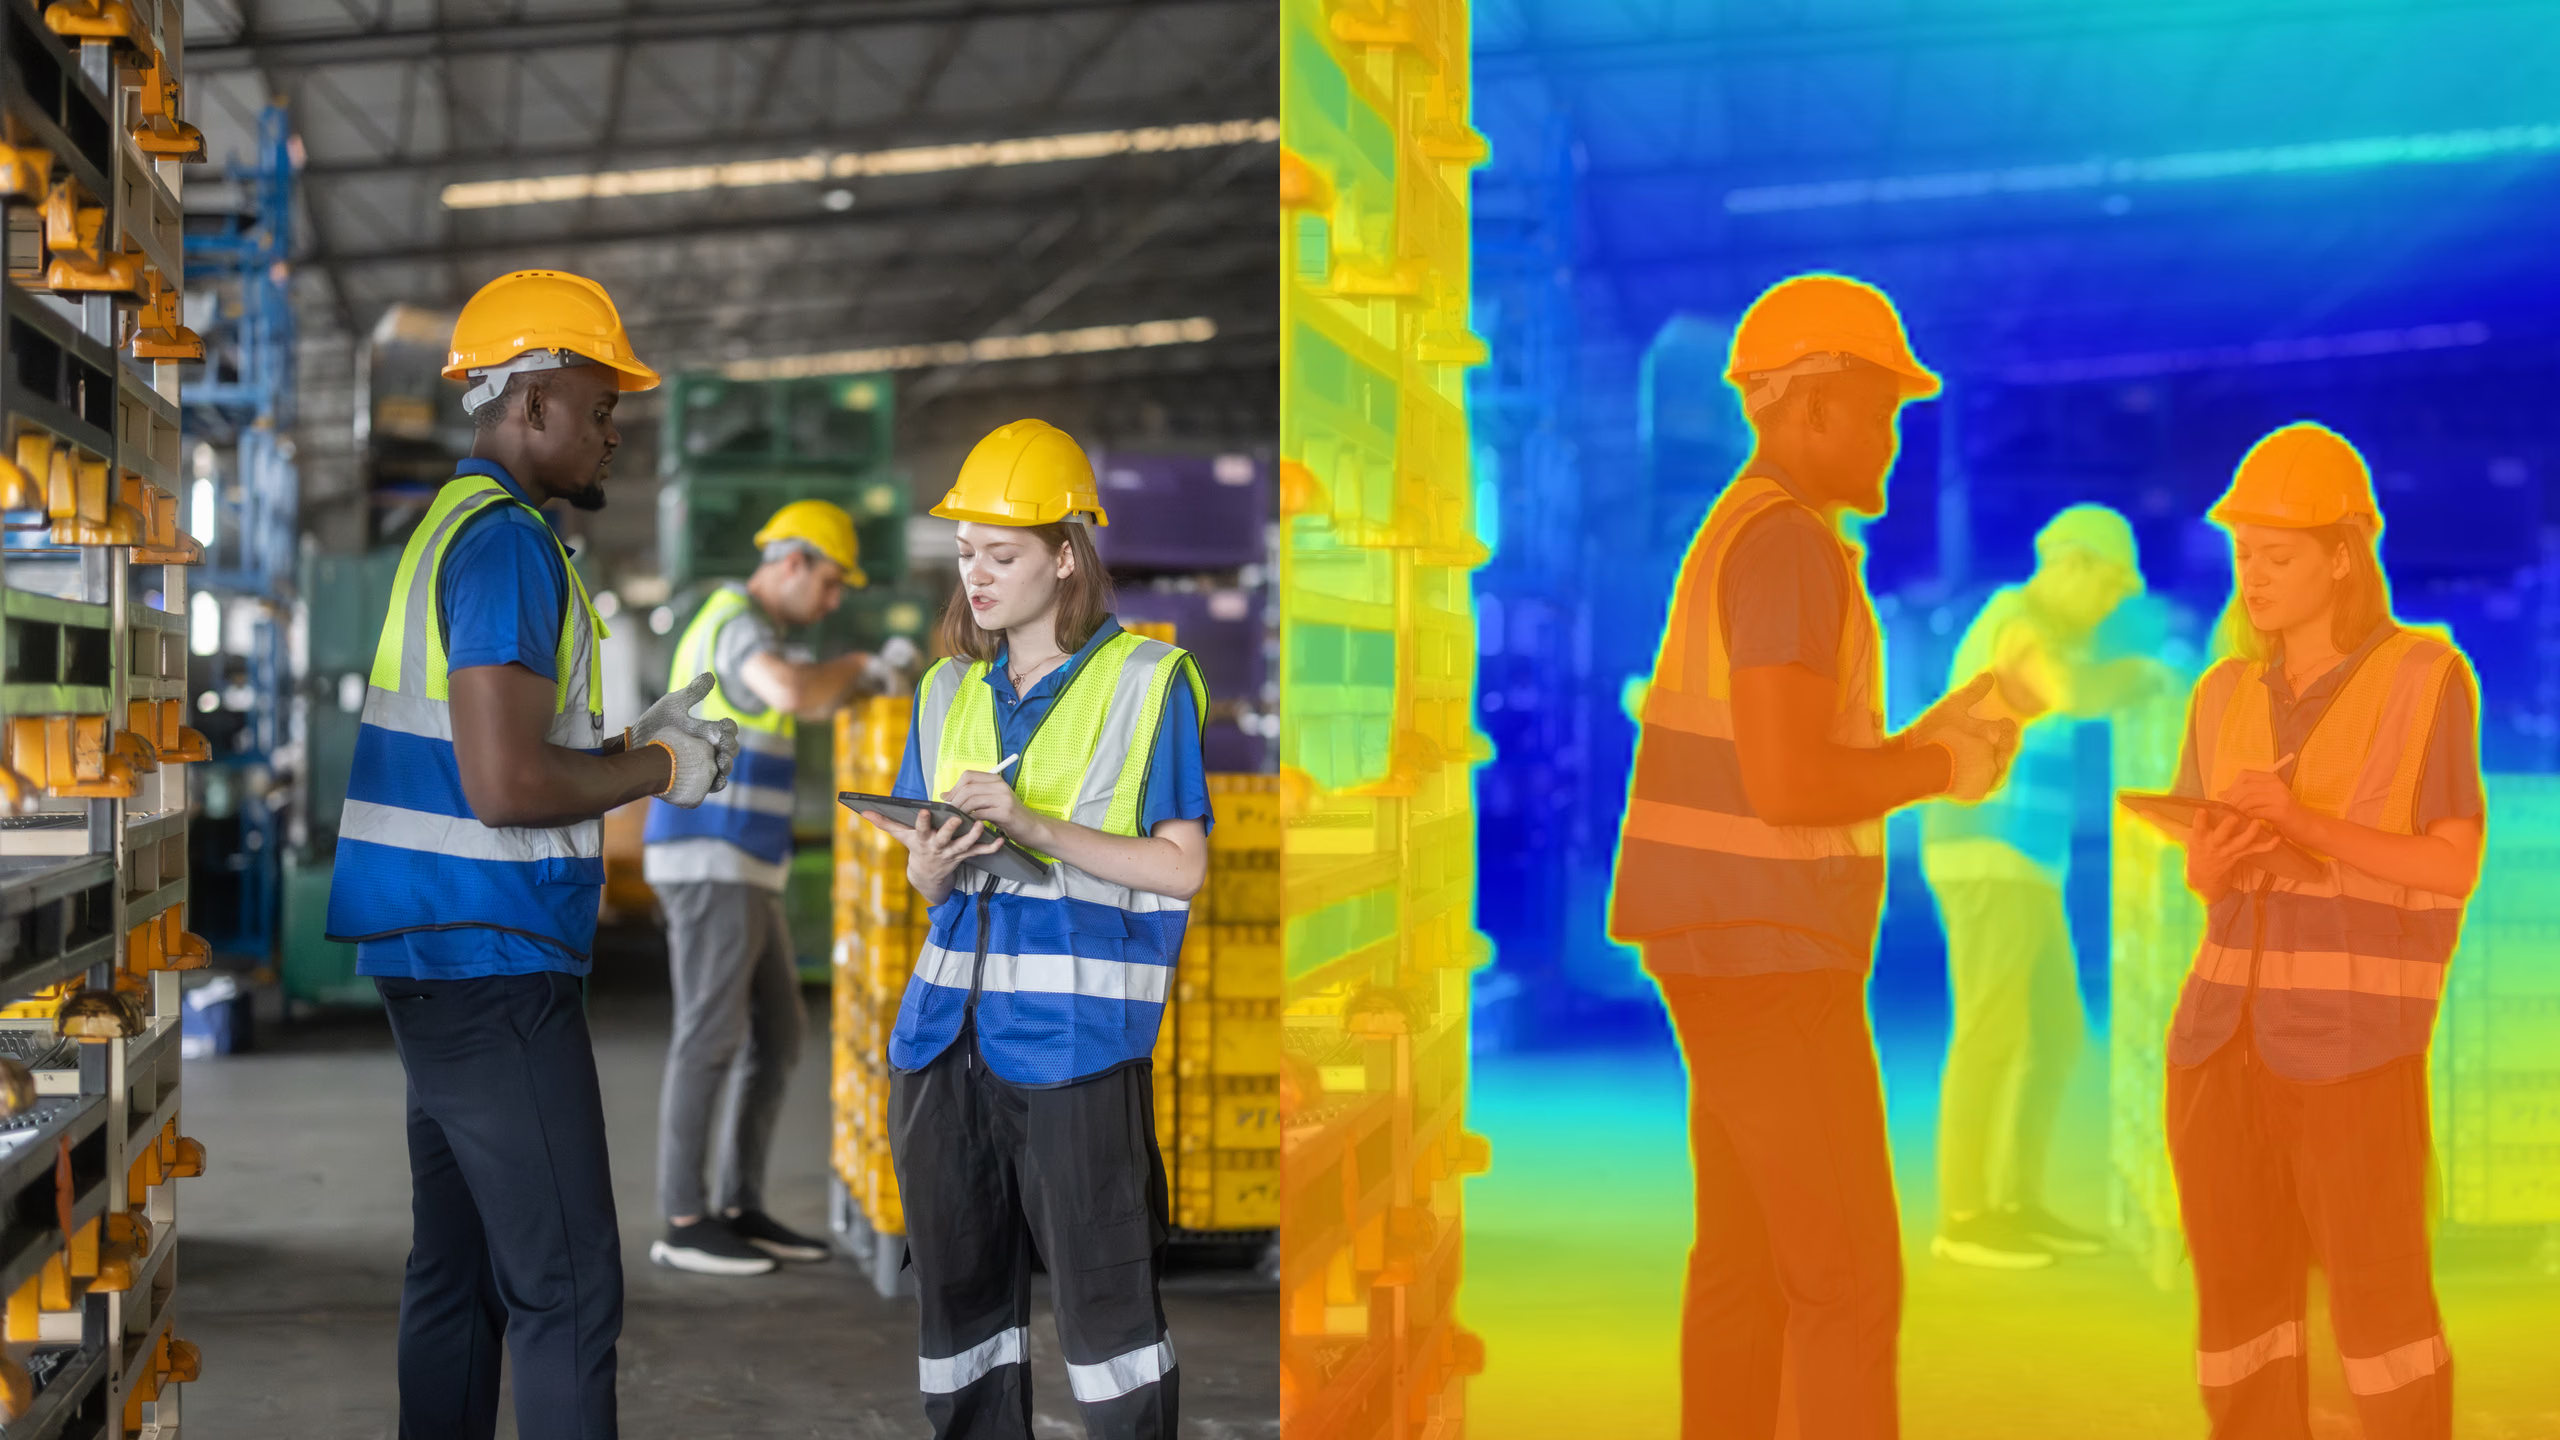 图 1. Ultralytics YOLO26 深度估计,用于安全与合规监控。
Ultralytics YOLO26 提供五种预训练深度模型,从 yolo26n-depth 到 yolo26x-depth,这些模型在涵盖约 219 万张室内和室外图像的多数据集混合数据上训练。在 NYU Depth V2 数据集上,nano 模型的 δ1 准确率为 0.882,特大模型则达到 0.933,因此你可以根据部署目标选择适合的速度与准确率权衡方案。
设计上不设深度上限#
大多数深度模型会将预测范围限制在固定区间,例如 0–10 米,这在室内场景中效果不错,但在室外就会遇到问题。Ultralytics 改用开放式对数尺度预测深度,不设硬性上限。
测试结果体现了这种差异。使用混合室内外数据训练时,受限模型几乎立刻就会达到性能平台期;在 KITTI 这类较远距离数据集上则会彻底失效,因为物体可能远在 80 米之外。Ultralytics YOLO26 的方法没有这样的上限,因此它会随着数据增加而持续改进,并能应对从几厘米到几百米的距离。在 KITTI 上,80 米范围内的 δ1 达到 0.942。这意味着同一个模型系列可以同样出色地处理桌面场景和高速公路场景。
对比 Ultralytics YOLO26 深度模型与 Depth Anything V2#
如果你现在同时运行 Depth Anything 和 YOLO,二者的差异就在于速度,以及随之而来的计算成本。Ultralytics YOLO26 深度模型的运行速度最高可达 Depth Anything V2 Base 的 20.3 倍、Depth Anything V2 Small 的 7.7 倍,而且模型小得多:nano 版本的参数量不到 1000 万,而 DA V2 较小的检查点约有 2400 万参数。
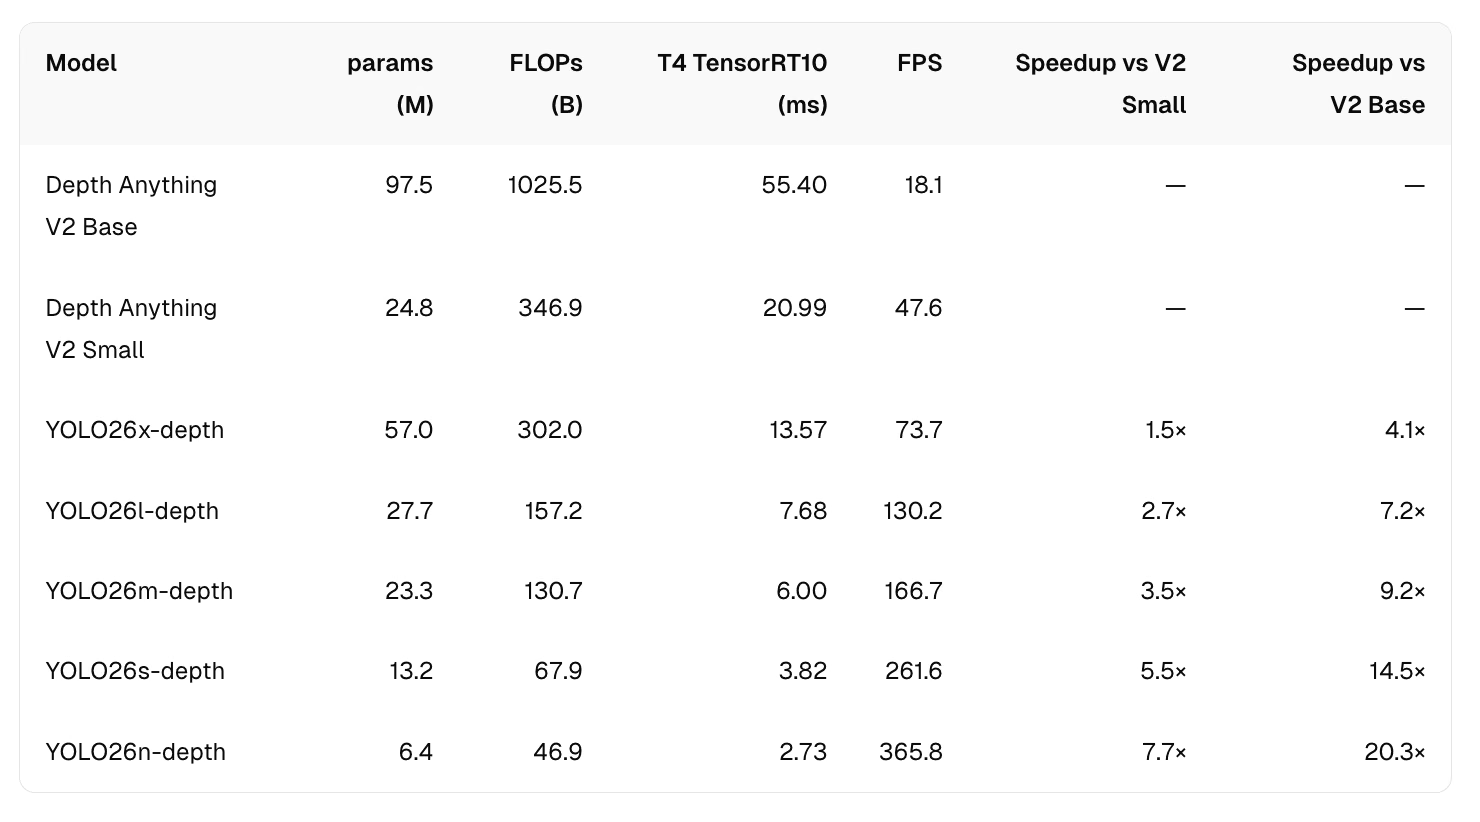 图 2. Ultralytics YOLO26 深度模型与 Depth Anything V2 的速度基准测试。
这种差距正是设计的重点。Depth Anything V2 的模型大得多;Ultralytics YOLO26-Depth 则旨在以更小的尺寸和更快的速度实现出色的深度性能,从而降低每帧的计算成本,并部署到这些模型无法覆盖的硬件上。文档公布了模型在 NYU Depth V2 和 KITTI 上的准确率数据,你可以据此对照自己的实际需求。
运行环境#
尺寸差异决定了深度估计实际上可以部署到哪些设备上。大多数评估深度估计方案的团队并不缺想法,而是计算资源不足。低功耗无人机、四足机器人、可穿戴设备、行车记录仪、会议设备和工业 PC,都会在达到准确率上限之前先遇到功耗和成本上限。
深度估计提供五种预训练模型,你可以选择适合目标设备的尺寸,而非只选基准测试中表现最好的尺寸。深度估计是 Ultralytics YOLO26 的原生任务,因此它与检测、分割和姿态估计使用相同的导出流程,支持以下格式:ONNX、TensorRT、CoreML、NCNN、LiteRT。
开始使用 Ultralytics YOLO26 深度估计#
Ultralytics Python 软件包提供统一接口,可用于训练、验证和推理所有 YOLO26 任务,包括深度估计。只需一条命令即可运行预训练深度模型:
from ultralytics import YOLO
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-depth.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 使用模型进行预测
results = model("https://ultralytics.com/images/bus.jpg")  # 对图像进行预测

# 访问结果
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, shape (H, W), meters
或者使用 CLI:
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
绝对距离取决于你的摄像头和场景。如果深度图的形状正确,但尺度不对,model.calibrate() 会在约 100 帧带标注的数据上拟合模型深度头中的两个变量:尺度和偏移量;整个过程只需几秒,无需训练,也不会更改网络的其余部分。
使用自己的数据进行微调#
要让预训练深度模型适配自己的摄像头或领域,请从预训练权重开始,使用 AdamW,并将学习率调到远低于从零开始训练时的默认值,让微调过程优化模型,而不是覆盖模型已有的能力:
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # 从预训练权重开始
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # 比从零开始训练时的默认值低约 100 倍
    warmup_bias_lr=1e-4,  # 预热过程也要保持平缓
)
由于默认的对数深度头不设上限,无论数据集中的距离较近还是较远,都可以开箱即用,无需进行 max_depth 调优。如果特定摄像头的绝对尺度不准确,model.calibrate() 会在小规模标注数据集上拟合轻量级的闭式校正,只需几秒,无需修改网络权重。
数据集将每张 RGB 图像与对应的 .npy 深度文件配对,并采用匹配的文件夹结构。Ultralytics 内置了 NYU Depth V2、KITTI、Hypersim、SUN RGB-D 和 ARKitScenes 的配置,因此大多数团队都可以立即开始针对标准基准进行验证。
深度估计的主要应用场景#
这项新功能只需普通摄像头即可使用,因此单目深度估计为许多产品和行业带来了更多机会,让它们无需承担双目或 LiDAR 方案的成本、功耗或标定开销,也能采用深度感知功能。下面来看看一些能够受益于这项功能的主要行业和应用场景:
- 机器人与自主导航。 移动机器人和无人机可以通过单个机载摄像头估算障碍物距离和可通行空间,无需专用深度硬件即可支持实时路径规划。
- 工业与物流感知。 通过单个固定摄像头进行间隙检查、可通行空间检测,以及货架或通道环境感知,适用于无法实际增加第二个传感器的场景。
- 安全与合规监控。 叉车和仓库安全区域、铁路事故检测,以及通过现有 CCTV 检测人员跌倒和物品遗留:为已安装的摄像头画面增加距离信息,并与现有安全认证传感器协同使用,而非取而代之。
- 基础设施与资产巡检。 高空线路净空分析、无人机资产与腐蚀检测,以及航空测绘作业;这些场景需要同一模型系列同时处理近距离细节和远距离场景。
- 驾驶辅助与汽车感知。 深度输出范围远且不设上限,意味着同一个模型系列既能处理室内近景,也能泛化到 80 米以上的驾驶场景。
- AR 与空间内容。 要让虚拟物体自然地融入真实场景,或应用深度感知特效,首先需要知道每个像素距离摄像头有多远。
让每一次 Ultralytics YOLO26 部署都能使用深度估计#
深度估计现已成为 Ultralytics YOLO26 的原生任务,各行业团队都可以通过任意 RGB 摄像头获取逐像素距离信息,并沿用熟悉的训练、验证、预测和导出工作流(与检测、分割和姿态估计相同),同时减少一个需要维护的第三方依赖。
因此,在规划 Ultralytics YOLO26 深度估计的部署时,下面来看看几个需要牢记的要点:
- Ultralytics YOLO Depth 专为 RGB 摄像头打造。任何标准摄像头都适用,包括网络摄像头、手机、工业摄像头或无人机。不过,LiDAR 点云、雷达、声呐、热成像和多光谱波段,以及网格和 IFC 数据等其他模态,不属于模型的输入格式支持范围。
- 用于感知决策的公制距离。输出是真实距离,单位为米,因此非常适合用于导航、净空检测和监控。不过,对于任何需要认证公差的应用,专用计量设备仍然是合适的工具。
- 逐图像推理。深度估计会独立处理每一帧,这与其他所有 Ultralytics YOLO26 任务一致,因此可以直接接入现有的逐帧处理流水线,无需改动。跨序列的推理仍由你的应用层负责。
- Ultralytics YOLO26-Depth 在有纹理的不透明表面上效果最好。玻璃、镜面、静水面、抛光金属和开放天空对于任何单摄像头方法而言都存在固有的模糊性,因此建议使用能代表实际环境的场景进行验证。
对视觉 AI 感兴趣?探索我们的许可选项,将计算机视觉应用到你的项目中。访问我们的GitHub 代码仓库,了解 Ultralytics 提供的完整任务和集成;还可以查看 Ultralytics Platform,开始构建自己的端到端视觉 AI 工作流。









