حسّن متانة نماذج الذكاء الاصطناعي باستخدام زيادة البيانات
اكتشف كيف تساعد إضافة تنويعات واقعية إلى بيانات التدريب من خلال زيادة البيانات على تحسين متانة نماذج الذكاء الاصطناعي وأدائها في العالم الحقيقي.
يُعد الاختبار جزءًا بالغ الأهمية من بناء أي حل تقني. فهو يوضح للفرق كيفية عمل النظام فعليًا قبل إطلاقه، ويتيح لها إصلاح المشكلات مبكرًا. وينطبق ذلك على العديد من المجالات، بما فيها الذكاء الاصطناعي، حيث يُتوقع من النماذج التعامل مع ظروف العالم الحقيقي غير المتوقعة بعد نشرها.
على سبيل المثال، تُعد الرؤية الحاسوبية فرعًا من الذكاء الاصطناعي يعلّم الآلات فهم الصور ومقاطع الفيديو. وتدعم نماذج الرؤية الحاسوبية مثل Ultralytics YOLO26 مهامًا مثل اكتشاف الكائنات، وتقسيم المثيلات، وتصنيف الصور.
يمكن استخدامها في العديد من الصناعات لتطبيقات مثل مراقبة المرضى، وتحليل حركة المرور، والدفع الآلي، وفحص الجودة في التصنيع. ومع ذلك، حتى مع النماذج المتقدمة وبيانات التدريب عالية الجودة، قد تظل حلول الذكاء الاصطناعي للرؤية تواجه صعوبات عند التعامل مع اختلافات العالم الحقيقي، مثل تغير الإضاءة أو الحركة أو حجب الكائنات جزئيًا.
يحدث ذلك لأن النماذج تتعلم من الأمثلة المقدمة إليها أثناء التدريب. فإذا لم ترَ من قبل ظروفًا مثل الوهج أو ضبابية الحركة أو الرؤية الجزئية، فستكون أقل قدرة على التعرّف على الكائنات بشكل صحيح في تلك السيناريوهات.
تتمثل إحدى طرق تحسين متانة النموذج في استخدام زيادة البيانات. فبدلًا من جمع كميات كبيرة من البيانات الجديدة، يمكن للمهندسين إجراء تغييرات صغيرة وهادفة على الصور الموجودة، مثل ضبط الإضاءة أو الاقتصاص أو دمج الصور. ويساعد ذلك النموذج على تعلّم التعرّف على الكائنات نفسها ضمن نطاق أوسع من الظروف.
في هذه المقالة، سنستكشف كيفية تعزيز زيادة البيانات لمتانة النموذج وموثوقية أنظمة الذكاء الاصطناعي للرؤية عند نشرها خارج البيئات الخاضعة للتحكم. لنبدأ!
كيفية التحقق من متانة النموذج#
قبل التعمق في زيادة البيانات، دعونا نناقش كيفية معرفة ما إذا كان نموذج الرؤية الحاسوبية جاهزًا فعلًا للاستخدام في العالم الحقيقي.
يواصل النموذج المتين أداءه الجيد حتى عند تغير الظروف، بدلًا من أن يقتصر عمله على الصور النظيفة والموسومة بدقة. فيما يلي بعض العوامل العملية التي ينبغي مراعاتها عند تقييم متانة نموذج الذكاء الاصطناعي:
- تغيرات الإضاءة: قد تتصرف النماذج بشكل مختلف عند تعرضها للضوء الساطع أو الخافت أو الوهج أو الظلال، مما قد يؤثر في مدى ثقتها عند اكتشاف الكائنات.
- الحجب الجزئي: غالبًا ما تُحجب الكائنات في المشاهد اليومية بواسطة عناصر أخرى أو لا تكون ظاهرة إلا جزئيًا. ويتمكن النموذج الأكثر متانة من التعرّف عليها حتى مع فقدان جزء من المعلومات المرئية.
- المشاهد المزدحمة: قد تجعل البيئات التي تحتوي على العديد من الكائنات المتداخلة عملية الاكتشاف أكثر صعوبة. وعادةً ما تكون النماذج التي تؤدي جيدًا في هذه الحالات أكثر موثوقية في البيئات المعقدة.
لا تُترجم النتائج الجيدة على الصور النظيفة والمُلتقطة بدقة إلى أداء قوي في العالم الحقيقي دائمًا. ويساعد الاختبار المنتظم عبر ظروف متنوعة على إظهار مدى قدرة النموذج على الصمود بعد نشره.
ما زيادة البيانات؟#
يمكن أن يتغير مظهر الكائن في الصورة تبعًا للإضاءة أو الزاوية أو المسافة أو الخلفية. وعند تدريب نموذج للرؤية الحاسوبية، يجب أن تتضمن مجموعة البيانات التي يتعلم منها هذا النوع من التنوع، حتى يتمكن من الأداء جيدًا في البيئات غير المتوقعة.
توسّع زيادة البيانات مجموعة بيانات التدريب من خلال إنشاء أمثلة إضافية من الصور المتوفرة لديك. ويتم ذلك بتطبيق تغييرات مقصودة، مثل تدوير الصورة أو قلبها، أو ضبط سطوعها، أو اقتصاص جزء منها.
على سبيل المثال، تخيل أن لديك صورة واحدة فقط لقطة. إذا أدرت الصورة أو غيّرت سطوعها، يمكنك إنشاء عدة إصدارات جديدة من تلك الصورة الواحدة. يبدو كل إصدار مختلفًا قليلًا، لكنه يظل صورة للقطة نفسها. وتساعد هذه الاختلافات على تعليم النموذج أن الكائن يمكن أن يبدو مختلفًا مع بقائه الشيء نفسه.
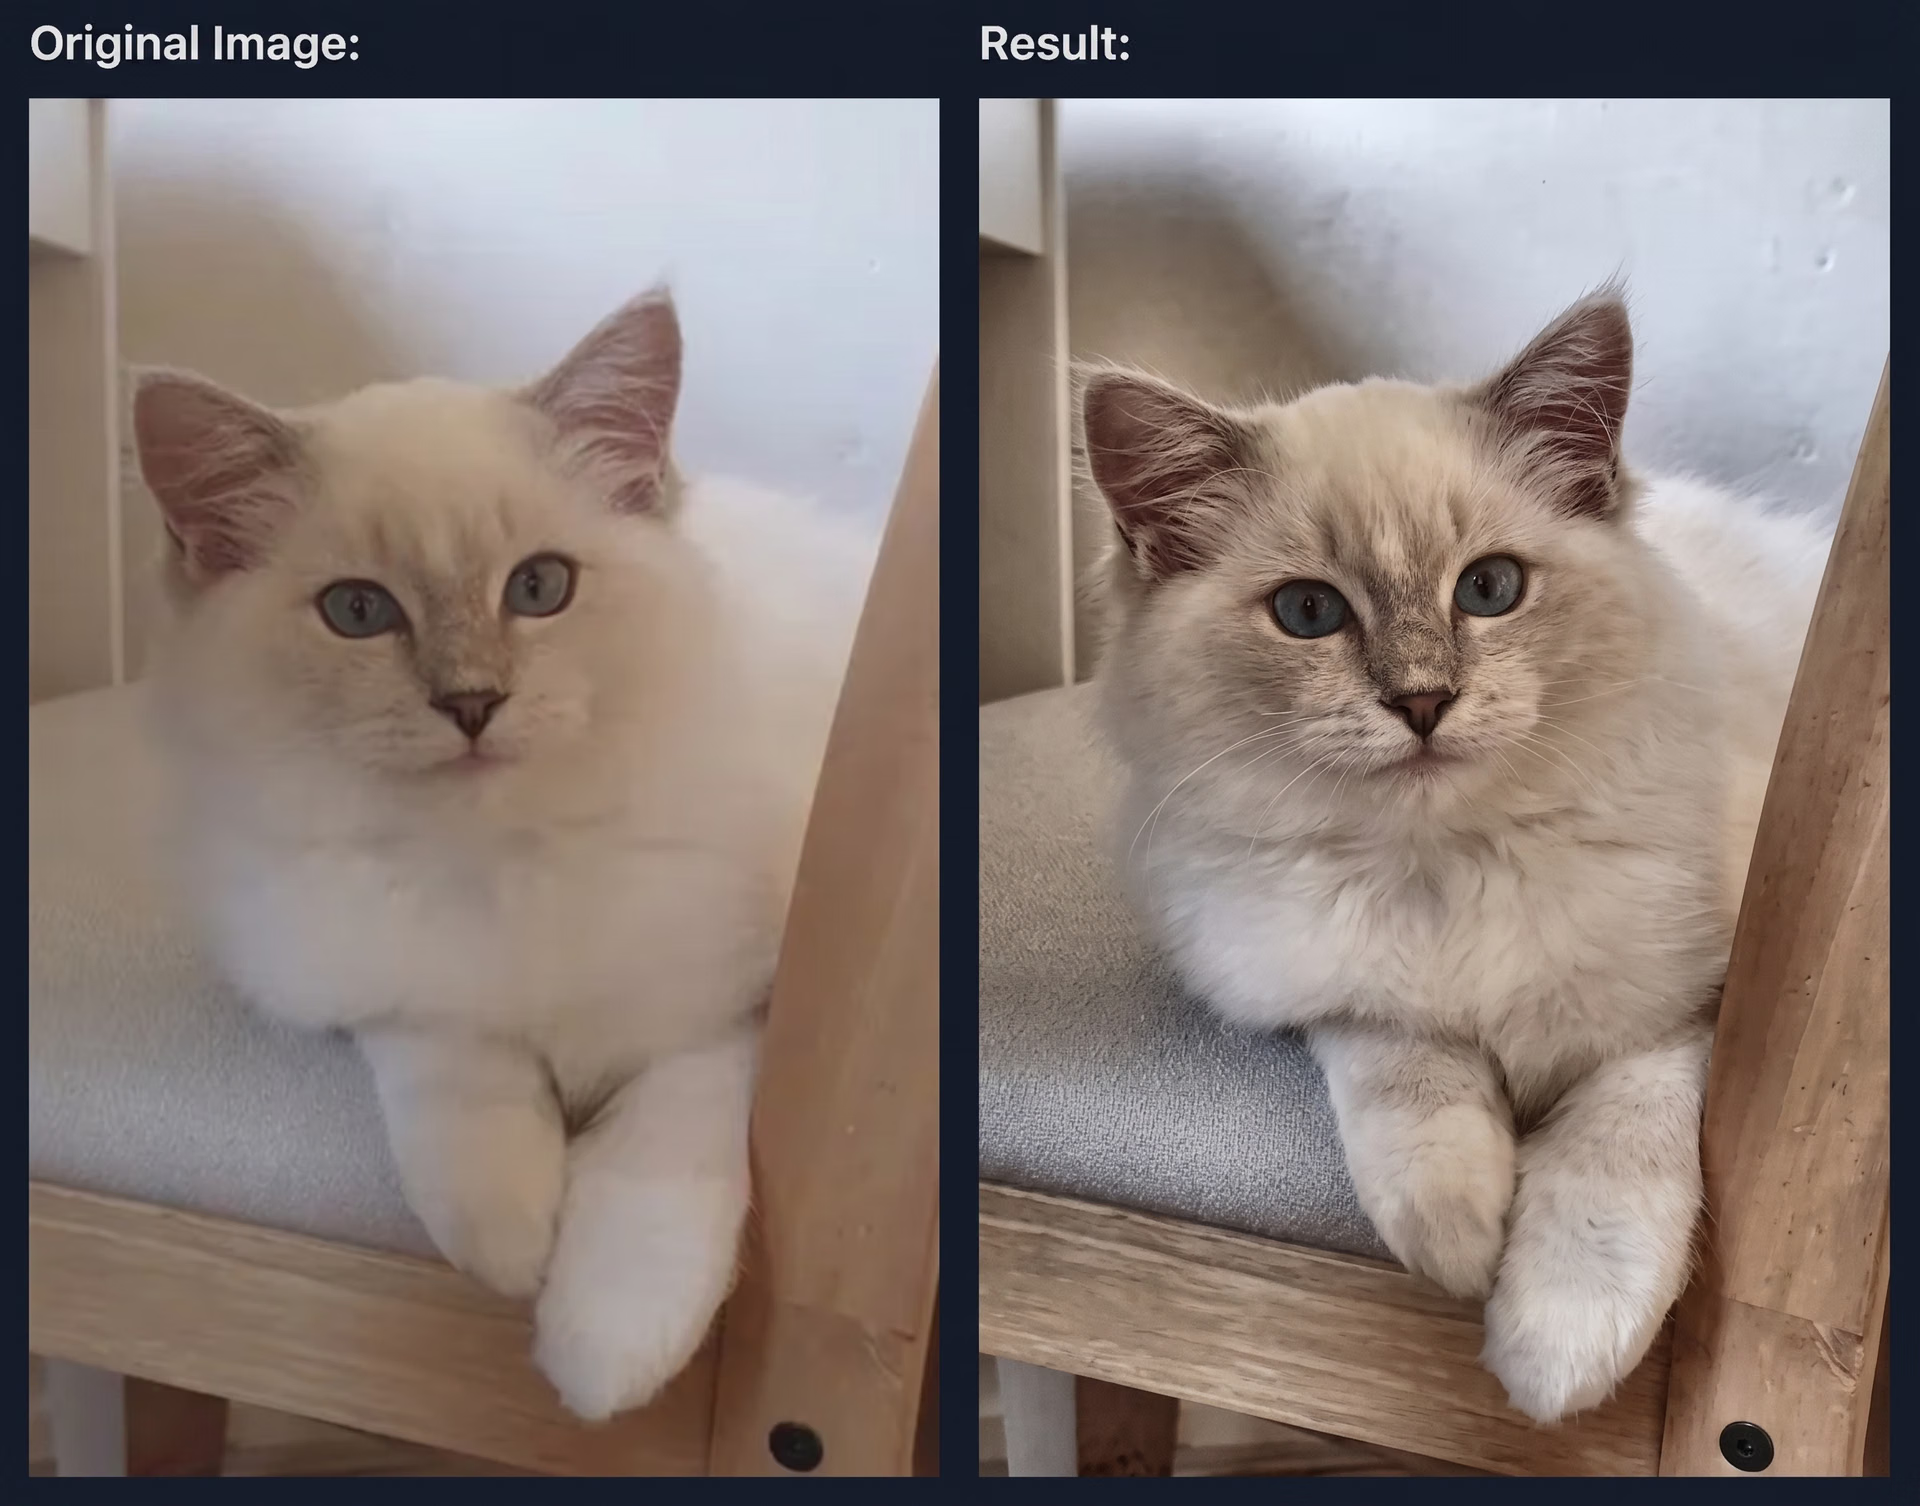
الشكل 1. نظرة على زيادة بيانات صورة قطة (المصدر)
كيف تحسّن زيادة البيانات أداء النموذج#
أثناء تدريب النموذج، يمكن دمج زيادة البيانات مباشرةً في مسار التدريب. فبدلًا من إنشاء نسخ جديدة من الصور وتخزينها يدويًا، يمكن تطبيق تحويلات عشوائية عند تحميل كل صورة.
وهذا يعني أن النموذج يرى إصدارًا مختلفًا قليلًا من الصورة في كل مرة، سواء بدت أكثر سطوعًا أو مقلوبة أو محجوبة جزئيًا. ويمكن لتقنيات مثل المحو العشوائي أن تزيل مناطق صغيرة من الصورة لمحاكاة مواقف العالم الحقيقي التي يكون فيها الكائن محجوبًا أو ظاهرًا جزئيًا فقط.
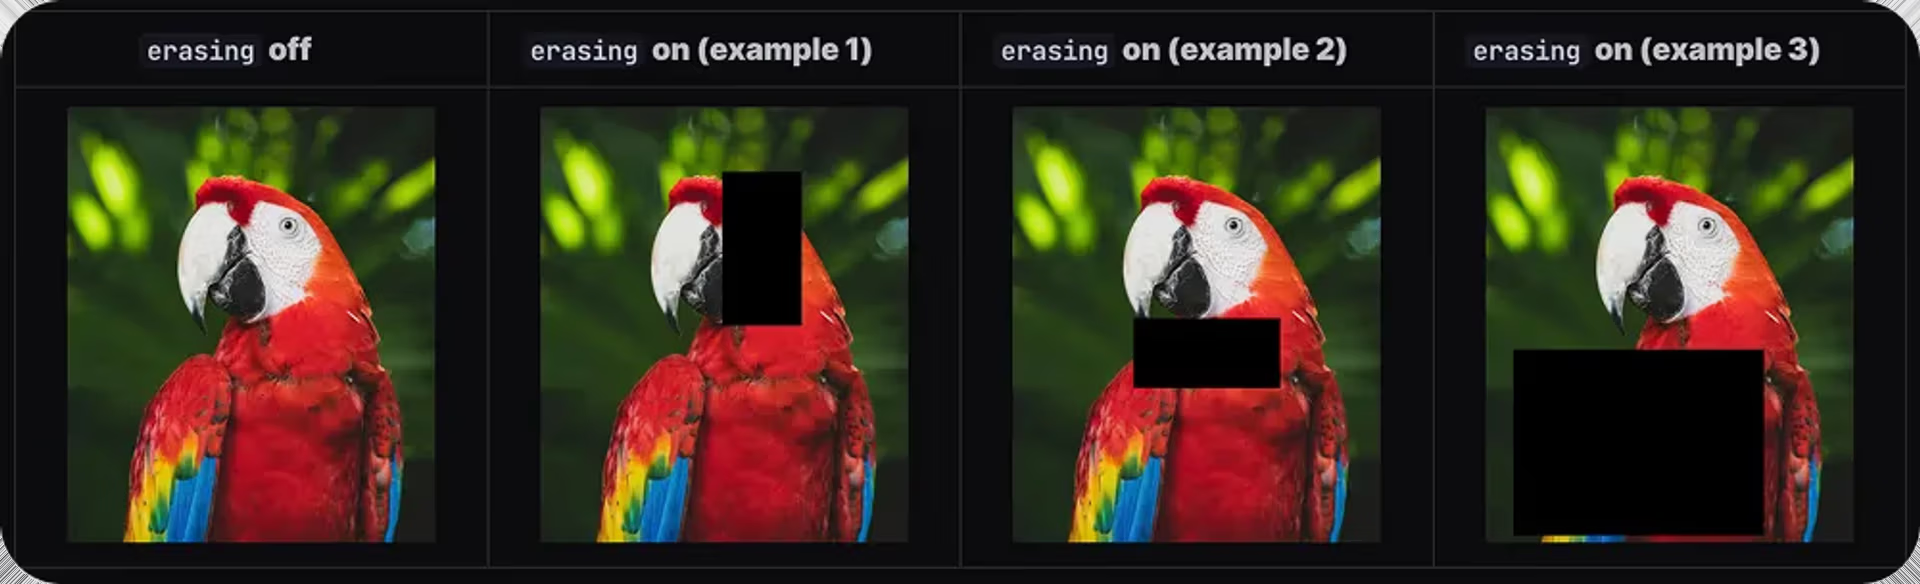
الشكل 2. أمثلة على زيادة البيانات القائمة على المحو العشوائي (المصدر)
تتيح رؤية العديد من الإصدارات المختلفة للصورة نفسها للنموذج أن يتعلم السمات المهمة، بدلًا من الاعتماد على مثال مثالي واحد. ويبني هذا التنوع متانة نموذج الذكاء الاصطناعي، بحيث يتمكن من الأداء بموثوقية أكبر في ظروف العالم الحقيقي.
تقنيات زيادة البيانات الشائعة#
فيما يلي بعض تقنيات زيادة البيانات المستخدمة لإدخال التنوع إلى صور التدريب:
- التحويلات الهندسية: تغيّر هذه التقنيات كيفية ظهور الكائن مكانيًا داخل الصورة. ويتيح تدوير الصورة أو قلبها أو تغيير حجمها أو اقتصاصها أو إزاحتها للنموذج فهم كيفية رؤية الكائن من زوايا أو مسافات مختلفة.
- ضبط الألوان والإضاءة: نادرًا ما تكون إضاءة العالم الحقيقي ثابتة. فقد تكون الصور شديدة السطوع أو شديدة الظ darkness أو مختلفة قليلًا في ألوانها، تبعًا للبيئة أو الكاميرا المستخدمة. ويتيح ضبط السطوع والتباين ودرجة اللون والتشبع للنماذج التعامل مع هذه التغيرات المرئية والأداء جيدًا عبر مشاهد مختلفة.
- اختلافات جودة الصورة: قد تجعل الضبابية أو التشويش المرئي الصور تبدو غير واضحة. وتساعد إضافة الضبابية أو التشويش أثناء التدريب النموذج على تعلم التعامل مع ضبابية الحركة أو الصور منخفضة الإضاءة أو نتائج الكاميرات منخفضة الجودة، مما يجعله أقل حساسية للصور غير المثالية.
- زيادات البيانات القائمة على الحجب: غالبًا ما تُحجب الكائنات جزئيًا بواسطة كائنات أخرى في البيئات الحقيقية. ويُشار إلى ذلك باسم حجب الصور. ويدعم إخفاء مناطق صغيرة من الصورة أو وضع أقنعة عليها أثناء التدريب تعلّم النموذج اكتشاف الكائنات حتى عندما يكون جزء منها فقط ظاهرًا.
- زيادات البيانات متعددة الصور: تدمج هذه التقنيات أجزاءً من صور متعددة في مثال تدريب واحد، مما قد يزيد عدد الكائنات الظاهرة ويحسّن قدرة النموذج على التعامل مع المشاهد المعقدة أو المزدحمة.
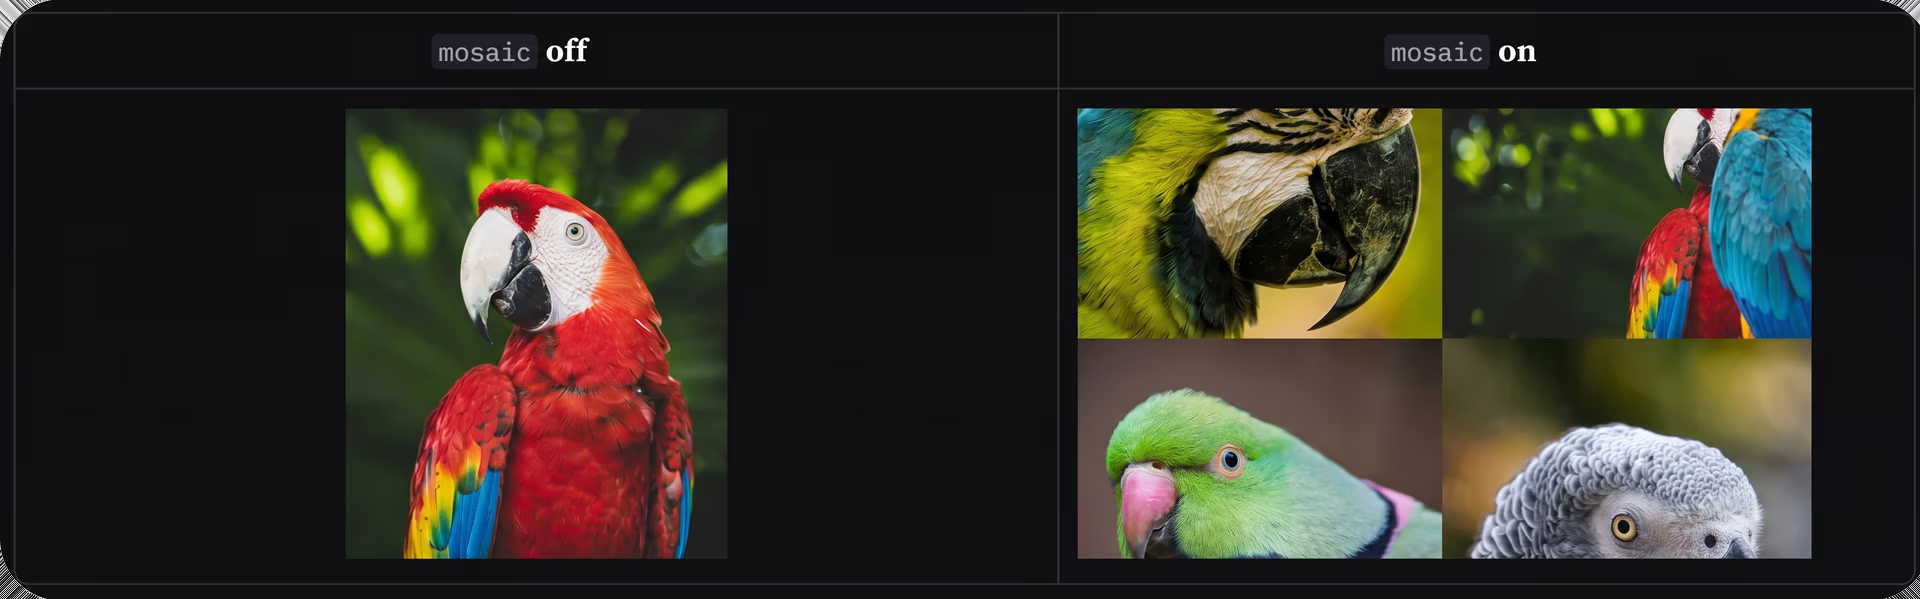
الشكل 3. مثال على زيادة البيانات متعددة الصور (المصدر)
تبسيط زيادة البيانات باستخدام حزمة Ultralytics Python#
يمكن أن تؤدي إدارة مجموعات البيانات وإنشاء تنويعات للصور وكتابة شيفرة التحويلات إلى إضافة خطوات extra إلى بناء تطبيق للرؤية الحاسوبية. وتساعد حزمة Ultralytics Python على تبسيط ذلك من خلال توفير واجهة واحدة لتدريب نماذج Ultralytics YOLO مثل YOLO26 وتشغيلها ونشرها. وكجزء من هذا الجهد لتبسيط مسارات عمل التدريب، تتضمن الحزمة زيادة بيانات مدمجة اختبرتها Ultralytics ومحسّنة لنماذج YOLO.
كما تدعم عمليات تكامل مفيدة تلغي الحاجة إلى أدوات منفصلة أو شيفرة مخصصة. وتحديدًا بالنسبة إلى زيادة البيانات، تتكامل الحزمة مع Albumentations، وهي مكتبة مستخدمة على نطاق واسع لزيادة الصور. ويتيح هذا التكامل تطبيق الزيادات تلقائيًا أثناء التدريب، من دون الحاجة إلى نصوص برمجية إضافية أو شيفرة مخصصة.
إدارة التعليقات التوضيحية ومجموعات البيانات المُعزَّزة#
هناك عامل آخر يؤثر في متانة النموذج، وهو جودة التعليقات التوضيحية. وتساعد التسميات النظيفة والدقيقة، التي تُنشأ وتُدار باستخدام أدوات للتعليقات التوضيحية مثل Roboflow، النموذج على فهم مواضع الكائنات ومظهرها.
أثناء التدريب، تُطبَّق زيادات البيانات مثل القلب والاقتصاص والتدوير ديناميكيًا، وتُعدَّل التعليقات التوضيحية تلقائيًا لتتوافق مع هذه التغييرات. وعندما تكون التسميات دقيقة، تعمل هذه العملية بسلاسة وتزوّد النموذج بالعديد من الأمثلة الواقعية للمشهد نفسه.
إذا كانت التعليقات التوضيحية غير دقيقة أو غير متسقة، فقد تتكرر هذه الأخطاء عبر الصور المُعزَّزة، مما قد يجعل التدريب أقل فعالية. ويمنع البدء بتعليقات توضيحية دقيقة انتشار هذه الأخطاء ويسهم في تحسين متانة النموذج.
تعزيز تطبيقات الذكاء الاصطناعي للرؤية باستخدام زيادة البيانات#
بعد ذلك، سنستعرض أمثلة على كيفية إسهام زيادة البيانات في متانة نماذج الذكاء الاصطناعي في تطبيقات العالم الحقيقي.
تعزيز دقة اكتشاف الكائنات في البيئات الحقيقية#
غالبًا ما تُستخدم الصور الاصطناعية لتدريب أنظمة اكتشاف الكائنات عندما تكون البيانات الحقيقية محدودة أو حساسة أو يصعب جمعها. فهي تتيح للفرق إنشاء أمثلة للمنتجات والبيئات وزوايا الكاميرا بسرعة، من دون الحاجة إلى التقاط كل سيناريو في الحياة الواقعية.
ومع ذلك، قد تبدو مجموعات البيانات الاصطناعية أحيانًا نظيفة أكثر من اللازم مقارنةً باللقطات الواقعية، حيث تتغير الإضاءة وتتداخل الكائنات وتتضمن المشاهد عناصر خلفية مشتتة. وتساعد زيادة البيانات على سد هذه الفجوة من خلال إدخال اختلافات واقعية، مثل اختلاف الإضاءة أو التشويش أو مواضع الكائنات، حتى يتعلم النموذج التعامل مع أنواع الظروف التي سيواجهها عند نشره.
على سبيل المثال، في دراسة حديثة، دُرِّب نموذج Ultralytics YOLO11 بالكامل على صور اصطناعية، وأُضيفت زيادة البيانات لإدخال تنوع إضافي. وأسهم ذلك في تعلّم النموذج التعرّف على الكائنات على نطاق أوسع. وقد أدى أداءً جيدًا عند اختباره على صور حقيقية، رغم أنه لم يرَ بيانات من العالم الحقيقي أثناء التدريب.
جعل حلول التصوير الطبي أكثر موثوقية#
غالبًا ما تكون مجموعات بيانات التصوير الطبي محدودة، كما قد تختلف الفحوصات نفسها بناءً على نوع المعدات أو إعدادات التصوير أو البيئة السريرية. وقد تجعل الاختلافات في تشريح المرضى أو الزوايا أو الإضاءة أو التشويش المرئي من الصعب على نماذج الرؤية الحاسوبية تعلم أنماط تعمم جيدًا عبر المرضى والمستشفيات.
تساعد زيادة البيانات على معالجة ذلك من خلال إنشاء تنويعات متعددة للفحص نفسه أثناء التدريب، مثل إضافة التشويش أو إزاحة الصورة قليلًا أو تطبيق تشوهات صغيرة. وتجعل هذه التغييرات بيانات التدريب أكثر تمثيلًا للظروف السريرية الحقيقية.
على سبيل المثال، في دراسة حول التصوير الطبي للأطفال، استخدم الباحثون Ultralytics YOLO11 لتقسيم البنى التشريحية ودربوه على بيانات طبية مُعزَّزة. وقد أدخلوا تنويعات مثل إضافة التشويش، وإزاحات طفيفة في الموضع، وتشوهات صغيرة لجعل الصور أكثر واقعية.
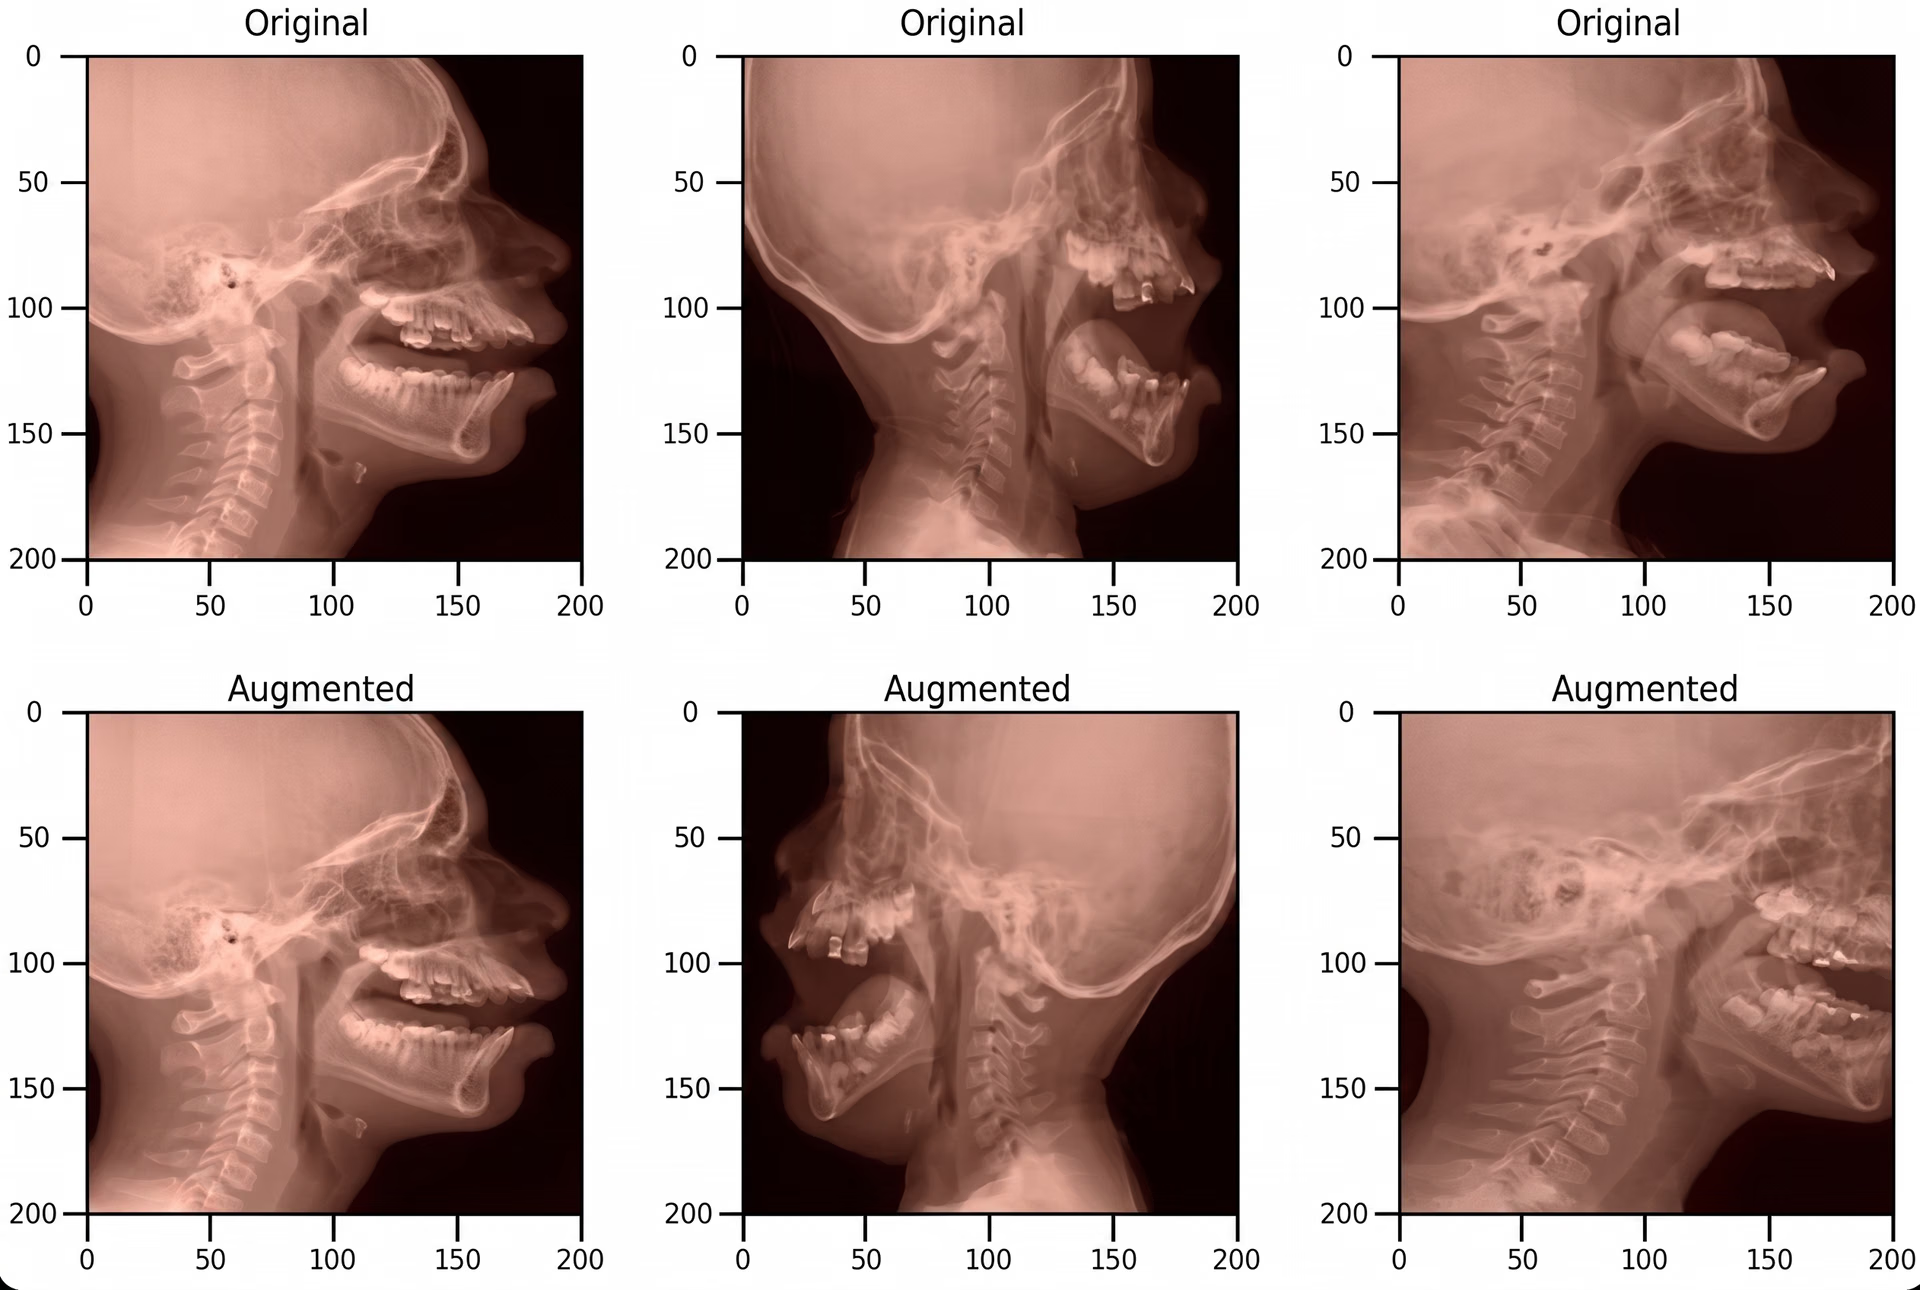
الشكل 4. صور طبية أصلية ومعزَّزة للأطفال (المصدر)
من خلال التعلم من هذه الاختلافات، ركّز النموذج على السمات التشريحية المهمة بدلًا من الفروق السطحية. وجعل ذلك نتائج التقسيم أكثر استقرارًا عبر الفحوصات وحالات المرضى المختلفة.
أهم النقاط المستخلصة#
يصعب جمع بيانات متنوعة، لكن زيادة البيانات تتيح للنماذج التعلم من نطاق أوسع من الظروف المرئية. وينتج عن ذلك متانة أكبر للنموذج عند التعامل مع الحجب وتغيرات الإضاءة والمشاهد المزدحمة. وبوجه عام، يساعد ذلك النماذج على الأداء بموثوقية أكبر خارج بيئات التدريب الخاضعة للتحكم.
انضم إلى مجتمعنا واستكشف أحدث التطورات في الذكاء الاصطناعي للرؤية على مستودع GitHub الخاص بنا. تفضل بزيارة صفحات حلولنا للتعرّف على كيفية دفع تطبيقات مثل الذكاء الاصطناعي في التصنيع والرؤية الحاسوبية في الرعاية الصحية عجلة التقدم، واطّلع على خيارات الترخيص لتشغيل حل الذكاء الاصطناعي التالي الخاص بك.








