ما تقدير العمق أحادي العين؟ نظرة عامة
تعرّف على آلية عمل تقدير العمق أحادي العين، وكيف يقارن بأساليب تقدير العمق المعتمدة على المستشعرات، وكيف يتيح إدراكًا ثلاثي الأبعاد قابلًا للتوسع في أنظمة الرؤية.
 Abirami Vina15 دقيقة قراءة
صُممت السيارات ذاتية القيادة لفهم ما يجري حولها كي تتمكن من القيادة بأمان. وهذا يعني تجاوز مجرد التعرّف على الأجسام، مثل المشاة أو المركبات الأخرى.
كما تحتاج إلى معرفة بُعد تلك الأجسام كي تستجيب على نحو صحيح. لكن تزويد الآلات بهذا الإحساس بالمسافة ليس أمرًا مباشرًا. فعلى خلاف البشر، لا تدرك الآلات العمق من الصور تلقائيًا، بل يجب تعليمها ذلك صراحةً.
ومن أسباب ذلك أن معظم الكاميرات تلتقط العالم على هيئة صور مسطحة ثنائية الأبعاد. ومن الصعب تحويل تلك الصور إلى ما يعكس العمق والبنية الثلاثية الأبعاد للعالم الحقيقي، ولا سيما عندما يتعين على الأنظمة العمل بموثوقية في الظروف اليومية.
ومن المثير للاهتمام أن الرؤية الحاسوبية، وهي فرع من الذكاء الاصطناعي يركز على تفسير البيانات المرئية وفهمها، تتيح للآلات فهم العالم من الصور على نحو أفضل. فعلى سبيل المثال، يُعد تقدير العمق أحادي العين تقنية للرؤية الحاسوبية تقدّر بُعد الأجسام باستخدام صورة واحدة من كاميرا واحدة فقط.
من خلال تعلّم الإشارات البصرية مثل حجم الأجسام والمنظور والملمس والتظليل، تستطيع هذه النماذج تقدير العمق دون الاعتماد على مستشعرات إضافية مثل LiDAR (الكشف عن الضوء وتحديد مداه) أو الكاميرات المجسّمة. في هذا المقال، سنستكشف ماهية تقدير العمق أحادي العين، وكيفية عمله، وبعض تطبيقاته في الواقع.
مقدمة سريعة إلى تقدير العمق أحادي العين#
يتيح تقدير العمق أحادي العين للآلة معرفة بُعد الأجسام عنها باستخدام صورة واحدة فقط. ولأن هذا النهج يعتمد على كاميرا واحدة فقط، فإنه يوفر مزايا عدة، منها انخفاض التكلفة وبساطة متطلبات الأجهزة.
فعلى سبيل المثال، يمكن استخدامه في روبوتات منزلية منخفضة التكلفة تعمل بكاميرا واحدة. وحتى من صورة واحدة، يستطيع النظام الروبوتي تحديد الجدران الأقرب والأبواب الأبعد، واستنتاج العمق العام للمكان.
غالبًا لا تتضمن الصورة الواحدة معلومات بمقياس صحيح، لذلك يركز تقدير العمق أحادي العين عمومًا على العمق النسبي. وبعبارة أخرى، يمكنه تحديد الأجسام الأقرب والأبعد، حتى إن لم تكن المسافات الدقيقة معروفة.
عندما يُدرَّب النموذج على بيانات تتضمن مسافات مرجعية صحيحة أو عمقًا مطلقًا، مثل قياسات العمق المستمدة من مستشعرات كـ LiDAR، يمكنه تعلم توقّع المسافات بوحدات العالم الحقيقي، مثل الأمتار. ومن دون هذا النوع من البيانات المرجعية، يظل النموذج قادرًا على استنتاج العمق النسبي، لكنه لا يستطيع تقدير المسافات المطلقة بموثوقية.
تكون مخرجات تقدير العمق أحادي العين عادةً خريطة عمق، وهي صورة تمثل فيها كل بكسلة مدى قرب ذلك الجزء من المشهد أو بعده. وتمنح خريطة العمق أنظمة الرؤية فهمًا أساسيًا للبنية الثلاثية الأبعاد للبيئة.
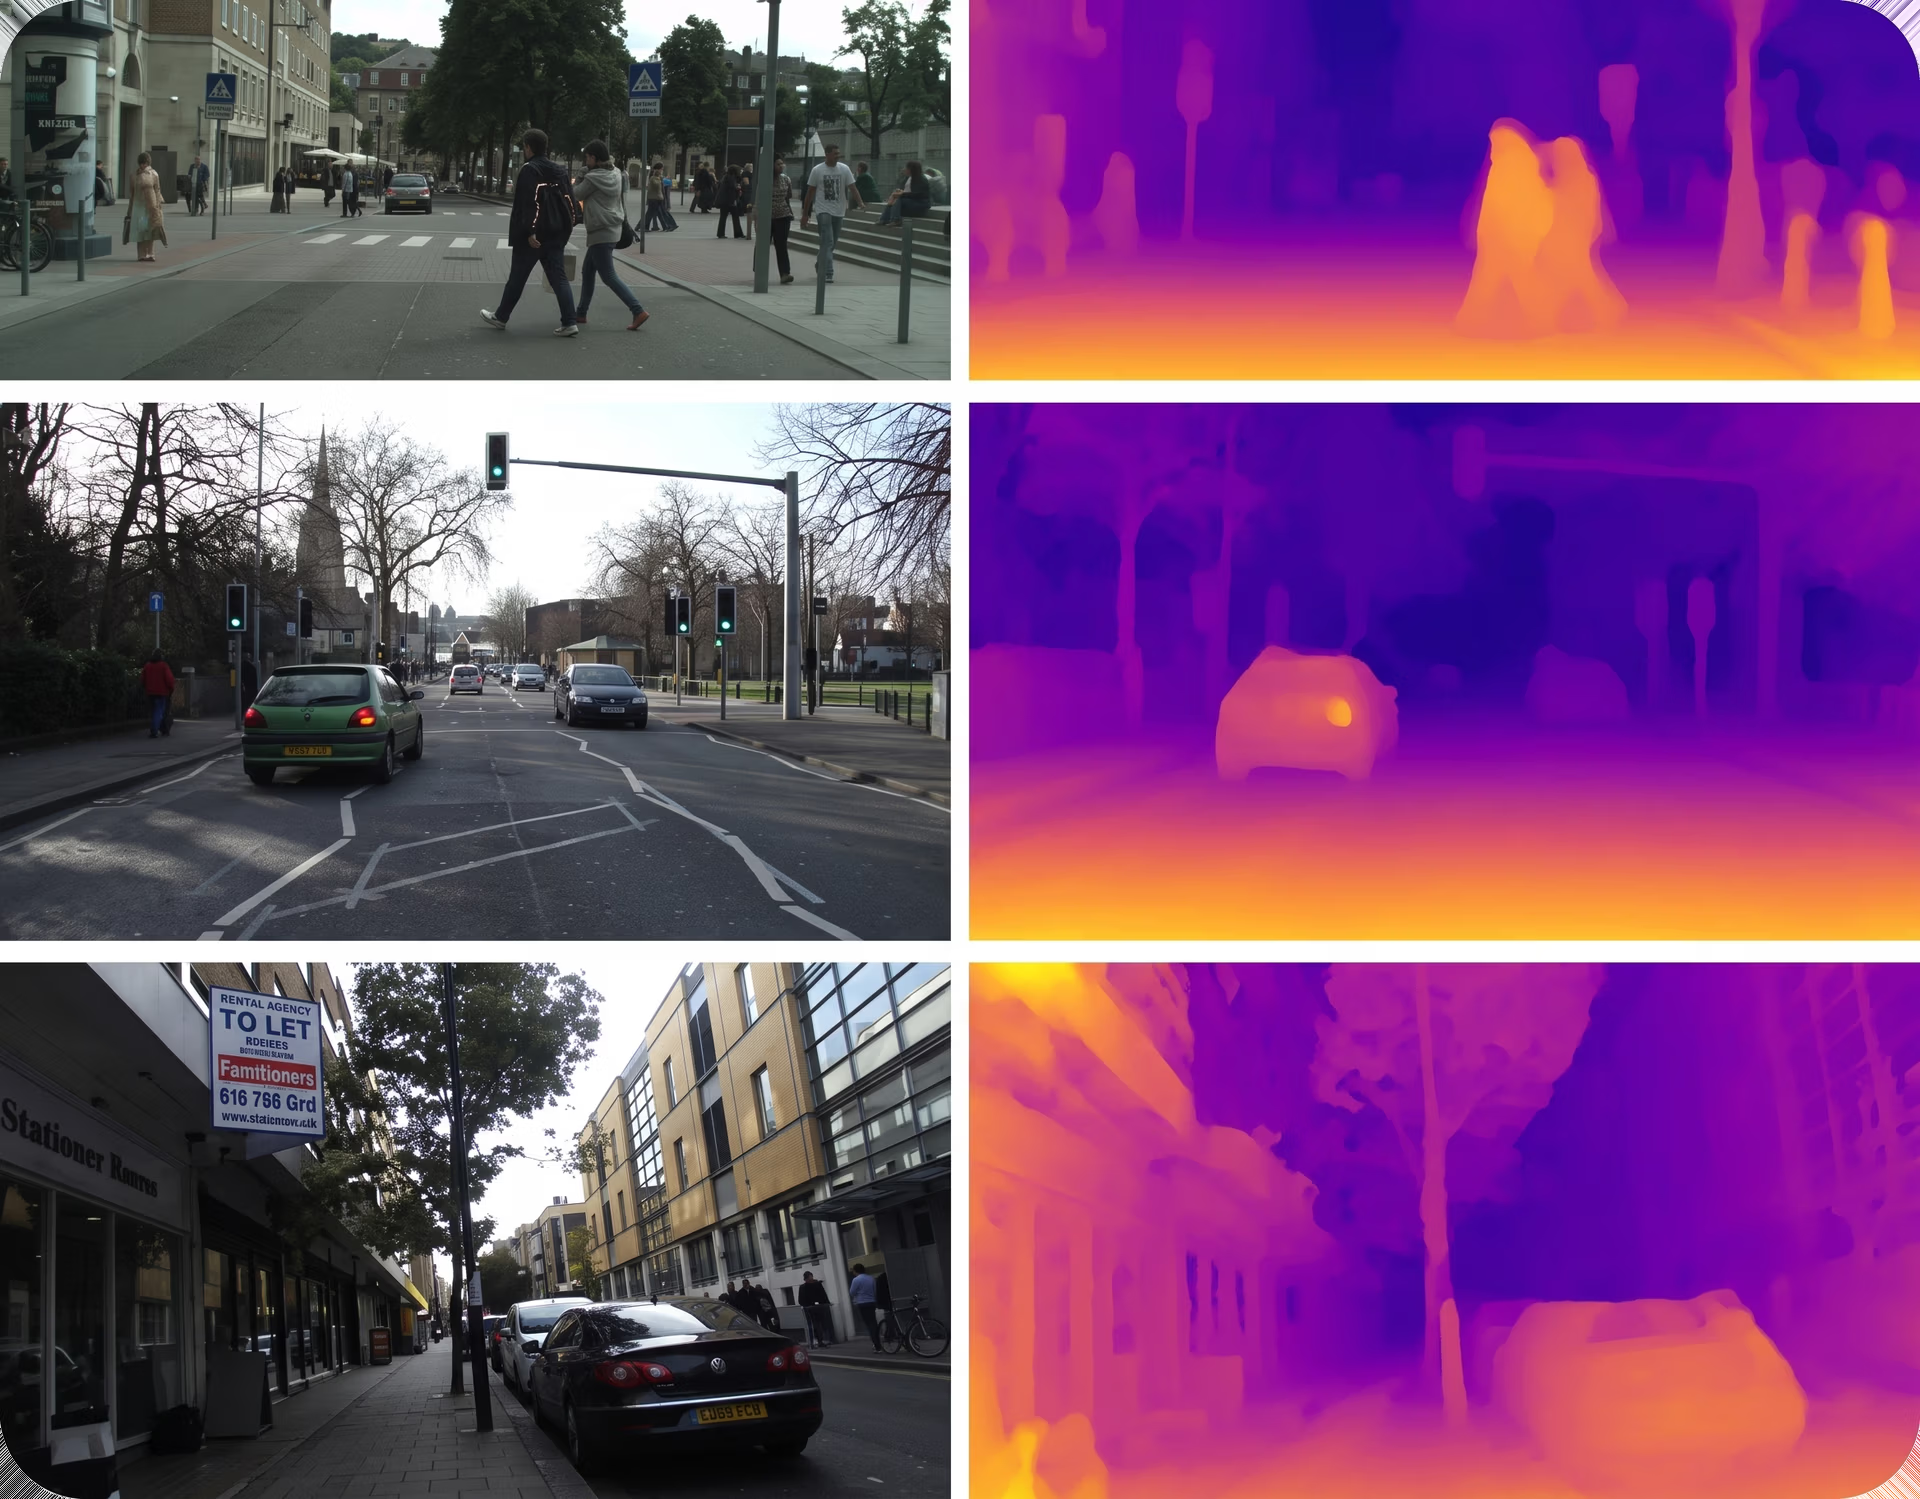
الشكل 1. مثال على خريطة عمق متوقعة أُنشئت باستخدام تقدير العمق أحادي العين (المصدر)
من المستشعرات إلى الصور: تقدير العمق#
يمكن اتباع عدة أساليب لتقدير العمق، وفقًا للمستشعرات المتاحة وقيود الأجهزة ومتطلبات الدقة. وتعتمد الطرق التقليدية غالبًا على نقاط مشاهدة متعددة أو مستشعرات متخصصة لقياس المسافة مباشرةً.
من الأساليب الشائعة الرؤية المجسمة، التي تقدّر العمق بمقارنة صورتين متزامنتين ملتقطتين من نقطتي مشاهدة متقاربتين ومختلفتين قليلًا. وبقياس الاختلاف بين النقاط المتناظرة في الصورتين، يستطيع النظام استنتاج بُعد الأجسام عن الكاميرا.
ومن الأساليب الأخرى أنظمة RGB-D (الأحمر والأخضر والأزرق والعمق)، التي تستخدم مستشعرات عمق نشطة لقياس المسافة مباشرةً عند كل بكسلة. ويمكن لهذه الأنظمة توفير معلومات دقيقة عن العمق في البيئات المضبوطة، لكنها تتطلب أجهزة إضافية.
أما الأساليب المعتمدة على LiDAR فتستخدم نبضات الليزر لإنشاء تمثيلات ثلاثية الأبعاد دقيقة للمشهد. ورغم دقتها العالية، غالبًا ما تكون مستشعرات LiDAR باهظة الثمن وتضيف تعقيدًا كبيرًا إلى الأجهزة.
في المقابل، يستنتج تقدير العمق أحادي العين العمق باستخدام صورة RGB واحدة فقط. ولأنه لا يعتمد على كاميرات متعددة أو مستشعرات متخصصة، فمن الأسهل نشره على نطاق واسع، كما أنه خيار مناسب عندما تكون التكلفة وموارد الأجهزة محدودة.
تعلّم العمق من صورة واحدة#
عند تقدير العمق من صورة واحدة، تتعلم نماذج العمق أحادي العين التعرّف على المؤشرات البصرية التي يستخدمها البشر تلقائيًا لتقدير المسافة. وتشمل هذه المؤشرات خطوط المنظور وحجم الجسم وكثافة الملمس وتداخل الأجسام والتظليل، وكلها تقدم دلائل على بُعد الأجسام عن الكاميرا.
تعمل هذه المؤشرات معًا لتكوين الإحساس بالعمق. فغالبًا ما تكون الأجسام التي تبدو أصغر أو المحجوبة جزئيًا أبعد، بينما تشير التفاصيل الأوضح والمظاهر البصرية الأكبر عادةً إلى أن الشيء أقرب.
ولتعلم هذه الأنماط، تُدرَّب نماذج العمق أحادي العين على مجموعات بيانات صور واسعة النطاق، غالبًا ما تقترن بمعلومات عمق مستمدة من مصادر أخرى مثل أنظمة LiDAR أو الأنظمة المجسمة. وأثناء التدريب، تتعلم النماذج العلاقة بين المؤشرات البصرية والعمق، ما يتيح لها استنتاج المسافة من صورة واحدة عند الاستدلال.
وبفضل تنوع بيانات التدريب، تستطيع نماذج الرؤية الحديثة تعميم هذا الفهم المكتسب على نطاق واسع من البيئات، بما فيها المشاهد الداخلية والخارجية، والتعامل مع زوايا المشاهدة غير المألوفة.
نظرة على تقنيات متنوعة لتقدير العمق أحادي العين#
سنستكشف بعد ذلك الأساليب الرئيسية المستخدمة لتقدير العمق من صورة واحدة، وكيف تطورت هذه الأساليب بمرور الوقت.
الأساليب التقليدية والقائمة على الهندسة#
اعتمدت أساليب تقدير العمق المبكرة على قواعد بصرية مباشرة مرتبطة بـهندسة الكاميرا. واستُخدمت مؤشرات مثل المنظور وحجم الجسم وحجب جسم لآخر لتقدير المسافة.
فعلى سبيل المثال، عندما يظهر جسمان متشابهان بحجمين مختلفين، يُفترض أن الأصغر أبعد. وقد حققت هذه الأساليب نتائج معقولة في البيئات المضبوطة، حيث تظل عوامل مثل الإضاءة وموضع الكاميرا وتخطيط المشهد ثابتة.
لكن هذه الافتراضات كثيرًا ما تنهار في المشاهد الواقعية. إذ يمكن أن تؤدي التغيرات في الإضاءة وتبدّل زاوية المشاهدة وازدياد تعقيد المشهد إلى تقديرات غير موثوقة للعمق، ما يحد من فعالية الأساليب التقليدية في الظروف غير المضبوطة.
أساليب تعلم الآلة المبكرة#
أتاحت أساليب تعلم الآلة المبكرة قدرًا أكبر من المرونة في تقدير العمق، إذ تعلمت الأنماط مباشرةً من البيانات. وبدلًا من الاعتماد على قواعد هندسية ثابتة فحسب، حاولت هذه النماذج تعلم العلاقة بين المعلومات البصرية والمسافة، والتعامل مع توقّع العمق بوصفه مسألة انحدار تستند إلى مؤشرات مثل الحواف والأنسجة وتغيرات الألوان.
كان اختيار هذه السمات جزءًا أساسيًا من العملية. إذ كان على المهندسين تحديد الإشارات البصرية التي ينبغي استخراجها وكيفية تمثيلها، وكان أداء النموذج يعتمد اعتمادًا كبيرًا على تلك الخيارات.
ورغم أن هذا النهج كان أفضل من الأساليب السابقة، فقد ظل محدودًا. فإذا افتقرت السمات المختارة إلى السياق المهم، كانت توقعات العمق أقل دقة. ومع ازدياد تعقيد المشاهد وتنوعها، واجهت هذه النماذج صعوبة في كثير من الأحيان في إنتاج نتائج موثوقة.
خوارزميات التعلم العميق#
تستخدم معظم أنظمة تقدير العمق أحادي العين الحديثة التعلم العميق، أي الشبكات العصبية ذات الطبقات الكثيرة القادرة على تعلم أنماط معقدة من البيانات. وتتعلم هذه النماذج توقّع العمق مباشرةً من الصور وإنشاء خرائط العمق.
تُبنى أساليب كثيرة باستخدام الشبكات العصبية الالتفافية (CNNs)، وهي نوع من الشبكات العصبية المصممة لمعالجة الصور عبر اكتشاف أنماط مثل الحواف والأشكال. وغالبًا ما تستخدم هذه النماذج بنية مُرمِّز–مُفكِّك ترميز: يستخرج المُرمِّز السمات البصرية من الصورة، ثم يحوّل المُفكِّك تلك السمات إلى خريطة عمق. وتساعد معالجة الصورة بمقاييس متعددة النموذج على استيعاب التخطيط العام للمشهد مع الحفاظ على وضوح حدود الأجسام.
تركز النماذج الأحدث على فهم العلاقات بين الأجزاء المختلفة للصورة. وتستخدم النماذج القائمة على Transformer ونماذج المحوّلات البصرية (ViT) آليات الانتباه، التي تتيح للنموذج تحديد مناطق الصورة الأكثر صلة وربط المناطق المتباعدة بعضها ببعض. وهذا يساعد النموذج على بناء فهم أكثر اتساقًا للعمق في المشهد بأكمله.
تجمع بعض الأنظمة بين الفكرتين. إذ تستخدم نماذج CNN–Transformer الهجينة شبكات CNN لالتقاط التفاصيل المحلية الدقيقة، وTransformers لنمذجة السياق العام للمشهد. ورغم أن ذلك يحسن الدقة غالبًا، فإنه يتطلب عادةً موارد حوسبة أكبر، مثل ذاكرة إضافية وقدرة معالجة أعلى.
أهمية فهم العمق لأنظمة الذكاء الاصطناعي للرؤية#
أثناء تعرّفك على تقدير العمق أحادي العين، قد تتساءل عن سبب أهمية فهم العمق لهذه الدرجة في أنظمة الذكاء الاصطناعي القائمة على الرؤية.
عندما يستطيع النظام تقدير بُعد الأجسام والأسطح، يصبح لديه فهم أفضل لتوزيع عناصر المشهد وعلاقاتها بعضها ببعض. ويُعد هذا النوع من الوعي المكاني ضروريًا لاتخاذ قرارات موثوقة، ولا سيما في التطبيقات الواقعية مثل القيادة الذاتية.
تضيف معلومات العمق أيضًا سياقًا قيّمًا إلى مهام الرؤية الحاسوبية الأخرى. فعلى سبيل المثال، يمكن لاكتشاف الأجسام، الذي تدعمه نماذج مثل Ultralytics YOLO26، أن يخبر النظام بما يوجد في المشهد، لكن العمق يساعد على تحديد مواقع تلك الأجسام بالنسبة إلى الكاميرا وإلى بعضها بعضًا.
تتيح هذه القدرات مجتمعةً مجموعة واسعة من تطبيقات الذكاء الاصطناعي للرؤية، مثل إنشاء خرائط ثلاثية الأبعاد والتنقل في البيئات المعقدة وفهم المشهد ككل.
تعتمد الروبوتات والمركبات ذاتية القيادة على هذه المعلومات للتحرك بأمان وتجنب العوائق والاستجابة للتغيرات في الوقت الفعلي. فعلى سبيل المثال، يعتمد نهج القيادة المعتمد على الرؤية فقط لدى Tesla على صور الكاميرات مقرونةً بتقدير العمق، بدلًا من LiDAR، لفهم بُعد الأجسام وكيفية تموضعها على الطريق.
آلية عمل نماذج تقدير العمق أحادي العين#
على الرغم من اختلاف بنى النماذج، تتبع معظم نماذج تقدير العمق أحادي العين عملية متشابهة لتحويل صورة واحدة إلى خريطة عمق. إليك نظرة سريعة على الخطوات الرئيسية:
- الإدخال والمعالجة المسبقة: يبدأ سير العمل بصورة إدخال. وقبل تمرير الصورة الأصلية إلى النموذج، تُعاد عادةً تهيئتها بالحجم والتطبيع وتحويلها إلى موتر، وهو تنسيق تستخدمه الشبكات العصبية لمعالجة بيانات الصور بكفاءة.
- استخراج السمات: تحلل شبكة المُرمِّز الصورة لاستخراج سمات بصرية ذات معنى. وتلتقط هذه السمات معلومات مثل الأنسجة وحدود الأجسام والتخطيط العام للمشهد. وتعمل معظم النماذج على مقاييس متعددة لتتمكن من فهم التفاصيل الدقيقة والبنية العامة معًا.
- استدلال العمق: باستخدام السمات المستخرجة، يدمج النموذج التفاصيل المحلية مع السياق العام لاستنتاج العلاقات المكانية في المشهد. وفي هذه المرحلة، يتعلم تحديد مناطق الصورة الأقرب إلى الكاميرا والأبعد عنها.
- إنشاء خريطة العمق: يحوّل المُفكِّك هذه المعلومات بعد ذلك إلى خريطة عمق كثيفة. وتُسنَد إلى كل بكسلة في الصورة قيمة عمق، غالبًا عبر دمج التوقعات المستمدة من مقاييس مختلفة لتحسين الدقة والاتساق.
كيفية تدريب نماذج تقدير العمق أحادي العين#
تفترض العملية التي ناقشناها للتو أن لدينا نموذجًا مدرّبًا أو مدرّبًا مسبقًا بالفعل. لكن كيف يعمل تدريب نموذج لتقدير العمق أحادي العين فعليًا؟
يبدأ التدريب بإعداد بيانات الصور كي تتمكن الشبكة من معالجتها بكفاءة. إذ يُعاد تحجيم صور الإدخال وتطبيعها إلى مقياس موحد، ثم تُمرر عبر النموذج لإنشاء خريطة عمق متوقعة تقدّر المسافة عند كل بكسلة.
بعد ذلك، تُقارَن خريطة العمق المتوقعة ببيانات العمق المرجعية باستخدام دالة خسارة تقيس مدى اختلاف توقع النموذج عن العمق المرجعي الصحيح. وتمثل قيمة الخسارة الخطأ الحالي للنموذج، وتوفر إشارة لتحسينه.
يستخدم المُحسِّن هذه الإشارة لتحديث النموذج عبر تعديل أوزانه الداخلية. ولتحقيق ذلك، يحسب المُحسِّن التدرج، الذي يصف كيفية تغير الخسارة بالنسبة إلى كل مُعلَمة في النموذج، ويطبق هذه التحديثات مرارًا خلال حقب متعددة، أي مرور كامل على مجموعة بيانات التدريب.
تُوجّه هذه العملية التكرارية للتدريب الخاضع للإشراف بمعلمات فائقة مثل معدل التعلّم، الذي يتحكم في حجم كل خطوة تحديث، وحجم الدفعة، الذي يحدد عدد الصور التي تُعالَج في المرة الواحدة. ولأن التدريب يتضمن عددًا كبيرًا من العمليات الرياضية، فإنه يُسرّع عادةً باستخدام وحدة معالجة الرسومات (GPU)، المناسبة جدًا للحوسبة المتوازية.
بعد اكتمال التدريب، يُقيَّم النموذج باستخدام مقاييس تقييم قياسية على مجموعة تحقق تتكون من صور لم تُستخدم أثناء التدريب. ويساعد هذا التقييم على قياس مدى تعميم النموذج على البيانات الجديدة.
بعد ذلك، يمكن إعادة استخدام النموذج المدرّب أو ضبطه بدقة لسيناريوهات جديدة. وإجمالًا، تمكّن عملية التدريب هذه نماذج تقدير العمق أحادي العين من إنتاج تقديرات متسقة للعمق، وهي ضرورية للمهام اللاحقة مثل إعادة البناء الثلاثي الأبعاد والنشر في العالم الحقيقي.
استكشاف أحدث النماذج واتجاهات البحث#
تحسن تقدير العمق أحادي العين بسرعة مع تطور قدرة النماذج على فهم المشاهد بأكملها بدلًا من التفاصيل البصرية الصغيرة فحسب. وغالبًا ما أنتجت الأساليب الأقدم خرائط عمق غير متجانسة، ولا سيما في البيئات المعقدة.
تركّز النماذج الأحدث، كما يتضح من الأبحاث الحديثة المنشورة على arXiv، بدرجة أكبر على السياق العام، ما يؤدي إلى تقديرات عمق تبدو أكثر استقرارًا وواقعية. وقد ساهمت نماذج معروفة مثل MiDaS وDPT في دفع هذا التحول من خلال تعلّم العمق من مجموعات بيانات متنوعة وعالية الدقة، والتعميم جيدًا على مشاهد كثيرة.
تطوّر نماذج أحدث، منها ZoeDepth وDepth Anything V2، هذا العمل من خلال تحسين اتساق المقياس مع الحفاظ على أداء قوي ضمن نطاق واسع من الإعدادات. وغالبًا ما يُقاس هذا التقدم باستخدام مجموعات بيانات معيارية شائعة مثل KITTI وNYU Depth V2، اللتين تشملان مشاهد خارجية وداخلية.
ومن الاتجاهات الواضحة أيضًا تحقيق التوازن بين الدقة والعملية. فالنماذج الأصغر محسّنة للسرعة ويمكنها العمل في الوقت الفعلي على الأجهزة الطرفية أو المحمولة، بينما تعطي النماذج الأكبر الأولوية للدقة الأعلى ودقة العمق لمسافات طويلة. على سبيل المثال، تتراوح نماذج تقدير العمق Ultralytics YOLO26 بين YOLO26n-depth خفيف الوزن للاستخدام الطرفي الآني، وYOLO26x-depth الأكبر والأعلى دقة.
تطبيقات تقدير العمق أحادي العين#
لنستعرض الآن بعض الأمثلة الواقعية التي توضح كيفية استخدام تقدير العمق أحادي العين لاستنتاج البنية الثلاثية الأبعاد للمشهد من صورة واحدة.
في جميع هذه الحالات، من المهم تذكّر أن معلومات العمق تقدير مستنتج من المؤشرات البصرية، وليست قياسًا دقيقًا. وهذا يجعل تقدير العمق أحادي العين مفيدًا لفهم التخطيط النسبي والعلاقات المكانية، لكنه لا يغني عن المستشعرات المصممة لقياس المسافة بدقة، مثل LiDAR أو الأنظمة المجسمة.
رسم خرائط التضاريس والملاحة باستخدام الطائرات المسيّرة#
غالبًا ما تعمل الطائرات المسيّرة في بيئات لا يُعتمد فيها على إشارات GPS، مثل الغابات ومواقع البناء ومناطق الكوارث والمناطق الحضرية المكتظة. وللطيران بأمان في هذه الظروف، تحتاج إلى فهم التضاريس المحيطة ومعرفة بُعد العوائق. وفي السابق، كان ذلك يتطلب عادةً إضافة مستشعرات مثل LiDAR أو كاميرات مجسمة، ما يزيد الوزن واستهلاك الطاقة والتكلفة الإجمالية.
يمثل تقدير العمق أحادي العين بديلًا أبسط. فباستخدام كاميرا RGB واحدة فقط، تستطيع الطائرات المسيّرة تقدير العمق من الصور وبناء فهم ثلاثي الأبعاد أساسي لبيئتها. وهذا يتيح لها اكتشاف العوائق مثل المباني والأشجار أو التغيرات المفاجئة في التضاريس، وتعديل مسار طيرانها في الوقت الفعلي.
تدعم تقديرات العمق هذه مهام الملاحة الرئيسية، بما فيها تجنب العوائق والتحكم في الارتفاع والهبوط الآمن. ونتيجة لذلك، تستطيع الطائرات المسيّرة خفيفة الوزن تنفيذ مهام رسم الخرائط والفحص والملاحة دون الاعتماد على مستشعرات عمق متخصصة.
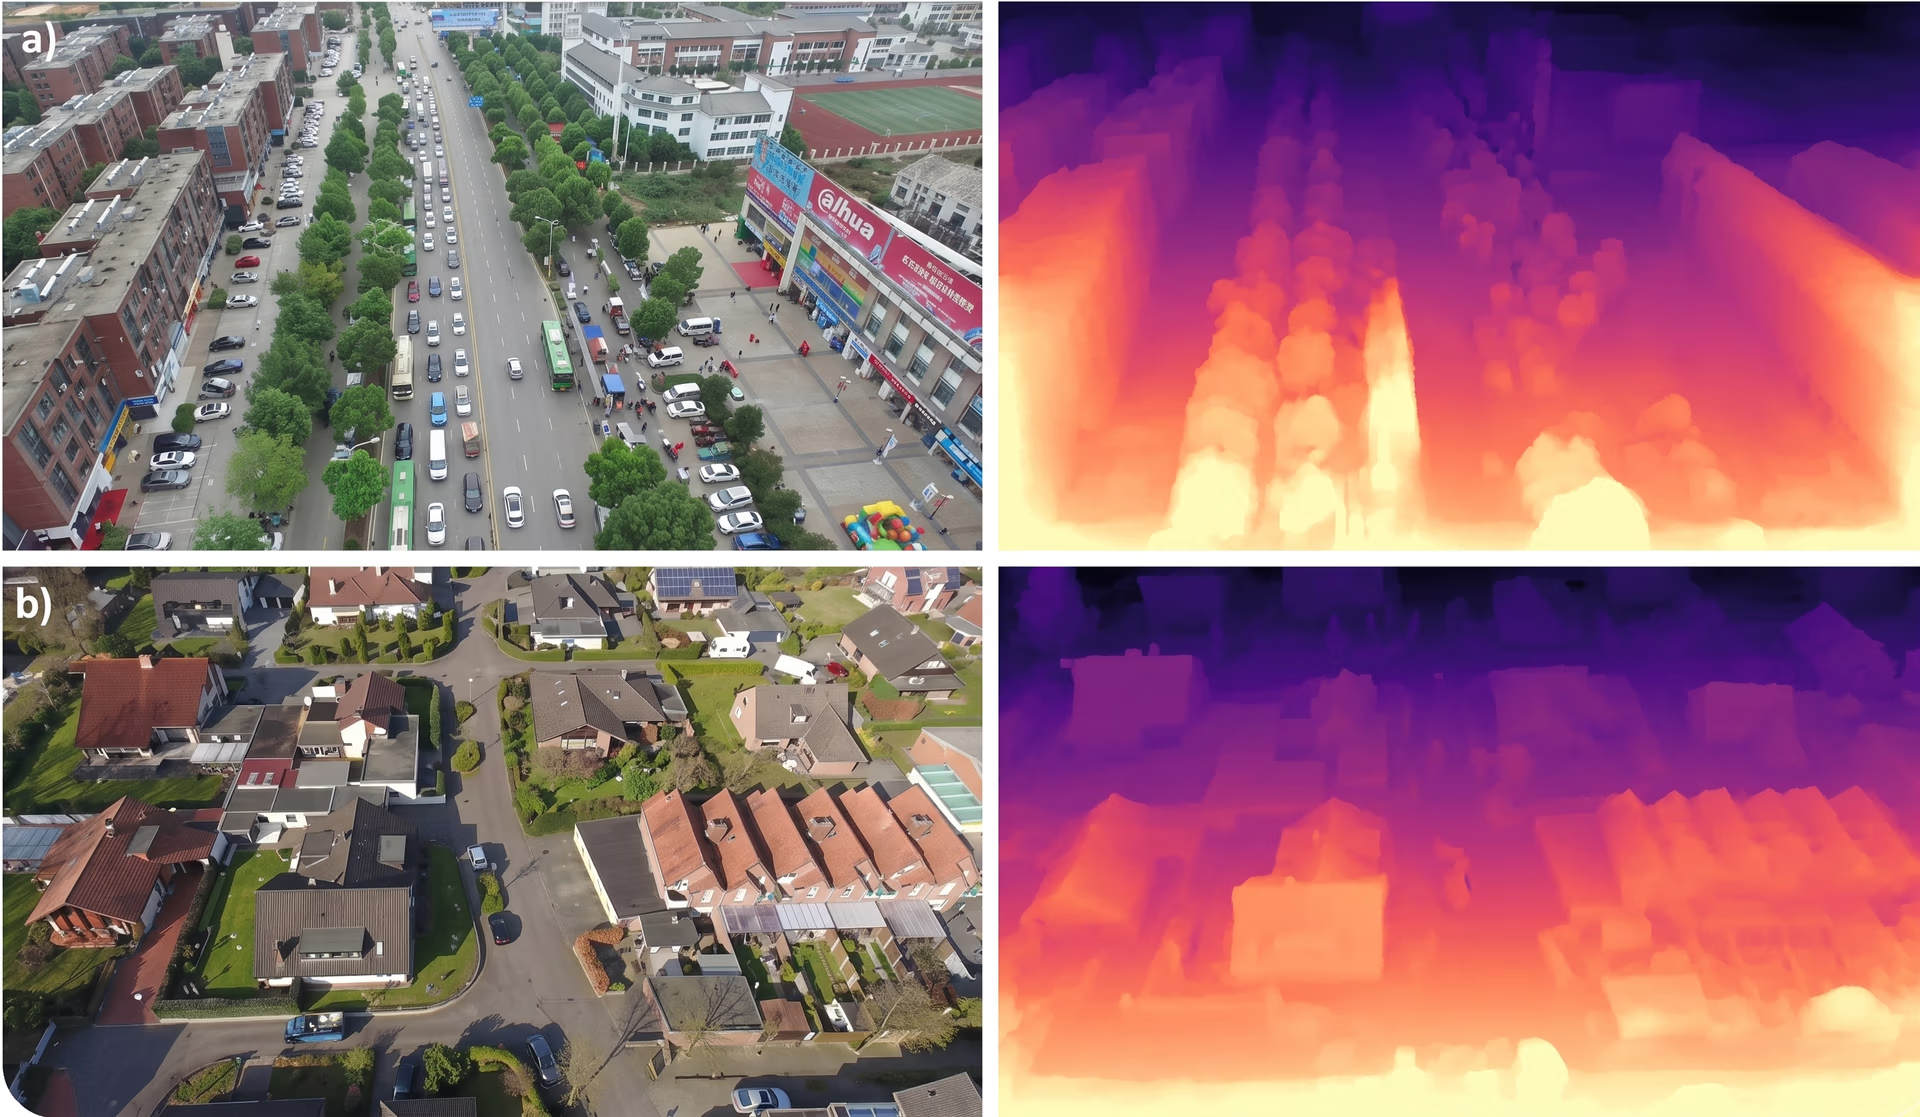
الشكل 2. يمكن استخدام تقدير العمق أحادي العين لتحليل صور الطائرات المسيّرة (المصدر)
سد النقاط العمياء للمركبات ذاتية القيادة المخصصة للسباقات#
تعتمد المركبات ذاتية القيادة عادةً اعتمادًا كبيرًا على مستشعرات LiDAR، التي تستخدم نبضات الليزر لقياس المسافة وإنشاء رؤية ثلاثية الأبعاد للطريق. ورغم دقتها العالية، قد تواجه LiDAR صعوبة عند قمم الطرق الحادة أو المنحدرات الشديدة أو حالات الحجب أو الميل المفاجئ للمركبة، وقد تنتج أحيانًا بيانات عمق متناثرة أو مفقودة.
يمكن لتقدير العمق أحادي العين سدّ هذه الفجوات من خلال توفير معلومات عمق كثيفة من صورة RGB واحدة، حتى عندما تكون بيانات LiDAR غير مكتملة. لنفترض سيناريو تقترب فيه سيارة ذاتية القيادة بسرعة من قمة تل. قد تتجاوز أشعة LiDAR الطريق الواقع وراء القمة، ما يترك حالة من عدم اليقين بشأن ما ينتظر السيارة.
لكن تقدير العمق المعتمد على الكاميرا يظل قادرًا على استنتاج شكل الطريق من الإشارات البصرية، مثل المنظور والملمس، ما يساعد المركبة على الحفاظ على إدراك موثوق إلى أن تستقر بيانات LiDAR. ويتيح الجمع بين LiDAR وتقدير العمق أحادي العين إدراكًا أكثر استقرارًا وتحكمًا أكثر أمانًا في ظروف القيادة الصعبة.
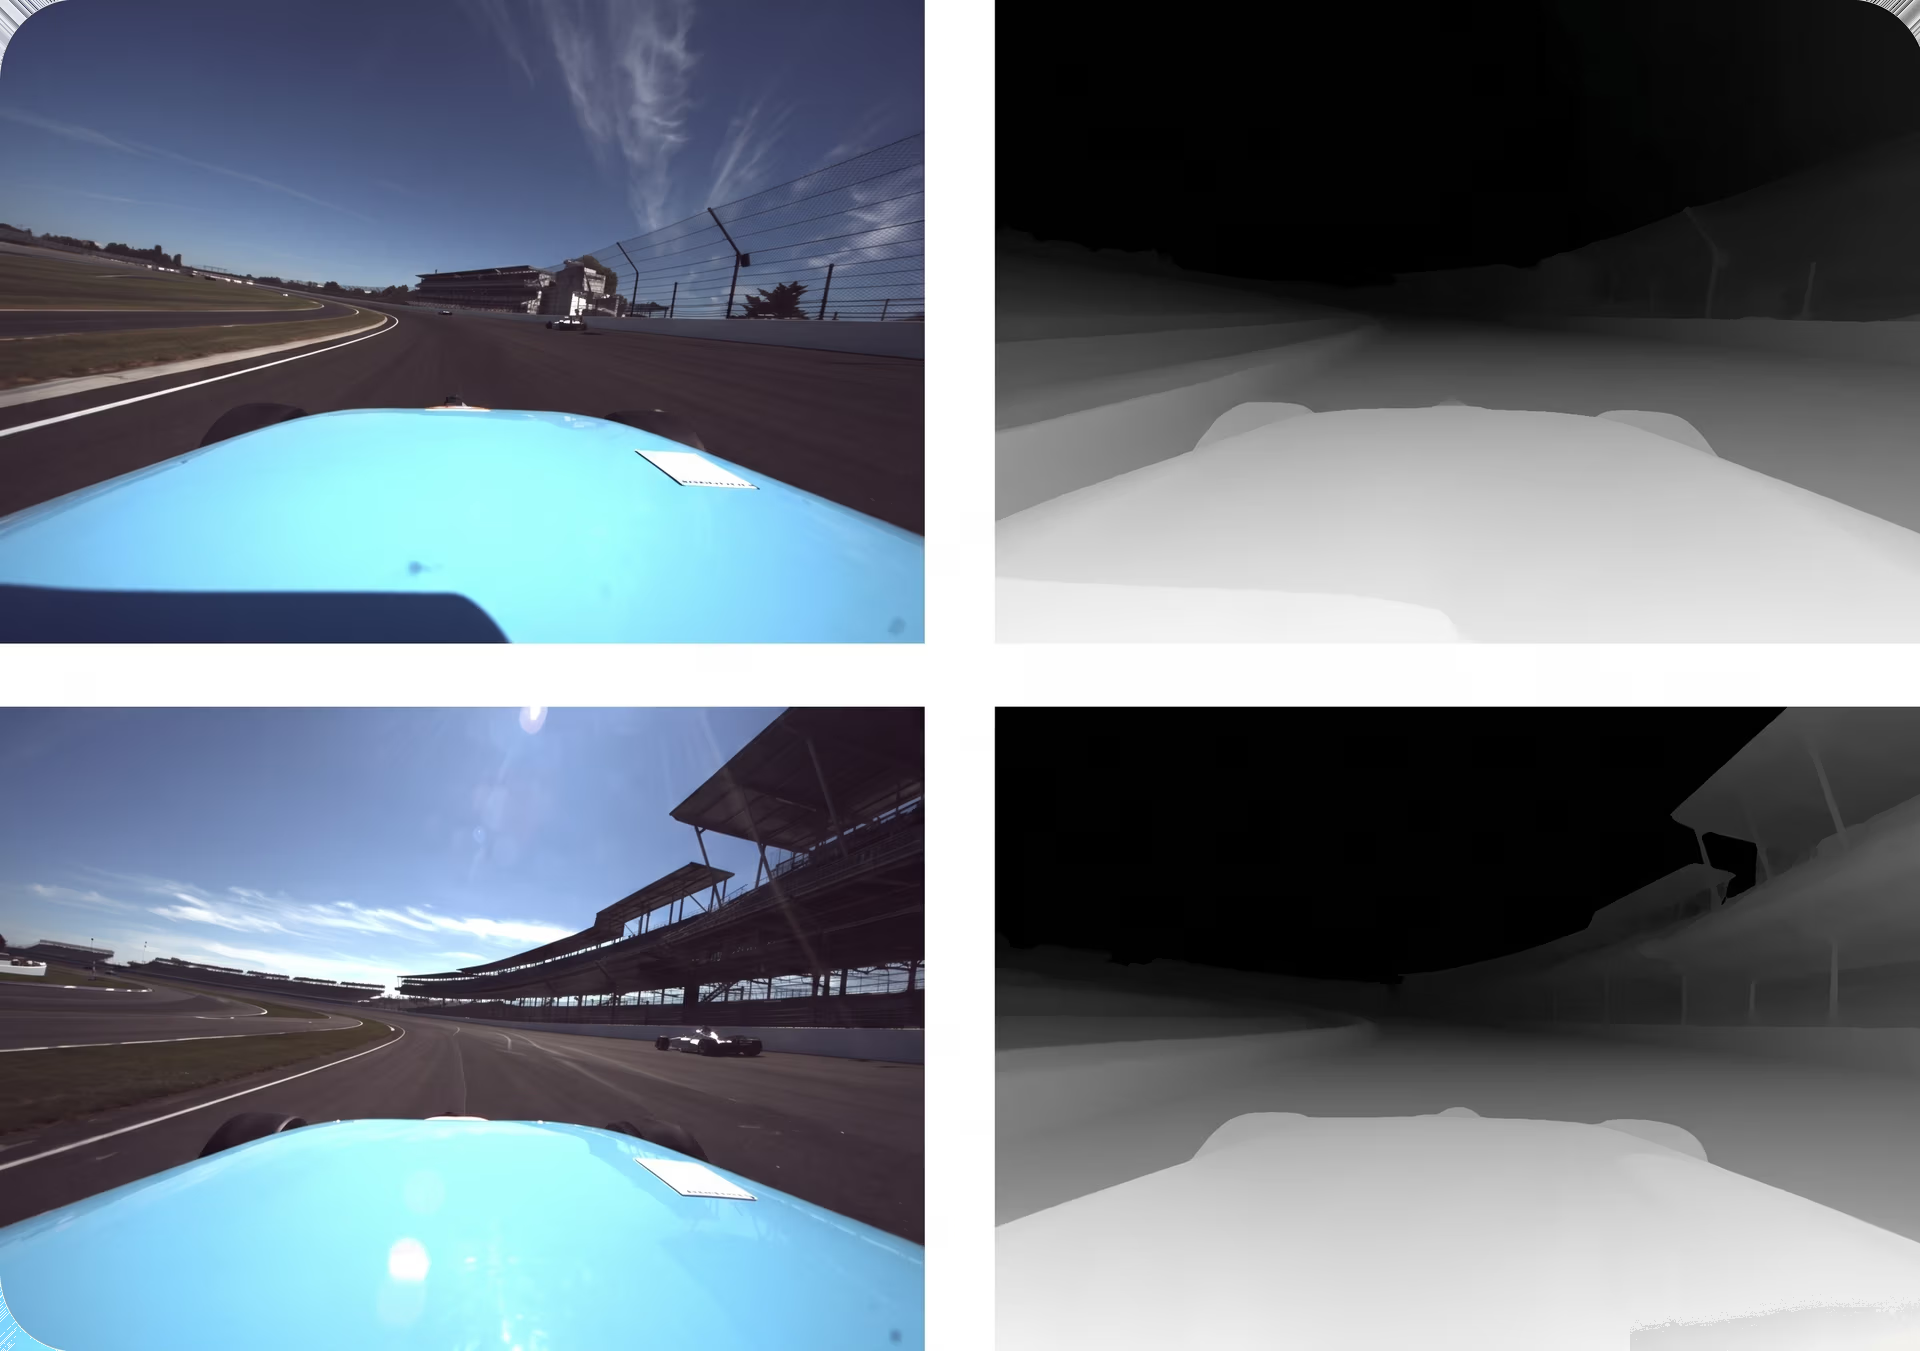
الشكل 3. تصور لاستخدام تقدير العمق أحادي العين في سباقات القيادة الذاتية (المصدر)
الملاحة الروبوتية وتجنب العوائق#
غالبًا ما تعمل الروبوتات في أماكن لا تتوفر فيها خرائط مفصلة، وتتغير فيها الظروف باستمرار. ولكي تتحرك بأمان، تحتاج إلى تقدير موثوق للمساحة المحيطة بها ومواقع العوائق.
يمكن لتقدير العمق أحادي العين توفير هذا الوعي المكاني باستخدام كاميرا RGB واحدة، دون الاعتماد على أجهزة ثقيلة أو باهظة الثمن. ومن خلال تعلم الإشارات البصرية مثل المقياس والمنظور، تستطيع نماذج تقدير العمق إنشاء خرائط عمق كثيفة للمحيط. وهذا يمنح الروبوتات تصورًا واضحًا للمسافة إلى الأسطح والأجسام.
وعلى وجه الخصوص، عندما تُدمج معلومات العمق مع مهام الرؤية الحاسوبية مثل اكتشاف الأجسام والتجزئة الدلالية، تستطيع الروبوتات تكوين رؤية أشمل لبيئتها. ويمكنها تحديد الأجسام وفهم المسافة إليها وتحديد الأماكن الآمنة للحركة. ويدعم ذلك تجنب العوائق واكتشاف المساحات الخالية والتخطيط الفوري للمسارات.
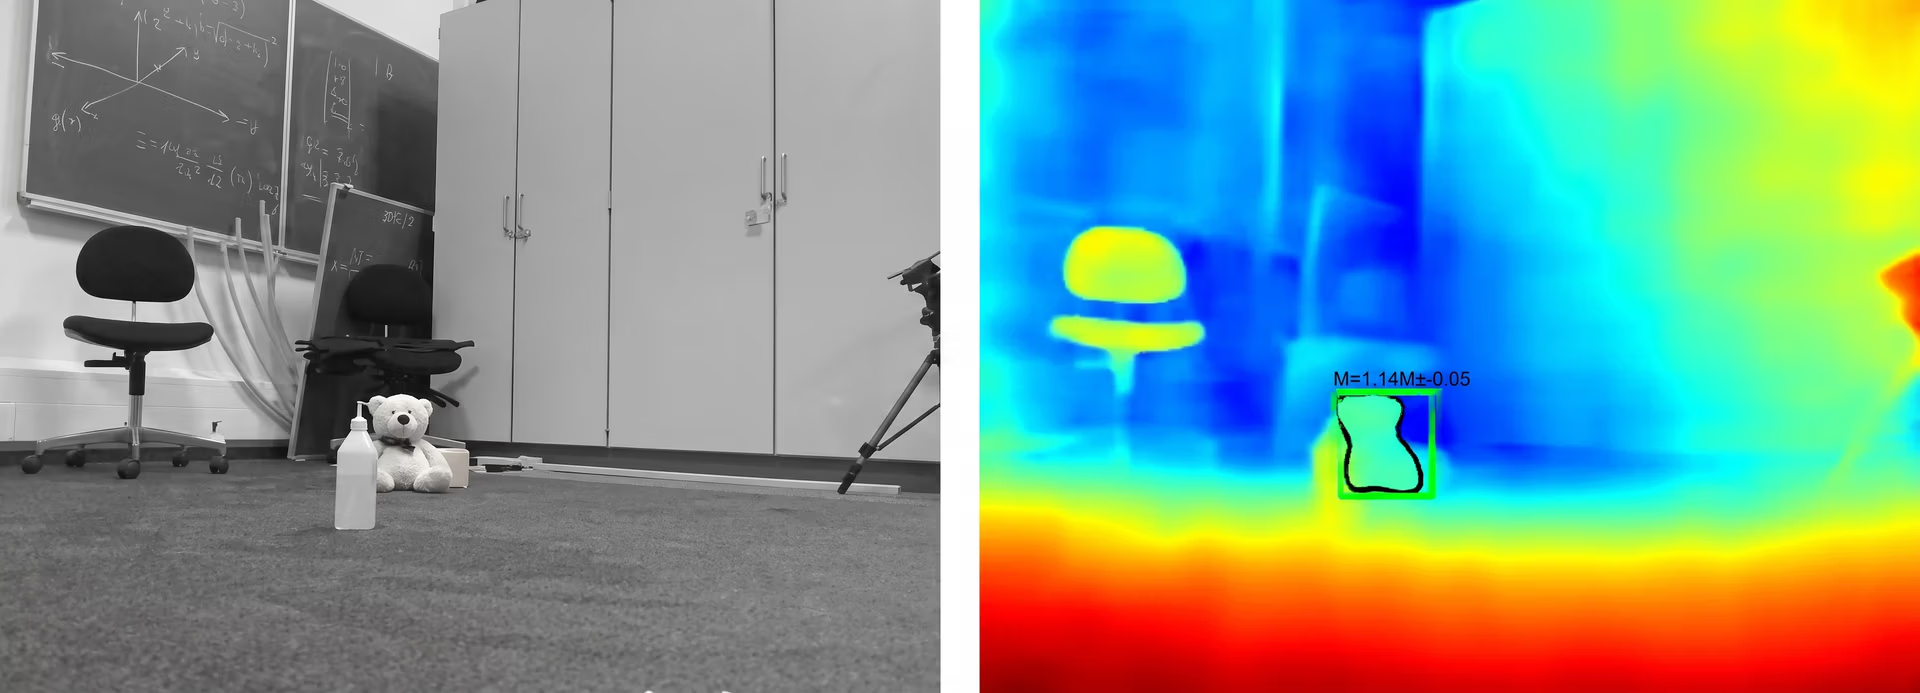
الشكل 4. اكتشاف الأجسام باستخدام تقدير العمق أحادي العين واكتشاف الأجسام (المصدر)
مزايا تقدير العمق أحادي العين وعيوبه#
فيما يلي بعض المزايا الرئيسية لاستخدام تقدير العمق أحادي العين:
- خفيف الوزن وموفر للطاقة: يقلل استخدام كاميرا واحدة من وزن النظام واستهلاكه للطاقة، وهو أمر بالغ الأهمية خصوصًا للروبوتات المتنقلة والطائرات المسيّرة والأنظمة المضمنة.
- متوافق مع دمج المستشعرات: يمكن للعمق أحادي العين أن يكمل مستشعرات أخرى، مثل LiDAR أو الرادار، من خلال سد الفجوات أو توفير التكرار.
- يعمل في بيئات متنوعة: يمكن استخدام النهج المعتمد على الكاميرا نفسه في الأماكن المغلقة والمفتوحة وعلى منصات مختلفة، دون الحاجة إلى تغيير الأجهزة.
على الرغم من المزايا الواضحة لتقدير العمق أحادي العين، إليك بعض القيود التي ينبغي أخذها في الحسبان:
- دقة أقل من المستشعرات النشطة: رغم التحسن السريع، لا يستطيع تقدير العمق أحادي العين عمومًا مجاراة الدقة المطلقة لمستشعرات LiDAR أو مستشعرات الضوء المنظّم في الظروف المضبوطة.
- التأثر بظروف الإضاءة: قد يتراجع الأداء في البيئات ضعيفة الإضاءة أو عند وجود ظلال حادة أو وهج أو مشاهد ذات ملمس بصري ضعيف.
- تحديات التعميم: قد لا ينتقل النموذج المدرّب في بيئة معينة دائمًا بموثوقية إلى نطاقات لم يسبق له رؤيتها، من دون تكييف أو ضبط دقيق.
متى ينبغي عدم الاعتماد على تقدير العمق أحادي العين#
رغم أن تقدير العمق أحادي العين مجال بحث مثير للاهتمام، فمن المهم فهم الحالات التي يمكن استخدامه فيها عمليًا وتلك التي لا يصلح لها. فالمسافات التي ينتجها تقديرات تستند إلى ما يراه النموذج في الصورة، وليست قياسات دقيقة مأخوذة من العالم الحقيقي.
لذلك، قد تتغير جودة النتائج تبعًا لعوامل مثل الإضاءة وتعقيد المشهد ومدى تشابه المشهد مع البيانات التي دُرّب عليها النموذج. يجيد تقدير العمق أحادي العين عادةً تحديد ما هو أقرب وما هو أبعد، لكنه لا يُعتمد عليه عند الحاجة إلى مسافات دقيقة.
في الحالات التي تكون فيها الدقة بالغة الأهمية، مثل الأنظمة الحرجة للسلامة أو الفحص الصناعي أو الروبوتات التي تحتاج إلى التفاعل مع الأجسام بدقة عالية جدًا، يجب قياس العمق مباشرةً. صُممت مستشعرات مثل LiDAR والرادار والكاميرات المجسمة وأنظمة الضوء المنظّم لهذا الغرض، وتوفر معلومات أكثر موثوقية عن المسافات.
قد يواجه تقدير العمق أحادي العين صعوبات أيضًا في الظروف البصرية المعقدة. فالإضاءة الضعيفة والظلال الحادة والأسطح العاكسة أو الشفافة والضباب والدخان والمشاهد ذات الملمس البصري المحدود، كلها عوامل قد تقلل موثوقية تقديرات العمق. ويُعد تقدير العمق لمسافات طويلة حالة أخرى تؤدي فيها المستشعرات المخصصة عادةً أداءً أفضل.
في التطبيقات الواقعية، يكون أداء تقدير العمق أحادي العين أفضل عندما يُستخدم أداةً مساندة لا حلًا مستقلًا. فهو يضيف سياقًا مكانيًا مفيدًا، ويساعد على سد الفجوات عندما تكون المستشعرات الأخرى محدودة، ويحسّن فهم المشهد عمومًا. لكنه لا ينبغي أن يكون المصدر الوحيد لمعلومات العمق عندما تكون الدقة أو السلامة أو متطلبات الموثوقية الصارمة مهمة.
أبرز النقاط#
تقدير العمق أحادي العين تقنية في الرؤية الحاسوبية تمكّن الآلات من تقدير مدى بُعد الأجسام باستخدام صورة واحدة من كاميرا واحدة فقط. ومن خلال تعلم الإشارات البصرية مثل المنظور وحجم الجسم والملمس والتظليل، تستطيع نماذج الذكاء الاصطناعي هذه استنتاج البنية ثلاثية الأبعاد للمشهد دون الاعتماد على مستشعرات مثل LiDAR أو الكاميرات المجسمة. وهذا يجعل تقدير العمق أحادي العين نهجًا منخفض التكلفة وقابلًا للتوسع لتطبيقات مثل القيادة الذاتية والروبوتات وفهم المشاهد ثلاثية الأبعاد.
للاطلاع على المزيد حول ذكاء الرؤية الاصطناعي، تفضل بزيارة مستودع GitHub وانضم إلى مجتمعنا. استكشف صفحات حلولنا للتعرف على الذكاء الاصطناعي في الروبوتات والرؤية الحاسوبية في التصنيع. تعرّف على خيارات الترخيص لدينا وابدأ استخدام الرؤية الحاسوبية اليوم!
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









