ما تكثيف مجموعات البيانات؟ نظرة عامة سريعة
تعرّف على كيفية تسريع تكثيف مجموعات البيانات لتدريب النماذج وخفض تكاليف الحوسبة، وذلك باستبدال مجموعات البيانات الكبيرة بمجموعة صغيرة ومحسّنة من العينات الاصطناعية.
 Abirami Vina14 دقيقة قراءة
قد يبدو تدريب النماذج الجزء الأكثر استهلاكًا للوقت في عمل عالم البيانات. لكن معظم الوقت، وغالبًا ما يتراوح بين 60% و80%، يُقضى فعليًا في تهيئة البيانات: جمعها وتنظيفها وتنظيمها لاستخدامها في النمذجة. ومع ازدياد حجم مجموعات البيانات، يزداد وقت التحضير أيضًا، ما يبطئ التجارب ويصعّب تكرارها.
لمعالجة هذه المشكلة، أمضى الباحثون سنوات في البحث عن طرق لتبسيط التدريب. وتهدف أساليب مثل البيانات الاصطناعية وضغط مجموعات البيانات وطرائق التحسين الأفضل إلى خفض تكلفة العمل مع مجموعات البيانات واسعة النطاق والاحتكاك المصاحب له، وتسريع سير عمل تعلّم الآلة.
ويثير ذلك سؤالًا جوهريًا: هل يمكننا تقليص مجموعة بيانات بدرجة كبيرة مع الحفاظ على الأداء نفسه الذي يتحقق عند تدريب نموذج على البيانات كاملةً؟ يُعد تقطير مجموعات البيانات إجابة واعدة عن هذا السؤال.
ينشئ هذا الأسلوب نسخة مدمجة من مجموعة بيانات تدريب كبيرة، مع الحفاظ على الأنماط الأساسية التي يحتاج إليها النموذج للتعلم بفاعلية. ويوفر مسارًا لتسريع التدريب وخفض احتياجات الحوسبة وإجراء التجارب بكفاءة أكبر. ويمكن تشبيهه بورقة غش دراسية للنموذج: مجموعة صغيرة من أمثلة البيانات الاصطناعية المصممة لتعليم الأنماط الأساسية نفسها التي تتضمنها مجموعة البيانات الكاملة.
سنستكشف في هذا المقال كيفية عمل تكثيف مجموعات البيانات وكيفية دعمه لتعلم الآلة والتعلم العميق القابلين للتوسع في تطبيقات العالم الحقيقي.
فهم تقطير مجموعات البيانات#
تقطير مجموعات البيانات عملية تُختزل فيها مجموعة بيانات تدريب كبيرة إلى مجموعة أصغر بكثير، مع احتفاظها بالقدرة على تعليم النموذج معلومات تكاد تماثل ما تعلمه مجموعة البيانات الأصلية. ويشير كثير من الباحثين إلى هذه العملية أيضًا باسم تكثيف مجموعة البيانات، لأن الهدف هو التقاط الأنماط الأساسية الموجودة في مجموعة البيانات كاملةً.
تختلف مجموعة البيانات المقطّرة عن البيانات الاصطناعية المولّدة عشوائيًا أو عن مجرد اختيار مجموعة فرعية أصغر من الصور الحقيقية. فهي ليست مجموعة بيانات زائفة عشوائية ولا نسخة مختصرة من المجموعة الأصلية.
بل يجري تحسينها عمدًا لالتقاط أهم الأنماط. وخلال هذه العملية، تُعدّل كل بكسل وكل سمة وتُحسّن، بحيث تتعلم الشبكة العصبية المدرّبة على البيانات المقطّرة كما لو أنها تدربت على مجموعة البيانات بأكملها.
ظهرت هذه الفكرة للمرة الأولى في ورقة بحثية نُشرت على arXiv عام 2018، ألّفها تونغتشو وانغ وجونغ يان تشو وأنطونيو تورالبا وأليكسي أ. إيفروس. واستخدمت الاختبارات المبكرة مجموعات بيانات بسيطة مثل MNIST وCIFAR-10، ما سهّل توضيح كيف يمكن لعدد قليل من العينات المقطّرة أن يحل محل آلاف الصور الحقيقية.
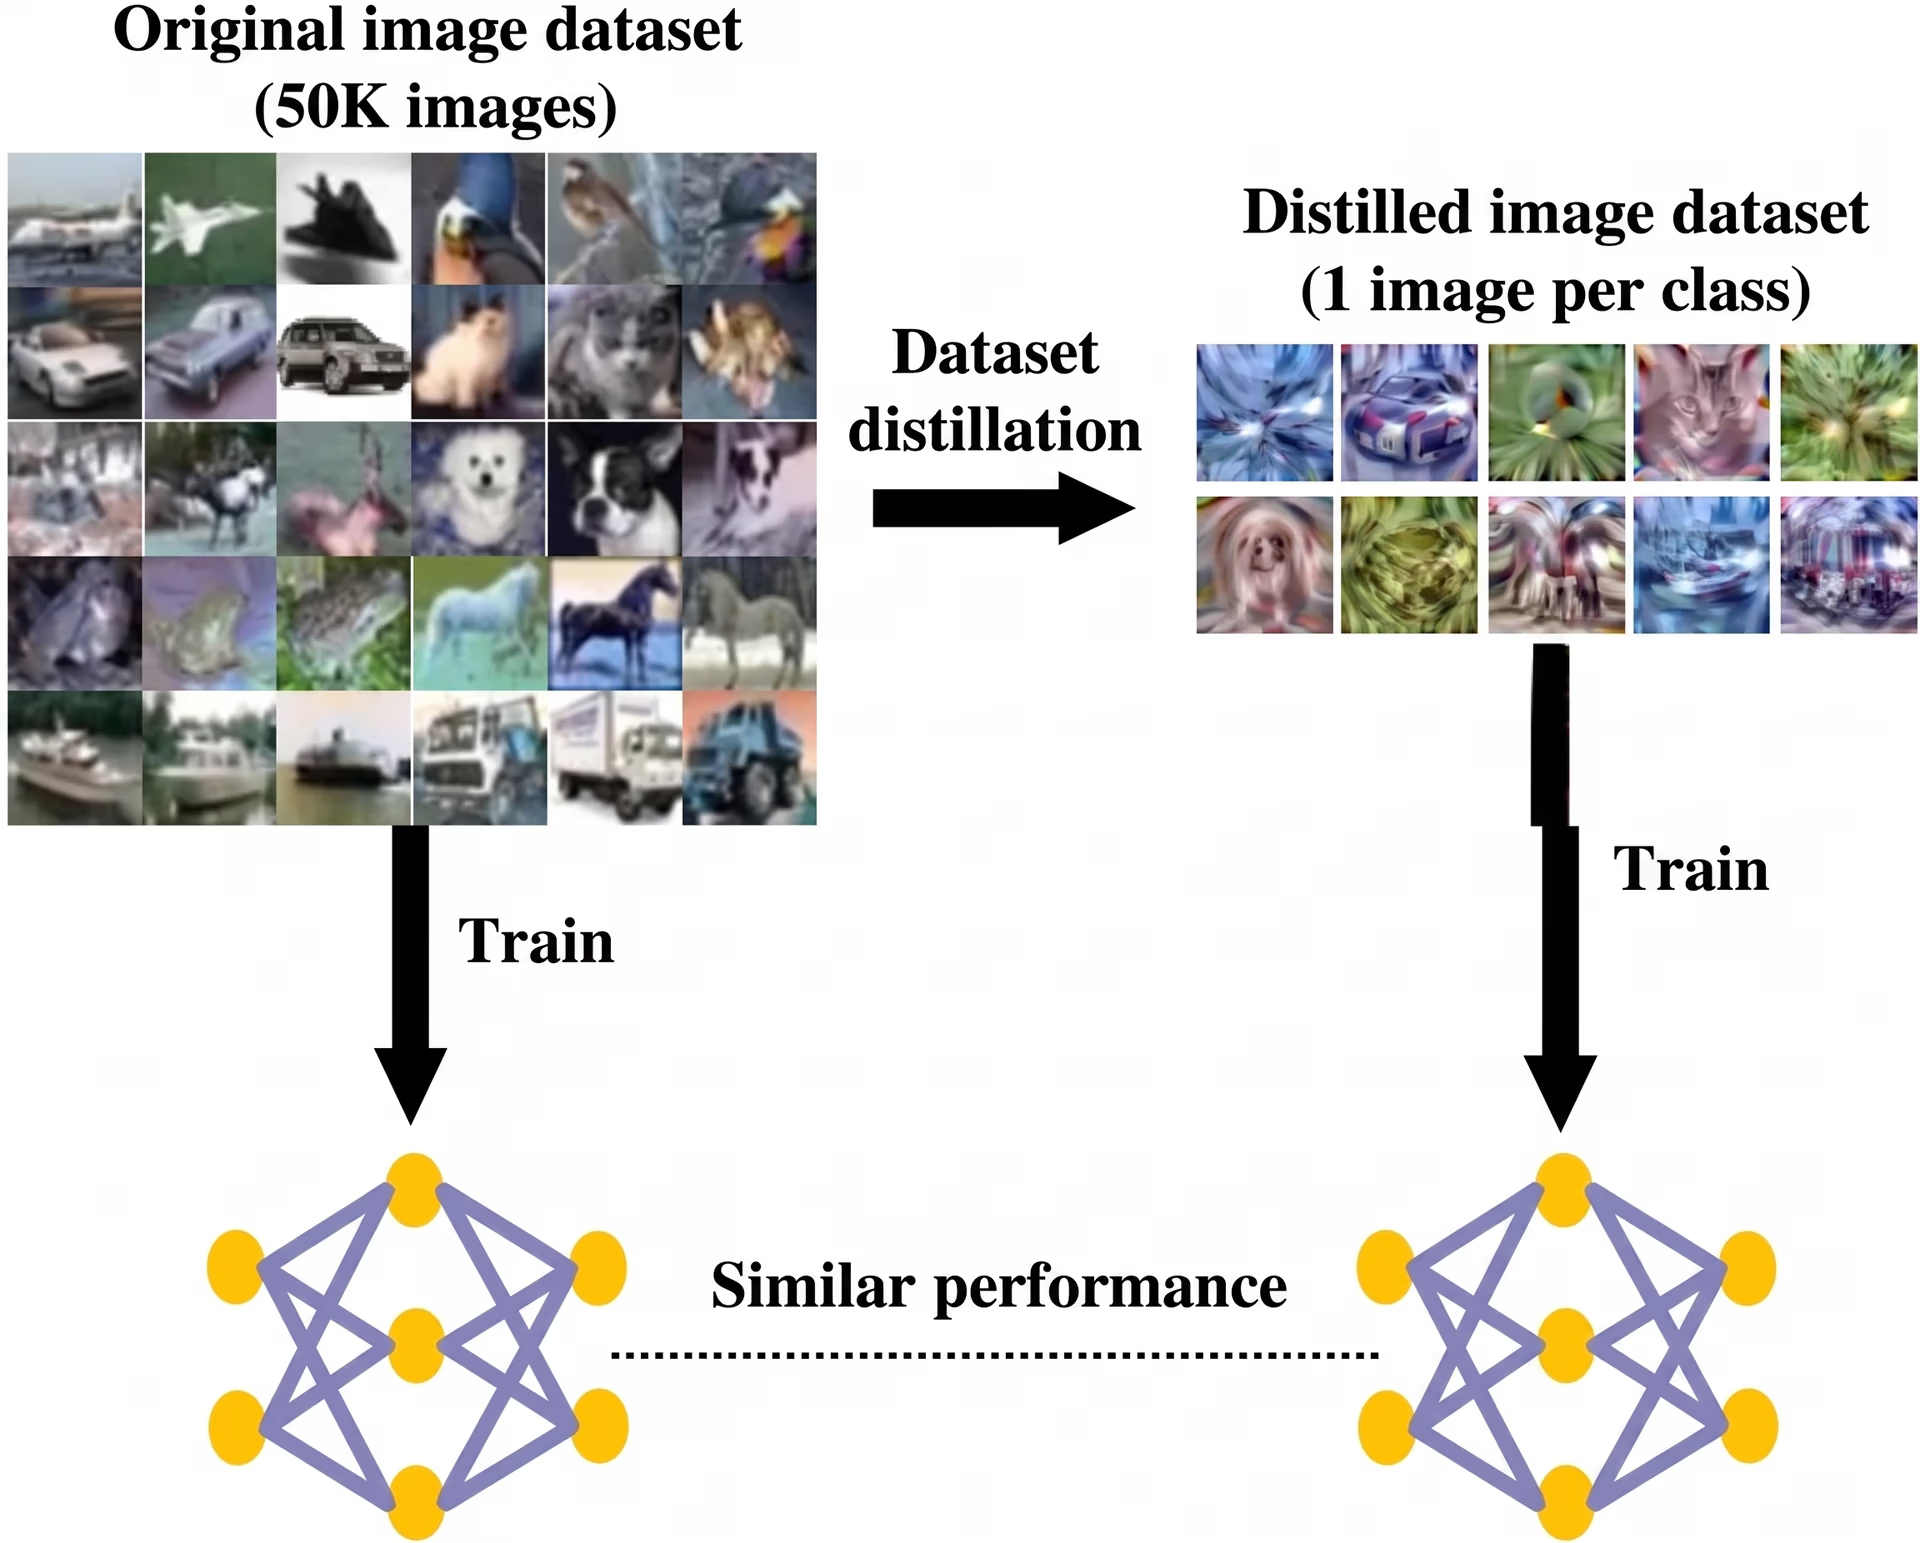
الشكل 1. استخدام تقطير مجموعات البيانات لبيانات الصور (المصدر)
ومنذ ذلك الحين، دفعت الأبحاث اللاحقة تقطير مجموعات البيانات إلى آفاق أبعد، بما في ذلك أساليب نُشرت في مؤتمري ICML وICLR وجعلت التكثيف أكثر كفاءة وقابلية للتوسع.
أهمية تقطير مجموعات البيانات#
يحسّن تقطير مجموعات البيانات كفاءة التدريب ويسرّع دورات التطوير. ومن خلال تقليل كمية البيانات التي يحتاج النموذج إلى التعلم منها، يخفض متطلبات الحوسبة.
ويفيد هذا الأسلوب خصوصًا في التعلم المستمر، حيث تُحدّث النماذج بمرور الوقت؛ والبحث عن بنى الشبكات العصبية، حيث تُختبر تصميمات كثيرة للنماذج؛ والتدريب على الأجهزة الطرفية، حيث تعمل النماذج على أجهزة صغيرة ذات ذاكرة وطاقة محدودتين. وبوجه عام، تجعل هذه المزايا تقطير مجموعات البيانات خيارًا ممتازًا للتهيئة السريعة والضبط الدقيق السريع وإنشاء النماذج الأولية المبكرة في طيف واسع من مسارات عمل تعلّم الآلة.
نظرة عامة على آلية عمل تقطير مجموعات البيانات#
ينشئ تقطير مجموعات البيانات عينات تدريب اصطناعية، أي مولّدة حاسوبيًا. وتساعد هذه العينات النموذج على التعلم بطريقة تحاكي إلى حد كبير تدريبه على بيانات حقيقية. وتعتمد العملية على تتبّع ثلاثة عوامل رئيسية أثناء التدريب المعتاد.
العامل الأول هو دالة الخسارة، وهي مقياس خطأ النموذج الذي يوضح مدى بُعد تنبؤاته عن الصواب. والثاني هو معلمات النموذج، أي الأوزان الداخلية للشبكة التي يجري تحديثها أثناء التعلم.
أما العامل الثالث فهو مسار التدريب، الذي يصف كيفية تغير الخطأ والأوزان خطوة بخطوة بمرور الوقت. ثم تُحسّن العينات الاصطناعية بحيث يؤدي تدريب النموذج عليها إلى خفض خطئه وتحديث أوزانه بالطريقة نفسها التي كان سيتبعها عند استخدام مجموعة البيانات كاملةً.
نظرة خطوة بخطوة على تقطير مجموعات البيانات#
إليك نظرة عن كثب على آلية عمل تقطير مجموعات البيانات:
- الخطوة 1 - تهيئة البكسلات الاصطناعية: تبدأ العملية بـصور اصطناعية تعمل كمدخلات قابلة للتعلم. تكون هذه الصور في البداية قليلة البنية وتشبه الصفحات البيضاء. ثم تُحسّن بمرور الوقت لتصبح أمثلة غنية بالمعلومات.
- الخطوة 2 - التحسين بمطابقة التدرجات والانتشار العكسي: أثناء تدريب النموذج على هذه الصور الاصطناعية، ينتج تدرجات توضح كيفية تغيير كل بكسل لمواءمة سلوك التدريب مع البيانات الحقيقية على نحو أفضل. والانتشار العكسي هو الأسلوب الذي تستخدمه الشبكة للتعلم من أخطائها. إذ يمرر الخطأ عكسيًا عبر النموذج لتحديد البكسلات والأوزان التي تسببت فيه، ثم يحدّثها قليلًا. وباستخدام هذه التدرجات، يعدّل الانتشار العكسي الصور الاصطناعية خطوة بخطوة كي تصبح أكثر إفادة في التدريب.
- الخطوة 3 - مطابقة السلوك عبر خطوات التدريب: يطابق الأسلوب أيضًا مسارات التدريب، أي التغيرات المتعاقبة التي يمر بها النموذج أثناء التعلم. ويضمن ذلك أن توجه مجموعة البيانات المقطّرة النموذج عبر مسار تعلم يشبه المسار الذي سيتبعه عند استخدام مجموعة البيانات كاملةً.
- الخطوة 4 - التحقق والتعميم: أخيرًا، تُقيّم مجموعة البيانات المقطّرة باستخدام بيانات تحقق حقيقية لمعرفة مدى جودة أداء النموذج المدرّب على أمثلة جديدة. ويضمن ذلك أن تعلّم البيانات الاصطناعية أنماطًا عامة قابلة للتطبيق، بدلًا من أن تدفع النموذج إلى حفظ عينات محددة.
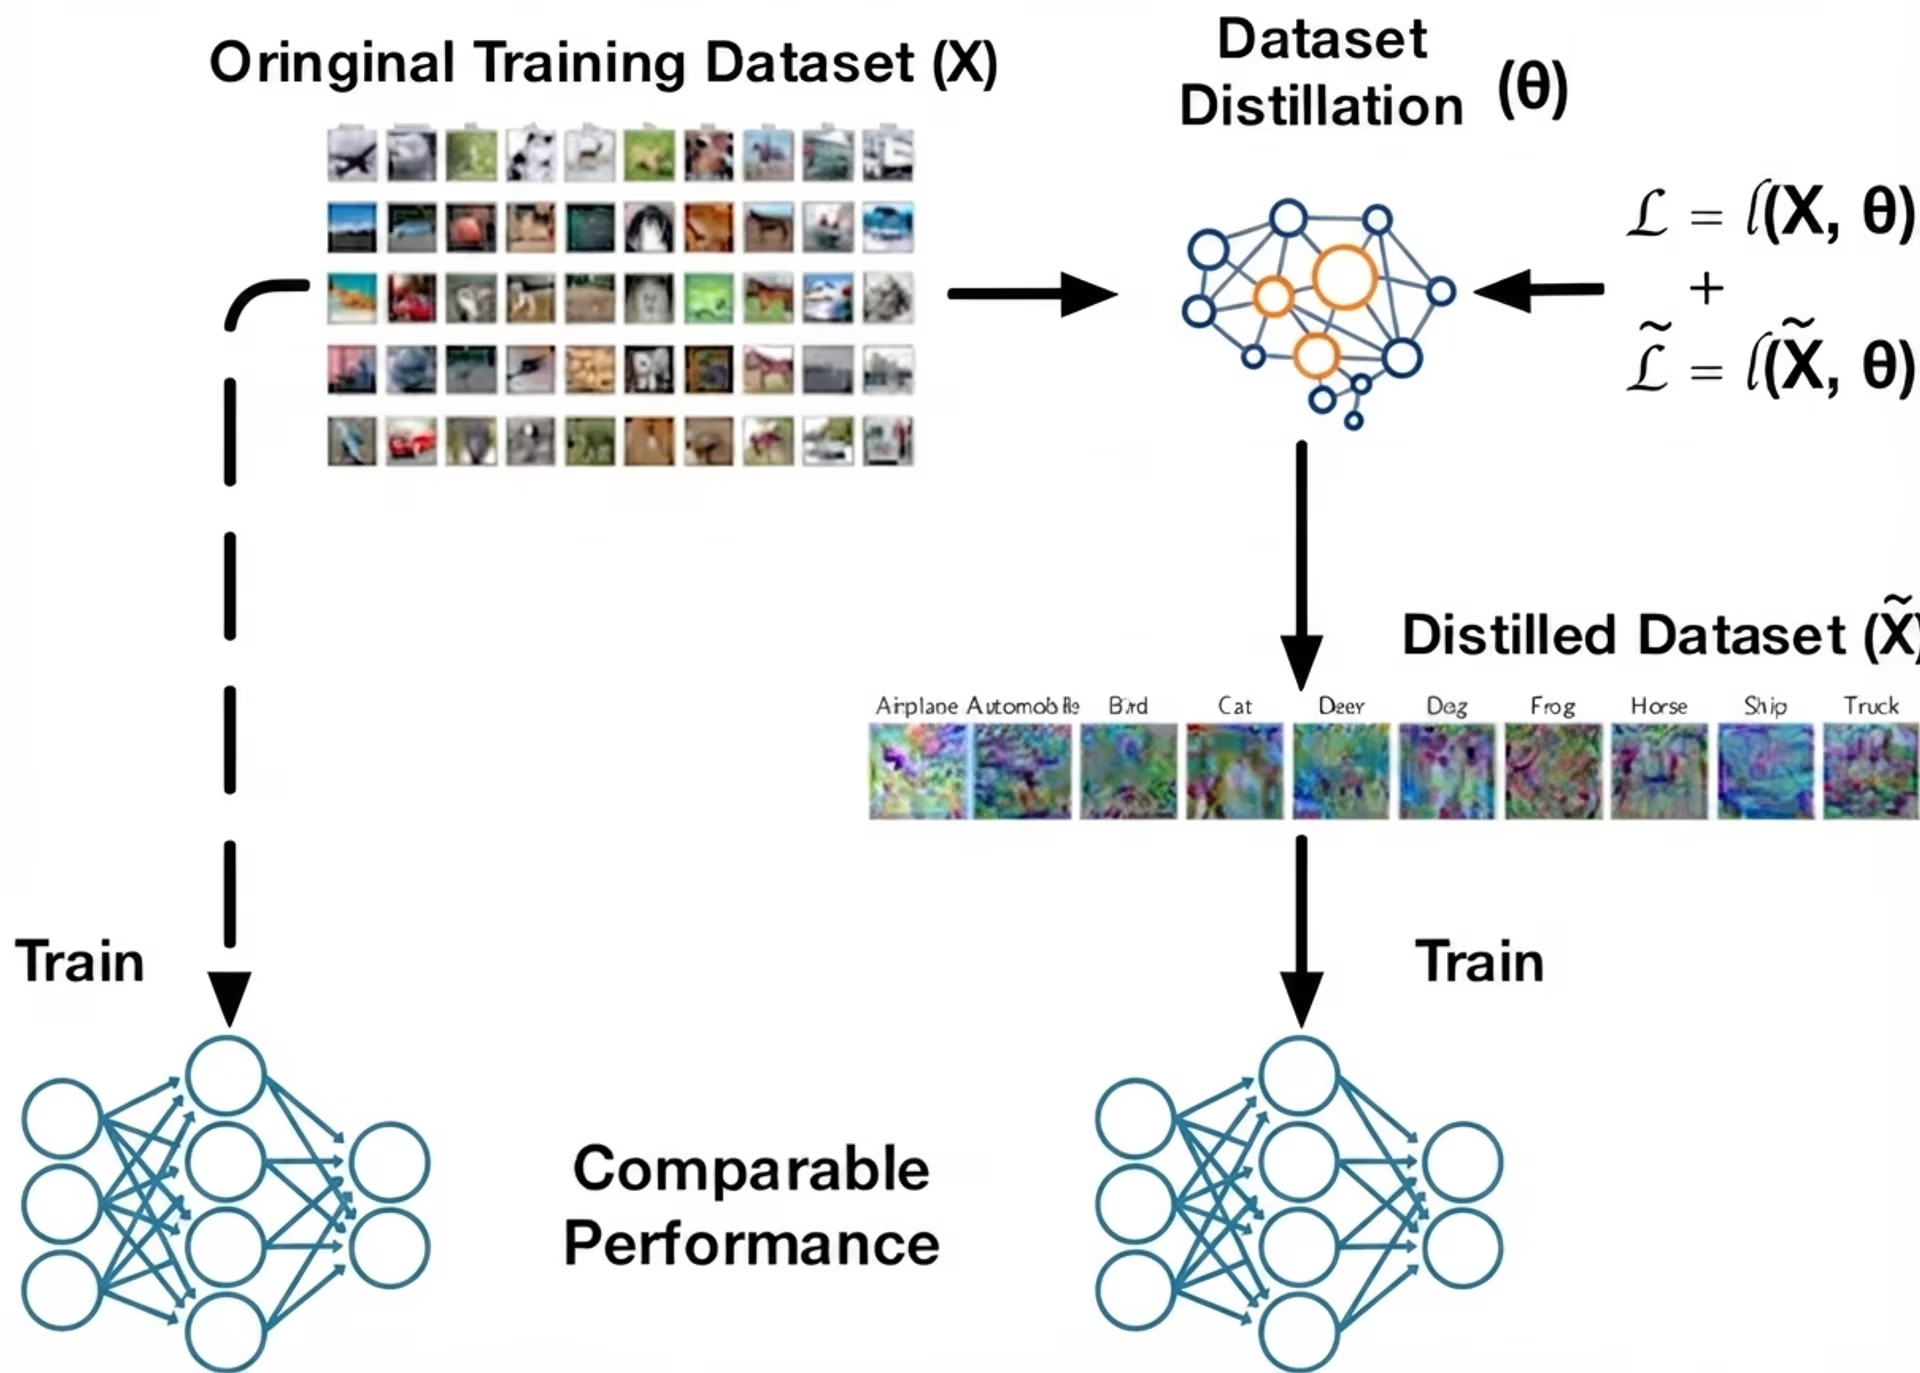
الشكل 2. نظرة على تقطير مجموعات البيانات (المصدر)
المنهجيات الرئيسية لتقطير مجموعات البيانات#
تستند جميع أساليب تقطير مجموعات البيانات إلى الفكرة الجوهرية نفسها، حتى إن اختلفت الخوارزميات المستخدمة لتحقيقها. وتقع معظم الأساليب ضمن ثلاث فئات: مطابقة الأداء، ومطابقة التوزيع، ومطابقة المعلمات.
والآن، لنستعرض كل فئة ونتعرف إلى آلية عملها.
مطابقة الأداء#
تركز مطابقة الأداء في تقطير مجموعات البيانات على إنشاء مجموعة تدريب صغيرة ومحسّنة تمكّن النموذج من بلوغ دقة تقارب الدقة التي كان سيحققها لو تدرب على مجموعة البيانات الأصلية كاملةً. وبدلًا من اختيار مجموعة فرعية عشوائية، تُحسّن العينات المقطّرة بحيث ينتج عن تدريب النموذج عليها تنبؤات مشابهة، أو سلوك خسارة مماثل أثناء التدريب، أو دقة نهائية تقارب ما يحققه نموذج مدرّب على مجموعة البيانات الأصلية.
يُعد التعلّم التلوي أسلوبًا شائعًا لتحسين هذه العملية. وتُحدّث مجموعة البيانات المقطّرة عبر حلقات تدريب متكررة، لتصبح فعالة في مجموعة واسعة من الحالات المحتملة.
خلال هذه الحلقات، تحاكي الطريقة كيفية تعلم نموذج طالب من العينات المقطّرة الحالية، وتتحقق من أدائه على البيانات الحقيقية، ثم تعدّل العينات المقطّرة لتصبح مصادر تعليم أفضل. وبمرور الوقت، تتعلم المجموعة المقطّرة دعم التعلم السريع والتعميم القوي، حتى عندما يبدأ نموذج الطالب بأوزان أولية مختلفة أو يستخدم بنية مختلفة. وهذا يجعل مجموعة البيانات المقطّرة أكثر موثوقية، وغير مرتبطة بجولة تدريب واحدة.
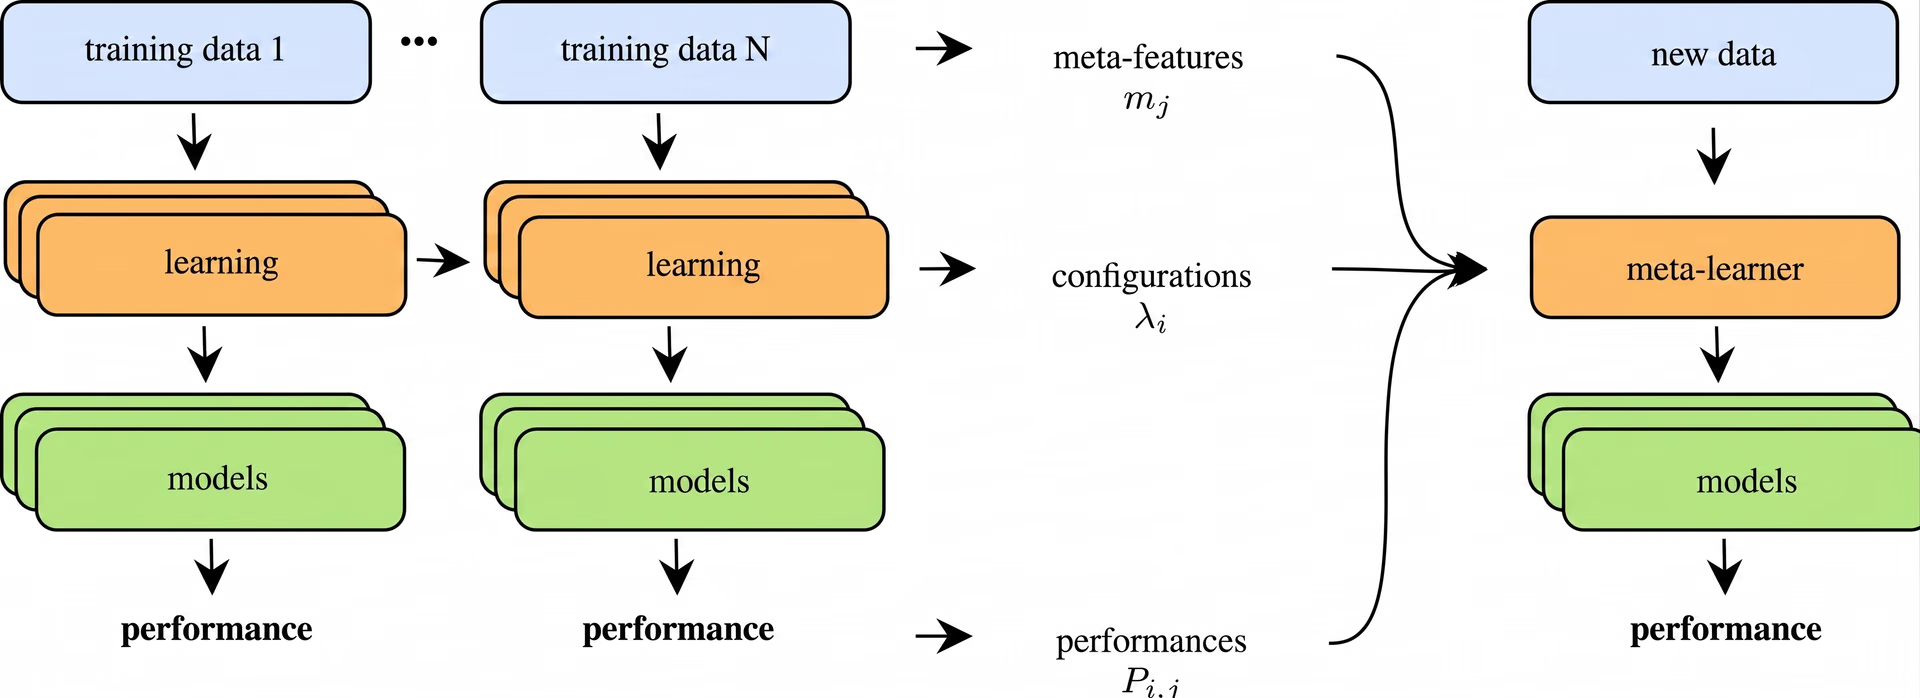
الشكل 3. عملية التعلّم التلوي (المصدر)
تقنيات مطابقة التوزيع#
في المقابل، تولّد مطابقة التوزيع بيانات اصطناعية تحاكي الأنماط الإحصائية لمجموعة البيانات الحقيقية. وبدلًا من التركيز على الدقة النهائية للنموذج وحدها، يركز هذا الأسلوب على السمات الداخلية التي تولّدها الشبكة العصبية أثناء التعلم.
والآن، لنلقِ نظرة على التقنيتين اللتين تقوم عليهما مطابقة التوزيع.
مطابقة التوزيع أحادية الطبقة#
تركّز مطابقة التوزيع أحادية الطبقة على طبقة واحدة من الشبكة العصبية، وتقارن السمات التي تنتجها للبيانات الحقيقية مقابل البيانات الاصطناعية. وتلتقط هذه السمات، التي تُسمّى أيضًا التنشيطات، ما تعلّمه النموذج عند تلك النقطة من الشبكة.
من خلال جعل البيانات الاصطناعية تنتج تنشيطات متشابهة، تشجّع الطريقة مجموعة البيانات المُقطّرة على عكس الأنماط المهمة نفسها الموجودة في مجموعة البيانات الأصلية. عمليًا، تُحدَّث العينات الاصطناعية مرارًا حتى تتطابق التنشيطات عند الطبقة المختارة عن كثب مع التنشيطات الناتجة عن الصور الحقيقية.
هذا النهج بسيط نسبيًا لأنه يحاذي مستوى تمثيل واحدًا فقط في كل مرة. ويمكن أن ينجح بفاعلية خاصة مع مجموعات البيانات الأصغر أو المهام التي لا تتطلب مطابقة تسلسلات هرمية عميقة ومتعددة المراحل للسمات. ومن خلال المحاذاة الواضحة لفضاء سمات واحد، توفر المطابقة أحادية الطبقة إشارة مستقرة وذات معنى للتعلم باستخدام مجموعة البيانات المُقطّرة.
مطابقة التوزيع متعددة الطبقات#
توسّع مطابقة التوزيع متعددة الطبقات فكرة مقارنة البيانات الحقيقية والاصطناعية، إذ تنفذ المقارنة عند عدة طبقات من الشبكة العصبية بدلًا من طبقة واحدة فقط. وتلتقط الطبقات المختلفة أنواعًا مختلفة من المعلومات، بدءًا من الحواف والأنسجة البسيطة في الطبقات الأولى، وصولًا إلى الأشكال والأنماط الأكثر تعقيدًا في الطبقات الأعمق.
من خلال مطابقة السمات عبر هذه الطبقات، تُوجَّه مجموعة البيانات المُقطّرة لتعكس ما يتعلمه النموذج على مستويات متعددة. ولأن هذا النهج يحاذي السمات عبر الشبكة بأكملها، فإنه يساعد البيانات الاصطناعية على الاحتفاظ بإشارات أغنى يعتمد عليها النموذج للتمييز بين الفئات.
يفيد هذا بوجه خاص في الرؤية الحاسوبية، أي المهام التي تتعلم فيها النماذج فهم الصور ومقاطع الفيديو، لأن الأنماط المفيدة موزعة على طبقات كثيرة. وعندما تتطابق توزيعات السمات جيدًا عند أعماق متعددة، تؤدي مجموعة البيانات المُقطّرة دور بديل أقوى وأكثر موثوقية لبيانات التدريب الأصلية.
طرق مطابقة المعلمات#
تُعد مطابقة المعلمات فئة رئيسية أخرى في تقطير مجموعات البيانات. فبدلًا من مطابقة الدقة أو توزيعات السمات، تطابق هذه الطريقة كيفية تغيّر أوزان النموذج أثناء التدريب. ومن خلال جعل التدريب على مجموعة البيانات المُقطّرة ينتج تحديثات للمعلمات مماثلة للتحديثات الناتجة عن التدريب على البيانات الحقيقية، يسلك النموذج مسار تعلم شبه مطابق.
سنستعرض فيما يلي الطريقتين الرئيسيتين لمطابقة المعلمات.
المطابقة بخطوة واحدة#
تقارن المطابقة بخطوة واحدة ما يحدث لأوزان النموذج بعد خطوة تدريب واحدة فقط على بيانات حقيقية. ثم تُضبط مجموعة البيانات المُقطّرة بحيث ينتج النموذج المدرّب عليها خطوة واحدة تحديثًا للأوزان مشابهًا جدًا. وبما أنها تركز على هذا التحديث الواحد فقط، فإن الطريقة مباشرة وسريعة التنفيذ.
أما عيبها فهو أن خطوة واحدة لا تعكس عملية التعلم كاملة، ولا سيما في المهام الأصعب التي يحتاج فيها النموذج إلى تحديثات كثيرة لبناء سمات أغنى. ولهذا السبب، تميل المطابقة بخطوة واحدة إلى تحقيق أفضل النتائج في المسائل الأبسط أو مجموعات البيانات الأصغر، حيث يمكن التقاط الأنماط المفيدة بسرعة.
مطابقة المعلمات متعددة الخطوات#
على النقيض من ذلك، تنظر مطابقة المعلمات متعددة الخطوات إلى كيفية تغيّر أوزان النموذج عبر عدة خطوات تدريب، لا خطوة واحدة فحسب. ويُسمّى تسلسل التحديثات هذا مسار تدريب النموذج.
تُبنى مجموعة البيانات المُقطّرة بحيث يتبع مسار النموذج عند تدريبه على العينات الاصطناعية المسار الذي كان سيسلكه عند التدريب على البيانات الحقيقية عن كثب. ومن خلال مطابقة فترة أطول من التعلم، تلتقط المجموعة المُقطّرة قدرًا أكبر من بنية عملية التدريب الأصلية.
ولأنها تعكس كيفية تطور التعلم بمرور الوقت، تحقق المطابقة متعددة الخطوات عادةً نتائج أفضل مع مجموعات البيانات الأكبر أو الأكثر تعقيدًا، حيث تحتاج النماذج إلى تحديثات كثيرة لالتقاط الأنماط المفيدة. لكنها تتطلب قدرًا أكبر من الحوسبة، إذ يلزمها تتبع خطوات متعددة، وغالبًا ما تنتج مجموعات بيانات مُقطّرة تحقق تعميمًا أفضل وأداءً أعلى من المطابقة بخطوة واحدة.
آلية إنشاء مجموعات البيانات الاصطناعية وتحسينها#
بعد فهم أفضل لأساليب التقطير الرئيسية، يمكننا الآن استكشاف كيفية إنشاء البيانات الاصطناعية. في تقطير مجموعات البيانات، تُحسَّن العينات الاصطناعية لالتقاط أهم إشارات التعلم، بحيث تتمكن مجموعة صغيرة من استبدال مجموعة بيانات أكبر بكثير.
سنرى فيما يلي كيفية إنشاء هذه البيانات المُقطّرة وتقييمها.
إنشاء الصور المُقطّرة وتقييمها#
أثناء تقطير مجموعة البيانات، تُحدَّث وحدات البكسل الاصطناعية عبر خطوات تدريب كثيرة. وتتعلم الشبكة العصبية من الصور الاصطناعية الحالية وترسل تغذية راجعة قائمة على التدرجات، توضّح كيفية تغيير كل بكسل لمطابقة الأنماط في مجموعة البيانات الحقيقية على نحو أفضل.
ينجح ذلك لأن العملية قابلة للاشتقاق (أي إن كل خطوة سلسة ولها تدرجات محددة جيدًا، لذا تؤدي التغييرات الصغيرة في وحدات البكسل إلى تغييرات متوقعة في الخسارة)، ما يتيح للنموذج ضبط البيانات الاصطناعية بسلاسة أثناء الانحدار المتدرج.
مع استمرار التحسين، تبدأ الصور الاصطناعية بتكوين بنية ذات معنى، تشمل الأشكال والأنسجة التي يتعرف عليها النموذج. وغالبًا ما تُستخدم هذه الصور الاصطناعية المنقّحة في مهام تصنيف الصور لأنها تلتقط الإشارات البصرية الأساسية التي يحتاج إليها المصنّف للتعلم.
تُقيَّم مجموعات البيانات المُقطّرة بتدريب النماذج عليها ومقارنة النتائج بنتائج النماذج المدرّبة على بيانات حقيقية. ويقيس الباحثون دقة التحقق، ويتحققون مما إذا كانت المجموعة الاصطناعية تحتفظ بالسمات التمييزية (الأنماط أو الإشارات التي يعتمد عليها النموذج للتمييز بين فئة وأخرى) اللازمة للفصل بين الفئات. كما يختبرون الاستقرار والتعميم عبر عمليات تشغيل أو إعدادات نماذج مختلفة، للتأكد من أن البيانات المُقطّرة لا تؤدي إلى فرط التكيّف.
تطبيقات تقطير البيانات في العالم الواقعي#
سنلقي نظرة عن كثب فيما يلي على أمثلة توضّح كيف تسرّع مجموعات البيانات المُقطّرة التدريب وتقلل تكاليف الحوسبة مع الحفاظ على أداء قوي، حتى عندما تكون البيانات محدودة أو شديدة التخصص.
استخدام تقطير مجموعات البيانات في تطبيقات الرؤية الحاسوبية#
في مجال الرؤية الحاسوبية، يتمثل الهدف في تدريب النماذج على فهم البيانات المرئية مثل الصور ومقاطع الفيديو. وتتعلم هذه النماذج أنماطًا مثل الحواف والأنسجة والأشكال والأجسام، ثم تستخدمها في مهام مثل تصنيف الصور واكتشاف الأجسام والتقسيم. ونظرًا إلى أن مشكلات الرؤية غالبًا ما تنطوي على تفاوتات كبيرة في الإضاءة والخلفيات وزوايا الرؤية، تحتاج أنظمة الرؤية الحاسوبية عادةً إلى مجموعات بيانات كبيرة لتحقيق تعميم جيد، ما يجعل التدريب بطيئًا ومكلفًا.
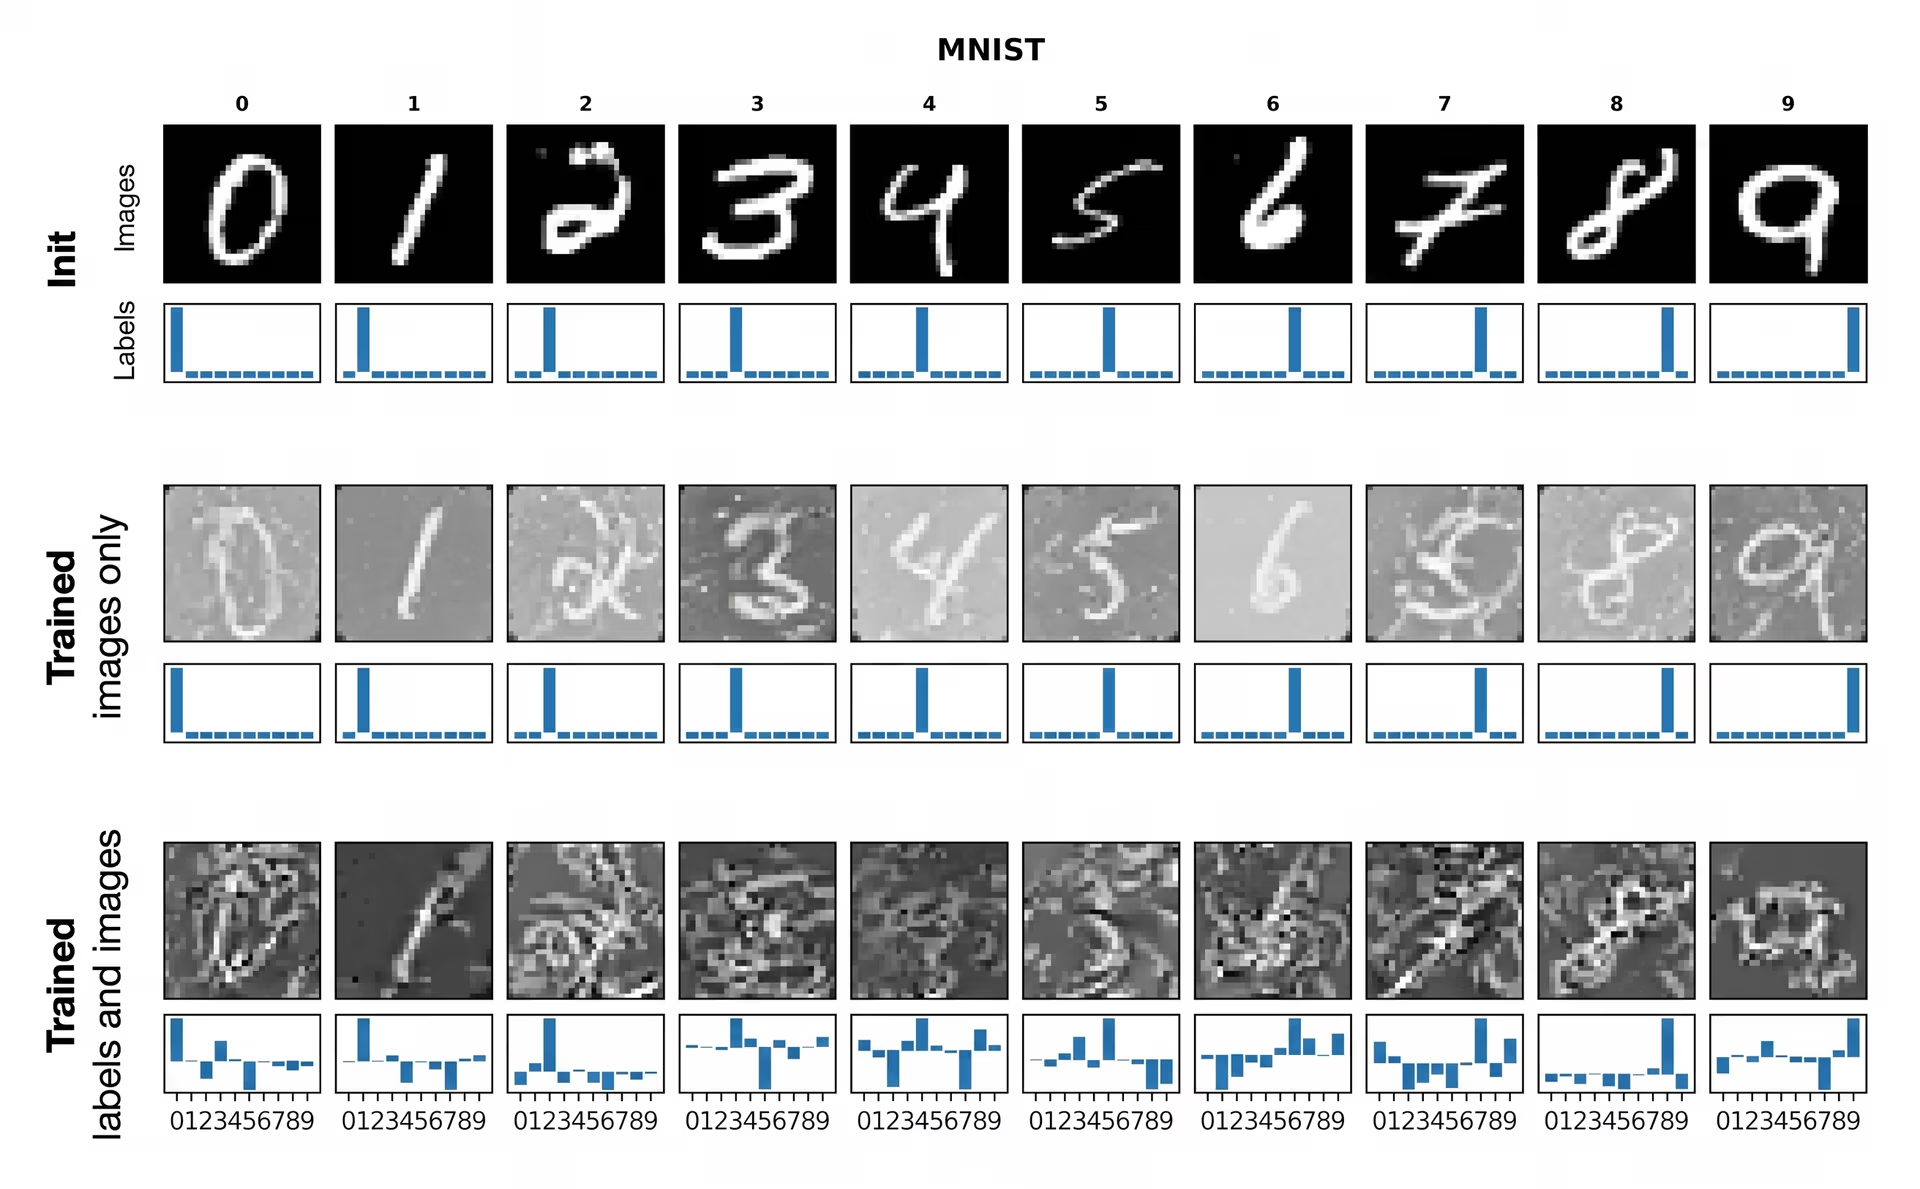
الشكل 4. مثال على تقطير مجموعة بيانات (المصدر)
في حالات استخدام تصنيف الصور، مثل الفحوصات الطبية ومراقبة الحياة البرية واكتشاف العيوب في المصانع، تواجه النماذج غالبًا مفاضلة صعبة بين الدقة وتكلفة التدريب. وعادةً ما تتضمن هذه المهام مجموعات بيانات ضخمة.
يمكن لتقطير مجموعة البيانات ضغط مجموعة التدريب الأصلية إلى عدد قليل من الصور الاصطناعية التي لا تزال تحتوي على أهم الإشارات البصرية التي يحتاج إليها المصنّف. وقد أظهرت مجموعات مُقطّرة لا تستخدم سوى نحو 4.2% من الصور الأصلية قدرتها على الحفاظ على دقة تصنيف قوية في معايير تقييم كبيرة مثل ImageNet. وهذا يعني أن مجموعة اصطناعية بديلة صغيرة جدًا يمكنها أن تحل محل ملايين العينات الحقيقية مع استخدام قدر أقل بكثير من الحوسبة.
البحث عن البنى العصبية#
البحث عن البنى المعمارية للشبكات العصبية، أو NAS، تقنية تستكشف تلقائيًا تصميمات عديدة محتملة للشبكات العصبية للعثور على الأنسب لمهمة معينة. ولأن NAS يتطلب تدريب عدد كبير من النماذج المرشحة وتقييمها، فقد يكون تشغيله على مجموعات البيانات الكاملة بطيئًا ومكثفًا جدًا من الناحية الحاسوبية.
يساعد تقطير مجموعة البيانات بإنشاء مجموعة تدريب اصطناعية صغيرة جدًا تحتفظ بإشارات التعلم الأساسية في البيانات الأصلية، بحيث يمكن اختبار كل بنية مرشحة بسرعة أكبر. وهذا يتيح لـ NAS مقارنة التصاميم بكفاءة، مع الحفاظ على موثوقية معقولة لترتيب البنى الجيدة مقابل السيئة، وخفض تكلفة البحث دون التضحية بجودة النموذج النهائية إلا قليلًا.
التعلم المستمر والنشر على الأجهزة الطرفية#
تحتاج أنظمة التعلم المستمر، أي النماذج التي تواصل التحديث عند ورود بيانات جديدة بدلًا من تدريبها مرة واحدة، إلى تحديثات سريعة وموفرة للذاكرة. وتواجه الأجهزة الطرفية مثل الكاميرات والهواتف وأجهزة الاستشعار قيودًا مماثلة، إذ لديها ميزانيات محدودة للقدرة الحاسوبية والتخزين.
يفيد تقطير مجموعة البيانات في الحالتين بضغط مجموعة تدريب كبيرة إلى مجموعة اصطناعية صغيرة جدًا، بحيث تتمكن النماذج من التكيف أو إعادة التدريب باستخدام مجموعة صغيرة لإعادة التشغيل بدلًا من مجموعة البيانات الكاملة. فعلى سبيل المثال، أظهر بحث في التعلم الفوقي المعتمد على النواة أن 10 عينات مُقطّرة فقط يمكنها تحقيق دقة تتجاوز 64% على CIFAR-10، وهو معيار شائع لتصنيف الصور. ولأن مجموعة إعادة التشغيل صغيرة جدًا، تصبح التحديثات أسرع بكثير وأكثر عملية، ولا سيما عندما تحتاج النماذج إلى التحديث باستمرار.
يمكن أن يعمل تكثيف مجموعات البيانات أيضًا جنبًا إلى جنب مع تقطير المعرفة للنماذج اللغوية الكبيرة. إذ يمكن لمجموعة بيانات صغيرة مكثفة أن تحتفظ بأهم إشارات المهمة المستخلصة من النموذج المعلّم، بحيث يمكن تدريب نموذج متعلم مضغوط أو تحديثه بكفاءة أكبر دون خسارة كبيرة في الأداء. ولأن مجموعات البيانات هذه صغيرة جدًا، فهي مفيدة خصوصًا للاستخدام الطرفي أو على الجهاز، حيث تكون سعة التخزين والقدرة الحاسوبية محدودة، مع الحاجة إلى الحفاظ على دقة النموذج بعد التحديثات.
إيجابيات تقطير البيانات وسلبياته#
فيما يلي بعض فوائد استخدام تقطير مجموعات البيانات:
- مناسب جدًا للتجارب السريعة. يمكنك اختبار بنى أو دوال خسارة أو معاملات فائقة جديدة من دون إعادة التدريب على مجموعة بيانات ضخمة في كل مرة.
- ميزة محتملة للخصوصية. قد يكون تبادل العينات الاصطناعية المُقطّرة أكثر أمانًا من تبادل نقاط بيانات المستخدمين الحقيقية، إذ لا تُكشف الأمثلة الخام مباشرةً.
- غالبًا ما يتفوق على اختيار مجموعة فرعية بسيطة. فبدلًا من مجرد اختيار الأمثلة، يحسّنها التقطير بفاعلية لتكون غنية بالمعلومات إلى أقصى حد.
مع أن تقطير مجموعات البيانات يقدم مزايا عديدة، فإليك بعض القيود التي ينبغي وضعها في الحسبان:
- فرط التكيّف. غالبًا ما تكون البيانات المكثفة أنسب للبنية المعمارية المستخدمة أثناء التكثيف، وقد لا تنتقل بفاعلية إلى نماذج مختلفة جدًا.
- حساسية عالية للمعاملات الفائقة. قد تعتمد النتائج كثيرًا على عوامل مثل معدل التعلم والتهيئة وعدد خطوات التقطير.
- صعوبة التوسع لمواجهة تعقيدات العالم الواقعي. قد تفقد الطرق التي تحقق نتائج جيدة في معايير التقييم دقتها عند التعامل مع مجموعات بيانات كبيرة أو فوضوية أو عالية الدقة.
أبرز النقاط#
يتيح تقطير مجموعات البيانات لمجموعة صغيرة من العينات الاصطناعية تعليم النموذج بفاعلية تكاد تضاهي مجموعة بيانات كاملة. وهذا يجعل التعلم الآلي أسرع وأكثر كفاءة وأسهل في التوسع. ومع نمو النماذج واحتياجها إلى مزيد من البيانات، تقدم مجموعات البيانات المُقطّرة وسيلة عملية لخفض تكاليف الحوسبة من دون التضحية بالدقة.
انضم إلى مجتمعنا وتفقّد مستودعنا على GitHub لاكتشاف المزيد عن الذكاء الاصطناعي. إذا كنت تتطلع إلى بناء مشروعك الخاص في الذكاء الاصطناعي للرؤية، فاطّلع على خيارات الترخيص. تعرّف على المزيد عن تطبيقات مثل الذكاء الاصطناعي في الرعاية الصحية والذكاء الاصطناعي للرؤية في قطاع البيع بالتجزئة بزيارة صفحات الحلول لدينا.
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









