ما هو فرط التكيّف في الرؤية الحاسوبية وكيفية منعه؟
تعرّف إلى فرط التكيّف في الرؤية الحاسوبية وكيفية منعه باستخدام زيادة البيانات، والتنظيم، والنماذج المدرّبة مسبقًا.
صُمِّمت نماذج الرؤية الحاسوبية للتعرّف على الأنماط واكتشاف الكائنات وتحليل الصور. ومع ذلك، يعتمد أداؤها على مدى جودة تعميمها على البيانات غير المرئية. والتعميم هو قدرة النموذج على العمل جيدًا على الصور الجديدة، وليس فقط الصور التي دُرِّب عليها. ومن المشكلات الشائعة في تدريب هذه النماذج فرط التكيّف، حيث يتعلم النموذج الكثير من بيانات التدريب، بما في ذلك الضوضاء غير الضرورية، بدلًا من تحديد الأنماط ذات المعنى.
عند حدوث ذلك، يؤدي النموذج أداءً جيدًا على بيانات التدريب، لكنه يواجه صعوبة مع الصور الجديدة. فعلى سبيل المثال، قد يفشل نموذج اكتشاف الكائنات المدرَّب فقط على صور عالية الدقة وجيدة الإضاءة عند تقديم صور ضبابية أو مظللة إليه في ظروف العالم الحقيقي. ويحدّ فرط التكيّف من قدرة النموذج على التكيف، مما يقيّد استخدامه في تطبيقات العالم الحقيقي مثل القيادة الذاتية والتصوير الطبي وأنظمة الأمان.
سنستكشف في هذه المقالة ماهية فرط التكيّف، وأسباب حدوثه، وكيفية الوقاية منه. وسنتناول أيضًا كيفية مساعدة نماذج الرؤية الحاسوبية مثل Ultralytics YOLO11 في الحد من فرط التكيّف وتحسين التعميم.
ما فرط التكيّف؟#
يحدث فرط التكيّف عندما يحفظ النموذج بيانات التدريب بدلًا من تعلم الأنماط التي تنطبق على المدخلات الجديدة على نطاق واسع. إذ يركّز النموذج بشكل مفرط على بيانات التدريب، فيواجه صعوبة مع الصور أو المواقف الجديدة التي لم يسبق له رؤيتها.
في الرؤية الحاسوبية، يمكن أن يؤثر فرط التكيّف في مهام مختلفة. فقد يواجه نموذج تصنيف دُرِّب فقط على صور ساطعة وواضحة صعوبة في ظروف الإضاءة المنخفضة. وقد يفشل نموذج اكتشاف كائنات يتعلم من صور مثالية في المشاهد المزدحمة أو الفوضوية. وبالمثل، قد يعمل نموذج تجزئة المثيلات جيدًا في بيئات مضبوطة، لكنه يواجه صعوبة مع الظلال أو الكائنات المتداخلة.
يمثل هذا مشكلة في تطبيقات الذكاء الاصطناعي في العالم الحقيقي، حيث يجب أن تتمكن النماذج من التعميم خارج ظروف التدريب المضبوطة. فعلى سبيل المثال، يجب أن تتمكن السيارات ذاتية القيادة من اكتشاف المشاة في ظروف إضاءة وطقس وبيئات مختلفة. ولن يؤدي النموذج الذي يعاني فرط التكيّف مع مجموعة تدريبه أداءً موثوقًا في مثل هذه السيناريوهات غير المتوقعة.
متى يحدث فرط التكيّف ولماذا؟#
يحدث فرط التكيّف عادةً بسبب مجموعات البيانات غير المتوازنة، والتعقيد المفرط للنموذج، والإفراط في التدريب. فيما يلي الأسباب الرئيسية:
- بيانات تدريب محدودة: تجعل مجموعات البيانات الصغيرة النماذج تحفظ الأنماط بدلًا من تعميمها. فقد يواجه نموذج دُرِّب على 50 صورة فقط لطيور صعوبة في اكتشاف أنواع الطيور خارج مجموعة البيانات تلك.
- نماذج معقدة ذات عدد كبير جدًا من المعلمات: تميل الشبكات العميقة ذات الطبقات والعصبونات المفرطة إلى حفظ التفاصيل الدقيقة بدلًا من التركيز على السمات الأساسية.
- نقص زيادة البيانات: من دون تحويلات مثل الاقتصاص أو القلب أو التدوير، قد يتعلم النموذج فقط من صور التدريب الأصلية كما هي.
- التدريب المطوّل: إذا مرّ النموذج على بيانات التدريب مرات كثيرة جدًا، وهو ما يُعرف باسم العصور، فإنه يحفظ التفاصيل بدلًا من تعلم الأنماط العامة، مما يجعله أقل قدرة على التكيف.
- تسميات غير متسقة أو مشوشة: تتسبب البيانات المصنفة بشكل غير صحيح في تعلم النموذج للأنماط الخاطئة. ويشيع ذلك في مجموعات البيانات المصنفة يدويًا.
يضمن اتباع نهج متوازن جيدًا تجاه تعقيد النموذج وجودة مجموعة البيانات وتقنيات التدريب تعميمًا أفضل.
فرط التكيّف مقابل نقص التكيّف#
فرط التكيّف ونقص التكيّف مشكلتان متناقضتان تمامًا في التعلم العميق.
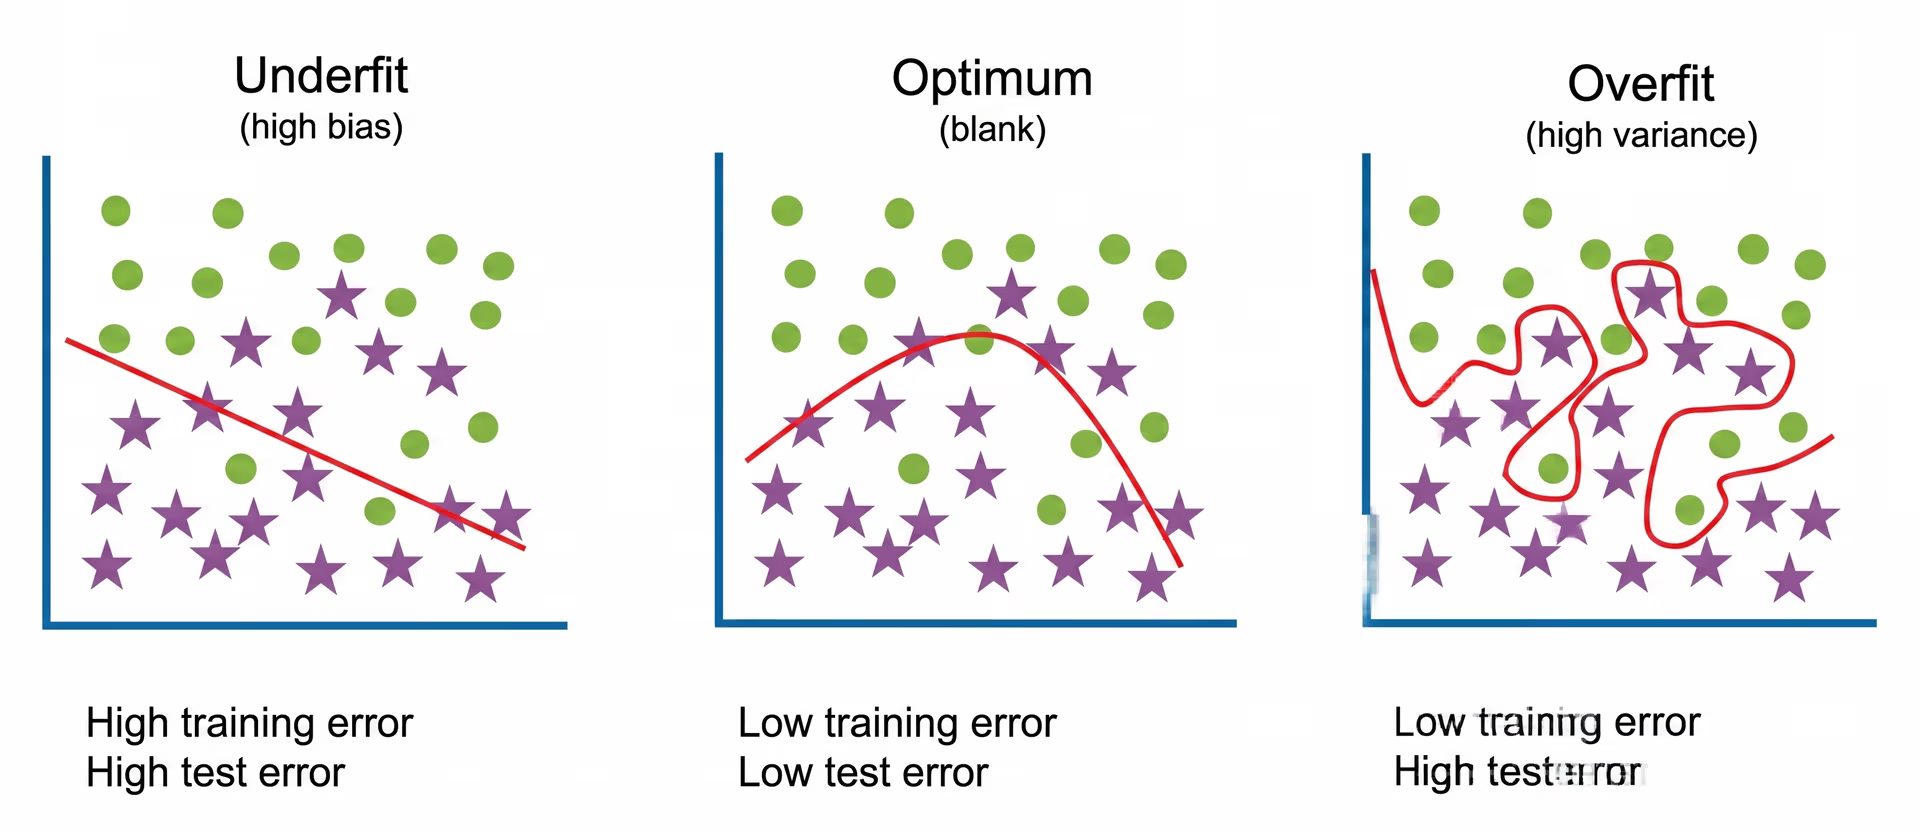
الشكل 1. مقارنة بين نقص التكيّف والتعلم الأمثل وفرط التكيّف في نماذج الرؤية الحاسوبية.
يحدث فرط التكيّف عندما يكون النموذج معقدًا جدًا، مما يجعله يركّز بشكل مفرط على بيانات التدريب. فبدلًا من تعلم الأنماط العامة، يحفظ التفاصيل الصغيرة، حتى غير المهمة منها مثل ضوضاء الخلفية. ويؤدي ذلك إلى أداء النموذج جيدًا على بيانات التدريب، لكنه يواجه صعوبة مع الصور الجديدة، مما يعني أنه لم يتعلم حقًا كيفية التعرّف على الأنماط التي تنطبق في مواقف مختلفة.
يحدث نقص التكيّف عندما يكون النموذج بسيطًا جدًا، فيفشل في التقاط الأنماط المهمة في البيانات. وقد يحدث ذلك عندما يحتوي النموذج على عدد قليل جدًا من الطبقات، أو لا يحصل على وقت تدريب كافٍ، أو تكون البيانات محدودة. ونتيجة لذلك، يفشل في التعرّف على الأنماط المهمة ويصدر تنبؤات غير دقيقة. ويؤدي هذا إلى أداء ضعيف على بيانات التدريب والاختبار معًا، لأن النموذج لم يتعلم ما يكفي لفهم المهمة على نحو صحيح.
يحقق النموذج المدرَّب جيدًا توازنًا بين التعقيد والتعميم. وينبغي أن يكون معقدًا بما يكفي لتعلم الأنماط ذات الصلة، ولكن ليس معقدًا إلى درجة تجعله يحفظ البيانات بدلًا من التعرّف على العلاقات الكامنة.
كيفية تحديد فرط التكيّف#
فيما يلي بعض العلامات التي تشير إلى أن النموذج يعاني فرط التكيّف:
- إذا كانت دقة التدريب أعلى بكثير من دقة التحقق، فمن المرجح أن النموذج يعاني فرط التكيّف.
- يُعد اتساع الفجوة بين خسارة التدريب وخسارة التحقق مؤشرًا قويًا آخر.
- يكون النموذج واثقًا أكثر من اللازم في الإجابات الخاطئة، مما يدل على أنه حفظ التفاصيل بدلًا من فهم الأنماط.
لضمان تعميم النموذج جيدًا، يجب اختباره على مجموعات بيانات متنوعة تعكس ظروف العالم الحقيقي.
كيفية الوقاية من فرط التكيّف في الرؤية الحاسوبية#
فرط التكيّف ليس حتميًا، ويمكن الوقاية منه. وباستخدام التقنيات المناسبة، يمكن لنماذج الرؤية الحاسوبية تعلم الأنماط العامة بدلًا من حفظ بيانات التدريب، مما يجعلها أكثر موثوقية في تطبيقات العالم الحقيقي.
فيما يلي خمس استراتيجيات رئيسية للوقاية من فرط التكيّف في الرؤية الحاسوبية.
زيادة تنوع البيانات باستخدام زيادة البيانات والبيانات الاصطناعية#
أفضل طريقة لمساعدة النموذج على العمل جيدًا مع البيانات الجديدة هي توسيع مجموعة البيانات باستخدام زيادة البيانات والبيانات الاصطناعية. تُنشأ البيانات الاصطناعية بواسطة الحاسوب بدلًا من جمعها من صور العالم الحقيقي. وهي تساعد على سد الفجوات عندما لا تتوفر بيانات حقيقية كافية.
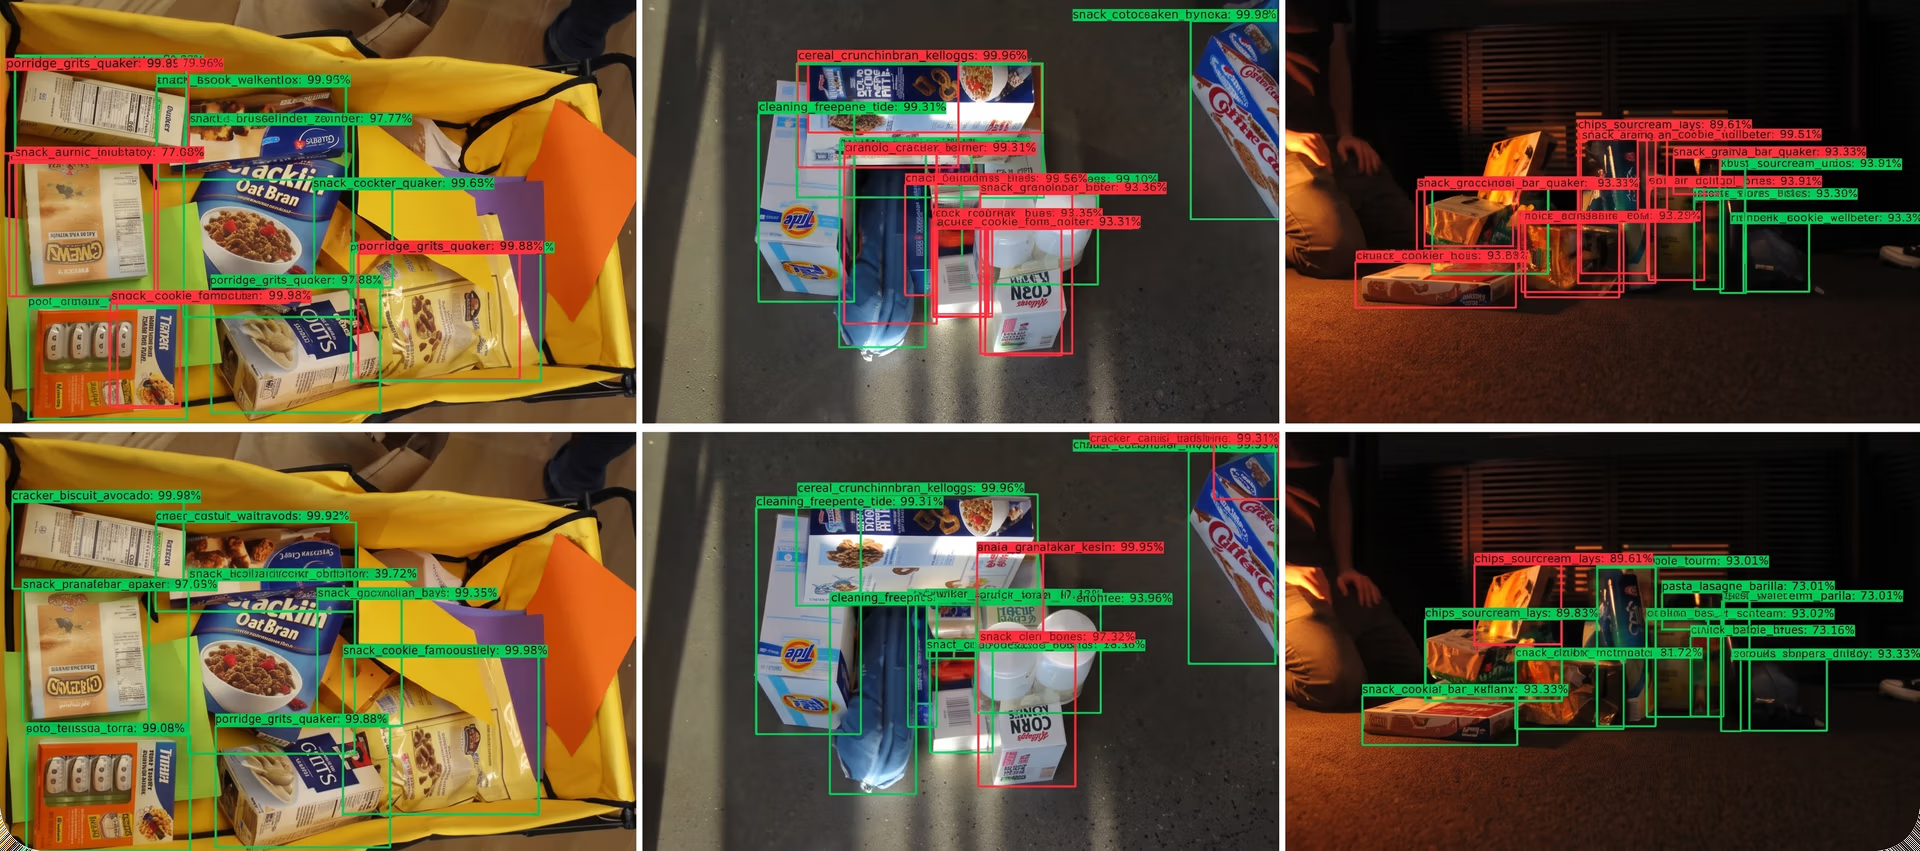
الشكل 2. يؤدي دمج بيانات العالم الحقيقي والبيانات الاصطناعية إلى الحد من فرط التكيّف وتحسين دقة اكتشاف الكائنات.
تُجري زيادة البيانات تغييرات طفيفة على الصور الموجودة من خلال قلبها أو تدويرها أو اقتصاصها أو ضبط سطوعها، بحيث لا يكتفي النموذج بحفظ التفاصيل، بل يتعلم التعرّف على الكائنات في مواقف مختلفة.
تكون البيانات الاصطناعية مفيدة عندما يصعب الحصول على صور حقيقية. فعلى سبيل المثال، يمكن لنماذج السيارات ذاتية القيادة أن تتدرب على مشاهد طرق مولَّدة بالحاسوب لتتعلم كيفية اكتشاف الكائنات في ظروف الطقس والإضاءة المختلفة. وهذا يجعل النموذج أكثر مرونة وموثوقية من دون الحاجة إلى آلاف الصور من العالم الحقيقي.
تحسين تعقيد النموذج وبنيته#
لا تكون الشبكة العصبية العميقة، وهي نوع من نماذج التعلم الآلي التي تحتوي على طبقات عديدة لمعالجة البيانات بدلًا من طبقة واحدة، أفضل دائمًا. فعندما يحتوي النموذج على عدد كبير جدًا من الطبقات أو المعلمات، فإنه يحفظ بيانات التدريب بدلًا من التعرّف على الأنماط الأوسع. ويمكن أن يساعد تقليل التعقيد غير الضروري في الوقاية من فرط التكيّف.
ولتحقيق ذلك، يتمثل أحد الأساليب في التقليم، الذي يزيل العصبونات والوصلات الزائدة، مما يجعل النموذج أكثر رشاقة وكفاءة.
ومن الأساليب الأخرى تبسيط البنية من خلال تقليل عدد الطبقات أو العصبونات. صُمِّمت النماذج المدرَّبة مسبقًا مثل Ultralytics YOLO11 للتعميم جيدًا عبر المهام باستخدام عدد أقل من المعلمات، مما يجعلها أكثر مقاومة لفرط التكيّف من تدريب نموذج عميق من الصفر.
يساعد العثور على التوازن المناسب بين عمق النموذج وكفاءته على تعلم الأنماط المفيدة بدلًا من مجرد حفظ بيانات التدريب.
تطبيق تقنيات التنظيم#
تمنع تقنيات التنظيم النماذج من الاعتماد المفرط على سمات محددة في بيانات التدريب. فيما يلي بعض التقنيات شائعة الاستخدام:
- يعمل الإسقاط على تعطيل أجزاء عشوائية من النموذج أثناء التدريب، بحيث يتعلم التعرّف على أنماط مختلفة بدلًا من الاعتماد المفرط على عدد قليل من السمات.
- يحدّ اضمحلال الأوزان (تنظيم L2) من قيم الأوزان المتطرفة، ويحافظ على تعقيد النموذج تحت السيطرة.
- يساعد تطبيع الدفعات على استقرار التدريب من خلال ضمان أن يكون النموذج أقل حساسية للتغيرات في مجموعة البيانات.
تساعد هذه التقنيات في الحفاظ على مرونة النموذج وقدرته على التكيف، مما يقلل من خطر فرط التكيّف مع الحفاظ على الدقة.
مراقبة التدريب باستخدام التحقق والإيقاف المبكر#
للوقاية من فرط التكيّف، من المهم تتبع كيفية تعلم النموذج وضمان تعميمه جيدًا على البيانات الجديدة. فيما يلي تقنيتان تساعدان في ذلك:
- الإيقاف المبكر: ينهي التدريب تلقائيًا عندما يتوقف النموذج عن التحسن، بحيث لا يستمر في تعلم التفاصيل غير الضرورية.
- التحقق المتقاطع: يقسم البيانات إلى أجزاء ويدرّب النموذج على كل جزء منها. ويساعد ذلك النموذج على تعلم الأنماط بدلًا من حفظ صور محددة.
تساعد هذه التقنيات النموذج على الحفاظ على توازنه، بحيث يتعلم ما يكفي لتحقيق الدقة دون أن يركّز بشكل مفرط على بيانات التدريب وحدها.
استخدام النماذج المدرَّبة مسبقًا وتحسين وسم مجموعة البيانات#
بدلًا من التدريب من الصفر، يمكن أن يساعد استخدام نماذج مدرَّبة مسبقًا مثل Ultralytics YOLO11 في الحد من فرط التكيّف. فقد دُرِّب YOLO11 على مجموعات بيانات واسعة النطاق، مما يتيح له التعميم جيدًا عبر ظروف مختلفة.
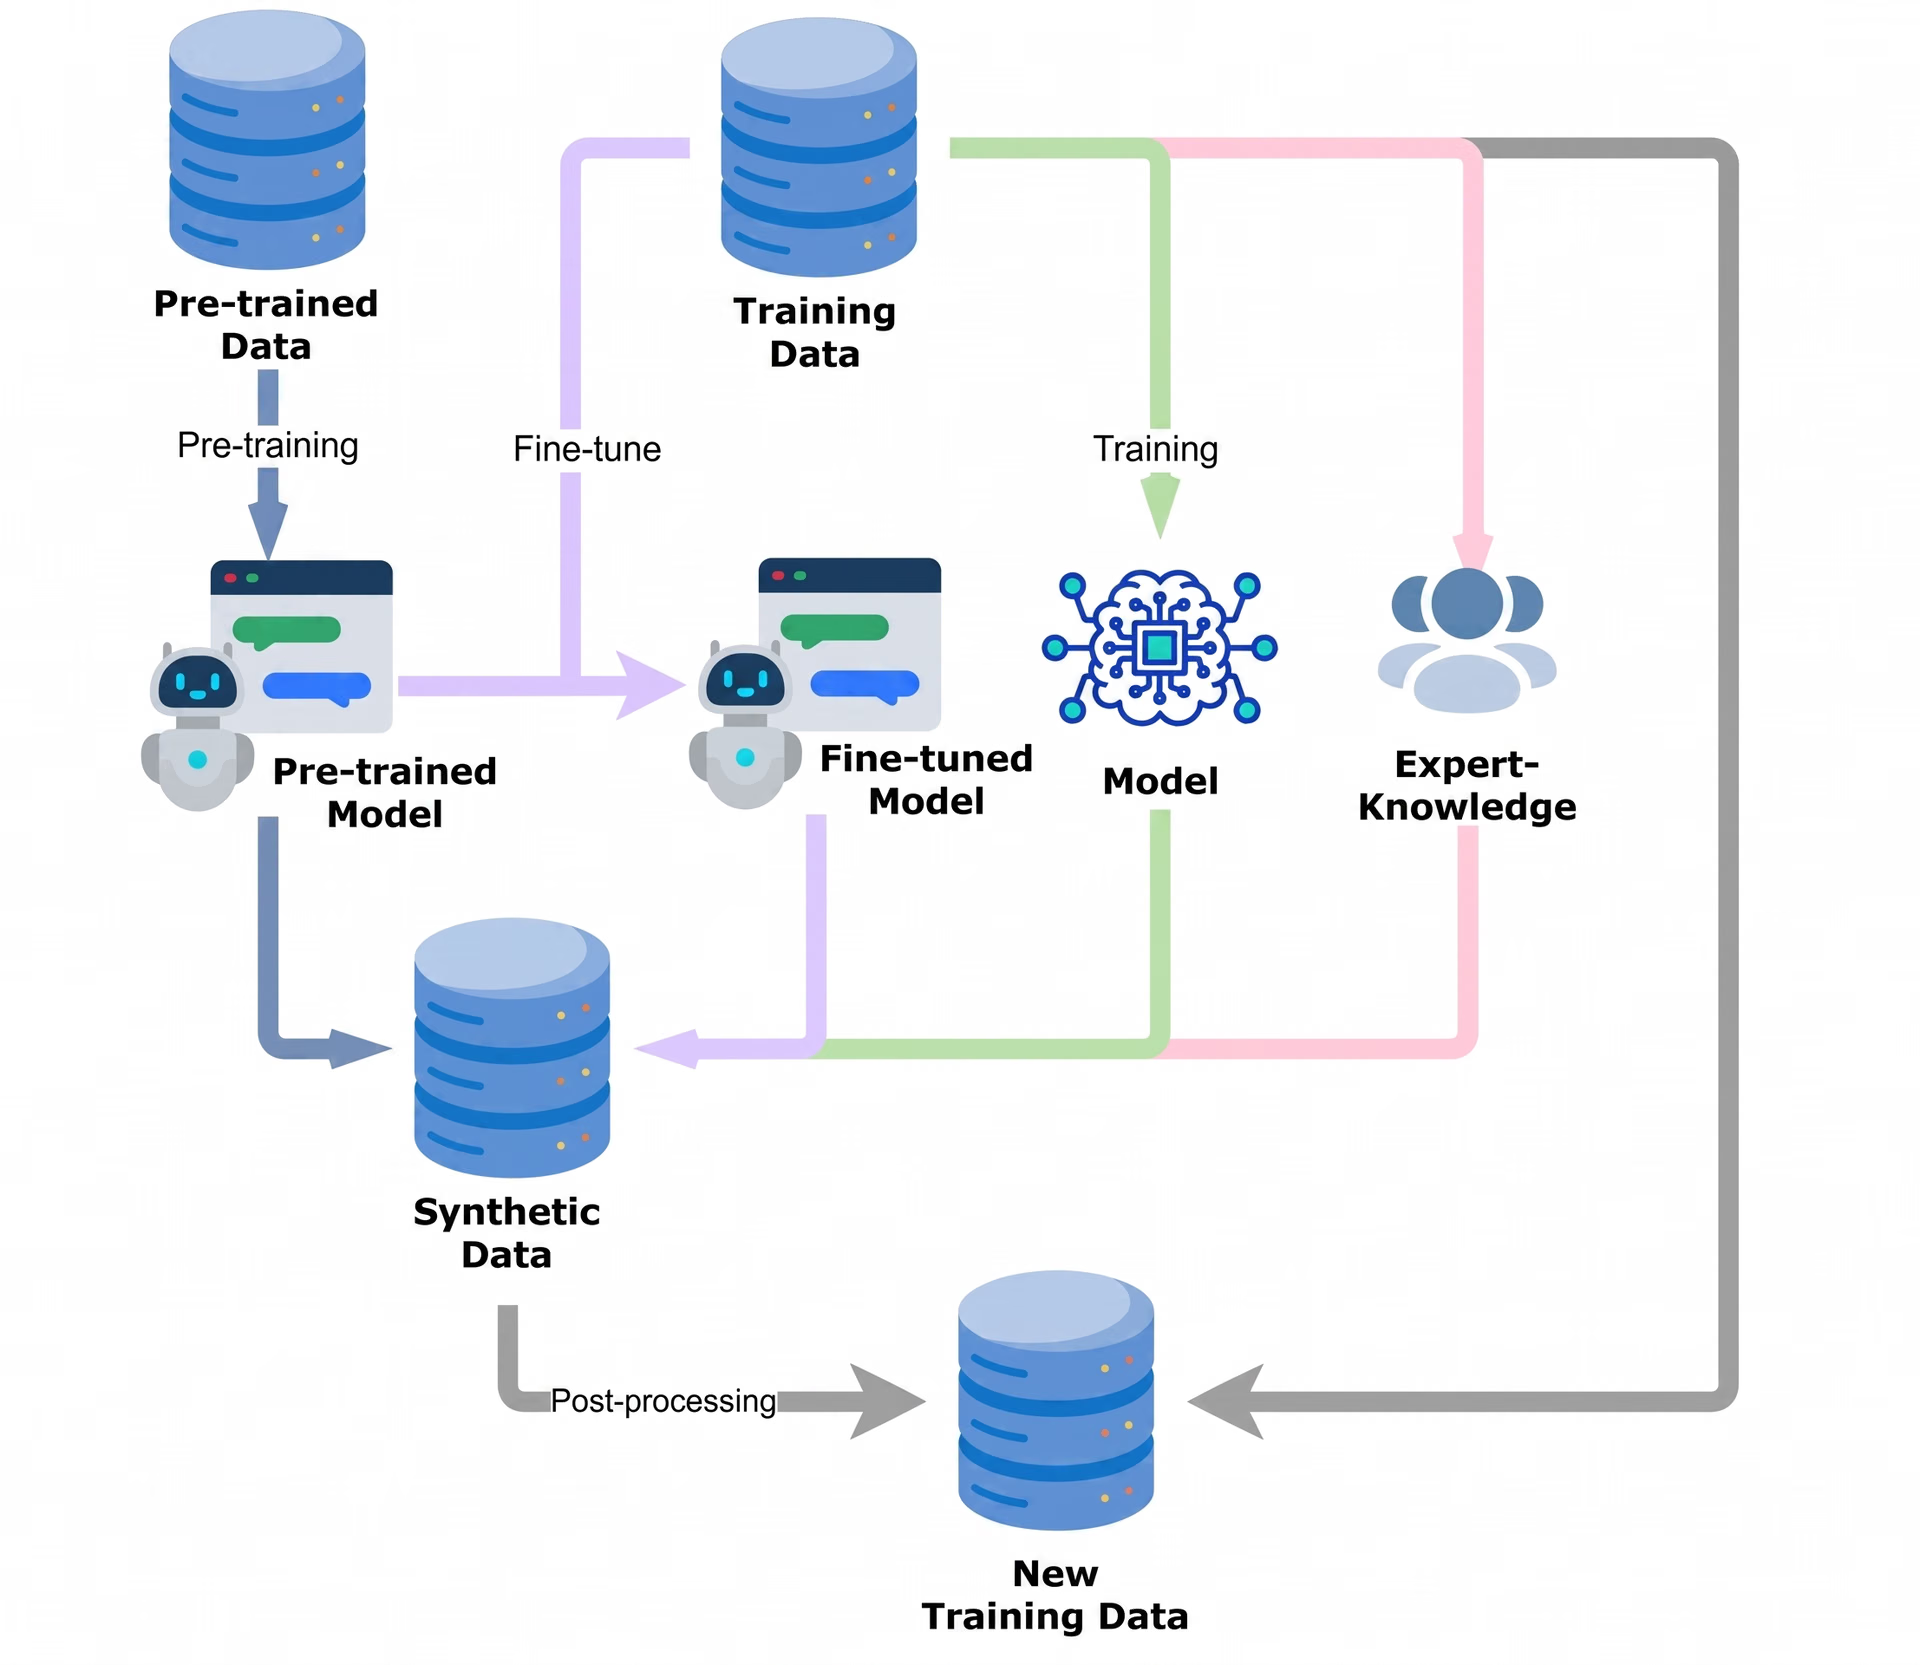
الشكل 3. تعزز نماذج الرؤية الحاسوبية المدرَّبة مسبقًا الدقة وتقي من فرط التكيّف.
يساعد الضبط الدقيق لنموذج مدرَّب مسبقًا على الاحتفاظ بما يعرفه بالفعل أثناء تعلم مهام جديدة، بحيث لا يكتفي بحفظ بيانات التدريب.
إضافةً إلى ذلك، يُعد ضمان وسم مجموعة البيانات بجودة عالية أمرًا ضروريًا. فقد تؤدي البيانات ذات التسميات الخاطئة أو غير المتوازنة إلى تضليل النماذج ودفعها إلى تعلم أنماط غير صحيحة. ويساعد تنظيف مجموعات البيانات، وتصحيح الصور ذات التسميات الخاطئة، وموازنة الفئات على تحسين الدقة وتقليل خطر فرط التكيّف. ومن الأساليب الفعالة الأخرى التدريب الخصومي، حيث يتعرض النموذج لأمثلة معدلة قليلًا أو أكثر تحديًا، صُمِّمت لاختبار حدوده.
أهم النقاط المستخلصة#
فرط التكيّف مشكلة شائعة في الرؤية الحاسوبية. فقد يعمل النموذج جيدًا على بيانات التدريب، لكنه يواجه صعوبة مع صور العالم الحقيقي. ولتجنب ذلك، تساعد تقنيات مثل زيادة البيانات والتنظيم واستخدام نماذج مدرَّبة مسبقًا مثل Ultralytics YOLO11 على تحسين الدقة والقدرة على التكيف.
من خلال تطبيق هذه الأساليب، يمكن لنماذج الذكاء الاصطناعي أن تظل موثوقة وتؤدي أداءً جيدًا في بيئات مختلفة. ومع تحسن التعلم العميق، سيكون ضمان تعميم النماذج على النحو الصحيح أمرًا أساسيًا لنجاح الذكاء الاصطناعي في العالم الحقيقي.
انضم إلى مجتمعنا المتنامي! واستكشف مستودعنا على GitHub لمعرفة المزيد عن الذكاء الاصطناعي. هل أنت مستعد لبدء مشاريعك الخاصة في مجال الرؤية الحاسوبية؟ اطّلع على خيارات الترخيص. واكتشف الذكاء الاصطناعي للرؤية في السيارات ذاتية القيادة والذكاء الاصطناعي في الرعاية الصحية من خلال زيارة صفحات حلولنا!








