Ultralytics YOLO11 mit früheren YOLO-Modellen vergleichen
Vergleiche Ultralytics YOLOv8, YOLOv9, YOLOv10 und Ultralytics YOLO11 anhand ihrer Funktionen, COCO-Benchmarks und Videotests und erfahre, wie sich YOLO von 2023 bis 2024 weiterentwickelt hat.
 Abirami Vina10 Min. Lesezeit

Von der Automatisierung alltäglicher Aufgaben bis hin zu fundierten Entscheidungen in Echtzeit: Künstliche Intelligenz (KI) gestaltet die Zukunft verschiedenster Branchen neu. Ein besonders spannendes Gebiet der KI ist Computer Vision, auch Vision-KI genannt. Dabei geht es darum, Maschinen dazu zu befähigen, visuelle Daten ähnlich wie Menschen zu analysieren und zu interpretieren.
Insbesondere Computer-Vision-Modelle treiben Innovationen voran, die sowohl die Sicherheit als auch die Effizienz verbessern. So kommen diese Modelle in selbstfahrenden Autos zum Einsatz, um Fußgänger zu erkennen, und in Sicherheitskameras, um rund um die Uhr Gelände zu überwachen.
Zu den bekanntesten Computer-Vision-Modellen gehören die YOLO-Modelle, die für ihre Fähigkeit zur Objekterkennung in Echtzeit bekannt sind. Im Laufe der Zeit wurden die YOLO-Modelle weiterentwickelt: Jede neue Version bietet bessere Leistung und mehr Flexibilität.
Neuere Versionen wie Ultralytics YOLO11 bewältigen verschiedene Aufgaben wie Instanzsegmentierung, Bildklassifizierung, Posenschätzung und die Verfolgung mehrerer Objekte – genauer und schneller als je zuvor.
In diesem Artikel vergleichen wir Ultralytics YOLOv8, YOLOv9, YOLOv10 und Ultralytics YOLO11, um besser nachzuvollziehen, wie sich diese Modelle weiterentwickelt haben. Wir untersuchen ihre wichtigsten Funktionen, Benchmark-Ergebnisse und Leistungsunterschiede.
Ein Überblick über Ultralytics YOLOv8#
YOLOv8 wurde am 10. Januar 2023 von Ultralytics veröffentlicht und stellte im Vergleich zu früheren YOLO-Modellen einen großen Fortschritt dar. Das Modell ist auf schnelle und genaue Erkennung in Echtzeit ausgelegt und kombiniert bewährte Ansätze mit neuen Verbesserungen, um bessere Ergebnisse zu erzielen.
Über die Objekterkennung hinaus unterstützt das Modell auch die folgenden Computer-Vision-Aufgaben: Instanzsegmentierung, Bildklassifizierung, Posenschätzung und Erkennung mit orientierten Begrenzungsrahmen (OBB). Ein weiteres wichtiges Merkmal von Ultralytics YOLOv8 ist, dass das Modell in fünf Varianten verfügbar ist: Nano, Small, Medium, Large und X. So kannst du je nach Bedarf die passende Balance zwischen Geschwindigkeit und Genauigkeit wählen.
Dank seiner Vielseitigkeit und starken Leistung lässt sich Ultralytics YOLOv8 in vielen praktischen Anwendungen einsetzen, etwa in Sicherheitssystemen, Smart Cities, im Gesundheitswesen und in der industriellen Automatisierung.

Abb. 1. Parkraumbewirtschaftung in Smart Cities mit YOLOv8.
Wichtige Funktionen von Ultralytics YOLOv8#
Hier findest du einen genaueren Überblick über einige weitere wichtige Funktionen von Ultralytics YOLOv8:
- Verbesserte Erkennungsarchitektur: Ultralytics YOLOv8 verwendet ein verbessertes CSPDarknet-Backbone. Dieses Backbone ist für die Merkmalsextraktion optimiert – den Prozess, bei dem wichtige Muster oder Details aus Eingabebildern erkannt und erfasst werden, damit das Modell genaue Vorhersagen treffen kann.
- Erkennungskopf: YOLOv8 verwendet ein entkoppeltes, ankerfreies Design. Das bedeutet, dass das Modell nicht auf vordefinierte Begrenzungsrahmenformen (Anker) angewiesen ist, sondern Objektpositionen direkt vorherzusagen lernt. Durch den entkoppelten Aufbau werden die Aufgaben, ein Objekt zu klassifizieren und seine Position vorherzusagen (Regression), getrennt voneinander verarbeitet. Das trägt zu einer höheren Genauigkeit und einem schnelleren Training bei.
- Ausgewogenes Verhältnis von Genauigkeit und Geschwindigkeit: Dieses Modell erzielt eine hohe Genauigkeit bei kurzen Inferenzzeiten und eignet sich damit sowohl für Cloud- als auch für Edge-Umgebungen.
- Benutzerfreundlichkeit: YOLOv8 ist so konzipiert, dass du schnell loslegen kannst. Mit dem Ultralytics-Python-Paket kannst du schon nach wenigen Minuten Vorhersagen erstellen und Ergebnisse sehen.
YOLOv9 setzt auf Recheneffizienz#
YOLOv9 wurde am 21. Februar 2024 von Chien-Yao Wang und Hong-Yuan Mark Liao vom Institute of Information Science der Academia Sinica in Taiwan veröffentlicht. Das Modell unterstützt Aufgaben wie Objekterkennung und Instanzsegmentierung.
Das Modell baut auf Ultralytics YOLOv5 auf und führt zwei wichtige Neuerungen ein: Programmierbare Gradienteninformationen (PGI) und ein verallgemeinertes effizientes Layer-Aggregationsnetzwerk (GELAN).
PGI hilft YOLOv9, wichtige Informationen zu bewahren, während die Daten die einzelnen Ebenen durchlaufen. Das führt zu genaueren Ergebnissen. GELAN verbessert unterdessen die Nutzung der Ebenen durch das Modell und steigert so Leistung und Recheneffizienz. Dank dieser Verbesserungen kann YOLOv9 Echtzeitaufgaben auf Edge-Geräten und in mobilen Apps bewältigen, wo die Rechenressourcen oft begrenzt sind.

Abb. 2. Wie GELAN die Genauigkeit von YOLOv9 verbessert.
Wichtige Funktionen von YOLOv9#
Hier ein Überblick über einige weitere wichtige Funktionen von YOLOv9:
- Hohe Genauigkeit bei geringem Ressourcenbedarf: YOLOv9 bietet eine hohe Erkennungsgenauigkeit, ohne viel Rechenleistung zu beanspruchen. Damit ist das Modell eine gute Wahl, wenn die Ressourcen begrenzt sind.
- Leichtgewichtige Modelle: Die leichtgewichtigen Modellvarianten von YOLOv9 sind für den Einsatz am Netzwerkrand und auf Mobilgeräten optimiert.
- Einfach zu verwenden: Das Ultralytics-Python-Paket unterstützt YOLOv9. Deshalb lässt sich das Modell in verschiedenen Umgebungen leicht einrichten und ausführen – ob mit Code oder über die Befehlszeile.
YOLOv10 ermöglicht Objekterkennung ohne NMS#
YOLOv10 wurde am 23. Mai 2024 von Forschenden der Tsinghua-Universität vorgestellt und ist auf die Objekterkennung in Echtzeit ausgerichtet. Das Modell behebt Einschränkungen früherer YOLO-Versionen, indem es die Notwendigkeit der Non-Maximum-Suppression (NMS), eines Nachverarbeitungsschritts zum Entfernen doppelter Erkennungen, beseitigt und den Gesamtaufbau des Modells weiter verfeinert. Dadurch werden Objekte schneller und effizienter erkannt, während gleichzeitig eine Genauigkeit auf dem neuesten Stand der Technik erreicht wird.
Ein wesentlicher Bestandteil dieses Ansatzes ist eine Trainingsmethode namens konsistente Zuordnung doppelter Labels. Sie kombiniert zwei Strategien: Eine ermöglicht es mehreren Vorhersagen, anhand desselben Objekts zu lernen (eins-zu-viele), die andere konzentriert sich auf die Auswahl der besten einzelnen Vorhersage (eins-zu-eins). Da beide Strategien dieselben Zuordnungsregeln verwenden, lernt das Modell selbstständig, doppelte Erkennungen zu vermeiden. NMS ist daher nicht erforderlich.

Abb. 3. YOLOv10 verwendet konsistente Zuordnungen doppelter Labels für das NMS-freie Training.
Die Architektur von YOLOv10 verwendet außerdem ein verbessertes CSPNet-Backbone, um Merkmale effektiver zu lernen, sowie einen PAN-Hals (Aggregationsnetzwerk für Pfade), der Informationen aus verschiedenen Ebenen zusammenführt. So kann das Modell sowohl kleine als auch große Objekte besser erkennen. Dank dieser Verbesserungen lässt sich YOLOv10 in praktischen Anwendungen der Fertigung, des Einzelhandels und des autonomen Fahrens einsetzen.
Wichtige Funktionen von YOLOv10#
Hier sind einige weitere besondere Funktionen von YOLOv10:
- Faltungen mit großen Kerneln: Das Modell verwendet Faltungen mit großen Kerneln, um mehr Kontext aus größeren Bildbereichen zu erfassen. Dadurch kann es die Gesamtszene besser verstehen.
- Partielle Selbstaufmerksamkeitsmodule: Das Modell umfasst partielle Selbstaufmerksamkeitsmodule, die sich auf die wichtigsten Bildbereiche konzentrieren, ohne zu viel Rechenleistung zu beanspruchen. So wird die Leistung effizient gesteigert.
- Einzigartige Modellvariante: Neben den üblichen Größen von YOLOv10 – Nano, Small, Medium, Large und X – gibt es auch eine besondere Version namens YOLOv10b (Balanced). Das Modell ist breiter, verarbeitet also auf jeder Ebene mehr Merkmale. Dadurch verbessert sich die Genauigkeit, während Geschwindigkeit und Größe ausgewogen bleiben.
- Benutzerfreundlich: YOLOv10 ist mit dem Ultralytics-Python-Paket kompatibel und dadurch einfach zu verwenden.
Ultralytics YOLO11: mehr Geschwindigkeit und Genauigkeit#
Am 30. September 2024 stellte Ultralytics YOLO11 auf seiner jährlichen Hybridveranstaltung YOLO Vision 2024 (YV24) offiziell vor.
Diese Veröffentlichung brachte deutliche Verbesserungen gegenüber früheren Versionen. Ultralytics YOLO11 ist schneller, genauer und besonders effizient. Das Modell unterstützt das gesamte Spektrum an Computer-Vision-Aufgaben, das Nutzer von YOLOv8 kennen, darunter Objekterkennung, Instanzsegmentierung und Bildklassifizierung. Außerdem bleibt es mit YOLOv8-Arbeitsabläufen kompatibel, sodass Nutzer problemlos auf die neue Version umsteigen können.
Darüber hinaus ist Ultralytics YOLO11 für unterschiedlichste Rechenanforderungen ausgelegt – von leichtgewichtigen Edge-Geräten bis hin zu leistungsstarken Cloud-Systemen. Das Modell ist sowohl als Open-Source- als auch als Enterprise-Version verfügbar und lässt sich so an verschiedene Anwendungsfälle anpassen.
Das Modell eignet sich hervorragend für präzisionskritische Aufgaben wie medizinische Bildgebung und die Erkennung von Satellitenbildern sowie für umfassendere Anwendungen in den Bereichen autonome Fahrzeuge, Landwirtschaft und Gesundheitswesen.

Abb. 4. Mit Ultralytics YOLO11 den Verkehr erkennen, zählen und verfolgen.
Wichtige Funktionen von Ultralytics YOLO11#
Hier sind einige weitere besondere Funktionen von Ultralytics YOLO11:
- Schnelle und effiziente Erkennung: Ultralytics YOLO11 verfügt über einen Erkennungskopf, der auf minimale Latenz ausgelegt ist. Dabei liegt der Schwerpunkt auf Geschwindigkeit in den abschließenden Vorhersageebenen, ohne die Leistung zu beeinträchtigen.
- Verbesserte Merkmalsextraktion: Eine optimierte Backbone- und Neck-Architektur verbessert die Merkmalsextraktion und ermöglicht genauere Vorhersagen.
- Plattformübergreifende Bereitstellung: Ultralytics YOLO11 ist für den effizienten Betrieb auf Edge-Geräten, Cloud-Plattformen und NVIDIA-GPUs optimiert und lässt sich dadurch an unterschiedliche Umgebungen anpassen.
YOLO-Modelle auf dem COCO-Datensatz vergleichen#
Bei der Untersuchung verschiedener Modelle ist es nicht immer einfach, sie allein anhand ihrer Funktionen zu vergleichen. Hier helfen Benchmarks. Wenn wir alle Modelle mit demselben Datensatz ausführen, können wir ihre Leistung objektiv messen und vergleichen. Sehen wir uns an, wie die einzelnen Modelle auf dem COCO-Datensatz abschneiden.
Beim Vergleich von YOLO-Modellen bringt jede neue Version deutliche Verbesserungen bei Genauigkeit, Geschwindigkeit und Flexibilität. Besonders YOLO11m macht hier einen großen Sprung: Es benötigt 22 % weniger Parameter als YOLOv8m und ist damit leichter und schneller auszuführen. Trotz seiner geringeren Größe erzielt es auf dem COCO-Datensatz außerdem eine höhere mittlere durchschnittliche Präzision (mAP). Diese Kennzahl misst, wie gut das Modell Objekte erkennt und lokalisiert. Ein höherer mAP-Wert bedeutet daher genauere Vorhersagen.
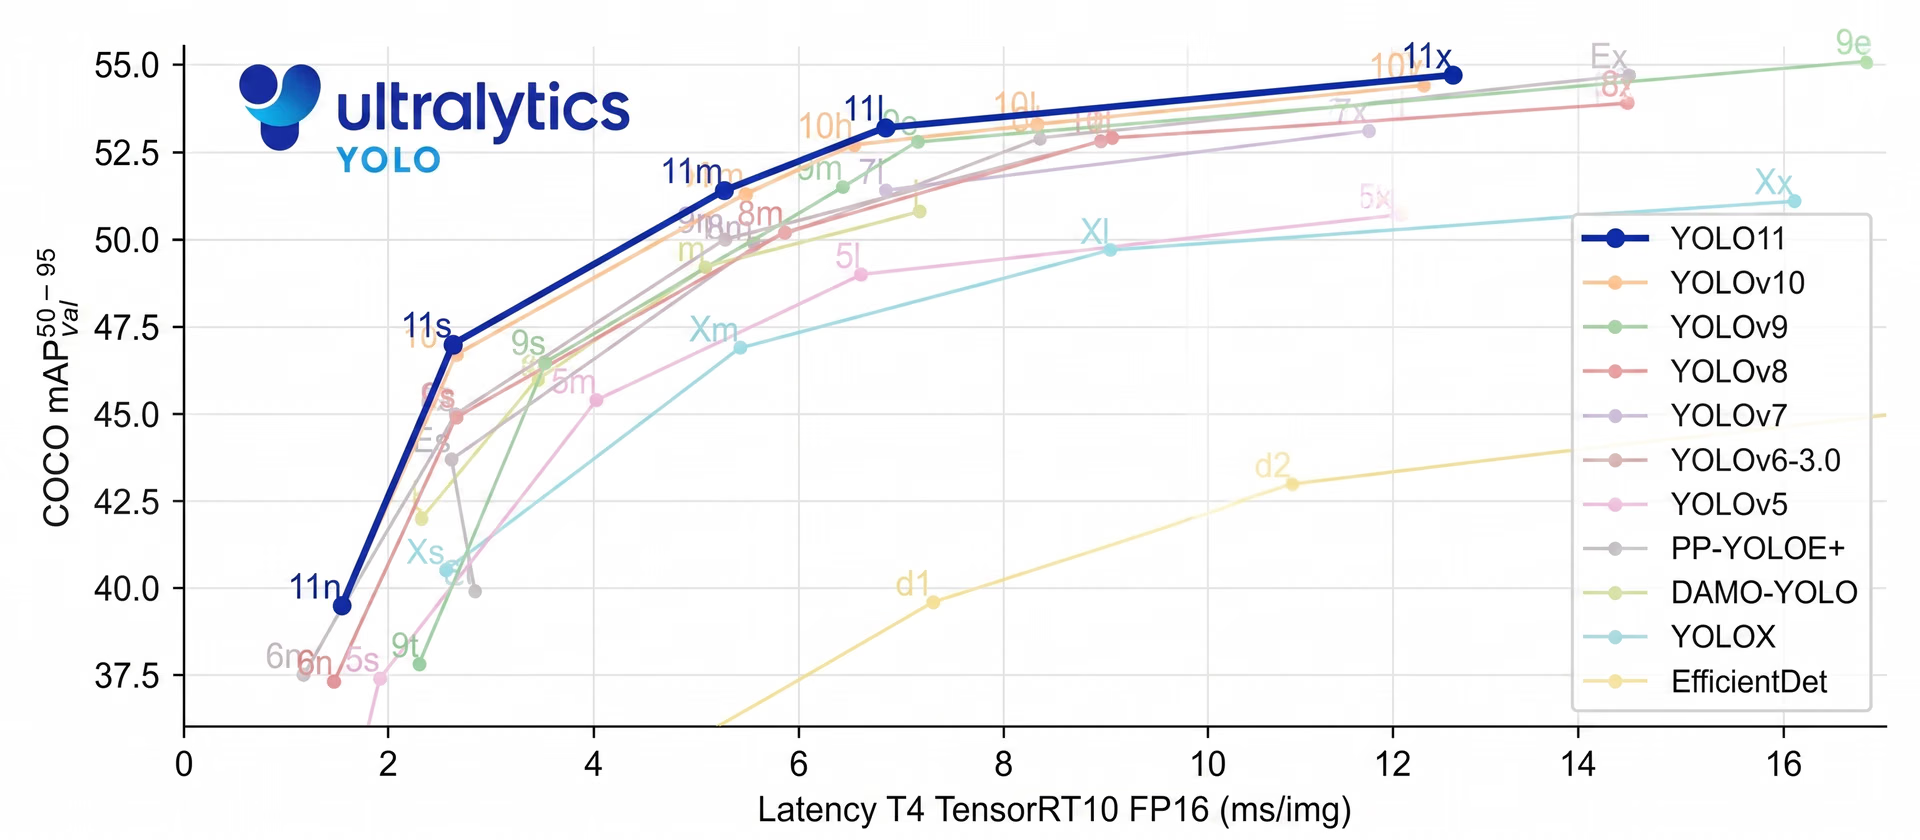
Abb. 5. Benchmark von YOLO11 und anderen YOLO-Modellen auf dem COCO-Datensatz.
YOLO-Modelle in einem Video testen und vergleichen#
Sehen wir uns an, wie sich diese Modelle in einer realen Situation bewähren.
Für den Vergleich von YOLOv8, YOLOv9, YOLOv10 und YOLO11 wurden alle vier Modelle mit einem Konfidenzwert von 0,3 auf dasselbe Verkehrsvideo angewendet. Das Modell zeigt Erkennungen nur dann an, wenn es mindestens zu 30 % sicher ist, ein Objekt korrekt erkannt zu haben. Für einen fairen Vergleich wurde eine Bildgröße von 640 verwendet. Die Ergebnisse der Objekterkennung und -verfolgung zeigten wesentliche Unterschiede bei Erkennungsgenauigkeit, Geschwindigkeit und Präzision.
Schon im ersten Bild erkannte YOLO11 große Fahrzeuge wie Lastwagen, die YOLOv10 übersah. YOLOv8 und YOLOv9 zeigten eine solide Leistung, die jedoch je nach Lichtverhältnissen und Objektgröße variierte. Kleinere, weiter entfernte Fahrzeuge blieben bei allen Modellen eine Herausforderung, wobei YOLO11 auch bei deren Erkennung deutliche Verbesserungen zeigte.

Abb. 6. Vergleich von YOLOv8, YOLOv9, YOLOv10 und YOLO11.
Bei der Geschwindigkeit lagen alle Modelle zwischen 10 und 20 Millisekunden pro Bild – schnell genug für Echtzeitaufgaben mit mehr als 50 FPS. Ultralytics YOLOv8 und YOLOv9 lieferten im gesamten Video stetige und zuverlässige Erkennungen. Interessanterweise war YOLOv10, das auf geringe Latenz ausgelegt ist, schneller, zeigte aber bei der Erkennung bestimmter Objektarten einige Unstimmigkeiten.
Ultralytics YOLO11 überzeugte dagegen durch seine Präzision und bot eine ausgewogene Kombination aus Geschwindigkeit und Genauigkeit. Keines der Modelle schnitt zwar in jedem Bild perfekt ab, doch der direkte Vergleich zeigte klar, dass YOLO11 insgesamt die beste Leistung erzielte.
Welches YOLO-Modell eignet sich am besten für Computer-Vision-Aufgaben?#
Die Wahl eines Modells für ein Projekt hängt von den konkreten Anforderungen ab. Bei manchen Anwendungen steht beispielsweise die Geschwindigkeit im Vordergrund, während andere eine höhere Genauigkeit erfordern oder durch Einsatzbedingungen eingeschränkt sind, die die Entscheidung beeinflussen.
Ein weiterer wichtiger Faktor ist die Art der Computer-Vision-Aufgaben, die du bearbeiten möchtest. Wenn du mehr Flexibilität für verschiedene Aufgaben suchst, sind YOLOv8 und YOLO11 gute Optionen.
Ob YOLOv8 oder YOLO11 besser geeignet ist, hängt ganz von deinen Anforderungen ab. YOLOv8 ist eine solide Wahl, wenn du neu im Bereich Computer Vision bist und Wert auf eine größere Community, mehr Anleitungen und umfangreiche Integrationen von Drittanbietern legst.
Wenn du hingegen eine höhere Genauigkeit und Geschwindigkeit suchst, ist Ultralytics YOLO11 die bessere Wahl. Da es sich um eine neuere Veröffentlichung handelt, hat das Modell allerdings eine kleinere Community und weniger Integrationen. Seit der Veröffentlichung dieses Vergleichs hat Ultralytics Ultralytics YOLO26 herausgebracht. Dieses Modell wird jetzt für neue Projekte empfohlen.
Die wichtigsten Erkenntnisse#
Von Ultralytics YOLOv8 bis Ultralytics YOLO11 spiegelt die Entwicklung der YOLO-Modellreihe das kontinuierliche Bestreben wider, intelligentere Computer-Vision-Modelle zu entwickeln. Jede YOLO-Version bringt sinnvolle Verbesserungen bei Geschwindigkeit, Genauigkeit und Präzision.
Mit den Fortschritten in Computer Vision bieten diese Modelle zuverlässige Lösungen für Herausforderungen in der Praxis – von der Objekterkennung bis hin zu autonomen Systemen. Die fortlaufende Entwicklung der YOLO-Modelle zeigt, wie weit das Fachgebiet bereits gekommen ist und was wir in Zukunft noch erwarten können.
In unserem GitHub-Repository erfährst du mehr über KI und kannst dich mit unserer Community austauschen. Entdecke Innovationen in verschiedenen Branchen – von Vision-KI in der Fertigung bis hin zu Computer Vision im Gesundheitswesen. Sieh dir unsere Lizenzoptionen an und starte noch heute deine Vision-KI-Projekte.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









