Die Robustheit von KI-Modellen mit Datenaugmentierung verbessern
Finde heraus, wie realistische Variationen in Trainingsdaten durch Datenaugmentierung die Robustheit von KI-Modellen und ihre Leistung in der Praxis verbessern.
 Abirami Vina9 Min. Lesezeit
Tests sind ein wichtiger Bestandteil der Entwicklung jeder technischen Lösung. Sie zeigen Teams, wie ein System tatsächlich funktioniert, bevor es in Betrieb geht, und ermöglichen es ihnen, Probleme frühzeitig zu beheben. Das gilt für viele Bereiche, darunter auch KI, denn von Modellen wird erwartet, dass sie nach der Bereitstellung mit unvorhersehbaren Bedingungen in der realen Welt zurechtkommen.
Computer Vision ist beispielsweise ein Teilgebiet der KI, das Maschinen beibringt, Bilder und Videos zu verstehen. Computer-Vision-Modelle wie Ultralytics YOLO26 unterstützen Aufgaben wie Objekterkennung, Instanzsegmentierung und Bildklassifizierung.
Sie lassen sich in vielen Branchen einsetzen, etwa zur Patientenüberwachung, Verkehrsanalyse, automatisierten Kassenabwicklung und Qualitätskontrolle in der Fertigung. Doch selbst mit fortschrittlichen Modellen und hochwertigen Trainingsdaten können KI-Lösungen zur visuellen Erkennung in der realen Welt Schwierigkeiten bekommen, etwa bei wechselnden Lichtverhältnissen, Bewegung oder teilweise verdeckten Objekten.
Das liegt daran, dass Modelle anhand der Beispiele lernen, die sie während des Trainings erhalten. Wenn sie Bedingungen wie Blendung, Bewegungsunschärfe oder eingeschränkte Sicht zuvor nicht gesehen haben, erkennen sie Objekte in solchen Situationen wahrscheinlich weniger zuverlässig.
Eine Möglichkeit, die Robustheit eines Modells zu verbessern, ist Datenerweiterung. Statt große Mengen neuer Daten zu sammeln, können Entwickler vorhandene Bilder gezielt und sinnvoll verändern – etwa die Beleuchtung anpassen, Bilder zuschneiden oder miteinander kombinieren. So lernt das Modell, dieselben Objekte in einem breiteren Spektrum von Situationen zu erkennen.
In diesem Artikel zeigen wir, wie Datenerweiterung die Robustheit von Modellen und die Zuverlässigkeit von KI-Systemen zur visuellen Erkennung verbessert, wenn sie außerhalb kontrollierter Umgebungen eingesetzt werden. Los geht’s!
So überprüfst du die Robustheit eines Modells#
Bevor wir uns mit Datenerweiterung beschäftigen, sehen wir uns an, woran du erkennst, ob ein Computer-Vision-Modell wirklich für den Einsatz in der Praxis bereit ist.
Ein robustes Modell liefert auch bei veränderten Bedingungen gute Ergebnisse, statt nur mit sauberen, perfekt beschrifteten Bildern zurechtzukommen. Bei der Bewertung der Robustheit eines KI-Modells solltest du folgende praktische Faktoren berücksichtigen:
- Veränderte Lichtverhältnisse: Bei hellem oder schwachem Licht, Blendung oder Schatten können sich Modelle unterschiedlich verhalten. Das wirkt sich darauf aus, wie sicher sie Objekte erkennen.
- Teilweise Verdeckung: In Alltagsszenen werden Objekte oft von anderen Gegenständen verdeckt oder sind nur teilweise sichtbar. Ein robusteres Modell kann sie auch dann erkennen, wenn visuelle Informationen fehlen.
- Überfüllte Szenen: Umgebungen mit vielen sich überlagernden Objekten erschweren die Erkennung. Modelle, die sich in solchen Situationen bewähren, sind in komplexen Umgebungen in der Regel zuverlässiger.
Gute Ergebnisse mit sauberen, perfekt aufgenommenen Bildern lassen sich nicht immer auf die reale Welt übertragen. Regelmäßige Tests unter unterschiedlichen Bedingungen zeigen, wie gut ein Modell nach der Bereitstellung tatsächlich funktioniert.
Was ist Datenerweiterung?#
Wie ein Objekt auf einem Foto erscheint, hängt von Beleuchtung, Blickwinkel, Entfernung und Hintergrund ab. Damit ein Computer-Vision-Modell in unvorhersehbaren Umgebungen gute Ergebnisse liefert, muss sein Trainingsdatensatz solche Variationen enthalten.
Bei der Datenerweiterung wird ein Trainingsdatensatz vergrößert, indem aus den bereits vorhandenen Bildern zusätzliche Beispiele erstellt werden. Dazu werden die Bilder gezielt verändert, etwa durch Drehen oder Spiegeln, Anpassen der Helligkeit oder Zuschneiden.
Stell dir zum Beispiel vor, du hast nur ein Foto einer Katze. Wenn du das Bild drehst oder seine Helligkeit änderst, kannst du aus diesem einen Foto mehrere neue Varianten erzeugen. Jede Variante sieht etwas anders aus, zeigt aber weiterhin dieselbe Katze. So lernt das Modell, dass ein Objekt unterschiedlich aussehen und dennoch dasselbe bleiben kann.
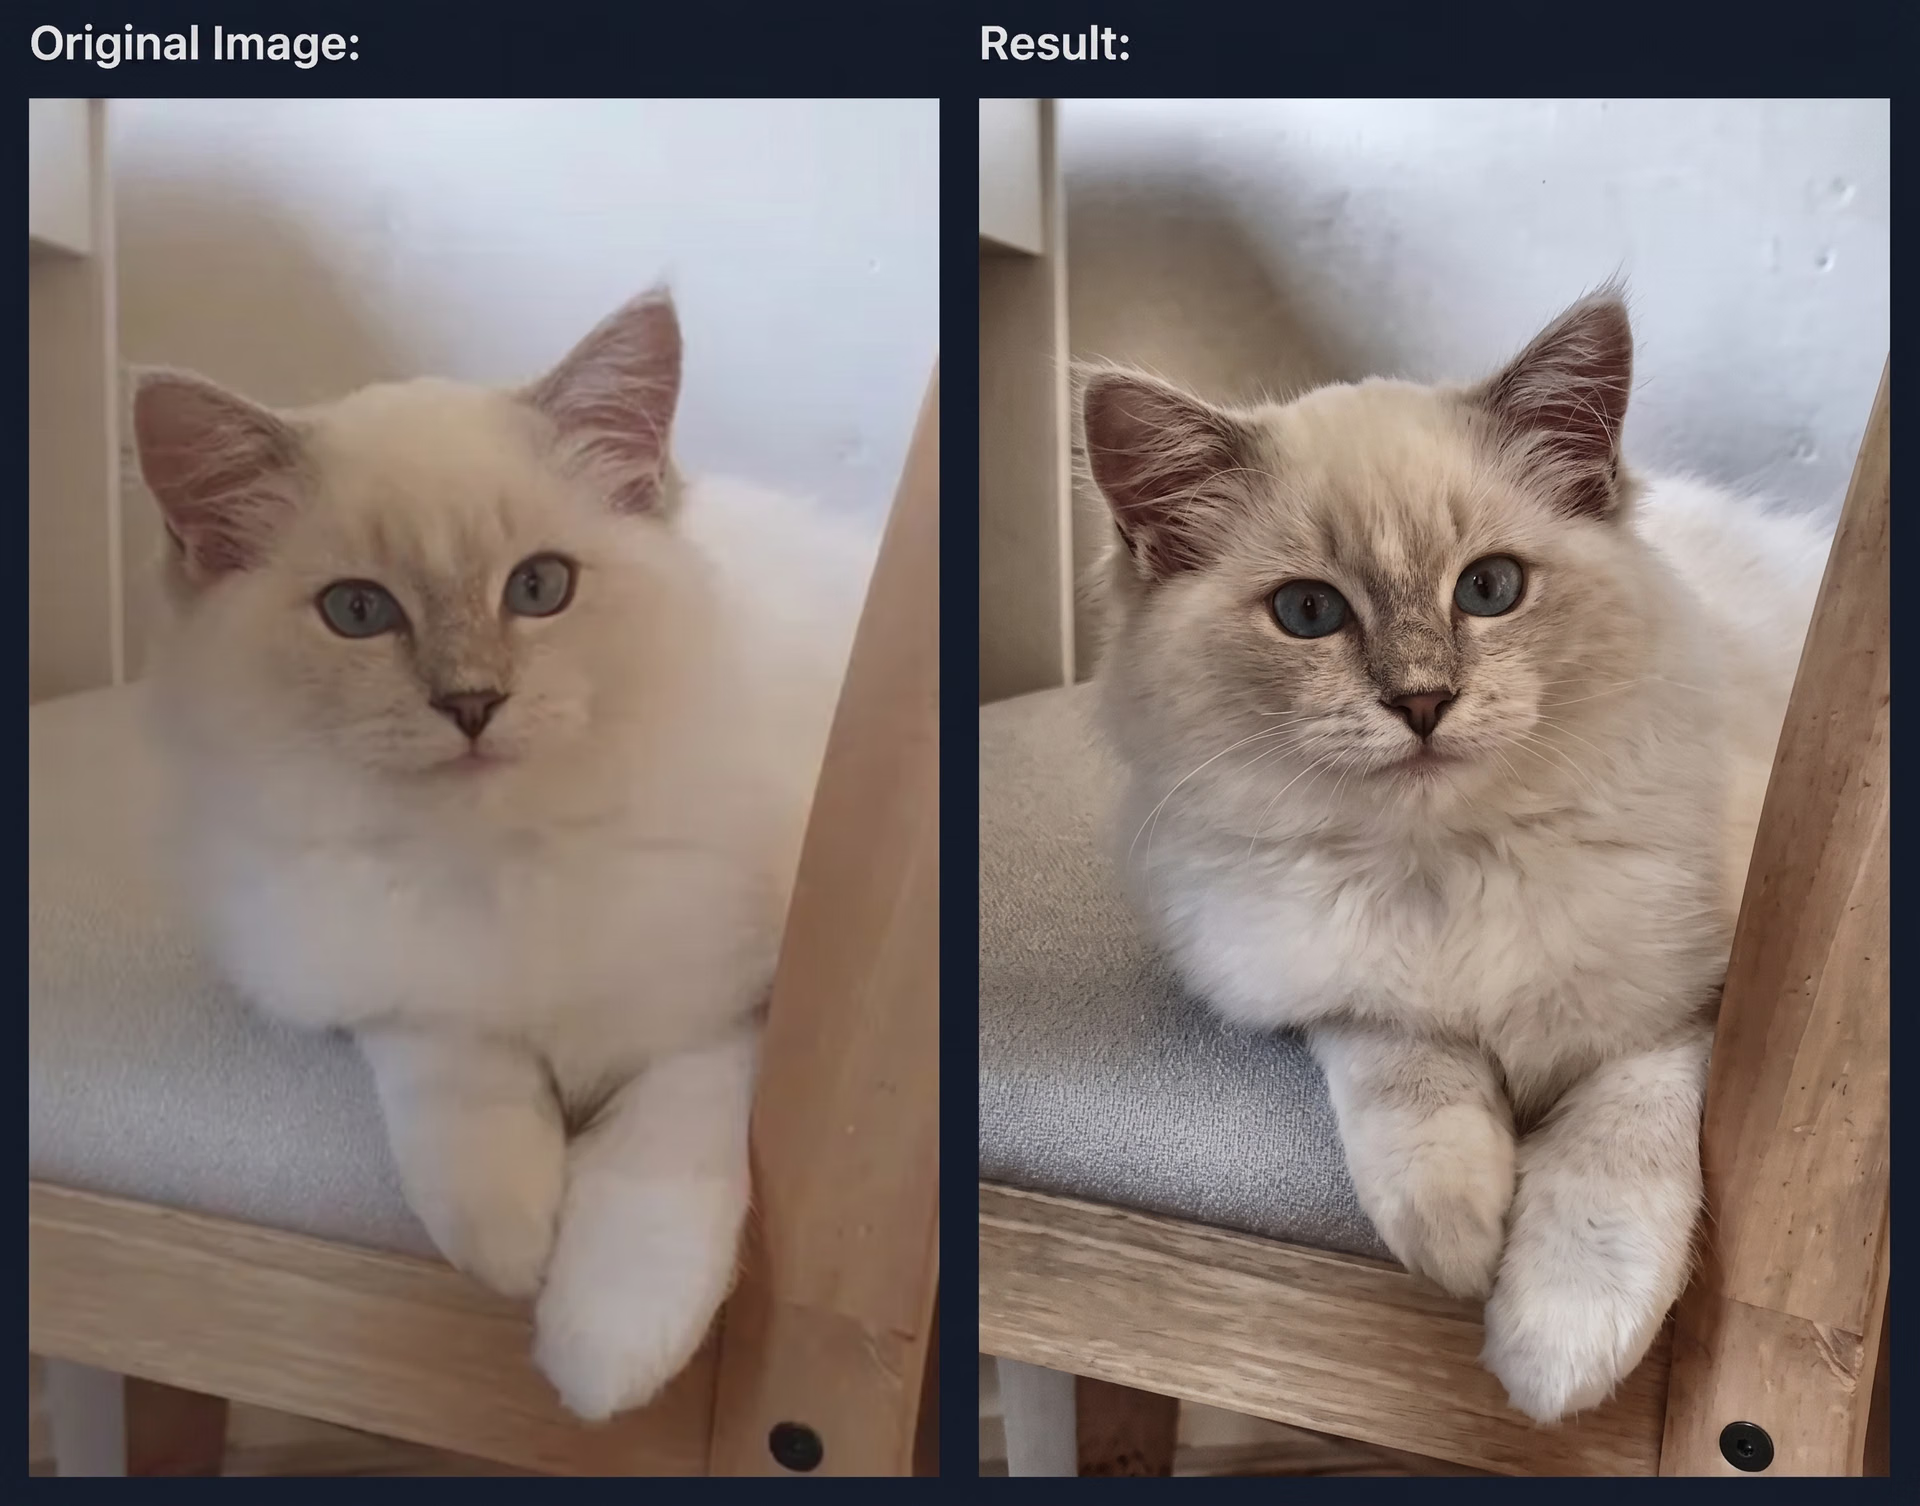
Abb. 1: Beispiel für die Erweiterung eines Katzenbildes (Quelle)
Wie Datenerweiterung die Modellleistung verbessert#
Während des Modelltrainings lässt sich die Datenerweiterung direkt in die Trainingspipeline integrieren. Statt neue Bildkopien manuell zu erstellen und zu speichern, können beim Laden jedes Bildes zufällige Transformationen angewendet werden.
Dadurch sieht das Modell jedes Mal eine leicht veränderte Version des Bildes – etwa mit höherer Helligkeit, gespiegelt oder teilweise verdeckt. Techniken wie das zufällige Löschen können sogar kleine Bildbereiche entfernen. So werden Situationen aus der realen Welt simuliert, in denen ein Objekt verdeckt oder nur teilweise sichtbar ist.
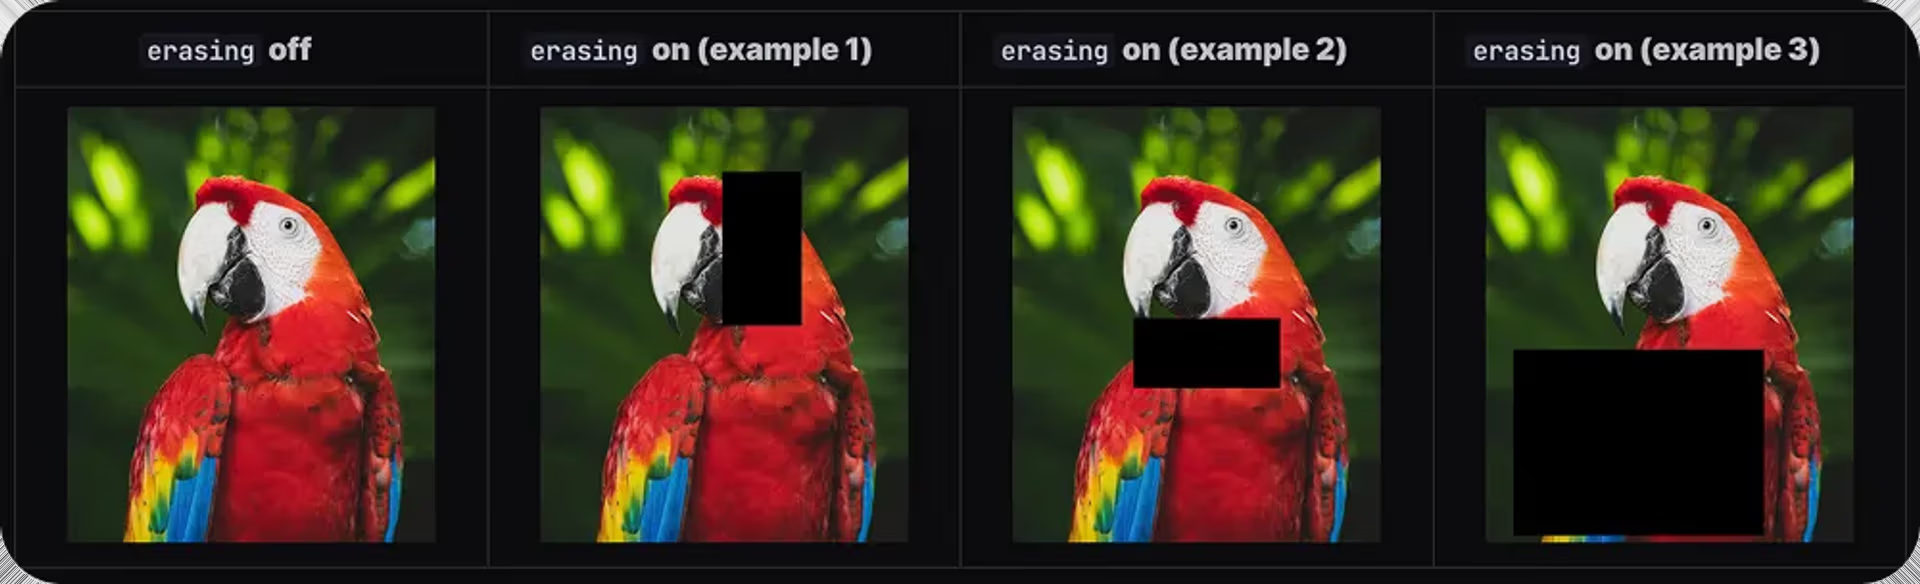
Abb. 2. Beispiele für Augmentierung durch zufälliges Löschen (Quelle)
Wenn das Modell viele verschiedene Versionen desselben Bildes sieht, kann es lernen, welche Merkmale wichtig sind, statt sich auf ein einziges perfektes Beispiel zu verlassen. Diese Vielfalt macht das KI-Modell robuster, sodass es unter realen Bedingungen zuverlässiger arbeitet.
Gängige Techniken zur Datenerweiterung#
Hier sind einige Datenerweiterungstechniken, mit denen sich die Vielfalt der Trainingsbilder erhöhen lässt:
- Geometrische Transformationen: Diese Techniken verändern die räumliche Darstellung eines Objekts in einem Bild. Durch Drehen, Spiegeln, Skalieren, Zuschneiden oder Verschieben eines Bildes kann das Modell verstehen, wie ein Objekt aus verschiedenen Winkeln oder Entfernungen aussehen kann.
- Anpassungen von Farbe und Beleuchtung: Die Beleuchtung ist in der realen Welt selten gleichmäßig. Je nach Umgebung oder verwendeter Kamera können Bilder zu hell, zu dunkel oder farblich leicht verfälscht sein. Durch Anpassungen von Helligkeit, Kontrast, Farbton und Sättigung können Modelle mit diesen visuellen Veränderungen umgehen und in unterschiedlichen Szenen gute Ergebnisse erzielen.
- Variationen der Bildqualität: Unschärfe oder Bildrauschen können Bilder undeutlich wirken lassen. Das Hinzufügen von Unschärfe oder Rauschen während des Trainings hilft dem Modell, mit Bewegungsunschärfe, Aufnahmen bei wenig Licht oder Bildern von Kameras mit geringerer Qualität zurechtzukommen. Dadurch reagiert es weniger empfindlich auf visuelle Unvollkommenheiten.
- Erweiterungen durch Verdeckung: In realen Umgebungen werden Objekte oft teilweise von anderen Objekten verdeckt. Das bezeichnet man als Verdeckung. Wenn während des Trainings kleine Bildbereiche ausgeblendet oder maskiert werden, lernt das Modell, Objekte auch dann zu erkennen, wenn nur ein Teil davon sichtbar ist.
- Augmentierungen mit mehreren Bildern: Bei diesen Techniken werden Teile mehrerer Bilder zu einem einzigen Trainingsbeispiel kombiniert. Dadurch können mehr Objekte gleichzeitig zu sehen sein und das Modell kann komplexe oder stark bevölkerte Szenen besser verarbeiten.
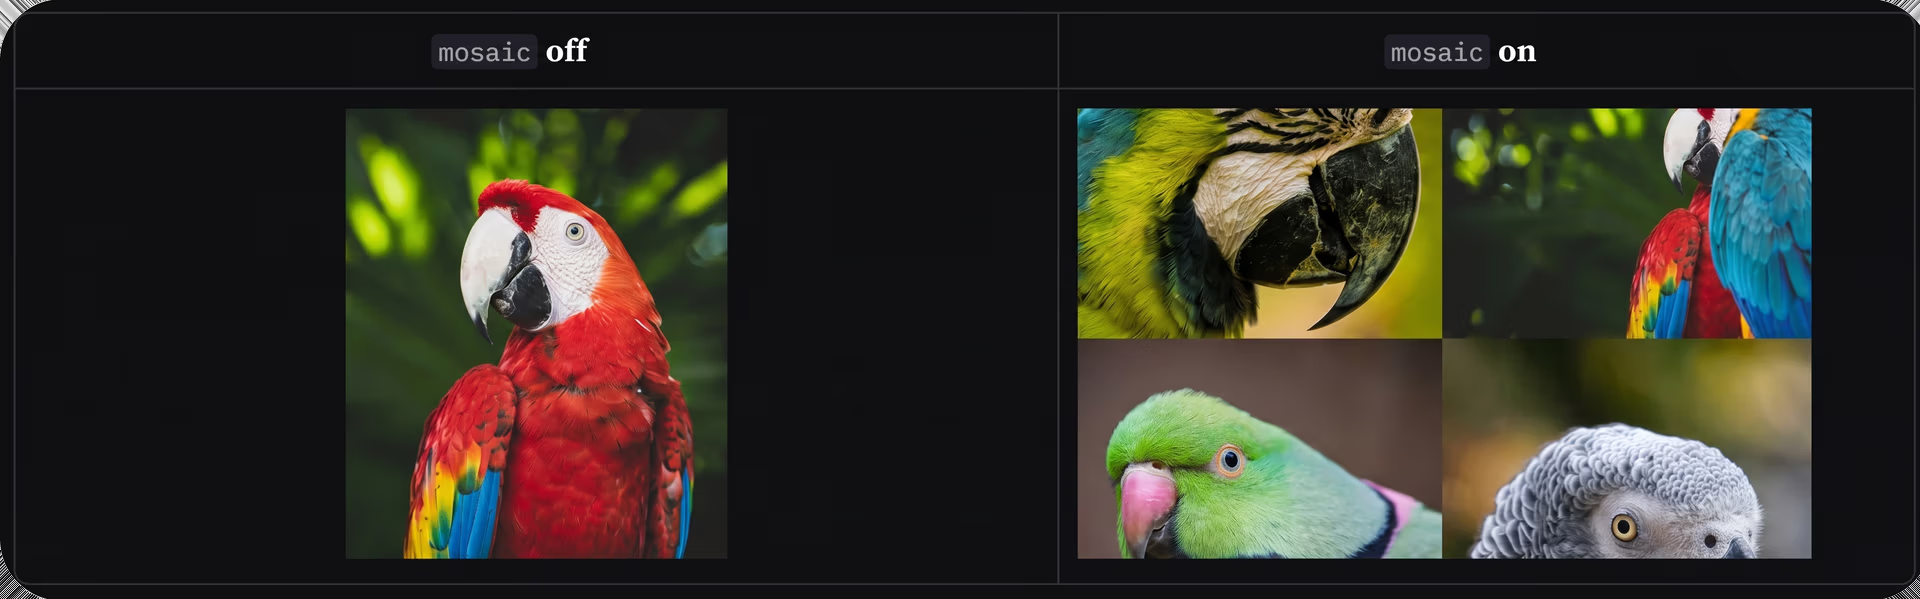
Abb. 3. Beispiel für eine Augmentierung mit mehreren Bildern (Quelle)
Datenerweiterung leicht gemacht mit dem Ultralytics Python-Paket#
Die Verwaltung von Datensätzen, das Erstellen von Bildvarianten und das Schreiben von Code für Transformationen können die Entwicklung einer Anwendung für Computer Vision um zusätzliche Schritte erweitern. Das Ultralytics Python-Paket vereinfacht diesen Prozess mit einer zentralen Schnittstelle zum Trainieren, Ausführen und Bereitstellen von Ultralytics-YOLO-Modellen wie YOLO26. Um Trainingsabläufe zu vereinfachen, enthält das Paket integrierte, von Ultralytics getestete und für YOLO-Modelle optimierte Datenerweiterungen.
Das Paket unterstützt außerdem nützliche Integrationen, sodass separate Tools oder eigener Code nicht erforderlich sind. Für die Datenerweiterung ist das Paket insbesondere mit Albumentations integriert, einer weit verbreiteten Bibliothek zur Bildaugmentierung. Dank dieser Integration können Augmentierungen während des Trainings automatisch angewendet werden, ohne dass zusätzliche Skripte oder eigener Code nötig sind.
Annotationen und erweiterte Datensätze verwalten#
Ein weiterer Faktor, der die Robustheit eines Modells beeinflusst, ist die Qualität der Annotationen. Saubere, präzise Beschriftungen, die mit Werkzeugen wie der Ultralytics Platform oder Roboflow erstellt und verwaltet werden, helfen dem Modell zu verstehen, wo sich Objekte befinden und wie sie aussehen.
Während des Trainings werden Datenerweiterungen wie Spiegelungen, Zuschnitte und Drehungen dynamisch angewendet und die Annotationen automatisch entsprechend angepasst. Wenn die Labels präzise sind, funktioniert dieser Prozess reibungslos und liefert dem Modell viele realistische Beispiele derselben Szene.
Sind Annotationen ungenau oder uneinheitlich, können sich diese Fehler in erweiterten Bildern wiederholen und das Training weniger effektiv machen. Präzise Annotationen von Anfang an verhindern, dass sich diese Fehler weiterverbreiten, und tragen zu einer höheren Robustheit des Modells bei.
Anwendungen für Vision AI mit Datenerweiterung verbessern#
Sehen wir uns nun Beispiele dafür an, wie Datenerweiterung die Robustheit von KI-Modellen in realen Anwendungen verbessert.
Die Genauigkeit der Objekterkennung in realen Umgebungen steigern#
Synthetische Bilder werden häufig zum Trainieren von Systemen zur Objekterkennung verwendet, wenn reale Daten begrenzt, sensibel oder schwer zu erfassen sind. Teams können damit schnell Beispiele für Produkte, Umgebungen und Kameraperspektiven erzeugen, ohne jedes Szenario in der realen Welt aufnehmen zu müssen.
Synthetische Datensätze können im Vergleich zu Aufnahmen aus der realen Welt jedoch manchmal zu sauber wirken. In der Realität verändert sich die Beleuchtung, Objekte überlagern sich und Szenen enthalten störende Hintergrundelemente. Datenerweiterung hilft, diese Lücke zu schließen, indem sie realistische Variationen wie unterschiedliche Beleuchtung, Rauschen oder Objektpositionen einbringt. So lernt das Modell, mit den Bedingungen umzugehen, denen es im Einsatz begegnet.
In einer aktuellen Studie wurde beispielsweise ein Ultralytics-YOLO11-Modell ausschließlich mit synthetischen Bildern trainiert und durch Datenerweiterung um zusätzliche Variationen ergänzt. Dadurch lernte das Modell, Objekte allgemeiner zu erkennen. Bei Tests mit realen Bildern schnitt es gut ab, obwohl es während des Trainings keine realen Daten gesehen hatte.
Bildgebende medizinische Verfahren zuverlässiger machen#
Datensätze aus der medizinischen Bildgebung sind oft begrenzt und die Aufnahmen selbst können je nach Gerätetyp, Einstellungen oder klinischer Umgebung variieren. Unterschiede in der Anatomie der Patientinnen und Patienten, bei Blickwinkeln, Beleuchtung oder Bildrauschen können es Computer-Vision-Modellen erschweren, Muster zu lernen, die sich gut auf verschiedene Patientinnen und Patienten sowie Krankenhäuser übertragen lassen.
Datenerweiterung hilft, diesem Problem zu begegnen, indem während des Trainings mehrere Varianten derselben Aufnahme erstellt werden, etwa durch das Hinzufügen von Rauschen, leichtes Verschieben des Bildes oder kleine Verzerrungen. Dadurch werden die Trainingsdaten repräsentativer für reale klinische Bedingungen.
In einer Studie zur pädiatrischen Bildgebung verwendeten Forschende beispielsweise Ultralytics YOLO11 zur anatomischen Segmentierung und trainierten das Modell mit erweiterten medizinischen Daten. Sie fügten Rauschen hinzu, verschoben die Position leicht und nahmen kleine Verzerrungen vor, um die Bilder realistischer zu machen.
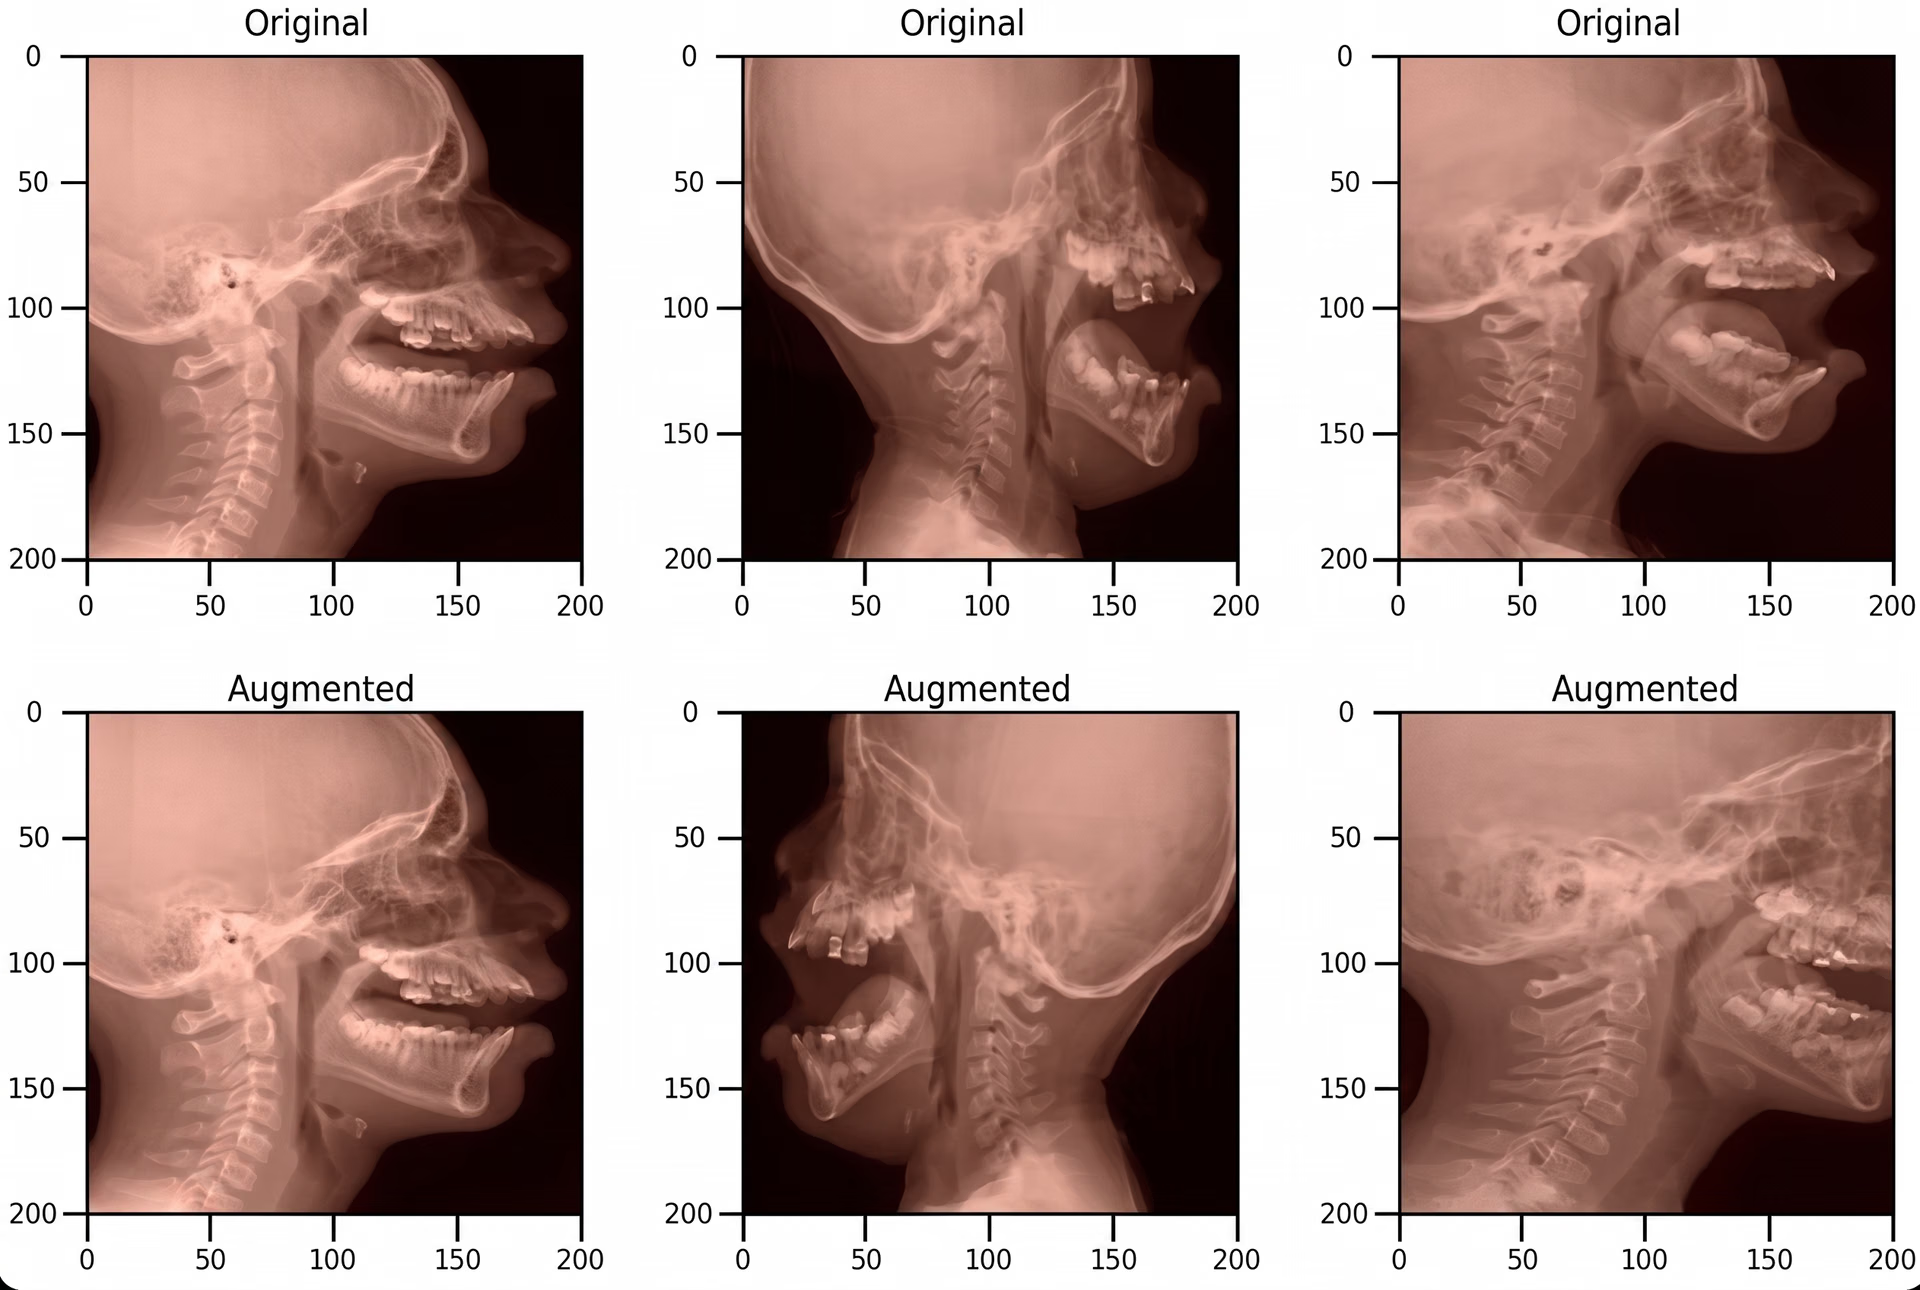
Abb. 4. Originale und augmentierte medizinische Aufnahmen von Kindern (Quelle)
Indem das Modell aus diesen Variationen lernte, konzentrierte es sich auf wichtige anatomische Merkmale statt auf oberflächliche Unterschiede. Dadurch waren die Segmentierungsergebnisse bei verschiedenen Aufnahmen und Patientenfällen stabiler.
Die wichtigsten Erkenntnisse#
Vielfältige Daten zu sammeln ist schwierig, doch durch Datenerweiterung können Modelle aus einem breiteren Spektrum visueller Bedingungen lernen. Dadurch wird das Modell robuster im Umgang mit Verdeckungen, Beleuchtungsänderungen und stark bevölkerten Szenen. Insgesamt hilft das dabei, außerhalb kontrollierter Trainingsumgebungen zuverlässiger zu arbeiten.
Werde Teil unserer Community und entdecke die neuesten Entwicklungen im Bereich Vision AI in unserem GitHub-Repository. Auf unseren Lösungsseiten erfährst du, wie Anwendungen wie KI in der Fertigung und Computer Vision im Gesundheitswesen Fortschritte ermöglichen. Sieh dir außerdem unsere Lizenzoptionen an, um deine nächste KI-Lösung umzusetzen.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









