Der umfassende Leitfaden zur Datenerweiterung im Jahr 2025
Erfahre, wie die Erweiterung von Bilddaten Vision-AI-Modellen beim Lernen hilft, die Genauigkeit verbessert und die Leistung in realen Situationen steigert.
Durch den KI-Boom machen Phänomene wie Roboter in Fabriken und selbstfahrende Autos auf Straßen immer häufiger Schlagzeilen. KI verändert die Art und Weise, wie Maschinen mit der Welt interagieren – von der Verbesserung medizinischer Bildgebung bis hin zur Unterstützung der Qualitätskontrolle in Produktionslinien.
Ein großer Teil dieser Fortschritte ist der Computer Vision zu verdanken, einem Bereich der KI, der es Maschinen ermöglicht, Bilder zu verstehen und zu interpretieren. So wie Menschen mit der Zeit lernen, Objekte und Muster zu erkennen, müssen Vision-AI-Modelle wie Ultralytics YOLO11 mit großen Mengen an Bilddaten trainiert werden, um ihr visuelles Verständnis zu entwickeln.
Es ist jedoch nicht immer einfach, so große Mengen visueller Daten zu sammeln. Obwohl die Computer-Vision-Community viele umfangreiche Datensätze erstellt hat, können darin bestimmte Variationen fehlen – etwa Bilder mit Objekten bei schlechten Lichtverhältnissen, teilweise verdeckten Gegenständen oder Objekten aus unterschiedlichen Blickwinkeln. Solche Abweichungen können Computer-Vision-Modelle verwirren, die nur unter bestimmten Bedingungen trainiert wurden.
Die Datenerweiterung für Bilder löst dieses Problem, indem sie bestehende Daten um neue Variationen ergänzt. Durch Änderungen an Bildern, etwa durch Anpassung der Farben, Drehung oder Perspektivverschiebung, wird der Datensatz vielfältiger. So können Vision-AI-Modelle Objekte in realen Situationen besser erkennen.
In diesem Artikel sehen wir uns an, wie die Datenerweiterung für Bilder funktioniert und welche Auswirkungen sie auf Computer-Vision-Anwendungen haben kann.
Was ist Datenerweiterung für Bilder?#
Stell dir vor, du versuchst, einen Freund in einer Menschenmenge zu erkennen, aber er trägt eine Sonnenbrille oder steht an einem schattigen Ort. Trotz dieser kleinen Veränderungen im Aussehen weißt du weiterhin, wer er ist. Ein Vision-AI-Modell kann dagegen mit solchen Variationen Schwierigkeiten haben, wenn es nicht darauf trainiert wurde, Objekte in unterschiedlichen Umgebungen zu erkennen.
Die Datenerweiterung für Bilder verbessert die Leistung von Computer-Vision-Modellen, indem sie veränderte Versionen vorhandener Bilder zu den Trainingsdaten hinzufügt, statt Tausende neuer Bilder zu sammeln.
Veränderungen an Bildern wie Spiegeln, Drehen, Anpassen der Helligkeit oder Hinzufügen kleiner Verzerrungen setzen Vision-AI-Modelle einer größeren Bandbreite von Bedingungen aus. Statt auf riesige Datensätze angewiesen zu sein, können Modelle mit kleineren Trainingsdatensätzen und erweiterten Bildern effizient lernen.
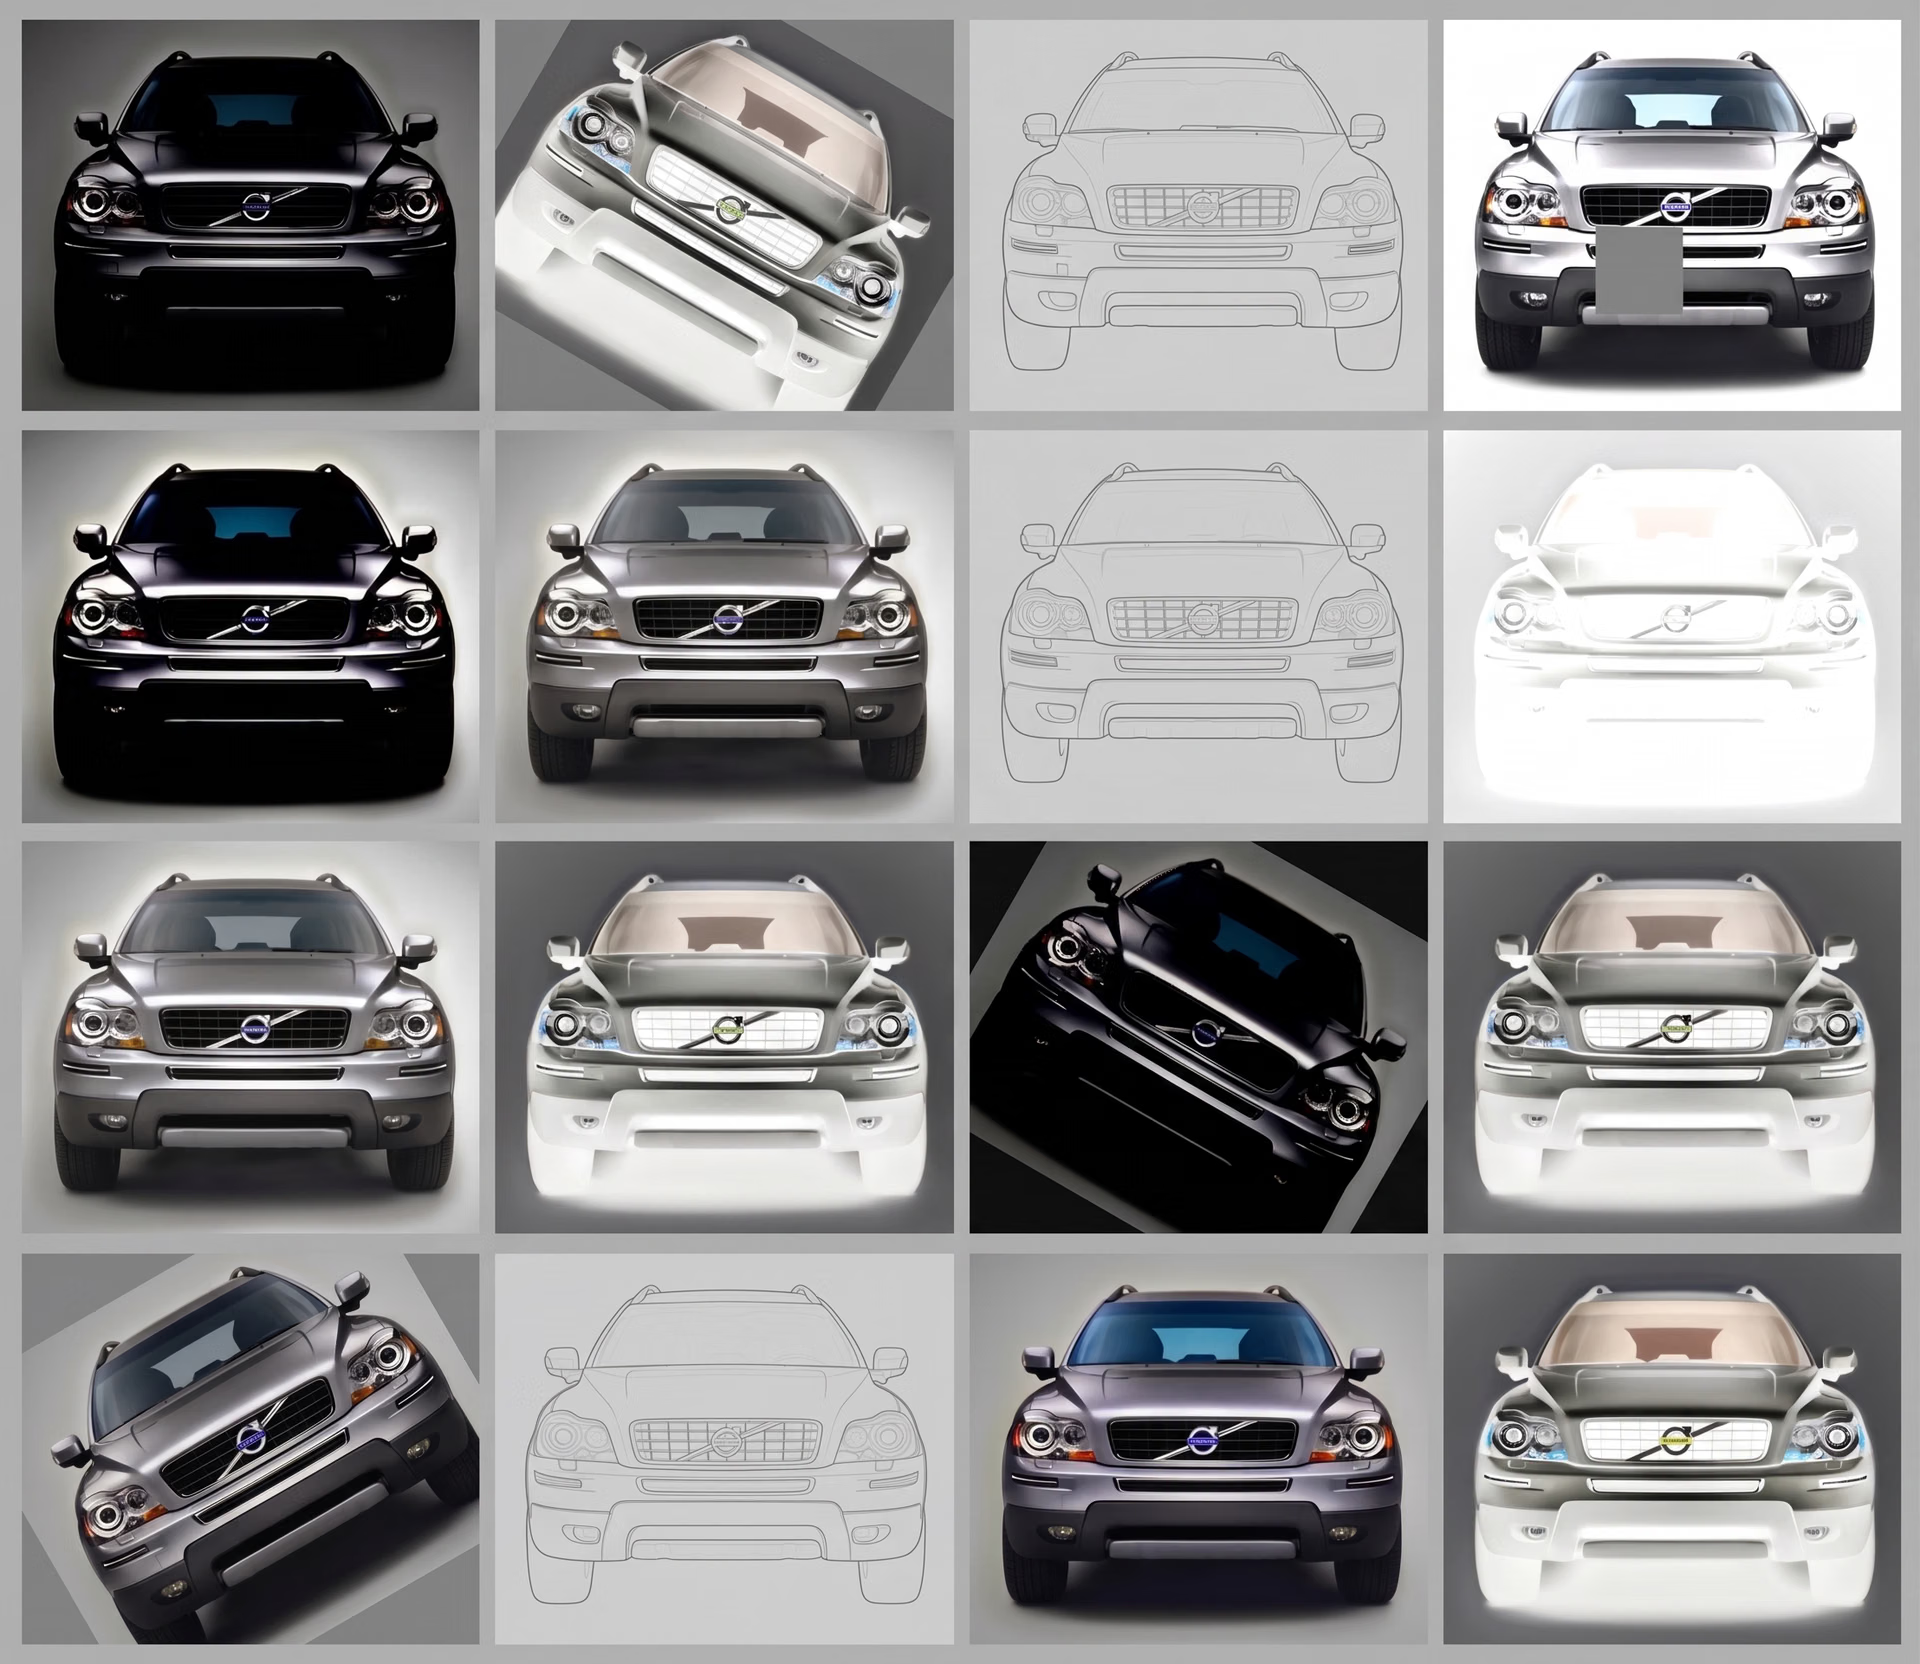
Abb. 1. Beispiele für erweiterte Autobilder.
Die Bedeutung der Datenerweiterung für Bilder in der Computer Vision#
Hier sind einige wichtige Gründe, warum Datenerweiterung für Computer Vision unverzichtbar ist:
- Reduziert den Datenbedarf: Das Sammeln umfangreicher Bilddatensätze erfordert Zeit und Ressourcen. Durch Datenerweiterung lassen sich Modelle effektiv trainieren, ohne riesige Datensätze zu benötigen.
- Verhindert Überanpassung: Ein Modell, das mit zu wenigen Beispielen trainiert wurde, kann sich Details einprägen, statt allgemeine Muster zu erkennen. Durch mehr Vielfalt bei der Datenerweiterung lernen Vision-AI-Modelle so, dass sie das Gelernte auch auf neue und unbekannte Daten anwenden können.
- Simuliert unvollkommene Bilder: Bilder in Datensätzen sind oft zu perfekt, während Fotos aus der realen Welt unscharf, verdeckt oder verzerrt sein können. Werden Bilder durch Rauschen, Verdeckungen oder andere Variationen erweitert, wirken sie realistischer.
- Erhöht die Robustheit von Modellen: Das Training mit vielfältigen Bildern hilft KI-Systemen, mit Veränderungen in der realen Welt umzugehen. Dadurch werden sie in unterschiedlichen Umgebungen, bei verschiedenen Lichtverhältnissen und in verschiedenen Situationen zuverlässiger.
Wann solltest du die Datenerweiterung für Bilder einsetzen?#
Die Datenerweiterung für Bilder ist besonders hilfreich, wenn ein Computer-Vision-Modell Objekte in unterschiedlichen Situationen erkennen muss, dafür aber nicht genügend vielfältige Bilder zur Verfügung stehen.
Wenn Forschende beispielsweise ein Vision-AI-Modell darauf trainieren, seltene Unterwasserarten zu erkennen, die nur selten fotografiert werden, ist der Datensatz möglicherweise klein oder wenig vielfältig. Durch die Erweiterung der Bilder – etwa indem Farben angepasst werden, um unterschiedliche Wassertiefen zu simulieren, Rauschen trübe Bedingungen nachahmt oder Formen leicht verändert werden, um natürliche Bewegungen abzubilden – kann das Modell Unterwasserobjekte genauer erkennen.
Hier sind weitere Situationen, in denen Datenerweiterung einen großen Unterschied macht:
- Ausgleichen des Datensatzes: Manche Objekte kommen in den Trainingsdaten seltener vor, was Vision-AI-Modelle verzerren kann. Durch Datenerweiterung lassen sich mehr Beispiele seltener Objekte erzeugen, damit das Modell alle Kategorien gleichermaßen gut erkennt.
- Anpassung an verschiedene Kameras: Je nach Gerät können Bilder unterschiedlich aussehen. Durch Datenerweiterung funktionieren Vision-AI-Modelle auch mit Fotos unterschiedlicher Auflösung, Beleuchtung und Qualität zuverlässig.
- Korrektur kleiner Kennzeichnungsfehler: Leichte Verschiebungen, Zuschnitte oder Drehungen helfen Computer-Vision-Modellen, Objekte richtig zu erkennen, selbst wenn die ursprünglichen Labels nicht perfekt ausgerichtet sind.
So funktioniert die Datenerweiterung für Bilder#
In den Anfangstagen der Computer Vision umfasste die Datenerweiterung für Bilder vor allem grundlegende Bildverarbeitung, etwa Spiegeln, Drehen und Zuschneiden, um die Vielfalt des Datensatzes zu erhöhen. Mit den Fortschritten der KI kamen fortschrittlichere Methoden hinzu, etwa die Anpassung von Farben (Farbraumtransformationen), das Schärfen oder Weichzeichnen von Bildern (Kernel-Filter) und das Überblenden mehrerer Bilder (Bildmischung), um den Lernprozess zu verbessern.
Die Datenerweiterung kann vor und während des Modelltrainings erfolgen. Vor dem Training lassen sich veränderte Bilder zum Datensatz hinzufügen, um mehr Vielfalt zu schaffen. Während des Trainings können Bilder in Echtzeit zufällig verändert werden, sodass sich Vision-AI-Modelle an unterschiedliche Bedingungen anpassen.
Diese Änderungen erfolgen mithilfe mathematischer Transformationen. Eine Drehung kippt beispielsweise ein Bild, beim Zuschneiden werden Teile entfernt, um unterschiedliche Ansichten nachzuahmen, und Helligkeitsänderungen simulieren variierende Lichtverhältnisse. Weichzeichnen lässt Bilder verschwommener wirken, Schärfen hebt Details deutlicher hervor und Bildmischung kombiniert Teile verschiedener Bilder. Vision-AI-Frameworks und Werkzeuge wie OpenCV, TensorFlow und PyTorch können diese Prozesse automatisieren und so eine schnelle und wirksame Datenerweiterung ermöglichen.
Wichtige Techniken zur Datenerweiterung für Bilder#
Nachdem wir nun besprochen haben, was Datenerweiterung für Bilder bedeutet, sehen wir uns einige grundlegende Techniken an, mit denen Trainingsdaten verbessert werden.
Ausrichtung und Position anpassen#
Computer-Vision-Modelle wie YOLO11 müssen Objekte häufig aus verschiedenen Winkeln und Perspektiven erkennen. Dazu können Bilder horizontal oder vertikal gespiegelt werden, damit das KI-Modell lernt, Objekte aus unterschiedlichen Blickwinkeln zu erkennen.
Auch eine leichte Drehung der Bilder verändert ihren Winkel, sodass das Modell Objekte aus mehreren Perspektiven erkennen kann. Durch Verschieben der Bilder in verschiedene Richtungen (Translation) lernen Modelle außerdem, kleine Positionsänderungen auszugleichen. Diese Transformationen sorgen dafür, dass Modelle besser auf reale Bedingungen generalisieren, in denen die Platzierung von Objekten im Bild unvorhersehbar ist.
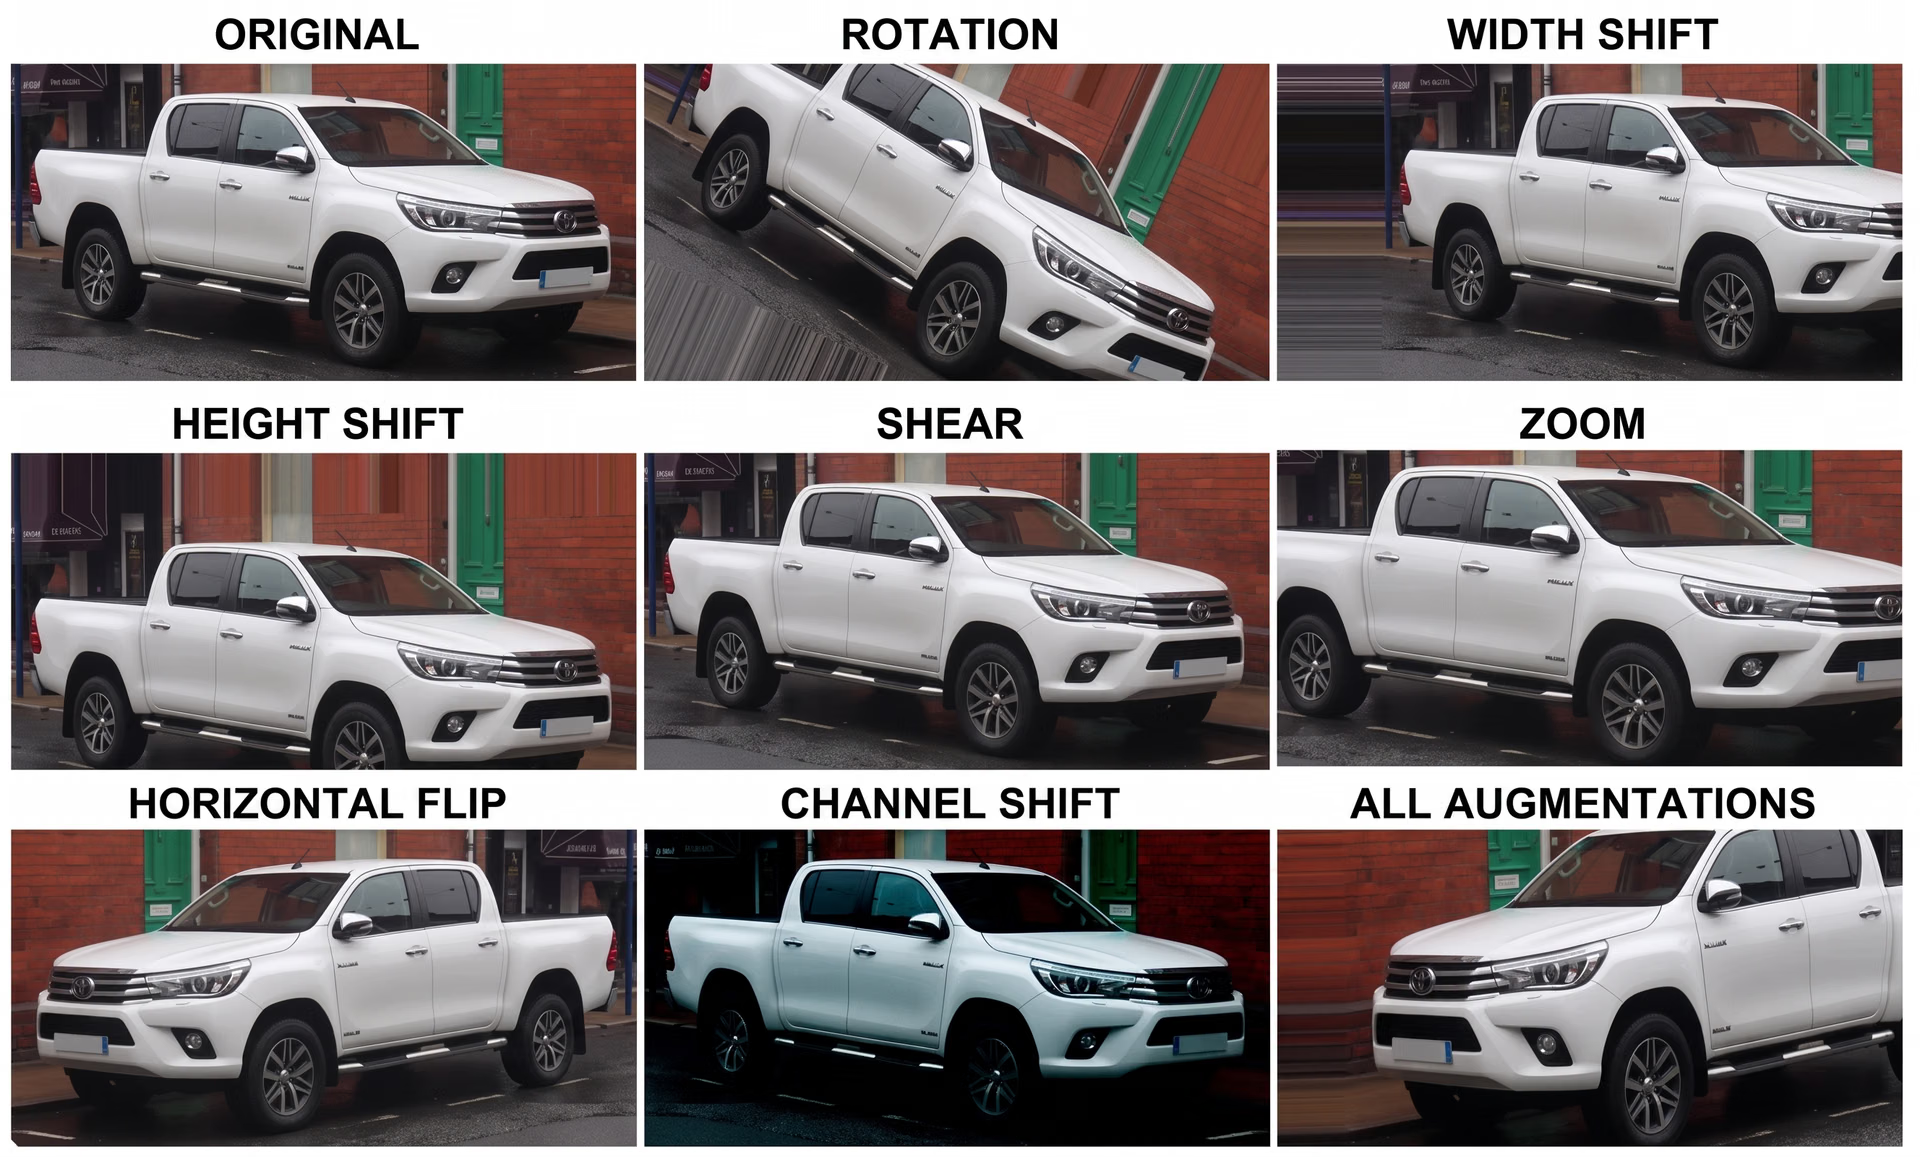
Abb. 2. Verschiedene Methoden zur Erweiterung von Ausrichtung und Position.
Größe ändern und zuschneiden#
Bei realen Computer-Vision-Lösungen können Objekte in Bildern in unterschiedlichen Entfernungen und Größen erscheinen. Bildverarbeitungsmodelle müssen robust genug sein, um sie unabhängig von diesen Unterschieden zu erkennen.
Zur Verbesserung der Anpassungsfähigkeit können die folgenden Augmentierungsmethoden eingesetzt werden:
- Skalierung: Durch Ändern der Größe wird das Bild unter Beibehaltung seiner Proportionen vergrößert oder verkleinert. So können KI-Modelle Objekte in unterschiedlichen Entfernungen erkennen.
- Zuschneiden: Dabei werden überflüssige Bildbereiche entfernt, damit sich das Modell auf wichtige Bereiche konzentrieren kann und weniger durch den Hintergrund abgelenkt wird.
- Scherung: Durch leichtes Verzerren eines Bildes entsteht der Eindruck, es sei geneigt oder gestreckt. So kann die KI Objekte aus verschiedenen Blickwinkeln erkennen.
Diese Anpassungen helfen Computer-Vision-Modellen, Objekte auch dann zu erkennen, wenn sich deren Größe oder Form geringfügig ändert.
Anpassungen von Perspektive und Verzerrung#
Objekte in Bildern können je nach Kamerawinkel unterschiedlich aussehen, was ihre Erkennung für Computer-Vision-Modelle erschwert. Damit Modelle mit diesen Abweichungen umgehen können, passen Augmentierungstechniken die Darstellung von Objekten in Bildern an.
Perspektivische Transformationen können beispielsweise den Blickwinkel verändern, sodass ein Objekt aussieht, als würde es aus einer anderen Position betrachtet. Dadurch können Bildverarbeitungsmodelle Objekte auch dann erkennen, wenn sie geneigt sind oder aus einem ungewöhnlichen Blickwinkel aufgenommen wurden.
Ein weiteres Beispiel ist eine elastische Transformation, die Bilder streckt, biegt oder verformt, um natürliche Verzerrungen nachzuahmen. Dadurch erscheinen Objekte so, wie sie in Spiegelungen oder unter Druck aussehen würden.
Farb- und Beleuchtungsanpassungen#
Beleuchtungsverhältnisse und Farbunterschiede können die Interpretation von Bildern durch Bildverarbeitungsmodelle erheblich beeinflussen. Da Objekte bei unterschiedlichen Lichtverhältnissen verschieden aussehen können, helfen die folgenden Augmentierungstechniken, mit diesen Situationen umzugehen:
- Anpassungen von Helligkeit und Kontrast: Durch die Simulation verschiedener Lichtverhältnisse können Bildverarbeitungsmodelle Objekte sowohl in hellen als auch in dunklen Umgebungen erkennen.
- Farbvariation: Die zufällige Änderung von Farbton, Sättigung und Farbbalance macht Computer-Vision-Modelle anpassungsfähiger an verschiedene Kameras und Lichtverhältnisse.
- Umwandlung in Graustufen: Durch die Umwandlung von Bildern in Schwarz-Weiß konzentrieren sich Bildverarbeitungsmodelle stärker auf Formen und Texturen statt auf Farben.
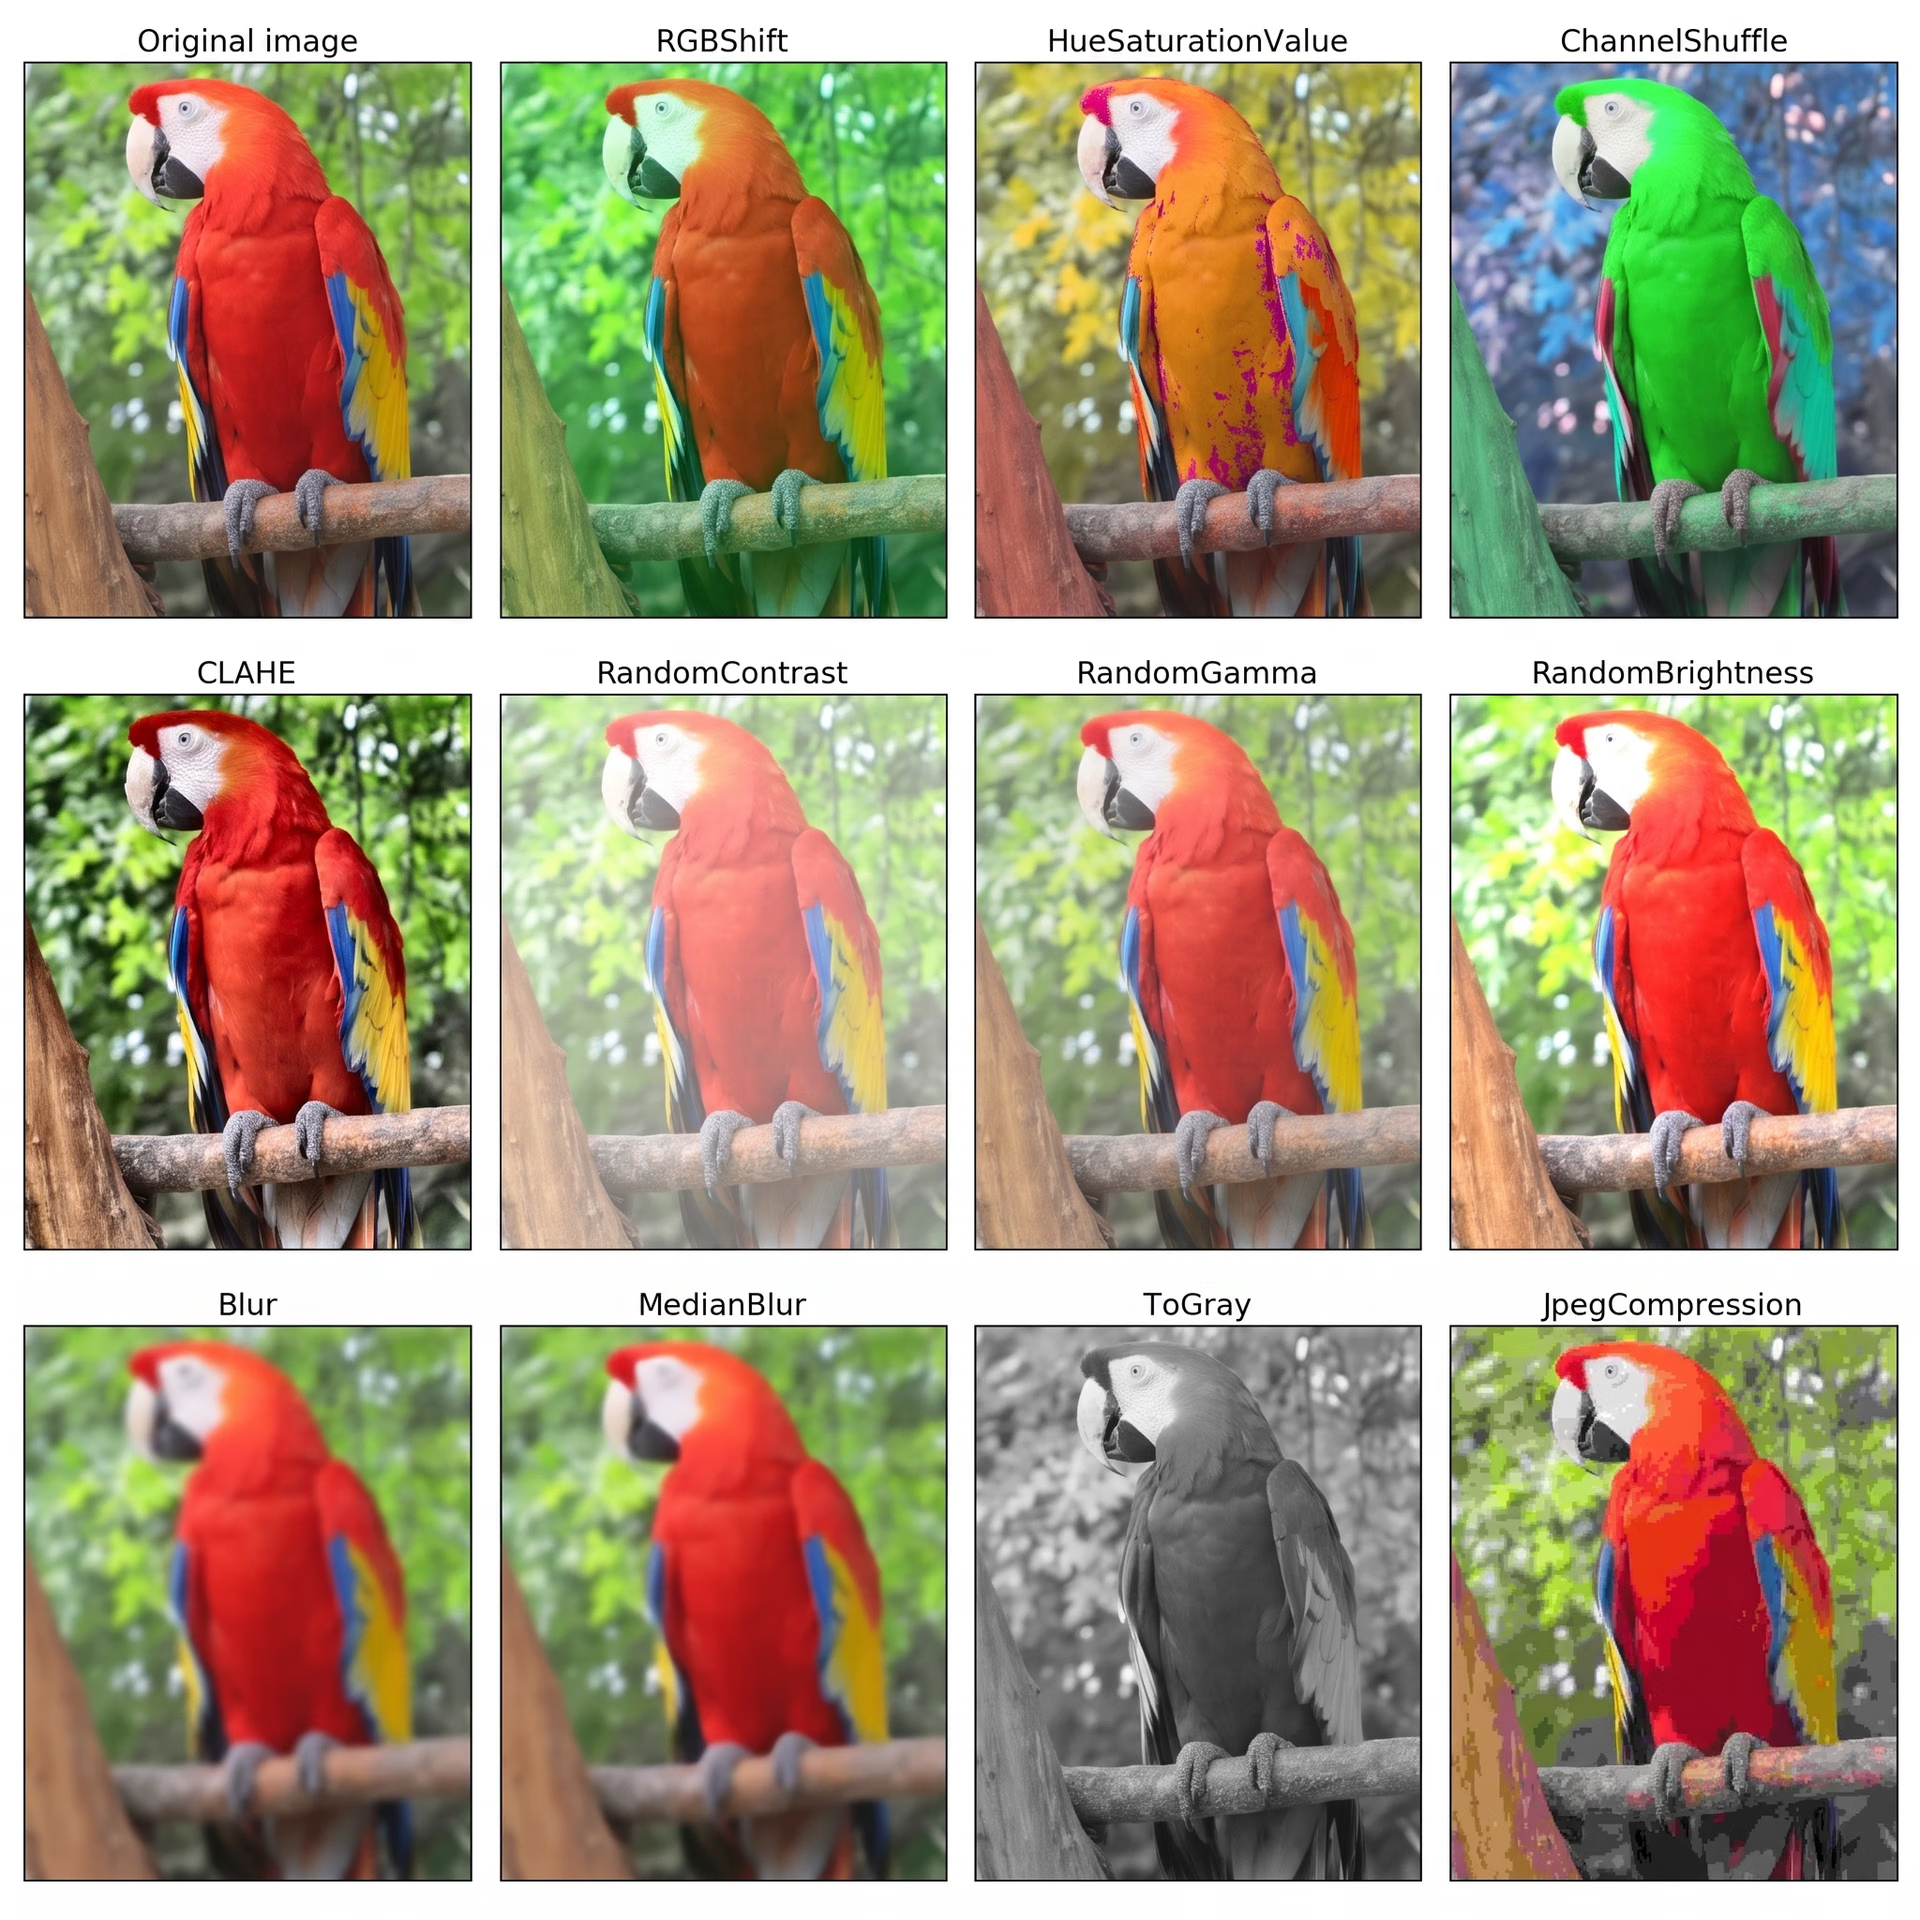
Abb. 3 Beispiele für Augmentierungen mit unterschiedlichen Farbvariationen.
Fortgeschrittene Techniken zur Bilddatenaugmentation#
Bisher haben wir nur Augmentierungstechniken betrachtet, die ein einzelnes Bild verändern. Einige fortgeschrittene Methoden kombinieren jedoch mehrere Bilder, um das Lernen der KI zu verbessern.
MixUp überlagert beispielsweise zwei Bilder und hilft Computer-Vision-Modellen so, Beziehungen zwischen Objekten zu verstehen und besser auf verschiedene Szenarien zu verallgemeinern. CutMix geht noch einen Schritt weiter: Dabei wird ein Bildbereich durch einen Ausschnitt aus einem anderen Bild ersetzt, sodass Modelle aus mehreren Kontexten innerhalb desselben Bildes lernen können. CutOut funktioniert anders und entfernt zufällige Bildbereiche. Dadurch lernen Bildverarbeitungsmodelle, Objekte auch dann zu erkennen, wenn sie teilweise verdeckt oder verborgen sind.
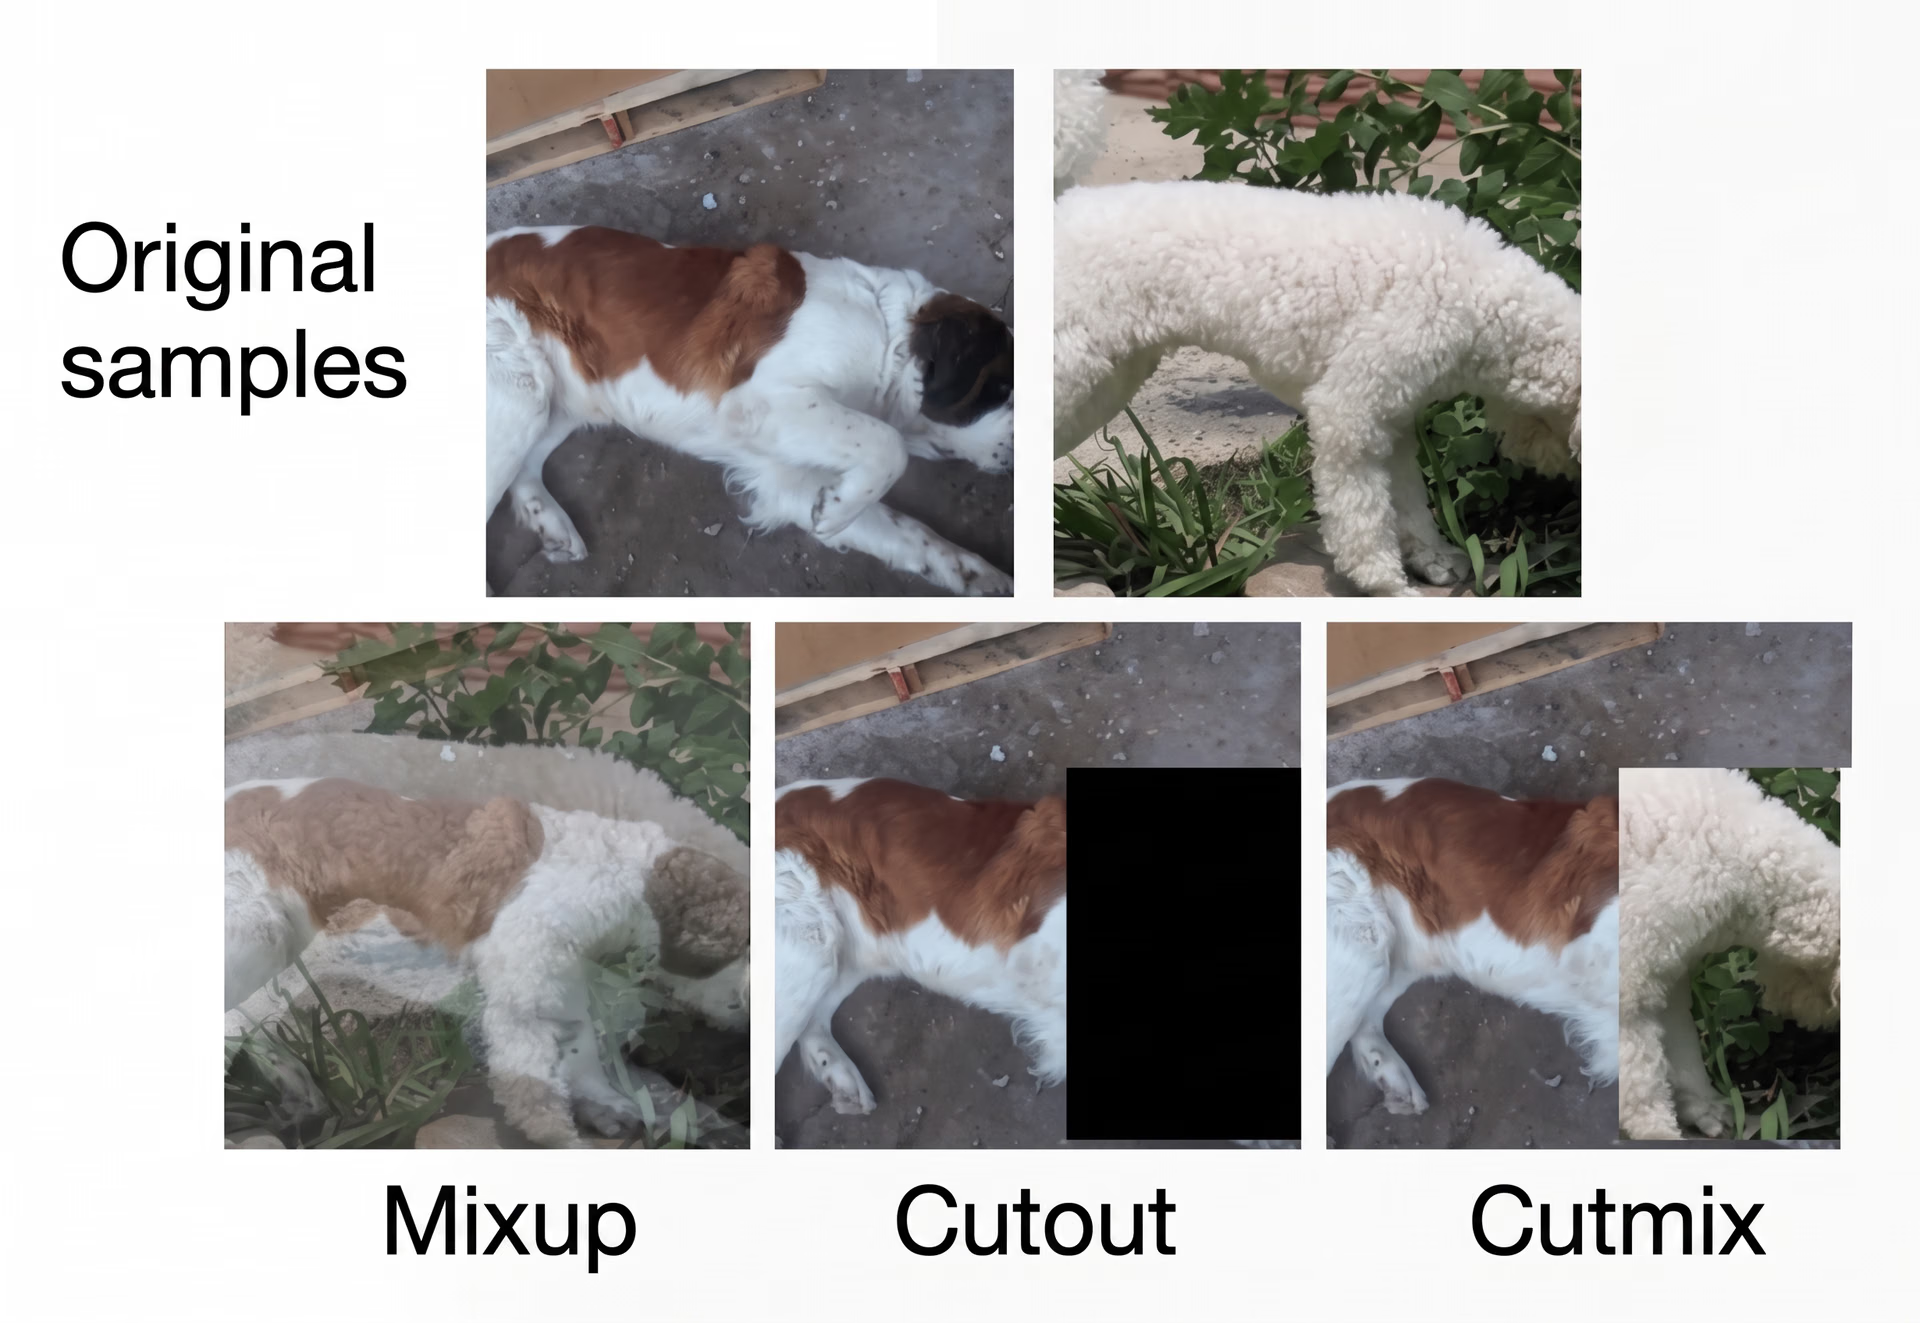
Abb. 4 Fortgeschrittene Techniken zur Bilddatenaugmentation.
Die Rolle generativer KI bei der Bilddatenaugmentation#
Generative KI gewinnt in vielen Branchen und alltäglichen Anwendungen zunehmend an Bedeutung. Wahrscheinlich bist du ihr bereits im Zusammenhang mit KI-generierten Bildern, Deepfake-Videos oder Apps begegnet, die realistische Avatare erstellen. Generative KI dient jedoch nicht nur der Kreativität und Unterhaltung, sondern spielt auch eine wichtige Rolle beim Trainieren von Bildverarbeitungsmodellen, indem sie aus vorhandenen Bildern neue erzeugt.
Statt Bilder einfach nur zu spiegeln oder zu drehen, kann sie realistische Variationen erstellen – etwa durch veränderte Gesichtsausdrücke oder Kleidung oder durch die Simulation unterschiedlicher Wetterbedingungen. Diese Variationen helfen Computer-Vision-Modellen, sich besser anzupassen und in vielfältigen realen Szenarien genauere Ergebnisse zu erzielen. Fortgeschrittene generative KI-Modelle wie GANs (Generative Adversarial Networks) und Diffusionsmodelle können außerdem fehlende Details ergänzen oder hochwertige synthetische Bilder erzeugen.
Einschränkungen der Bilddatenaugmentation#
Datenaugmentation verbessert zwar Trainingsdatensätze, doch es gibt auch einige Einschränkungen, die du beachten solltest. Hier sind einige wichtige Herausforderungen der Bilddatenaugmentation:
- Begrenzte Datenvielfalt: Augmentierte Bilder basieren auf vorhandenen Daten und können keine völlig neuen Muster oder seltenen Perspektiven hinzufügen.
- Mögliche Datenverzerrung: Zu starke Transformationen können Bilder unrealistisch wirken lassen und dadurch die Modellgenauigkeit in realen Szenarien verringern.
- Höherer Rechenaufwand: Echtzeit-Augmentierung während des Modelltrainings kann viel Rechenleistung erfordern, das Training verlangsamen und den Speicherbedarf erhöhen.
- Klassenungleichgewicht bleibt bestehen: Durch Augmentierung entstehen keine vollständig neuen Stichproben. Daher können unterrepräsentierte Kategorien weiterhin zu verzerrtem Lernen führen.
Ein praktischer Anwendungsfall für Bilddatenaugmentation#
Ein interessantes Anwendungsgebiet der Bilddatenaugmentation sind selbstfahrende Autos, bei denen Entscheidungen in Sekundenbruchteilen durch Computer-Vision-Modelle wie Ultralytics YOLO11 entscheidend sind. Das Modell muss Straßen, Menschen und andere Objekte zuverlässig erkennen können.
Die realen Bedingungen, denen ein autonomes Fahrzeug begegnet, sind jedoch unvorhersehbar. Schlechtes Wetter, Bewegungsunschärfe und verdeckte Schilder können Bildverarbeitungslösungen in diesem Bereich vor komplexe Herausforderungen stellen. Computer-Vision-Modelle ausschließlich mit realen Bildern zu trainieren, reicht oft nicht aus. Bilddatensätze für Modelle in selbstfahrenden Autos müssen vielfältig sein, damit die Modelle den Umgang mit unerwarteten Situationen lernen können.
Bilddatenaugmentation löst dieses Problem, indem sie Nebel simuliert, die Helligkeit anpasst und Formen verzerrt. Diese Änderungen helfen Modellen, Objekte unter verschiedenen Bedingungen zu erkennen. Dadurch werden Modelle leistungsfähiger und zuverlässiger.
Mit augmentierten Trainingsdaten passen sich Bildverarbeitungslösungen für selbstfahrende Autos besser an und treffen sicherere Entscheidungen. Genauere Ergebnisse bedeuten weniger Unfälle und eine bessere Navigation.
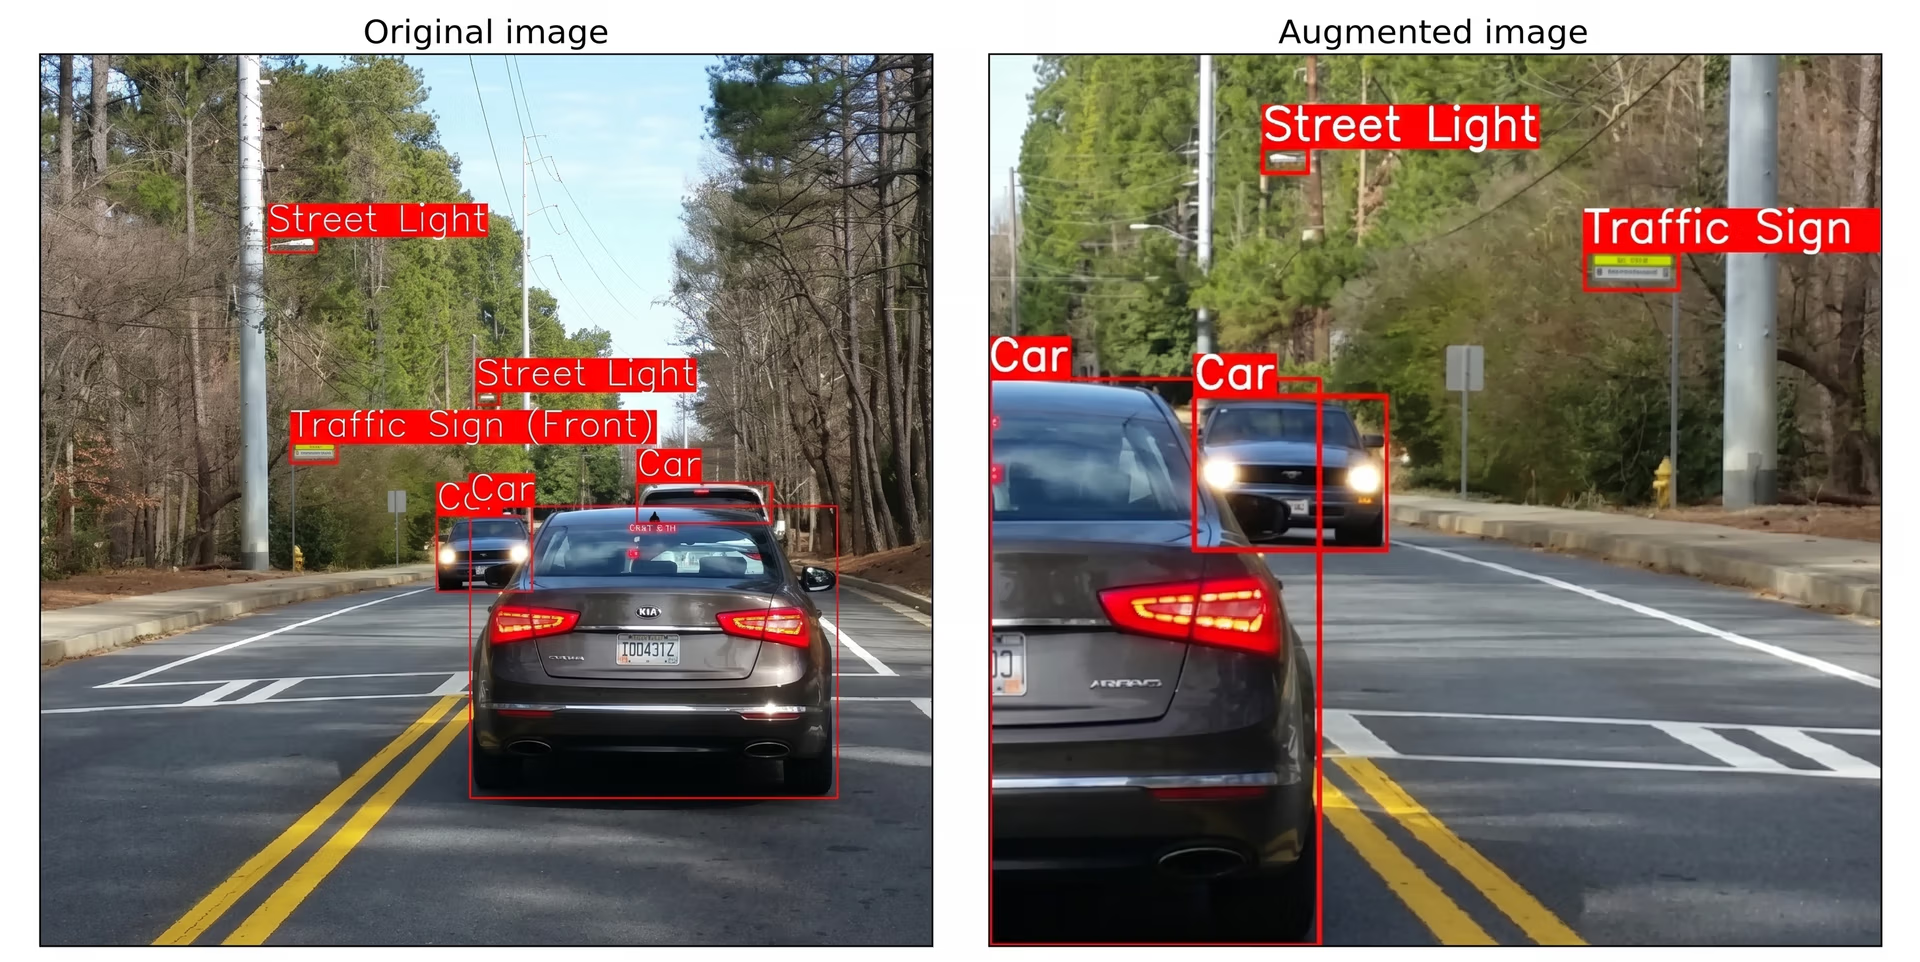
Abb. 5 Ein Beispiel für Bilddatenaugmentation bei selbstfahrenden Autos.
Selbstfahrende Autos sind nur ein Beispiel. Tatsächlich ist Bilddatenaugmentation in vielen Bereichen wichtig, von der medizinischen Bildgebung bis zur Einzelhandelsanalyse. Jede Anwendung, die auf Computer Vision basiert, kann von Bilddatenaugmentation profitieren.
Die wichtigsten Erkenntnisse#
Bildverarbeitungssysteme müssen Objekte unter unterschiedlichen Bedingungen erkennen können. Es kann jedoch schwierig sein, unbegrenzt viele reale Bilder für das Training zu sammeln. Bilddatenaugmentation löst dieses Problem, indem sie Variationen vorhandener Bilder erzeugt. So lernen Modelle schneller und leisten in realen Situationen bessere Arbeit. Sie verbessert die Genauigkeit und stellt sicher, dass Bildverarbeitungsmodelle wie Ultralytics YOLO11 mit unterschiedlichen Lichtverhältnissen, Blickwinkeln und Umgebungen umgehen können.
Für Unternehmen und Entwickler spart Bilddatenaugmentation Zeit und Aufwand und macht Computer-Vision-Modelle zugleich zuverlässiger. Viele Branchen, vom Gesundheitswesen bis zu selbstfahrenden Autos, sind darauf angewiesen. Mit der Weiterentwicklung der Bildverarbeitung wird Augmentierung auch künftig ein wesentlicher Bestandteil sein, um intelligentere und anpassungsfähigere Modelle zu entwickeln.
Werde Teil unserer Community und besuche unser GitHub-Repository, um KI in Aktion zu erleben. Informiere dich über unsere Lizenzoptionen und erfahre auf unseren Lösungsseiten mehr über KI in der Landwirtschaft und Computer Vision in der Fertigung.








