Was sind Diffusionsmodelle? Ein kurzer und umfassender Leitfaden
Entdecke mit uns, wie sich Diffusionsmodelle zur Erstellung realistischer Inhalte einsetzen lassen und mit vielfältigen Anwendungen Bereiche wie Design, Musik und Film neu definieren.
Der Einsatz von generativen KI-Tools wie Midjourney und Sora zur Erstellung von Inhalten wird immer häufiger, und das Interesse daran, hinter die Kulissen dieser Tools zu schauen, wächst. Eine aktuelle Studie zeigt sogar, dass 94 % der Menschen bereit sind, neue Fähigkeiten zu erlernen, um mit generativer KI zu arbeiten. Wenn du verstehst, wie generative KI-Modelle funktionieren, kannst du diese Tools effektiver nutzen und mehr aus ihnen herausholen.
Im Kern von Tools wie Midjourney und Sora stehen fortschrittliche Diffusionsmodelle – generative KI-Modelle, die Bilder, Videos, Texte und Audio für verschiedene Anwendungen erstellen können. Diffusionsmodelle eignen sich beispielsweise hervorragend für kurze Marketingvideos für soziale Plattformen wie TikTok und YouTube Shorts. In diesem Artikel erfährst du, wie Diffusionsmodelle funktionieren und wofür sie eingesetzt werden können. Los geht’s!
Die Inspiration hinter fortschrittlichen Diffusionsmodellen#
In der Physik bezeichnet Diffusion den Prozess, bei dem sich Moleküle von Bereichen mit höherer Konzentration in Bereiche mit niedrigerer Konzentration ausbreiten. Das Konzept der Diffusion hängt eng mit der Brownschen Bewegung zusammen. Dabei bewegen sich Teilchen zufällig, während sie mit Molekülen in einer Flüssigkeit zusammenstoßen, und breiten sich allmählich im Laufe der Zeit aus.
Diese Konzepte inspirierten die Entwicklung von Diffusionsmodellen in der generativen KI. Diffusionsmodelle fügen Daten schrittweise Rauschen hinzu und lernen anschließend, diesen Vorgang umzukehren, um neue, hochwertige Daten wie Texte, Bilder oder Klänge zu erzeugen. Das ähnelt der Idee der umgekehrten Diffusion in der Physik. Theoretisch lässt sich Diffusion rückwärts verfolgen, um Teilchen in ihren ursprünglichen Zustand zurückzuversetzen. Ebenso lernen Diffusionsmodelle, das hinzugefügte Rauschen umzukehren, um aus verrauschten Eingaben realistische neue Daten zu erzeugen.
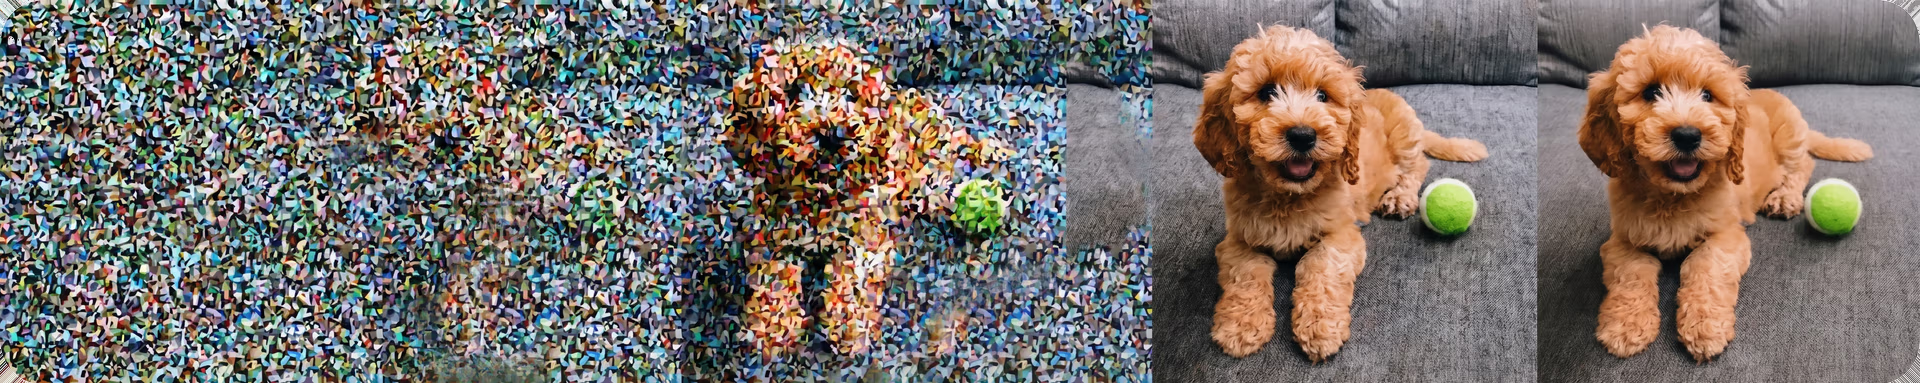
Ein Blick hinter die Kulissen von Diffusionsmodellen#
Im Allgemeinen umfasst die Architektur eines Diffusionsmodells zwei wesentliche Schritte. Zunächst lernt das Modell, dem Datensatz schrittweise Rauschen hinzuzufügen. Anschließend wird es darauf trainiert, diesen Vorgang umzukehren und die Daten in ihren ursprünglichen Zustand zurückzuführen. Sehen wir uns genauer an, wie das funktioniert.
Datenvorverarbeitung#
Bevor wir uns mit dem Kern eines Diffusionsmodells befassen, solltest du daran denken, dass alle Daten, mit denen das Modell trainiert wird, vorverarbeitet werden müssen. Wenn du beispielsweise ein Diffusionsmodell zur Bilderzeugung trainierst, muss der Bilddatensatz für das Training zunächst bereinigt werden. Bei der Vorverarbeitung von Bilddaten können Ausreißer entfernt werden, die die Ergebnisse beeinflussen könnten. Außerdem lassen sich Pixelwerte normalisieren, damit alle Bilder denselben Wertebereich haben, und durch Datenerweiterung lässt sich für mehr Vielfalt sorgen. Schritte zur Datenvorverarbeitung tragen zur Qualität der Trainingsdaten bei – und das gilt nicht nur für Diffusionsmodelle, sondern für jedes KI-Modell.
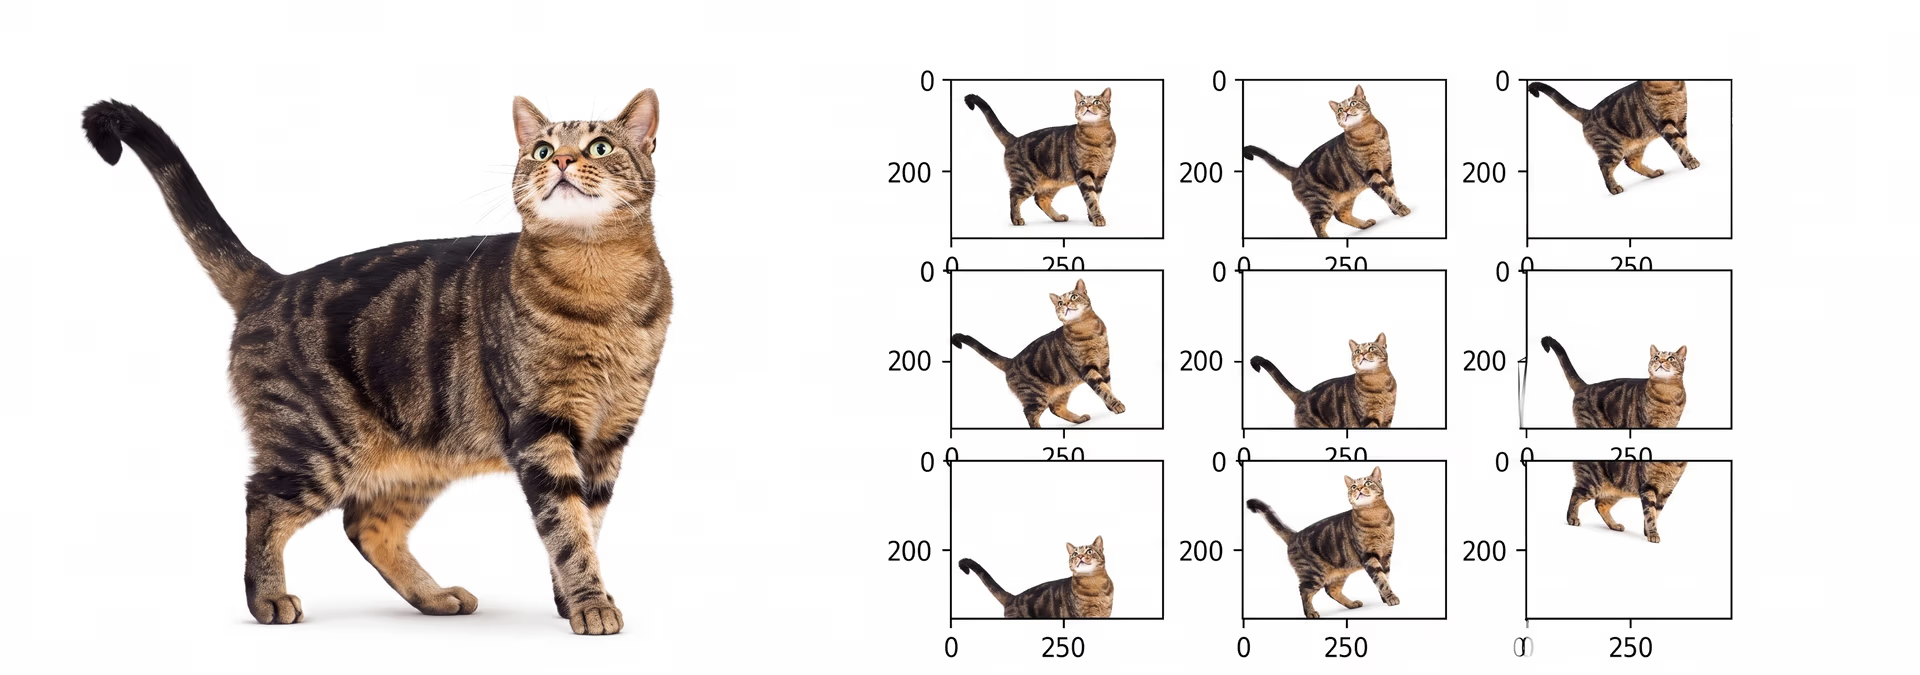
Abb. 2. Beispiele für die Datenerweiterung von Bildern.
Vorwärts gerichteter Diffusionsprozess#
Nach der Datenvorverarbeitung folgt der vorwärts gerichtete Diffusionsprozess. Betrachten wir das Training eines Diffusionsmodells zur Bilderzeugung. Der Prozess beginnt mit einer Stichprobe aus einer einfachen Verteilung, beispielsweise einer Gauß-Verteilung. Mit anderen Worten: Es wird zufälliges Rauschen ausgewählt. Wie in der folgenden Abbildung zu sehen ist, verändert das Modell das Bild schrittweise in einer Reihe von Schritten. Anfangs ist das Bild klar, doch mit jedem Schritt wird es zunehmend verrauschter, bis es am Ende fast nur noch aus Rauschen besteht.
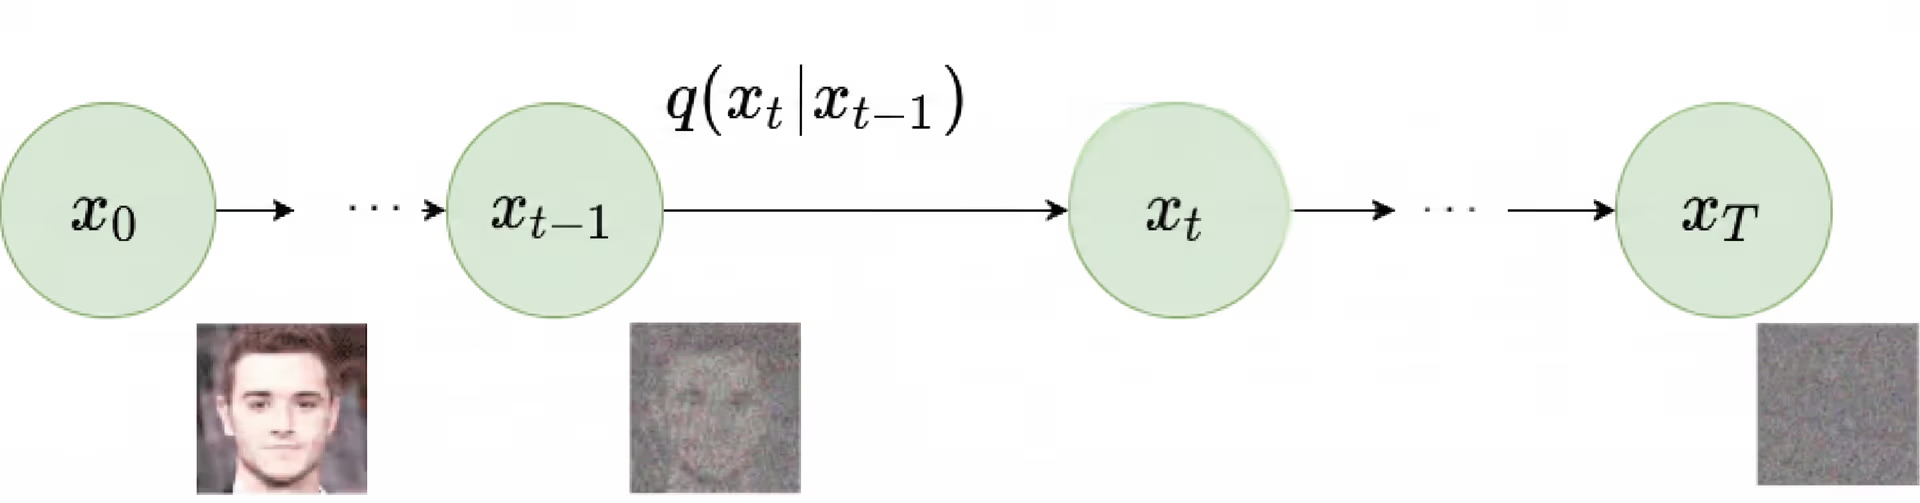
Abb. 3. Vorwärts gerichteter Diffusionsprozess.
Jeder Schritt baut auf dem vorherigen auf, und mithilfe einer Markov-Kette wird kontrolliert und schrittweise Rauschen hinzugefügt. Eine Markov-Kette ist ein mathematisches Modell, bei dem die Wahrscheinlichkeit des nächsten Zustands nur vom aktuellen Zustand abhängt. Sie dient dazu, anhand der gegenwärtigen Bedingungen zukünftige Ergebnisse vorherzusagen. Da jeder Schritt die Daten komplexer macht, können wir auch die feinsten Muster und Details der ursprünglichen Bilddatenverteilung erfassen. Durch das Hinzufügen von Gaußschem Rauschen entstehen außerdem vielfältige und realistische Stichproben, während der Diffusionsprozess abläuft.
Umgekehrter Diffusionsprozess#
Der umgekehrte Diffusionsprozess beginnt, sobald der vorwärts gerichtete Diffusionsprozess eine Stichprobe in einen verrauschten, komplexen Zustand überführt hat. Mithilfe einer Reihe inverser Transformationen wird die verrauschte Stichprobe schrittweise in ihren ursprünglichen Zustand zurückgeführt. Die Schritte, die das Hinzufügen von Rauschen umkehren, werden von einer umgekehrten Markov-Kette gesteuert.
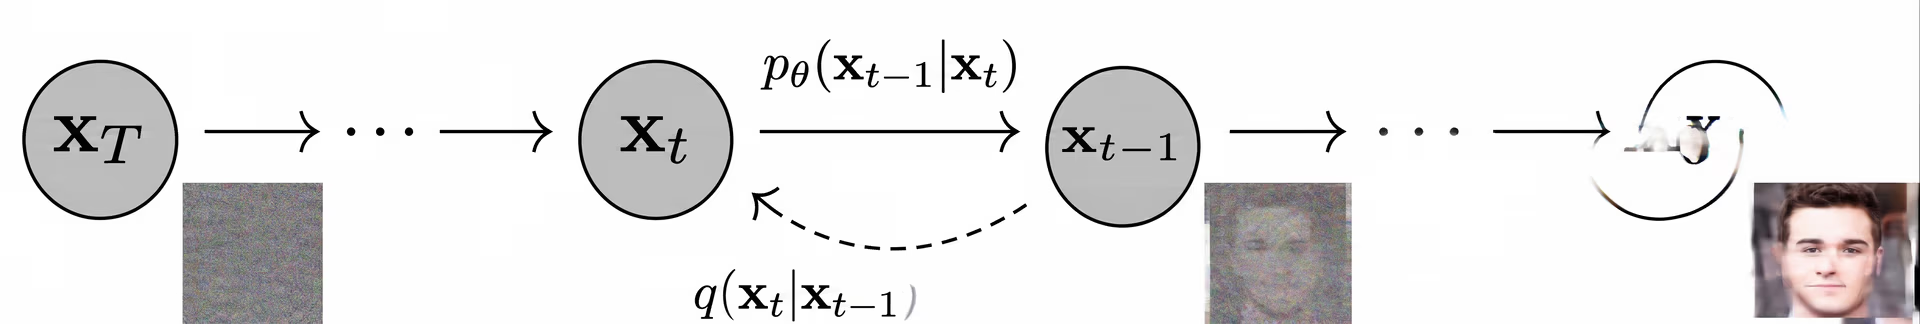
Abb. 4. Umgekehrter Diffusionsprozess.
Während des umgekehrten Prozesses lernen Diffusionsmodelle, neue Daten zu erzeugen, indem sie mit einer Stichprobe aus zufälligem Rauschen beginnen und diese nach und nach zu einer klaren, detaillierten Ausgabe verfeinern. Die erzeugten Daten ähneln schließlich stark dem ursprünglichen Datensatz. Dank dieser Fähigkeit eignen sich Diffusionsmodelle besonders für Aufgaben wie Bildsynthese, Datenergänzung und Entrauschung. Im nächsten Abschnitt sehen wir uns weitere Anwendungen von Diffusionsmodellen an.
Anwendungen von Diffusionsmodellen#
Dank des schrittweisen Diffusionsprozesses können Diffusionsmodelle komplexe Datenverteilungen effizient erzeugen, ohne von der hohen Dimensionalität der Daten überfordert zu werden. Sehen wir uns einige Anwendungsbereiche an, in denen Diffusionsmodelle besonders überzeugen.
Grafikdesign#
Diffusionsmodelle können schnell visuelle Grafikinhalte erzeugen. Designer und Künstler können Skizzen, Layouts oder sogar einfache grobe Ideen vorgeben, die die Modelle dann zum Leben erwecken. Das kann den gesamten Designprozess beschleunigen, zahlreiche neue Möglichkeiten vom ersten Konzept bis zum fertigen Produkt eröffnen und menschlichen Designern viel wertvolle Zeit sparen.
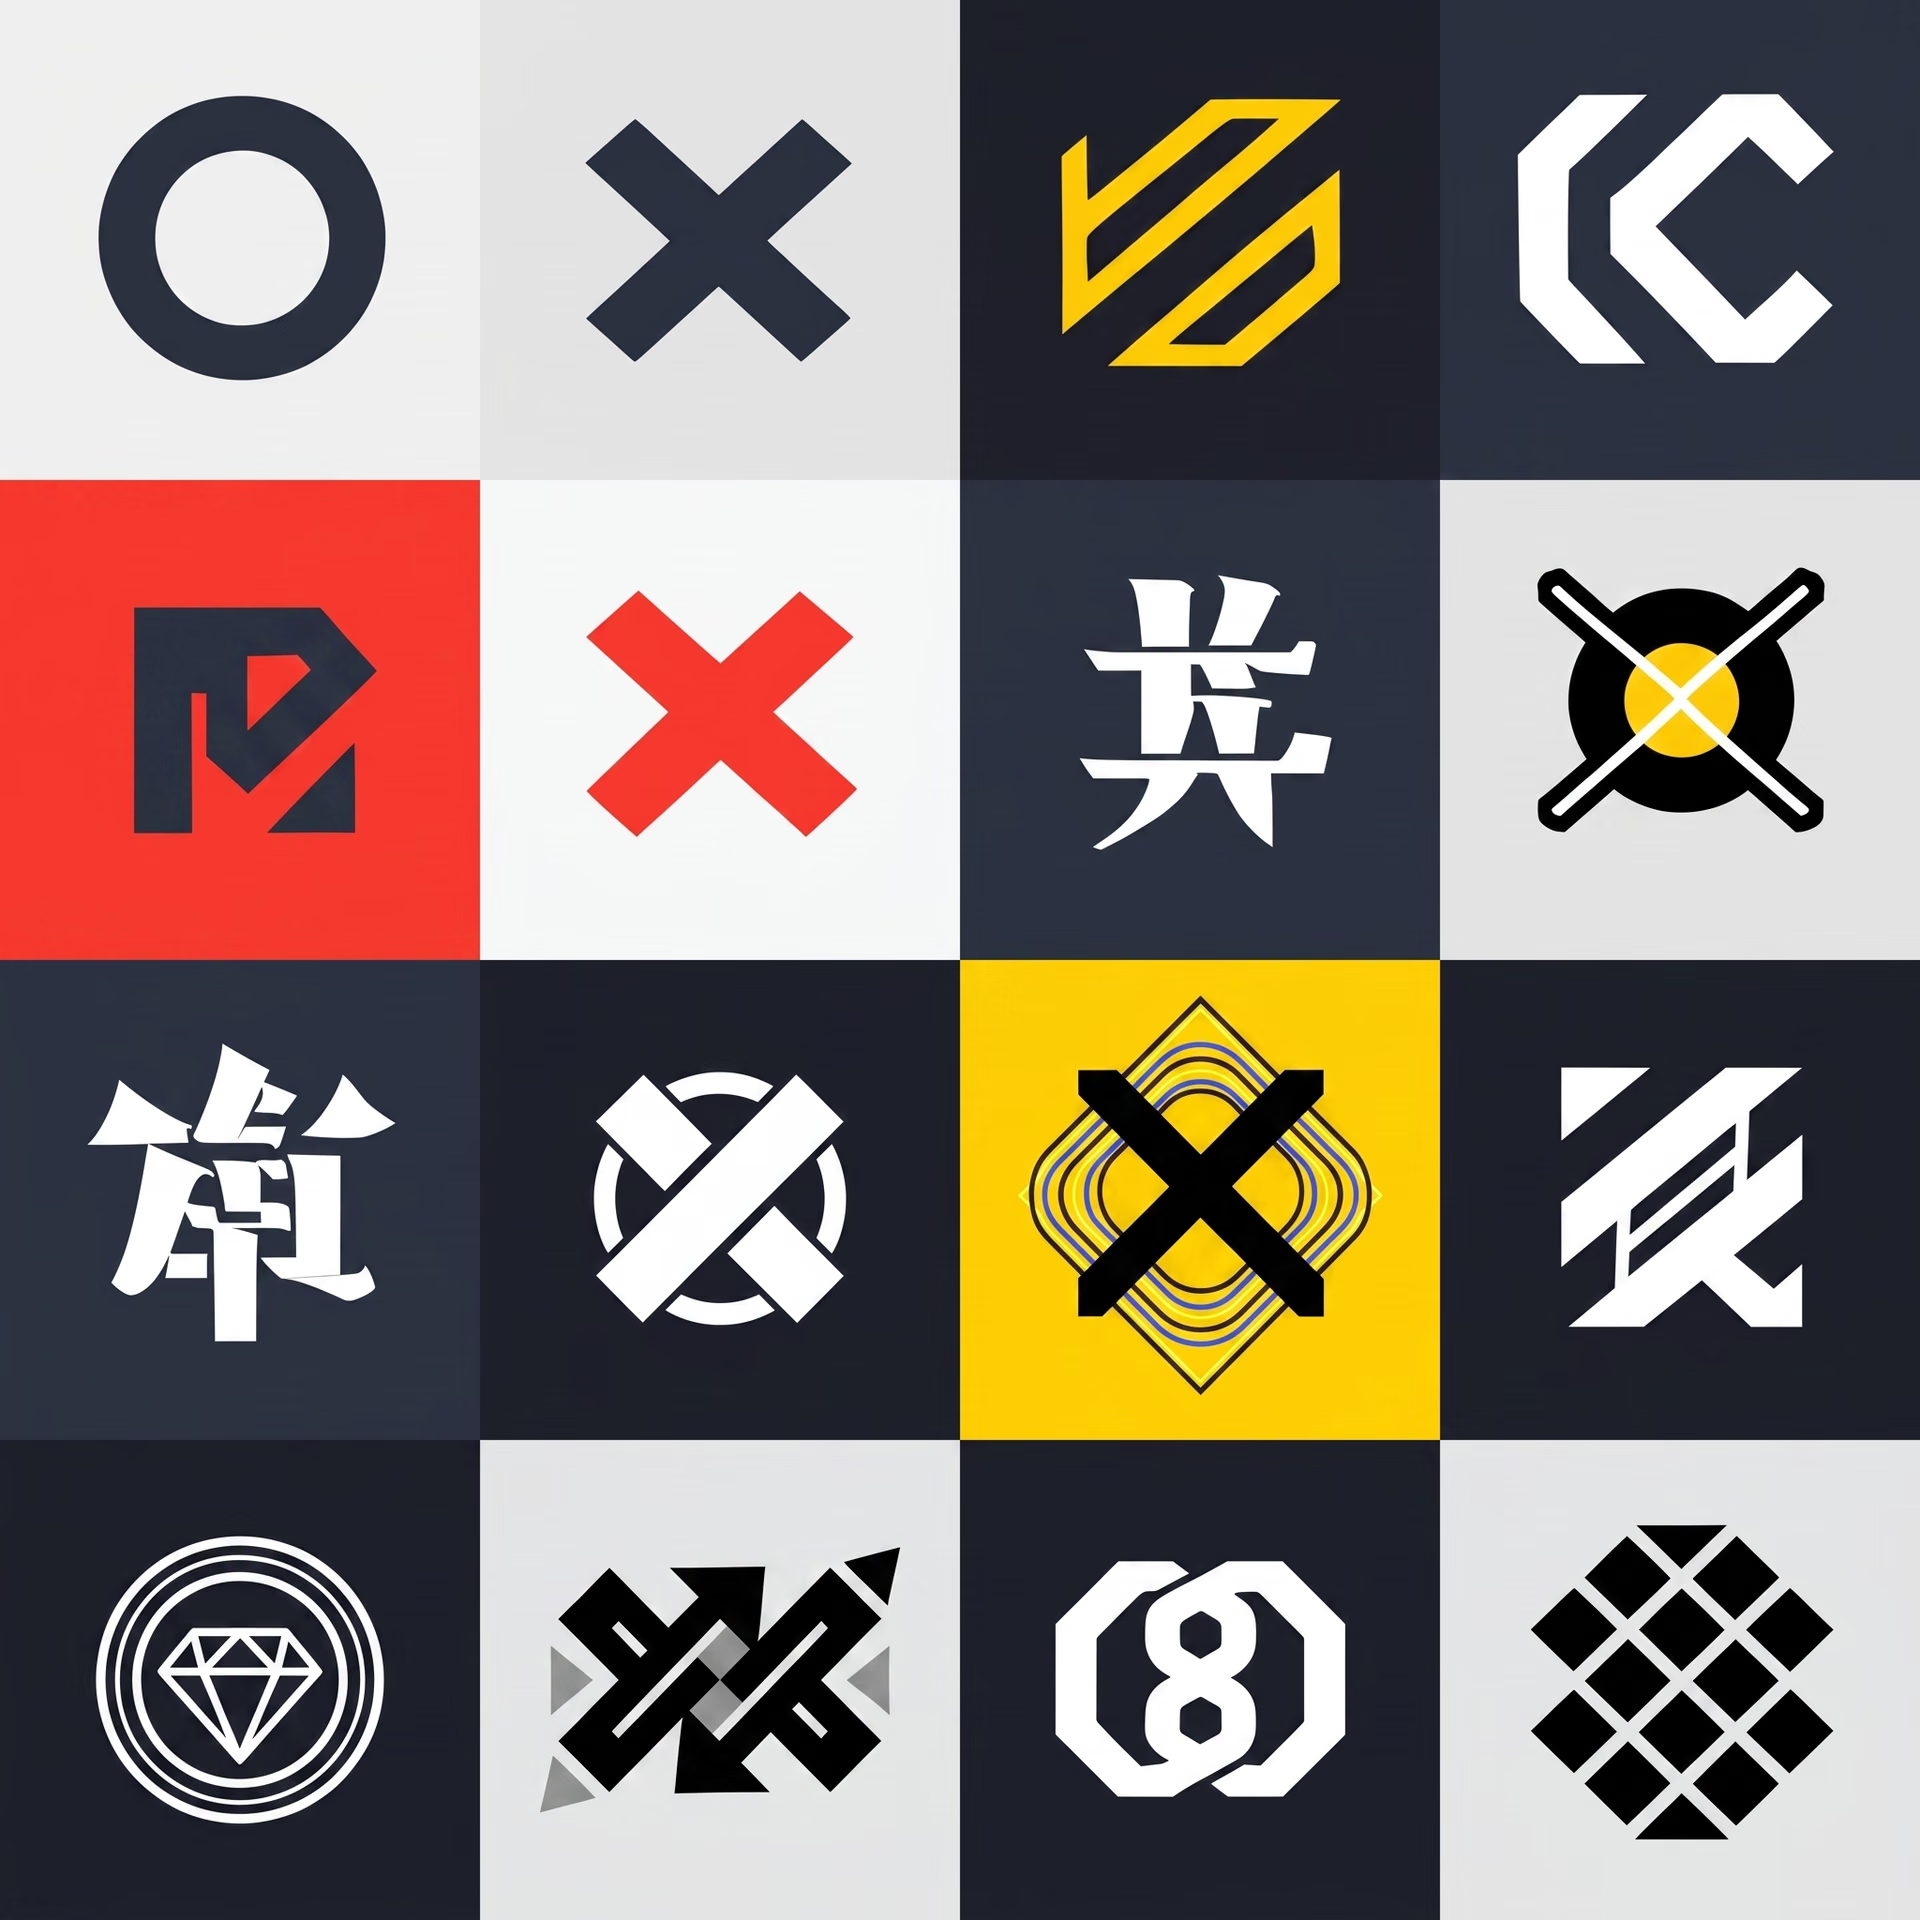
Abb. 5. Mit Diffusionsmodellen erstellte Grafikdesigns.
Musik und Sounddesign#
Diffusionsmodelle lassen sich auch so anpassen, dass sie einzigartige Klanglandschaften oder Musiknoten erzeugen. Sie eröffnen Musikern und Künstlern neue Möglichkeiten, Klangerlebnisse zu visualisieren und zu gestalten. Hier sind einige Anwendungsfälle von Diffusionsmodellen im Bereich der Klang- und Musikerzeugung:
- Stimmenübertragung: Diffusionsmodelle können einen Klang in einen anderen umwandeln, etwa eine Kickdrum-Aufnahme in einen Snare-Klang, um einzigartige Klangkombinationen zu erzeugen.
- Klangvariation und Vermenschlichung: Audiodiffusion kann Klänge leicht variieren und so digitalen Audiodateien eine menschliche Note verleihen, indem sie Live-Auftritte mit Instrumenten simuliert.
- Anpassungen des Sounddesigns: Diese Modelle können einen Klang subtil verändern, etwa eine Türknall-Aufnahme verstärken, und seine Eigenschaften tiefgreifender verändern als herkömmliche Entzerrung oder Filterung.
- Melodieerzeugung: Sie können auch dabei helfen, neue Melodien zu erzeugen, und Künstler ähnlich wie beim Durchstöbern von Sample-Paketen inspirieren.
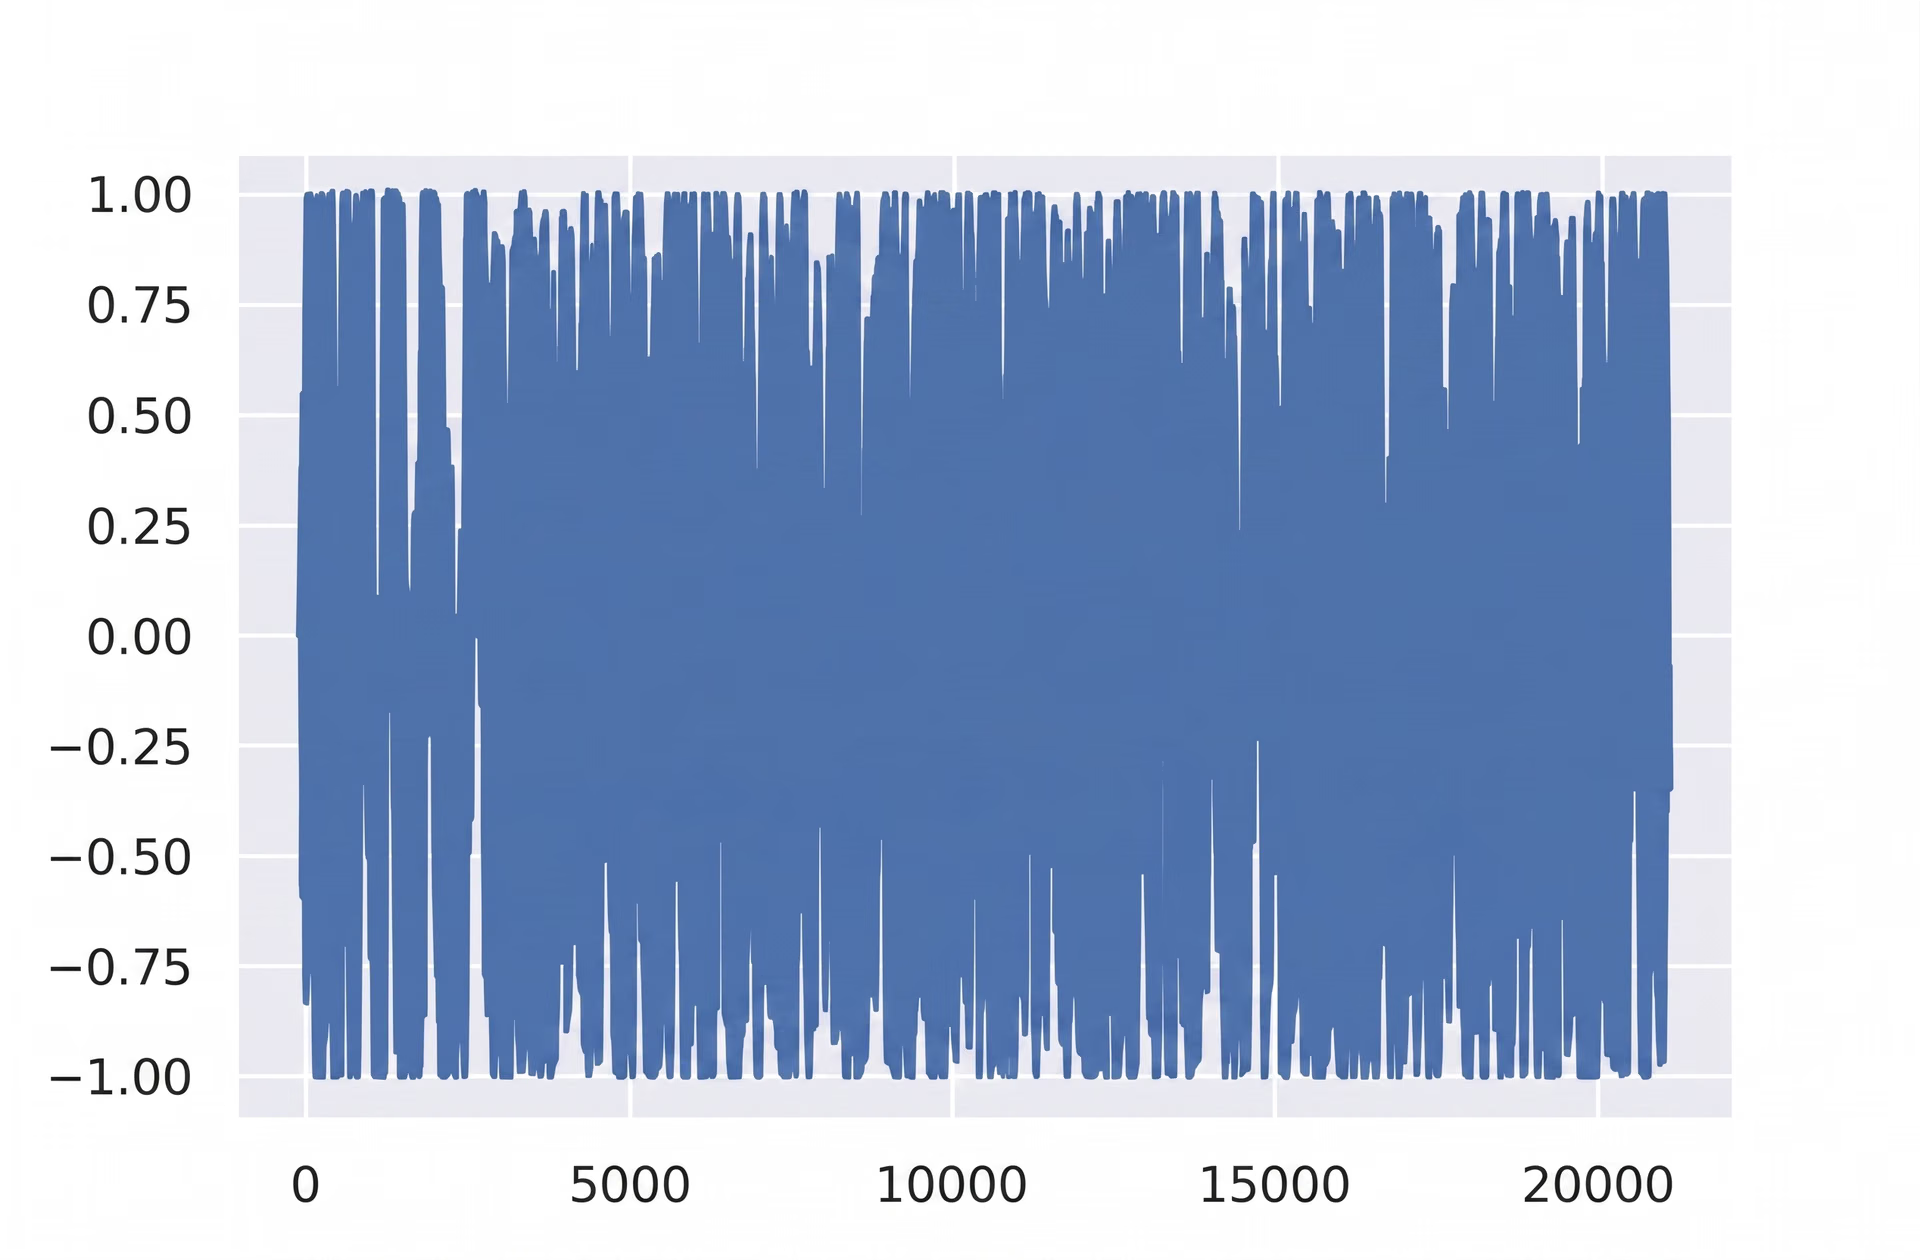
Abb. 6. Visualisierung der Audiodiffusion.
Film und Animation#
Ein weiterer interessanter Anwendungsfall von Diffusionsmodellen ist das Erstellen von Film- und Animationsclips. Sie können verwendet werden, um Figuren zu erzeugen, realistische Hintergründe zu gestalten und sogar dynamische Elemente in Szenen einzufügen. Der Einsatz von Diffusionsmodellen kann für Produktionsfirmen ein großer Vorteil sein. Er optimiert den gesamten Arbeitsablauf und schafft Raum für mehr Experimente und Kreativität beim visuellen Erzählen. Einige mit diesen Modellen erstellte Clips sind mit echten Animations- oder Filmclips vergleichbar. Es ist sogar möglich, mit diesen Modellen ganze Filme zu erstellen.
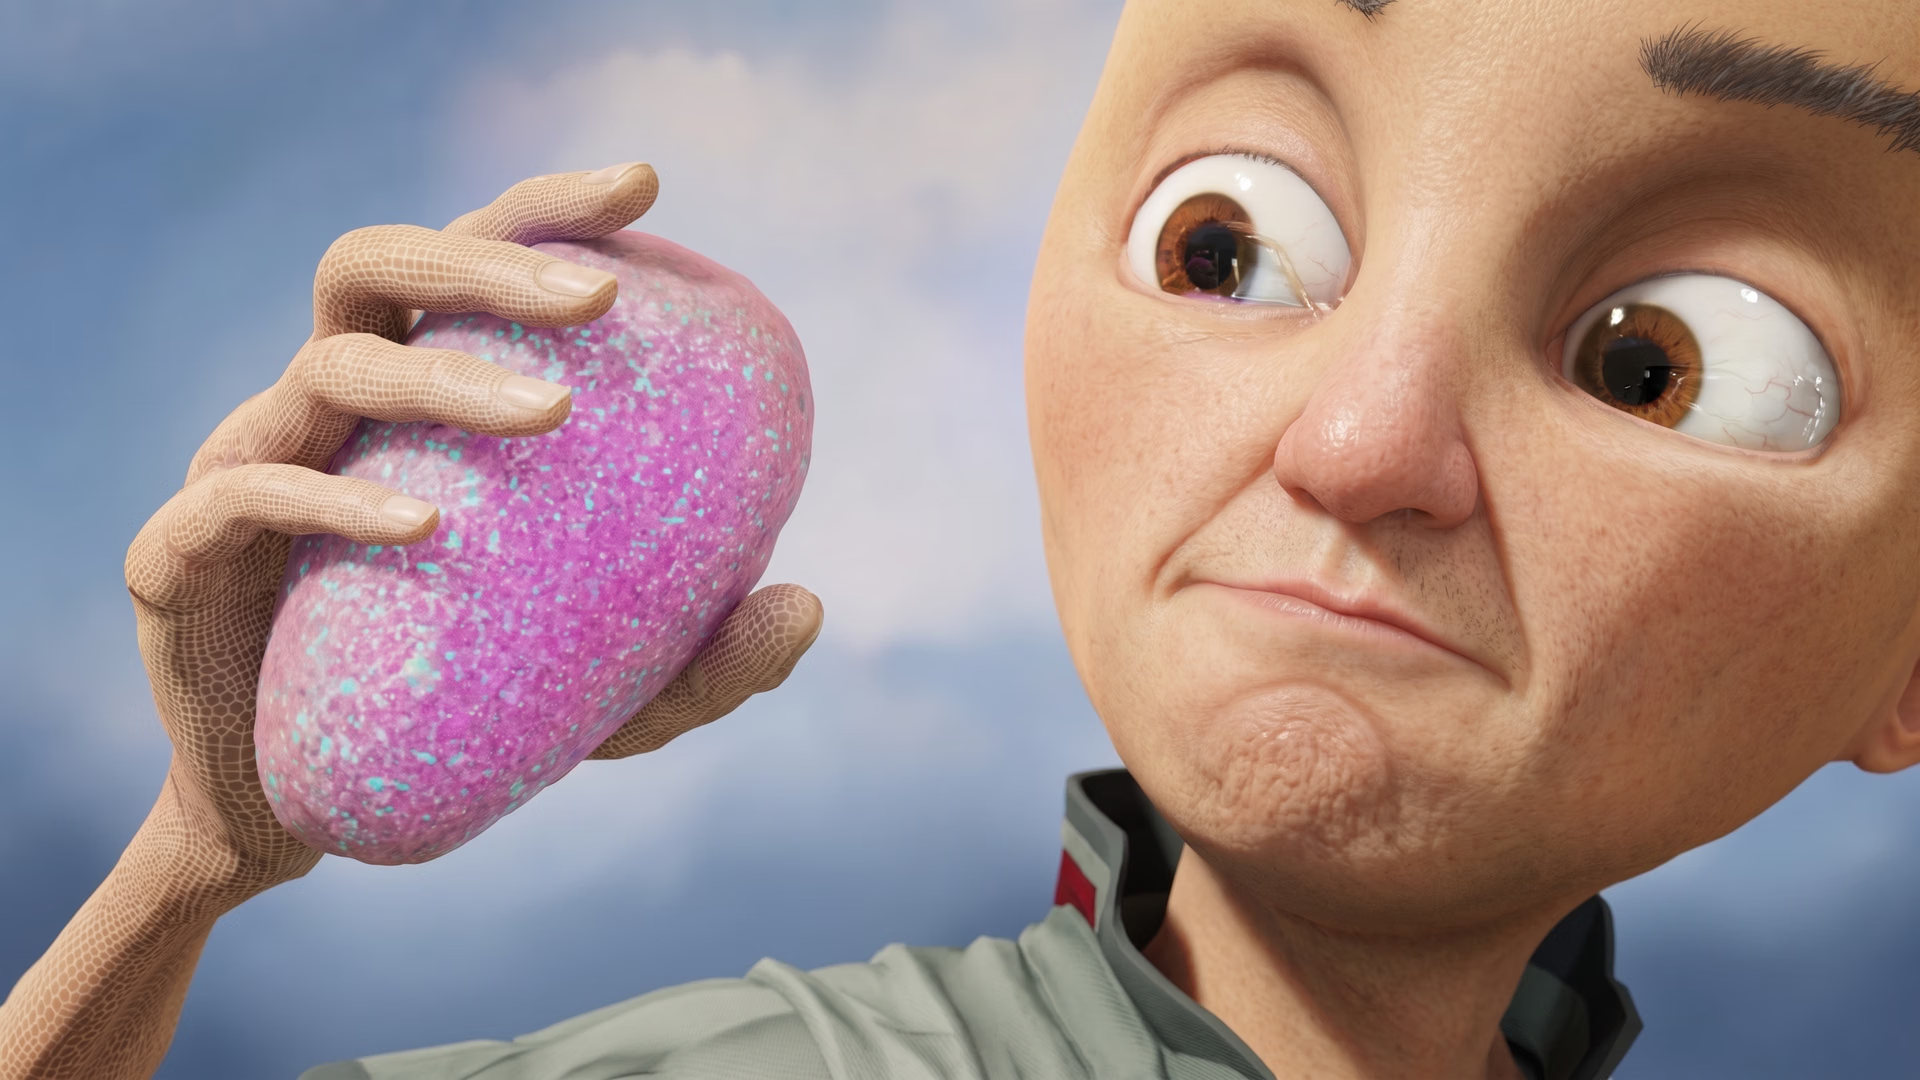
Abb. 7. Eine Szene aus dem Kurzfilm Seasons, der mit Diffusionsmodellen erstellt wurde.
Beliebte Diffusionsmodelle#
Nachdem wir nun einige Anwendungen von Diffusionsmodellen kennengelernt haben, sehen wir uns einige beliebte Diffusionsmodelle an, die du ausprobieren kannst.
- Stable Diffusion: Stable Diffusion wurde von Stability AI entwickelt und ist ein effizientes Modell, das dafür bekannt ist, Textaufforderungen in realistische Bilder umzuwandeln. Es genießt einen ausgezeichneten Ruf für die Erzeugung hochwertiger Bilder. Außerdem lässt es sich für Film und Animation anpassen.
- DALL-E 3: DALL-E 3 ist die neueste Version des Bilderzeugungsmodells von OpenAI. Es ist in ChatGPT integriert und bietet gegenüber der Vorgängerversion DALL-E 2 zahlreiche Verbesserungen bei der Bildqualität.
- Sora: Sora ist das Text-zu-Video-Modell von OpenAI. Es kann äußerst realistische Videos in 1080p mit einer Länge von bis zu einer Minute erzeugen. Einige mit Sora erstellte Videoclips lassen sich leicht für echte Aufnahmen halten.
- Imagen: Imagen wurde von Google entwickelt und ist ein Text-zu-Bild-Diffusionsmodell, das für seinen Fotorealismus und sein fortschrittliches Sprachverständnis bekannt ist.
Herausforderungen und Einschränkungen von Diffusionsmodellen#
Diffusionsmodelle bieten zwar Vorteile in vielen Branchen, doch solltest du auch einige damit verbundene Herausforderungen berücksichtigen. Eine davon ist, dass der Trainingsprozess sehr ressourcenintensiv ist. Fortschritte bei der Hardwarebeschleunigung können helfen, sind aber mit hohen Kosten verbunden. Ein weiteres Problem ist, dass Diffusionsmodelle nur eingeschränkt auf unbekannte Daten verallgemeinern können. Ihre Anpassung an bestimmte Bereiche kann umfangreiche Feinabstimmung oder erneutes Training erfordern.
Die Integration dieser Modelle in praktische Anwendungen bringt eigene Herausforderungen mit sich. Entscheidend ist, dass die von der KI erzeugten Ergebnisse tatsächlich den menschlichen Vorstellungen entsprechen. Es gibt auch ethische Bedenken, etwa das Risiko, dass diese Modelle Verzerrungen aus den Trainingsdaten übernehmen und widerspiegeln. Hinzu kommt, dass es kontinuierlichen Aufwand erfordern kann, die Erwartungen der Nutzer zu steuern und die Modelle anhand von Feedback ständig zu verbessern, damit die Tools so wirksam und zuverlässig wie möglich sind.
Die Zukunft der Diffusionsmodelle#
Diffusionsmodelle sind ein faszinierendes Konzept der generativen KI, mit dem sich hochwertige Bilder, Videos und Klänge für viele verschiedene Bereiche erstellen lassen. Die Implementierung kann zwar Herausforderungen mit sich bringen, etwa den Rechenaufwand und ethische Bedenken, doch die KI-Community arbeitet ständig daran, ihre Effizienz und Wirkung zu verbessern. Während Diffusionsmodelle weiterentwickelt werden, dürften sie Branchen wie Film, Musikproduktion und digitale Inhaltserstellung grundlegend verändern.
Lass uns gemeinsam lernen und Neues entdecken! In unserem GitHub-Repository findest du unsere Beiträge zur KI. Erfahre, wie wir Branchen wie die Fertigung und das Gesundheitswesen mit modernster KI-Technologie neu gestalten.









