Selbstüberwachtes Lernen zur Rauschminderung: Schritt für Schritt erklärt
Erfahre, wie selbstüberwachtes Lernen zur Rauschminderung funktioniert, warum Bilder verrauschen und welche wichtigen Methoden und Schritte saubere Bilddetails wiederherstellen.
 Abirami Vina13 Min. Lesezeit
Kameras nehmen die Welt nicht immer so auf, wie wir sie sehen. Ein Porträt bei schwachem Licht oder ein Foto von einem schnell fahrenden Auto kann körnig, unscharf oder verzerrt wirken.
Langsame Sensoren, dunkle Umgebungen und Bewegung können winzige Rauschartefakte verursachen, die Kanten weichzeichnen und wichtige Details verbergen. Geht diese Klarheit verloren, können selbst fortschrittliche KI- und maschinelle Lernsysteme Schwierigkeiten haben, den Bildinhalt zu erfassen, da viele intelligente Systeme auf diese feinen Details angewiesen sind.
Computer Vision ist beispielsweise ein Teilgebiet der künstlichen Intelligenz, das Maschinen die Interpretation von Bildern und Videos ermöglicht. Damit diese Interpretation präzise gelingt, benötigen Computer-Vision-Modelle saubere, hochwertige visuelle Daten zum Lernen.
Modelle wie Ultralytics YOLO11 und Ultralytics YOLO26 (veröffentlicht im Januar 2026) unterstützen Aufgaben wie Objekterkennung, Instanzsegmentierung und Posenschätzung und lassen sich für verschiedene Anwendungsfälle individuell trainieren. Diese Aufgaben beruhen auf klaren visuellen Merkmalen wie Kanten, Texturen, Farben und feinen strukturellen Details.
Wenn Rauschen diese Merkmale verdeckt, erhält das Modell schwächere Trainingssignale und kann präzise Muster schwerer lernen. Dadurch kann schon wenig Rauschen die Leistung in realen Anwendungen beeinträchtigen.
Zuvor haben wir uns angesehen, wie selbstüberwachtes Lernen Bilder entrauscht. In diesem Artikel erklären wir genauer, wie selbstüberwachte Entrauschungsverfahren funktionieren und wie sie dabei helfen, aussagekräftige visuelle Informationen wiederherzustellen.
Häufige Rauscharten in realen Bildern#
Bevor wir uns ansehen, wie selbstüberwachtes Lernen bei der Bildentrauschung eingesetzt wird, schauen wir uns zunächst noch einmal an, warum Bilder überhaupt verrauschen.
Bilder realer Objekte und Szenen sind selten perfekt. Schwaches Licht, eine begrenzte Sensorqualität und schnelle Bewegungen können zufällige Störungen in einzelnen Pixeln des Bildes verursachen. Diese Störungen auf Pixelebene, die als Rauschen bezeichnet werden, verringern die allgemeine Bildschärfe und erschweren das Erkennen wichtiger Details.
Wenn Rauschen Kanten, Texturen und feine Muster verdeckt, fällt es Computer-Vision-Systemen schwer, Objekte zu erkennen oder Szenen präzise zu interpretieren. Unterschiedliche Bedingungen erzeugen verschiedene Rauscharten, die sich jeweils anders auf das Bild auswirken.
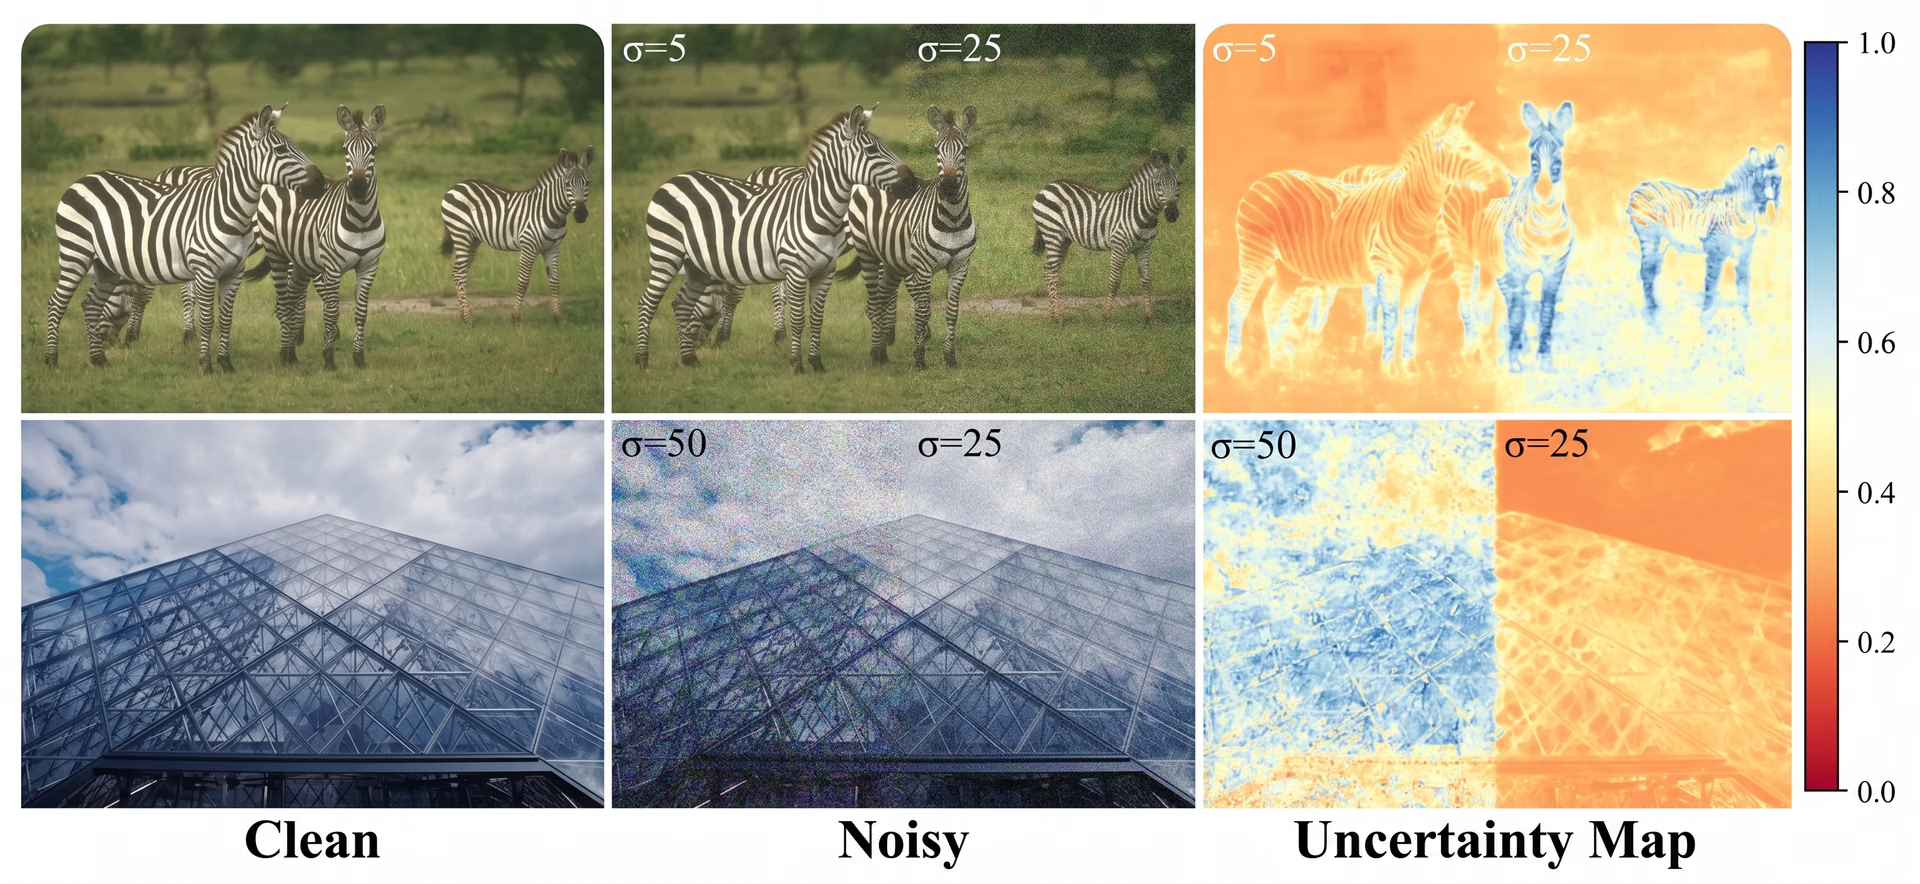
Abb. 1. Beispiel dafür, wie Rauschen die Unsicherheit in einem Bild erhöhen kann. (Quelle)
Hier sind einige der häufigsten Rauscharten in Bildern:
- Gaußsches Rauschen: Diese Rauschart zeigt sich als feines, zufälliges Korn, das durch elektronische Sensorstörungen oder Temperaturschwankungen entsteht. Es folgt einer Gaußschen (Normal-)Verteilung, bei der kleine Pixelabweichungen feine Details verwischen und die allgemeine Bildschärfe verringern.
- Poisson-Rauschen: Diese Rauschart, auch Photonenrauschen genannt, tritt bei schwachem Licht oder kurzen Belichtungszeiten auf. Ihre Varianz nimmt mit der Helligkeit zu. Das Rauschen ist jedoch in dunkleren Bildbereichen oft deutlicher sichtbar, weil dort weniger Photonen erfasst werden und dadurch das Signal-Rausch-Verhältnis geringer ist.
- Salz-und-Pfeffer-Rauschen: Diese Rauschart zeigt sich als scharfe schwarze oder weiße Pixelausschläge. Sie wird meist durch Übertragungsfehler, beschädigte Bits oder defekte Kamerasensoren verursacht und führt häufig zu fehlenden oder beschädigten Pixelwerten.
- Speckle-Rauschen: Diese Rauschart zeigt sich als körnige, fleckenartige Muster und tritt häufig in der medizinischen Bildgebung, Radarbildern und Ultraschallbildern auf. Sie wird durch Signalstörungen und Streuung verursacht, wodurch der Kontrast sinkt und Kanten schwerer zu erkennen sind.
Wann solltest du selbstüberwachtes Entrauschen einsetzen?#
Was macht selbstüberwachtes Entrauschen also besonders? Es eignet sich hervorragend für Situationen, in denen keine sauberen Referenzbilder vorliegen oder diese nur sehr schwer aufzunehmen sind.
Das kommt häufig bei Aufnahmen bei schwachem Licht, Bildern mit hohem ISO-Wert, in der medizinischen und wissenschaftlichen Bildgebung oder in anderen Umgebungen vor, in denen Rauschen unvermeidbar ist und sich perfekte Referenzdaten nicht realistisch erfassen lassen. Statt saubere Beispiele zu benötigen, lernt das Modell direkt aus den bereits vorhandenen verrauschten Bildern und kann sich so an die spezifischen Rauschmuster deiner Kamera oder deines Sensors anpassen.
Selbstüberwachtes Entrauschen ist auch eine gute Option, wenn du die Leistung nachgelagerter Computer-Vision-Aufgaben verbessern möchtest, dein Datensatz aber uneinheitliche oder verrauschte Bilder enthält. Indem diese Verfahren klarere Kanten, Texturen und Strukturen wiederherstellen, helfen sie Modellen wie YOLO, Szenen zuverlässiger zu erkennen, zu segmentieren und zu verstehen. Kurz gesagt: Wenn du mit verrauschten Daten arbeitest und keine sauberen Trainingsbilder verfügbar sind, ist selbstüberwachtes Entrauschen oft die praktischste und wirksamste Lösung.
Die zentralen Verfahren für selbstüberwachtes Entrauschen#
Wie bereits erwähnt, ist selbstüberwachtes Entrauschen ein Deep-Learning-basierter KI-Ansatz, mit dem Modelle direkt aus verrauschten Bildern lernen können, ohne auf saubere Beschriftungen angewiesen zu sein. Der Ansatz baut auf den Prinzipien des selbstüberwachten Lernens auf, bei dem Modelle ihre Trainingssignale direkt aus den Daten selbst erzeugen.
Anders gesagt: Ein Modell kann sich selbst beibringen, verrauschte Bilder sowohl als Eingabe als auch als Quelle seines Lernsignals zu verwenden. Indem es verschiedene beschädigte Versionen desselben Bildes vergleicht oder verdeckte Pixel vorhersagt, lernt das Modell, welche Muster die tatsächliche Struktur darstellen und welche lediglich Rauschen sind. Durch iterative Optimierung und Mustererkennung verbessert das Netzwerk nach und nach seine Fähigkeit, aussagekräftige Bildinhalte von zufälligen Abweichungen zu unterscheiden.
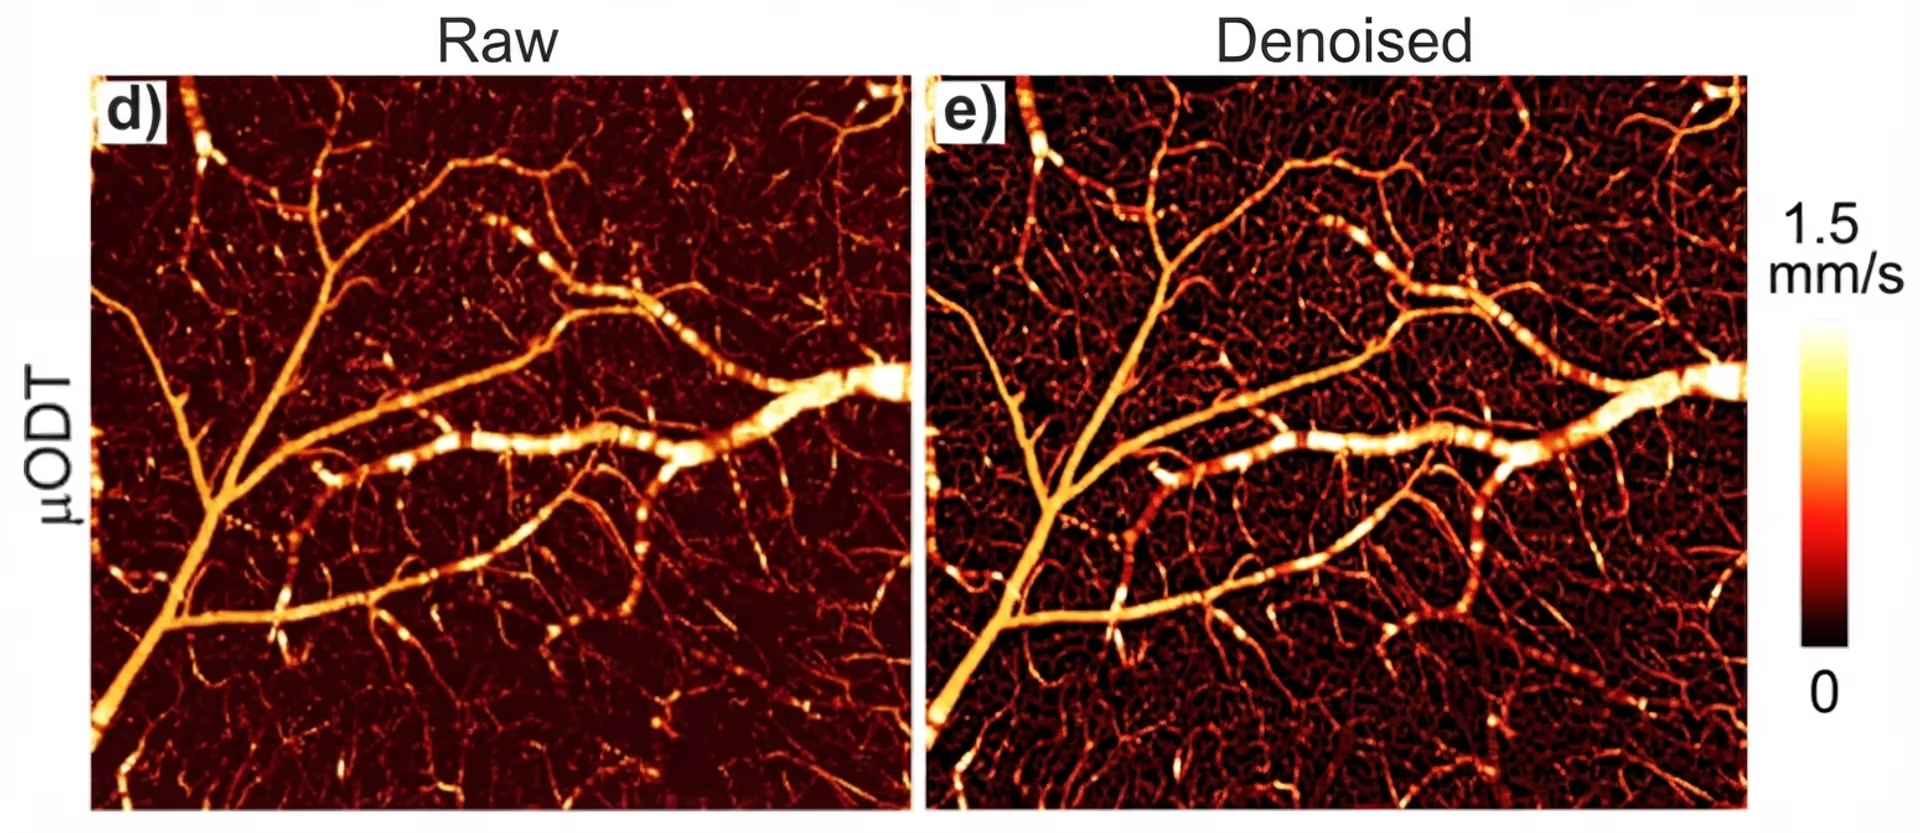
Abb. 2. Ein unbearbeitetes und ein entrauschtes Bild. (Quelle)
Möglich wird dies durch bestimmte Lernstrategien, die dem Modell dabei helfen, stabile Bildstrukturen von zufälligem Rauschen zu trennen. Schauen wir uns nun die wichtigsten Verfahren und Algorithmen genauer an, die diesen Prozess vereinfachen, und betrachten wir, wie die einzelnen Ansätze dem Modell helfen, klarere und zuverlässigere Bilder zu rekonstruieren.
Paarweise Verfahren zur Bildentrauschung#
Viele frühe selbstüberwachte Lernverfahren zur Entrauschung verglichen zwei verrauschte Versionen desselben Bildes. Da sich das Rauschen bei jeder Aufnahme oder Beschädigung eines Bildes zufällig ändert, die tatsächliche Struktur aber gleich bleibt, lassen sich diese Unterschiede als Lernsignal für ein Modell verwenden.
Diese Ansätze werden üblicherweise als paarweise Verfahren zur Bildentrauschung bezeichnet, weil sie während des Trainings auf Paare verrauschter Bilder zurückgreifen oder solche erzeugen. Beim Ansatz Noise2Noise beispielsweise, der von Jaakko Lehtinen und seinem Team vorgestellt wurde, wird ein Modell mit zwei unabhängig verrauschten Bildern derselben Szene trainiert. Da sich die Rauschmuster der beiden Versionen unterscheiden, lernt das Modell, die gleichbleibenden Details zu erkennen, die das tatsächliche zugrunde liegende Bild darstellen.
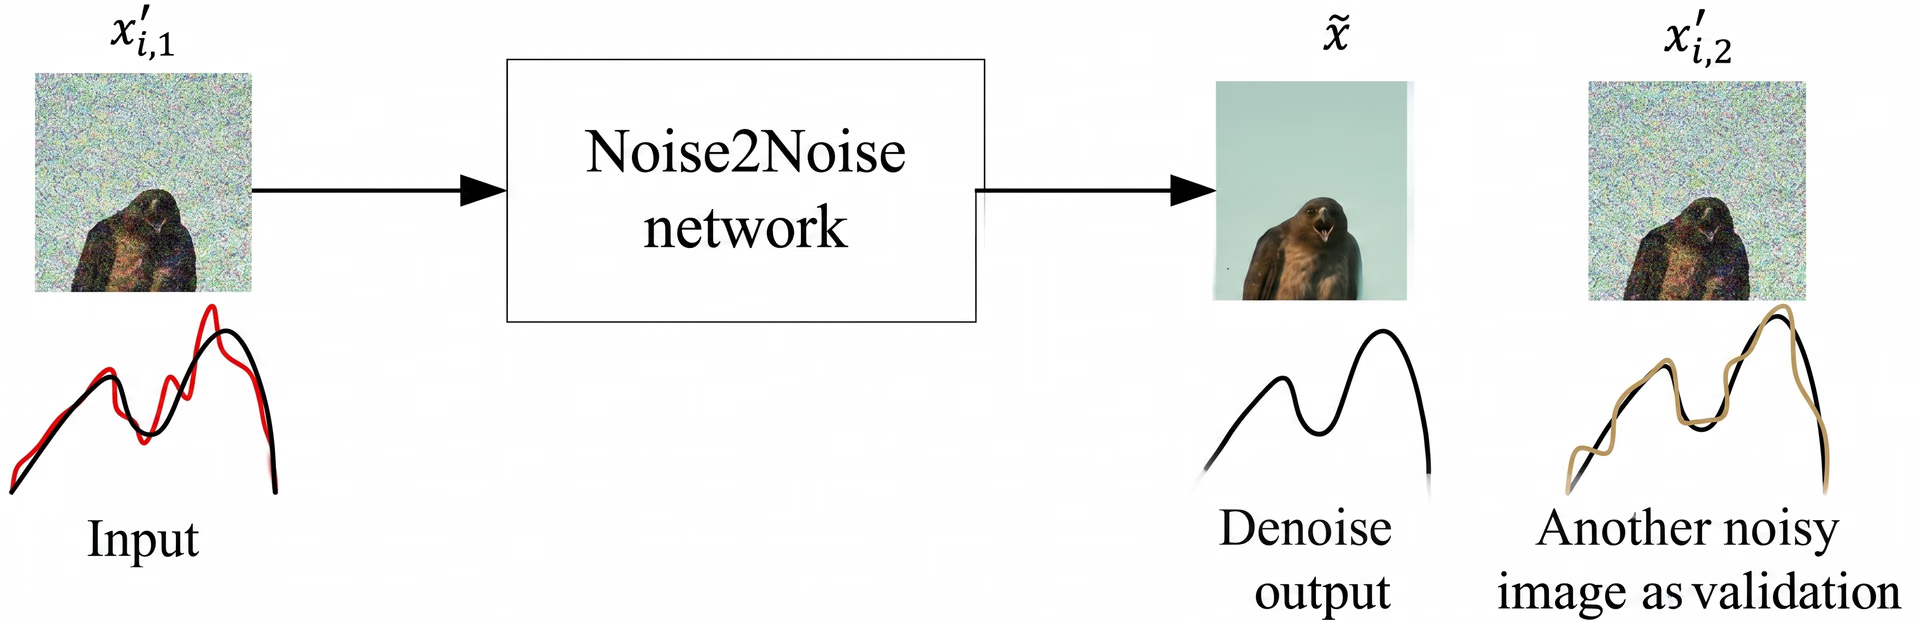
Abb. 3. So funktioniert Noise2Noise (Quelle)
Mit der Zeit lernt das Netzwerk so, zufälliges Rauschen zu unterdrücken und echte Strukturen zu erhalten, obwohl es nie ein sauberes Referenzbild sieht. Stell dir als einfaches Beispiel vor, du machst nachts zwei Fotos einer Straße bei schwachem Licht.
Jedes Bild enthält dieselben Gebäude, Lichter und Schatten, aber das körnige Rauschen tritt an unterschiedlichen Stellen auf. Beim Vergleich dieser beiden verrauschten Fotos während des Trainings kann ein selbstüberwachtes Modell lernen, welche visuellen Muster stabil sind und welche durch Rauschen entstehen. Dadurch verbessert es letztlich seine Fähigkeit, klarere Bilder zu rekonstruieren.
Selbstüberwachte Entrauschungsverfahren mit blinden Flecken#
Während paarweise Verfahren zwei unterschiedlich beschädigte Versionen desselben Bildes vergleichen, gehen Verfahren mit blinden Flecken anders vor. Sie ermöglichen dem Modell, anhand eines einzigen verrauschten Bildes zu lernen, indem ausgewählte Pixel verdeckt werden, sodass das Netzwerk deren verfälschte Werte nicht sehen kann.
Anschließend muss das Modell die verdeckten Pixel ausschließlich anhand ihres Umfelds vorhersagen. Die Grundidee lautet: Rauschen ist zufällig, die zugrunde liegende Bildstruktur hingegen nicht.
Indem sie verhindern, dass das Modell den verrauschten Wert eines Pixels kopiert, regen Verfahren mit blinden Flecken das Modell dazu an, den erwarteten Pixelwert anhand stabiler Bildmuster wie benachbarter Kanten, Texturen oder Farbverläufe abzuleiten. Verfahren wie Noise2Void, das von Alexander Krull und seinem Team vorgestellt wurde, und Noise2Self, entwickelt von Joshua Batson und Loïc Royer, setzen dieses Prinzip um, indem sie einzelne Pixel oder kleine Bereiche maskieren und das Modell darauf trainieren, sie zu rekonstruieren.
Fortschrittlichere Ansätze wie Noise2Same und PN2V verbessern die Robustheit, indem sie konsistente Vorhersagen über mehrere maskierte Versionen hinweg erzwingen oder die Rauschverteilung explizit modellieren, um die Unsicherheit zu schätzen. Da diese Verfahren nur ein einziges verrauschtes Bild benötigen, eignen sie sich besonders für Bereiche, in denen saubere oder gepaarte Bilder nur schwer oder gar nicht aufgenommen werden können, etwa in der Mikroskopie, der Astronomie, der biomedizinischen Bildgebung oder bei Aufnahmen bei schwachem Licht.
Entrauschungsverfahren mit Unterstützung durch Transformer#
Die meisten paarweisen und Blind-Spot-Verfahren für selbstüberwachtes Entrauschen setzen auf Faltungsneuronale Netze (CNNs) oder Entrauschungsnetzwerke. CNNs eignen sich für diese Ansätze besonders gut, weil sie sich auf lokale Muster konzentrieren, also auf Kanten, Texturen und kleine Details.
Architekturen wie U-Net werden häufig eingesetzt, da sie feingranulare Merkmale mit Informationen aus mehreren Auflösungsstufen verbinden. CNNs arbeiten jedoch hauptsächlich in begrenzten Nachbarschaften und können deshalb wichtige Zusammenhänge übersehen, die sich über größere Bildbereiche erstrecken.
Modernste Entrauschungsverfahren auf Basis von Transformer wurden entwickelt, um diese Einschränkung zu überwinden. Anstatt nur benachbarte Pixel zu betrachten, verwenden diese Verfahren Aufmerksamkeitsmechanismen, um zu verstehen, wie verschiedene Bildbereiche miteinander zusammenhängen.
Einige Modelle nutzen eine vollständige globale Aufmerksamkeit, während andere den Rechenaufwand durch auf Fenster begrenzte oder hierarchische Aufmerksamkeit senken. Im Allgemeinen sollen diese Verfahren jedoch weitreichende Strukturen erfassen, die CNNs allein nicht erkennen können. Diese umfassendere Perspektive hilft dem Modell, wiederkehrende Texturen, glatte Flächen oder große Objekte wiederherzustellen, für die Informationen aus dem gesamten Bild benötigt werden.
Weitere Verfahren zur Bildentrauschung#
Neben selbstüberwachten Verfahren gibt es noch andere Möglichkeiten, verrauschte Bilder zu bereinigen. Herkömmliche Methoden wie bilaterale Filterung, Wavelet-Entrauschung und nichtlokale Mittel verwenden einfache mathematische Regeln, um Rauschen zu glätten und zugleich wichtige Details zu erhalten.
Es gibt auch Deep-Learning-Ansätze, darunter überwachte Modelle, die anhand sauberer und verrauschter Bildpaare lernen, sowie generative gegnerische Netze (GANs), die schärfere und realistischere Ergebnisse erzeugen. Diese Methoden benötigen für das Training jedoch in der Regel eine bessere Bildqualität.
Schritt für Schritt: So funktioniert die selbstüberwachte Bildentrauschung#
Da wir gerade mehrere verschiedene Verfahren betrachtet haben, fragst du dich vielleicht, ob jedes Verfahren völlig anders funktioniert, weil sie unterschiedliche Architekturen verwenden. Sie folgen jedoch alle einer ähnlichen Abfolge, die mit der Datenaufbereitung beginnt und mit der Modellbewertung endet.
Sehen wir uns als Nächstes Schritt für Schritt genauer an, wie der gesamte Prozess des selbstüberwachten Bildentrauschens abläuft.
Schritt 1: Vorverarbeitung und Normalisierung#
Bevor das Modell aus verrauschten Bildern lernen kann, muss zunächst sichergestellt werden, dass alle Bilder einheitlich aussehen. Echte Fotos können sich stark unterscheiden.
Manche Bilder sind möglicherweise zu hell, andere zu dunkel, und bei einigen können die Farben leicht verfälscht sein. Werden diese Unterschiede direkt in ein Modell eingespeist, fällt es ihm schwerer, sich darauf zu konzentrieren, wie Rauschen aussieht.
Um diesem Problem zu begegnen, wird jedes Bild normalisiert und einer grundlegenden Vorverarbeitung unterzogen. Dazu kann gehören, Pixelwerte auf einen Standardbereich zu skalieren, Helligkeitsabweichungen auszugleichen oder Bilder zuzuschneiden und in der Größe anzupassen. Wichtig ist, dass das Modell konsistente Daten als stabile und vergleichbare Eingaben erhält.
Schritt 2: Ein selbstüberwachtes Trainingssignal erzeugen#
Sobald die Bilder normalisiert sind, wird als Nächstes ein Trainingssignal erzeugt, mit dem das Modell lernen kann, ohne jemals ein sauberes Bild zu sehen. Selbstüberwachte Entrauschungsverfahren stellen dabei sicher, dass das Modell die empfangenen verrauschten Pixelwerte nicht einfach kopieren kann.
Stattdessen schaffen sie Situationen, in denen sich das Modell auf den Bildkontext mit seiner stabilen Struktur verlassen muss und nicht auf das unvorhersehbare Rauschen. Die verschiedenen Verfahren setzen das auf leicht unterschiedliche Weise um, doch die Grundidee ist dieselbe.
Einige Ansätze verdecken oder maskieren vorübergehend bestimmte Pixel, sodass das Modell sie ausgehend von benachbarten Pixeln erschließen muss. Andere erzeugen eine separat beschädigte Version desselben verrauschten Bildes, sodass Eingabe und Ziel unabhängiges Rauschen enthalten. In beiden Fällen enthält das Zielbild aussagekräftige strukturelle Informationen, verhindert aber zugleich, dass das Netzwerk auf den ursprünglichen verrauschten Wert des Pixels zugreift, den es vorhersagen soll.
Da sich das Rauschen zufällig ändert, während das zugrunde liegende Bild gleich bleibt, wird das Modell durch diesen Aufbau auf natürliche Weise dazu angeregt, die tatsächliche Struktur zu lernen und das Rauschen zu ignorieren, das sich von einer Version zur nächsten ändert.
Schritt 3: Durch Entrauschung die Bildstruktur wiederherstellen#
Sobald das Trainingssignal vorliegt, kann das Modell im Training lernen, aussagekräftige Bildstrukturen von Rauschen zu unterscheiden. Jedes Mal, wenn es ein maskiertes oder erneut beschädigtes Pixel vorhersagt, muss es sich auf den umgebenden Kontext verlassen, statt auf den verrauschten Wert, der sich ursprünglich an dieser Stelle befand.
Über viele Iterationen oder Epochen hinweg lernt das Netzwerk so, Muster zu erkennen, die im gesamten Bild stabil bleiben, etwa Kanten, Texturen und glatte Flächen. Außerdem lernt es, die zufälligen Schwankungen zu ignorieren, die für Rauschen charakteristisch sind.
Betrachte beispielsweise ein Foto bei schwachem Licht, auf dem eine Fläche extrem körnig erscheint. Obwohl das Rauschen von Pixel zu Pixel variiert, ist die zugrunde liegende Fläche weiterhin glatt. Indem das Modell in solchen Bereichen wiederholt verdeckte Pixel erschließt, erkennt es nach und nach besser das stabile Muster unter dem Rauschen und rekonstruiert es klarer.
Während des Modelltrainings entwickelt das Netzwerk eine interne Repräsentation der Bildstruktur. Dadurch kann das Modell zusammenhängende Details wiederherstellen, selbst wenn die Eingabe stark beschädigt ist.
Schritt 4: Validierung und Ergebnisse der Rauschunterdrückung#
Nachdem das Modell gelernt hat, verdeckte oder erneut beschädigte Pixel vorherzusagen, wird abschließend geprüft, wie gut es vollständige Bilder verarbeitet. Während des Tests erhält das Modell ein vollständiges verrauschtes Bild und erstellt anhand seines erlernten Verständnisses der Bildstruktur eine vollständige entrauschte Version. Um die Wirksamkeit des Verfahrens zu messen, wird das Ergebnis mit sauberen Referenzbildern oder standardisierten Benchmark-Datensätzen verglichen.
Zwei häufig verwendete Messgrößen sind PSNR (Signal-Rausch-Verhältnis), das misst, wie nahe die Rekonstruktion am sauberen Referenzbild liegt, und SSIM (struktureller Ähnlichkeitsindex), der bewertet, wie gut wichtige Merkmale wie Kanten und Texturen erhalten bleiben. Höhere Werte weisen im Allgemeinen auf eine präzisere und visuell zuverlässigere Entrauschung hin.
Bilddatensätze für Training und Benchmarking#
Forschung zum selbstüberwachten Entrauschen, die in IEEE-Fachzeitschriften, auf CVF-Konferenzen wie CVPR, ICCV und ECCV sowie auf arXiv veröffentlicht wird, stützt sich häufig auf eine Kombination aus synthetischen und realen Datensätzen. Damit wird die Leistung von Deep-Learning-Verfahren unter kontrollierten und praxisnahen Bedingungen bewertet. Synthetische Datensätze basieren auf sauberen Bildern, denen künstliches Rauschen hinzugefügt wird. So lassen sich Verfahren anhand von Kennzahlen wie PSNR und SSIM leicht vergleichen.
Hier sind einige beliebte Datensätze, die häufig mit hinzugefügtem synthetischem Rauschen zum Benchmarking verwendet werden:
- Kodak24: Dieser Datensatz enthält hochwertige Fotografien natürlicher Szenen, die häufig zum visuellen Vergleich von Entrauschungsergebnissen verwendet werden.
- DIV2K: Dieser hochauflösende Datensatz enthält vielfältige, detailreiche Bilder und wird zur Bewertung der Texturtreue und der allgemeinen Qualität der Bildwiederherstellung verwendet.
Datensätze mit verrauschten Bildern aus der Praxis enthalten dagegen Aufnahmen, die bei schlechten Lichtverhältnissen, hoher ISO-Empfindlichkeit oder anderen schwierigen Bedingungen direkt von Kamerasensoren aufgenommen wurden. Mit diesen Datensätzen wird geprüft, ob ein Modell mit komplexem, nicht gaußschem Rauschen umgehen kann, das sich nicht ohne Weiteres simulieren lässt.
Hier sind einige beliebte Datensätze mit verrauschten Bildern aus der Praxis:
- SIDD: Dieser Datensatz enthält Paare aus verrauschten und rauschfreien Bildern, die mit Smartphone-Sensoren bei unterschiedlichen Lichtverhältnissen aufgenommen wurden.
- DND: Dieser Datensatz enthält Fotografien mit hoher ISO-Empfindlichkeit, die realistische, für Verbraucher-Kameras typische Sensorausprägungen von Rauschen zeigen.
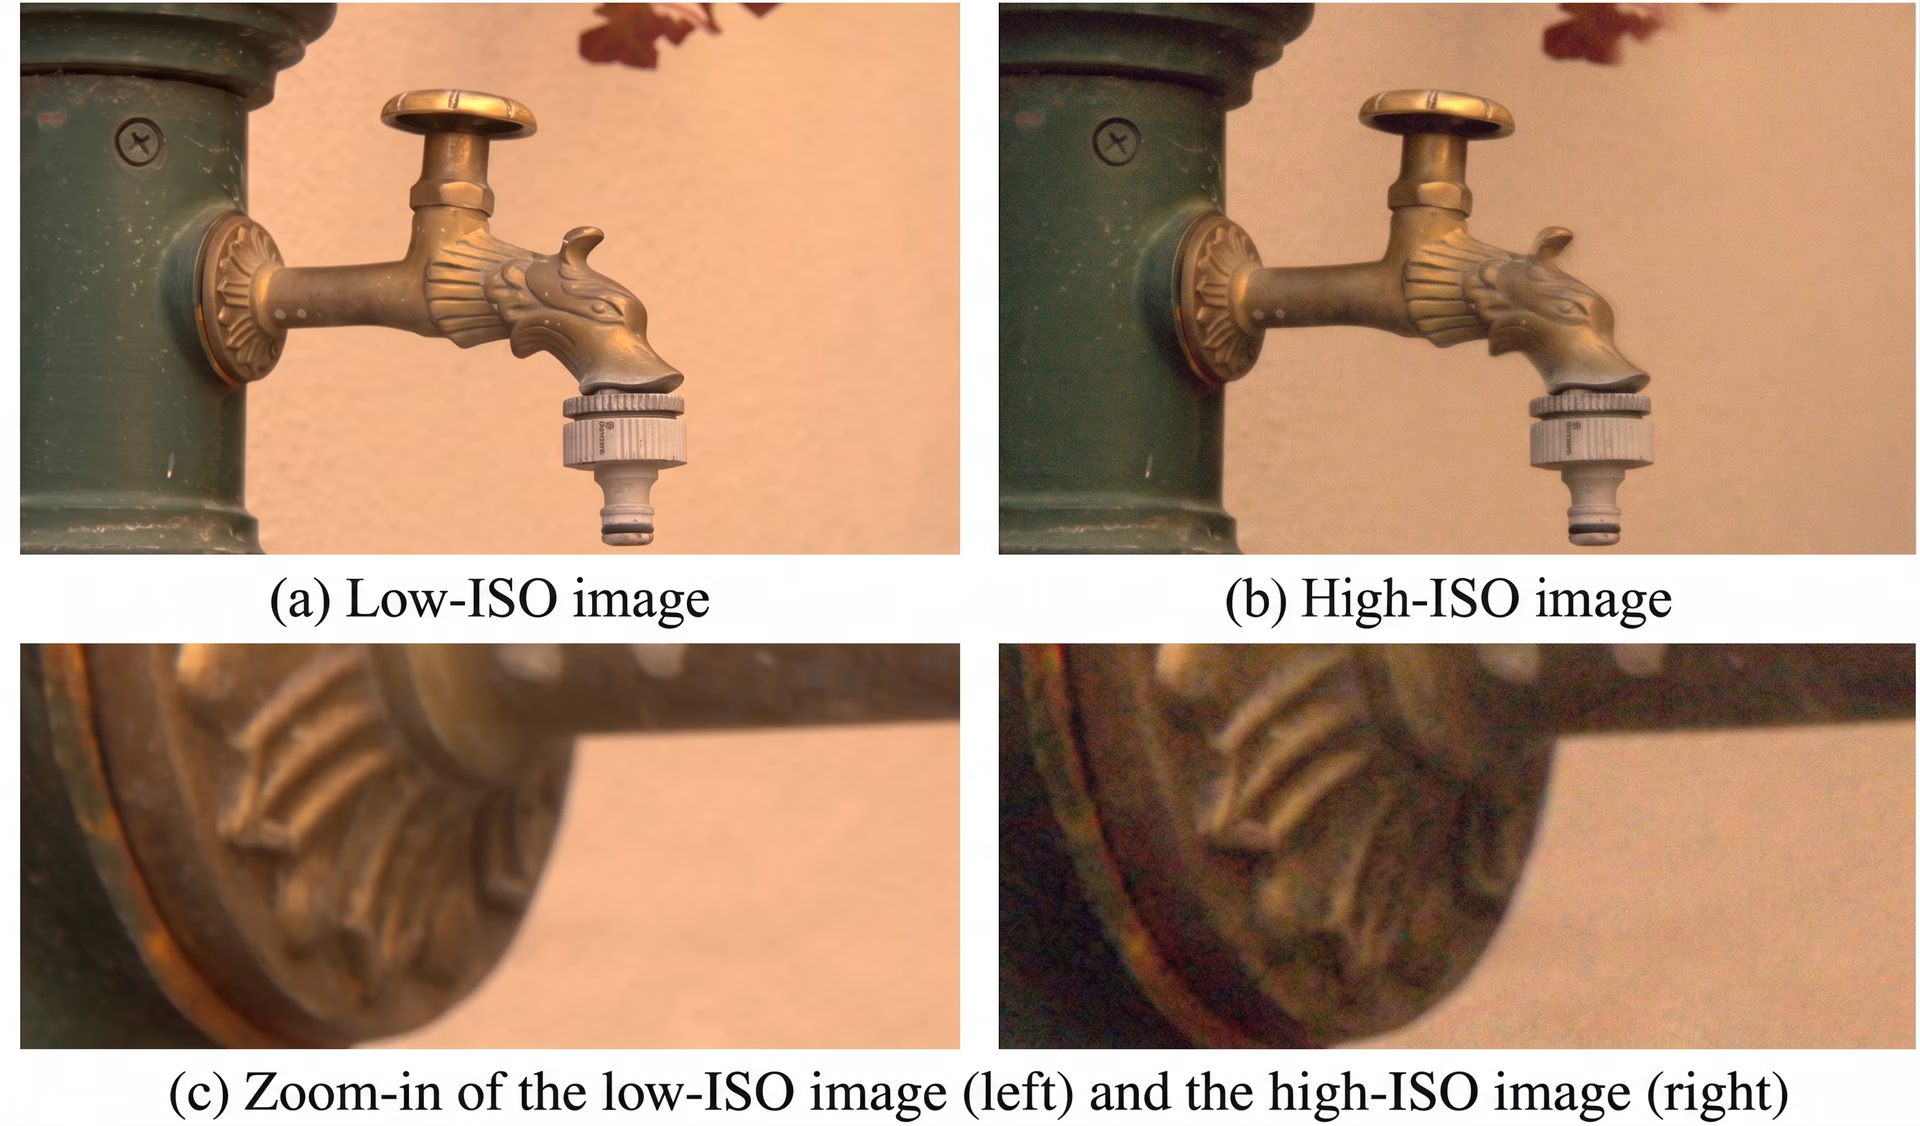
Abb. 4. Ein Beispiel aus dem DND-Datensatz. (Quelle)
Faktoren, die beim Training eines selbstüberwachten Entrauschungsmodells zu berücksichtigen sind#
Hier sind einige Faktoren und Einschränkungen, die du berücksichtigen solltest, wenn du ein selbstüberwachtes, auf Deep Learning basierendes Entrauschungsmodell trainieren möchtest:
- Die Rauschverteilung abstimmen: Die verrauschten Bilder für das Training sollten dem Rauschen entsprechen, dem das Modell im praktischen Einsatz begegnet. Nicht übereinstimmendes Rauschen führt zu einer schlechten Generalisierung.
- Für vielfältige Trainingsdaten sorgen: Eine geringe Vielfalt kann bei komplexen Texturen zu Überanpassung oder übermäßiger Glättung führen.
- Einschränkungen bei der Rauschart beachten: Selbstüberwachte Methoden haben größere Schwierigkeiten mit strukturiertem, korreliertem oder nicht zufälligem Rauschen.
- Mit verschiedenen Geräten oder Sensoren testen: Die Entrauschungsleistung kann je nach Kamera oder Bildgebungssystem stark variieren.
Die wichtigsten Erkenntnisse#
Selbstüberwachtes Entrauschen bietet KI-Begeisterten eine praktische Möglichkeit, Bilder ausschließlich mit den verrauschten Daten zu bereinigen, die bereits vorliegen. Indem diese Methoden lernen, reale Strukturen im Rauschen zu erkennen, können sie wichtige visuelle Details wiederherstellen. Mit den Fortschritten der Entrauschungstechnologie dürfte ein breites Spektrum an Computer-Vision-Aufgaben im Alltag zuverlässiger werden.
Werde Teil unserer wachsenden Community! Entdecke unser GitHub-Repository, um mehr über KI zu erfahren. Wenn du Computer-Vision-Lösungen entwickeln möchtest, sieh dir unsere Lizenzoptionen an. Erfahre mehr über die Vorteile von Computer Vision im Einzelhandel und entdecke, wie KI in der Fertigung etwas bewirkt!
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









