Was ist monokulare Tiefenschätzung? Ein Überblick
Erfahre, wie die monokulare Tiefenschätzung funktioniert, wie sie sich von sensorbasierten Tiefenmessverfahren unterscheidet und wie sie eine skalierbare 3D-Wahrnehmung in Bildverarbeitungssystemen ermöglicht.
 Abirami Vina17 Min. Lesezeit
Selbstfahrende Autos sollen verstehen, was um sie herum geschieht, damit sie sicher fahren können. Dafür reicht es nicht, einfach nur Objekte wie Fußgänger oder andere Fahrzeuge zu erkennen.
Sie müssen außerdem wissen, wie weit diese Objekte entfernt sind, um richtig reagieren zu können. Maschinen diesen Entfernungssinn zu vermitteln, ist jedoch nicht einfach. Anders als Menschen nehmen sie Tiefe in Bildern nicht von selbst wahr und müssen ausdrücklich lernen, dies zu tun.
Ein Grund dafür ist, dass die meisten Kameras die Welt als flache, zweidimensionale Bilder aufnehmen. Diese Bilder so umzuwandeln, dass sie die Tiefe und die dreidimensionale Struktur der realen Welt widerspiegeln, ist anspruchsvoll – besonders, wenn Systeme unter Alltagsbedingungen zuverlässig funktionieren müssen.
Interessanterweise ermöglicht Computer Vision, ein Bereich der KI, der sich mit der Interpretation und dem Verständnis visueller Daten befasst, Maschinen, die Welt anhand von Bildern besser zu erfassen. Die monokulare Tiefenschätzung ist beispielsweise eine Computer-Vision-Technik, mit der die Entfernung von Objekten anhand eines einzelnen Kamerabilds geschätzt wird.
Indem diese Modelle visuelle Merkmale wie Objektgröße, Perspektive, Textur und Schattierung erlernen, können sie die Tiefe vorhersagen, ohne auf zusätzliche Sensoren wie LiDAR (Lichterkennung und Entfernungsmessung) oder Stereokameras angewiesen zu sein. In diesem Artikel sehen wir uns an, was monokulare Tiefenschätzung ist, wie sie funktioniert und in welchen realen Anwendungen sie zum Einsatz kommt.
Eine kurze Einführung in die monokulare Tiefenschätzung#
Die monokulare Tiefenschätzung ermöglicht es einer Maschine, allein anhand eines einzelnen Bildes zu erfassen, wie weit Objekte von ihr entfernt sind. Da dieser Ansatz nur eine Kamera benötigt, bietet er mehrere Vorteile, darunter geringere Kosten und einfachere Hardwareanforderungen.
Sie kann beispielsweise in kostengünstigen Haushaltsrobotern eingesetzt werden, die mit einer einzigen Kamera arbeiten. Selbst anhand eines einzelnen Bildes kann das Robotersystem erkennen, welche Wände näher und welche Türen weiter entfernt sind, und die Gesamttiefe des Raums ableiten.
Ein einzelnes Bild enthält häufig keine Angaben zum tatsächlichen Maßstab. Deshalb konzentriert sich die monokulare Tiefenschätzung im Allgemeinen auf die relative Tiefe. Anders gesagt: Sie kann bestimmen, welche Objekte näher und welche weiter entfernt sind, auch wenn die genauen Entfernungen unbekannt sind.
Wird ein Modell mit Daten trainiert, die Referenzwerte für Entfernungen oder absolute Tiefen enthalten – etwa Tiefenmessungen von Sensoren wie LiDAR –, kann es lernen, Entfernungen in realen Maßeinheiten wie Metern vorherzusagen. Ohne solche Referenzdaten kann das Modell weiterhin relative Tiefen ableiten, absolute Entfernungen jedoch nicht zuverlässig schätzen.
Das Ergebnis der monokularen Tiefenschätzung ist normalerweise eine Tiefenkarte. Dabei handelt es sich um ein Bild, in dem jeder Pixel angibt, wie nah oder fern der entsprechende Teil der Szene ist. Eine Tiefenkarte vermittelt Bildverarbeitungssystemen ein grundlegendes Verständnis der dreidimensionalen Struktur ihrer Umgebung.
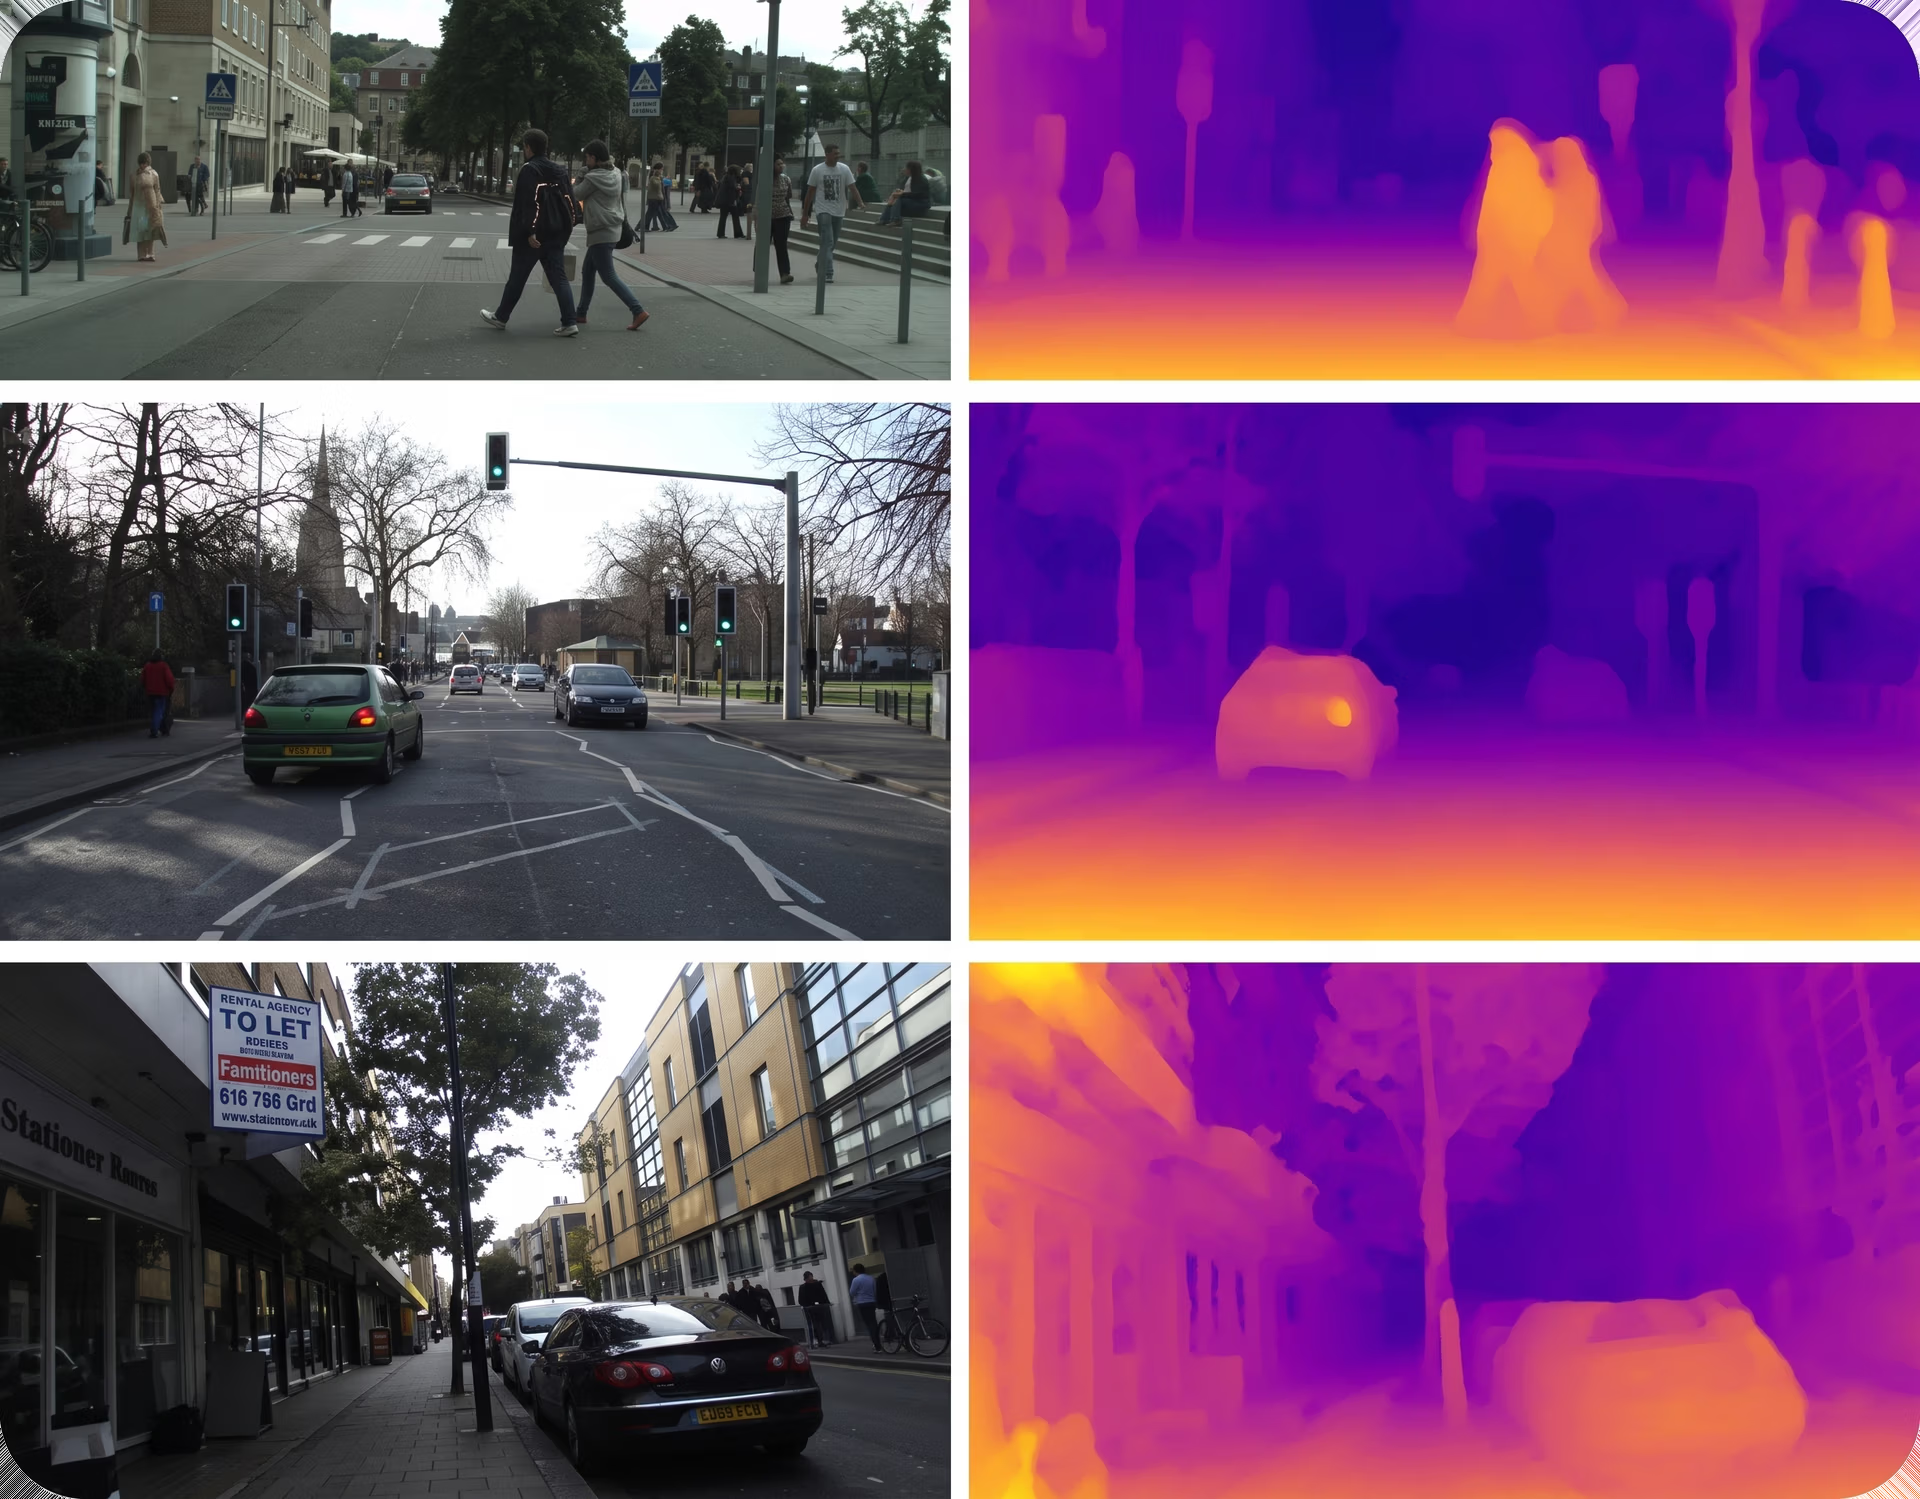
Abb. 1. Beispiel einer vorhergesagten Tiefenkarte, die mit monokularer Tiefenschätzung erstellt wurde (Quelle)
Von Sensoren zu Bildern: Tiefe schätzen#
Je nach verfügbaren Sensoren, Hardwarebeschränkungen und Genauigkeitsanforderungen gibt es verschiedene Ansätze zur Tiefenschätzung. Traditionelle Methoden nutzen häufig mehrere Blickwinkel oder spezielle Sensoren, um Entfernungen direkt zu messen.
Ein verbreiteter Ansatz ist das Stereo-Sehen, bei dem die Tiefe durch den Vergleich zweier synchronisierter Bilder geschätzt wird, die aus leicht unterschiedlichen Blickwinkeln aufgenommen wurden. Indem das System die Unterschiede zwischen korrespondierenden Punkten in den beiden Bildern misst, kann es ableiten, wie weit Objekte von der Kamera entfernt sind.
Ein weiterer Ansatz sind RGB-D-Systeme (Systeme mit Rot-, Grün-, Blau- und Tiefenkanal), die aktive Tiefensensoren verwenden, um die Entfernung an jedem Pixel direkt zu messen. Diese Systeme können in kontrollierten Umgebungen genaue Tiefeninformationen liefern, benötigen jedoch zusätzliche Hardware.
LiDAR-basierte Verfahren nutzen Laserimpulse, um präzise dreidimensionale Darstellungen einer Szene zu erzeugen. LiDAR-Sensoren sind zwar sehr genau, aber häufig teuer und erhöhen die Hardwarekomplexität erheblich.
Im Gegensatz dazu leitet die monokulare Tiefenschätzung die Tiefe allein aus einem einzelnen RGB-Bild ab. Da sie weder mehrere Kameras noch spezielle Sensoren benötigt, lässt sie sich leichter in großem Maßstab einsetzen und eignet sich gut, wenn Kosten und Hardware-Ressourcen begrenzt sind.
Tiefe aus einem einzelnen Bild lernen#
Bei der Schätzung der Tiefe anhand eines einzelnen Bildes lernen monokulare Tiefenmodelle, visuelle Hinweise zu erkennen, die Menschen instinktiv zur Einschätzung von Entfernungen nutzen. Dazu gehören Perspektivlinien, Objektgröße, Texturdichte, Überlappungen von Objekten und Schattierungen – all dies gibt Hinweise darauf, wie weit Objekte von der Kamera entfernt sind.
Diese Hinweise wirken zusammen und erzeugen einen Tiefeneindruck. Kleiner erscheinende oder teilweise verdeckte Objekte sind häufig weiter entfernt, während deutlichere Details und eine größere visuelle Erscheinung meist darauf hindeuten, dass etwas näher ist.
Um diese Muster zu lernen, werden monokulare Tiefenmodelle mit umfangreichen Bilddatensätzen trainiert, die häufig mit Tiefeninformationen aus anderen Quellen wie LiDAR- oder Stereosystemen ergänzt werden. Während des Trainings lernen die Modelle, wie visuelle Hinweise mit Tiefe zusammenhängen. So können sie bei der Inferenz Entfernungen anhand eines einzelnen Bildes ableiten.
Mit vielfältigen Trainingsdaten können moderne Bildverarbeitungsmodelle dieses erlernte Verständnis auf ein breites Spektrum von Umgebungen übertragen, darunter Innen- und Außenszenen, und auch mit unbekannten Blickwinkeln umgehen.
Ein Überblick über verschiedene Verfahren zur monokularen Tiefenschätzung#
Als Nächstes betrachten wir die wichtigsten Ansätze zur Tiefenschätzung anhand eines einzelnen Bildes und ihre Weiterentwicklung im Laufe der Zeit.
Klassische und geometriebasierte Ansätze#
Frühe Verfahren zur Tiefenschätzung stützten sich auf einfache visuelle Regeln im Zusammenhang mit der Kamerageometrie. Hinweise wie Perspektive, Objektgröße und die Verdeckung eines Objekts durch ein anderes dienten zur Schätzung der Entfernung.
Wenn beispielsweise zwei ähnliche Objekte unterschiedlich groß erschienen, nahm man an, dass sich das kleinere weiter entfernt befand. In kontrollierten Umgebungen funktionierten diese Ansätze recht gut, solange Faktoren wie Beleuchtung, Kameraposition und Szenenaufbau gleich blieben.
In realen Szenen versagen diese Annahmen jedoch häufig. Unterschiede bei der Beleuchtung, Änderungen des Blickwinkels und eine höhere Szenenkomplexität können zu unzuverlässigen Tiefenschätzungen führen und die Wirksamkeit klassischer Verfahren in unkontrollierten Umgebungen einschränken.
Frühe Ansätze des maschinellen Lernens#
Frühe Verfahren des maschinellen Lernens machten die Tiefenschätzung flexibler, indem sie Muster direkt aus Daten lernten. Statt sich ausschließlich auf feste geometrische Regeln zu verlassen, versuchten diese Modelle, den Zusammenhang zwischen visuellen Informationen und Entfernungen zu erlernen. Dazu behandelten sie die Tiefenvorhersage anhand von Hinweisen wie Kanten, Texturen und Farbänderungen als Regressionsproblem.
Die Auswahl dieser Merkmale war ein wichtiger Teil des Prozesses. Ingenieure mussten entscheiden, welche visuellen Signale extrahiert und wie sie dargestellt werden sollten. Die Leistung des Modells hing stark von diesen Entscheidungen ab.
Obwohl dieser Ansatz besser funktionierte als frühere Verfahren, hatte er weiterhin Grenzen. Fehlte den ausgewählten Merkmalen wichtiger Kontext, waren die Tiefenvorhersagen weniger genau. Mit zunehmender Komplexität und Vielfalt der Szenen hatten diese Modelle häufig Schwierigkeiten, zuverlässige Ergebnisse zu liefern.
Algorithmen des Deep Learning#
Die meisten modernen Systeme zur monokularen Tiefenschätzung verwenden Deep Learning. Darunter versteht man neuronale Netze mit vielen Schichten, die komplexe Muster aus Daten lernen können. Diese Modelle lernen, die Tiefe direkt aus Bildern vorherzusagen und Tiefenkarten zu erstellen.
Viele Ansätze basieren auf Faltungsnetzwerken (CNNs), einer Art neuronaler Netze, die Bilder verarbeiten, indem sie Muster wie Kanten und Formen erkennen. Diese Modelle verwenden häufig einen Encoder-Decoder-Aufbau: Der Encoder extrahiert visuelle Merkmale aus dem Bild, und der Decoder wandelt diese Merkmale in eine Tiefenkarte um. Die Verarbeitung des Bildes in mehreren Maßstäben hilft dem Modell, sowohl den Gesamtaufbau der Szene als auch klare Objektgrenzen zu erfassen.
Neuere Modelle konzentrieren sich darauf, Beziehungen zwischen verschiedenen Bildbereichen zu verstehen. Transformer-basierte Modelle und Vision Transformer (ViT)-Modelle verwenden Aufmerksamkeitsmechanismen. Dadurch kann das Modell erkennen, welche Bildbereiche am relevantesten sind, und entfernte Bereiche miteinander in Beziehung setzen. So kann es ein konsistenteres Verständnis der Tiefe in der gesamten Szene aufbauen.
Einige Systeme verbinden beide Ansätze. Hybride CNN-Transformer-Modelle nutzen CNNs, um feine lokale Details zu erfassen, und Transformer, um den globalen Szenenkontext zu modellieren. Das verbessert häufig die Genauigkeit, erfordert in der Regel aber mehr Rechenressourcen, etwa zusätzlichen Speicher und Rechenleistung.
Warum das Tiefenverständnis für Vision-AI-Systeme wichtig ist#
Wenn du dich mit monokularer Tiefenschätzung beschäftigst, fragst du dich vielleicht, warum das Verständnis von Tiefe für KI-Systeme mit visueller Wahrnehmung so wichtig ist.
Kann ein System abschätzen, wie weit Objekte und Oberflächen entfernt sind, versteht es besser, wie eine Szene aufgebaut ist und wie verschiedene Elemente zueinander stehen. Dieses räumliche Verständnis ist entscheidend für zuverlässige Entscheidungen, insbesondere in realen Anwendungen wie dem autonomen Fahren.
Tiefeninformationen liefern auch wertvollen Kontext für andere Computer-Vision-Aufgaben. Die Objekterkennung, die Modelle wie Ultralytics YOLO26 unterstützen, kann einem System beispielsweise sagen, was in einer Szene vorhanden ist. Die Tiefe hilft jedoch zu bestimmen, wo sich diese Objekte relativ zur Kamera und zueinander befinden.
Zusammen ermöglichen diese Fähigkeiten vielfältige Anwendungen von Vision AI, etwa den Aufbau von 3D-Karten, die Navigation in komplexen Umgebungen und das ganzheitliche Verständnis einer Szene.
Roboter und autonome Fahrzeuge sind auf diese Informationen angewiesen, um sich sicher zu bewegen, Hindernissen auszuweichen und in Echtzeit auf Veränderungen zu reagieren. So setzt beispielsweise Teslas Ansatz für autonomes Fahren allein mit visuellen Daten auf Kamerabilder in Kombination mit Tiefenschätzung statt auf LiDAR, um zu erfassen, wie weit Objekte entfernt sind und wo sie sich auf der Straße befinden.
Wie Modelle zur monokularen Tiefenschätzung funktionieren#
Auch wenn sich die Modellarchitekturen unterscheiden, gehen die meisten Modelle zur monokularen Tiefenschätzung ähnlich vor, um ein einzelnes Bild in eine Tiefenkarte umzuwandeln. Hier ein kurzer Überblick über die wichtigsten Schritte:
- Eingabe und Vorverarbeitung: Der Arbeitsablauf beginnt mit einem Eingabebild. Bevor es dem Modell zugeführt wird, wird das Originalbild üblicherweise in der Größe angepasst, normalisiert und in einen Tensor umgewandelt – ein Format, mit dem neuronale Netze Bilddaten effizient verarbeiten können.
- Merkmalsextraktion: Ein Encoder-Netzwerk analysiert das Bild und extrahiert aussagekräftige visuelle Merkmale. Diese Merkmale erfassen Informationen wie Texturen, Objektgrenzen und den Gesamtaufbau der Szene. Die meisten Modelle arbeiten mit mehreren Maßstäben, damit sie sowohl feine Details als auch die Gesamtstruktur erfassen können.
- Tiefenableitung: Anhand der extrahierten Merkmale verbindet das Modell lokale Details mit dem globalen Kontext, um räumliche Beziehungen in der Szene abzuleiten. In diesem Schritt lernt es, welche Bildbereiche näher an der Kamera und welche weiter entfernt sind.
- Erzeugung der Tiefenkarte: Anschließend wandelt ein Decoder diese Informationen in eine dichte Tiefenkarte um. Jedem Pixel im Bild wird ein Tiefenwert zugewiesen. Häufig werden Vorhersagen aus verschiedenen Maßstäben kombiniert, um Genauigkeit und Konsistenz zu verbessern.
Wie Modelle zur monokularen Tiefenschätzung trainiert werden#
Der gerade beschriebene Prozess setzt voraus, dass bereits ein trainiertes oder vortrainiertes Modell vorliegt. Doch wie funktioniert das Training eines Modells zur monokularen Tiefenschätzung eigentlich?
Das Training beginnt mit der Aufbereitung der Bilddaten, damit das Netzwerk sie effizient verarbeiten kann. Die Eingabebilder werden auf eine einheitliche Größe gebracht und normalisiert. Anschließend durchlaufen sie das Modell, das eine vorhergesagte Tiefenkarte mit Schätzungen der Entfernung für jeden Pixel erzeugt.
Anschließend wird die vorhergesagte Tiefenkarte mithilfe einer Verlustfunktion mit Referenztiefendaten verglichen. Die Verlustfunktion misst, wie stark die Vorhersage des Modells von der tatsächlichen Tiefe abweicht. Dieser Verlustwert gibt den aktuellen Fehler des Modells an und liefert einen Ansatzpunkt für Verbesserungen.
Ein Optimierer nutzt dieses Signal, um das Modell anzupassen, indem er seine internen Gewichte verändert. Dazu berechnet der Optimierer den Gradienten, der beschreibt, wie sich der Verlust in Abhängigkeit von den einzelnen Modellparametern verändert. Diese Anpassungen werden über mehrere Epochen – also vollständige Durchläufe durch den Trainingsdatensatz – wiederholt angewendet.
Dieser iterative, überwachte Trainingsprozess wird durch Hyperparameter wie die Lernrate gesteuert, die die Größe jedes Aktualisierungsschritts bestimmt, und die Batchgröße, die festlegt, wie viele Bilder gleichzeitig verarbeitet werden. Da beim Training zahlreiche mathematische Berechnungen anfallen, wird es üblicherweise mit einer Grafikprozessoreinheit (GPU) beschleunigt, die sich hervorragend für parallele Berechnungen eignet.
Nach Abschluss des Trainings wird das Modell anhand gängiger Bewertungsmetriken mit einem Validierungsdatensatz geprüft. Dieser besteht aus Bildern, die nicht während des Trainings verwendet wurden. Die Auswertung hilft dabei, zu ermitteln, wie gut sich das Modell auf neue Daten übertragen lässt.
Anschließend kann das trainierte Modell wiederverwendet oder für neue Szenarien feinabgestimmt werden. Insgesamt ermöglicht dieser Trainingsprozess Modellen zur monokularen Tiefenschätzung, konsistente Tiefenschätzungen zu erstellen, die für nachgelagerte Aufgaben wie die 3D-Rekonstruktion und den Einsatz in der Praxis unerlässlich sind.
Ein Blick auf hochmoderne Modelle und aktuelle Forschungstrends#
Die monokulare Tiefenschätzung hat sich rasant weiterentwickelt, da Modelle immer besser darin wurden, ganze Szenen statt nur kleiner visueller Details zu verstehen. Frühere Ansätze erzeugten häufig ungleichmäßige Tiefenkarten, besonders in komplexen Umgebungen.
Neuere Modelle, wie sie in aktuellen Forschungsarbeiten auf arXiv zu sehen sind, berücksichtigen stärker den globalen Kontext. Dadurch wirken die Tiefenvorhersagen stabiler und realistischer. Bekannte Modelle wie MiDaS und DPT haben diesen Wandel vorangetrieben, indem sie Tiefe anhand vielfältiger, hochauflösender Datensätze erlernten und sich gut auf viele Szenen übertragen ließen.
Neuere Modelle, darunter ZoeDepth und Depth Anything V2, bauen auf dieser Arbeit auf und verbessern die Konsistenz der Maßstäbe, während sie in einer Vielzahl von Umgebungen leistungsfähig bleiben. Diese Fortschritte werden häufig anhand gängiger Benchmark-Datensätze wie KITTI und NYU Depth V2 gemessen, die sowohl Außen- als auch Innenbereiche abdecken.
Ein weiterer klarer Trend ist, Genauigkeit und Praxistauglichkeit miteinander in Einklang zu bringen. Kleinere Modelle sind auf Geschwindigkeit optimiert und können in Echtzeit auf Edge- oder Mobilgeräten ausgeführt werden, während größere Modelle eine höhere Auflösung und genaue Tiefenschätzungen über größere Entfernungen bieten. Die Tiefenmodelle Ultralytics YOLO26 reichen beispielsweise vom leichten YOLO26n-depth für Echtzeiteinsätze am Netzwerkrand bis zum größeren und genaueren YOLO26x-depth.
Anwendungen der monokularen Tiefenschätzung#
Als Nächstes sehen wir uns Beispiele aus der Praxis an, die zeigen, wie die monokulare Tiefenschätzung anhand eines einzelnen Bildes Rückschlüsse auf die dreidimensionale Struktur einer Szene ermöglicht.
Bei allen diesen Anwendungen solltest du beachten, dass es sich bei den Tiefeninformationen um Schätzungen handelt, die aus visuellen Hinweisen abgeleitet werden, nicht um präzise Messwerte. Deshalb eignet sich die monokulare Tiefenschätzung zwar dazu, relative Anordnungen und räumliche Beziehungen zu verstehen, ersetzt aber keine Sensoren zur genauen Entfernungsmessung wie LiDAR oder Stereosysteme.
Kartierung von Gelände und Navigation mit Drohnen#
Drohnen sind häufig in Umgebungen unterwegs, in denen GPS-Signale unzuverlässig sind, etwa in Wäldern, auf Baustellen, in Katastrophengebieten oder in dicht bebauten Städten. Um dort sicher zu fliegen, müssen sie das umliegende Gelände erfassen und wissen, wie weit Hindernisse entfernt sind. Früher waren dafür oft zusätzliche Sensoren wie LiDAR oder Stereokameras nötig, die Gewicht, Stromverbrauch und Gesamtkosten erhöhen.
Die monokulare Tiefenschätzung ist eine einfachere Alternative. Mithilfe einer einzelnen RGB-Kamera können Drohnen die Tiefe anhand von Bildern schätzen und ein grundlegendes dreidimensionales Verständnis ihrer Umgebung aufbauen. So können sie Hindernisse wie Gebäude und Bäume oder plötzliche Geländeänderungen erkennen und ihre Flugbahn in Echtzeit anpassen.
Diese Tiefenschätzungen unterstützen wichtige Navigationsaufgaben wie die Hindernisvermeidung, die Höhensteuerung und die sichere Landung. Dadurch können leichte Drohnen Kartierungs-, Inspektions- und Navigationsaufgaben ausführen, ohne auf spezielle Tiefensensoren angewiesen zu sein.
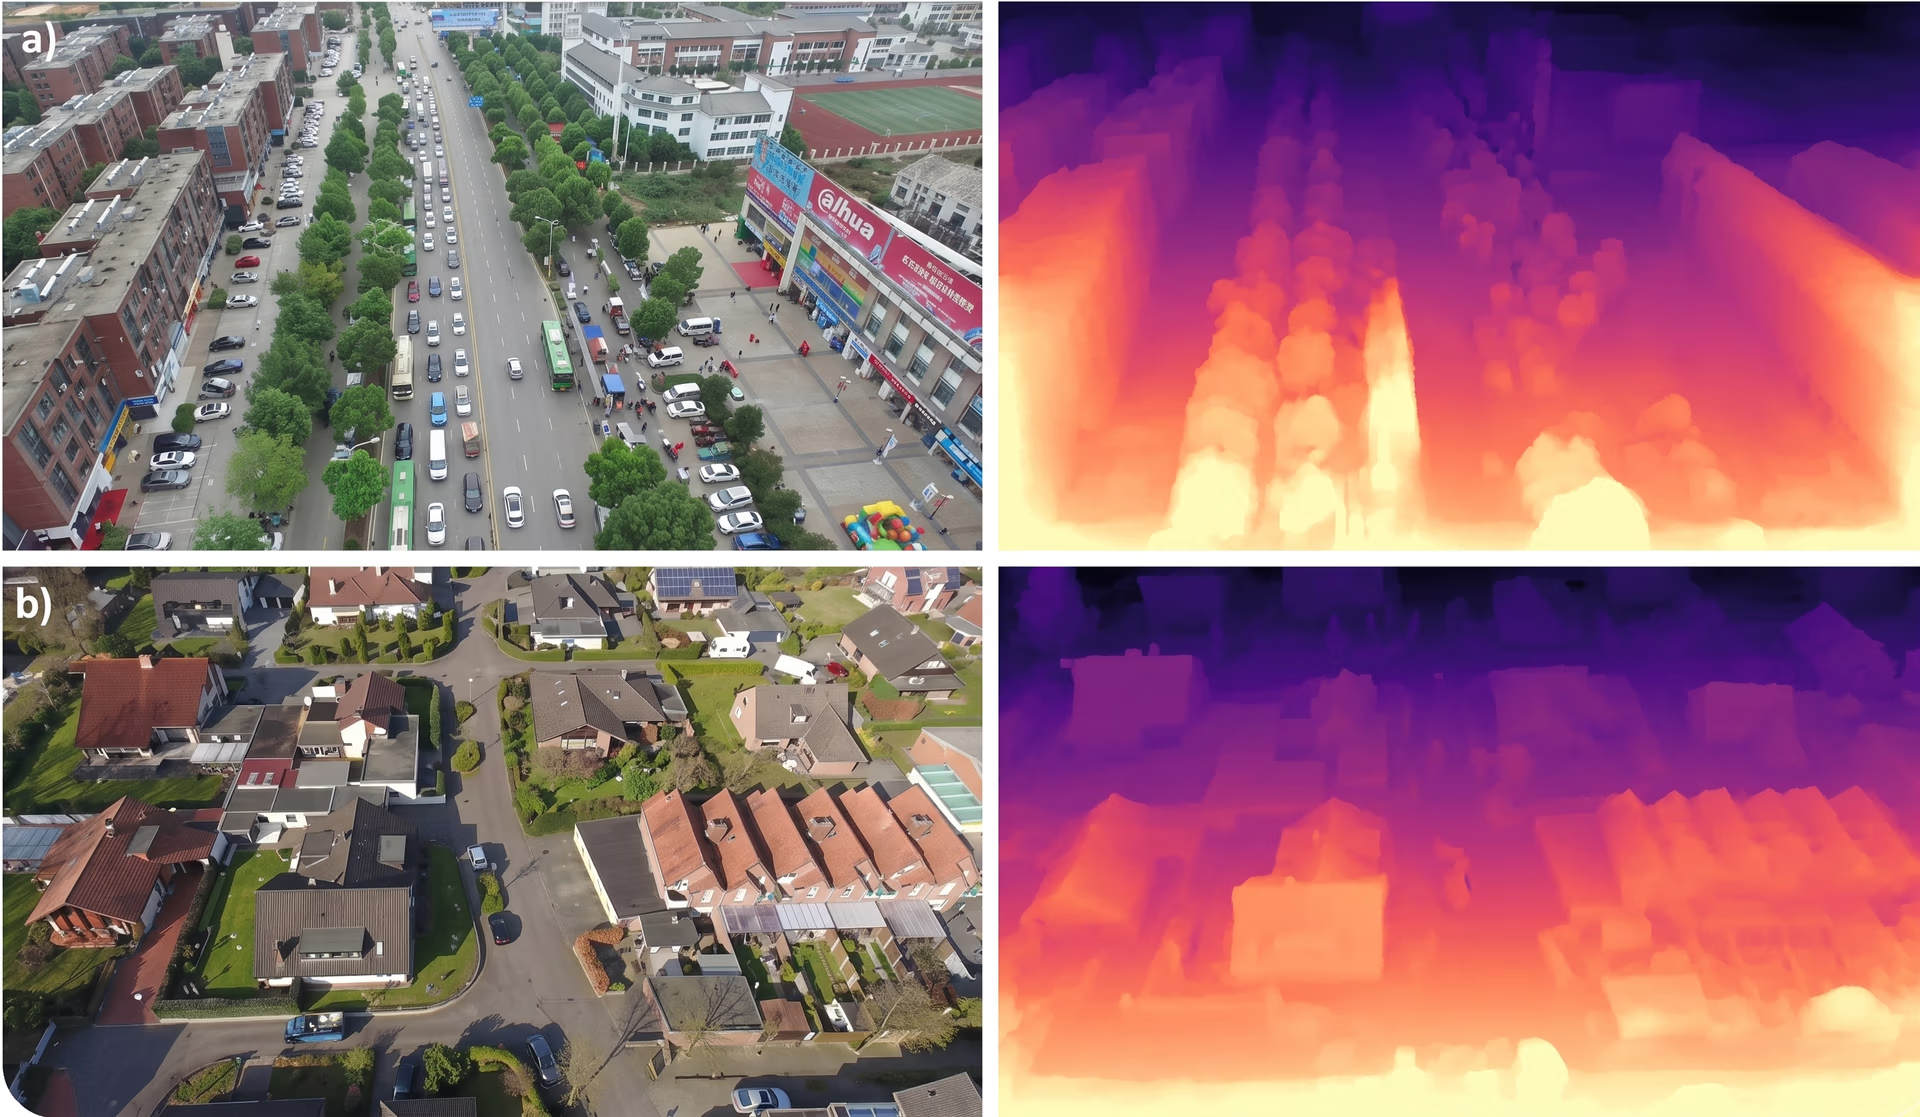
Abb. 2. Monokulare Tiefenschätzung kann zur Analyse von Drohnenaufnahmen eingesetzt werden (Quelle)
Tote Winkel bei autonomen Rennfahrzeugen ausgleichen#
Autonome Fahrzeuge sind meist stark auf LiDAR-Sensoren angewiesen. Diese nutzen Laserimpulse, um Entfernungen zu messen und eine dreidimensionale Darstellung der Straße zu erstellen. LiDAR ist zwar sehr genau, kann aber bei scharfen Kuppen, steilen Gefällen, Verdeckungen oder plötzlichem Nicken des Fahrzeugs Probleme haben. Dabei entstehen mitunter lückenhafte oder fehlende Tiefendaten.
Die monokulare Tiefenschätzung kann diese Lücken schließen, indem sie dichte Tiefeninformationen aus einem einzelnen RGB-Bild liefert, selbst wenn die LiDAR-Daten unvollständig sind. Stell dir ein Szenario vor, in dem sich ein selbstfahrendes Auto mit hoher Geschwindigkeit einer Bergkuppe nähert. LiDAR-Strahlen können über die Straße hinter der Kuppe hinausschießen und so Ungewissheit darüber lassen, was vor dem Fahrzeug liegt.
Die kamerabasierte Tiefenschätzung kann jedoch anhand visueller Hinweise wie Perspektive und Textur weiterhin die Straßenform ableiten und dem Fahrzeug so helfen, eine zuverlässige Wahrnehmung aufrechtzuerhalten, bis sich die LiDAR-Daten stabilisieren. Gemeinsam ermöglichen LiDAR und monokulare Tiefenschätzung eine stabilere Wahrnehmung und sicherere Steuerung unter schwierigen Fahrbedingungen.
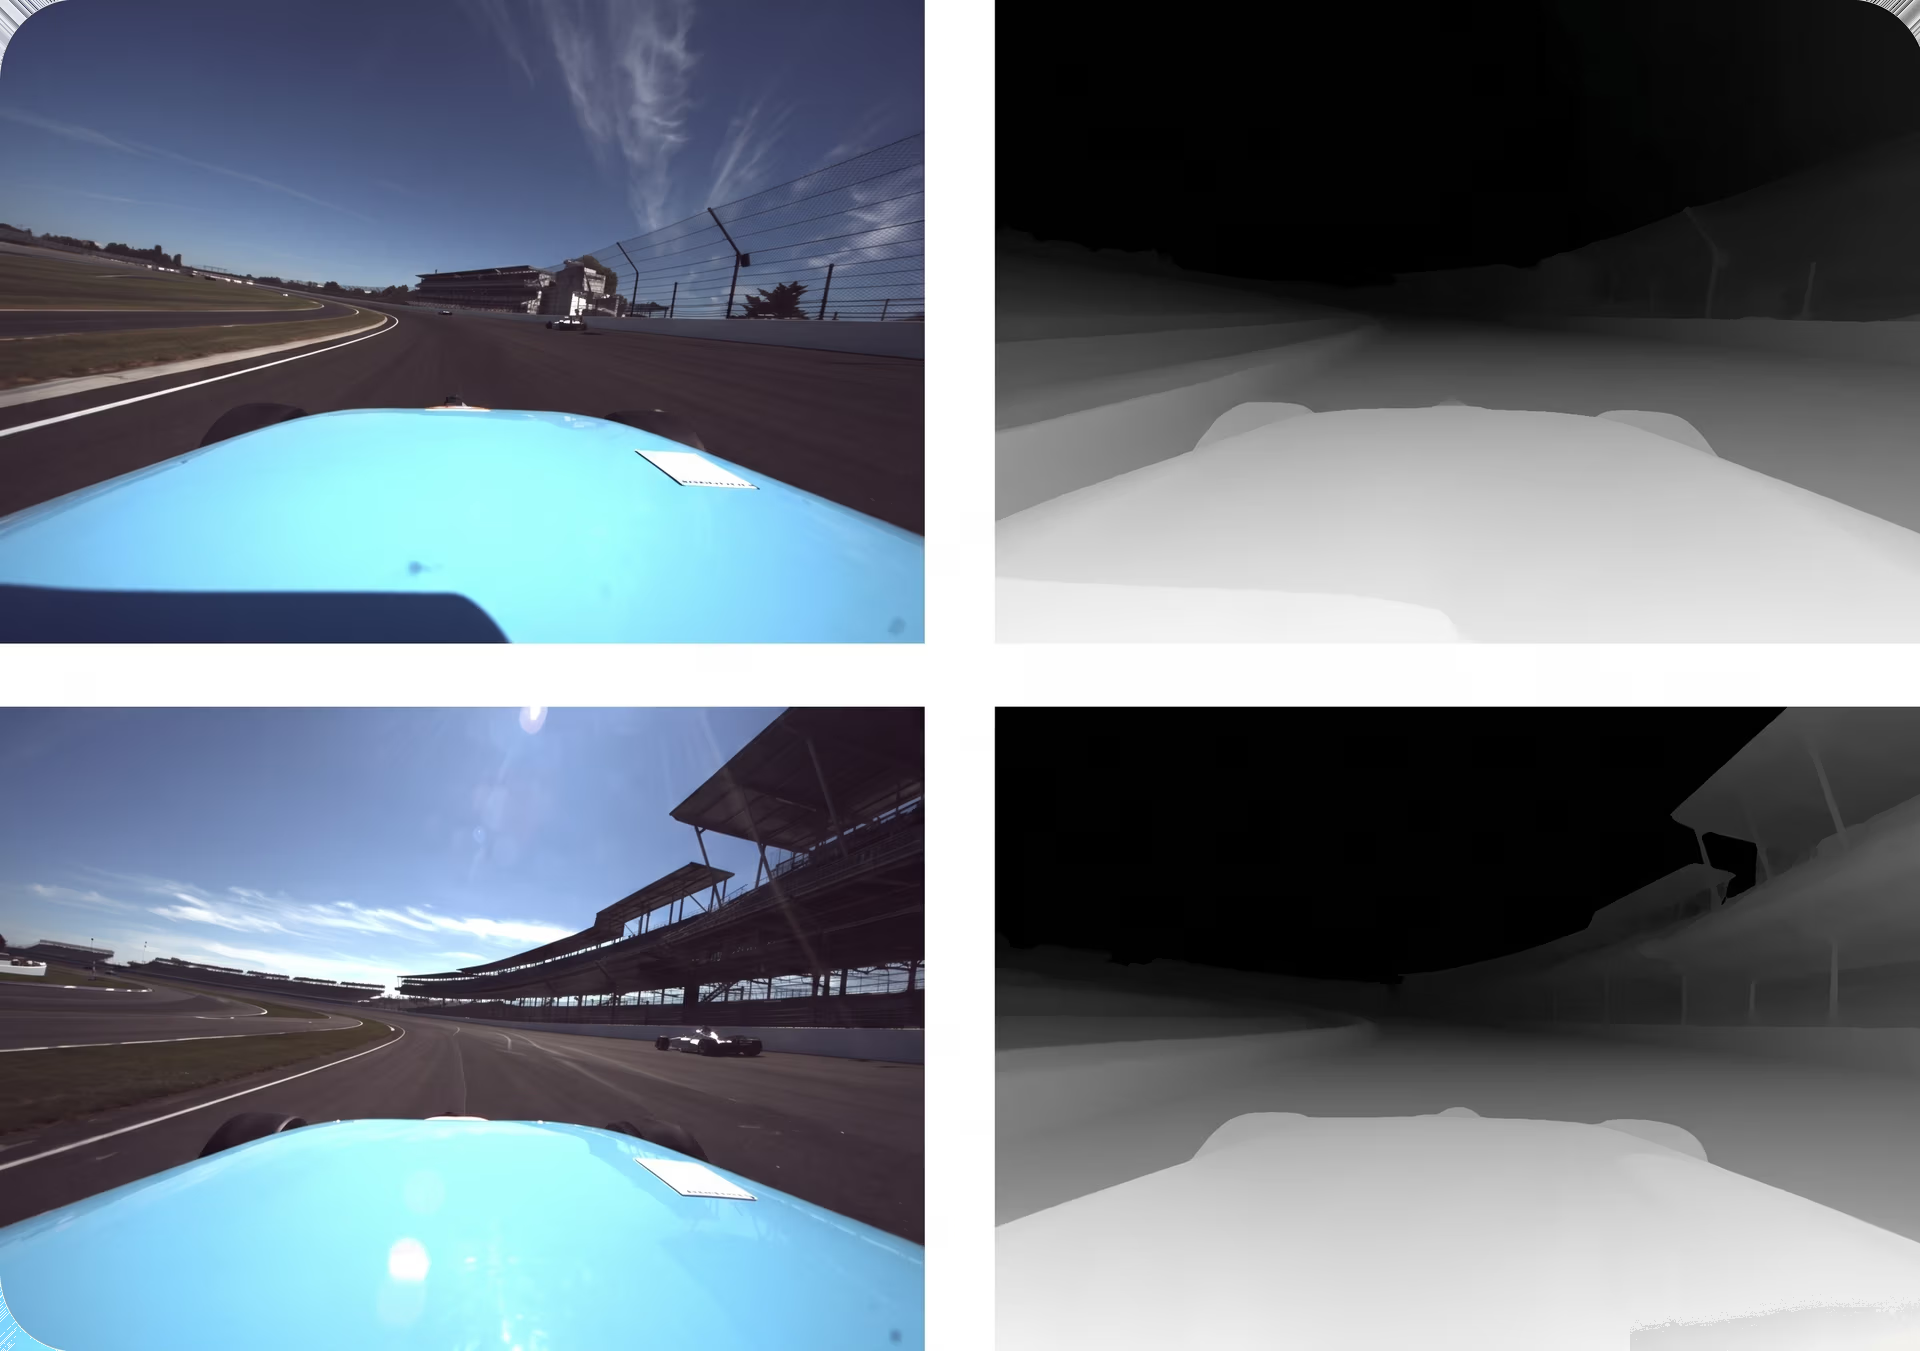
Abb. 3. Visualisierung der monokularen Tiefenschätzung im autonomen Rennsport (Quelle)
Roboternavigation und Hindernisvermeidung#
Roboter werden häufig an Orten eingesetzt, an denen keine detaillierten Karten verfügbar sind und sich die Bedingungen ständig ändern. Um sich sicher fortzubewegen, müssen sie zuverlässig einschätzen können, wie viel Platz sie um sich herum haben und wo sich Hindernisse befinden.
Die monokulare Tiefenschätzung kann dieses räumliche Bewusstsein mithilfe einer einzelnen RGB-Kamera ermöglichen, ohne auf schwere oder teure Hardware angewiesen zu sein. Indem sie visuelle Hinweise wie Maßstab und Perspektive lernt, können Tiefenschätzungsmodelle dichte Tiefenkarten der Umgebung erstellen. So erhalten Roboter einen klaren Überblick über die Entfernung zu Oberflächen und Objekten.
Wenn Tiefeninformationen mit Computer-Vision-Aufgaben wie der Objekterkennung und der semantischen Segmentierung kombiniert werden, erhalten Roboter einen vollständigeren Überblick über ihre Umgebung. Sie können Objekte erkennen, deren Entfernung einschätzen und entscheiden, wohin sie sich sicher bewegen können. Das ermöglicht Hindernisvermeidung, die Erkennung freier Flächen und die Routenplanung in Echtzeit.
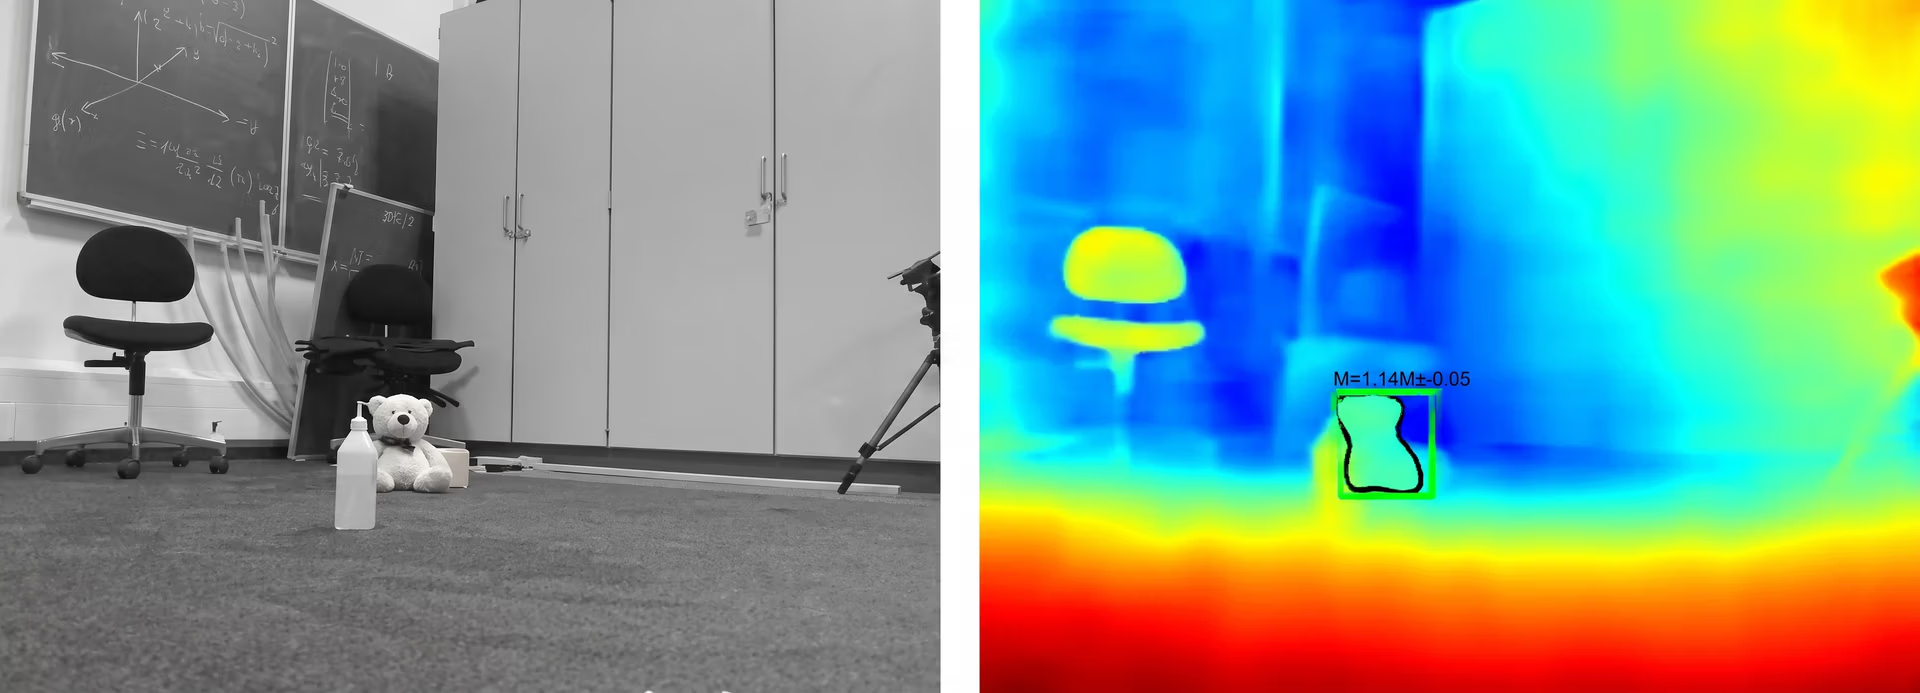
Abb. 4. Erkennung von Objekten mithilfe monokularer Tiefenschätzung und Objekterkennung (Quelle)
Vor- und Nachteile der monokularen Tiefenschätzung#
Hier sind einige der wichtigsten Vorteile der monokularen Tiefenschätzung:
- Geringes Gewicht und niedriger Energieverbrauch: Eine einzelne Kamera verringert das Systemgewicht und den Energieverbrauch. Das ist besonders wichtig für mobile Roboter, Drohnen und eingebettete Systeme.
- Gut mit Sensorfusion kombinierbar: Die monokulare Tiefenschätzung kann andere Sensoren wie LiDAR oder Radar ergänzen, indem sie Lücken schließt oder zusätzliche Redundanz bietet.
- In vielen Umgebungen einsetzbar: Derselbe kamerabasierte Ansatz lässt sich in Innenräumen, im Freien und auf verschiedenen Plattformen nutzen, ohne dass Änderungen an der Hardware erforderlich sind.
Die monokulare Tiefenschätzung bietet zwar klare Vorteile, doch es gibt einige Einschränkungen, die du berücksichtigen solltest:
- Geringere Genauigkeit als bei aktiven Sensoren: Obwohl sich die monokulare Tiefenschätzung rasch verbessert, erreicht sie unter kontrollierten Bedingungen in der Regel nicht die absolute Genauigkeit von LiDAR oder Sensoren mit strukturiertem Licht.
- Empfindlichkeit gegenüber Lichtverhältnissen: Bei schwachem Licht, starken Schatten, Blendung oder Szenen mit wenig Textur kann die Leistung nachlassen.
- Herausforderungen bei der Generalisierung: Ein in einer Umgebung trainiertes Modell lässt sich ohne Anpassung oder Feinabstimmung möglicherweise nicht zuverlässig auf unbekannte Bereiche übertragen.
Wann du dich nicht auf die monokulare Tiefenschätzung verlassen solltest#
Die monokulare Tiefenschätzung ist zwar ein interessantes Forschungsgebiet, aber es ist wichtig zu verstehen, wo sie praktisch eingesetzt werden kann und wo nicht. Die von ihr ermittelten Entfernungen sind Schätzwerte auf Grundlage dessen, was das Modell in einem Bild sieht, und keine exakten Messungen der realen Welt.
Daher kann sich die Ergebnisqualität je nach Faktoren wie Beleuchtung, Komplexität der Szene und Ähnlichkeit der Szene mit den Trainingsdaten des Modells ändern. Die monokulare Tiefenschätzung kann in der Regel gut erkennen, was näher und was weiter entfernt ist, ist aber nicht zuverlässig, wenn du genaue Entfernungsangaben benötigst.
In Situationen, in denen Präzision wirklich entscheidend ist, etwa bei sicherheitskritischen Systemen, der industriellen Inspektion oder Robotern, die sehr präzise mit Objekten interagieren müssen, muss die Tiefe direkt gemessen werden. Sensoren wie LiDAR, Radar, Stereokameras oder Systeme mit strukturiertem Licht sind dafür ausgelegt und liefern deutlich zuverlässigere Entfernungsinformationen.
Auch unter visuell schwierigen Bedingungen kann die monokulare Tiefenschätzung an ihre Grenzen stoßen. Schlechte Beleuchtung, starke Schatten, reflektierende oder transparente Oberflächen, Nebel, Rauch oder Szenen mit sehr wenig visueller Textur können die Zuverlässigkeit der Tiefenschätzungen beeinträchtigen. Auch bei großen Entfernungen arbeiten spezielle Sensoren in der Regel besser.
Für praktische Anwendungen eignet sich die monokulare Tiefenschätzung am besten als unterstützendes Werkzeug und nicht als eigenständige Lösung. Sie kann nützlichen räumlichen Kontext liefern, Lücken schließen, wenn andere Sensoren eingeschränkt sind, und das allgemeine Szenenverständnis verbessern. Wenn Genauigkeit, Sicherheit oder strenge Zuverlässigkeitsanforderungen wichtig sind, sollte sie jedoch nicht die einzige Quelle für Tiefeninformationen sein.
Die wichtigsten Erkenntnisse#
Die monokulare Tiefenschätzung ist eine Computer-Vision-Technik, mit der Maschinen allein anhand eines einzelnen Kamerabilds die Entfernung zu Objekten schätzen können. Indem diese KI-Modelle visuelle Hinweise wie Perspektive, Objektgröße, Textur und Schattierung lernen, können sie die 3D-Struktur einer Szene ableiten, ohne auf Sensoren wie LiDAR oder Stereokameras angewiesen zu sein. Dadurch ist die monokulare Tiefenschätzung ein kostengünstiger und skalierbarer Ansatz für Anwendungen wie autonomes Fahren, Robotik und das Verständnis von 3D-Szenen.
Weitere Informationen zu Vision-KI findest du in unserem GitHub-Repository und in unserer Community. Auf unseren Lösungsseiten erfährst du mehr über KI in der Robotik und Computer Vision in der Fertigung. Entdecke unsere Lizenzoptionen und starte noch heute mit Computer Vision!
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









