Was ist Datensatzdestillation? Ein kurzer Überblick
Erfahre, wie die Destillation von Datensätzen das Modelltraining beschleunigt und Rechenkosten senkt, indem große Datensätze durch eine kleine, optimierte Auswahl synthetischer Beispiele ersetzt werden.
 Abirami Vina15 Min. Lesezeit
Das Trainieren von Modellen scheint vielleicht der zeitaufwendigste Teil der Arbeit von Data Scientists zu sein. Tatsächlich fließen jedoch oft 60 bis 80 % ihrer Zeit in die Aufbereitung der Daten: Sie sammeln, bereinigen und organisieren die Daten für die Modellierung. Mit zunehmender Größe der Datensätze steigt auch der Zeitaufwand für die Vorbereitung. Das verlangsamt Experimente und erschwert iterative Verbesserungen.
Um dieses Problem anzugehen, suchen Forschende seit Jahren nach Möglichkeiten, das Training effizienter zu gestalten. Ansätze wie synthetische Daten, die Komprimierung von Datensätzen und bessere Optimierungsmethoden sollen den Aufwand und die Kosten bei der Arbeit mit großen Datensätzen verringern und Abläufe beim maschinellen Lernen beschleunigen.
Dabei stellt sich die Frage, ob wir einen Datensatz drastisch verkleinern und dennoch dieselbe Leistung erzielen können wie beim Training eines Modells mit den vollständigen Daten. Die Destillation von Datensätzen ist eine vielversprechende Antwort darauf.
Dabei wird eine kompakte Version eines großen Trainings-Datensatzes erstellt, die zugleich die wesentlichen Muster bewahrt, die das Modell für effektives Lernen benötigt. Das ermöglicht schnelleres Training, geringeren Rechenaufwand und effizientere Experimente. Du kannst dir das wie einen Spickzettel für das Modell vorstellen: eine winzige Sammlung von Beispielen mit synthetischen Daten, die dieselben grundlegenden Muster wie der vollständige Datensatz vermitteln soll.
In diesem Artikel untersuchen wir, wie die Destillation von Datensätzen funktioniert und wie sie skalierbares maschinelles Lernen und Deep Learning in praktischen Anwendungen unterstützt.
Die Destillation von Datensätzen verstehen#
Bei der Destillation von Datensätzen wird ein großer Trainingsdatensatz auf eine viel kleinere Datenmenge verdichtet, die einem Modell dennoch fast dieselben Informationen vermittelt wie der ursprüngliche Datensatz. Viele Forschende bezeichnen dieses Verfahren auch als Datenkondensation, denn dabei sollen die wesentlichen Muster des gesamten Datensatzes erfasst werden.
Ein destillierter Datensatz unterscheidet sich von zufällig erzeugten synthetischen Daten und davon, einfach eine kleinere Teilmenge echter Bilder auszuwählen. Es handelt sich weder um einen zufälligen künstlichen Datensatz noch um eine gekürzte Kopie des Originals.
Stattdessen wird er gezielt optimiert, um die wichtigsten Muster zu erfassen. Dabei werden jedes Pixel und jedes Merkmal angepasst und optimiert, sodass ein mit den destillierten Daten trainiertes neuronales Netz fast so lernt, als wäre es mit dem gesamten Datensatz trainiert worden.
Diese Idee tauchte erstmals 2018 in einem arXiv-Artikel von Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba und Alexei A. Efros auf. In frühen Tests kamen einfache Datensätze wie MNIST und CIFAR-10 zum Einsatz. So ließ sich leicht zeigen, dass wenige destillierte Beispiele Tausende echter Bilder ersetzen können.
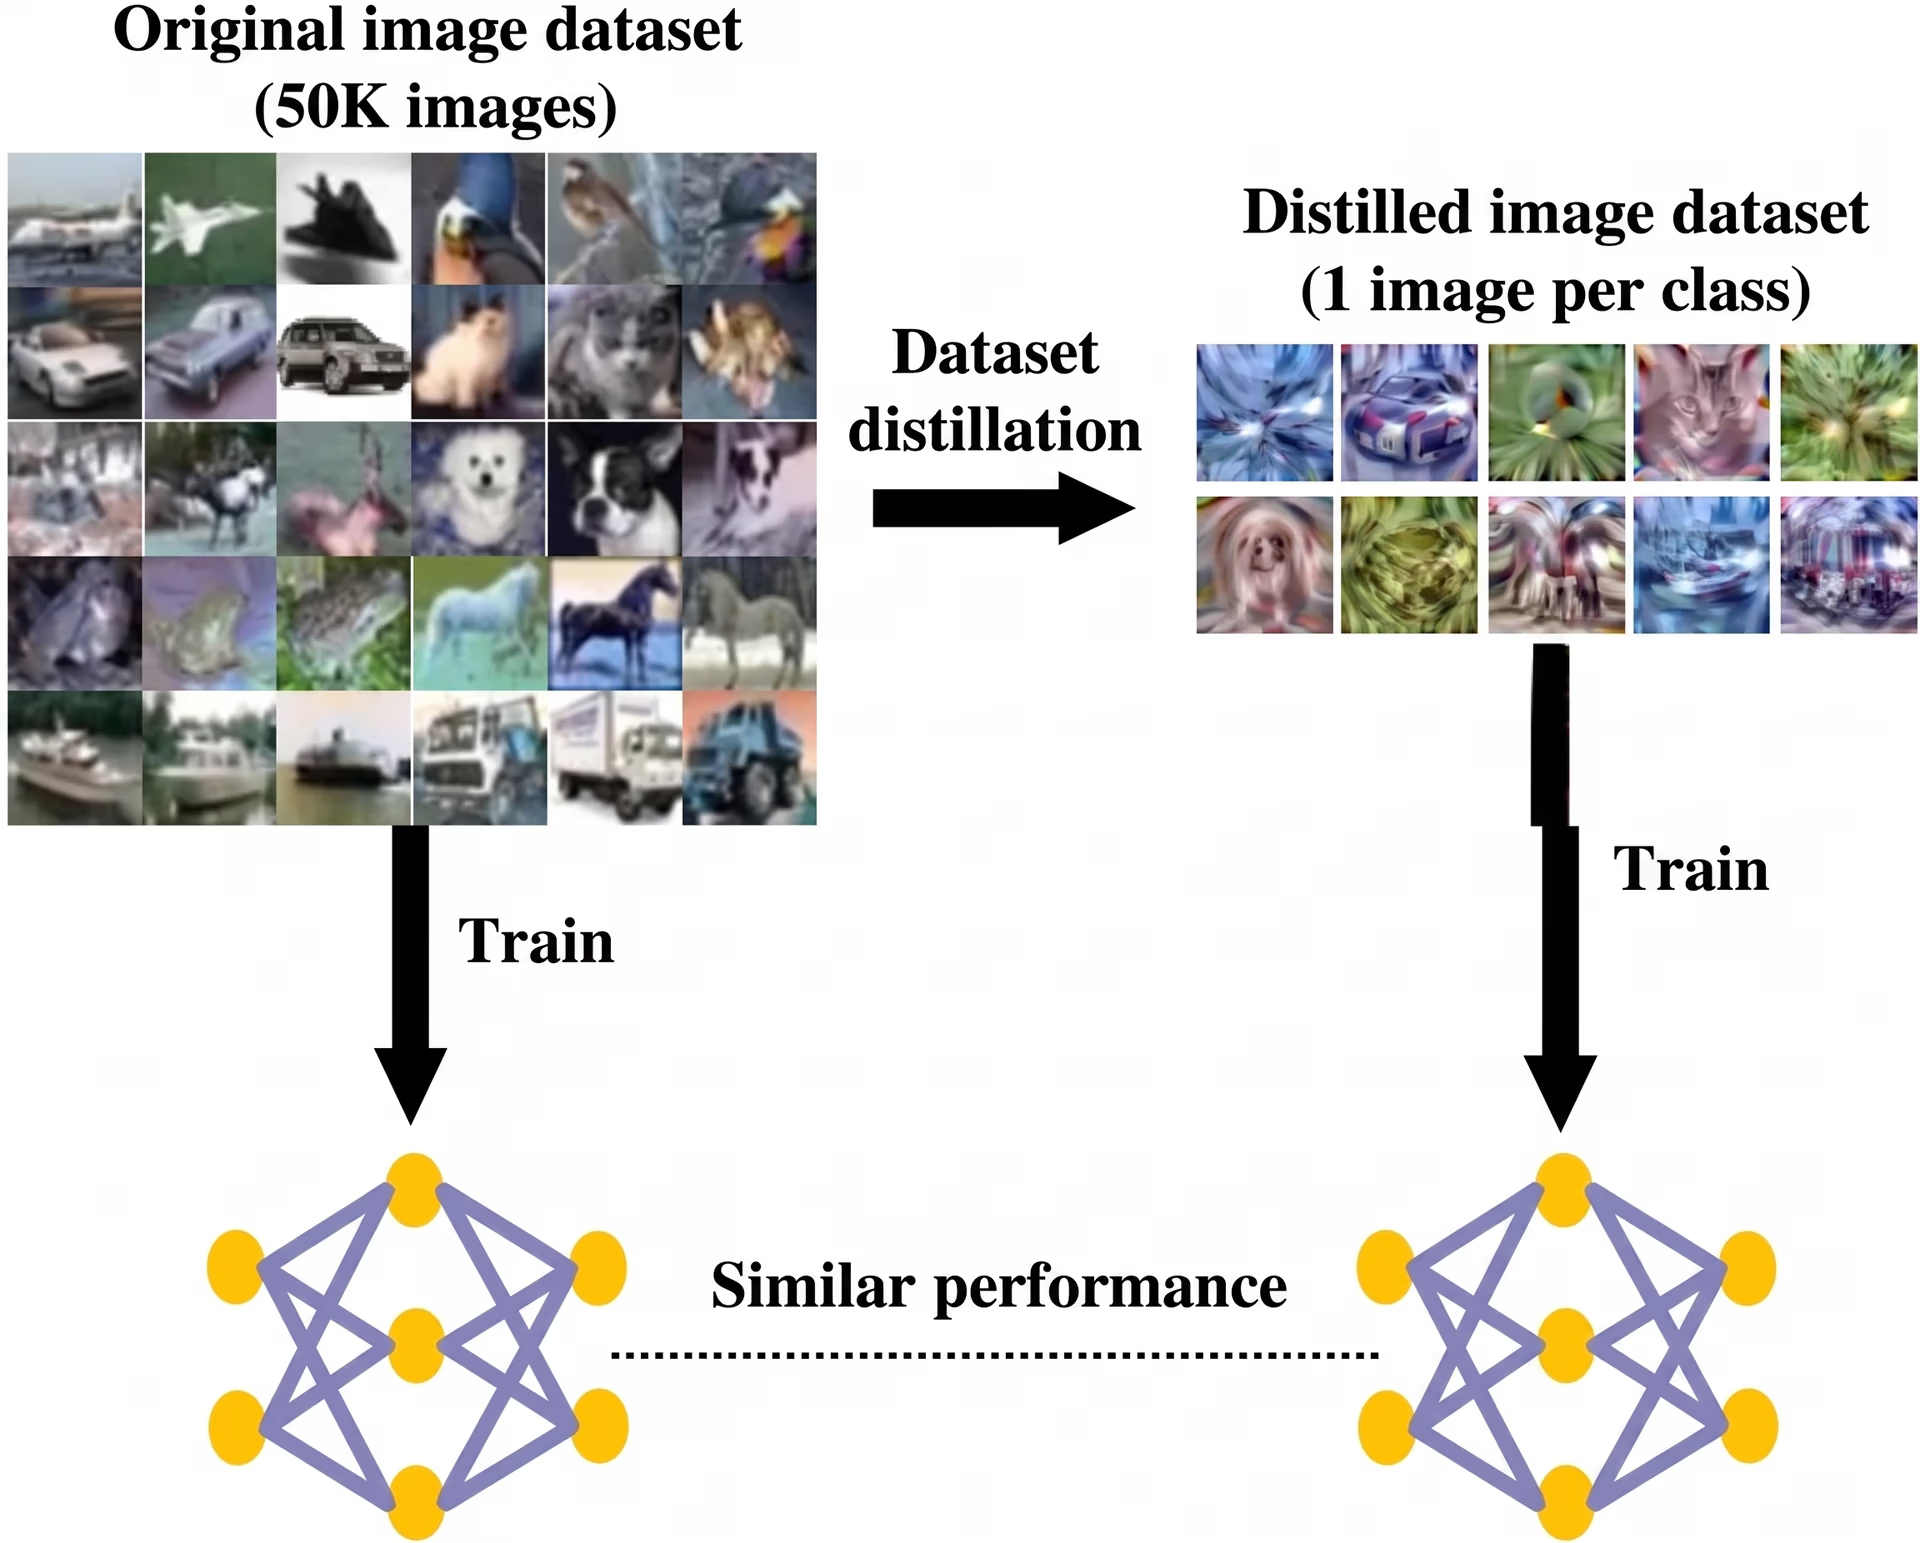
Abb. 1. Die Destillation von Datensätzen für Bilddaten nutzen (Quelle)
Seitdem haben Folgearbeiten die Destillation von Datensätzen weiter vorangebracht. Dazu zählen auf ICML und ICLR veröffentlichte Methoden, die die Kondensation effizienter und skalierbarer machen.
Die Bedeutung der Destillation von Datensätzen#
Die Destillation von Datensätzen steigert die Trainingseffizienz und beschleunigt Entwicklungszyklen. Indem sie die Datenmenge verringert, die ein Modell zum Lernen benötigt, senkt sie den Rechenaufwand.
Das ist besonders beim kontinuierlichen Lernen nützlich, bei dem Modelle regelmäßig aktualisiert werden, bei der Suche nach neuronalen Netzarchitekturen, bei der viele Modellvarianten getestet werden, und beim Training auf Edge-Geräten mit begrenztem Speicher und geringem Energieverbrauch. Insgesamt eignet sich die Destillation von Datensätzen daher hervorragend für eine schnelle Initialisierung, zügige Feinabstimmung und die Entwicklung erster Prototypen in vielen Arbeitsabläufen des maschinellen Lernens.
Ein Überblick über die Funktionsweise der Datensatzdestillation#
Bei der Destillation von Datensätzen werden synthetische, also künstlich erzeugte Trainingsbeispiele erstellt. Sie helfen einem Modell auf eine Weise zu lernen, die dem Training mit echten Daten sehr nahekommt. Das Verfahren verfolgt dabei drei wichtige Faktoren während des regulären Trainings.
Der erste Faktor ist die Verlustfunktion, also der Fehlerwert des Modells, der angibt, wie falsch seine Vorhersagen sind. Der zweite sind die Modellparameter: die internen Gewichte des Netzwerks, die beim Lernen aktualisiert werden.
Der dritte Faktor ist die Trainingsentwicklung, die beschreibt, wie sich Fehler und Gewichte im Laufe der Zeit Schritt für Schritt verändern. Anschließend werden die synthetischen Beispiele so optimiert, dass sich beim Training eines Modells damit der Fehler verringert und die Gewichte genauso aktualisiert werden wie beim Training mit dem vollständigen Datensatz.
Schritt für Schritt: die Destillation von Datensätzen#
Hier siehst du genauer, wie die Destillation eines Datensatzes abläuft:
- Schritt 1 – Synthetische Pixel initialisieren: Der Prozess beginnt mit synthetischen Bildern, die als lernbare Eingaben dienen. Zunächst haben diese Bilder kaum Struktur und ähneln leeren Leinwänden. Mit der Zeit werden sie zu aussagekräftigen Beispielen optimiert.
- Schritt 2 – Mit Gradientenabgleich und Rückpropagation optimieren: Während das Modell mit diesen synthetischen Bildern trainiert wird, erzeugt es Gradienten, die anzeigen, wie jedes Pixel verändert werden sollte, damit das Trainingsverhalten realer Daten besser nachgebildet wird. Die Rückpropagation ist das Verfahren, mit dem das Netzwerk aus Fehlern lernt. Dabei wird der Fehler rückwärts durch das Modell geleitet, um herauszufinden, welche Pixel und Gewichte ihn verursacht haben. Anschließend werden diese geringfügig angepasst. Mithilfe der Gradienten passt die Rückpropagation die synthetischen Bilder Schritt für Schritt an, bis sie für das Training aussagekräftiger sind.
- Schritt 3 – Verhalten über Trainingsschritte hinweg abgleichen: Das Verfahren gleicht auch die Trainingsverläufe ab, also die schrittweisen Veränderungen, die das Modell beim Lernen durchläuft. Dadurch führt der destillierte Datensatz das Modell auf einem Lernpfad, der dem mit dem vollständigen Datensatz ähnelt.
- Schritt 4 – Validierung und Verallgemeinerungsfähigkeit: Abschließend wird der destillierte Datensatz anhand echter Validierungsdaten ausgewertet, um festzustellen, wie gut das trainierte Modell bei neuen Beispielen abschneidet. So wird geprüft, ob die synthetischen Daten allgemeine, funktionale Muster vermitteln, statt das Modell zum Auswendiglernen bestimmter Beispiele zu verleiten.
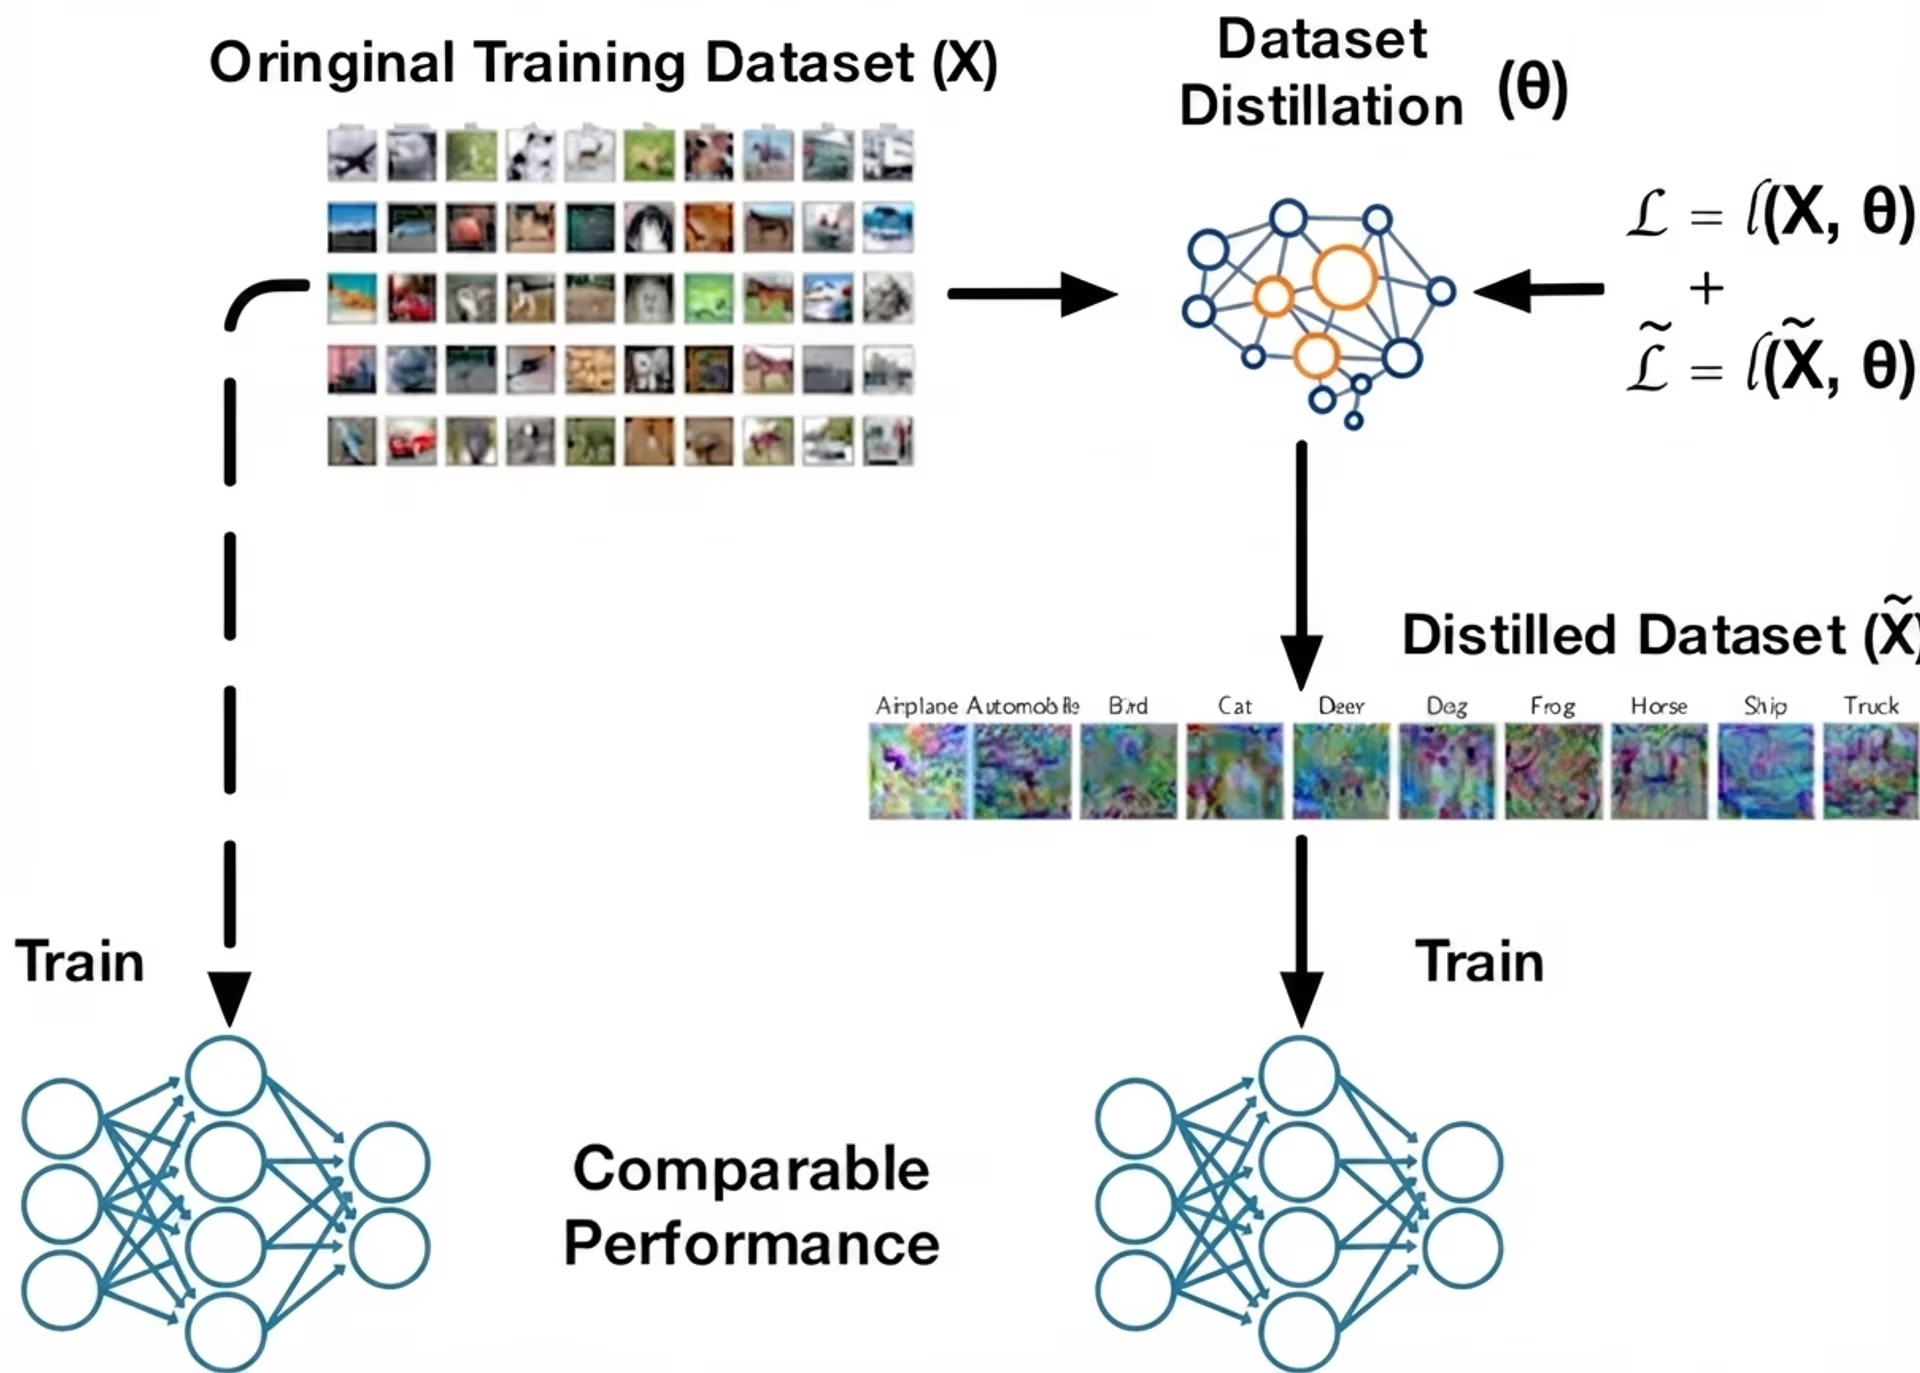
Abb. 2. Ein Blick auf die Datensatzdestillation (Quelle)
Wichtige Methoden zur Destillation von Datensätzen#
Alle Methoden zur Destillation von Datensätzen beruhen auf derselben Grundidee, auch wenn sie unterschiedliche Algorithmen verwenden. Die meisten Ansätze gehören zu einer von drei Kategorien: Abgleich der Leistung, Abgleich der Verteilung und Abgleich der Parameter.
Sehen wir uns nun die einzelnen Verfahren und ihre Funktionsweise an.
Abgleich der Leistung#
Beim Abgleich der Leistung in der Datensatzdestillation geht es darum, einen winzigen, optimierten Trainingsdatensatz zu erstellen, mit dem ein Modell nahezu dieselbe Genauigkeit erreicht wie beim Training mit dem vollständigen Originaldatensatz. Statt eine zufällige Teilmenge auszuwählen, werden die destillierten Beispiele so optimiert, dass ein damit trainiertes Modell ähnliche Vorhersagen, einen ähnlichen Verlustverlauf während des Trainings oder eine ähnliche abschließende Genauigkeit wie ein mit dem Originaldatensatz trainiertes Modell erzielt.
Metlernen ist ein häufig eingesetztes Verfahren, um diesen Prozess zu verbessern. Der destillierte Datensatz wird in wiederholten Trainingsdurchläufen angepasst, sodass er sich in vielen möglichen Situationen bewährt.
In diesen Durchläufen simuliert das Verfahren, wie ein Schülermodell anhand der aktuellen destillierten Beispiele lernt, prüft, wie gut es mit echten Daten abschneidet, und passt anschließend die destillierten Beispiele so an, dass sie bessere Lehrbeispiele sind. Mit der Zeit lernt der destillierte Datensatz, schnelles Lernen und eine hohe Verallgemeinerungsfähigkeit zu unterstützen – selbst wenn das Schülermodell mit anderen Anfangsgewichten startet oder eine andere Architektur verwendet. Dadurch wird der destillierte Datensatz zuverlässiger und ist nicht an einen einzelnen Trainingslauf gebunden.
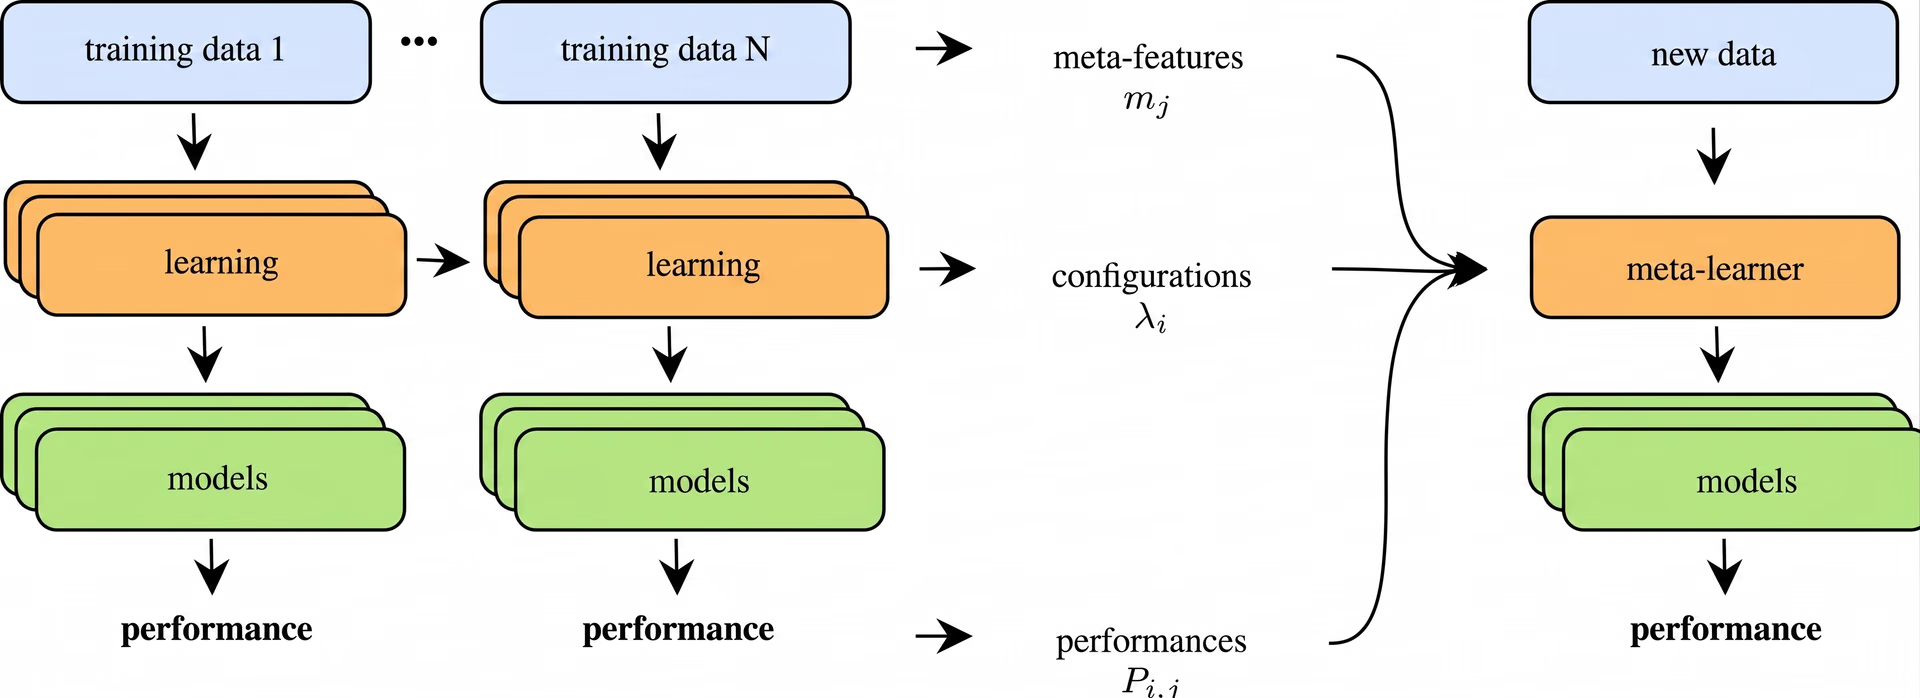
Abb. 3. Der Metlernprozess (Quelle)
Verfahren zum Abgleich der Verteilung#
Beim Abgleich der Verteilung werden synthetische Daten erzeugt, die den statistischen Mustern des echten Datensatzes entsprechen. Statt sich nur auf die endgültige Genauigkeit eines Modells zu konzentrieren, richtet sich dieser Ansatz auf die internen Merkmale, die ein neuronales Netz während des Lernens erzeugt.
Sehen wir uns nun die beiden Verfahren an, auf denen der Abgleich der Verteilung beruht.
Abgleich von Verteilungen auf einer einzelnen Schicht#
Beim Abgleich von Verteilungen auf einer einzelnen Schicht wird eine einzelne Schicht eines neuronalen Netzes betrachtet und die Merkmale verglichen, die sie für reale und synthetische Daten erzeugt. Diese Merkmale, auch Aktivierungen genannt, erfassen, was das Modell an dieser Stelle im Netzwerk gelernt hat.
Indem die synthetischen Daten ähnliche Aktivierungen erzeugen, wird dafür gesorgt, dass der destillierte Datensatz dieselben wichtigen Muster wie der ursprüngliche Datensatz widerspiegelt. In der Praxis werden die synthetischen Beispiele wiederholt aktualisiert, bis die Aktivierungen an der ausgewählten Schicht weitgehend denen realer Bilder entsprechen.
Dieser Ansatz ist vergleichsweise einfach, da jeweils nur eine Darstellungsebene angeglichen wird. Er eignet sich besonders gut für kleinere Datensätze oder Aufgaben, bei denen es nicht nötig ist, tiefe, mehrstufige Merkmalsstrukturen abzugleichen. Durch den klaren Abgleich eines Merkmalsraums liefert der Abgleich auf einer einzelnen Schicht ein stabiles und aussagekräftiges Signal für das Lernen mit dem destillierten Datensatz.
Abgleich von Verteilungen über mehrere Schichten#
Der Abgleich von Verteilungen über mehrere Schichten baut auf der Idee auf, reale und synthetische Daten zu vergleichen, führt diesen Vergleich jedoch an mehreren Schichten eines neuronalen Netzes statt nur an einer durch. Verschiedene Schichten erfassen unterschiedliche Arten von Informationen: von einfachen Kanten und Texturen in frühen Schichten bis hin zu Formen und komplexeren Mustern in tieferen Schichten.
Durch den Abgleich von Merkmalen über diese Schichten hinweg wird der destillierte Datensatz so optimiert, dass er widerspiegelt, was das Modell auf mehreren Ebenen lernt. Da dieser Ansatz Merkmale im gesamten Netzwerk angleicht, bleiben in den synthetischen Daten vielfältigere Signale erhalten, auf die sich das Modell stützt, um Klassen voneinander zu unterscheiden.
Das ist besonders hilfreich bei Aufgaben der Computer Vision, also bei Aufgaben, bei denen Modelle Bilder und Videos verstehen lernen, denn nützliche Muster verteilen sich über viele Schichten. Stimmen die Merkmalsverteilungen über mehrere Tiefen hinweg gut überein, ist der destillierte Datensatz ein leistungsfähigerer und zuverlässigerer Ersatz für die ursprünglichen Trainingsdaten.
Methoden zum Abgleich von Parametern#
Eine weitere wichtige Kategorie der Datensatzdestillation ist der Abgleich von Parametern. Statt die Genauigkeit oder Merkmalsverteilungen abzugleichen, wird verglichen, wie sich die Gewichte eines Modells während des Trainings ändern. Wenn das Training mit dem destillierten Datensatz ähnliche Parameteraktualisierungen hervorbringt wie das Training mit realen Daten, folgt das Modell einem nahezu identischen Lernverlauf.
Im Folgenden gehen wir die beiden wichtigsten Methoden zum Abgleich von Parametern durch.
Abgleich in einem Schritt#
Beim Abgleich in einem Schritt wird verglichen, wie sich die Gewichte eines Modells nach nur einem Trainingsschritt mit realen Daten ändern. Anschließend wird der destillierte Datensatz so angepasst, dass ein damit trainiertes Modell nach einem Schritt eine sehr ähnliche Gewichtsaktualisierung erzeugt. Da nur diese einzelne Aktualisierung betrachtet wird, ist die Methode unkompliziert und schnell durchzuführen.
Der Nachteil ist, dass ein einzelner Schritt nicht den gesamten Lernprozess abbildet, insbesondere bei schwierigeren Aufgaben, bei denen das Modell viele Aktualisierungen benötigt, um komplexere Merkmale aufzubauen. Deshalb eignet sich der Abgleich in einem Schritt meist am besten für einfachere Probleme oder kleinere Datensätze, bei denen nützliche Muster schnell erkannt werden können.
Abgleich von Parametern über mehrere Schritte#
Im Gegensatz dazu betrachtet der Abgleich von Parametern über mehrere Schritte, wie sich die Gewichte eines Modells während mehrerer Trainingsschritte ändern, nicht nur während eines einzigen. Diese Abfolge von Aktualisierungen bildet den Trainingsverlauf des Modells.
Der destillierte Datensatz wird so erstellt, dass der Trainingsverlauf eines mit den synthetischen Beispielen trainierten Modells dem Verlauf mit realen Daten möglichst genau folgt. Durch den Abgleich eines längeren Lernabschnitts erfasst der destillierte Datensatz mehr von der Struktur des ursprünglichen Trainingsprozesses.
Da der Abgleich über mehrere Schritte den zeitlichen Verlauf des Lernens abbildet, funktioniert er in der Regel besser bei größeren oder komplexeren Datensätzen, bei denen Modelle viele Aktualisierungen benötigen, um nützliche Muster zu erkennen. Dafür ist mehr Rechenaufwand erforderlich, weil mehrere Schritte verfolgt werden müssen. Häufig entstehen jedoch destillierte Datensätze, die besser generalisieren und eine höhere Leistung erzielen als beim Abgleich in einem Schritt.
So funktionieren die Erzeugung und Optimierung synthetischer Datensätze#
Nachdem wir nun die wichtigsten Destillationsansätze besser verstanden haben, sehen wir uns an, wie synthetische Daten erstellt werden. Bei der Datensatzdestillation werden synthetische Beispiele so optimiert, dass sie die wichtigsten Lernsignale erfassen und eine kleine Menge einen wesentlich größeren Datensatz ersetzen kann.
Als Nächstes sehen wir uns an, wie diese destillierten Daten erzeugt und ausgewertet werden.
Destillierte Bilder erstellen und bewerten#
Während der Datensatzdestillation werden die Pixel der synthetischen Bilder über viele Trainingsschritte hinweg aktualisiert. Das neuronale Netz lernt aus den jeweils aktuellen synthetischen Bildern und gibt gradientenbasiertes Feedback dazu, wie sich jedes Pixel ändern sollte, damit die Muster des realen Datensatzes besser abgebildet werden.
Das funktioniert, weil der Prozess differenzierbar ist (das heißt, jeder Schritt verläuft glatt und hat wohldefinierte Gradienten, sodass kleine Pixeländerungen vorhersehbare Änderungen des Verlusts bewirken). Dadurch kann das Modell die synthetischen Daten während des Gradientenabstiegs schrittweise anpassen.
Im Verlauf der Optimierung bilden die synthetischen Bilder zunehmend sinnvolle Strukturen, darunter Formen und Texturen, die das Modell erkennt. Diese verfeinerten synthetischen Bilder werden häufig für Aufgaben der Bildklassifizierung verwendet, da sie die entscheidenden visuellen Hinweise erfassen, die ein Klassifizierer lernen muss.
Destillierte Datensätze werden bewertet, indem Modelle mit ihnen trainiert und die Ergebnisse mit denen von Modellen verglichen werden, die mit realen Daten trainiert wurden. Forschende messen die Validierungsgenauigkeit und prüfen, ob der synthetische Datensatz die unterscheidungsrelevanten Merkmale erhält – also die Muster oder Signale, auf die sich das Modell stützt, um Klassen voneinander zu unterscheiden. Außerdem testen sie die Stabilität und Generalisierungsfähigkeit bei verschiedenen Durchläufen oder Modellkonfigurationen, um sicherzustellen, dass die destillierten Daten nicht zu einer Überanpassung führen.
Anwendungen der Datendestillation in der Praxis#
Als Nächstes sehen wir uns Beispiele genauer an, die zeigen, wie destillierte Datensätze das Training beschleunigen und Rechenkosten senken und dabei auch bei begrenzten oder hochspezialisierten Daten eine hohe Leistung aufrechterhalten.
Datensatzdestillation für Computer-Vision-Anwendungen#
Bei Computer Vision geht es darum, Modelle darauf zu trainieren, visuelle Daten wie Bilder und Videos zu verstehen. Diese Modelle lernen Muster wie Kanten, Texturen, Formen und Objekte und nutzen sie anschließend für Aufgaben wie Bildklassifizierung, Objekterkennung oder Segmentierung. Da bei visuellen Aufgaben oft große Unterschiede bei Beleuchtung, Hintergrund und Blickwinkel auftreten, benötigen Computer-Vision-Systeme in der Regel umfangreiche Datensätze, um gut zu generalisieren. Dadurch wird das Training teuer und langwierig.
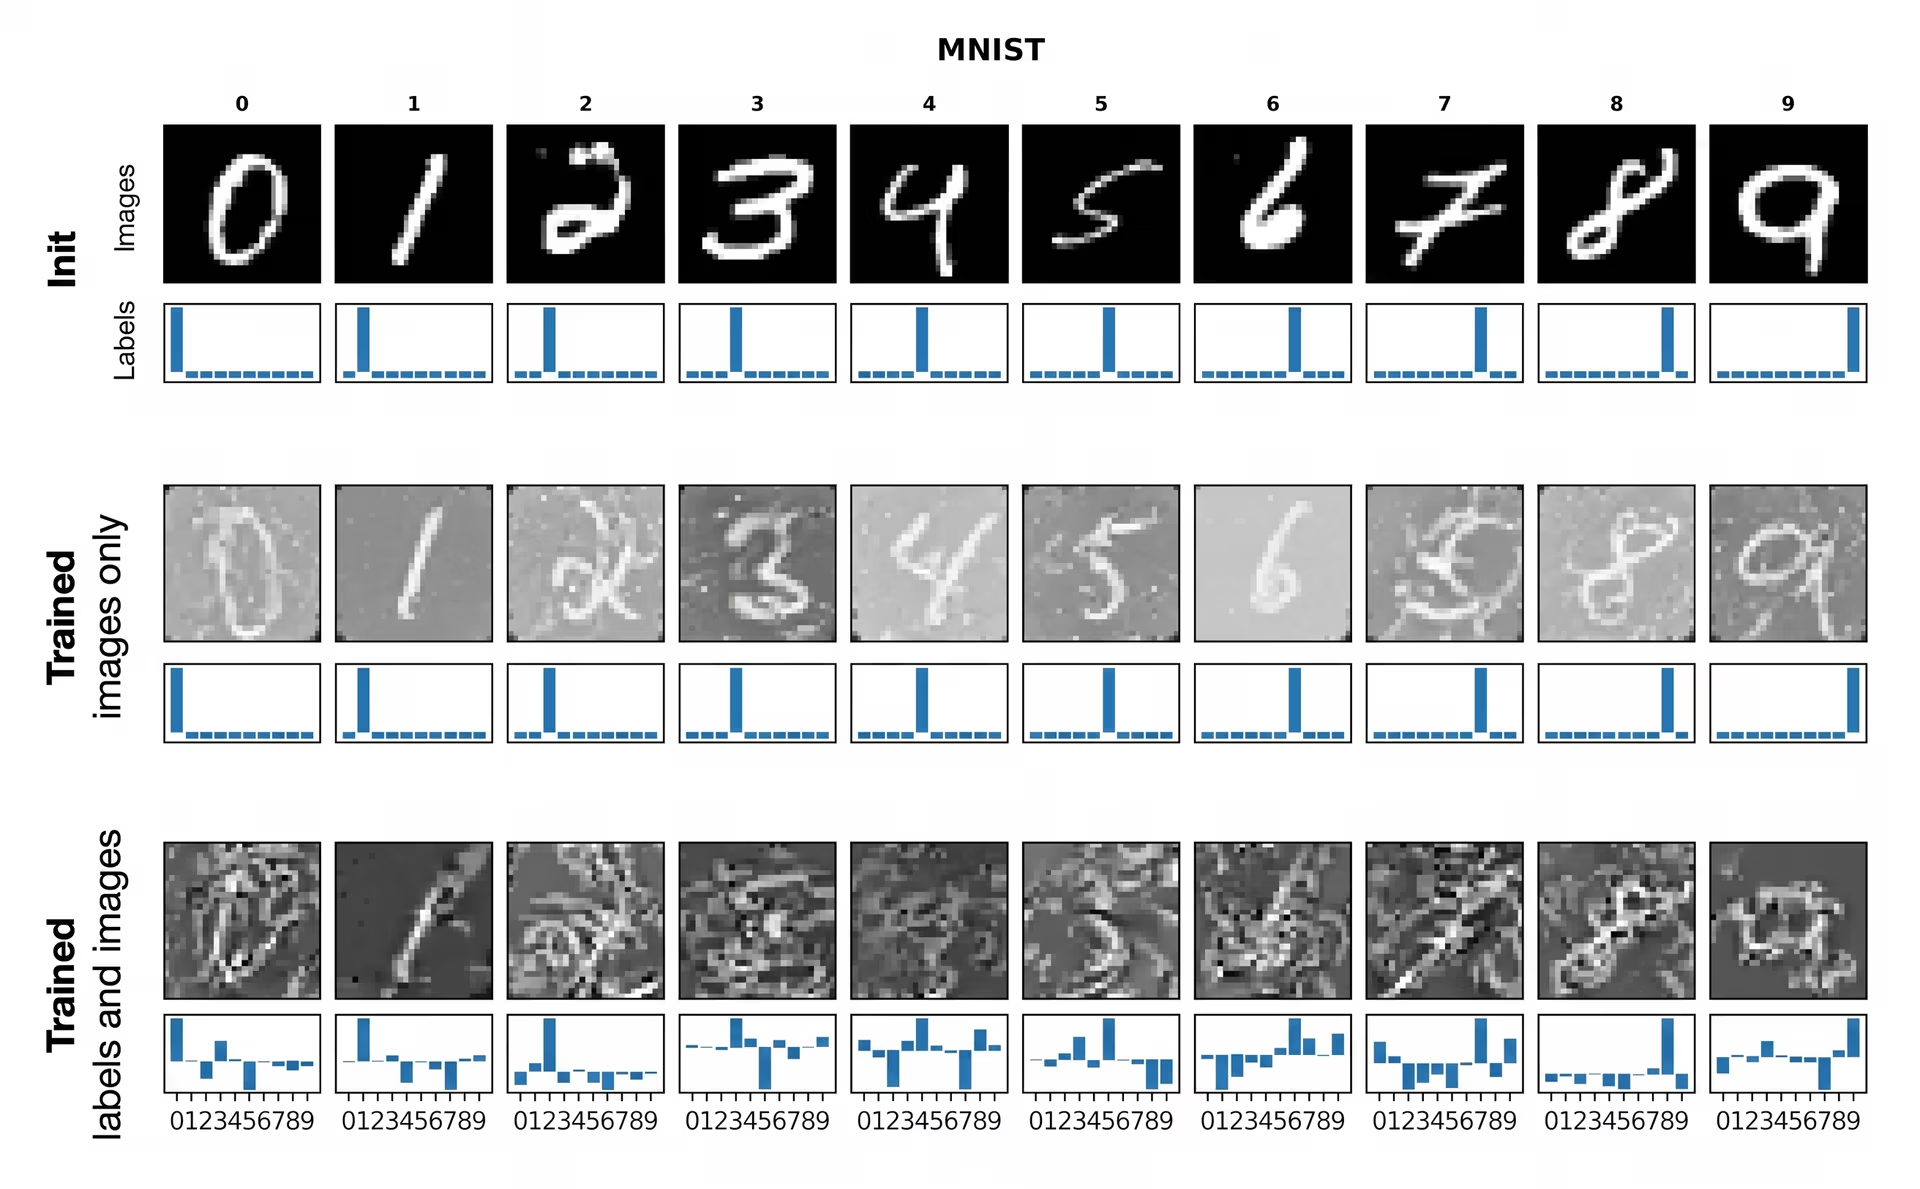
Abb. 4: Ein Beispiel für Datensatzdestillation (Quelle)
Bei Anwendungsfällen der Bildklassifizierung wie medizinischen Aufnahmen, der Wildtierüberwachung oder der Erkennung von Produktionsfehlern müssen Modelle oft einen schwierigen Kompromiss zwischen Genauigkeit und Trainingskosten eingehen. Für diese Aufgaben werden in der Regel sehr große Datensätze benötigt.
Mit der Datensatzdestillation lässt sich der ursprüngliche Trainingsdatensatz auf wenige synthetische Bilder komprimieren, die dennoch die wichtigsten visuellen Hinweise für den Klassifizierer enthalten. Bei großen Benchmarks wie ImageNet wurde gezeigt, dass destillierte Datensätze mit nur etwa 4,2 % der ursprünglichen Bilder eine hohe Klassifizierungsgenauigkeit beibehalten. Das bedeutet, dass ein winziger synthetischer Ersatz Millionen realer Beispiele mit deutlich geringerem Rechenaufwand ersetzen kann.
Suche nach neuronalen Architekturen#
Suche nach neuronalen Architekturen, kurz NAS, ist ein Verfahren, das automatisch zahlreiche mögliche neuronale Netzwerkarchitekturen durchsucht, um die für eine Aufgabe am besten geeignete zu finden. Da NAS viele Kandidatenmodelle trainieren und bewerten muss, kann die Ausführung auf vollständigen Datensätzen langsam und sehr rechenintensiv sein.
Die Datensatzdestillation hilft, indem sie einen winzigen synthetischen Trainingsdatensatz erstellt, der dennoch die wichtigsten Lernsignale der ursprünglichen Daten enthält. So lässt sich jede mögliche Architektur viel schneller testen. Dadurch kann NAS Entwürfe effizient vergleichen und gleichzeitig die Rangfolge guter und schlechter Architekturen recht zuverlässig beibehalten. Die Suchkosten sinken, ohne dass die Qualität des endgültigen Modells wesentlich leidet.
Kontinuierliches Lernen und Bereitstellung auf Edge-Geräten#
Systeme für kontinuierliches Lernen, also Modelle, die sich mit neuen Daten laufend aktualisieren, statt nur einmal trainiert zu werden, benötigen schnelle und speichereffiziente Aktualisierungen. Für Edge-Geräte wie Kameras, Smartphones und Sensoren gelten ähnliche Einschränkungen, da ihnen nur begrenzte Rechen- und Speicherkapazitäten zur Verfügung stehen.
Die Datensatzdestillation hilft in beiden Fällen, indem sie einen großen Trainingsdatensatz zu einem winzigen synthetischen Datensatz komprimiert. So können Modelle angepasst oder erneut trainiert werden, ohne den vollständigen Datensatz zu verwenden. Eine Studie zum Meta-Lernen mit Kernelmethoden zeigte beispielsweise, dass bereits 10 destillierte Beispiele bei CIFAR-10, einem Standardbenchmark für Bildklassifizierung, eine Genauigkeit von über 64 % erzielen können. Da der zur Wiederholung verwendete Datensatz so kompakt ist, lassen sich Aktualisierungen viel schneller und praktischer durchführen, insbesondere wenn Modelle häufig aktualisiert werden müssen.
Die Destillation von Datensätzen lässt sich auch zusammen mit der Wissensdestillation für große Sprachmodelle einsetzen. Ein kleiner, destillierter Datensatz kann die wichtigsten aufgabenbezogenen Signale des Lehrermodells bewahren. So lässt sich ein komprimiertes Schülermodell effizienter trainieren oder aktualisieren, ohne viel Leistung einzubüßen. Da diese Datensätze sehr klein sind, eignen sie sich besonders für Edge- oder Geräteanwendungen, bei denen Speicher- und Rechenkapazitäten begrenzt sind, das Modell nach Aktualisierungen aber trotzdem genau bleiben soll.
Vor- und Nachteile der Datendestillation#
Hier sind einige Vorteile der Datensatzdestillation:
- Ideal für schnelle Experimente. Du kannst neue Architekturen, Verlustfunktionen oder Hyperparameter testen, ohne jedes Mal mit einem riesigen Datensatz neu trainieren zu müssen.
- Möglicher Datenschutzvorteil. Das Teilen destillierter synthetischer Beispiele kann sicherer sein als das Teilen realer Nutzerdaten, da keine Rohdaten direkt offengelegt werden.
- Oft besser als die einfache Auswahl einer Teilmenge. Statt nur Beispiele auszuwählen, werden sie bei der Destillation aktiv so optimiert, dass sie möglichst viele Informationen enthalten.
Die Datensatzdestillation bietet zwar mehrere Vorteile, doch solltest du auch die folgenden Einschränkungen beachten:
- Überanpassung. Destillierte Daten funktionieren häufig am besten mit der während der Destillation verwendeten Architektur und lassen sich möglicherweise nur schlecht auf ganz andere Modelle übertragen.
- Empfindlich gegenüber Hyperparametern. Die Ergebnisse können stark von Faktoren wie der Lernrate, der Initialisierung oder der Anzahl der Destillationsschritte abhängen.
- Schwieriger auf die Komplexität realer Anwendungen übertragbar. Methoden, die bei Benchmarks gut funktionieren, können bei großen, uneinheitlichen oder hochauflösenden Datensätzen an Genauigkeit verlieren.
Die wichtigsten Erkenntnisse#
Mit der Datensatzdestillation kann eine kleine Menge synthetischer Beispiele einem Modell fast genauso effektiv Wissen vermitteln wie ein vollständiger Datensatz. Dadurch wird maschinelles Lernen schneller, effizienter und einfacher skalierbar. Da Modelle wachsen und mehr Daten benötigen, bieten destillierte Datensätze eine praktische Möglichkeit, Rechenkosten zu senken, ohne die Genauigkeit zu beeinträchtigen.
Tritt unserer Community bei und sieh dir unser GitHub-Repository an, um mehr über KI zu erfahren. Wenn du dein eigenes KI-Projekt für visuelle Daten entwickeln möchtest, informiere dich über unsere Lizenzoptionen. Auf unseren Lösungsseiten erfährst du mehr über Anwendungen wie KI im Gesundheitswesen und visuelle KI im Einzelhandel.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









