Was ist Overfitting in der Computer Vision und wie verhinderst du es?
Erfahre, was Overfitting in der Computer Vision ist, wie du es erkennst und wie du es mit Augmentierung, Regularisierung, vorzeitigem Abbruch und vortrainierten Modellen verhinderst.
 Abdelrahman Elgendy8 Min. Lesezeit
Computer-Vision- Modelle sind darauf ausgelegt, Muster zu erkennen, Objekte aufzuspüren und Bilder zu analysieren. Ihre Leistung hängt jedoch davon ab, wie gut sie auf zuvor unbekannte Daten generalisieren. Generalisierung ist die Fähigkeit eines Modells, auch mit neuen Bildern gut zu funktionieren – und nicht nur mit den Bildern, mit denen es trainiert wurde. Ein häufiges Problem beim Training dieser Modelle ist Overfitting: Dabei lernt ein Modell zu viel aus seinen Trainingsdaten, einschließlich unwichtiger Störungen, statt aussagekräftige Muster zu erkennen.
In diesem Fall funktioniert das Modell mit den Trainingsdaten gut, hat aber Schwierigkeiten mit neuen Bildern. Ein Objekterkennungsmodell, das ausschließlich mit hochauflösenden, gut beleuchteten Bildern trainiert wurde, kann beispielsweise bei unscharfen oder schattigen Bildern unter realen Bedingungen versagen. Overfitting schränkt die Anpassungsfähigkeit eines Modells ein und begrenzt seinen Einsatz in realen Anwendungen wie autonomem Fahren, medizinischer Bildgebung und Sicherheitssystemen.
In diesem Artikel sehen wir uns an, was Overfitting ist, warum es auftritt und wie du es verhindern kannst. Außerdem betrachten wir, wie Computer-Vision-Modelle wie Ultralytics YOLO11 dazu beitragen, Overfitting zu verringern und die Generalisierung zu verbessern.
Was ist Overfitting?#
Overfitting tritt auf, wenn sich ein Modell Trainingsdaten einprägt, statt Muster zu lernen, die sich auf neue Eingaben übertragen lassen. Das Modell richtet seine Aufmerksamkeit zu stark auf die Trainingsdaten und hat deshalb Schwierigkeiten mit neuen Bildern oder Situationen, die es noch nicht kennt.
In der Computer Vision kann sich Overfitting auf verschiedene Aufgaben auswirken. Ein Klassifizierungsmodell, das ausschließlich mit hellen, klaren Bildern trainiert wurde, kann bei schlechten Lichtverhältnissen Schwierigkeiten haben. Ein Objekterkennungsmodell, das anhand perfekter Bilder lernt, könnte in überfüllten oder unübersichtlichen Szenen versagen. Ebenso kann ein Instanzsegmentierungsmodell in kontrollierten Umgebungen gut funktionieren, aber mit Schatten oder sich überlappenden Objekten Probleme haben.
Das wird in KI-Anwendungen der Praxis zum Problem, denn Modelle müssen über kontrollierte Trainingsbedingungen hinaus generalisieren können. Selbstfahrende Autos müssen beispielsweise Fußgänger bei unterschiedlichen Lichtverhältnissen, Wetterbedingungen und in verschiedenen Umgebungen erkennen können. Ein Modell, das zu stark auf seinen Trainingsdatensatz angepasst ist, funktioniert in solch unvorhersehbaren Situationen nicht zuverlässig.
Wann und warum tritt Overfitting auf?#
Overfitting entsteht meist durch unausgewogene Datensätze, übermäßig komplexe Modelle und zu langes Training. Hier sind die wichtigsten Ursachen:
- Begrenzte Trainingsdaten: Bei kleinen Datensätzen prägen sich Modelle Muster eher ein, statt sie zu generalisieren. Ein Modell, das nur mit 50 Vogelbildern trainiert wurde, kann Vogelarten außerhalb dieses Datensatzes möglicherweise nur schwer erkennen.
- Komplexe Modelle mit zu vielen Parametern: Tiefe Netzwerke mit übermäßig vielen Schichten und Neuronen neigen dazu, sich feine Details einzuprägen, statt sich auf wesentliche Merkmale zu konzentrieren.
- Fehlende Datenerweiterung: Ohne Transformationen wie Zuschneiden, Spiegeln oder Drehen lernt ein Modell möglicherweise nur anhand seiner konkreten Trainingsbilder.
- Zu langes Training: Wenn ein Modell die Trainingsdaten zu oft durchläuft – diese Durchläufe werden als Epochen bezeichnet –, prägt es sich Details ein, statt allgemeine Muster zu lernen, und lässt sich dadurch schlechter anpassen.
- Uneinheitliche oder verrauschte Labels: Falsch beschriftete Daten bringen ein Modell dazu, falsche Muster zu lernen. Das kommt bei manuell beschrifteten Datensätzen häufig vor.
Ein ausgewogenes Verhältnis zwischen Modellkomplexität, Datensatzqualität und Trainingsmethoden führt zu einer besseren Generalisierung.
Overfitting im Vergleich zu Underfitting#
Overfitting und Underfitting sind zwei gegensätzliche Probleme im Deep Learning.
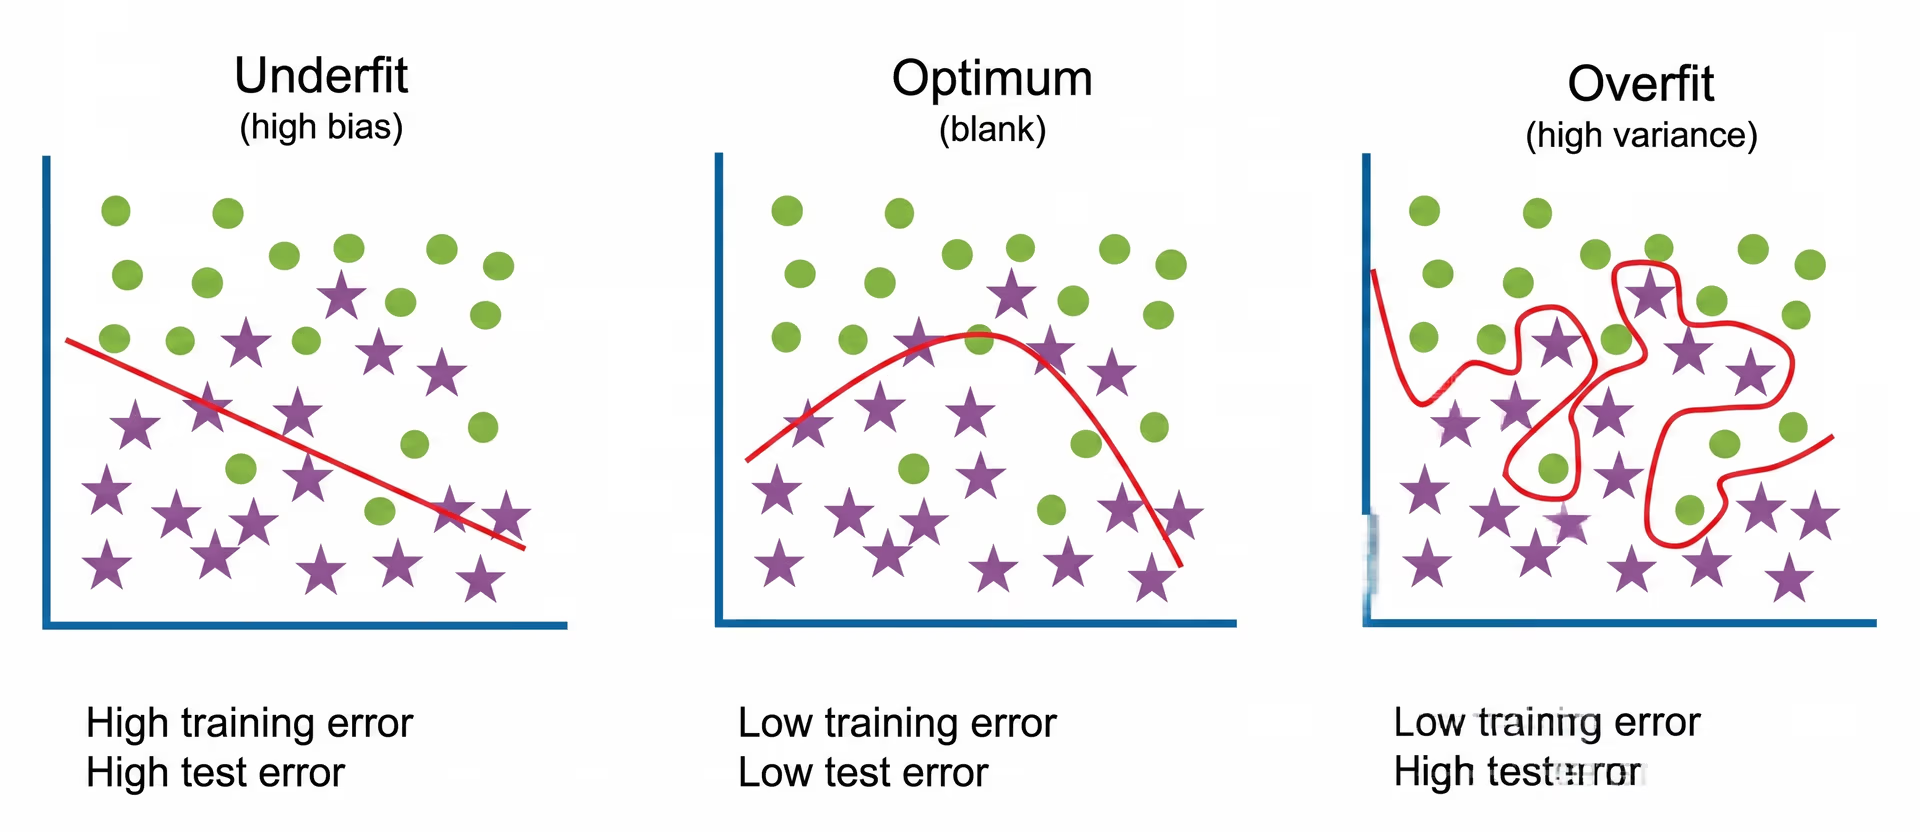
Abb. 1 Vergleich von Underfitting, optimalem Lernen und Overfitting bei Computer-Vision-Modellen.
Overfitting tritt auf, wenn ein Modell zu komplex ist und sich übermäßig auf die Trainingsdaten konzentriert. Statt allgemeine Muster zu lernen, prägt es sich kleine Details ein – auch irrelevante wie Hintergrundrauschen. Dadurch funktioniert das Modell mit den Trainingsdaten gut, hat aber Schwierigkeiten mit neuen Bildern. Es hat also nicht wirklich gelernt, Muster zu erkennen, die in verschiedenen Situationen gelten.
Underfitting tritt auf, wenn ein Modell zu einfach ist und deshalb wichtige Muster in den Daten übersieht. Dazu kann es kommen, wenn das Modell zu wenige Schichten hat, nicht lange genug trainiert wurde oder nur begrenzte Daten zur Verfügung stehen. Infolgedessen erkennt es wichtige Muster nicht und erstellt ungenaue Vorhersagen. Das führt sowohl bei den Trainings- als auch bei den Testdaten zu schlechter Leistung, weil das Modell nicht genug gelernt hat, um die Aufgabe richtig zu verstehen.
Ein gut trainiertes Modell findet die Balance zwischen Komplexität und Generalisierung. Es sollte komplex genug sein, um relevante Muster zu lernen, aber nicht so komplex, dass es sich Daten einprägt, statt zugrunde liegende Zusammenhänge zu erkennen.
Overfitting erkennen#
Hier sind einige Anzeichen für Overfitting bei einem Modell:
- Ist die Genauigkeit beim Training deutlich höher als bei der Validierung, liegt wahrscheinlich Overfitting vor.
- Ein größer werdender Abstand zwischen Trainingsverlust und Validierungsverlust ist ein weiteres deutliches Anzeichen.
- Das Modell ist zu selbstsicher bei falschen Antworten. Das zeigt, dass es sich Details eingeprägt hat, statt Muster zu verstehen.
Damit ein Modell gut generalisiert, muss es mit vielfältigen Datensätzen getestet werden, die reale Bedingungen abbilden.
Overfitting in der Computer Vision verhindern#
Overfitting ist nicht unvermeidbar und lässt sich verhindern. Mit den passenden Techniken können Computer-Vision-Modelle allgemeine Muster lernen, statt sich Trainingsdaten einzuprägen. Dadurch werden sie in Anwendungen der Praxis zuverlässiger.
Hier sind fünf wichtige Strategien, um Overfitting in der Computer Vision zu verhindern.
Datenvielfalt durch Augmentierung und synthetische Daten erhöhen#
Am besten sorgst du dafür, dass ein Modell mit neuen Daten gut zurechtkommt, indem du den Datensatz mithilfe von Datenaugmentierung und synthetischen Daten erweiterst. Synthetische Daten werden am Computer generiert, statt aus realen Bildern zu stammen. Sie helfen, Lücken zu füllen, wenn nicht genügend reale Daten verfügbar sind.
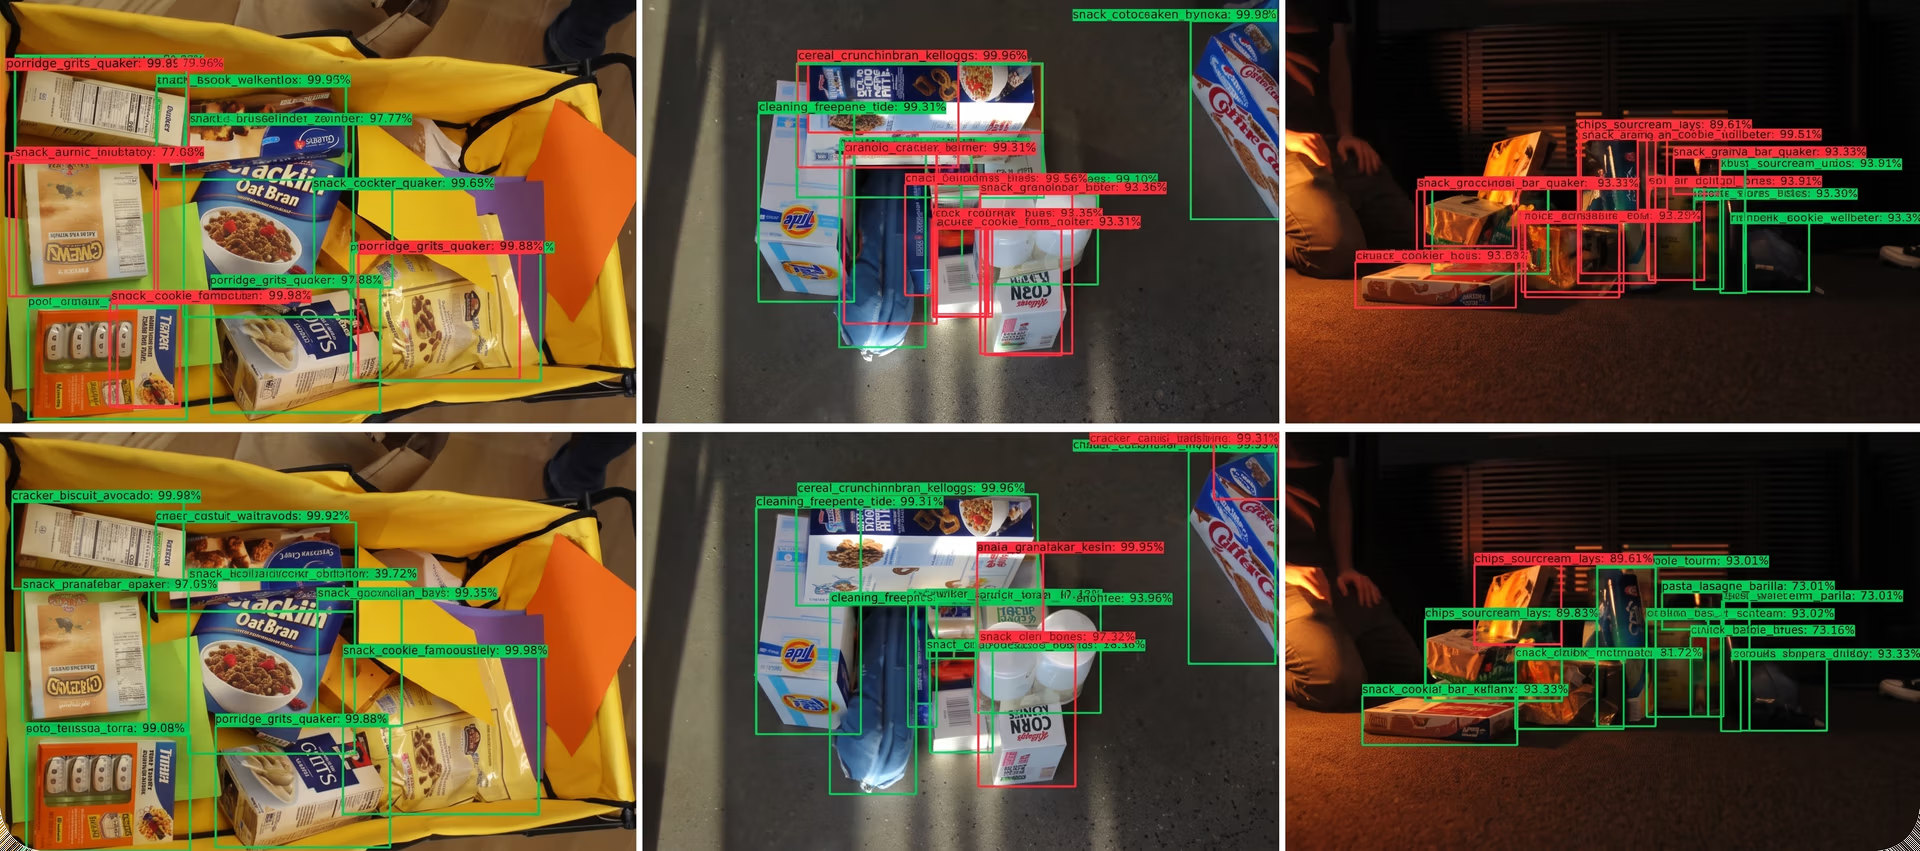
Abb. 2. Die Kombination realer und synthetischer Daten verringert Overfitting und verbessert die Genauigkeit der Objekterkennung.
Bei der Datenerweiterung werden vorhandene Bilder durch Spiegeln, Drehen, Zuschneiden oder Anpassen der Helligkeit leicht verändert. So prägt sich das Modell nicht einfach Details ein, sondern lernt, Objekte in verschiedenen Situationen zu erkennen.
Synthetische Daten sind nützlich, wenn reale Bilder schwer zu beschaffen sind. Selbstfahrende Autos können beispielsweise mit computergenerierten Straßenszenen trainiert werden, damit ihre Modelle Objekte bei unterschiedlichen Wetter- und Lichtverhältnissen erkennen lernen. Dadurch wird das Modell flexibler und zuverlässiger, ohne dass Tausende realer Bilder benötigt werden.
Modellkomplexität und Architektur optimieren#
Ein tiefes neuronales Netz ist eine Art Machine-Learning-Modell mit vielen Schichten, die Daten verarbeiten, statt nur einer einzigen Schicht. Es ist nicht immer besser. Hat ein Modell zu viele Schichten oder Parameter, memorisiert es die Trainingsdaten, statt übergreifende Muster zu erkennen. Unnötige Komplexität zu reduzieren, kann Overfitting verhindern.
Dazu kannst du beispielsweise Pruning einsetzen. Dabei werden redundante Neuronen und Verbindungen entfernt, wodurch das Modell schlanker und effizienter wird.
Eine weitere Möglichkeit ist, die Architektur durch weniger Schichten oder Neuronen zu vereinfachen. Vortrainierte Modelle wie Ultralytics YOLO11 sind darauf ausgelegt, mit weniger Parametern über verschiedene Aufgaben hinweg gut zu generalisieren. Dadurch sind sie weniger anfällig für Overfitting als ein tiefes Modell, das von Grund auf trainiert wird.
Das richtige Gleichgewicht zwischen Modelltiefe und Effizienz hilft dem Modell, nützliche Muster zu lernen, statt lediglich die Trainingsdaten zu memorisieren.
Regularisierungstechniken anwenden#
Regularisierungstechniken verhindern, dass Modelle zu abhängig von bestimmten Merkmalen in den Trainingsdaten werden. Hier sind einige häufig verwendete Techniken:
- Dropout deaktiviert während des Trainings zufällige Teile des Modells. So lernt es, unterschiedliche Muster zu erkennen, statt sich zu sehr auf wenige Merkmale zu verlassen.
- Gewichtsabnahme (L2-Regularisierung) wirkt extremen Gewichtswerten entgegen und hält so die Komplexität des Modells unter Kontrolle.
- Batch-Normalisierung stabilisiert das Training, indem sie dafür sorgt, dass das Modell weniger empfindlich auf Schwankungen im Datensatz reagiert.
Diese Techniken erhalten die Flexibilität und Anpassungsfähigkeit des Modells. Sie verringern das Risiko von Overfitting, ohne die Genauigkeit zu beeinträchtigen.
Training mit Validierung und Early Stopping überwachen#
Um Overfitting zu verhindern, ist es wichtig, nachzuverfolgen, wie das Modell lernt, und sicherzustellen, dass es gut auf neue Daten generalisiert. Hier sind zwei Techniken, die dabei helfen:
- Vorzeitiger Abbruch: Beendet das Training automatisch, wenn sich die Leistung auf dem Validierungsdatensatz nicht mehr verbessert. So lernt das Modell keine unnötigen Details weiter.
- Kreuzvalidierung: Teilt die Daten in mehrere Teilmengen auf. Anschließend wird wiederholt auf allen Teilmengen bis auf eine trainiert und auf der zurückgehaltenen Teilmenge validiert. So lässt sich zuverlässiger einschätzen, wie gut das Modell über bestimmte Bilder hinaus verallgemeinert.
Diese Techniken helfen dabei, das Modell im Gleichgewicht zu halten, damit es genug lernt, um genau zu sein, ohne sich zu stark auf die Trainingsdaten zu konzentrieren.
Vortrainierte Modelle verwenden und die Beschriftung des Datensatzes verbessern#
Statt von Grund auf zu trainieren, kannst du mit vortrainierten Modellen wie Ultralytics YOLO11 Overfitting reduzieren. YOLO11 wurde mit großen Datensätzen trainiert und kann dadurch unter unterschiedlichen Bedingungen gut generalisieren.
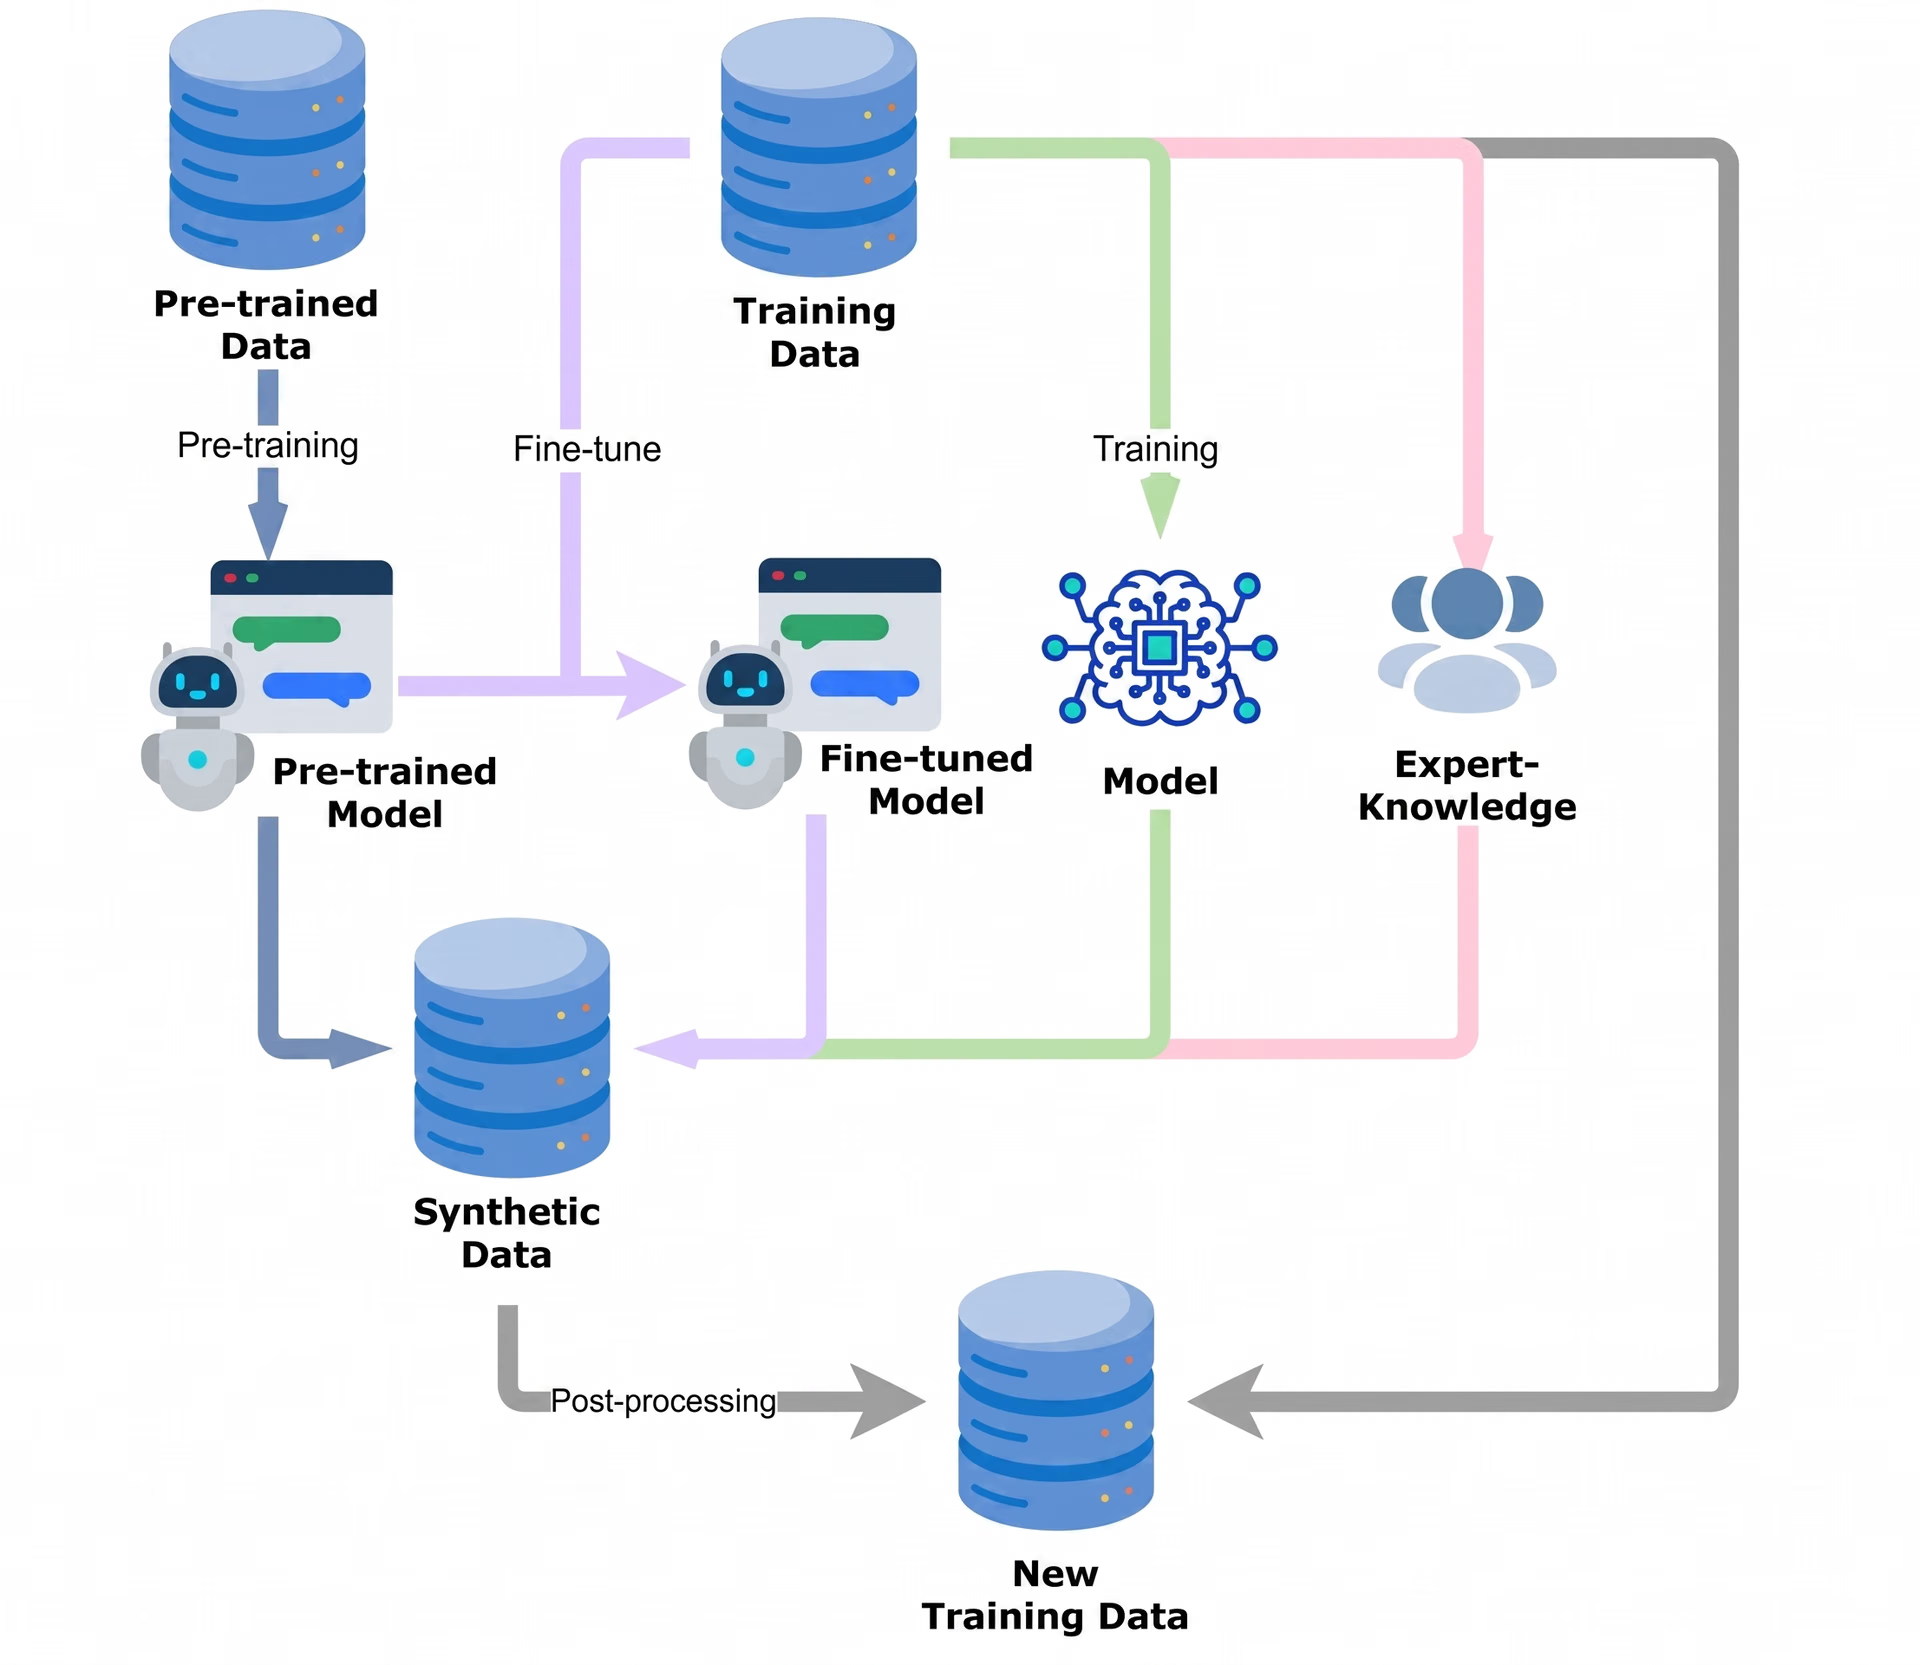
Abb. 3. Vortrainierte Computer-Vision-Modelle verbessern die Genauigkeit und verhindern Overfitting.
Durch die Feinabstimmung eines vortrainierten Modells kann es sein bisheriges Wissen beibehalten und gleichzeitig neue Aufgaben lernen. So memorisiert es nicht einfach die Trainingsdaten.
Außerdem ist eine hochwertige Beschriftung des Datensatzes unerlässlich. Falsch beschriftete oder unausgewogene Daten können dazu führen, dass Modelle falsche Muster lernen. Das Bereinigen von Datensätzen, das Korrigieren falsch beschrifteter Bilder und der Ausgleich der Klassen verbessern die Genauigkeit und verringern das Overfitting-Risiko. Ein weiterer wirksamer Ansatz ist adversariales Training, bei dem das Modell leicht veränderten oder anspruchsvolleren Beispielen ausgesetzt wird, die seine Grenzen testen sollen.
Die wichtigsten Erkenntnisse#
Overfitting ist ein häufiges Problem im Bereich Computer Vision. Ein Modell kann mit Trainingsdaten gut funktionieren, aber Schwierigkeiten mit realen Bildern haben. Um das zu verhindern, helfen Techniken wie Datenaugmentierung, Regularisierung und die Verwendung vortrainierter Modelle wie Ultralytics YOLO11, die Genauigkeit und Anpassungsfähigkeit zu verbessern.
Mit diesen Methoden bleiben KI-Modelle zuverlässig und leistungsfähig in unterschiedlichen Umgebungen. Mit den Fortschritten im Deep Learning wird es entscheidend sein, sicherzustellen, dass Modelle richtig generalisieren, damit KI in der Praxis erfolgreich ist.
Werde Teil unserer wachsenden Community! Erfahre mehr über KI in unserem GitHub-Repository. Möchtest du eigene Computer-Vision-Projekte starten? Sieh dir unsere Lizenzoptionen an. Entdecke Vision-KI für selbstfahrende Autos und KI im Gesundheitswesen auf unseren Lösungsseiten!
Verfasst von
Autor · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









