Overfitting trong thị giác máy tính là gì và cách ngăn chặn?
Tìm hiểu overfitting trong thị giác máy tính và cách ngăn chặn hiện tượng này bằng tăng cường dữ liệu, regularization và các model được huấn luyện trước.
Các model thị giác máy tính được thiết kế để nhận diện mẫu, phát hiện vật thể và phân tích hình ảnh. Tuy nhiên, hiệu năng của chúng phụ thuộc vào khả năng tổng quát hóa trên dữ liệu chưa từng thấy. Khả năng tổng quát hóa là khả năng hoạt động tốt của model trên các hình ảnh mới, không chỉ những hình ảnh được dùng để huấn luyện. Một vấn đề phổ biến khi huấn luyện các model này là overfitting, trong đó model học quá nhiều từ dữ liệu huấn luyện, bao gồm cả nhiễu không cần thiết, thay vì xác định các mẫu có ý nghĩa.
Khi xảy ra điều này, model hoạt động tốt trên dữ liệu huấn luyện nhưng gặp khó khăn với các hình ảnh mới. Ví dụ, một model phát hiện vật thể chỉ được huấn luyện trên các hình ảnh có độ phân giải cao và ánh sáng tốt có thể không hoạt động khi gặp những hình ảnh bị mờ hoặc có bóng trong điều kiện thực tế. Overfitting làm hạn chế khả năng thích ứng của model, từ đó hạn chế việc sử dụng model trong các ứng dụng thực tế như xe tự hành, chẩn đoán hình ảnh y tế và hệ thống an ninh.
Trong bài viết này, chúng ta sẽ tìm hiểu overfitting là gì, nguyên nhân xảy ra và cách ngăn chặn. Chúng ta cũng sẽ xem xét cách các model thị giác máy tính như Ultralytics YOLO11 giúp giảm overfitting và cải thiện khả năng tổng quát hóa.
Overfitting là gì?#
Overfitting xảy ra khi model ghi nhớ dữ liệu huấn luyện thay vì học các mẫu có khả năng áp dụng rộng rãi cho những đầu vào mới. Model tập trung quá mức vào dữ liệu huấn luyện nên gặp khó khăn với các hình ảnh hoặc tình huống mới mà nó chưa từng thấy.
Trong thị giác máy tính, overfitting có thể ảnh hưởng đến nhiều tác vụ khác nhau. Một model phân loại chỉ được huấn luyện trên các hình ảnh sáng, rõ nét có thể gặp khó khăn trong điều kiện thiếu sáng. Một model phát hiện vật thể học từ những hình ảnh hoàn hảo có thể không hoạt động trong các cảnh đông đúc hoặc lộn xộn. Tương tự, một model phân đoạn đối tượng có thể hoạt động tốt trong môi trường được kiểm soát nhưng gặp khó khăn với bóng đổ hoặc các vật thể chồng lấn.
Điều này trở thành vấn đề trong các ứng dụng AI thực tế, nơi model phải có khả năng tổng quát hóa vượt ra ngoài các điều kiện huấn luyện được kiểm soát. Chẳng hạn, xe tự hành phải có khả năng phát hiện người đi bộ trong nhiều điều kiện ánh sáng, thời tiết và môi trường khác nhau. Một model bị overfitting trên tập huấn luyện sẽ không hoạt động đáng tin cậy trong những tình huống khó dự đoán như vậy.
Overfitting xảy ra khi nào và tại sao?#
Overfitting thường xảy ra do dataset mất cân bằng, model quá phức tạp và huấn luyện quá lâu. Dưới đây là các nguyên nhân chính:
- Dữ liệu huấn luyện hạn chế: Dataset nhỏ khiến model ghi nhớ các mẫu thay vì tổng quát hóa chúng. Một model chỉ được huấn luyện trên 50 hình ảnh về chim có thể gặp khó khăn khi phát hiện các loài chim nằm ngoài dataset đó.
- Model phức tạp với quá nhiều tham số: Các mạng sâu có quá nhiều lớp và neuron thường ghi nhớ các chi tiết nhỏ thay vì tập trung vào những đặc trưng thiết yếu.
- Thiếu tăng cường dữ liệu: Nếu không có các phép biến đổi như cắt, lật hoặc xoay, model có thể chỉ học từ chính xác những hình ảnh trong tập huấn luyện.
- Huấn luyện kéo dài: Nếu model lặp qua dữ liệu huấn luyện quá nhiều lần, được gọi là epoch, model sẽ ghi nhớ các chi tiết thay vì học các mẫu tổng quát, khiến khả năng thích ứng kém hơn.
- Nhãn không nhất quán hoặc chứa nhiễu: Dữ liệu được gán nhãn không chính xác khiến model học các mẫu sai. Điều này thường gặp trong các dataset được gán nhãn thủ công.
Một cách tiếp cận cân bằng giữa độ phức tạp của model, chất lượng dataset và các kỹ thuật huấn luyện sẽ đảm bảo khả năng tổng quát hóa tốt hơn.
Overfitting và underfitting#
Overfitting và underfitting là hai vấn đề hoàn toàn đối lập trong deep learning.
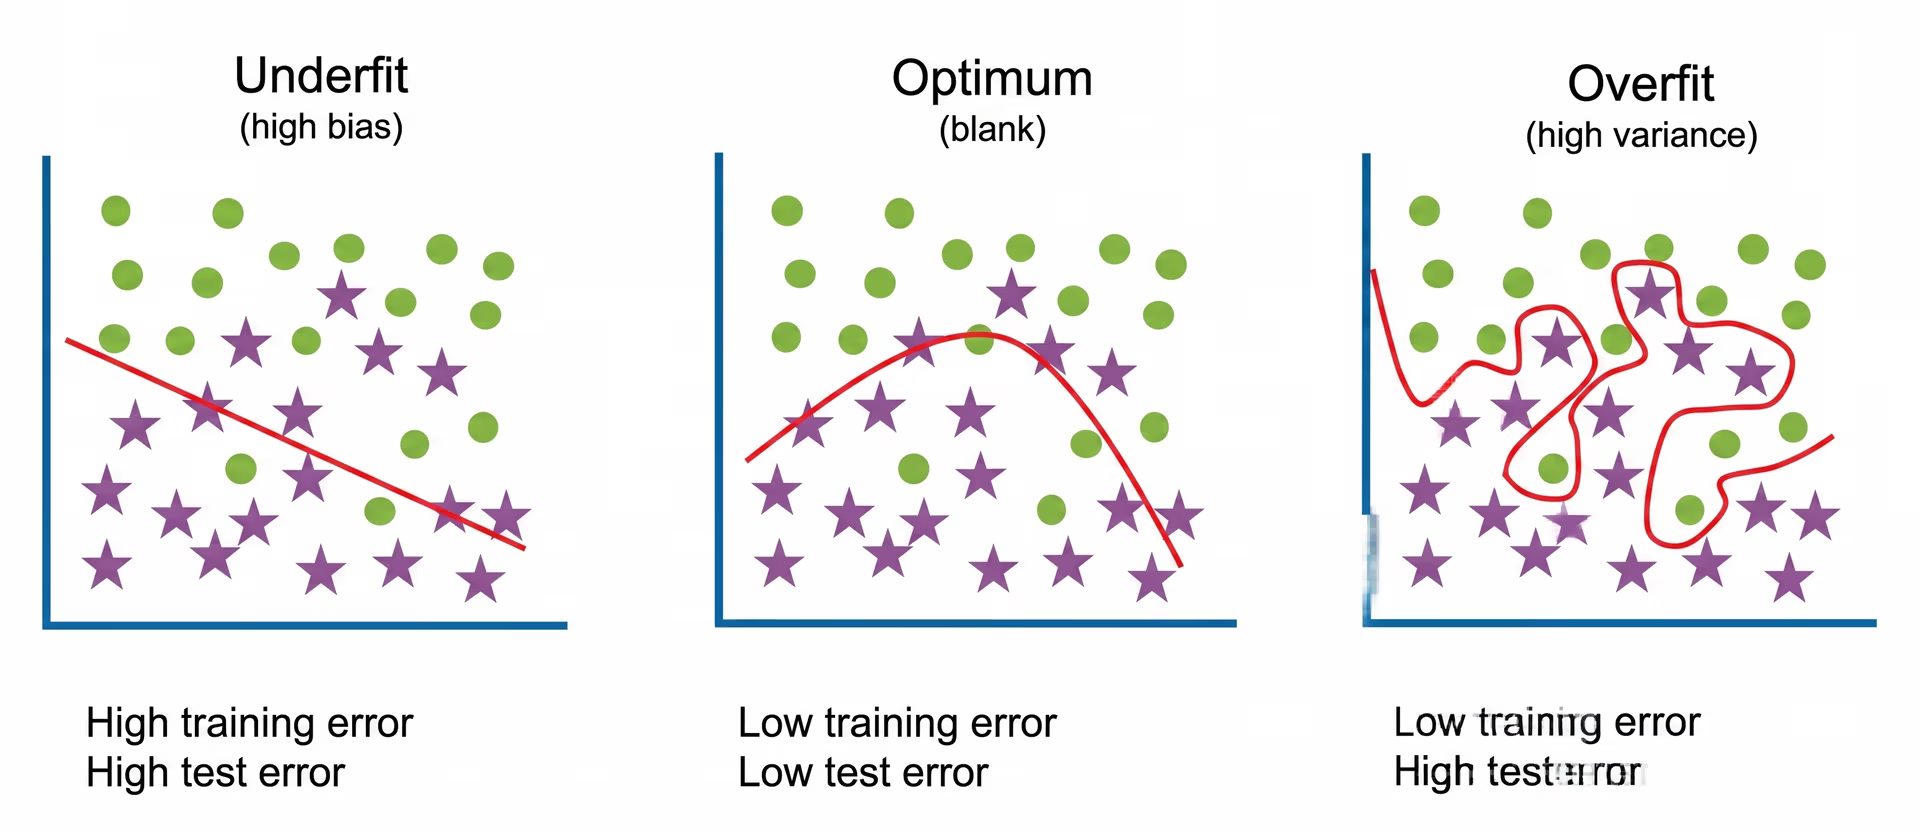
Hình 1. So sánh underfitting, quá trình học tối ưu và overfitting trong các model thị giác máy tính.
Overfitting xảy ra khi model quá phức tạp, khiến model tập trung quá mức vào dữ liệu huấn luyện. Thay vì học các mẫu tổng quát, model ghi nhớ những chi tiết nhỏ, thậm chí cả những chi tiết không liên quan như nhiễu nền. Điều này khiến model hoạt động tốt trên dữ liệu huấn luyện nhưng gặp khó khăn với các hình ảnh mới, cho thấy model chưa thực sự học cách nhận diện những mẫu có thể áp dụng trong các tình huống khác nhau.
Underfitting xảy ra khi model quá đơn giản nên bỏ sót các mẫu quan trọng trong dữ liệu. Điều này có thể xảy ra khi model có quá ít lớp, thời gian huấn luyện không đủ hoặc dữ liệu bị hạn chế. Do đó, model không nhận diện được các mẫu quan trọng và đưa ra dự đoán không chính xác. Điều này dẫn đến hiệu năng kém trên cả dữ liệu huấn luyện và dữ liệu kiểm thử vì model chưa học đủ để hiểu đúng tác vụ.
Một model được huấn luyện tốt sẽ tìm được sự cân bằng giữa độ phức tạp và khả năng tổng quát hóa. Model cần đủ phức tạp để học các mẫu liên quan nhưng không được phức tạp đến mức ghi nhớ dữ liệu thay vì nhận diện các mối quan hệ nền tảng.
Cách nhận diện overfitting#
Dưới đây là một số dấu hiệu cho thấy model đang bị overfitting:
- Nếu độ chính xác trên dữ liệu huấn luyện cao hơn đáng kể so với độ chính xác trên dữ liệu validation, nhiều khả năng model đang bị overfitting.
- Khoảng cách ngày càng lớn giữa loss trên dữ liệu huấn luyện và loss trên dữ liệu validation là một dấu hiệu rõ ràng khác.
- Model quá tự tin với các câu trả lời sai, cho thấy model đã ghi nhớ các chi tiết thay vì hiểu các mẫu.
Để đảm bảo model có khả năng tổng quát hóa tốt, cần kiểm thử model trên các dataset đa dạng phản ánh điều kiện thực tế.
Cách ngăn chặn overfitting trong thị giác máy tính#
Overfitting không phải là điều tất yếu và có thể được ngăn chặn. Với các kỹ thuật phù hợp, model thị giác máy tính có thể học các mẫu tổng quát thay vì ghi nhớ dữ liệu huấn luyện, từ đó hoạt động đáng tin cậy hơn trong các ứng dụng thực tế.
Dưới đây là năm chiến lược chính để ngăn chặn overfitting trong thị giác máy tính.
Tăng tính đa dạng của dữ liệu bằng tăng cường dữ liệu và dữ liệu tổng hợp#
Cách tốt nhất để giúp model hoạt động tốt trên dữ liệu mới là mở rộng dataset bằng cách sử dụng tăng cường dữ liệu và dữ liệu tổng hợp. Dữ liệu tổng hợp được tạo bằng máy tính thay vì thu thập từ các hình ảnh trong thế giới thực. Dữ liệu này giúp bổ sung những phần còn thiếu khi không có đủ dữ liệu thực tế.
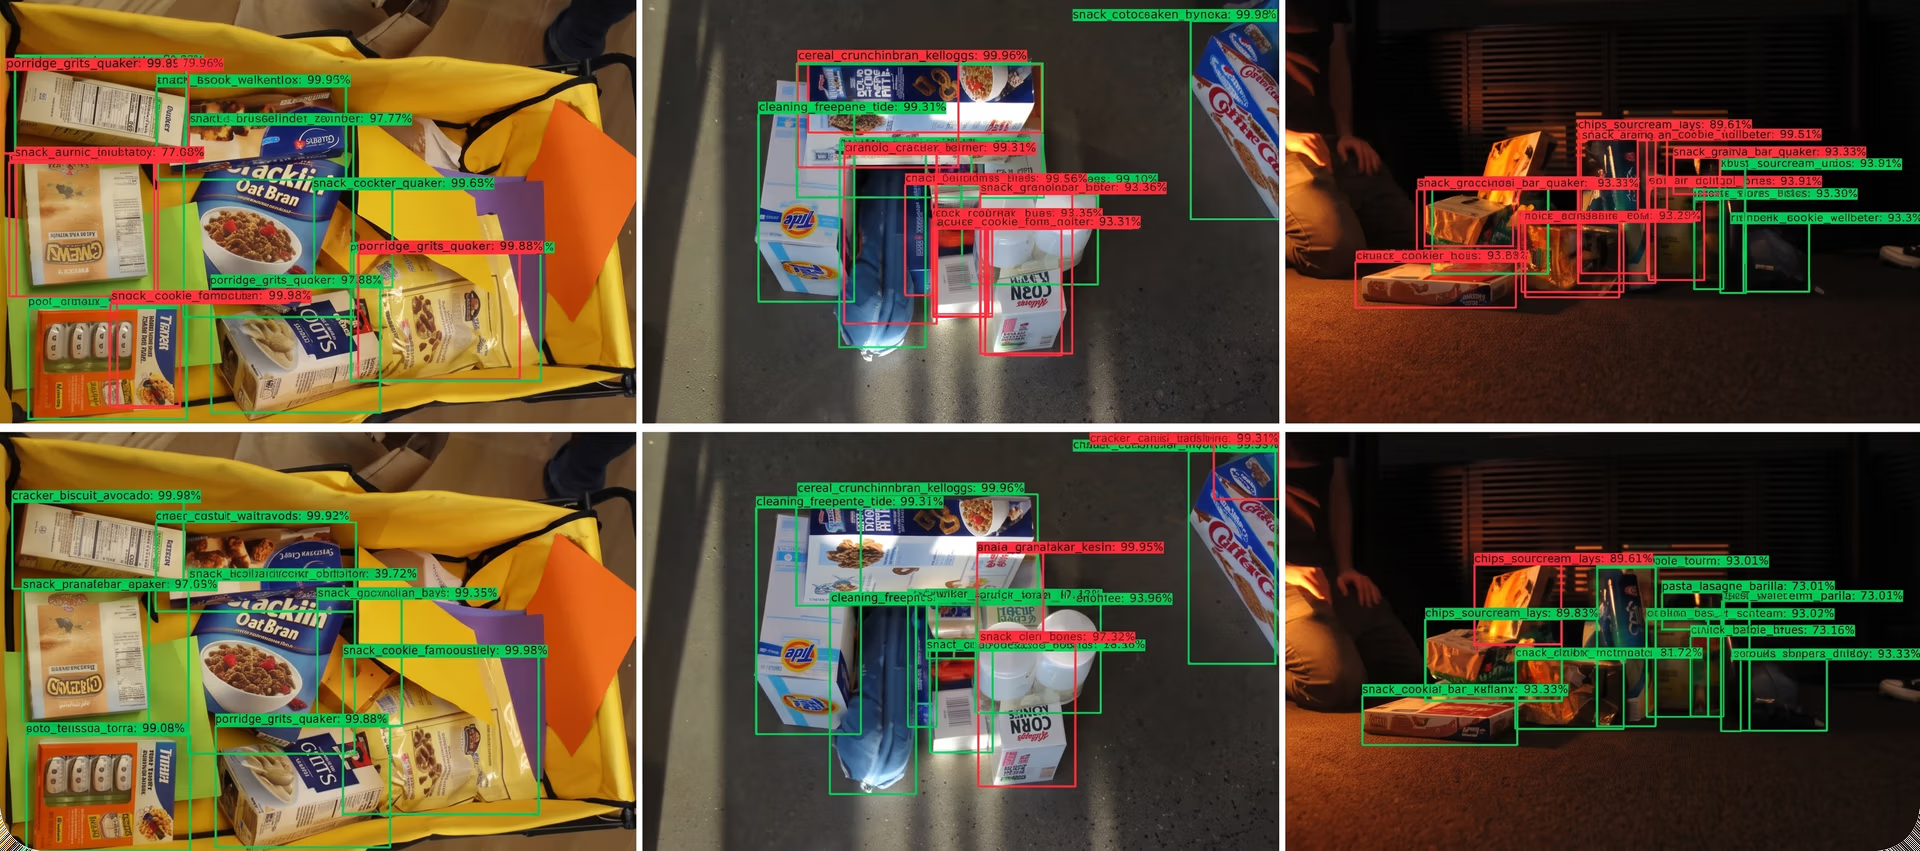
Hình 2. Kết hợp dữ liệu thực tế và dữ liệu tổng hợp giúp giảm overfitting và cải thiện độ chính xác phát hiện vật thể.
Tăng cường dữ liệu làm thay đổi nhẹ các hình ảnh hiện có bằng cách lật, xoay, cắt hoặc điều chỉnh độ sáng, nhờ đó model không chỉ ghi nhớ các chi tiết mà còn học cách nhận diện vật thể trong những tình huống khác nhau.
Dữ liệu tổng hợp hữu ích khi khó thu thập hình ảnh thực tế. Ví dụ, các model dành cho xe tự hành có thể được huấn luyện trên những cảnh đường sá do máy tính tạo ra để học cách phát hiện vật thể trong các điều kiện thời tiết và ánh sáng khác nhau. Điều này giúp model linh hoạt và đáng tin cậy hơn mà không cần hàng nghìn hình ảnh thực tế.
Tối ưu hóa độ phức tạp và kiến trúc model#
Một mạng neuron sâu, tức là một loại model machine learning có nhiều lớp xử lý dữ liệu thay vì chỉ một lớp, không phải lúc nào cũng tốt hơn. Khi model có quá nhiều lớp hoặc tham số, model sẽ ghi nhớ dữ liệu huấn luyện thay vì nhận diện các mẫu rộng hơn. Giảm độ phức tạp không cần thiết có thể giúp ngăn chặn overfitting.
Để đạt được điều này, một phương pháp là pruning, trong đó các neuron và kết nối dư thừa được loại bỏ, giúp model tinh gọn và hiệu quả hơn.
Một phương pháp khác là đơn giản hóa kiến trúc bằng cách giảm số lượng lớp hoặc neuron. Các model được huấn luyện trước như Ultralytics YOLO11 được thiết kế để tổng quát hóa tốt trên nhiều tác vụ với ít tham số hơn, giúp chúng chống overfitting tốt hơn so với việc huấn luyện một model sâu từ đầu.
Tìm được sự cân bằng phù hợp giữa độ sâu và hiệu quả của model sẽ giúp model học các mẫu hữu ích mà không chỉ ghi nhớ dữ liệu huấn luyện.
Áp dụng các kỹ thuật regularization#
Các kỹ thuật regularization ngăn model trở nên quá phụ thuộc vào những đặc trưng cụ thể trong dữ liệu huấn luyện. Dưới đây là một số kỹ thuật thường được sử dụng:
- Dropout tắt ngẫu nhiên một số phần của model trong quá trình huấn luyện, giúp model học cách nhận diện các mẫu khác nhau thay vì phụ thuộc quá nhiều vào một vài đặc trưng.
- Weight decay (regularization L2) hạn chế các giá trị trọng số quá lớn, giúp kiểm soát độ phức tạp của model.
- Batch normalization giúp ổn định quá trình huấn luyện bằng cách đảm bảo model ít nhạy cảm hơn với những biến thiên trong dataset.
Các kỹ thuật này giúp duy trì tính linh hoạt và khả năng thích ứng của model, giảm nguy cơ overfitting mà vẫn bảo toàn độ chính xác.
Giám sát quá trình huấn luyện bằng validation và early stopping#
Để ngăn chặn overfitting, điều quan trọng là theo dõi cách model học và đảm bảo model tổng quát hóa tốt trên dữ liệu mới. Dưới đây là một số kỹ thuật hỗ trợ việc này:
- Early stopping: Tự động kết thúc quá trình huấn luyện khi model không còn cải thiện, nhờ đó model không tiếp tục học các chi tiết không cần thiết.
- Cross-validation: Chia dữ liệu thành các phần và huấn luyện model trên từng phần. Điều này giúp model học các mẫu thay vì ghi nhớ những hình ảnh cụ thể.
Các kỹ thuật này giúp model duy trì sự cân bằng để học đủ nhằm đạt độ chính xác cao mà không tập trung quá mức chỉ vào dữ liệu huấn luyện.
Sử dụng các model được huấn luyện trước và cải thiện việc gán nhãn dataset#
Thay vì huấn luyện từ đầu, sử dụng các model được huấn luyện trước như Ultralytics YOLO11 có thể giảm overfitting. YOLO11 được huấn luyện trên các dataset quy mô lớn, nhờ đó có khả năng tổng quát hóa tốt trong nhiều điều kiện khác nhau.
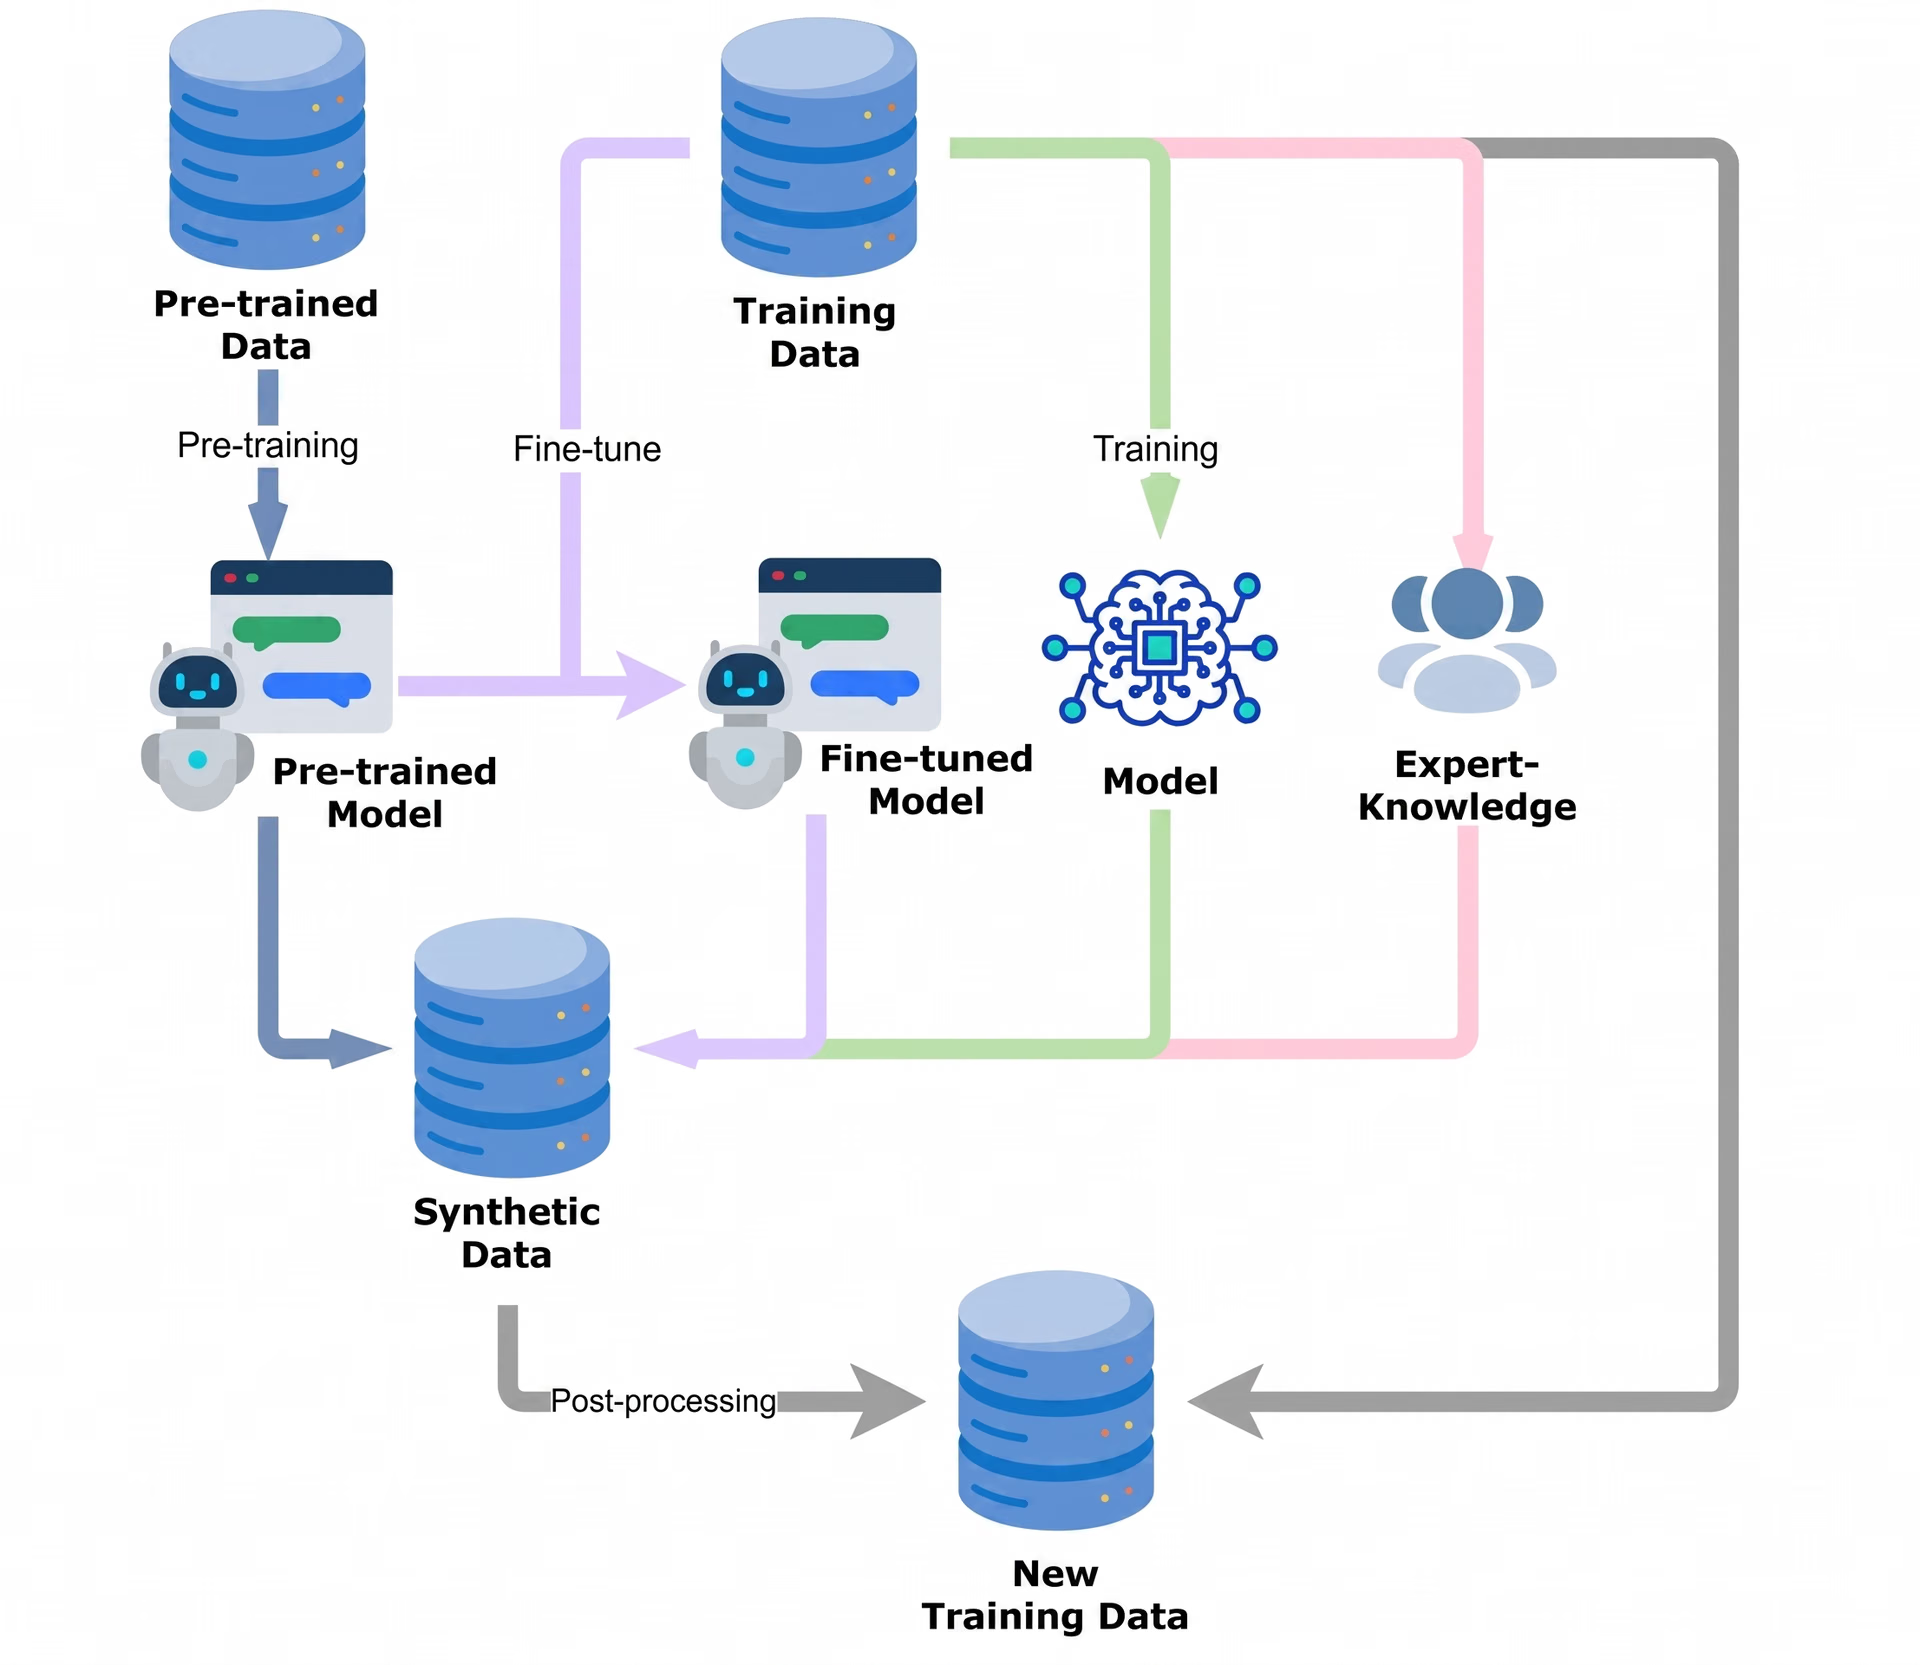
Hình 3. Các model thị giác máy tính được huấn luyện trước giúp nâng cao độ chính xác và ngăn chặn overfitting.
Fine-tuning một model được huấn luyện trước giúp model duy trì những gì đã biết trong khi học các tác vụ mới, nhờ đó model không chỉ ghi nhớ dữ liệu huấn luyện.
Ngoài ra, việc đảm bảo dataset được gán nhãn chất lượng cao là điều thiết yếu. Dữ liệu bị gán nhãn sai hoặc mất cân bằng có thể khiến model học các mẫu không chính xác. Làm sạch dataset, sửa các hình ảnh bị gán nhãn sai và cân bằng các class giúp cải thiện độ chính xác và giảm nguy cơ overfitting. Một phương pháp hiệu quả khác là adversarial training, trong đó model được tiếp xúc với các ví dụ bị thay đổi nhẹ hoặc khó hơn, được thiết kế để kiểm tra giới hạn của model.
Những điểm chính#
Overfitting là một vấn đề phổ biến trong thị giác máy tính. Một model có thể hoạt động tốt trên dữ liệu huấn luyện nhưng gặp khó khăn với các hình ảnh thực tế. Để tránh điều này, các kỹ thuật như tăng cường dữ liệu, regularization và sử dụng các model được huấn luyện trước như Ultralytics YOLO11 giúp cải thiện độ chính xác và khả năng thích ứng.
Bằng cách áp dụng các phương pháp này, các model AI có thể duy trì độ tin cậy và hoạt động tốt trong nhiều môi trường khác nhau. Khi deep learning tiếp tục phát triển, đảm bảo model tổng quát hóa đúng cách sẽ là yếu tố then chốt để AI thành công trong thế giới thực.
Hãy tham gia cộng đồng đang phát triển của chúng tôi! Khám phá repository GitHub để tìm hiểu thêm về AI. Sẵn sàng bắt đầu các dự án thị giác máy tính của riêng bạn? Hãy xem các tùy chọn cấp phép của chúng tôi. Khám phá AI thị giác trong xe tự hành và AI trong lĩnh vực chăm sóc sức khỏe bằng cách truy cập các trang giải pháp của chúng tôi!








