Hướng dẫn toàn diện về tăng cường dữ liệu năm 2025
Tìm hiểu cách tăng cường dữ liệu hình ảnh giúp model Vision AI học tốt hơn, nâng cao độ chính xác và hoạt động hiệu quả hơn trong các tình huống thực tế.
Nhờ làn sóng AI, những hiện tượng như robot làm việc trong nhà máy và xe tự lái di chuyển trên đường phố ngày càng xuất hiện nhiều trên các mặt báo. AI đang thay đổi cách máy móc tương tác với thế giới, từ cải thiện hình ảnh y khoa đến hỗ trợ kiểm soát chất lượng trên dây chuyền sản xuất.
Phần lớn tiến bộ này đến từ thị giác máy tính, một nhánh của AI giúp máy có khả năng hiểu và diễn giải hình ảnh. Cũng như con người học cách nhận diện đối tượng và mẫu hình theo thời gian, các model Vision AI như Ultralytics YOLO11 cần được huấn luyện trên lượng lớn dữ liệu hình ảnh để phát triển khả năng hiểu thị giác.
Tuy nhiên, việc thu thập lượng dữ liệu hình ảnh khổng lồ như vậy không phải lúc nào cũng dễ dàng. Dù cộng đồng thị giác máy tính đã tạo ra nhiều dataset lớn, các dataset này vẫn có thể thiếu một số biến thể nhất định — chẳng hạn ảnh có đối tượng trong điều kiện thiếu sáng, vật thể bị che khuất một phần hoặc được chụp từ các góc khác nhau. Những khác biệt này có thể gây nhầm lẫn cho các model thị giác máy tính chỉ được huấn luyện trong những điều kiện cụ thể.
Tăng cường dữ liệu hình ảnh là kỹ thuật giải quyết vấn đề này bằng cách tạo thêm các biến thể mới từ dữ liệu hiện có. Bằng cách chỉnh sửa hình ảnh như điều chỉnh màu sắc, xoay hoặc thay đổi phối cảnh, dataset trở nên đa dạng hơn, giúp model Vision AI nhận diện đối tượng tốt hơn trong các tình huống thực tế.
Trong bài viết này, chúng ta sẽ tìm hiểu cách tăng cường dữ liệu hình ảnh hoạt động và tác động của kỹ thuật này đến các ứng dụng thị giác máy tính.
Tăng cường dữ liệu hình ảnh là gì?#
Hãy tưởng tượng bạn đang cố nhận ra một người bạn trong đám đông, nhưng người đó đeo kính râm hoặc đứng ở nơi râm mát. Dù diện mạo có những thay đổi nhỏ này, bạn vẫn nhận ra họ. Ngược lại, model Vision AI có thể gặp khó khăn với những biến thể như vậy nếu chưa được huấn luyện để nhận diện đối tượng trong các điều kiện khác nhau.
Tăng cường dữ liệu hình ảnh cải thiện hiệu năng của model thị giác máy tính bằng cách bổ sung các phiên bản đã chỉnh sửa của hình ảnh hiện có vào dữ liệu huấn luyện, thay vì phải thu thập hàng nghìn ảnh mới.
Những thay đổi như lật, xoay, điều chỉnh độ sáng hoặc thêm biến dạng nhỏ giúp model Vision AI tiếp xúc với nhiều điều kiện hơn. Thay vì phụ thuộc vào dataset khổng lồ, model có thể học hiệu quả từ dataset huấn luyện nhỏ hơn có chứa ảnh đã được tăng cường.
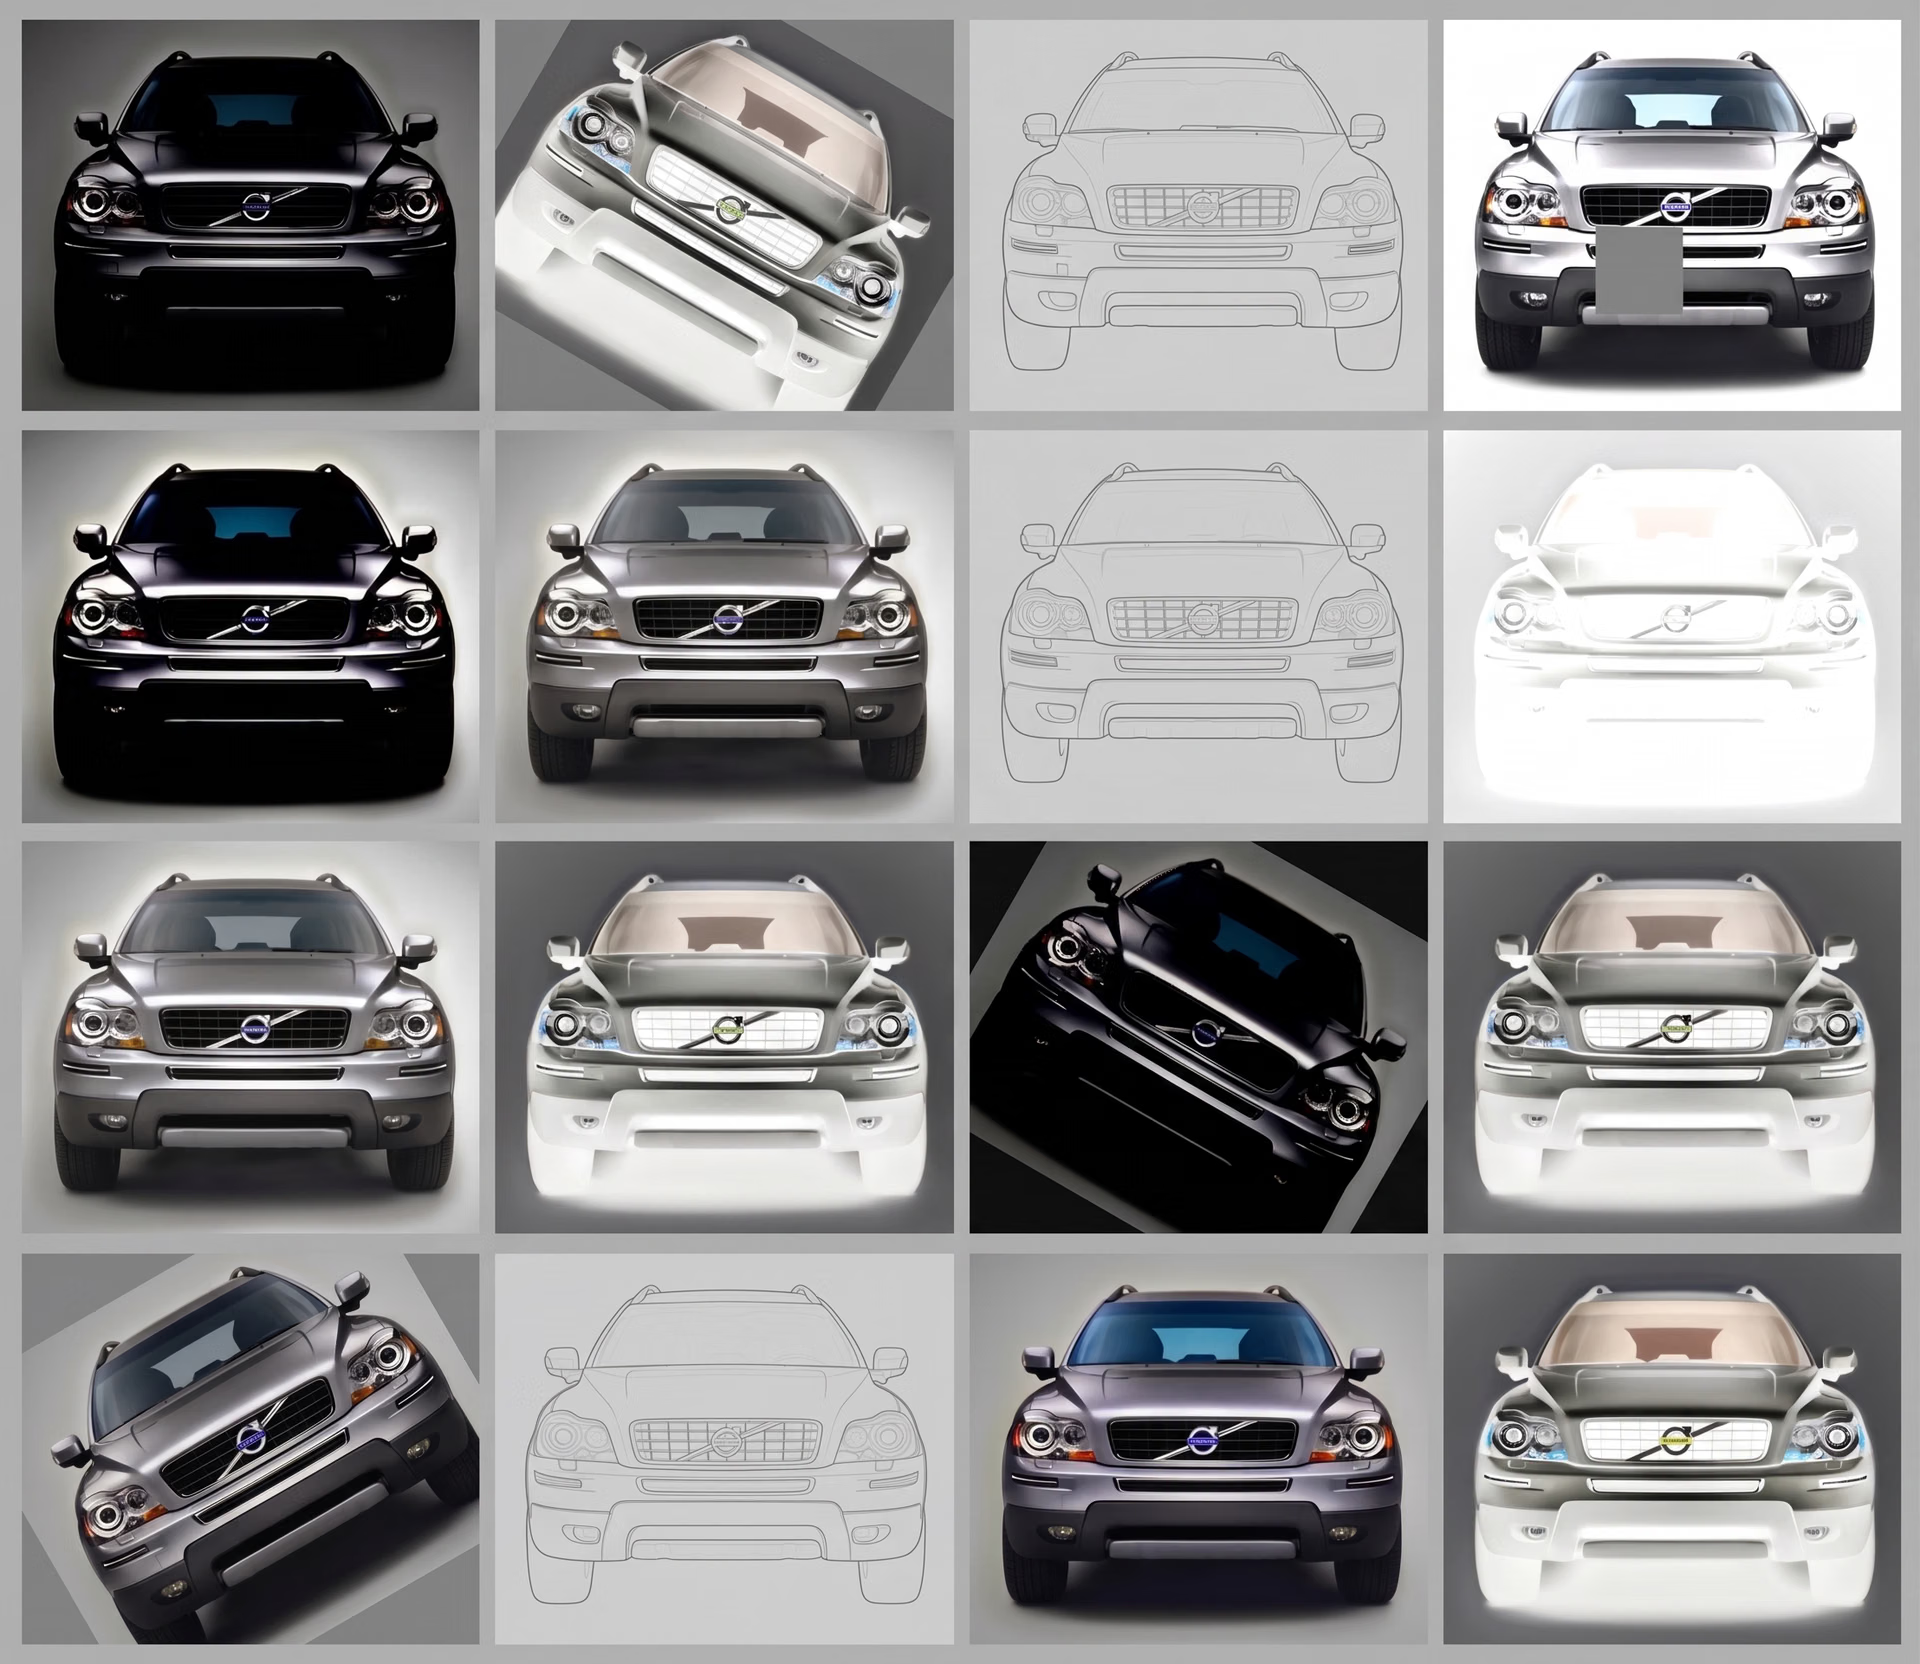
Hình 1. Ví dụ về ảnh ô tô đã qua tăng cường dữ liệu.
Tầm quan trọng của tăng cường dữ liệu trong thị giác máy tính#
Dưới đây là một số lý do chính khiến tăng cường dữ liệu rất cần thiết cho thị giác máy tính:
- Giảm yêu cầu về dữ liệu: Việc thu thập dataset hình ảnh lớn đòi hỏi thời gian và tài nguyên. Có thể sử dụng tăng cường dữ liệu để huấn luyện model hiệu quả mà không cần dataset khổng lồ.
- Ngăn overfitting: Model được huấn luyện bằng quá ít ví dụ có thể ghi nhớ chi tiết thay vì nhận diện các mẫu hình tổng quát. Việc bổ sung sự đa dạng thông qua tăng cường dữ liệu đảm bảo model Vision AI học theo cách có thể áp dụng cho dữ liệu mới và chưa từng thấy.
- Mô phỏng hình ảnh không hoàn hảo: Hình ảnh trong dataset thường quá hoàn hảo, trong khi ảnh thực tế có thể bị mờ, che khuất hoặc biến dạng. Tăng cường ảnh bằng nhiễu, vật che khuất hoặc các biến thể khác giúp ảnh trở nên thực tế hơn.
- Tăng độ vững chắc của model: Huấn luyện bằng nhiều loại hình ảnh giúp AI xử lý các thay đổi trong thực tế, khiến model đáng tin cậy hơn trong những môi trường, điều kiện ánh sáng và tình huống khác nhau.
Khi nào nên sử dụng tăng cường dữ liệu hình ảnh?#
Tăng cường dữ liệu hình ảnh đặc biệt hữu ích khi model thị giác máy tính cần nhận diện đối tượng trong nhiều tình huống khác nhau nhưng không có đủ ảnh đa dạng.
Ví dụ, nếu các nhà nghiên cứu huấn luyện model Vision AI để nhận diện những loài sinh vật dưới nước quý hiếm ít khi được chụp ảnh, dataset có thể nhỏ hoặc thiếu tính đa dạng. Bằng cách tăng cường hình ảnh — điều chỉnh màu sắc để mô phỏng các độ sâu nước khác nhau, thêm nhiễu để bắt chước điều kiện nước đục hoặc thay đổi hình dạng đôi chút để phản ánh chuyển động tự nhiên — model có thể phát hiện đối tượng dưới nước chính xác hơn.
Dưới đây là một số tình huống khác mà tăng cường dữ liệu tạo ra khác biệt đáng kể:
- Cân bằng dataset: Một số đối tượng có thể xuất hiện ít hơn trong dữ liệu huấn luyện, khiến model Vision AI bị thiên lệch. Tăng cường dữ liệu giúp tạo thêm ví dụ về các đối tượng hiếm để model nhận diện công bằng tất cả các danh mục.
- Thích ứng với các camera khác nhau: Hình ảnh có thể trông khác nhau tùy theo thiết bị. Tăng cường dữ liệu giúp model Vision AI hoạt động tốt với ảnh có độ phân giải, ánh sáng và chất lượng khác nhau.
- Sửa lỗi gán nhãn nhỏ: Dịch chuyển nhẹ, cắt ảnh hoặc xoay ảnh giúp model thị giác máy tính nhận diện đối tượng chính xác, ngay cả khi nhãn ban đầu chưa được căn chỉnh hoàn hảo.
Tăng cường dữ liệu hình ảnh hoạt động như thế nào#
Trong những ngày đầu của thị giác máy tính, tăng cường dữ liệu hình ảnh chủ yếu sử dụng các kỹ thuật xử lý ảnh cơ bản như lật, xoay và cắt ảnh để tăng tính đa dạng của dataset. Khi AI phát triển, các phương pháp nâng cao hơn được đưa vào, chẳng hạn điều chỉnh màu sắc (chuyển đổi không gian màu), làm sắc nét hoặc làm mờ ảnh (bộ lọc kernel) và pha trộn nhiều ảnh (trộn ảnh) để cải thiện quá trình học.
Tăng cường dữ liệu có thể diễn ra trước và trong quá trình huấn luyện model. Trước khi huấn luyện, có thể thêm ảnh đã chỉnh sửa vào dataset để tăng tính đa dạng. Trong quá trình huấn luyện, ảnh có thể được biến đổi ngẫu nhiên theo thời gian thực, giúp model Vision AI thích ứng với các điều kiện khác nhau.
Những thay đổi này được thực hiện bằng các phép biến đổi toán học. Ví dụ, phép xoay làm nghiêng ảnh, phép cắt loại bỏ các phần ảnh để mô phỏng góc nhìn khác nhau, còn thay đổi độ sáng mô phỏng các biến thể ánh sáng. Làm mờ khiến ảnh mềm hơn, làm sắc nét giúp chi tiết rõ hơn, còn trộn ảnh kết hợp các phần từ nhiều ảnh khác nhau. Framework Vision AI và các công cụ như OpenCV, TensorFlow và PyTorch có thể tự động hóa những quy trình này, giúp tăng cường dữ liệu nhanh chóng và hiệu quả.
Các kỹ thuật tăng cường dữ liệu hình ảnh quan trọng#
Giờ đây khi đã tìm hiểu tăng cường dữ liệu hình ảnh là gì, hãy cùng xem xét kỹ hơn một số kỹ thuật tăng cường dữ liệu hình ảnh cơ bản được sử dụng để cải thiện dữ liệu huấn luyện.
Điều chỉnh hướng và vị trí#
Các model thị giác máy tính như YOLO11 thường cần nhận diện đối tượng từ nhiều góc độ và góc nhìn khác nhau. Để hỗ trợ việc này, có thể lật ảnh theo chiều ngang hoặc chiều dọc để model AI học cách nhận diện đối tượng từ các góc nhìn khác nhau.
Tương tự, xoay ảnh một góc nhỏ sẽ thay đổi góc ảnh, giúp model nhận diện đối tượng từ nhiều góc nhìn. Ngoài ra, dịch chuyển ảnh theo các hướng khác nhau (translation) giúp model thích ứng với những thay đổi nhỏ về vị trí. Những phép biến đổi này đảm bảo model khái quát hóa tốt hơn trong điều kiện thực tế, nơi vị trí đối tượng trong ảnh không thể dự đoán trước.
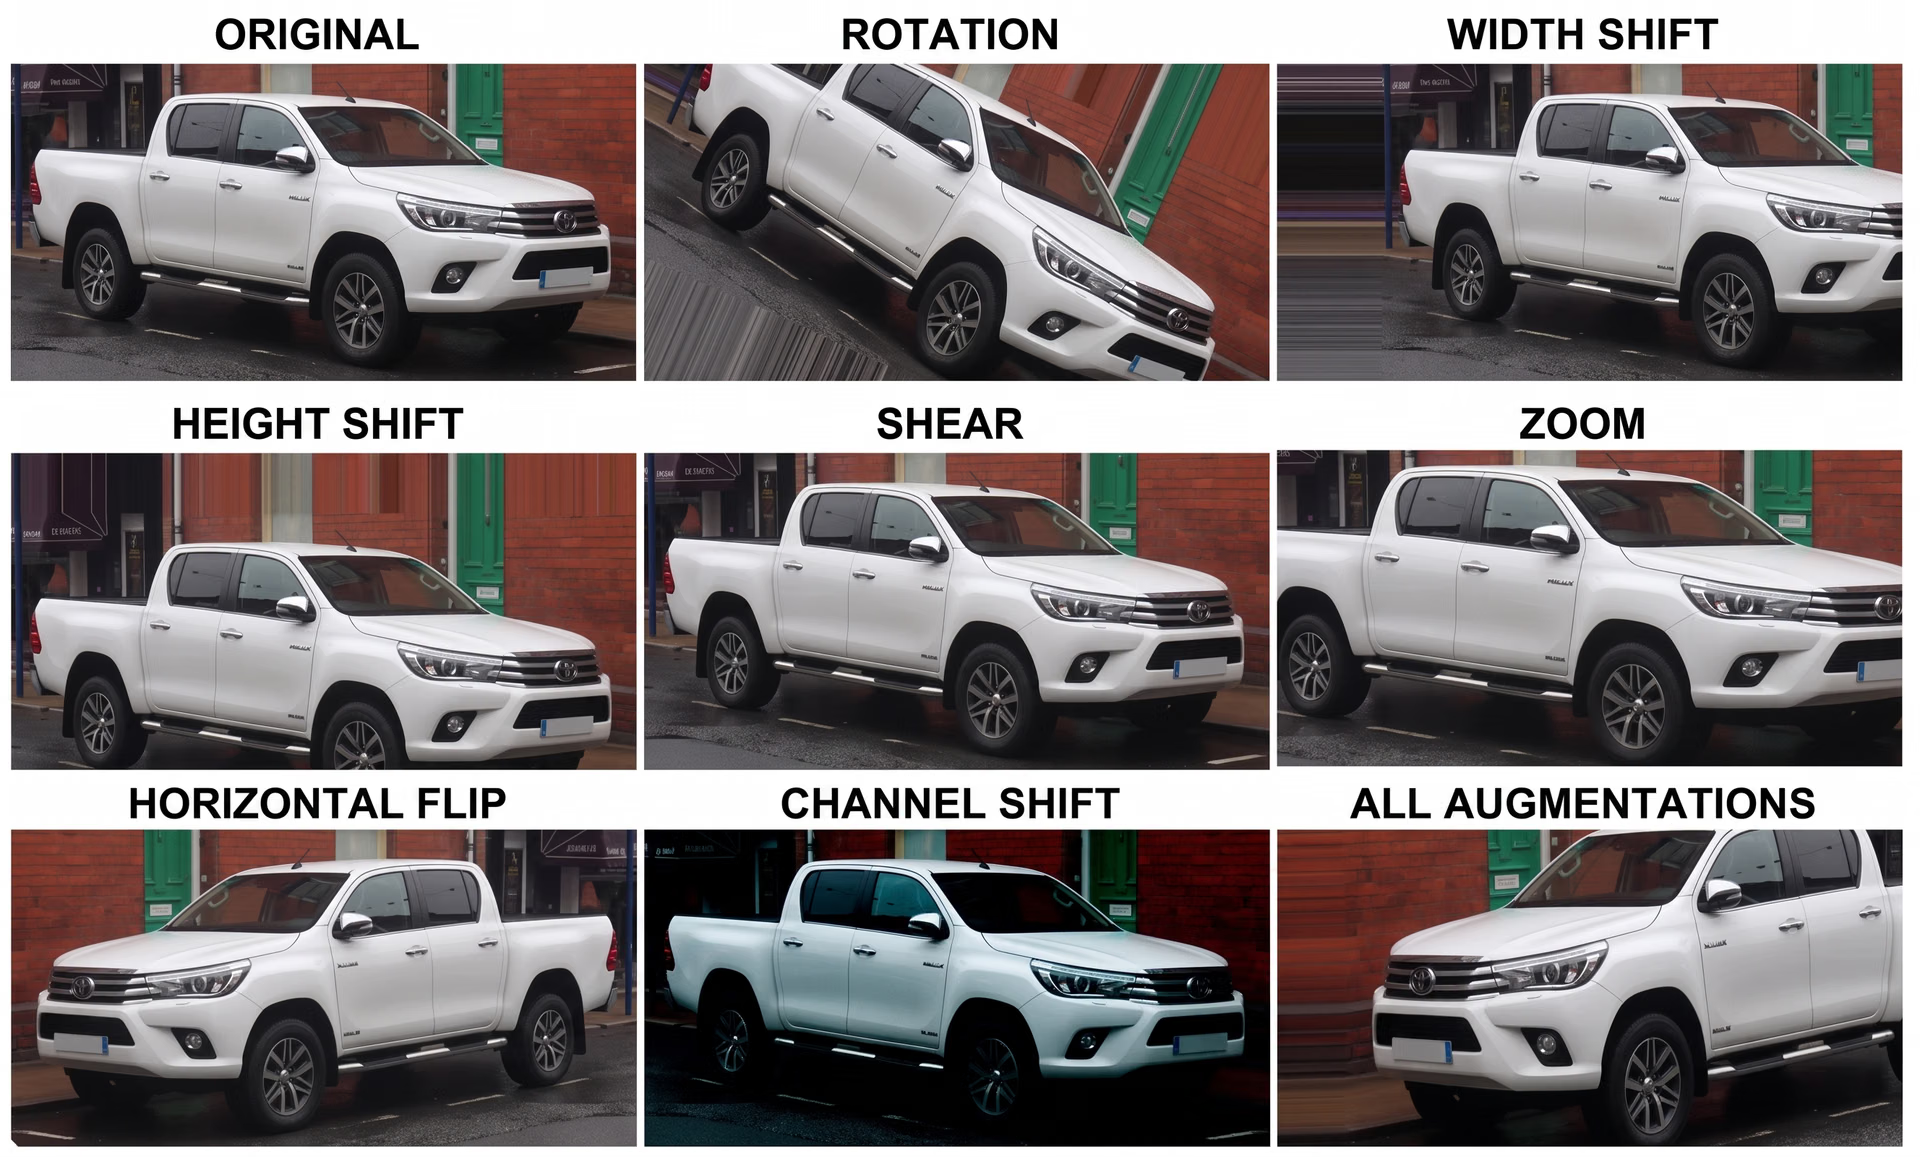
Hình 2. Các phương pháp tăng cường dữ liệu liên quan đến hướng và vị trí.
Thay đổi kích thước và cắt ảnh#
Đối với các giải pháp thị giác máy tính trong thế giới thực, các đối tượng trong ảnh có thể xuất hiện ở nhiều khoảng cách và kích thước khác nhau. Các model Vision AI cần đủ robust để phát hiện chúng bất kể những khác biệt này.
Để tăng khả năng thích ứng, có thể sử dụng các phương pháp tăng cường dữ liệu sau:
- Co giãn: Thay đổi kích thước ảnh trong khi vẫn giữ nguyên tỷ lệ, cho phép các model AI phát hiện đối tượng ở những khoảng cách khác nhau.
- Cắt ảnh: Loại bỏ những phần không cần thiết của ảnh, giúp model tập trung vào các vùng chính và giảm yếu tố gây xao nhãng từ background.
- Biến dạng xiên: Làm lệch ảnh một chút để mô phỏng hình ảnh nghiêng hoặc kéo giãn, giúp AI nhận diện đối tượng từ nhiều góc độ khác nhau.
Những điều chỉnh này giúp các model thị giác máy tính nhận diện đối tượng ngay cả khi kích thước hoặc hình dạng của chúng thay đổi đôi chút.
Điều chỉnh phối cảnh và biến dạng#
Đối tượng trong ảnh có thể trông khác nhau tùy theo góc camera, khiến các model thị giác máy tính khó nhận diện. Để giúp model xử lý những biến thể này, các kỹ thuật tăng cường dữ liệu có thể điều chỉnh cách thể hiện đối tượng trong ảnh.
Ví dụ, phép biến đổi phối cảnh có thể thay đổi góc nhìn, khiến đối tượng trông như đang được quan sát từ một vị trí khác. Nhờ đó, các model Vision AI có thể nhận diện đối tượng ngay cả khi chúng bị nghiêng hoặc được chụp từ một góc nhìn bất thường.
Một ví dụ khác là phép biến đổi đàn hồi, kéo giãn, uốn cong hoặc làm biến dạng ảnh để mô phỏng các biến dạng tự nhiên, khiến đối tượng trông như khi xuất hiện trong hình phản chiếu hoặc chịu áp lực.
Điều chỉnh màu sắc và ánh sáng#
Điều kiện ánh sáng và khác biệt màu sắc có thể ảnh hưởng đáng kể đến cách các model Vision AI diễn giải ảnh. Vì đối tượng có thể trông khác nhau trong các điều kiện ánh sáng khác nhau, những kỹ thuật tăng cường dữ liệu sau đây có thể giúp xử lý các tình huống này:
- Điều chỉnh độ sáng và độ tương phản: Mô phỏng các điều kiện ánh sáng khác nhau giúp model Vision AI nhận diện đối tượng trong cả môi trường sáng lẫn tối.
- Biến đổi màu ngẫu nhiên: Thay đổi ngẫu nhiên sắc độ, độ bão hòa và cân bằng màu giúp các model thị giác máy tính thích ứng tốt hơn với nhiều camera và điều kiện ánh sáng khác nhau.
- Chuyển đổi thang xám: Chuyển ảnh sang đen trắng khuyến khích các model Vision AI tập trung vào hình dạng và kết cấu thay vì màu sắc.
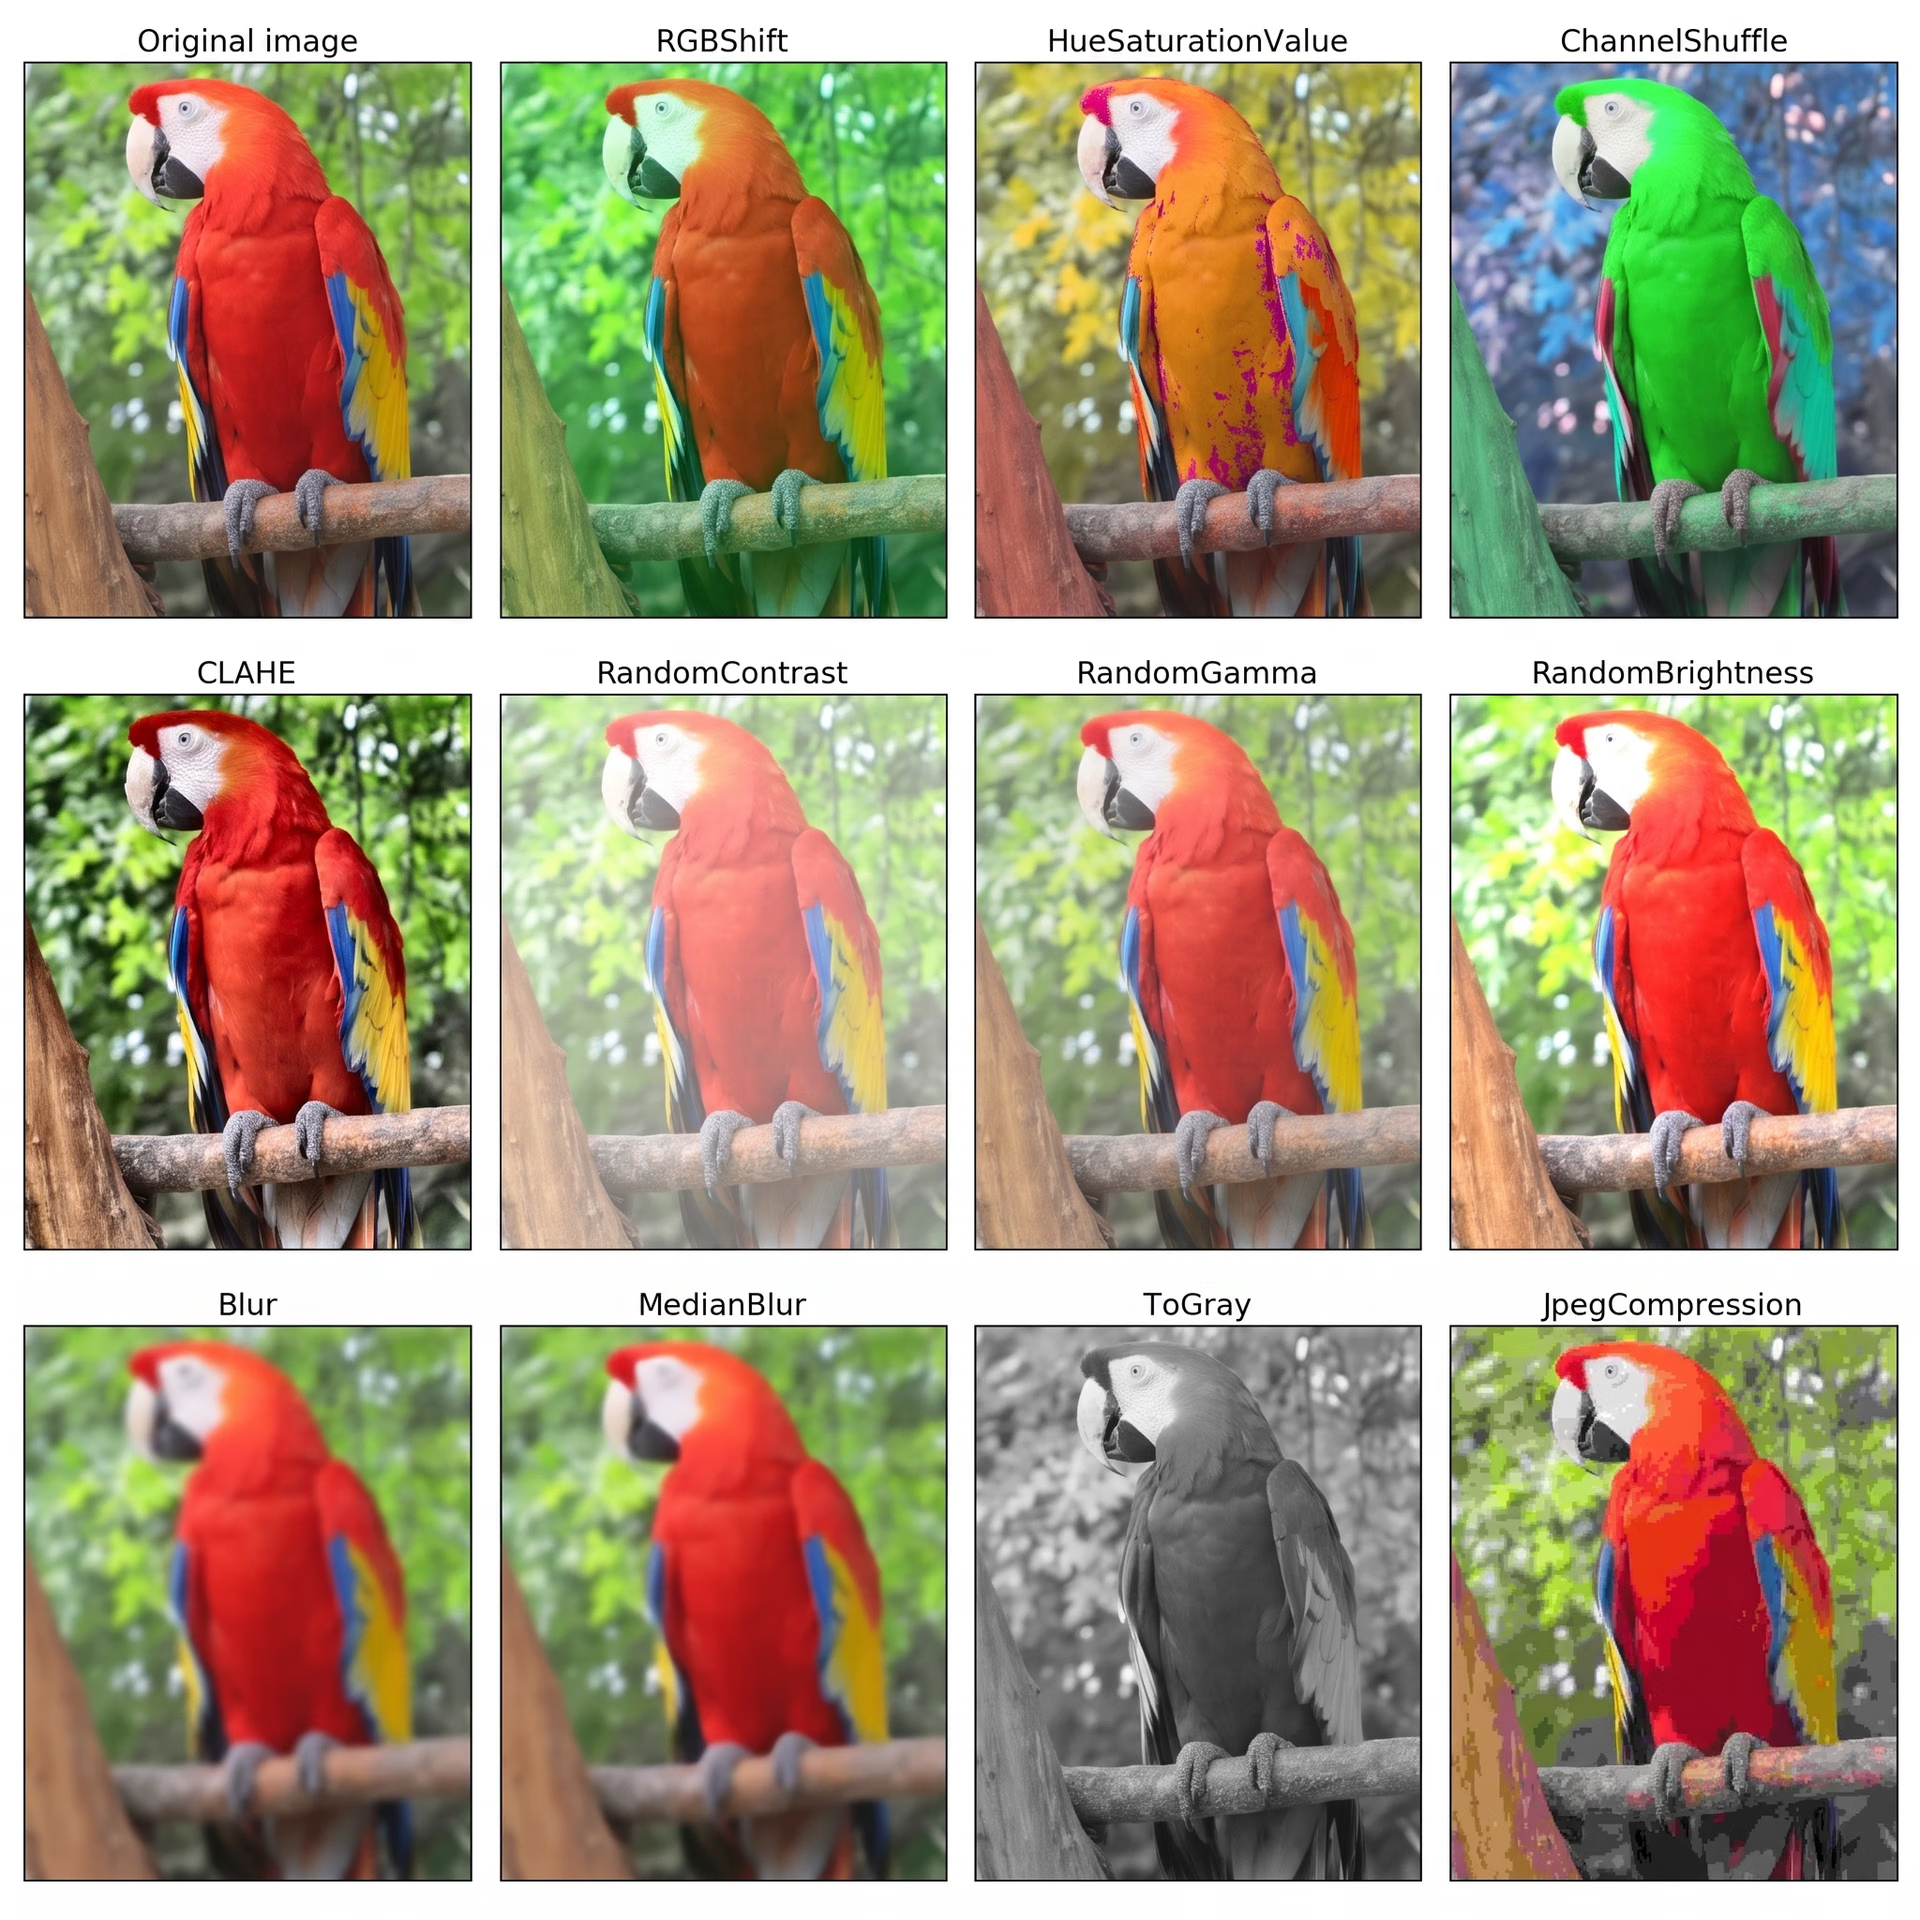
Hình 3. Ví dụ về các phép tăng cường liên quan đến biến thể màu sắc.
Các kỹ thuật tăng cường dữ liệu ảnh nâng cao#
Đến đây, chúng ta mới chỉ tìm hiểu các kỹ thuật tăng cường dữ liệu chỉnh sửa một ảnh đơn lẻ. Tuy nhiên, một số phương pháp nâng cao kết hợp nhiều ảnh để cải thiện khả năng học của AI.
Ví dụ, MixUp pha trộn hai ảnh, giúp các model thị giác máy tính hiểu mối quan hệ giữa các đối tượng và cải thiện khả năng tổng quát hóa trong nhiều tình huống khác nhau. CutMix tiến thêm một bước bằng cách thay một vùng của ảnh bằng một phần từ ảnh khác, cho phép model học từ nhiều ngữ cảnh trong cùng một ảnh. Trong khi đó, CutOut hoạt động theo cách khác: loại bỏ ngẫu nhiên một số phần của ảnh, huấn luyện các model Vision AI nhận diện đối tượng ngay cả khi chúng bị che khuất một phần hoặc bị cản trở.
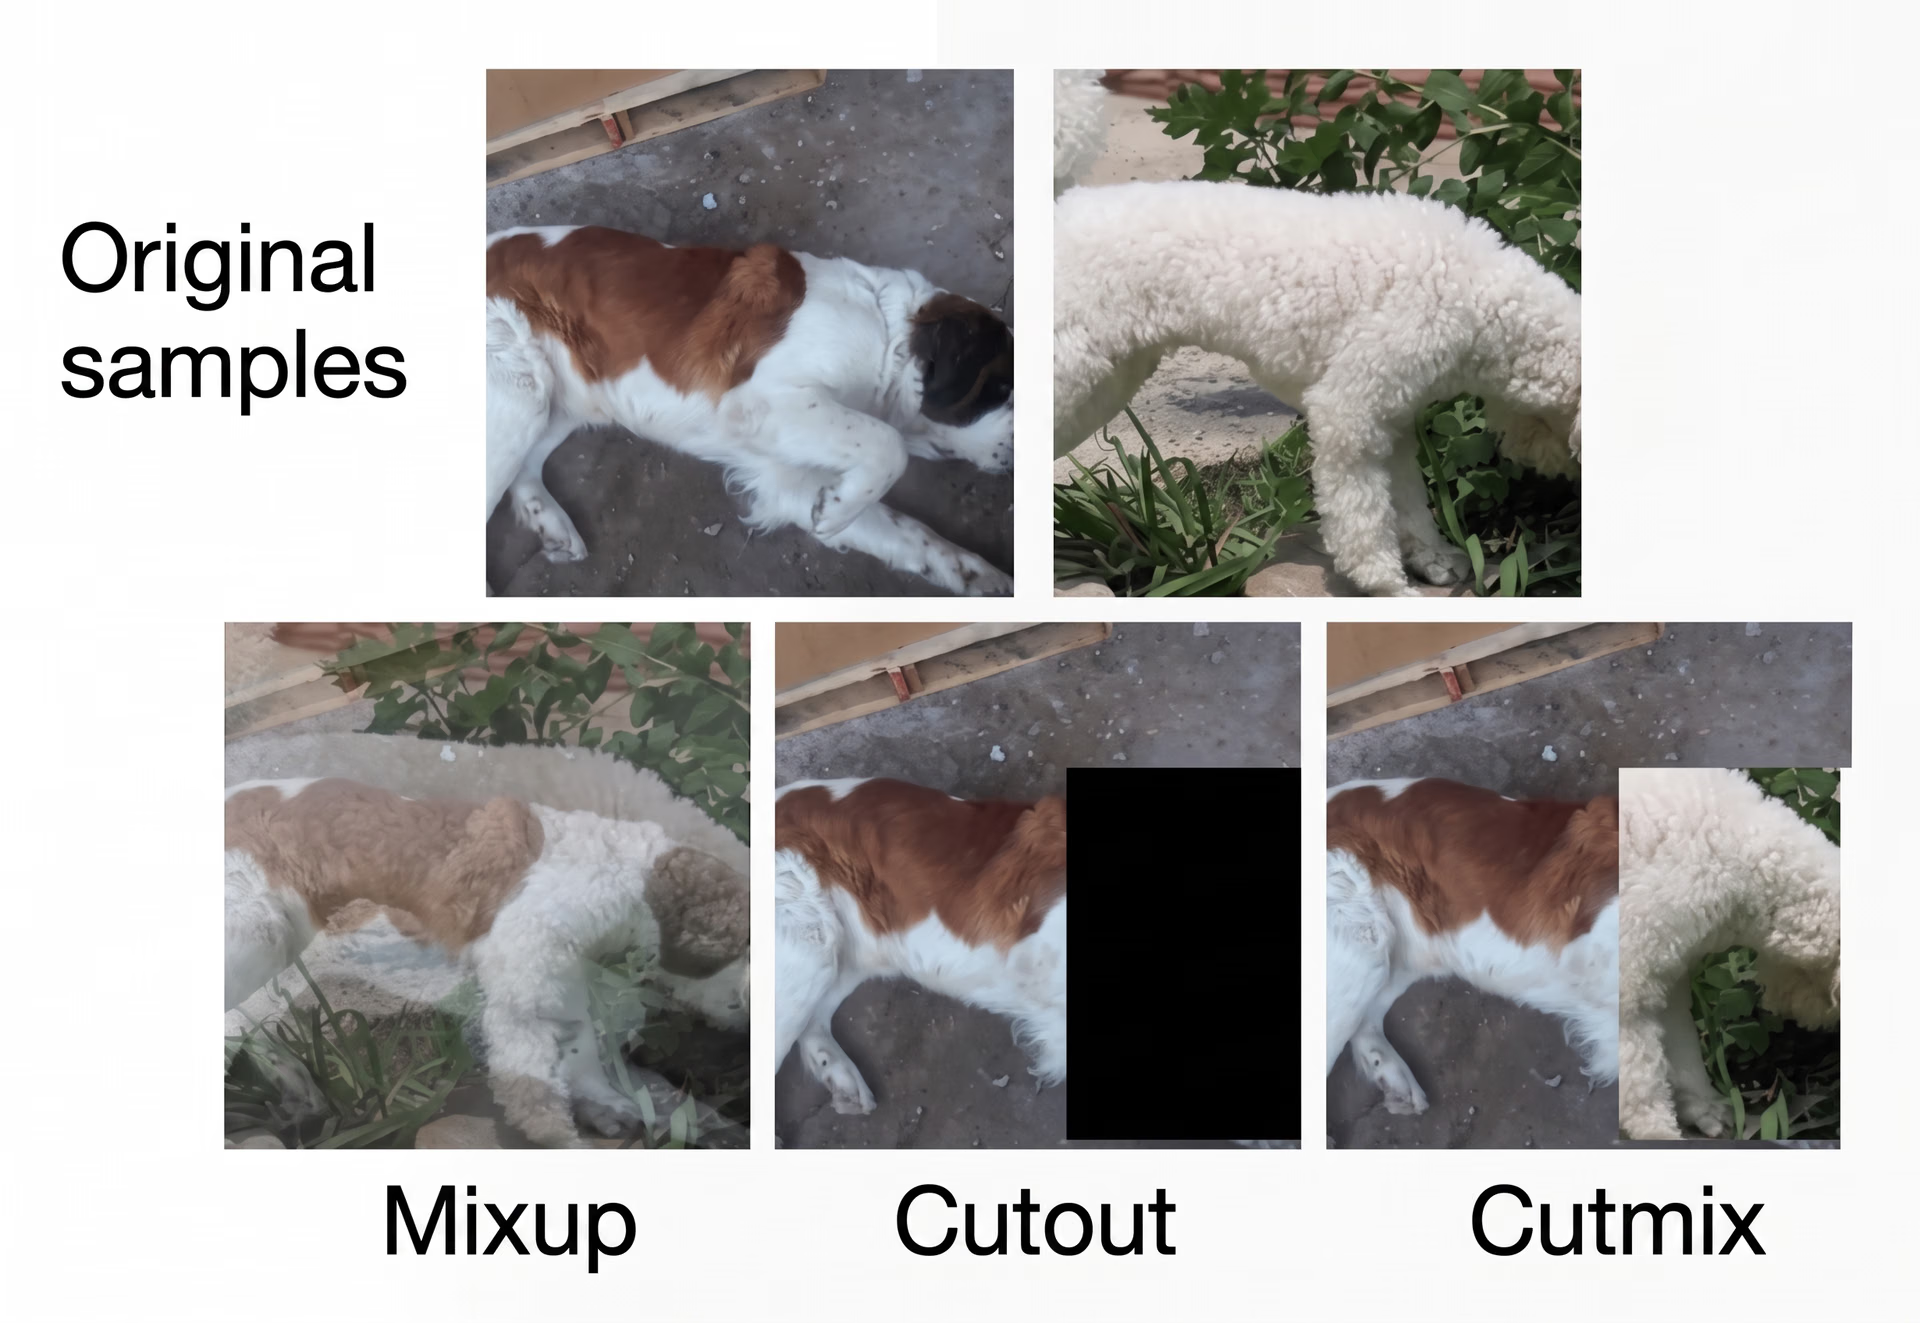
Hình 4. Các kỹ thuật tăng cường dữ liệu ảnh nâng cao.
Vai trò của AI tạo sinh trong tăng cường dữ liệu ảnh#
AI tạo sinh đang ngày càng phổ biến trong nhiều ngành và ứng dụng hằng ngày. Có thể bạn đã bắt gặp công nghệ này qua hình ảnh do AI tạo, video deepfake hoặc ứng dụng tạo avatar chân thực. Tuy nhiên, ngoài sáng tạo và giải trí, AI tạo sinh còn đóng vai trò quan trọng trong việc huấn luyện các model Vision AI bằng cách tạo ảnh mới từ ảnh hiện có.
Thay vì chỉ lật hoặc xoay ảnh, công nghệ này có thể tạo ra các biến thể chân thực — thay đổi biểu cảm khuôn mặt, phong cách trang phục hoặc thậm chí mô phỏng các điều kiện thời tiết khác nhau. Những biến thể này giúp các model thị giác máy tính thích ứng tốt hơn và chính xác hơn trong nhiều tình huống thực tế. Các model AI tạo sinh tiên tiến như GAN (Mạng đối sinh tạo) và model khuếch tán cũng có thể bổ sung chi tiết còn thiếu hoặc tạo ảnh tổng hợp chất lượng cao.
Hạn chế của tăng cường dữ liệu ảnh#
Dù tăng cường dữ liệu cải thiện tập dữ liệu huấn luyện, cũng cần cân nhắc một số hạn chế. Dưới đây là một vài thách thức chính liên quan đến tăng cường dữ liệu ảnh:
- Đa dạng dữ liệu hạn chế: Ảnh tăng cường được tạo từ dữ liệu hiện có và không thể bổ sung các mẫu hoàn toàn mới hoặc góc nhìn hiếm gặp.
- Nguy cơ làm sai lệch dữ liệu: Các phép biến đổi quá mức có thể khiến ảnh trông không chân thực, làm giảm độ chính xác của model trong các tình huống thực tế.
- Tăng mức tiêu thụ tính toán: Tăng cường dữ liệu theo thời gian thực trong quá trình huấn luyện model có thể đòi hỏi khá nhiều năng lực xử lý, làm chậm quá trình huấn luyện và tăng mức sử dụng bộ nhớ.
- Mất cân bằng lớp vẫn còn: Tăng cường dữ liệu không tạo ra các mẫu hoàn toàn mới, vì vậy các lớp ít được đại diện vẫn có thể dẫn đến quá trình học bị thiên lệch.
Ứng dụng thực tế của tăng cường dữ liệu ảnh#
Một ứng dụng thú vị của tăng cường dữ liệu ảnh là xe tự lái, nơi các quyết định trong tích tắc của những model thị giác máy tính như Ultralytics YOLO11 đóng vai trò thiết yếu. Model phải phát hiện chính xác đường sá, người và các đối tượng khác.
Tuy nhiên, điều kiện thực tế mà xe tự lái gặp phải có thể khó dự đoán. Thời tiết xấu, nhòe chuyển động và biển báo bị che khuất có thể khiến các giải pháp Vision AI trong lĩnh vực này trở nên phức tạp. Chỉ huấn luyện model thị giác máy tính bằng ảnh thực tế thường là chưa đủ. Bộ dữ liệu ảnh dành cho model trên xe tự lái cần đa dạng để model có thể học cách xử lý những tình huống bất ngờ.
Tăng cường dữ liệu ảnh giải quyết vấn đề này bằng cách mô phỏng sương mù, điều chỉnh độ sáng và làm biến dạng hình dạng. Những thay đổi này giúp model nhận diện đối tượng trong các điều kiện khác nhau. Nhờ đó, model trở nên thông minh hơn và đáng tin cậy hơn.
Với dữ liệu huấn luyện đã tăng cường, các giải pháp Vision AI trên xe tự lái thích ứng tốt hơn và đưa ra quyết định an toàn hơn. Kết quả chính xác hơn đồng nghĩa với ít tai nạn hơn và khả năng điều hướng được cải thiện.
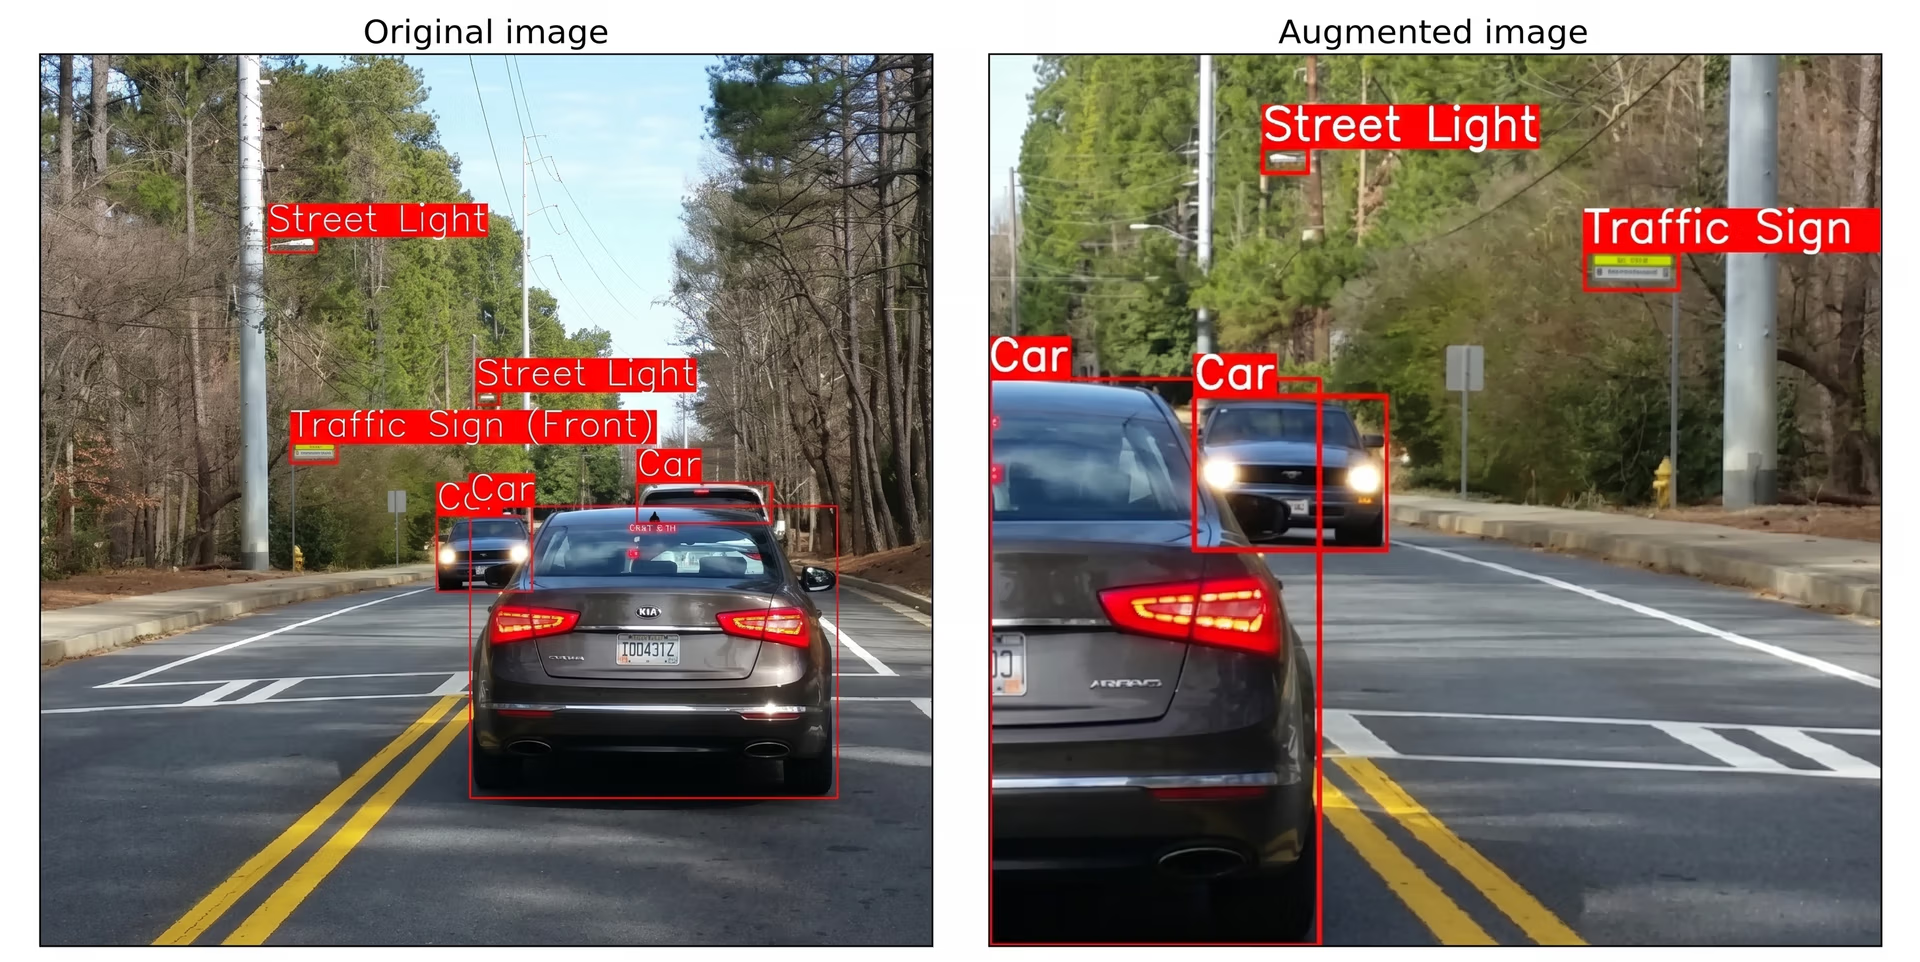
Hình 5. Ví dụ về tăng cường dữ liệu ảnh trong lĩnh vực xe tự lái.
Xe tự lái chỉ là một ví dụ. Trên thực tế, tăng cường dữ liệu ảnh rất quan trọng trong nhiều lĩnh vực, từ chẩn đoán hình ảnh y khoa đến phân tích bán lẻ. Bất kỳ ứng dụng nào dựa vào thị giác máy tính đều có thể hưởng lợi từ việc tăng cường dữ liệu ảnh.
Điểm chính cần ghi nhớ#
Các hệ thống Vision AI cần nhận diện đối tượng trong nhiều điều kiện khác nhau, nhưng việc thu thập vô số ảnh thực tế để huấn luyện có thể rất khó khăn. Tăng cường dữ liệu ảnh giải quyết vấn đề này bằng cách tạo các biến thể từ ảnh hiện có, giúp model học nhanh hơn và hoạt động tốt hơn trong các tình huống thực tế. Phương pháp này cải thiện độ chính xác, đảm bảo các model Vision AI như Ultralytics YOLO11 có thể xử lý nhiều điều kiện ánh sáng, góc nhìn và môi trường khác nhau.
Đối với doanh nghiệp và developer, tăng cường dữ liệu ảnh giúp tiết kiệm thời gian và công sức, đồng thời nâng cao độ tin cậy của các model thị giác máy tính. Nhiều ngành, từ chăm sóc sức khỏe đến xe tự lái, đều phụ thuộc vào phương pháp này. Khi Vision AI tiếp tục phát triển, tăng cường dữ liệu sẽ vẫn là phần thiết yếu để xây dựng các model thông minh hơn và dễ thích ứng hơn trong tương lai.
Tham gia cộng đồng của chúng tôi và truy cập repository GitHub của chúng tôi để xem AI hoạt động thực tế. Khám phá các tùy chọn cấp phép và tìm hiểu thêm về AI trong nông nghiệp cũng như thị giác máy tính trong sản xuất trên các trang giải pháp của chúng tôi.









