¿Qué es el sobreajuste en visión artificial y cómo se puede prevenir?
Descubre qué es el sobreajuste en visión artificial, cómo detectarlo y cómo prevenirlo con aumento de datos, regularización, parada temprana y modelos preentrenados.
 Abdelrahman Elgendy10 min de lectura
Los modelos de visión artificial están diseñados para reconocer patrones, detectar objetos y analizar imágenes. Sin embargo, su rendimiento depende de su capacidad para generalizar ante datos que no han visto. La generalización es la capacidad del modelo para funcionar bien con imágenes nuevas, no solo con aquellas con las que se ha entrenado. Un problema habitual al entrenar estos modelos es el sobreajuste, que se produce cuando un modelo aprende demasiado de los datos de entrenamiento, incluido el ruido innecesario, en lugar de identificar patrones relevantes.
Cuando esto ocurre, el modelo funciona bien con los datos de entrenamiento, pero tiene dificultades con imágenes nuevas. Por ejemplo, un modelo de detección de objetos entrenado solo con imágenes de alta resolución y bien iluminadas puede fallar ante imágenes borrosas o con sombras en condiciones reales. El sobreajuste limita la capacidad de adaptación del modelo y, por tanto, su uso en aplicaciones reales como la conducción autónoma, el diagnóstico por imagen y los sistemas de seguridad.
En este artículo veremos qué es el sobreajuste, por qué se produce y cómo prevenirlo. También veremos cómo los modelos de visión artificial como Ultralytics YOLO11 ayudan a reducir el sobreajuste y mejorar la generalización.
¿Qué es el sobreajuste?#
El sobreajuste se produce cuando un modelo memoriza los datos de entrenamiento en lugar de aprender patrones aplicables de forma general a nuevas entradas. El modelo se centra demasiado en los datos de entrenamiento y, por eso, tiene dificultades con imágenes o situaciones nuevas que no ha visto antes.
En visión artificial, el sobreajuste puede afectar a distintas tareas. Un modelo de clasificación entrenado solo con imágenes claras y bien iluminadas puede tener dificultades en condiciones de poca luz. Un modelo de detección de objetos que aprende a partir de imágenes perfectas podría fallar en escenas abarrotadas o desordenadas. Del mismo modo, un modelo de segmentación de instancias puede funcionar bien en entornos controlados, pero tener problemas con las sombras o los objetos superpuestos.
Esto supone un problema en las aplicaciones de IA del mundo real, donde los modelos deben generalizar más allá de las condiciones de entrenamiento controladas. Por ejemplo, los coches autónomos deben poder detectar peatones con distintas condiciones de iluminación, meteorológicas y ambientales. Un modelo sobreajustado a su conjunto de entrenamiento no funcionará de forma fiable en situaciones tan impredecibles.
¿Cuándo y por qué se produce el sobreajuste?#
El sobreajuste suele deberse a conjuntos de datos desequilibrados, a una complejidad excesiva del modelo y a un entrenamiento demasiado prolongado. Estas son las causas principales:
- Datos de entrenamiento limitados: Los conjuntos de datos pequeños hacen que los modelos memoricen patrones en lugar de generalizarlos. Un modelo entrenado con solo 50 imágenes de aves puede tener dificultades para detectar especies de aves que no estén representadas en ese conjunto de datos.
- Modelos complejos con demasiados parámetros: Las redes profundas con un exceso de capas y neuronas tienden a memorizar detalles minuciosos en lugar de centrarse en las características esenciales.
- Falta de aumento de datos: Sin transformaciones como recortar, voltear o rotar las imágenes, es posible que el modelo solo aprenda de las imágenes exactas del conjunto de entrenamiento.
- Entrenamiento prolongado: Si un modelo repasa los datos de entrenamiento demasiadas veces, es decir, durante demasiadas épocas, memoriza detalles en lugar de aprender patrones generales, lo que reduce su capacidad de adaptación.
- Etiquetas incoherentes o ruidosas: Los datos mal etiquetados hacen que el modelo aprenda patrones incorrectos. Esto es habitual en conjuntos de datos etiquetados manualmente.
Un enfoque equilibrado de la complejidad del modelo, la calidad del conjunto de datos y las técnicas de entrenamiento garantiza una mejor generalización.
Sobreajuste frente a infraajuste#
El sobreajuste y el infraajuste son dos problemas opuestos del aprendizaje profundo.
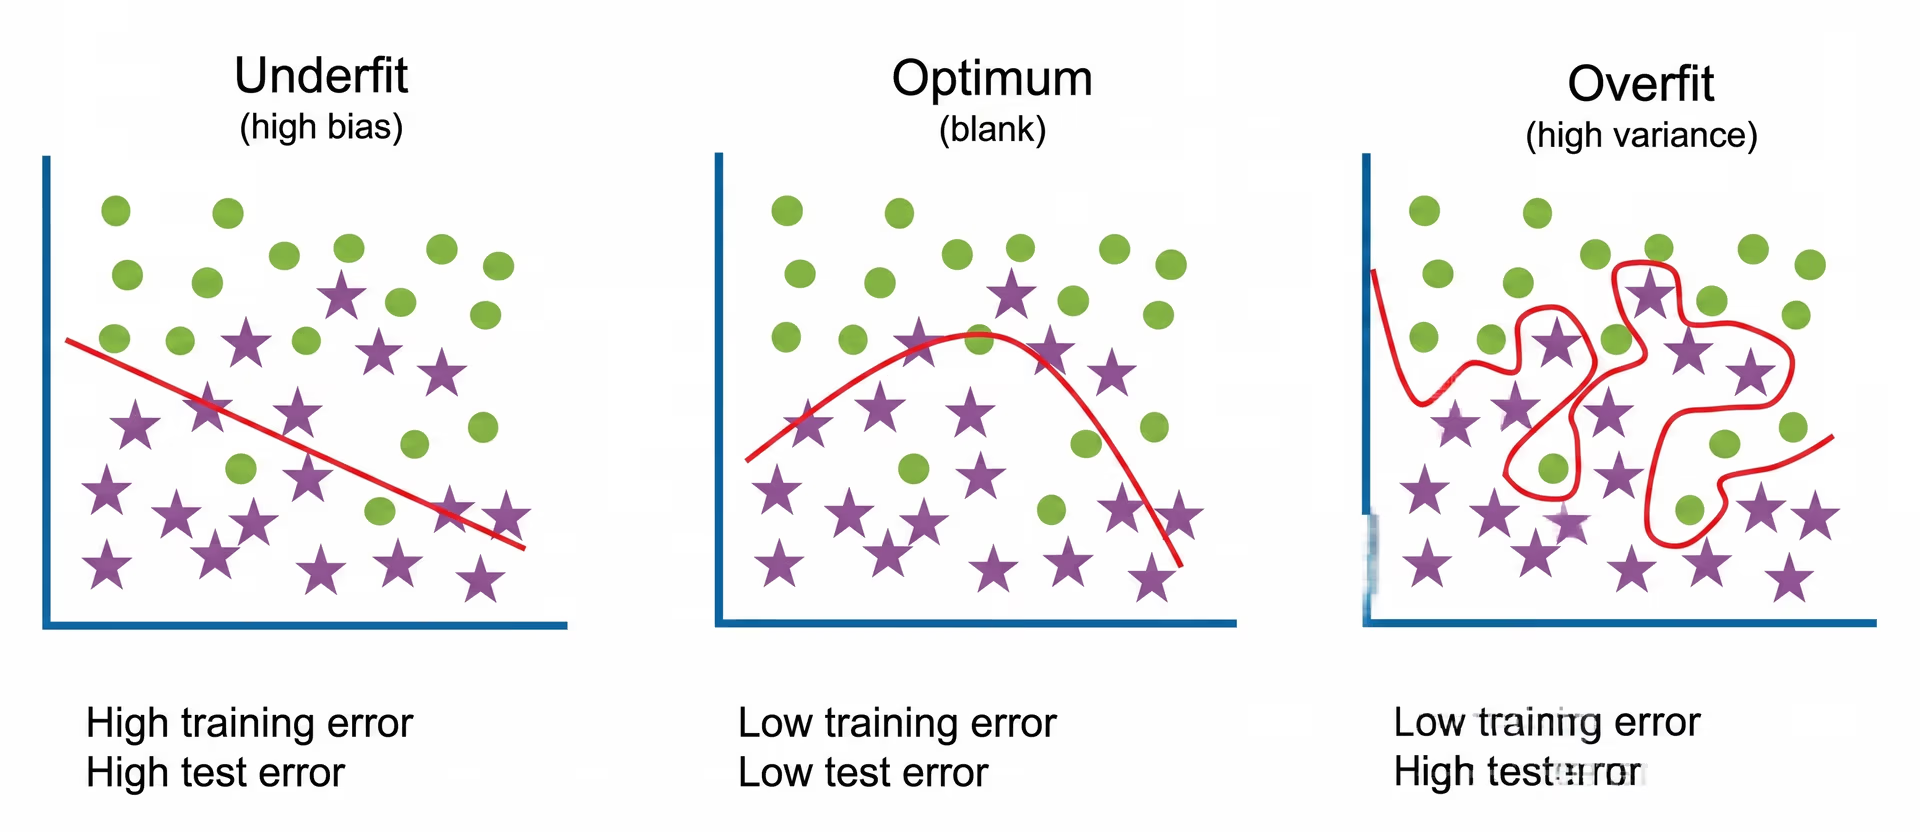
Fig. 1. Comparación del infraajuste, el aprendizaje óptimo y el sobreajuste en modelos de visión artificial.
El sobreajuste se produce cuando un modelo es demasiado complejo y se centra en exceso en los datos de entrenamiento. En lugar de aprender patrones generales, memoriza pequeños detalles, incluso otros irrelevantes, como el ruido de fondo. Esto hace que el modelo funcione bien con los datos de entrenamiento, pero tenga dificultades con imágenes nuevas, lo que significa que en realidad no ha aprendido a reconocer patrones aplicables en distintas situaciones.
El infraajuste se produce cuando un modelo es demasiado básico y no capta patrones importantes de los datos. Puede ocurrir cuando el modelo tiene muy pocas capas, no se entrena durante suficiente tiempo o los datos son limitados. Como resultado, no reconoce patrones importantes y realiza predicciones inexactas. Esto provoca un rendimiento deficiente tanto con los datos de entrenamiento como con los de prueba, porque el modelo no ha aprendido lo suficiente para comprender bien la tarea.
Un modelo bien entrenado encuentra el equilibrio entre complejidad y generalización. Debe ser lo bastante complejo para aprender patrones relevantes, pero no tanto como para memorizar los datos en lugar de reconocer las relaciones subyacentes.
Cómo identificar el sobreajuste#
Estas son algunas señales de que un modelo sufre sobreajuste:
- Si la precisión en el entrenamiento es significativamente superior a la precisión en la validación, es probable que el modelo presente sobreajuste.
- Una diferencia cada vez mayor entre la pérdida de entrenamiento y la pérdida de validación es otro indicio claro.
- El modelo confía demasiado en respuestas incorrectas, lo que demuestra que ha memorizado detalles en lugar de comprender patrones.
Para asegurarte de que un modelo generaliza bien, debes probarlo con conjuntos de datos diversos que reflejen las condiciones del mundo real.
Cómo prevenir el sobreajuste en visión artificial#
El sobreajuste no es inevitable y se puede prevenir. Con las técnicas adecuadas, los modelos de visión artificial pueden aprender patrones generales en lugar de memorizar los datos de entrenamiento, lo que los hace más fiables en aplicaciones del mundo real.
Estas son cinco estrategias clave para prevenir el sobreajuste en visión artificial.
Aumenta la diversidad de los datos con aumento de datos y datos sintéticos#
La mejor forma de ayudar a un modelo a funcionar bien con datos nuevos es ampliar el conjunto de datos mediante el aumento de datos y los datos sintéticos. Los datos sintéticos se generan por ordenador, en lugar de recopilarse a partir de imágenes del mundo real. Ayudan a cubrir carencias cuando no hay suficientes datos reales.
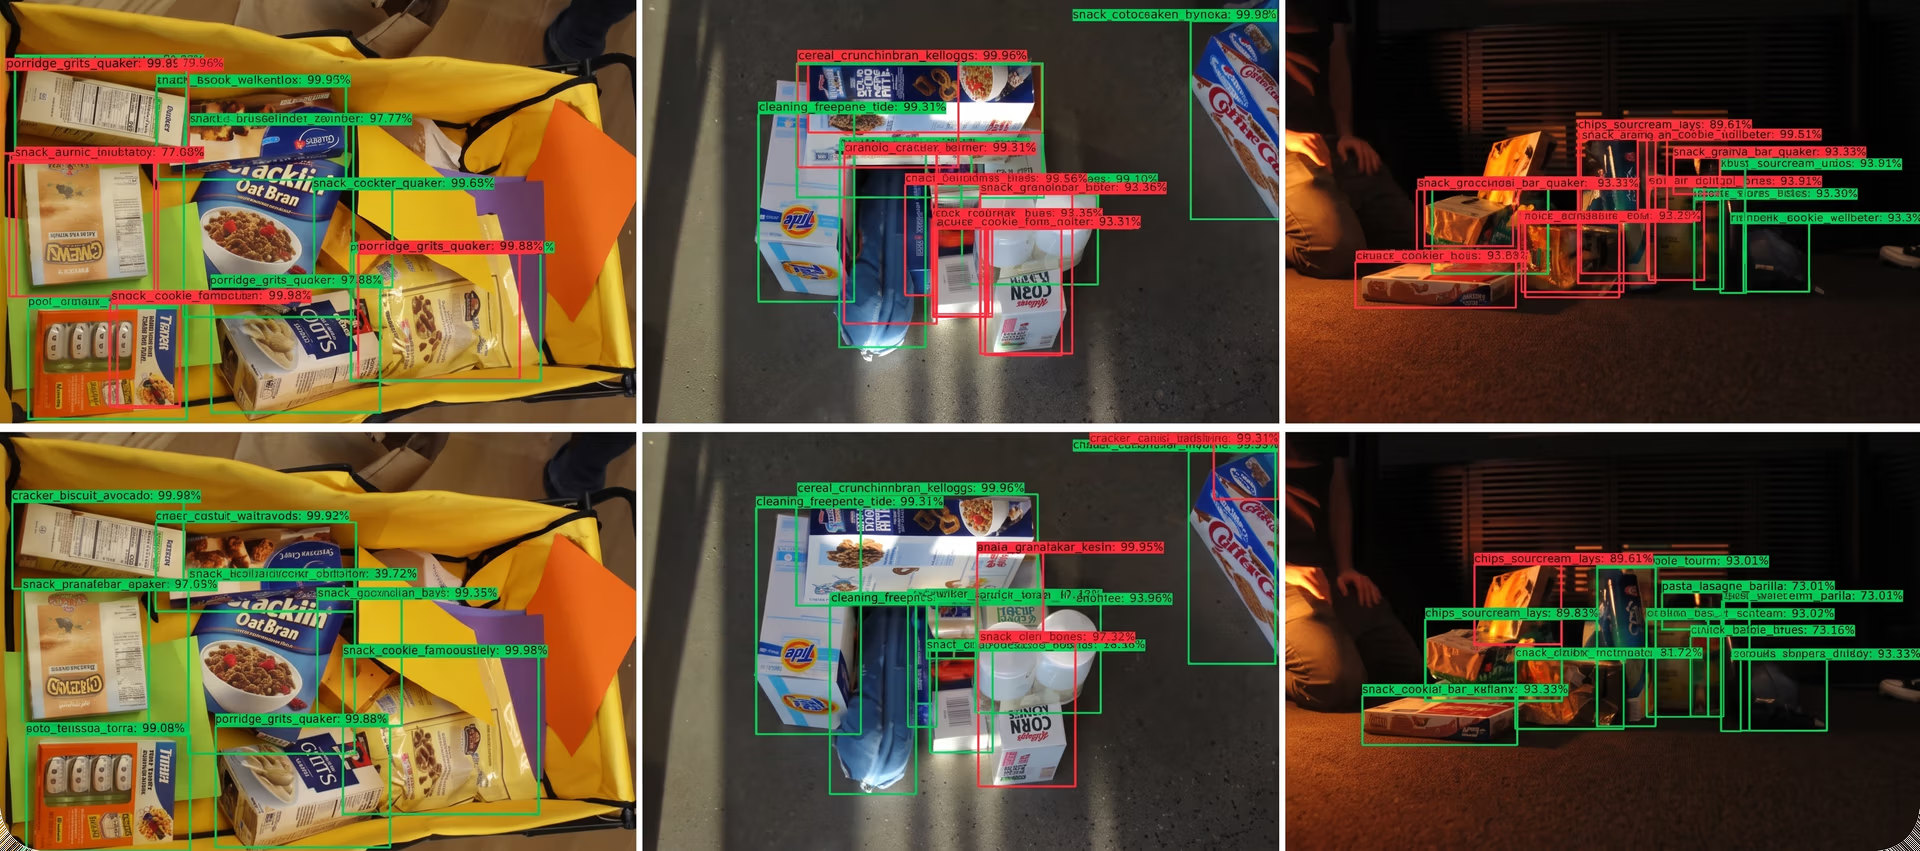
Fig. 2. La combinación de datos del mundo real y datos sintéticos reduce el sobreajuste y mejora la precisión de la detección de objetos.
El aumento de datos modifica ligeramente las imágenes existentes al voltearlas, girarlas, recortarlas o ajustar su brillo, para que el modelo no se limite a memorizar detalles, sino que aprenda a reconocer objetos en distintas situaciones.
Los datos sintéticos son útiles cuando es difícil conseguir imágenes reales. Por ejemplo, los modelos de conducción autónoma pueden entrenarse con escenas de carretera generadas por ordenador para aprender a detectar objetos con distintas condiciones meteorológicas y de iluminación. Esto hace que el modelo sea más flexible y fiable sin necesidad de miles de imágenes del mundo real.
Optimiza la complejidad y la arquitectura del modelo#
Una red neuronal profunda, un tipo de modelo de aprendizaje automático con muchas capas que procesan datos en lugar de una sola, no siempre es mejor. Cuando un modelo tiene demasiadas capas o parámetros, memoriza los datos de entrenamiento en vez de reconocer patrones más generales. Reducir la complejidad innecesaria puede ayudar a evitar el sobreajuste.
Para lograrlo, una opción es la poda, que elimina neuronas y conexiones redundantes para que el modelo sea más ligero y eficiente.
Otra opción es simplificar la arquitectura reduciendo el número de capas o neuronas. Los modelos preentrenados, como Ultralytics YOLO11, están diseñados para generalizar bien en distintas tareas con menos parámetros, por lo que son más resistentes al sobreajuste que un modelo profundo entrenado desde cero.
Encontrar el equilibrio adecuado entre la profundidad y la eficiencia del modelo le ayuda a aprender patrones útiles sin limitarse a memorizar los datos de entrenamiento.
Aplica técnicas de regularización#
Las técnicas de regularización evitan que los modelos dependan demasiado de características concretas de los datos de entrenamiento. Estas son algunas técnicas de uso habitual:
- Dropout desactiva partes aleatorias del modelo durante el entrenamiento para que aprenda a reconocer distintos patrones, en lugar de depender demasiado de unas pocas características.
- Decaimiento de pesos (regularización L2) desincentiva los valores extremos de los pesos y mantiene bajo control la complejidad del modelo.
- Normalización por lotes ayuda a estabilizar el entrenamiento al hacer que el modelo sea menos sensible a las variaciones del conjunto de datos.
Estas técnicas ayudan a mantener la flexibilidad y la capacidad de adaptación del modelo, reducen el riesgo de sobreajuste y conservan la precisión.
Supervisa el entrenamiento con validación y parada temprana#
Para evitar el sobreajuste, es importante seguir cómo aprende el modelo y asegurarse de que generaliza bien con datos nuevos. Estas son un par de técnicas que pueden ayudarte:
- Parada temprana: Finaliza automáticamente el entrenamiento cuando el rendimiento en validación deja de mejorar, para evitar que el modelo siga aprendiendo detalles innecesarios.
- Validación cruzada: Divide los datos en varios subconjuntos y, a continuación, entrena repetidamente con todos menos uno y valida con el subconjunto reservado. Esto permite evaluar de forma más fiable hasta qué punto generaliza el modelo más allá de las imágenes concretas.
Estas técnicas ayudan a mantener el equilibrio del modelo para que aprenda lo suficiente como para ser preciso, sin centrarse demasiado en los datos de entrenamiento.
Usa modelos preentrenados y mejora el etiquetado del conjunto de datos#
En lugar de entrenar desde cero, usar modelos preentrenados como Ultralytics YOLO11 puede reducir el sobreajuste. YOLO11 se entrena con conjuntos de datos a gran escala, lo que le permite generalizar bien en distintas condiciones.
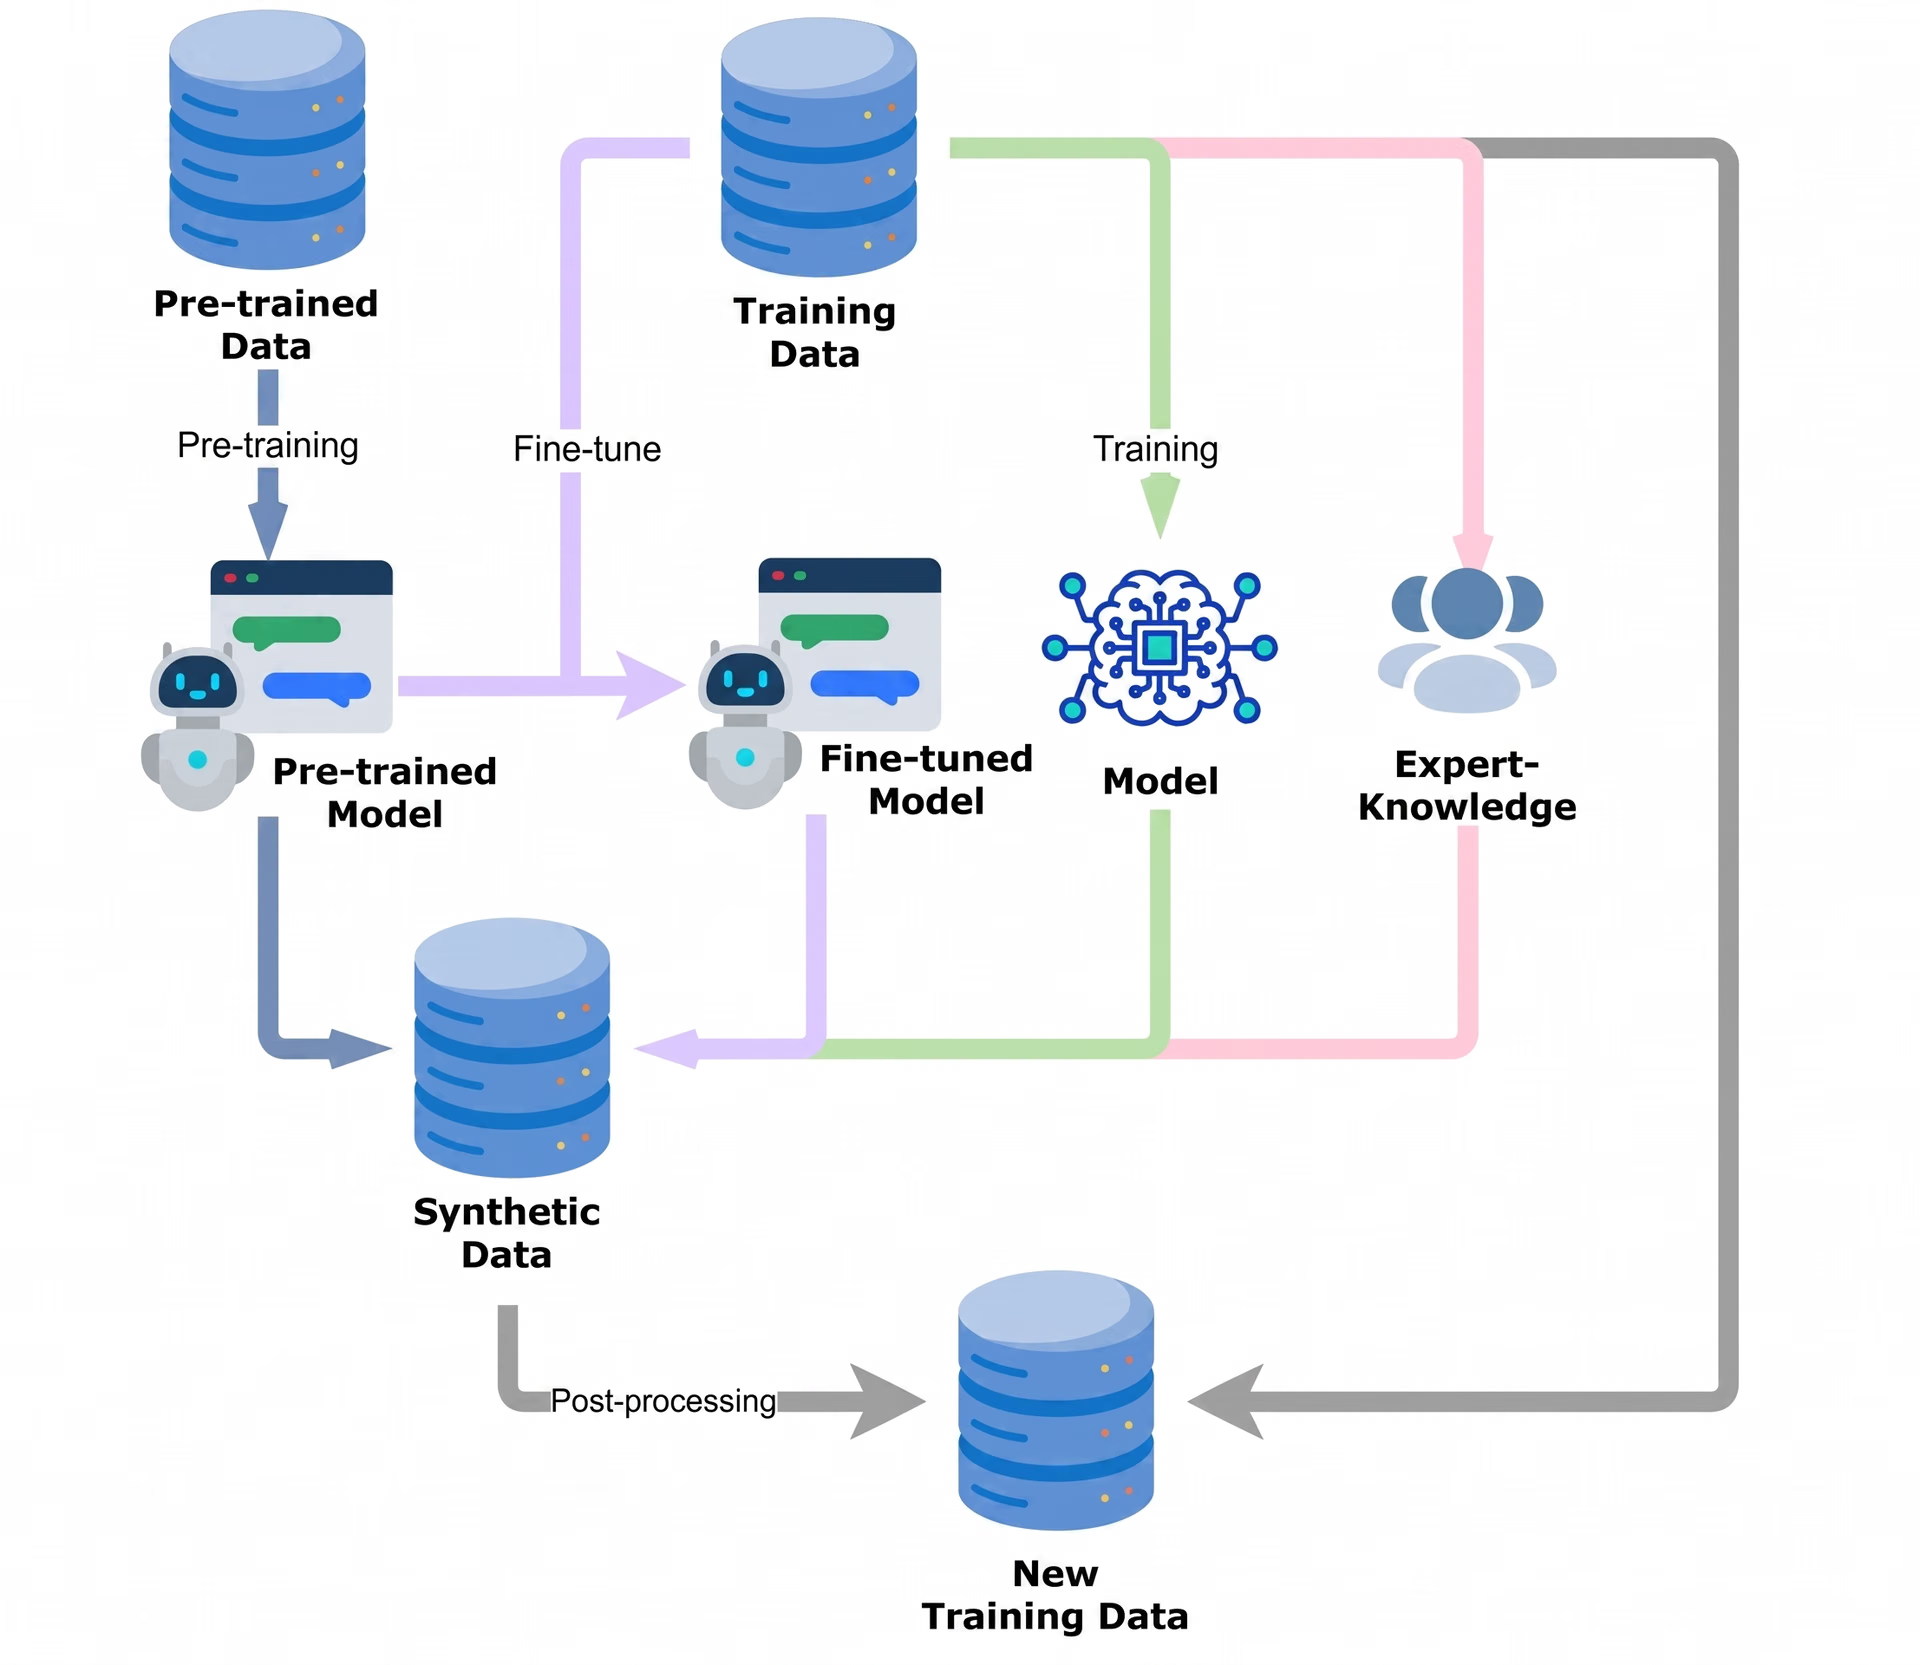
Fig. 3. Los modelos de visión artificial preentrenados aumentan la precisión y evitan el sobreajuste.
Ajustar un modelo preentrenado le ayuda a conservar lo que ya sabe mientras aprende nuevas tareas, para que no se limite a memorizar los datos de entrenamiento.
Además, es esencial garantizar que el etiquetado del conjunto de datos sea de alta calidad. Los datos mal etiquetados o desequilibrados pueden llevar a los modelos a aprender patrones incorrectos. Limpiar los conjuntos de datos, corregir las imágenes mal etiquetadas y equilibrar las clases mejora la precisión y reduce el riesgo de sobreajuste. Otro método eficaz es el entrenamiento adversario, en el que el modelo se expone a ejemplos ligeramente modificados o más difíciles, diseñados para poner a prueba sus límites.
Conclusiones clave#
El sobreajuste es un problema habitual en visión artificial. Puede que un modelo funcione bien con los datos de entrenamiento, pero tenga dificultades con imágenes del mundo real. Para evitarlo, técnicas como el aumento de datos, la regularización y el uso de modelos preentrenados como Ultralytics YOLO11 ayudan a mejorar la precisión y la capacidad de adaptación.
Al aplicar estos métodos, los modelos de IA pueden mantener su fiabilidad y funcionar bien en distintos entornos. A medida que mejora el aprendizaje profundo, garantizar que los modelos generalicen correctamente será fundamental para que la IA tenga éxito en el mundo real.
¡Únete a nuestra creciente comunidad! Explora nuestro repositorio de GitHub para aprender más sobre IA. ¿Te animas a empezar tus propios proyectos de visión artificial? Echa un vistazo a nuestras opciones de licencia. Descubre la IA para la visión en la conducción autónoma y la IA en la atención sanitaria en nuestras páginas de soluciones.
Escrito por
Autor · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









