¿Qué es la destilación de conjuntos de datos? Un resumen rápido
Descubre cómo la destilación de conjuntos de datos acelera el entrenamiento de modelos y reduce los costes de computación al sustituir grandes conjuntos de datos por un pequeño conjunto optimizado de muestras sintéticas.
 Abirami Vina18 min de lectura
Entrenar modelos puede parecer la parte más larga del trabajo de un científico de datos. Sin embargo, gran parte de su tiempo, a menudo entre el 60 % y el 80 %, se dedica en realidad a preparar los datos: recopilarlos, limpiarlos y organizarlos para modelarlos. A medida que los conjuntos de datos crecen, también aumenta el tiempo de preparación, lo que ralentiza los experimentos y dificulta la iteración.
Para abordar este problema, los investigadores llevan años buscando formas de agilizar el entrenamiento. Métodos como los datos sintéticos, la compresión de conjuntos de datos y técnicas de optimización mejores pretenden reducir el coste y las dificultades de trabajar con conjuntos de datos a gran escala y acelerar los flujos de trabajo de aprendizaje automático.
Esto plantea una pregunta clave: ¿podemos reducir drásticamente un conjunto de datos y, aun así, lograr el mismo rendimiento que al entrenar un modelo con todos los datos? La destilación de conjuntos de datos es una posible respuesta prometedora.
Crea una versión compacta de un conjunto de datos de entrenamiento de gran tamaño que conserva los patrones esenciales que el modelo necesita para aprender eficazmente. Ofrece una vía para acelerar el entrenamiento, reducir las necesidades de cálculo y experimentar de forma más eficiente. Puedes imaginarla como una chuleta de estudio para el modelo: un pequeño conjunto de ejemplos de datos sintéticos diseñado para enseñarle los mismos patrones fundamentales que el conjunto de datos completo.
En este artículo, veremos cómo funciona la destilación de conjuntos de datos y cómo contribuye al aprendizaje automático y al aprendizaje profundo escalables en aplicaciones del mundo real.
Cómo entender la destilación de conjuntos de datos#
La destilación de conjuntos de datos es un proceso que condensa un conjunto de datos de entrenamiento grande en otro mucho más pequeño que sigue enseñando al modelo casi la misma información que el conjunto original. Muchos investigadores también llaman a este proceso condensación de conjuntos de datos, porque el objetivo es captar los patrones esenciales presentes en todo el conjunto de datos.
Un conjunto de datos destilado es distinto de los datos sintéticos generados aleatoriamente o de seleccionar simplemente un subconjunto más pequeño de imágenes reales. No es un conjunto de datos ficticio aleatorio ni una copia recortada del original.
En cambio, se optimiza deliberadamente para captar los patrones más importantes. Durante este proceso, se ajustan y optimizan cada píxel y cada característica para que una red neuronal entrenada con los datos destilados aprenda casi como si se hubiera entrenado con el conjunto de datos completo.
Esta idea apareció por primera vez en un artículo de arXiv de 2018 de Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba y Alexei A. Efros. Las primeras pruebas utilizaron conjuntos de datos sencillos, como MNIST y CIFAR-10, que facilitaron demostrar que unas pocas muestras destiladas podían sustituir a miles de imágenes reales.
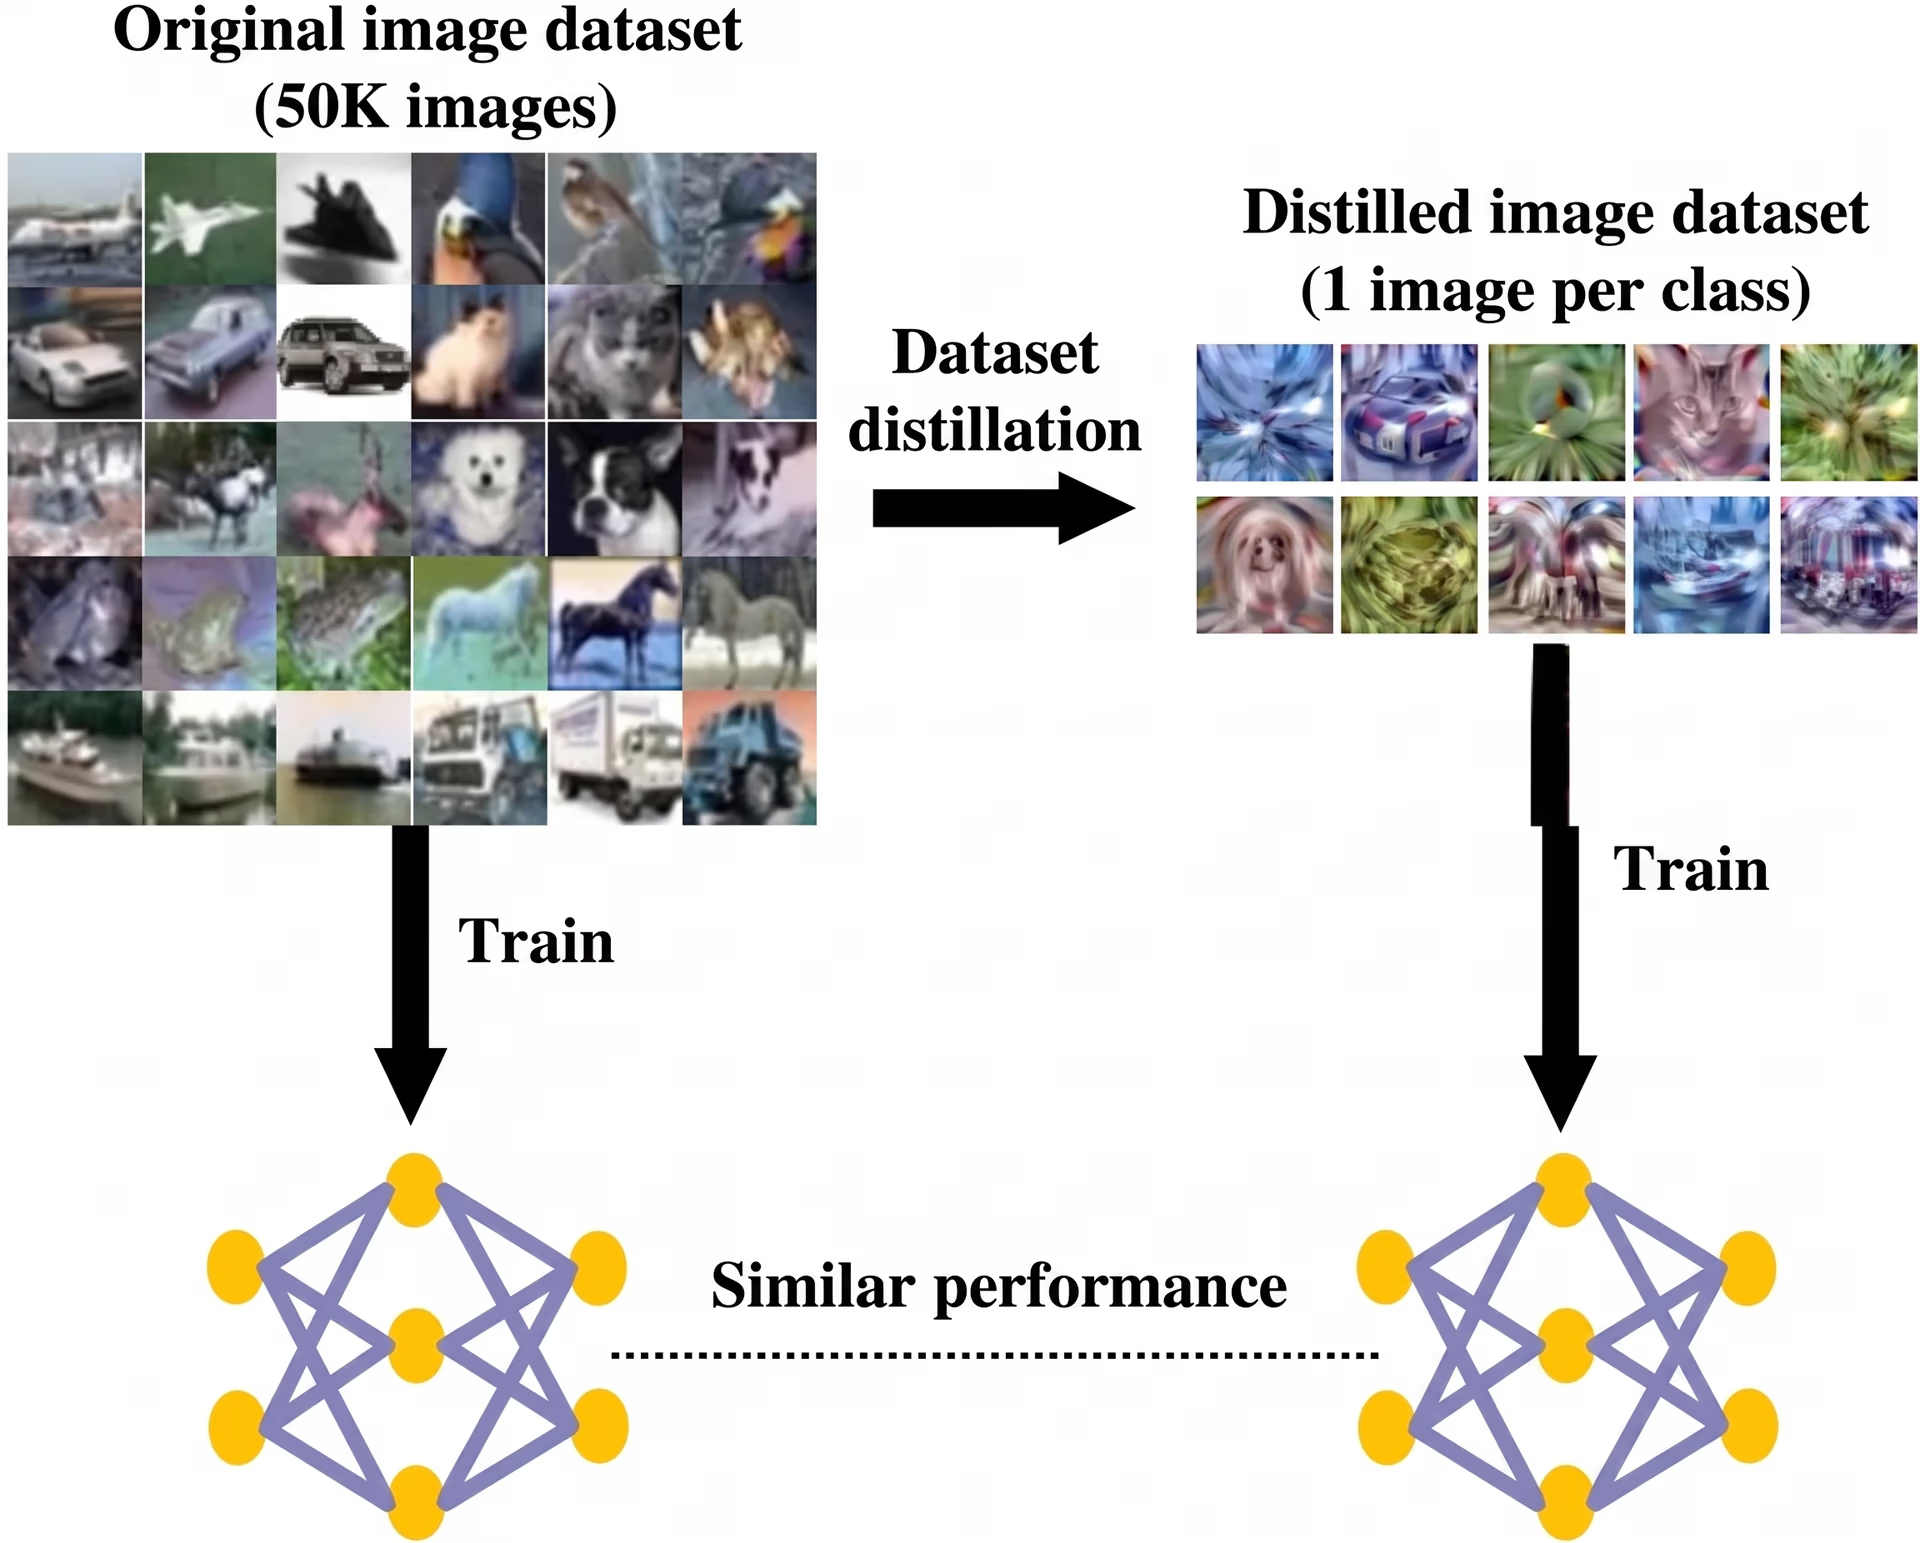
Fig. 1. Uso de la destilación de conjuntos de datos para datos de imagen (Fuente)
Desde entonces, los trabajos posteriores han ampliado aún más la destilación de conjuntos de datos, con métodos publicados en ICML e ICLR que hacen que la condensación sea más eficiente y escalable.
La importancia de la destilación de conjuntos de datos#
La destilación de conjuntos de datos mejora la eficiencia del entrenamiento y acelera los ciclos de desarrollo. Al reducir la cantidad de datos de los que debe aprender un modelo, disminuye los requisitos computacionales.
Esto resulta especialmente útil en el aprendizaje continuo, donde los modelos se actualizan con el tiempo; en la búsqueda de arquitecturas neuronales, donde se prueban muchos diseños de modelos; y en el entrenamiento en el borde, donde los modelos se ejecutan en dispositivos pequeños con memoria y potencia limitadas. En conjunto, estas ventajas hacen que la destilación de conjuntos de datos sea una excelente opción para la inicialización rápida, el ajuste fino ágil y la creación de prototipos iniciales en muchos flujos de trabajo de aprendizaje automático.
Descripción general del funcionamiento de la destilación de conjuntos de datos#
La destilación de conjuntos de datos crea muestras de entrenamiento sintéticas, es decir, generadas artificialmente. Estas muestras ayudan al modelo a aprender de una forma muy similar a como lo haría si se entrenara con datos reales. El proceso funciona siguiendo tres factores clave durante el entrenamiento habitual.
El primero es la función de pérdida, que es la puntuación de error del modelo y muestra hasta qué punto se equivoca en sus predicciones. El segundo son los parámetros del modelo, es decir, los pesos internos de la red que se actualizan a medida que aprende.
El tercero es la trayectoria de entrenamiento, que describe cómo cambian el error y los pesos paso a paso con el tiempo. A continuación, se optimizan las muestras sintéticas para que, cuando el modelo se entrene con ellas, el error disminuya y los pesos se actualicen igual que lo harían con el conjunto de datos completo.
Análisis paso a paso de la destilación de conjuntos de datos#
Veamos más de cerca cómo funciona el proceso de destilación de conjuntos de datos:
- Paso 1 - Inicializar los píxeles sintéticos: El proceso comienza con imágenes sintéticas que actúan como entradas que se pueden aprender. Al principio, estas imágenes tienen poca estructura y parecen lienzos en blanco. Con el tiempo, se optimizan hasta convertirse en ejemplos informativos.
- Paso 2 - Optimizar mediante la coincidencia de gradientes y la retropropagación: Cuando el modelo se entrena con estas imágenes sintéticas, produce gradientes que indican cómo debe cambiar cada píxel para ajustarse mejor al comportamiento de entrenamiento de los datos reales. La retropropagación es el método que utiliza la red para aprender de sus errores. Propaga el error hacia atrás a través del modelo para determinar qué píxeles y pesos lo han causado y, a continuación, los actualiza ligeramente. Con esos gradientes, la retropropagación ajusta las imágenes sintéticas paso a paso para que sean más informativas durante el entrenamiento.
- Paso 3 - Coincidir el comportamiento entre pasos de entrenamiento: El método también hace coincidir las trayectorias de entrenamiento, es decir, los cambios paso a paso que experimenta el modelo mientras aprende. Así se garantiza que el conjunto de datos destilado guíe al modelo por una ruta de aprendizaje similar a la que seguiría con el conjunto de datos completo.
- Paso 4 - Validación y generalización: Por último, el conjunto de datos destilado se evalúa con datos reales de validación para comprobar el rendimiento del modelo entrenado con ejemplos nuevos. Así se verifica que los datos sintéticos enseñen patrones amplios y funcionales, en lugar de hacer que el modelo memorice muestras concretas.
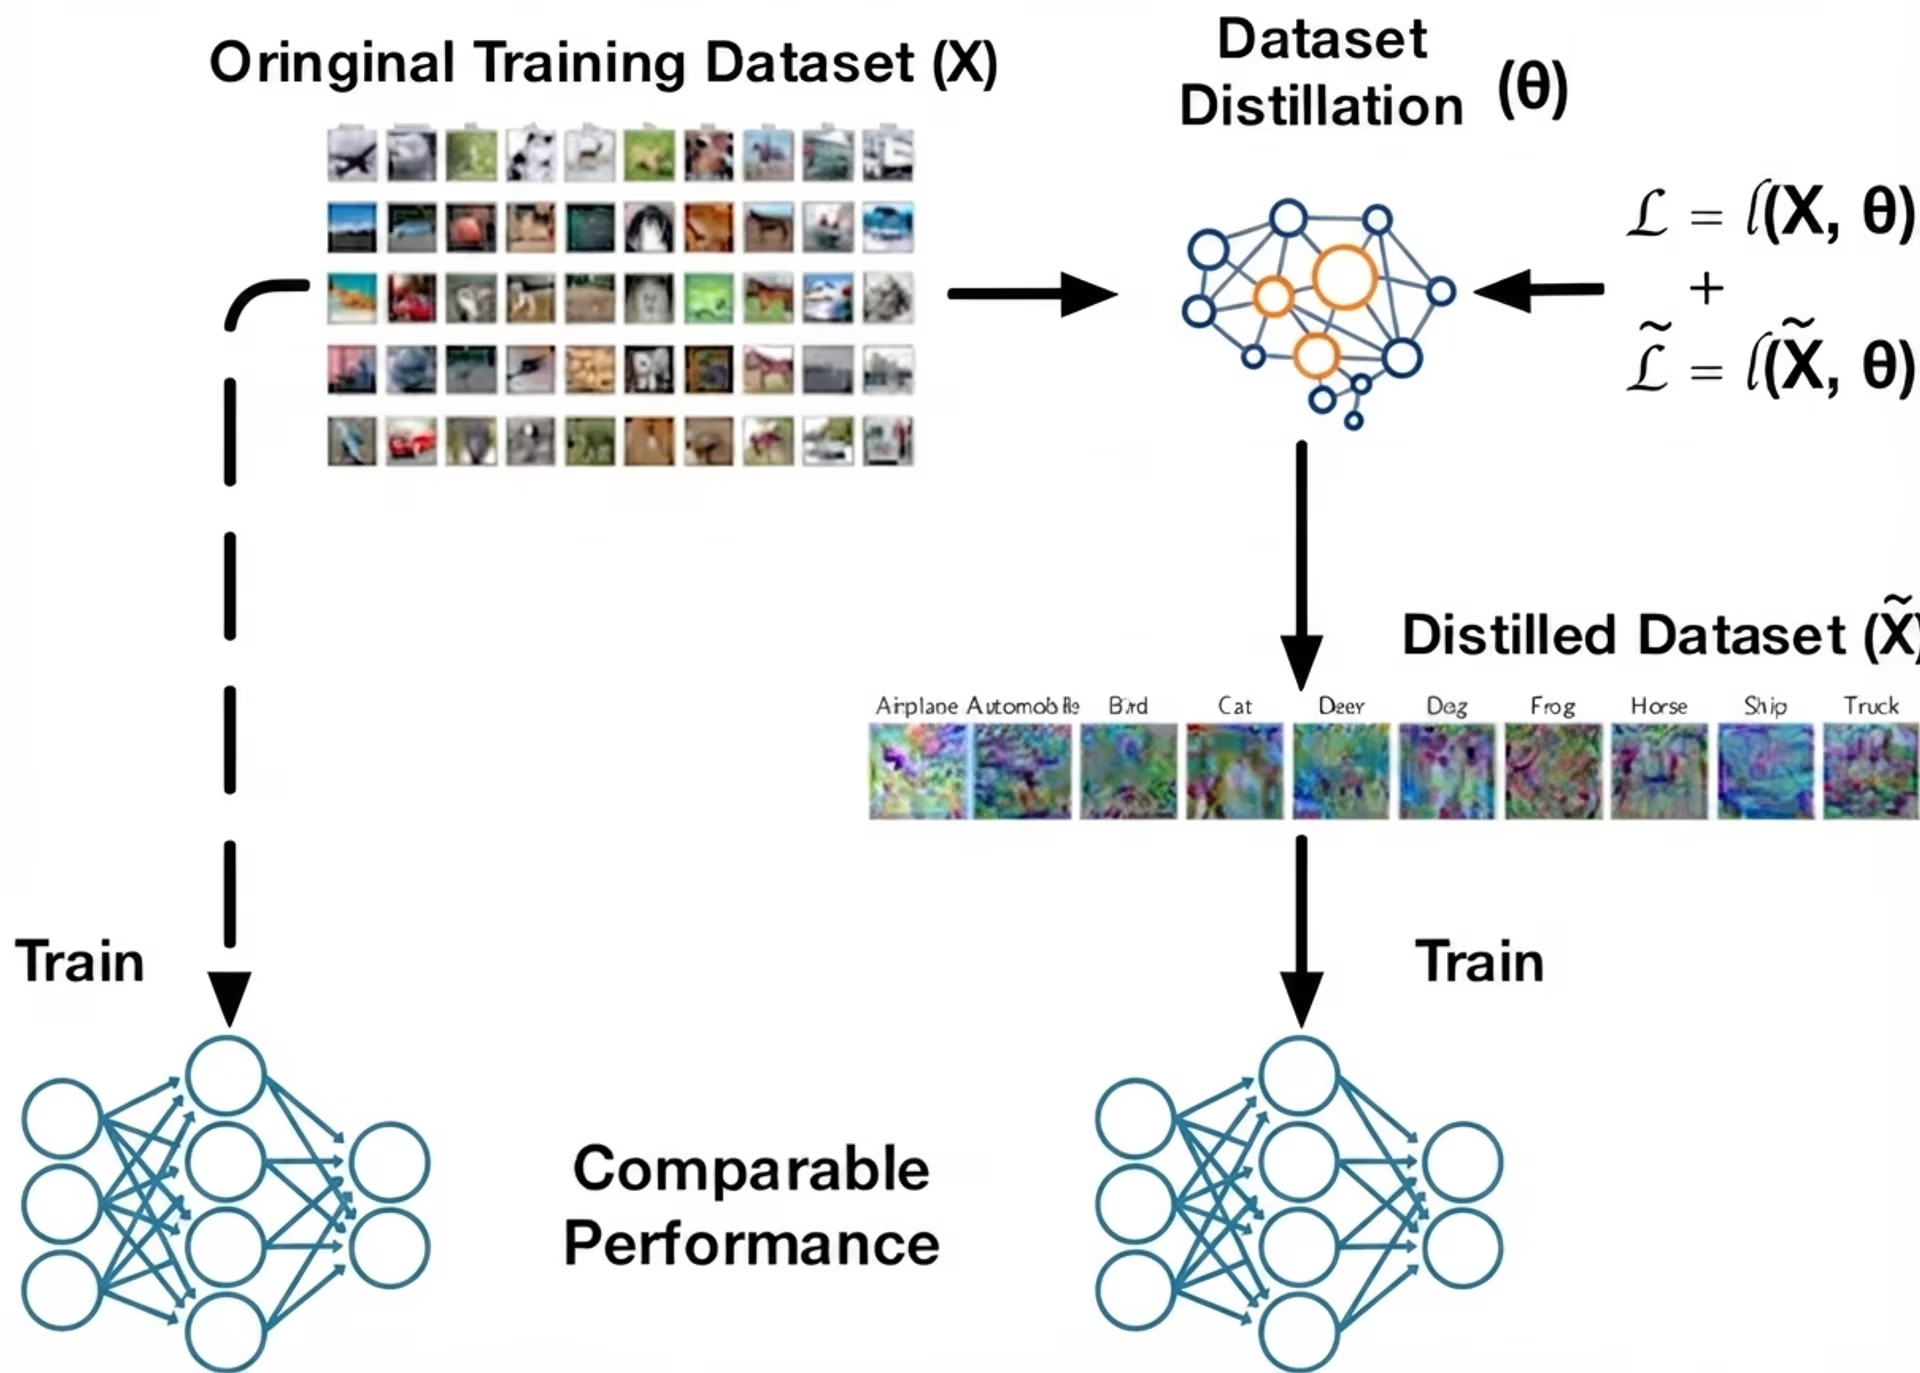
Fig. 2. Una mirada a la destilación de conjuntos de datos (Fuente)
Principales metodologías de destilación de conjuntos de datos#
Todos los métodos de destilación de conjuntos de datos se basan en la misma idea fundamental, aunque utilicen distintos algoritmos para aplicarla. La mayoría de los enfoques se clasifican en tres categorías: coincidencia del rendimiento, coincidencia de distribuciones y coincidencia de parámetros.
A continuación, veamos cada categoría y cómo funciona.
Coincidencia del rendimiento#
La coincidencia del rendimiento en la destilación de conjuntos de datos se centra en crear un conjunto de entrenamiento diminuto y optimizado que permita al modelo alcanzar una precisión casi igual a la que obtendría si se entrenara con el conjunto de datos original completo. En lugar de elegir un subconjunto aleatorio, se optimizan las muestras destiladas para que un modelo entrenado con ellas obtenga predicciones, un comportamiento de pérdida durante el entrenamiento o una precisión final similares a los de un modelo entrenado con el conjunto original.
El metaaprendizaje es un método habitual para mejorar este proceso. El conjunto de datos destilado se actualiza mediante episodios de entrenamiento repetidos, de modo que resulta eficaz en muchas situaciones posibles.
Durante estos episodios, el método simula cómo aprende un modelo alumno a partir de las muestras destiladas actuales, comprueba su rendimiento con datos reales y, después, ajusta las muestras destiladas para que enseñen mejor. Con el tiempo, el conjunto destilado aprende a facilitar un aprendizaje rápido y una buena generalización, incluso cuando el modelo alumno parte de pesos iniciales distintos o utiliza una arquitectura diferente. Esto hace que el conjunto de datos destilado sea más fiable y no dependa de una única ejecución de entrenamiento.
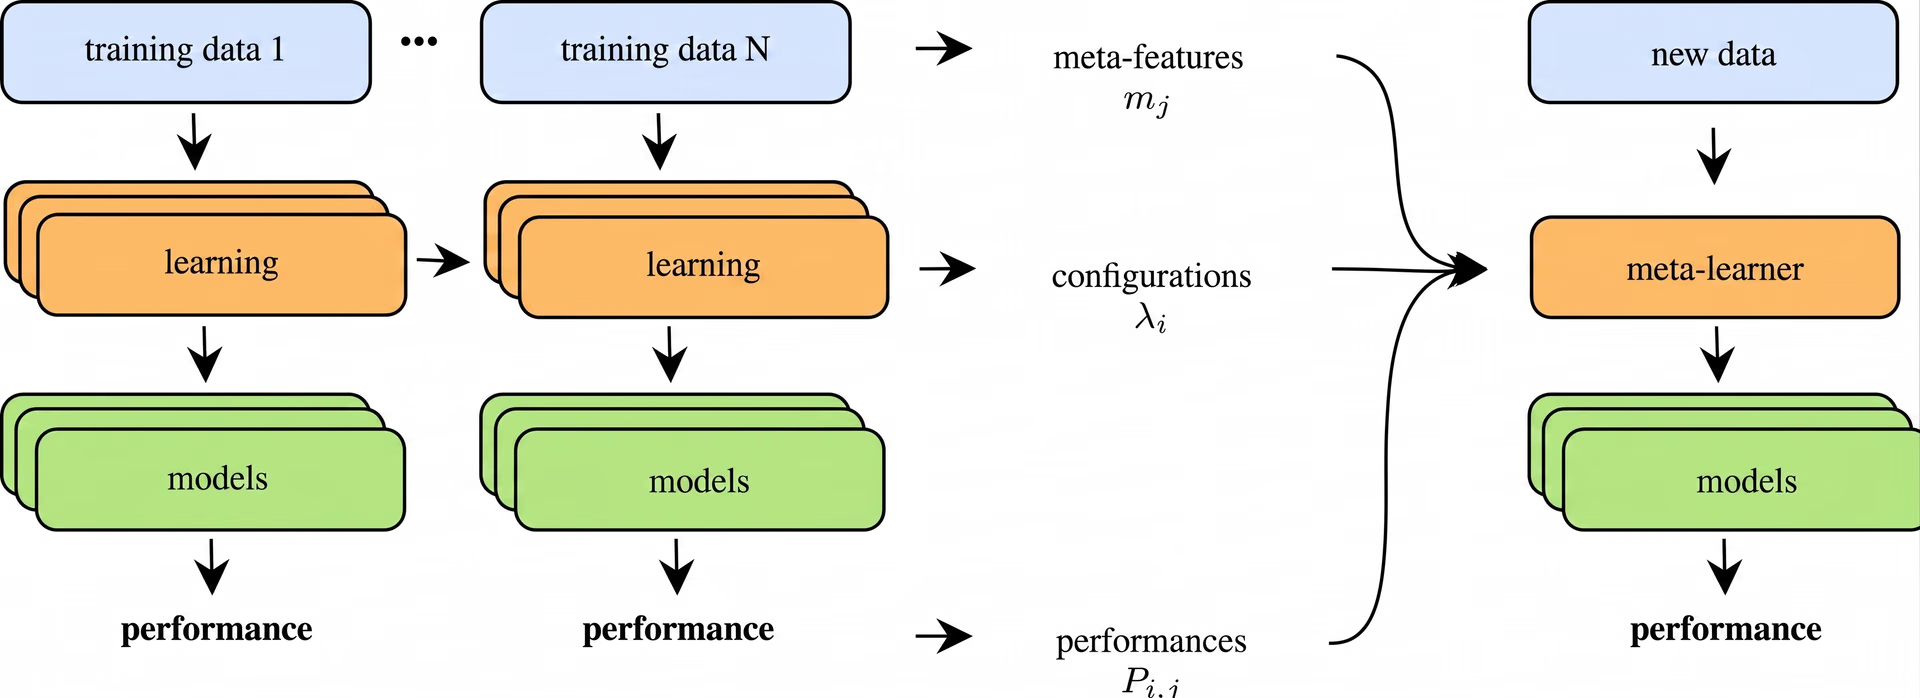
Fig. 3. El proceso de metaaprendizaje (Fuente)
Técnicas de coincidencia de distribuciones#
Por su parte, la coincidencia de distribuciones genera datos sintéticos que reproducen los patrones estadísticos del conjunto de datos real. En lugar de centrarse únicamente en la precisión final del modelo, este enfoque se centra en las características internas que genera una red neuronal durante el aprendizaje.
A continuación, veamos las dos técnicas que hacen posible la coincidencia de distribuciones.
Emparejamiento de distribuciones de una sola capa#
El emparejamiento de distribuciones de una sola capa se centra en una única capa de una red neuronal y compara las características que genera para datos reales y sintéticos. Esas características, también llamadas activaciones, capturan lo que el modelo ha aprendido en ese punto de la red.
Al hacer que los datos sintéticos generen activaciones similares, el método anima al conjunto de datos destilado a reflejar los mismos patrones importantes que el conjunto de datos original. En la práctica, las muestras sintéticas se actualizan repetidamente hasta que las activaciones de la capa elegida se asemejan mucho a las de las imágenes reales.
Este enfoque es relativamente sencillo porque alinea un solo nivel de representación cada vez. Puede funcionar especialmente bien con conjuntos de datos más pequeños o tareas en las que no sea necesario emparejar jerarquías de características profundas y formadas por varias etapas. Al alinear claramente un espacio de características, el emparejamiento de una sola capa proporciona una señal estable y significativa para aprender con el conjunto de datos destilado.
Emparejamiento de distribuciones multicapa#
El emparejamiento de distribuciones multicapa parte de la idea de comparar datos reales y sintéticos, pero lo hace en varias capas de una red neuronal en lugar de en una sola. Las distintas capas capturan diferentes tipos de información: desde bordes y texturas sencillos en las primeras capas hasta formas y patrones más complejos en las capas más profundas.
Al emparejar características de estas capas, se consigue que el conjunto de datos destilado refleje lo que el modelo aprende en varios niveles. Como alinea las características de toda la red, este enfoque ayuda a que los datos sintéticos conserven señales más ricas en las que se basa el modelo para distinguir las clases.
Esto resulta especialmente útil en visión artificial, es decir, en tareas en las que los modelos aprenden a interpretar imágenes y vídeos, porque los patrones útiles se distribuyen entre muchas capas. Cuando las distribuciones de características coinciden bien en varios niveles de profundidad, el conjunto de datos destilado sirve como sustituto más sólido y fiable de los datos de entrenamiento originales.
Métodos de emparejamiento de parámetros#
Otra categoría clave de la destilación de conjuntos de datos es el emparejamiento de parámetros. En lugar de emparejar la precisión o las distribuciones de características, empareja los cambios de los pesos de un modelo durante el entrenamiento. Al hacer que el entrenamiento con el conjunto de datos destilado genere actualizaciones de parámetros similares a las del entrenamiento con datos reales, el modelo sigue una trayectoria de aprendizaje casi idéntica.
A continuación, repasaremos los dos métodos principales de emparejamiento de parámetros.
Emparejamiento de un solo paso#
El emparejamiento de un solo paso compara lo que les ocurre a los pesos de un modelo tras un único paso de entrenamiento con datos reales. Después, el conjunto de datos destilado se ajusta para que un modelo entrenado con él durante un paso genere una actualización de pesos muy similar. Como se centra únicamente en esta actualización, el método es sencillo y rápido de ejecutar.
El inconveniente es que un solo paso no refleja todo el proceso de aprendizaje, sobre todo en tareas más difíciles, en las que el modelo necesita muchas actualizaciones para crear características más ricas. Por eso, el emparejamiento de un solo paso suele funcionar mejor con problemas más sencillos o conjuntos de datos más pequeños, donde se pueden aprender patrones útiles con rapidez.
Emparejamiento de parámetros en varios pasos#
En cambio, el emparejamiento de parámetros en varios pasos analiza cómo cambian los pesos de un modelo a lo largo de varios pasos de entrenamiento, no solo de uno. Esta secuencia de actualizaciones es la trayectoria de entrenamiento del modelo.
El conjunto de datos destilado se crea para que, cuando un modelo se entrene con las muestras sintéticas, su trayectoria se asemeje mucho a la que seguiría con datos reales. Al emparejar un tramo de aprendizaje más largo, el conjunto destilado captura mejor la estructura del proceso de entrenamiento original.
Como refleja cómo evoluciona el aprendizaje con el tiempo, el emparejamiento en varios pasos suele funcionar mejor con conjuntos de datos más grandes o complejos, en los que los modelos necesitan muchas actualizaciones para aprender patrones útiles. Requiere más capacidad de cálculo, ya que debe seguir varios pasos, pero a menudo produce conjuntos de datos destilados que generalizan mejor y ofrecen un rendimiento superior al del emparejamiento de un solo paso.
Cómo funcionan la generación y la optimización de conjuntos de datos sintéticos#
Ahora que conocemos mejor los principales enfoques de destilación, podemos ver cómo se crean los datos sintéticos. En la destilación de conjuntos de datos, las muestras sintéticas se optimizan para capturar la señal de aprendizaje más importante, de modo que un conjunto pequeño pueda sustituir a otro mucho más grande.
A continuación, veremos cómo se generan y evalúan estos datos destilados.
Creación y evaluación de imágenes destiladas#
Durante la destilación de conjuntos de datos, los píxeles sintéticos se actualizan a lo largo de muchos pasos de entrenamiento. La red neuronal aprende a partir de las imágenes sintéticas actuales y proporciona información basada en gradientes, que indica cómo debe cambiar cada píxel para reflejar mejor los patrones del conjunto de datos real.
Esto funciona porque el proceso es diferenciable (es decir, cada paso es fluido y tiene gradientes bien definidos, por lo que pequeños cambios en los píxeles producen cambios predecibles en la pérdida), lo que permite al modelo ajustar gradualmente los datos sintéticos durante el descenso del gradiente.
A medida que continúa la optimización, las imágenes sintéticas empiezan a adquirir una estructura significativa, con formas y texturas que el modelo reconoce. Estas imágenes sintéticas refinadas suelen utilizarse en tareas de clasificación de imágenes, ya que capturan las señales visuales clave que necesita aprender un clasificador.
Los conjuntos de datos destilados se evalúan entrenando modelos con ellos y comparando los resultados con los de modelos entrenados con datos reales. Los investigadores miden la precisión de validación y comprueban si el conjunto sintético conserva las características discriminativas (los patrones o señales en los que se basa el modelo para distinguir unas clases de otras) necesarias para separar las clases. También prueban la estabilidad y la capacidad de generalización en distintas ejecuciones o configuraciones de modelos para asegurarse de que los datos destilados no provoquen sobreajuste.
Aplicaciones reales de la destilación de datos#
A continuación, veremos más de cerca algunos ejemplos de cómo los conjuntos de datos destilados aceleran el entrenamiento y reducen los costes de cálculo, sin dejar de ofrecer un rendimiento sólido, incluso cuando los datos son limitados o muy especializados.
Uso de la destilación de conjuntos de datos en aplicaciones de visión artificial#
En visión artificial, el objetivo es entrenar modelos para que interpreten datos visuales, como imágenes y vídeos. Estos modelos aprenden patrones como bordes, texturas, formas y objetos, y luego los utilizan en tareas como la clasificación de imágenes, la detección de objetos o la segmentación. Como los problemas de visión suelen presentar grandes variaciones de iluminación, fondos y puntos de vista, los sistemas de visión artificial necesitan conjuntos de datos grandes para generalizar bien, lo que encarece y ralentiza el entrenamiento.
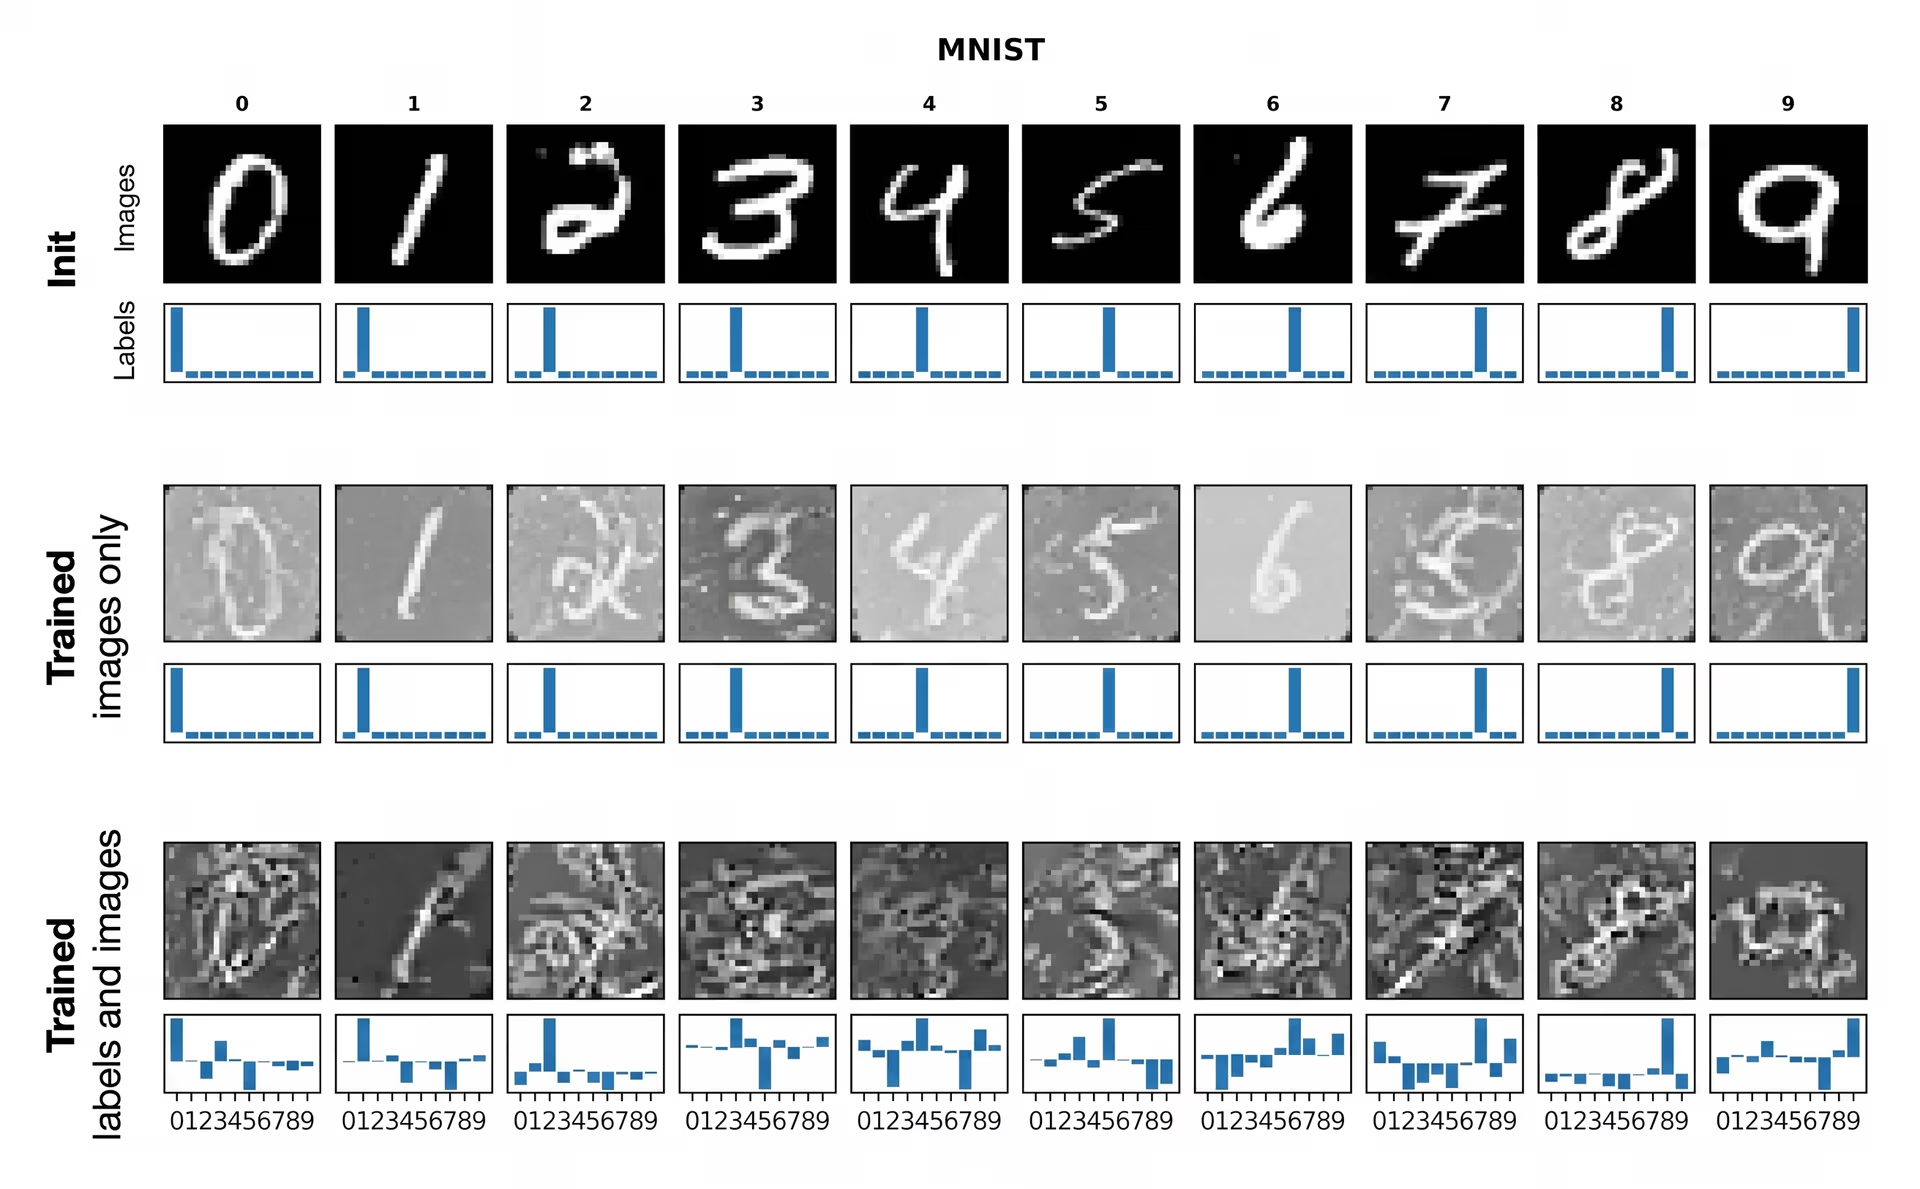
Fig. 4. Un ejemplo de destilación de conjuntos de datos (Fuente)
En casos de uso de clasificación de imágenes, como el análisis de imágenes médicas, la monitorización de la fauna o la detección de defectos en fábricas, los modelos suelen enfrentarse a un difícil equilibrio entre precisión y coste de entrenamiento. Estas tareas suelen implicar conjuntos de datos enormes.
La destilación de conjuntos de datos puede comprimir el conjunto de entrenamiento original en un pequeño número de imágenes sintéticas que aún contienen las señales visuales más importantes para el clasificador. En grandes conjuntos de referencia como ImageNet, se ha demostrado que los conjuntos destilados que utilizan solo alrededor del 4,2 % de las imágenes originales mantienen una gran precisión de clasificación. Esto significa que un pequeño conjunto sintético de referencia puede sustituir a millones de muestras reales con muchos menos recursos de cálculo.
Búsqueda de arquitecturas neuronales#
La búsqueda de arquitecturas neuronales, o NAS, es una técnica que explora automáticamente muchos diseños posibles de redes neuronales para encontrar el que mejor funciona para una tarea. Como NAS debe entrenar y evaluar un gran número de modelos candidatos, ejecutarla con conjuntos de datos completos puede ser lento y exigir muchos recursos computacionales.
La destilación de conjuntos de datos ayuda a resolver este problema al crear un conjunto de entrenamiento sintético diminuto que conserva la señal de aprendizaje principal de los datos originales, de modo que cada arquitectura candidata se pueda probar mucho más rápido. Esto permite que NAS compare diseños de forma eficiente y mantenga una fiabilidad razonable en la clasificación de las arquitecturas mejores y peores, lo que reduce el coste de la búsqueda sin sacrificar demasiada calidad en el modelo final.
Aprendizaje continuo y despliegue en el borde#
Los sistemas de aprendizaje continuo, es decir, modelos que se actualizan continuamente a medida que llegan nuevos datos en lugar de entrenarse una sola vez, necesitan actualizaciones rápidas y eficientes en el uso de la memoria. Los dispositivos edge, como cámaras, teléfonos y sensores, afrontan límites similares porque disponen de presupuestos reducidos de cálculo y almacenamiento.
La destilación de conjuntos de datos ayuda en ambos casos al comprimir un conjunto de entrenamiento grande en uno sintético diminuto, para que los modelos puedan adaptarse o volver a entrenarse con un pequeño conjunto de repetición en lugar de utilizar el conjunto de datos completo. Por ejemplo, un trabajo sobre metaaprendizaje basado en núcleos demostró que solo 10 muestras destiladas pueden alcanzar más del 64 % de precisión en CIFAR-10, un conjunto de referencia estándar para la clasificación de imágenes. Como el conjunto de repetición es tan compacto, las actualizaciones son mucho más rápidas y prácticas, sobre todo cuando es necesario actualizar los modelos con frecuencia.
La destilación de conjuntos de datos también puede combinarse con la destilación de conocimiento para modelos de lenguaje grandes. Un conjunto de datos pequeño y destilado puede conservar las señales de tarea más importantes del modelo profesor, de modo que se pueda entrenar o actualizar un modelo estudiante comprimido con mayor eficiencia y sin perder demasiado rendimiento. Como estos conjuntos de datos son diminutos, resultan especialmente útiles para el uso en edge o en el propio dispositivo, donde el almacenamiento y la capacidad de cálculo son limitados, pero se quiere que el modelo mantenga su precisión tras las actualizaciones.
Ventajas e inconvenientes de la destilación de datos#
Estas son algunas de las ventajas de utilizar la destilación de conjuntos de datos:
- Ideal para hacer pruebas rápidas. Puedes probar nuevas arquitecturas, funciones de pérdida o hiperparámetros sin tener que volver a entrenar cada vez con un conjunto de datos enorme.
- Posible ventaja en materia de privacidad. Compartir muestras sintéticas destiladas puede ser más seguro que compartir datos reales de usuarios, ya que los ejemplos sin procesar no quedan expuestos directamente.
- A menudo, mejor que una simple selección de subconjuntos. En lugar de limitarse a seleccionar ejemplos, la destilación los optimiza activamente para que sean lo más informativos posible.
Aunque la destilación de conjuntos de datos ofrece varias ventajas, estas son algunas limitaciones que conviene tener en cuenta:
- Sobreajuste. Los datos destilados suelen funcionar mejor con la arquitectura utilizada durante la destilación y pueden transferirse mal a modelos muy diferentes.
- Sensibilidad a los hiperparámetros. Los resultados pueden depender mucho de factores como la tasa de aprendizaje, la inicialización o el número de pasos de destilación.
- Más difícil de escalar a la complejidad del mundo real. Los métodos que funcionan bien en conjuntos de referencia pueden perder precisión con conjuntos de datos grandes, desordenados o de alta resolución.
Conclusiones clave#
La destilación de conjuntos de datos permite que un pequeño conjunto de muestras sintéticas enseñe a un modelo casi con la misma eficacia que un conjunto de datos completo. Esto hace que el aprendizaje automático sea más rápido, eficiente y fácil de escalar. A medida que los modelos crecen y necesitan más datos, los conjuntos de datos destilados ofrecen una forma práctica de reducir los costes de cálculo sin sacrificar precisión.
Únete a nuestra comunidad y echa un vistazo a nuestro repositorio de GitHub para descubrir más sobre la IA. Si quieres crear tu propio proyecto de IA visual, consulta nuestras opciones de licencia. Descubre más sobre aplicaciones como la IA en la atención sanitaria y la IA visual en el comercio minorista visitando nuestras páginas de soluciones.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









