¿Qué es la estimación monocular de profundidad? Resumen
Descubre cómo funciona la estimación monocular de profundidad, cómo se compara con los métodos de profundidad basados en sensores y cómo permite una percepción 3D escalable en sistemas de visión.
 Abirami Vina20 min de lectura
Los coches autónomos están diseñados para entender lo que ocurre a su alrededor y así poder circular de forma segura. Para ello, deben ir más allá de reconocer objetos como peatones u otros vehículos.
También necesitan saber a qué distancia están esos objetos para responder correctamente. Sin embargo, dotar a las máquinas de esta percepción de la distancia no es sencillo. A diferencia de las personas, no perciben la profundidad de forma natural a partir de las imágenes y hay que enseñarles explícitamente a hacerlo.
Una de las razones es que la mayoría de las cámaras capturan el mundo en imágenes planas y bidimensionales. Convertir esas imágenes en una representación de la profundidad y la estructura 3D del mundo real es complicado, sobre todo cuando los sistemas deben funcionar de forma fiable en condiciones cotidianas.
Curiosamente, la visión artificial, una rama de la IA centrada en interpretar y comprender datos visuales, permite que las máquinas entiendan mejor el mundo a partir de imágenes. Por ejemplo, la estimación monocular de profundidad es una técnica de visión artificial que calcula la distancia a los objetos utilizando la imagen de una sola cámara.
Al aprender señales visuales como el tamaño de los objetos, la perspectiva, la textura y las sombras, estos modelos pueden predecir la profundidad sin depender de sensores adicionales como LiDAR (detección y medición de distancias mediante luz) o cámaras estereoscópicas. En este artículo veremos qué es la estimación monocular de profundidad, cómo funciona y algunas de sus aplicaciones en el mundo real.
Breve introducción a la estimación monocular de profundidad#
La estimación monocular de profundidad permite que una máquina calcule a qué distancia están los objetos utilizando una sola imagen. Como solo requiere una cámara, este método ofrece varias ventajas, como un coste menor y requisitos de hardware más sencillos.
Por ejemplo, puede utilizarse en robots domésticos asequibles que funcionan con una sola cámara. A partir de una única imagen, el sistema robótico puede identificar qué paredes están más cerca y qué puertas están más lejos, e inferir la profundidad general del espacio.
A menudo, una sola imagen no contiene información sobre la escala correcta, por lo que la estimación monocular de profundidad suele centrarse en la profundidad relativa. En otras palabras, puede determinar qué objetos están más cerca y cuáles más lejos, aunque no se conozcan las distancias exactas.
Cuando un modelo se entrena con datos que incluyen distancias reales o profundidad absoluta, como las mediciones de profundidad de sensores LiDAR, puede aprender a predecir distancias en unidades del mundo real, como metros. Sin este tipo de datos de referencia, el modelo puede seguir infiriendo la profundidad relativa, pero no puede calcular distancias absolutas de forma fiable.
El resultado de la estimación monocular de profundidad suele ser un mapa de profundidad: una imagen en la que cada píxel representa la cercanía o lejanía de esa parte de la escena. Un mapa de profundidad ofrece a los sistemas de visión una comprensión básica de la estructura 3D del entorno.
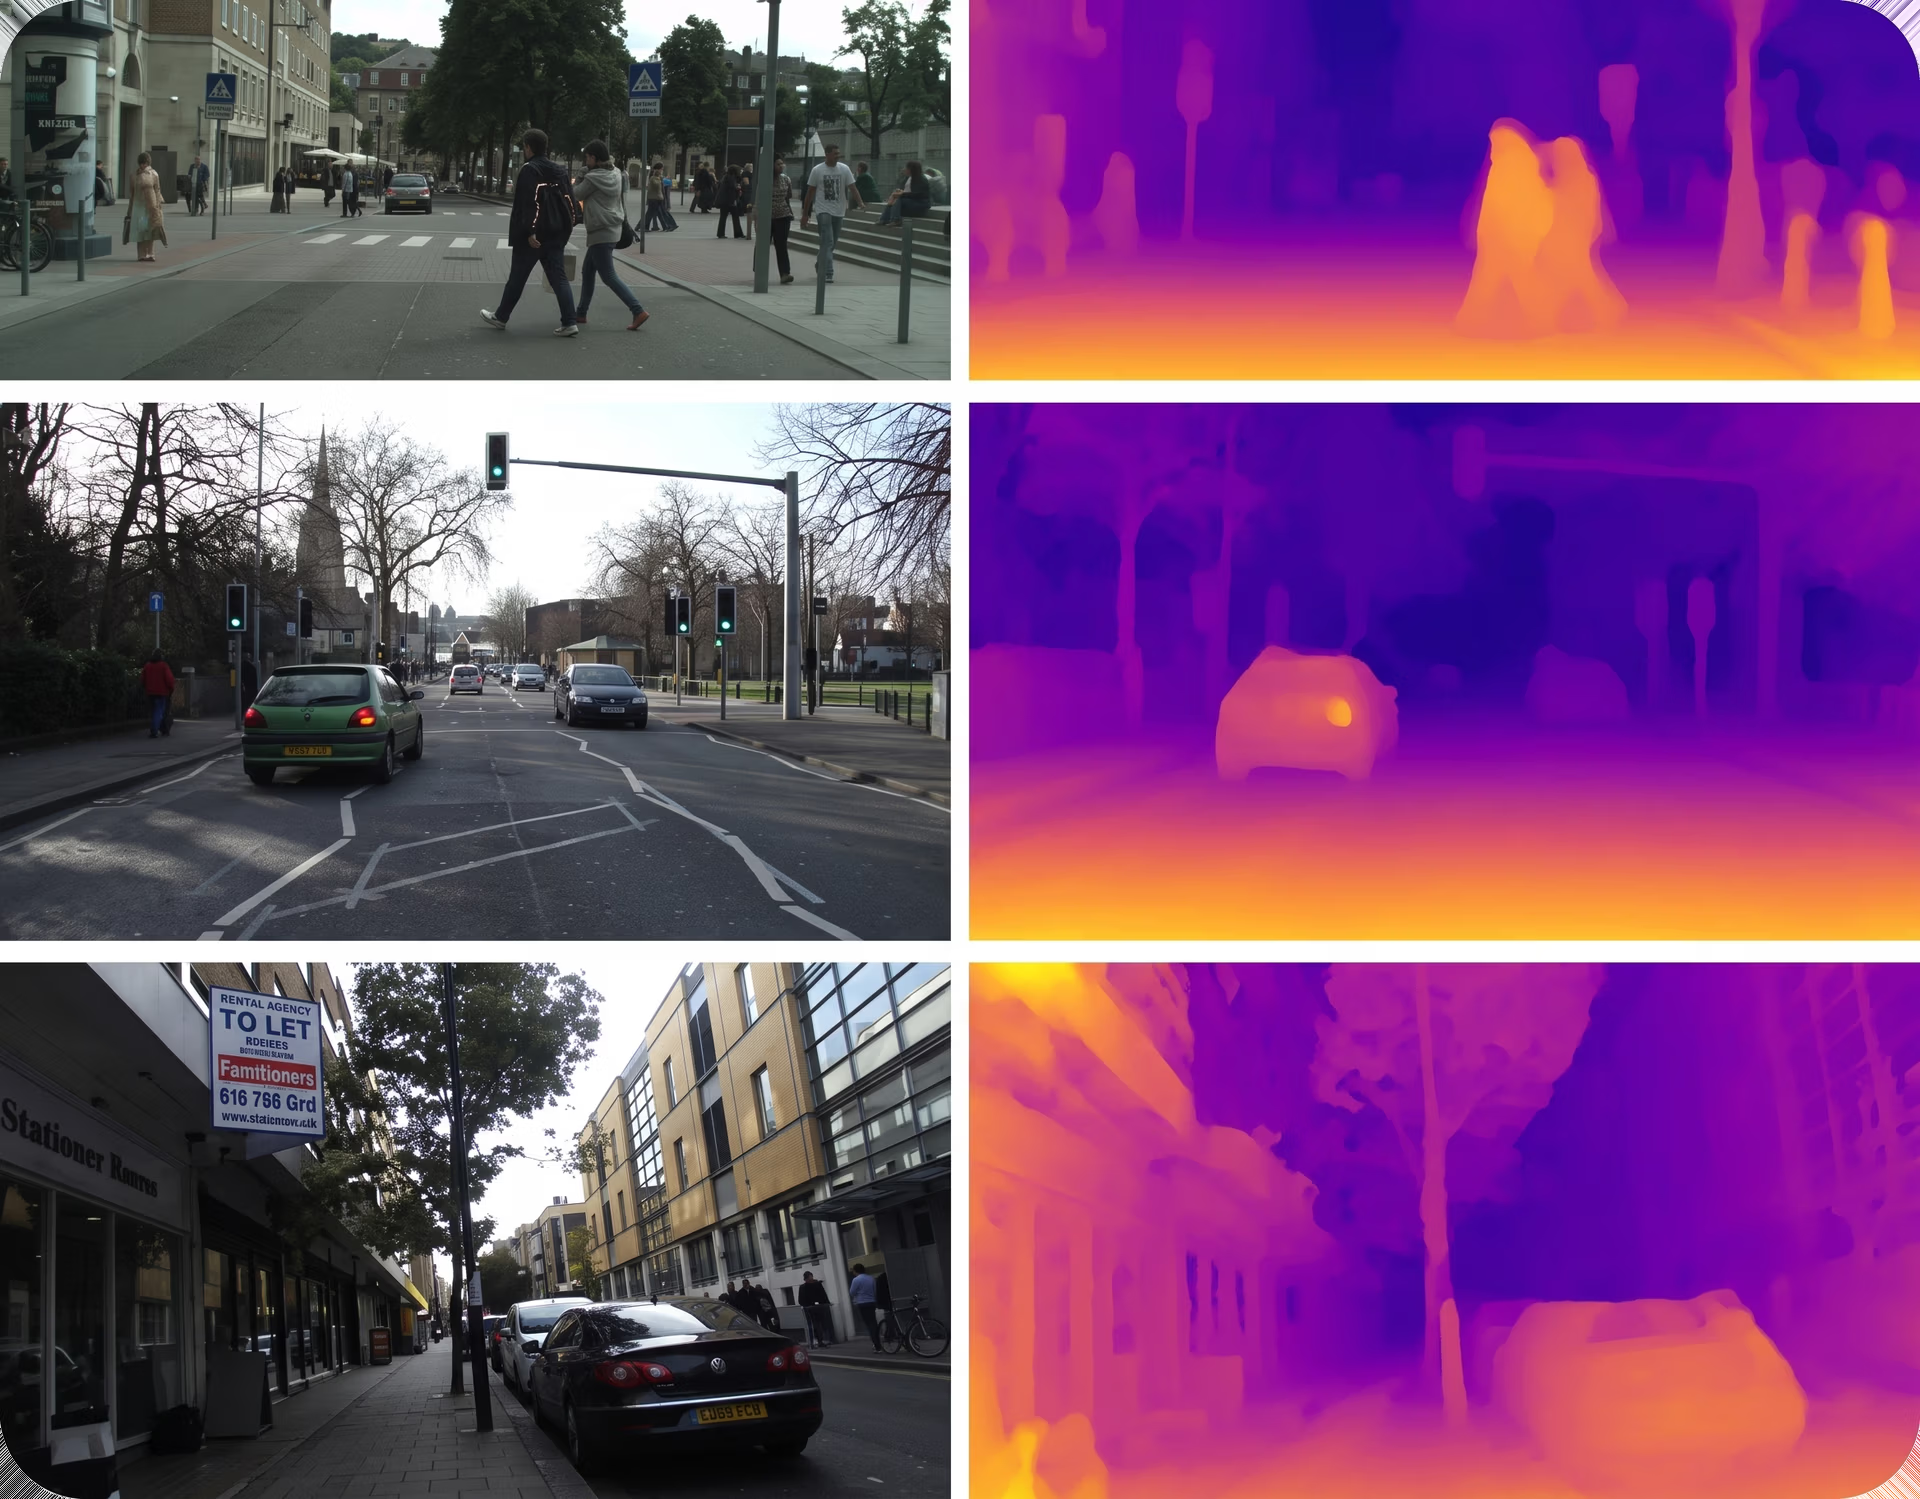
Fig. 1. Ejemplo de un mapa de profundidad predicho mediante estimación monocular de profundidad (Fuente)
De los sensores a las imágenes: estimación de profundidad#
La estimación de profundidad puede abordarse de varias maneras, en función de los sensores disponibles, las limitaciones de hardware y los requisitos de precisión. Los métodos tradicionales suelen recurrir a varios puntos de vista o a sensores especializados para medir directamente la distancia.
Un método habitual es la visión estereoscópica, que calcula la profundidad comparando dos imágenes sincronizadas capturadas desde puntos de vista ligeramente distintos. Al medir la diferencia entre los puntos correspondientes de ambas imágenes, el sistema puede inferir a qué distancia están los objetos de la cámara.
Otro método son los sistemas RGB-D (rojo, verde, azul y profundidad), que utilizan sensores de profundidad activos para medir directamente la distancia de cada píxel. Estos sistemas pueden proporcionar información de profundidad precisa en entornos controlados, pero requieren hardware adicional.
Por su parte, los métodos basados en LiDAR utilizan pulsos láser para generar representaciones tridimensionales precisas de una escena. Aunque los sensores LiDAR son muy precisos, suelen ser caros y añaden una complejidad de hardware considerable.
En cambio, la estimación monocular de profundidad infiere la profundidad utilizando una sola imagen RGB. Como no depende de varias cámaras ni de sensores especializados, es más fácil de implementar a gran escala y una buena opción cuando el coste y los recursos de hardware son limitados.
Aprender a estimar la profundidad a partir de una sola imagen#
Al estimar la profundidad a partir de una sola imagen, los modelos monoculares de profundidad aprenden a reconocer los indicios visuales que las personas utilizan instintivamente para calcular distancias. Estos indicios incluyen las líneas de perspectiva, el tamaño de los objetos, la densidad de las texturas, la oclusión entre objetos y el sombreado; todos ofrecen pistas sobre la distancia de los objetos respecto a la cámara.
Estos indicios se combinan para crear una sensación de profundidad. Los objetos que parecen más pequeños o están parcialmente ocultos suelen encontrarse más lejos, mientras que los detalles más nítidos y una apariencia visual de mayor tamaño suelen indicar que algo está más cerca.
Para aprender estos patrones, los modelos monoculares de profundidad se entrenan con conjuntos de datos de imágenes a gran escala, a menudo emparejados con información de profundidad obtenida de otras fuentes, como LiDAR o sistemas estereoscópicos. Durante el entrenamiento, los modelos aprenden cómo se relacionan los indicios visuales con la profundidad, lo que les permite inferir distancias a partir de una sola imagen durante la inferencia.
Con datos de entrenamiento diversos, los modelos de visión modernos pueden generalizar lo aprendido a una amplia variedad de entornos, tanto interiores como exteriores, y gestionar puntos de vista desconocidos.
Repaso de distintas técnicas de estimación monocular de profundidad#
A continuación, veremos los principales métodos para estimar la profundidad a partir de una sola imagen y cómo han evolucionado con el tiempo.
Métodos clásicos y basados en la geometría#
Los primeros métodos de estimación de profundidad se basaban en reglas visuales sencillas vinculadas a la geometría de la cámara. Se utilizaban indicios como la perspectiva, el tamaño de los objetos y el hecho de que un objeto ocultara a otro para calcular la distancia.
Por ejemplo, si dos objetos similares aparecían con tamaños distintos, se suponía que el más pequeño estaba más lejos. Estos métodos funcionaban razonablemente bien en entornos controlados, donde factores como la iluminación, la posición de la cámara y la distribución de la escena se mantenían constantes.
Sin embargo, estas suposiciones suelen fallar en escenas del mundo real. Las variaciones de iluminación, los cambios de punto de vista y la mayor complejidad de la escena pueden dar lugar a estimaciones de profundidad poco fiables, lo que limita la eficacia de los métodos clásicos en entornos no controlados.
Primeros métodos de aprendizaje automático#
Los primeros métodos de aprendizaje automático aportaron más flexibilidad a la estimación de profundidad, ya que aprendían patrones directamente de los datos. En lugar de depender únicamente de reglas geométricas fijas, estos modelos intentaban aprender la relación entre la información visual y la distancia, planteando la predicción de profundidad como un problema de regresión basado en indicios como los bordes, las texturas y los cambios de color.
La selección de estas características era una parte clave del proceso. Los ingenieros tenían que decidir qué señales visuales extraer y cómo representarlas, y el rendimiento del modelo dependía en gran medida de esas decisiones.
Aunque este método funcionaba mejor que los anteriores, seguía teniendo limitaciones. Si las características seleccionadas no incluían contexto importante, las predicciones de profundidad eran menos precisas. A medida que las escenas se volvían más complejas y diversas, estos modelos solían tener dificultades para obtener resultados fiables.
Algoritmos de aprendizaje profundo#
La mayoría de los sistemas modernos de estimación monocular de profundidad utilizan aprendizaje profundo, es decir, redes neuronales con muchas capas capaces de aprender patrones complejos a partir de los datos. Estos modelos aprenden a predecir la profundidad directamente a partir de las imágenes y generan mapas de profundidad.
Muchos métodos se basan en redes neuronales convolucionales (CNNs), un tipo de red neuronal diseñada para procesar imágenes mediante la detección de patrones como bordes y formas. Estos modelos suelen utilizar una estructura de codificador-decodificador: el codificador extrae características visuales de la imagen y el decodificador las convierte en un mapa de profundidad. Procesar la imagen a varias escalas ayuda al modelo a captar la distribución general de la escena y, a la vez, a identificar con claridad los límites de los objetos.
Los modelos más recientes se centran en comprender las relaciones entre distintas partes de una imagen. Los modelos basados en Transformer y los Vision Transformer (ViT) utilizan mecanismos de atención, que permiten al modelo identificar las regiones más relevantes de una imagen y relacionar entre sí zonas distantes. Esto ayuda al modelo a crear una comprensión de la profundidad más coherente en toda la escena.
Algunos sistemas combinan ambas ideas. Los modelos híbridos CNN-Transformer utilizan CNNs para captar detalles locales precisos y Transformers para modelar el contexto global de la escena. Aunque esto suele mejorar la precisión, por lo general requiere más recursos computacionales, como memoria adicional y capacidad de procesamiento.
Por qué es importante comprender la profundidad para los sistemas de IA visual#
Al aprender sobre la estimación monocular de profundidad, quizá te preguntes por qué comprender la profundidad es tan importante para los sistemas de IA basados en visión.
Cuando un sistema puede calcular a qué distancia están los objetos y las superficies, comprende mejor cómo se distribuye la escena y cómo se relacionan sus distintos elementos. Esta percepción espacial es esencial para tomar decisiones fiables, sobre todo en aplicaciones del mundo real como la conducción autónoma.
La información de profundidad también aporta un contexto valioso a otras tareas de visión artificial. Por ejemplo, la detección de objetos, que admiten modelos como Ultralytics YOLO26, puede indicar a un sistema qué hay en una escena, pero la profundidad ayuda a determinar dónde se encuentran esos objetos con respecto a la cámara y entre sí.
En conjunto, estas capacidades hacen posibles numerosas aplicaciones de IA visual, como crear mapas 3D, recorrer entornos complejos y comprender una escena en su totalidad.
Los robots y los vehículos autónomos dependen de esta información para desplazarse de forma segura, evitar obstáculos y reaccionar a los cambios en tiempo real. Por ejemplo, el enfoque de conducción basada únicamente en visión de Tesla combina imágenes de cámaras con la estimación de profundidad, en lugar de utilizar LiDAR, para comprender a qué distancia están los objetos y dónde se encuentran en la carretera.
Cómo funcionan los modelos de estimación monocular de profundidad#
Aunque las arquitecturas de los modelos varían, la mayoría de los modelos de estimación monocular de profundidad siguen un proceso similar para convertir una sola imagen en un mapa de profundidad. A continuación tienes un breve resumen de los pasos principales:
- Entrada y preprocesamiento: el flujo de trabajo empieza con una imagen de entrada. Antes de introducirla en el modelo, normalmente se cambia el tamaño de la imagen original, se normaliza y se convierte en un tensor, el formato que utilizan las redes neuronales para procesar datos de imagen de forma eficiente.
- Extracción de características: una red codificadora analiza la imagen para extraer características visuales relevantes. Estas características capturan información como las texturas, los límites de los objetos y la distribución general de la escena. La mayoría de los modelos trabajan con varias escalas para comprender tanto los detalles precisos como la estructura global.
- Razonamiento sobre la profundidad: a partir de las características extraídas, el modelo combina los detalles locales con el contexto global para razonar sobre las relaciones espaciales de la escena. En esta fase aprende qué regiones de la imagen están más cerca de la cámara y cuáles más lejos.
- Generación del mapa de profundidad: a continuación, un decodificador convierte esta información en un mapa de profundidad denso. Se asigna un valor de profundidad a cada píxel de la imagen, a menudo combinando predicciones de distintas escalas para mejorar la precisión y la coherencia.
Cómo se entrenan los modelos de estimación monocular de profundidad#
El proceso que acabamos de describir presupone que ya tenemos un modelo entrenado o preentrenado. Pero ¿cómo se entrena realmente un modelo de estimación monocular de profundidad?
El entrenamiento empieza con la preparación de los datos de imagen para que la red pueda procesarlos de forma eficiente. Se cambia el tamaño de las imágenes de entrada y se normalizan a una escala uniforme; después, se introducen en el modelo para generar un mapa de profundidad predicho que calcula la distancia de cada píxel.
A continuación, el mapa de profundidad predicho se compara con los datos de profundidad de referencia mediante una función de pérdida, que mide cuánto se aleja la predicción del modelo de la profundidad real. Este valor de pérdida representa el error actual del modelo y proporciona una señal para mejorarlo.
Un optimizador utiliza esta señal para actualizar el modelo y ajustar sus pesos internos. Para ello, calcula el gradiente, que describe cómo cambia la pérdida con respecto a cada parámetro del modelo, y aplica estas actualizaciones repetidamente durante varias épocas, es decir, recorridos completos por el conjunto de datos de entrenamiento.
Este proceso iterativo de entrenamiento supervisado se guía mediante hiperparámetros como la tasa de aprendizaje, que controla el tamaño de cada paso de actualización, y el tamaño del lote, que determina cuántas imágenes se procesan a la vez. Como el entrenamiento implica un gran número de operaciones matemáticas, suele acelerarse mediante una unidad de procesamiento gráfico (GPU), ideal para el cálculo paralelo.
Una vez finalizado el entrenamiento, el modelo se evalúa con métricas de evaluación estándar en un conjunto de validación, compuesto por imágenes que no se utilizaron durante el entrenamiento. Esta evaluación permite medir hasta qué punto el modelo generaliza a datos nuevos.
Después, el modelo entrenado se puede reutilizar o ajustar para nuevos escenarios. En conjunto, este proceso de entrenamiento permite que los modelos de estimación monocular de profundidad generen estimaciones coherentes, esenciales para tareas posteriores como la reconstrucción 3D y la implementación en el mundo real.
Modelos de vanguardia y tendencias de investigación#
La estimación monocular de profundidad ha avanzado rápidamente a medida que los modelos han mejorado su capacidad para comprender escenas completas, en lugar de limitarse a pequeños detalles visuales. Los primeros métodos solían generar mapas de profundidad irregulares, sobre todo en entornos complejos.
Los modelos más recientes, como los que aparecen en investigaciones publicadas en arXiv, se centran más en el contexto global, lo que da lugar a predicciones de profundidad más estables y realistas. Modelos conocidos como MiDaS y DPT impulsaron este cambio al aprender la profundidad a partir de conjuntos de datos diversos y de alta resolución y generalizar bien en muchas escenas.
Modelos más recientes, como ZoeDepth y Depth Anything V2, se basan en este trabajo y mejoran la coherencia de escala, manteniendo un rendimiento sólido en una amplia variedad de entornos. Este tipo de progreso suele medirse con conjuntos de datos de referencia habituales, como KITTI y NYU Depth V2, que incluyen escenas tanto exteriores como interiores.
Una tendencia clara es buscar el equilibrio entre precisión y practicidad. Los modelos más pequeños se optimizan para ofrecer velocidad y ejecutarse en tiempo real en dispositivos perimetrales o móviles, mientras que los modelos más grandes priorizan una mayor resolución y precisión de profundidad a larga distancia. Por ejemplo, los modelos de profundidad Ultralytics YOLO26 abarcan desde el ligero YOLO26n-depth, pensado para usos perimetrales en tiempo real, hasta el YOLO26x-depth, más grande y preciso.
Aplicaciones de la estimación monocular de profundidad#
A continuación, veremos algunos ejemplos del mundo real que muestran cómo se utiliza la estimación monocular de profundidad para inferir la estructura 3D de una escena a partir de una sola imagen.
En todos estos casos, es importante recordar que la información de profundidad es una estimación inferida a partir de indicios visuales, no una medición precisa. Por eso, la estimación monocular de profundidad es útil para comprender la distribución relativa y las relaciones espaciales, pero no sustituye a los sensores diseñados para medir distancias con precisión, como LiDAR o los sistemas estereoscópicos.
Cartografía del terreno y navegación con drones#
Los drones suelen operar en entornos donde las señales GPS no son fiables, como bosques, obras, zonas de desastre o áreas urbanas densas. Para volar con seguridad en estas condiciones, necesitan comprender el terreno circundante y saber a qué distancia están los obstáculos. Antes, esto solía requerir sensores adicionales como LiDAR o cámaras estereoscópicas, que aumentan el peso, el consumo energético y el coste total.
La estimación monocular de profundidad es una alternativa más sencilla. Con una sola cámara RGB, los drones pueden calcular la profundidad a partir de imágenes y construir una comprensión 3D básica de su entorno. Esto les permite detectar obstáculos como edificios, árboles o cambios bruscos del terreno y ajustar su trayectoria en tiempo real.
Estas estimaciones de profundidad permiten realizar tareas de navegación clave, como evitar obstáculos, controlar la altitud y aterrizar de forma segura. Así, los drones ligeros pueden realizar tareas de cartografía, inspección y navegación sin depender de sensores de profundidad especializados.
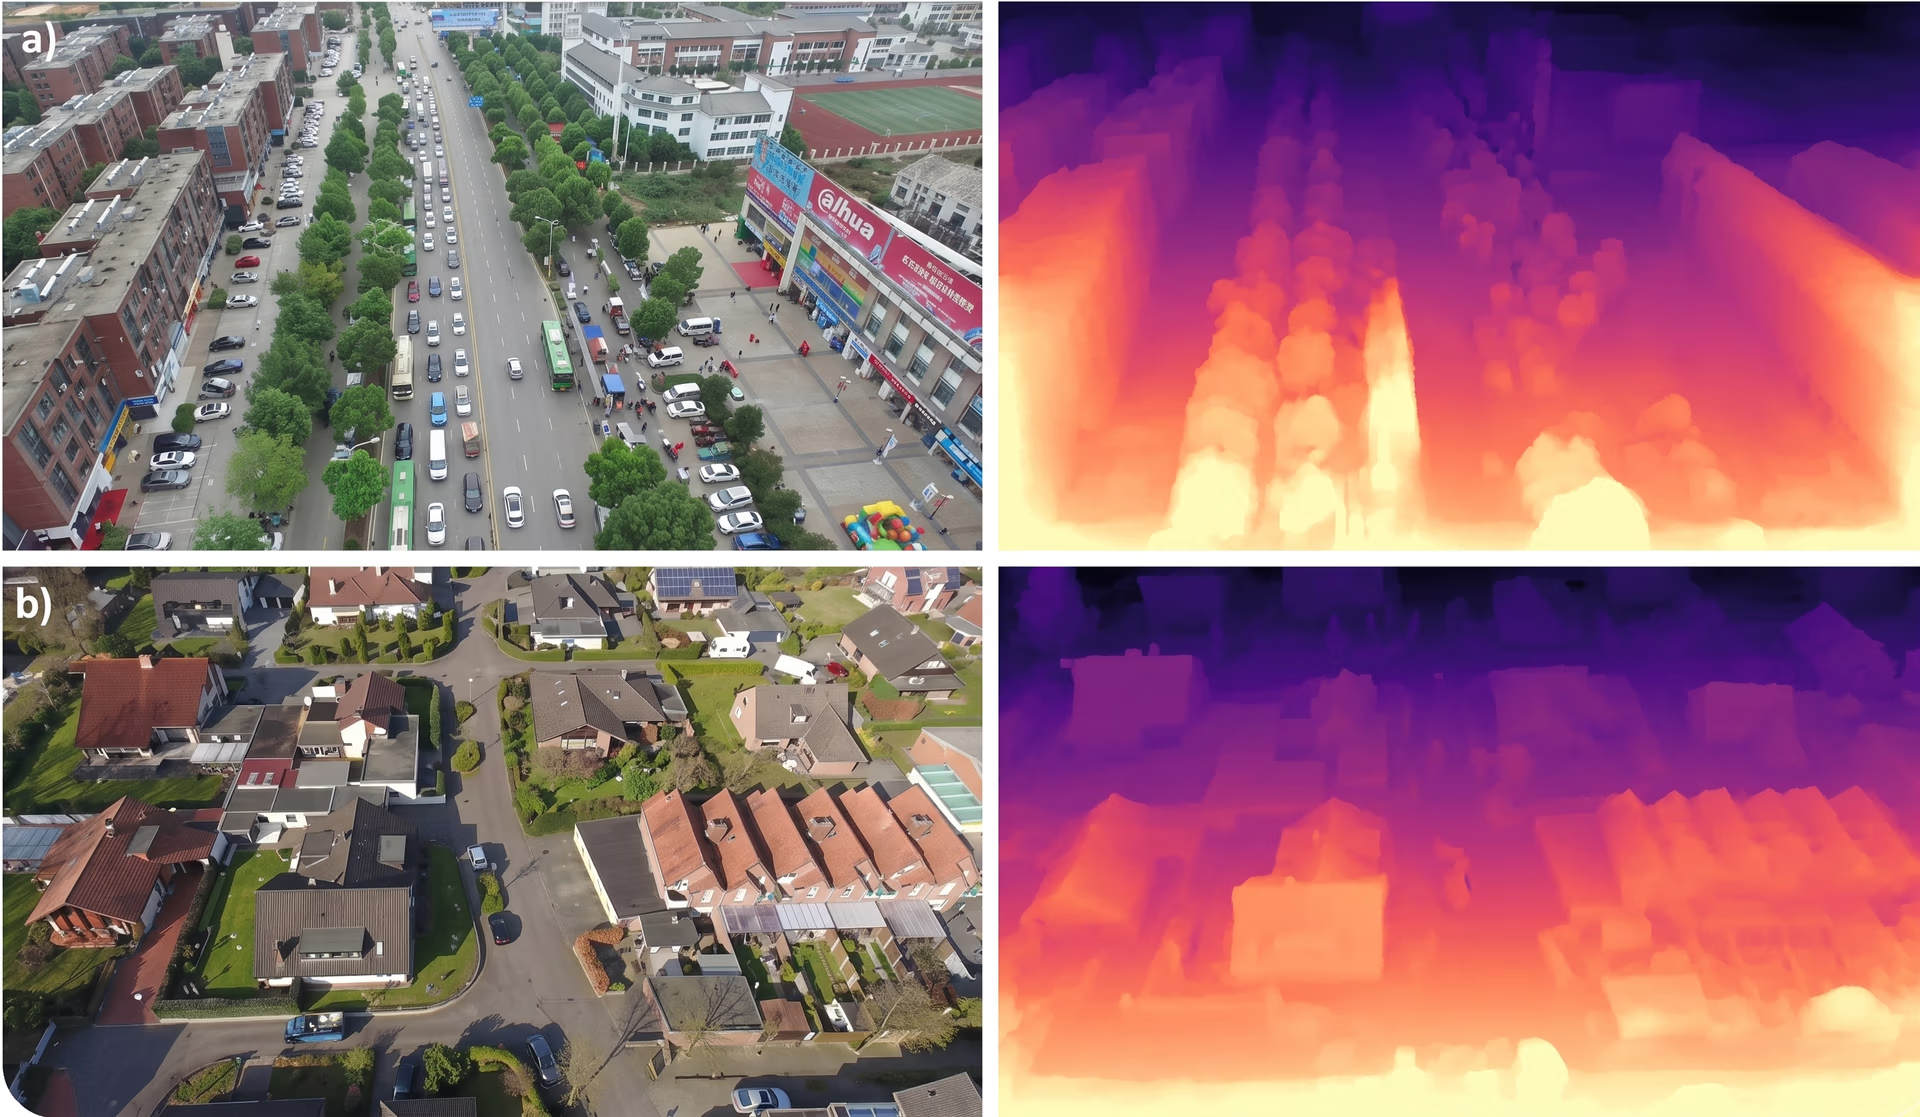
Fig. 2. La estimación monocular de profundidad puede utilizarse para analizar imágenes de drones (Fuente)
Cómo cubrir los puntos ciegos de los vehículos de carreras autónomos#
Los vehículos autónomos suelen depender en gran medida de sensores LiDAR, que utilizan pulsos láser para medir distancias y crear una representación 3D de la carretera. Aunque ofrece una gran precisión, LiDAR puede tener problemas con los cambios bruscos de rasante, las pendientes pronunciadas, la oclusión o los cambios repentinos de inclinación del vehículo, y a veces proporciona datos de profundidad escasos o incompletos.
La estimación monocular de profundidad puede ayudar a suplir estas carencias proporcionando información de profundidad densa a partir de una sola imagen RGB, incluso cuando los datos LiDAR están incompletos. Imagina una situación en la que un coche autónomo se aproxima a la cima de una cuesta a gran velocidad. Los haces LiDAR pueden sobrepasar la carretera más allá de la cima, lo que deja dudas sobre lo que hay delante.
Sin embargo, la estimación de profundidad basada en cámaras puede seguir deduciendo la forma de la carretera a partir de pistas visuales como la perspectiva y la textura, lo que ayuda al vehículo a mantener una percepción fiable hasta que los datos LiDAR se estabilizan. En conjunto, LiDAR y la estimación monocular de profundidad permiten una percepción más estable y un control más seguro en condiciones de conducción difíciles.
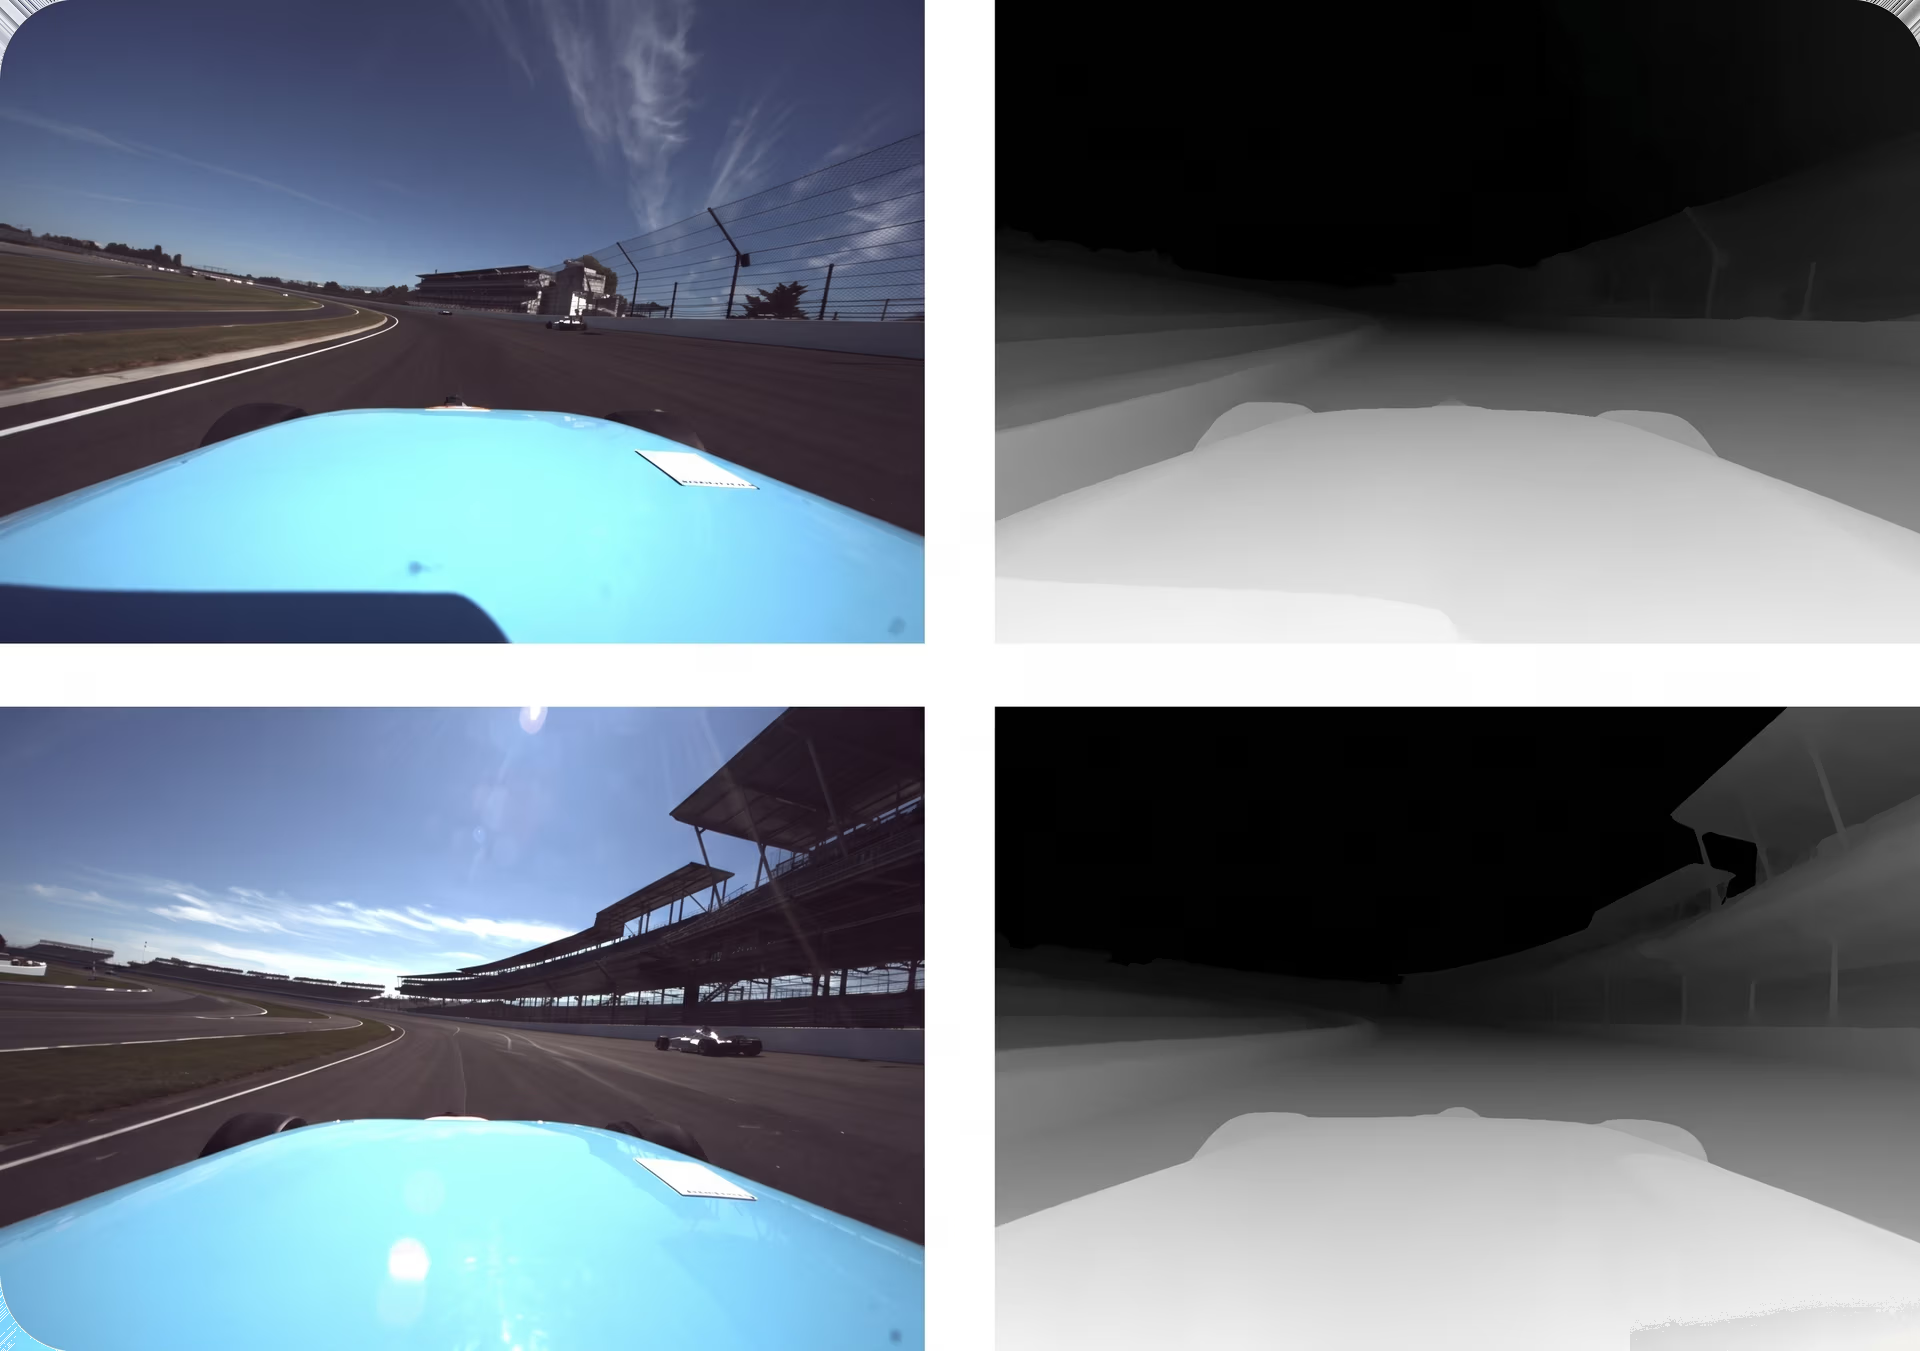
Fig. 3. Visualización del uso de la estimación monocular de profundidad en carreras autónomas (Fuente)
Navegación robótica y evitación de obstáculos#
Los robots suelen funcionar en lugares donde no hay mapas detallados disponibles y las condiciones cambian constantemente. Para desplazarse con seguridad, necesitan saber de forma fiable cuánto espacio tienen alrededor y dónde están los obstáculos.
La estimación monocular de profundidad puede proporcionar esta percepción espacial con una sola cámara RGB, sin depender de hardware pesado o caro. Al aprender pistas visuales como la escala y la perspectiva, los modelos de estimación de profundidad pueden generar mapas de profundidad densos del entorno. Esto ofrece a los robots una visión clara de la distancia a las superficies y los objetos.
En particular, cuando la información de profundidad se combina con tareas de visión artificial como la detección de objetos y la segmentación semántica, los robots pueden obtener una visión más completa de su entorno. Pueden identificar objetos, calcular a qué distancia están y decidir por dónde es seguro desplazarse. Esto facilita la evitación de obstáculos, la detección de espacio libre y la planificación de rutas en tiempo real.
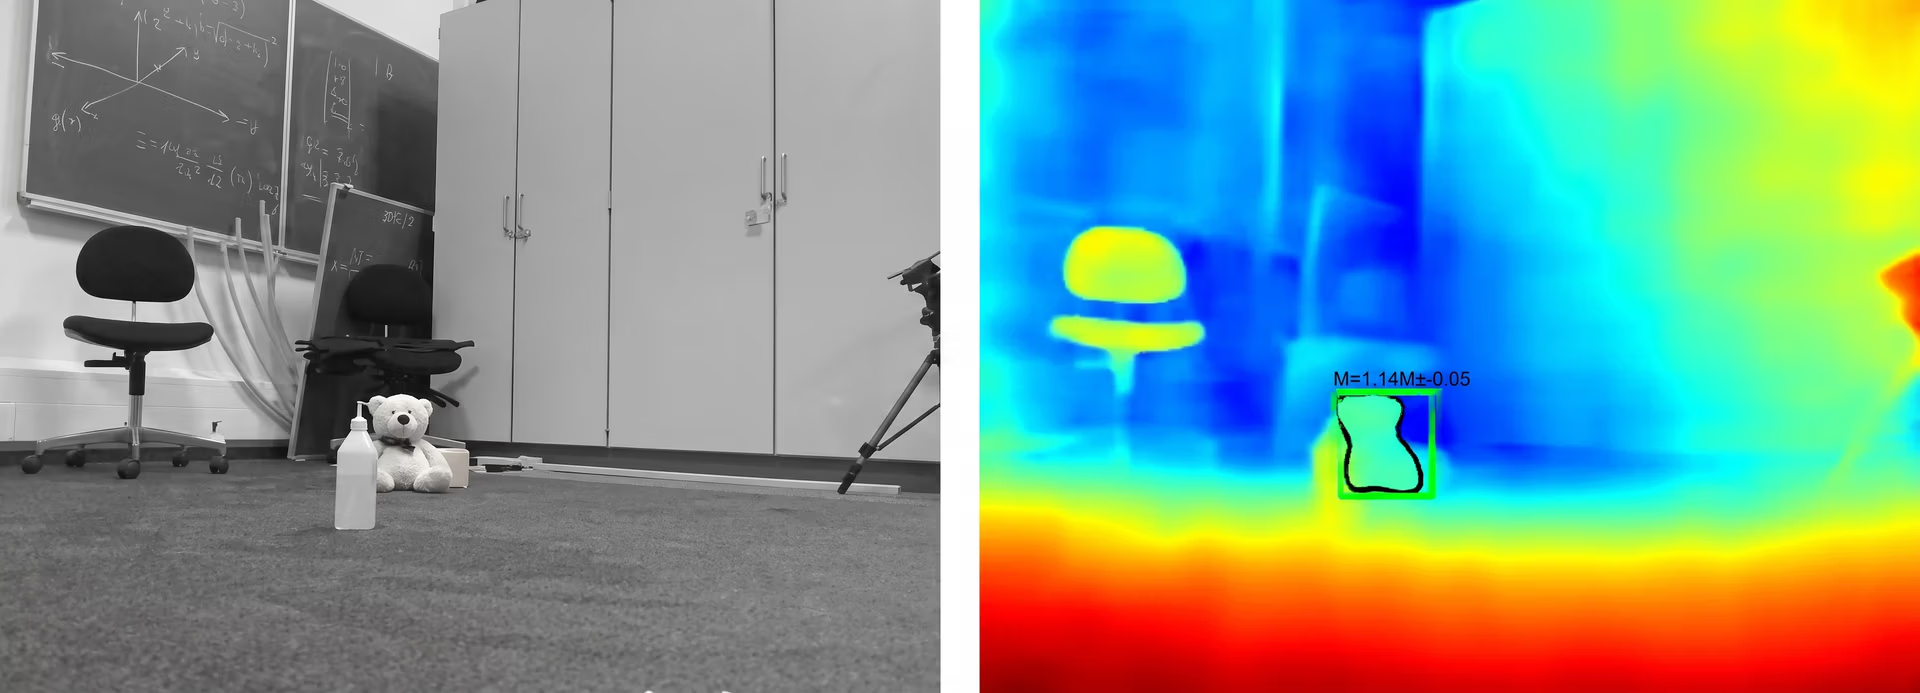
Fig. 4. Detección de objetos mediante estimación monocular de profundidad y detección de objetos (Fuente)
Ventajas e inconvenientes de la estimación monocular de profundidad#
Estas son algunas de las principales ventajas de utilizar la estimación monocular de profundidad:
- Ligera y eficiente energéticamente: El uso de una sola cámara reduce el peso del sistema y el consumo de energía, algo especialmente importante en robots móviles, drones y sistemas integrados.
- Compatible con la fusión de sensores: La profundidad monocular puede complementar otros sensores, como LiDAR o radar, al cubrir lagunas o aportar redundancia.
- Funciona en muchos entornos: El mismo enfoque basado en cámaras puede utilizarse en interiores, exteriores y distintas plataformas sin necesidad de cambiar el hardware.
Aunque la estimación monocular de profundidad ofrece ventajas claras, aquí tienes algunas limitaciones que debes tener en cuenta:
- Menor precisión que los sensores activos: Aunque mejora rápidamente, por lo general la estimación monocular de profundidad no puede igualar la precisión absoluta de LiDAR o de los sensores de luz estructurada en condiciones controladas.
- Sensibilidad a las condiciones de iluminación: El rendimiento puede empeorar con poca luz, sombras intensas, deslumbramientos o escenas con poca textura.
- Dificultades de generalización: Es posible que un modelo entrenado en un entorno no se adapte de forma fiable a dominios desconocidos sin adaptación ni ajuste fino.
Cuándo no confiar en la estimación monocular de profundidad#
Aunque la estimación monocular de profundidad es un área de investigación interesante, es importante entender en qué situaciones se puede utilizar en la práctica y en cuáles no. Las distancias que proporciona son estimaciones basadas en lo que el modelo ve en una imagen, no mediciones exactas del mundo real.
Por eso, la calidad de los resultados puede variar en función de factores como la iluminación, la complejidad de la escena y su parecido con las escenas con las que se entrenó el modelo. La estimación monocular de profundidad suele ser eficaz para determinar qué está más cerca y qué más lejos, pero no es fiable cuando necesitas distancias exactas.
En situaciones en las que la precisión es realmente importante, como los sistemas críticos para la seguridad, la inspección industrial o los robots que deben interactuar con objetos con gran precisión, la profundidad debe medirse directamente. Los sensores como LiDAR, el radar, las cámaras estéreo o los sistemas de luz estructurada están diseñados para ello y proporcionan información sobre las distancias mucho más fiable.
La estimación monocular de profundidad también puede tener dificultades en condiciones visuales complejas. La poca luz, las sombras intensas, las superficies reflectantes o transparentes, la niebla, el humo o las escenas con muy poca textura visual pueden reducir la fiabilidad de las estimaciones de profundidad. La estimación de profundidad a grandes distancias es otro caso en el que los sensores específicos suelen ofrecer mejores resultados.
En aplicaciones reales, la estimación monocular de profundidad funciona mejor como herramienta complementaria que como solución independiente. Puede aportar un contexto espacial útil, ayudar a cubrir lagunas cuando otros sensores tienen limitaciones y mejorar la comprensión general de la escena. Sin embargo, no debería ser la única fuente de información de profundidad cuando son importantes la precisión, la seguridad o unos requisitos estrictos de fiabilidad.
Conclusiones clave#
La estimación monocular de profundidad es una técnica de visión artificial que permite a las máquinas calcular a qué distancia están los objetos utilizando solo la imagen de una cámara. Al aprender pistas visuales como la perspectiva, el tamaño de los objetos, la textura y el sombreado, estos modelos de IA pueden deducir la estructura 3D de una escena sin depender de sensores como LiDAR o las cámaras estéreo. Esto convierte la estimación monocular de profundidad en una opción rentable y escalable para aplicaciones como la conducción autónoma, la robótica y la comprensión de escenas 3D.
Para descubrir más sobre la IA visual, visita nuestro repositorio de GitHub y únete a nuestra comunidad. Echa un vistazo a nuestras páginas de soluciones para saber más sobre la IA en robótica y la visión artificial en la fabricación. Descubre nuestras opciones de licencia y empieza hoy mismo con la visión artificial.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









