Che cos’è l’overfitting nella computer vision e come si previene?
Scopri cos'è l'overfitting nella visione artificiale, come riconoscerlo e come prevenirlo con l'aumento dei dati, la regolarizzazione, l'arresto anticipato e i modelli preaddestrati.
 Abdelrahman Elgendy9 min di lettura
I modelli di visione artificiale sono progettati per riconoscere schemi, rilevare oggetti e analizzare immagini. Le loro prestazioni, tuttavia, dipendono dalla capacità di generalizzare a dati mai visti. La generalizzazione è la capacità del modello di funzionare bene con nuove immagini, non soltanto con quelle usate per addestrarlo. Un problema comune nell'addestramento di questi modelli è l'overfitting, in cui il modello apprende troppo dai dati di addestramento, compreso il rumore non necessario, invece di individuare schemi significativi.
Quando accade, il modello funziona bene sui dati di addestramento, ma incontra difficoltà con nuove immagini. Ad esempio, un modello di rilevamento degli oggetti addestrato solo con immagini ad alta risoluzione e ben illuminate potrebbe non funzionare quando si trova di fronte a immagini sfocate o in ombra, in condizioni reali. L'overfitting limita l'adattabilità del modello e, di conseguenza, il suo impiego in applicazioni reali come la guida autonoma, l'imaging medico e i sistemi di sicurezza.
In questo articolo vedremo che cos'è l'overfitting, perché si verifica e come prevenirlo. Vedremo anche come i modelli di visione artificiale come Ultralytics YOLO11 aiutano a ridurre l'overfitting e a migliorare la generalizzazione.
Che cos'è l'overfitting?#
L'overfitting si verifica quando un modello memorizza i dati di addestramento invece di apprendere schemi applicabili a nuovi input in modo più generale. Il modello si concentra troppo sui dati di addestramento e fatica quindi ad affrontare immagini o situazioni nuove che non ha mai visto.
Nella visione artificiale, l'overfitting può influire su diverse attività. Un modello di classificazione addestrato solo con immagini luminose e nitide potrebbe incontrare difficoltà in condizioni di scarsa illuminazione. Un modello di rilevamento degli oggetti che apprende da immagini perfette potrebbe non funzionare in scene affollate o disordinate. Allo stesso modo, un modello di segmentazione delle istanze potrebbe funzionare bene in ambienti controllati, ma avere difficoltà con le ombre o gli oggetti sovrapposti.
Questo è un problema nelle applicazioni di IA del mondo reale, in cui i modelli devono generalizzare oltre le condizioni controllate di addestramento. Le auto a guida autonoma, ad esempio, devono essere in grado di rilevare i pedoni con illuminazione, condizioni meteorologiche e ambienti diversi. Un modello che va in overfitting sul proprio set di addestramento non funzionerà in modo affidabile in scenari così imprevedibili.
Quando e perché si verifica l'overfitting?#
L'overfitting si verifica in genere a causa di dataset sbilanciati, eccessiva complessità del modello e addestramento prolungato. Ecco le cause principali:
- Dati di addestramento limitati: dataset di piccole dimensioni spingono i modelli a memorizzare gli schemi anziché a generalizzarli. Un modello addestrato con sole 50 immagini di uccelli potrebbe avere difficoltà a rilevare specie di uccelli assenti dal dataset.
- Modelli complessi con troppi parametri: le reti profonde con un numero eccessivo di livelli e neuroni tendono a memorizzare i dettagli più fini, anziché concentrarsi sulle caratteristiche essenziali.
- Mancanza di aumento dei dati: senza trasformazioni come ritaglio, riflessione o rotazione, un modello potrebbe apprendere solo dalle immagini esatte usate per l'addestramento.
- Addestramento prolungato: se un modello esamina i dati di addestramento troppe volte, ovvero per un numero eccessivo di epoche, memorizza i dettagli invece di apprendere schemi generali, diventando meno adattabile.
- Etichette incoerenti o rumorose: i dati etichettati in modo errato inducono il modello ad apprendere schemi sbagliati. È un problema comune nei dataset etichettati manualmente.
Un approccio equilibrato alla complessità del modello, alla qualità del dataset e alle tecniche di addestramento garantisce una migliore generalizzazione.
Overfitting e underfitting a confronto#
L'overfitting e l'underfitting sono due problemi opposti nel deep learning.
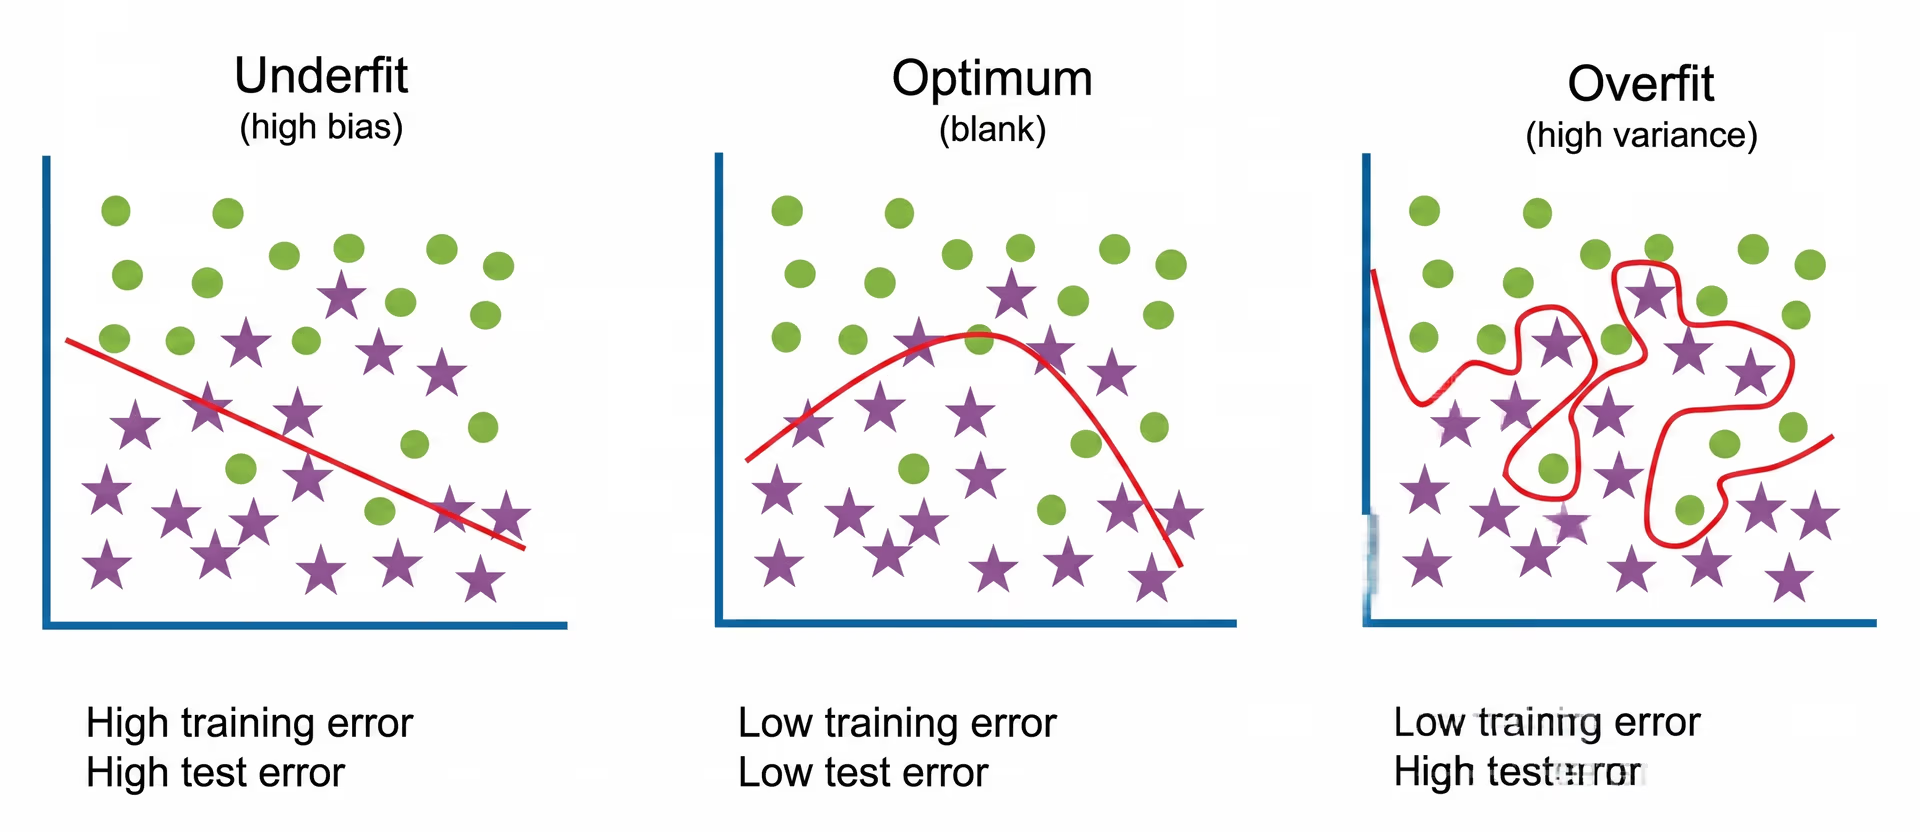
Fig. 1 Confronto tra underfitting, apprendimento ottimale e overfitting nei modelli di visione artificiale.
L'overfitting si verifica quando un modello è troppo complesso e si concentra eccessivamente sui dati di addestramento. Invece di apprendere schemi generali, memorizza piccoli dettagli, anche irrilevanti come il rumore di fondo. Di conseguenza, il modello funziona bene sui dati di addestramento, ma fatica con le nuove immagini: significa che non ha davvero imparato a riconoscere gli schemi applicabili a situazioni diverse.
L'underfitting si verifica quando un modello è troppo semplice e non coglie schemi importanti nei dati. Può accadere se il modello ha troppo pochi livelli, non viene addestrato abbastanza a lungo o dispone di dati limitati. Di conseguenza, non riesce a riconoscere gli schemi importanti e produce previsioni imprecise. Le prestazioni sono scarse sia sui dati di addestramento sia su quelli di test, perché il modello non ha appreso abbastanza per comprendere correttamente l'attività.
Un modello ben addestrato trova il giusto equilibrio tra complessità e generalizzazione. Deve essere abbastanza complesso da apprendere gli schemi rilevanti, ma non così complesso da memorizzare i dati invece di riconoscere le relazioni sottostanti.
Come individuare l'overfitting#
Ecco alcuni segnali che indicano che un modello è in overfitting:
- Se la precisione sui dati di addestramento è nettamente superiore a quella sui dati di convalida, è probabile che il modello stia andando in overfitting.
- Un divario crescente tra la perdita sui dati di addestramento e quella sui dati di convalida è un altro chiaro indicatore.
- Il modello è troppo sicuro delle risposte sbagliate, segno che ha memorizzato i dettagli invece di comprendere gli schemi.
Per assicurarsi che un modello generalizzi bene, è necessario testarlo su dataset diversificati che rispecchino le condizioni del mondo reale.
Come prevenire l'overfitting nella visione artificiale#
L'overfitting non è inevitabile e si può prevenire. Con le tecniche giuste, i modelli di visione artificiale possono apprendere schemi generali invece di memorizzare i dati di addestramento, diventando più affidabili nelle applicazioni reali.
Ecco cinque strategie chiave per prevenire l'overfitting nella visione artificiale.
Aumenta la varietà dei dati con l’aumento dei dati e i dati sintetici#
Il modo migliore per aiutare un modello a funzionare bene su nuovi dati è ampliare il dataset usando l’aumento dei dati e i dati sintetici. I dati sintetici sono generati al computer anziché raccolti da immagini del mondo reale. Aiutano a colmare le lacune quando non ci sono abbastanza dati reali.
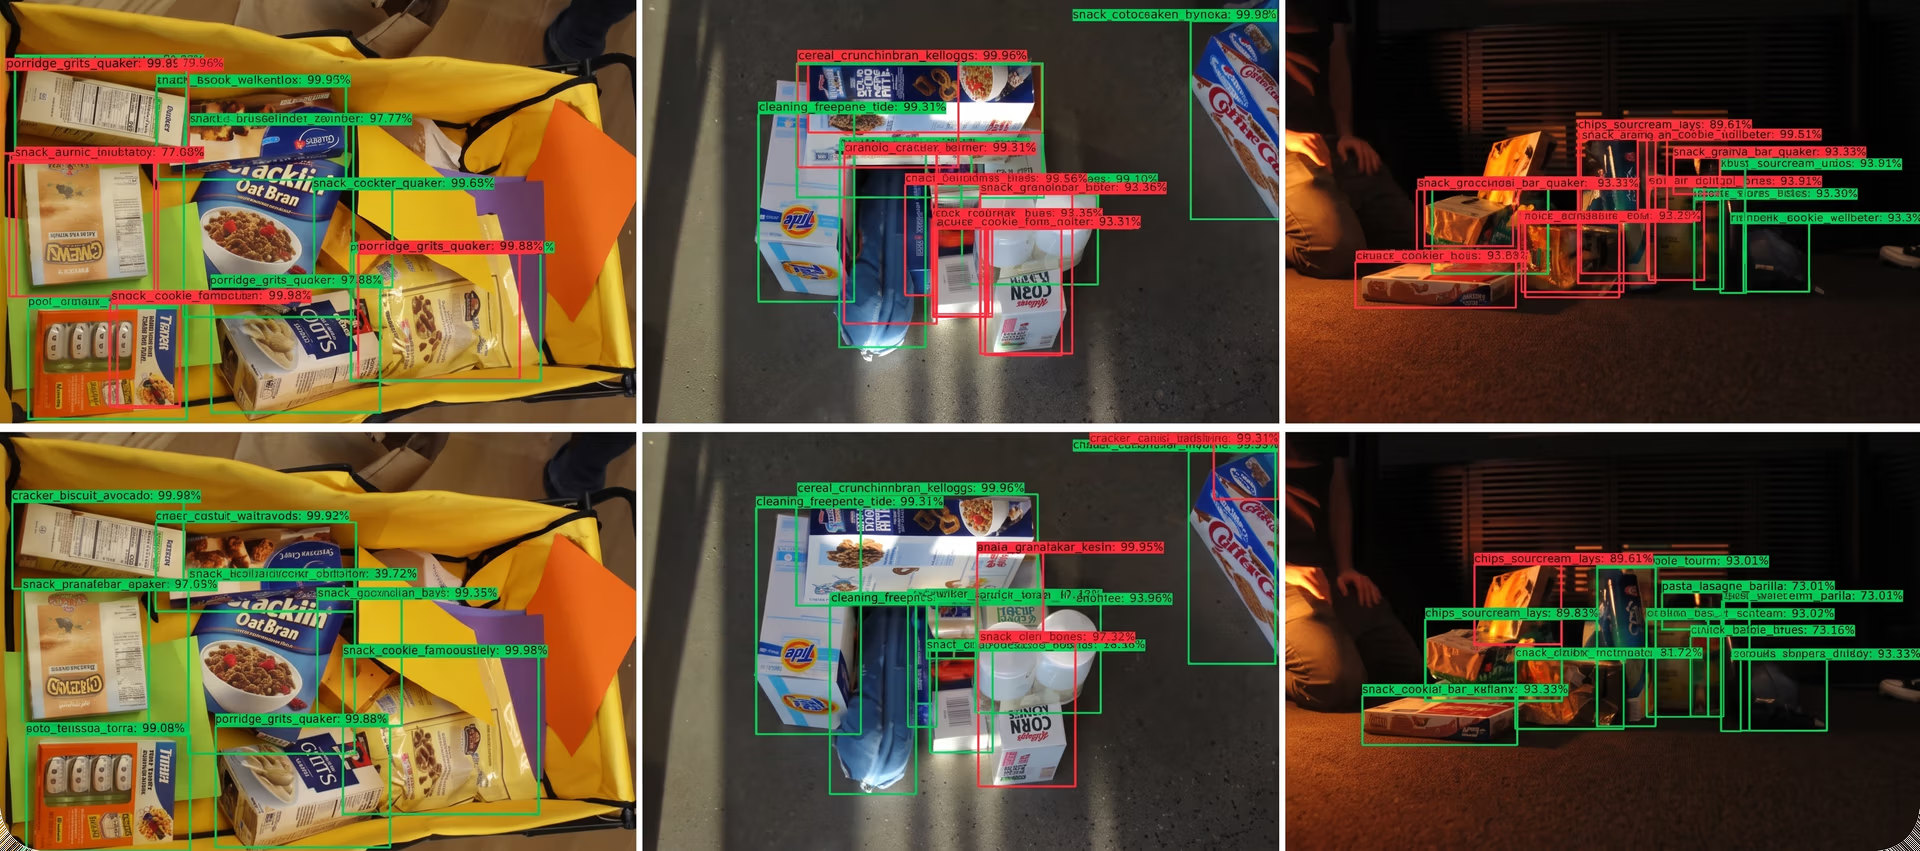
Fig. 2 Combinare dati del mondo reale e dati sintetici riduce l’overfitting e migliora la precisione del rilevamento degli oggetti.
L'aumento dei dati modifica leggermente le immagini esistenti capovolgendole, ruotandole, ritagliandole o regolando la luminosità, così il modello non si limita a memorizzare i dettagli, ma impara a riconoscere gli oggetti in situazioni diverse.
I dati sintetici sono utili quando è difficile ottenere immagini reali. Ad esempio, i modelli per auto a guida autonoma possono essere addestrati su scene stradali generate al computer per imparare a rilevare oggetti in diverse condizioni meteorologiche e di illuminazione. Questo rende il modello più flessibile e affidabile senza richiedere migliaia di immagini del mondo reale.
Ottimizza la complessità e l’architettura del modello#
Una rete neurale profonda, ovvero un tipo di modello di machine learning con molti livelli che elaborano i dati anziché un singolo livello, non è sempre migliore. Quando un modello ha troppi livelli o parametri, memorizza i dati di addestramento invece di riconoscere schemi più generali. Ridurre la complessità non necessaria può aiutare a prevenire l’overfitting.
Per ottenere questo risultato, un approccio consiste nel pruning, che rimuove neuroni e connessioni ridondanti, rendendo il modello più snello ed efficiente.
Un altro approccio consiste nel semplificare l’architettura riducendo il numero di livelli o neuroni. I modelli preaddestrati come Ultralytics YOLO11 sono progettati per generalizzare bene su diverse attività con un numero inferiore di parametri, risultando più resistenti all’overfitting rispetto all’addestramento di un modello profondo da zero.
Trovare il giusto equilibrio tra profondità ed efficienza del modello lo aiuta ad apprendere schemi utili senza limitarsi a memorizzare i dati di addestramento.
Applica tecniche di regolarizzazione#
Le tecniche di regolarizzazione impediscono ai modelli di dipendere eccessivamente da caratteristiche specifiche dei dati di addestramento. Ecco alcune tecniche di uso comune:
- Dropout disattiva parti casuali del modello durante l’addestramento, così impara a riconoscere schemi diversi anziché affidarsi troppo a poche caratteristiche.
- Decadimento dei pesi (regolarizzazione L2) scoraggia valori estremi dei pesi, mantenendo sotto controllo la complessità del modello.
- Normalizzazione dei batch aiuta a stabilizzare l’addestramento assicurando che il modello sia meno sensibile alle variazioni del dataset.
Queste tecniche aiutano a mantenere la flessibilità e l’adattabilità del modello, riducendo il rischio di overfitting senza compromettere la precisione.
Monitora l’addestramento con la convalida e l’arresto anticipato#
Per prevenire l’overfitting, è importante monitorare come apprende il modello e assicurarsi che generalizzi bene a nuovi dati. Ecco un paio di tecniche utili:
- Arresto anticipato: interrompe automaticamente l'addestramento quando le prestazioni di convalida smettono di migliorare, evitando che il modello continui ad apprendere dettagli non necessari.
- Convalida incrociata: suddivide i dati in più fold, quindi addestra ripetutamente il modello su tutti i fold tranne uno e lo convalida sul fold escluso. In questo modo si ottiene un quadro più affidabile della capacità del modello di generalizzare oltre le immagini specifiche.
Queste tecniche aiutano a mantenere il modello equilibrato, così apprende abbastanza da essere preciso senza concentrarsi troppo sui soli dati di addestramento.
Usa modelli preaddestrati e migliora l’etichettatura del dataset#
Anziché addestrare un modello da zero, usare modelli preaddestrati come Ultralytics YOLO11 può ridurre l’overfitting. YOLO11 è addestrato su dataset su larga scala, il che gli permette di generalizzare bene in condizioni diverse.
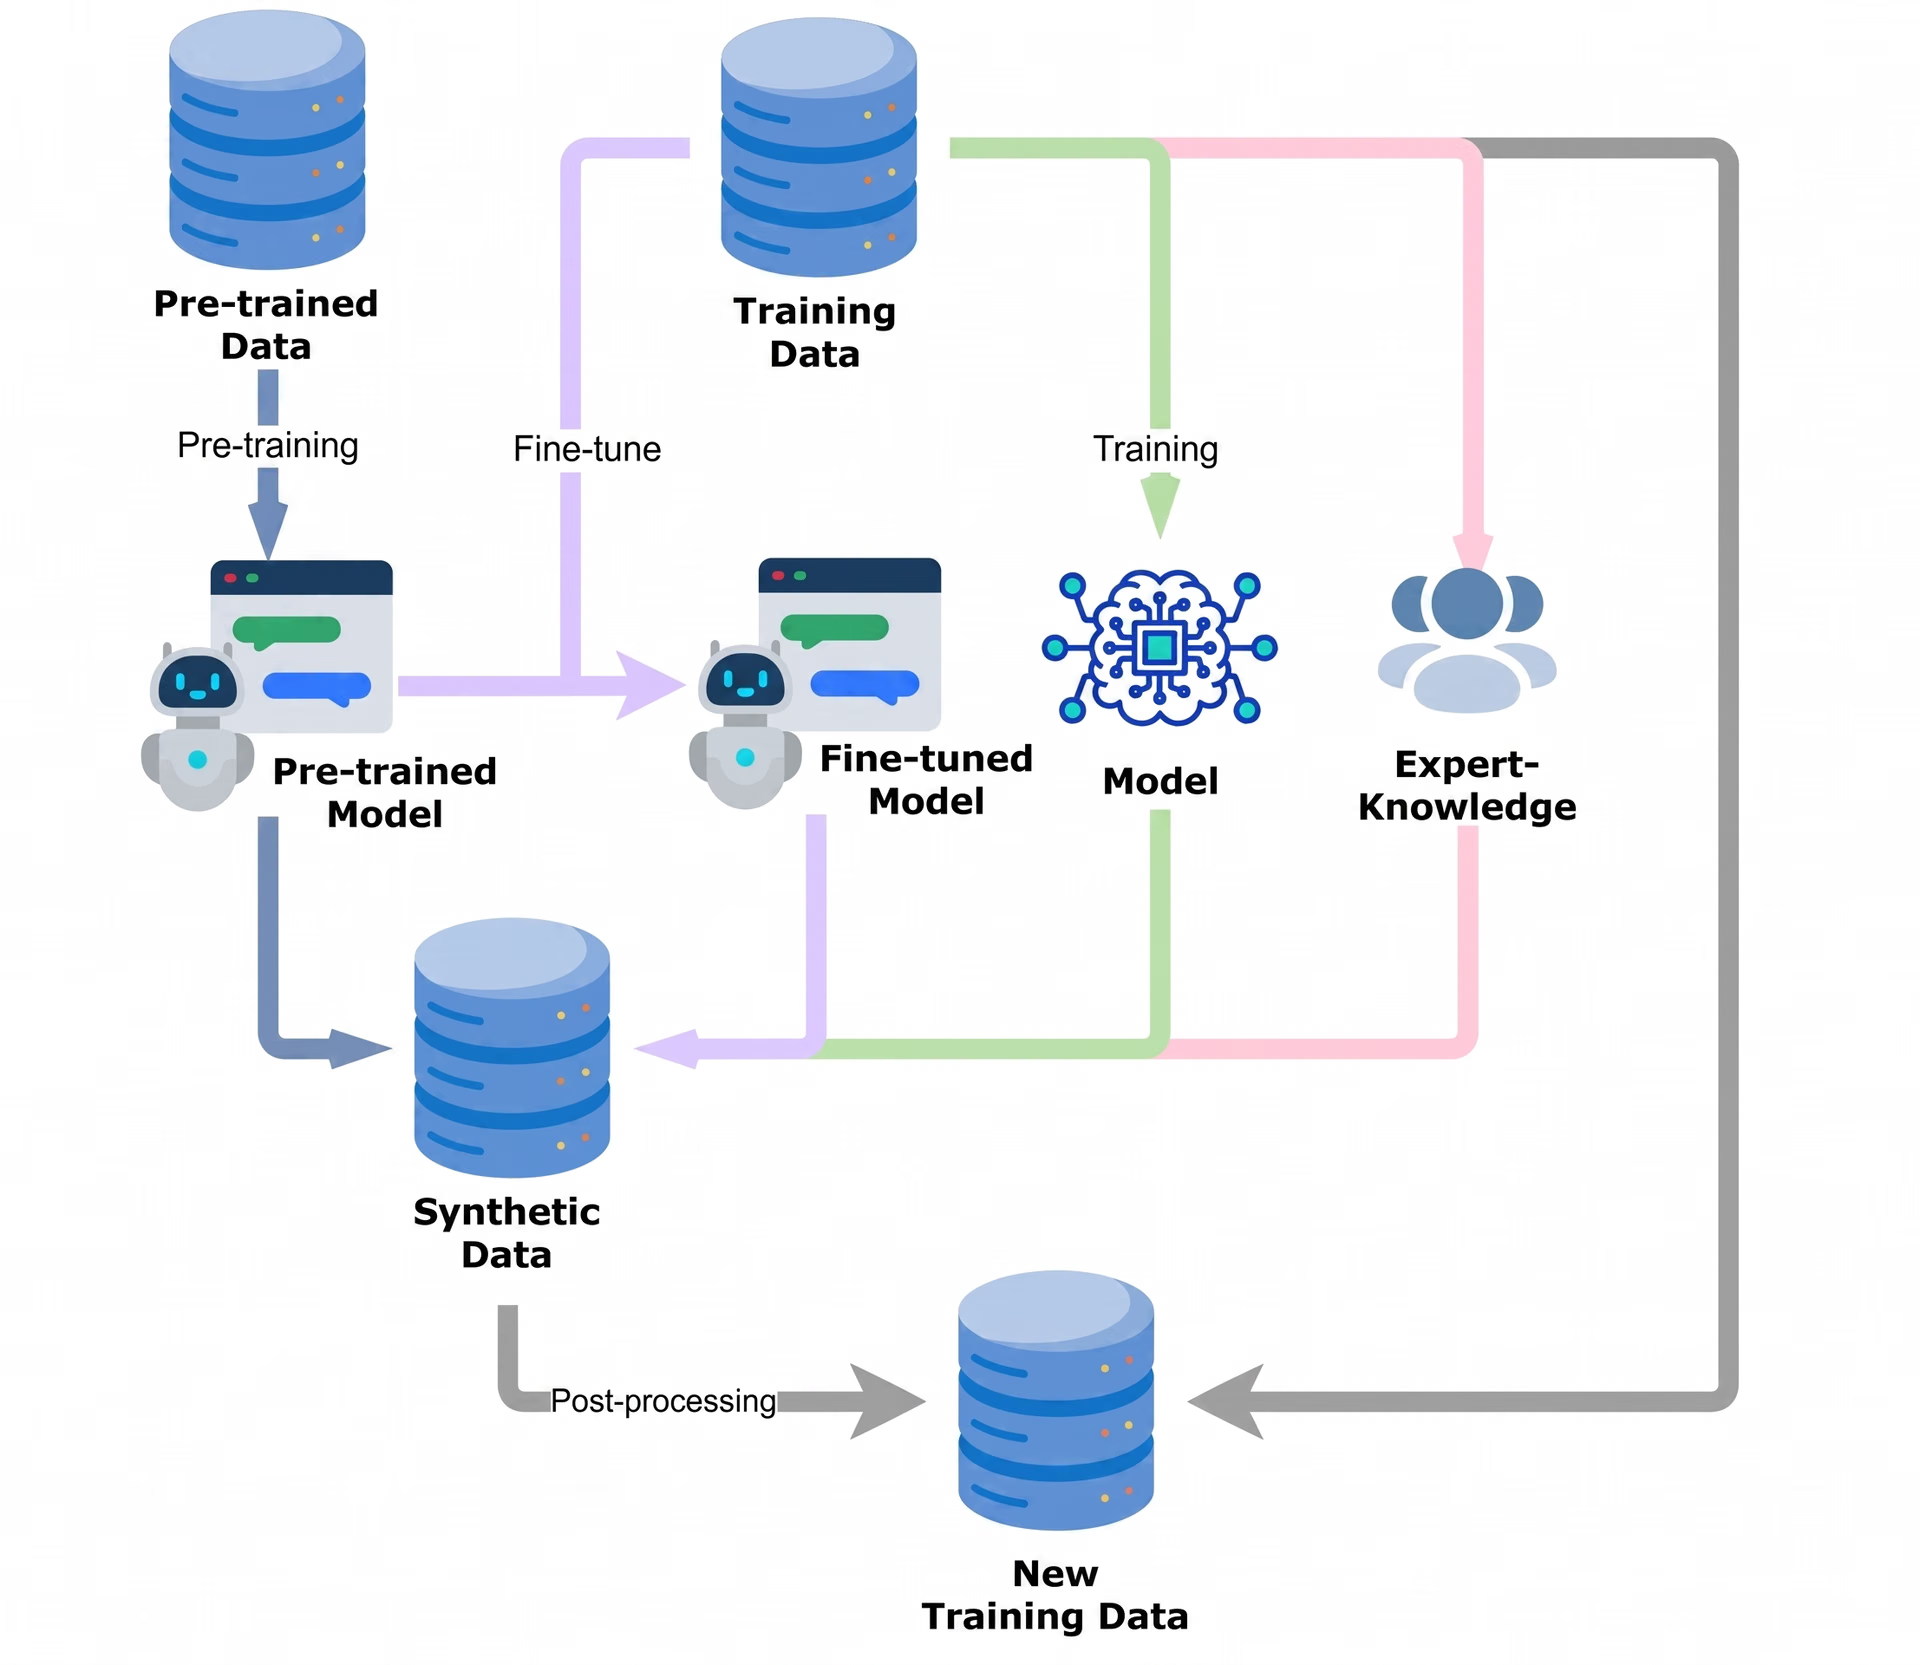
Fig. 3 I modelli di visione artificiale preaddestrati migliorano la precisione e prevengono l’overfitting.
Il fine-tuning di un modello preaddestrato lo aiuta a conservare ciò che già conosce mentre apprende nuove attività, così non si limita a memorizzare i dati di addestramento.
Inoltre, è essenziale garantire un’etichettatura di alta qualità del dataset. Dati etichettati in modo errato o sbilanciati possono indurre i modelli ad apprendere schemi scorretti. Pulire i dataset, correggere le immagini etichettate in modo errato e bilanciare le classi migliora la precisione e riduce il rischio di overfitting. Un altro approccio efficace è l’addestramento avversario, in cui il modello viene esposto a esempi leggermente alterati o più impegnativi, progettati per metterne alla prova i limiti.
Punti chiave#
L’overfitting è un problema comune nella visione artificiale. Un modello potrebbe funzionare bene sui dati di addestramento, ma avere difficoltà con le immagini del mondo reale. Per evitarlo, tecniche come l’aumento dei dati, la regolarizzazione e l’uso di modelli preaddestrati come Ultralytics YOLO11 aiutano a migliorare la precisione e l’adattabilità.
Applicando questi metodi, i modelli di IA possono rimanere affidabili e funzionare bene in ambienti diversi. Con il progresso del deep learning, assicurarsi che i modelli generalizzino correttamente sarà fondamentale per il successo dell’IA nel mondo reale.
Unisciti alla nostra community in continua crescita! Esplora il nostro repository GitHub per saperne di più sull’IA. Vuoi avviare i tuoi progetti di visione artificiale? Scopri le nostre opzioni di licenza. Scopri la Vision AI per la guida autonoma e l’IA in ambito sanitario visitando le pagine dedicate alle nostre soluzioni!
Scritto da
Autore · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









