La guida definitiva all'aumento dei dati nel 2025
Scopri come l'aumento dei dati delle immagini aiuta i modelli di Vision AI ad apprendere meglio, migliorare la precisione e ottenere prestazioni più efficaci nel mondo reale.
Con il boom dell’IA, fenomeni come i robot che lavorano nelle fabbriche e le auto a guida autonoma che percorrono le strade conquistano sempre più spesso le prime pagine. L’IA sta cambiando il modo in cui le macchine interagiscono con il mondo, dal miglioramento delle immagini mediche al supporto del controllo qualità sulle linee di produzione.
Gran parte di questi progressi è dovuta alla visione artificiale, un ramo dell’IA che permette alle macchine di comprendere e interpretare le immagini. Proprio come gli esseri umani imparano a riconoscere oggetti e schemi nel tempo, i modelli di Vision AI come Ultralytics YOLO11 devono essere addestrati su grandi quantità di dati visivi per sviluppare la propria capacità di comprensione delle immagini.
Tuttavia, raccogliere una quantità così vasta di dati visivi non è sempre facile. Anche se la community della visione artificiale ha creato molti grandi dataset, alcuni potrebbero non includere determinate variazioni, per esempio immagini con oggetti in condizioni di scarsa illuminazione, elementi parzialmente nascosti o ripresi da angolazioni diverse. Queste differenze possono confondere i modelli di visione artificiale addestrati solo in condizioni specifiche.
L’aumento dei dati delle immagini è una tecnica che risolve questo problema introducendo nuove variazioni nei dati esistenti. Modificando le immagini, per esempio regolando i colori, ruotandole o cambiando la prospettiva, il dataset diventa più vario e i modelli di Vision AI imparano a riconoscere meglio gli oggetti nelle situazioni reali.
In questo articolo vedremo come funziona l’aumento dei dati delle immagini e quale impatto può avere sulle applicazioni di visione artificiale.
Che cos’è l’aumento dei dati delle immagini?#
Immagina di dover riconoscere un amico in mezzo alla folla, ma che indossi degli occhiali da sole o si trovi in un punto ombreggiato. Anche con queste piccole differenze nell’aspetto, sai comunque chi è. Un modello di Vision AI, invece, potrebbe avere difficoltà con variazioni simili, a meno che non sia stato addestrato a riconoscere gli oggetti in contesti diversi.
L’aumento dei dati delle immagini migliora le prestazioni dei modelli di visione artificiale aggiungendo ai dati di addestramento versioni modificate delle immagini esistenti, invece di raccogliere migliaia di nuove immagini.
Modifiche alle immagini come il capovolgimento, la rotazione, la regolazione della luminosità o l’aggiunta di piccole distorsioni espongono i modelli di Vision AI a una gamma più ampia di condizioni. Invece di affidarsi a dataset enormi, i modelli possono apprendere in modo efficiente da dataset di addestramento più piccoli con immagini aumentate.
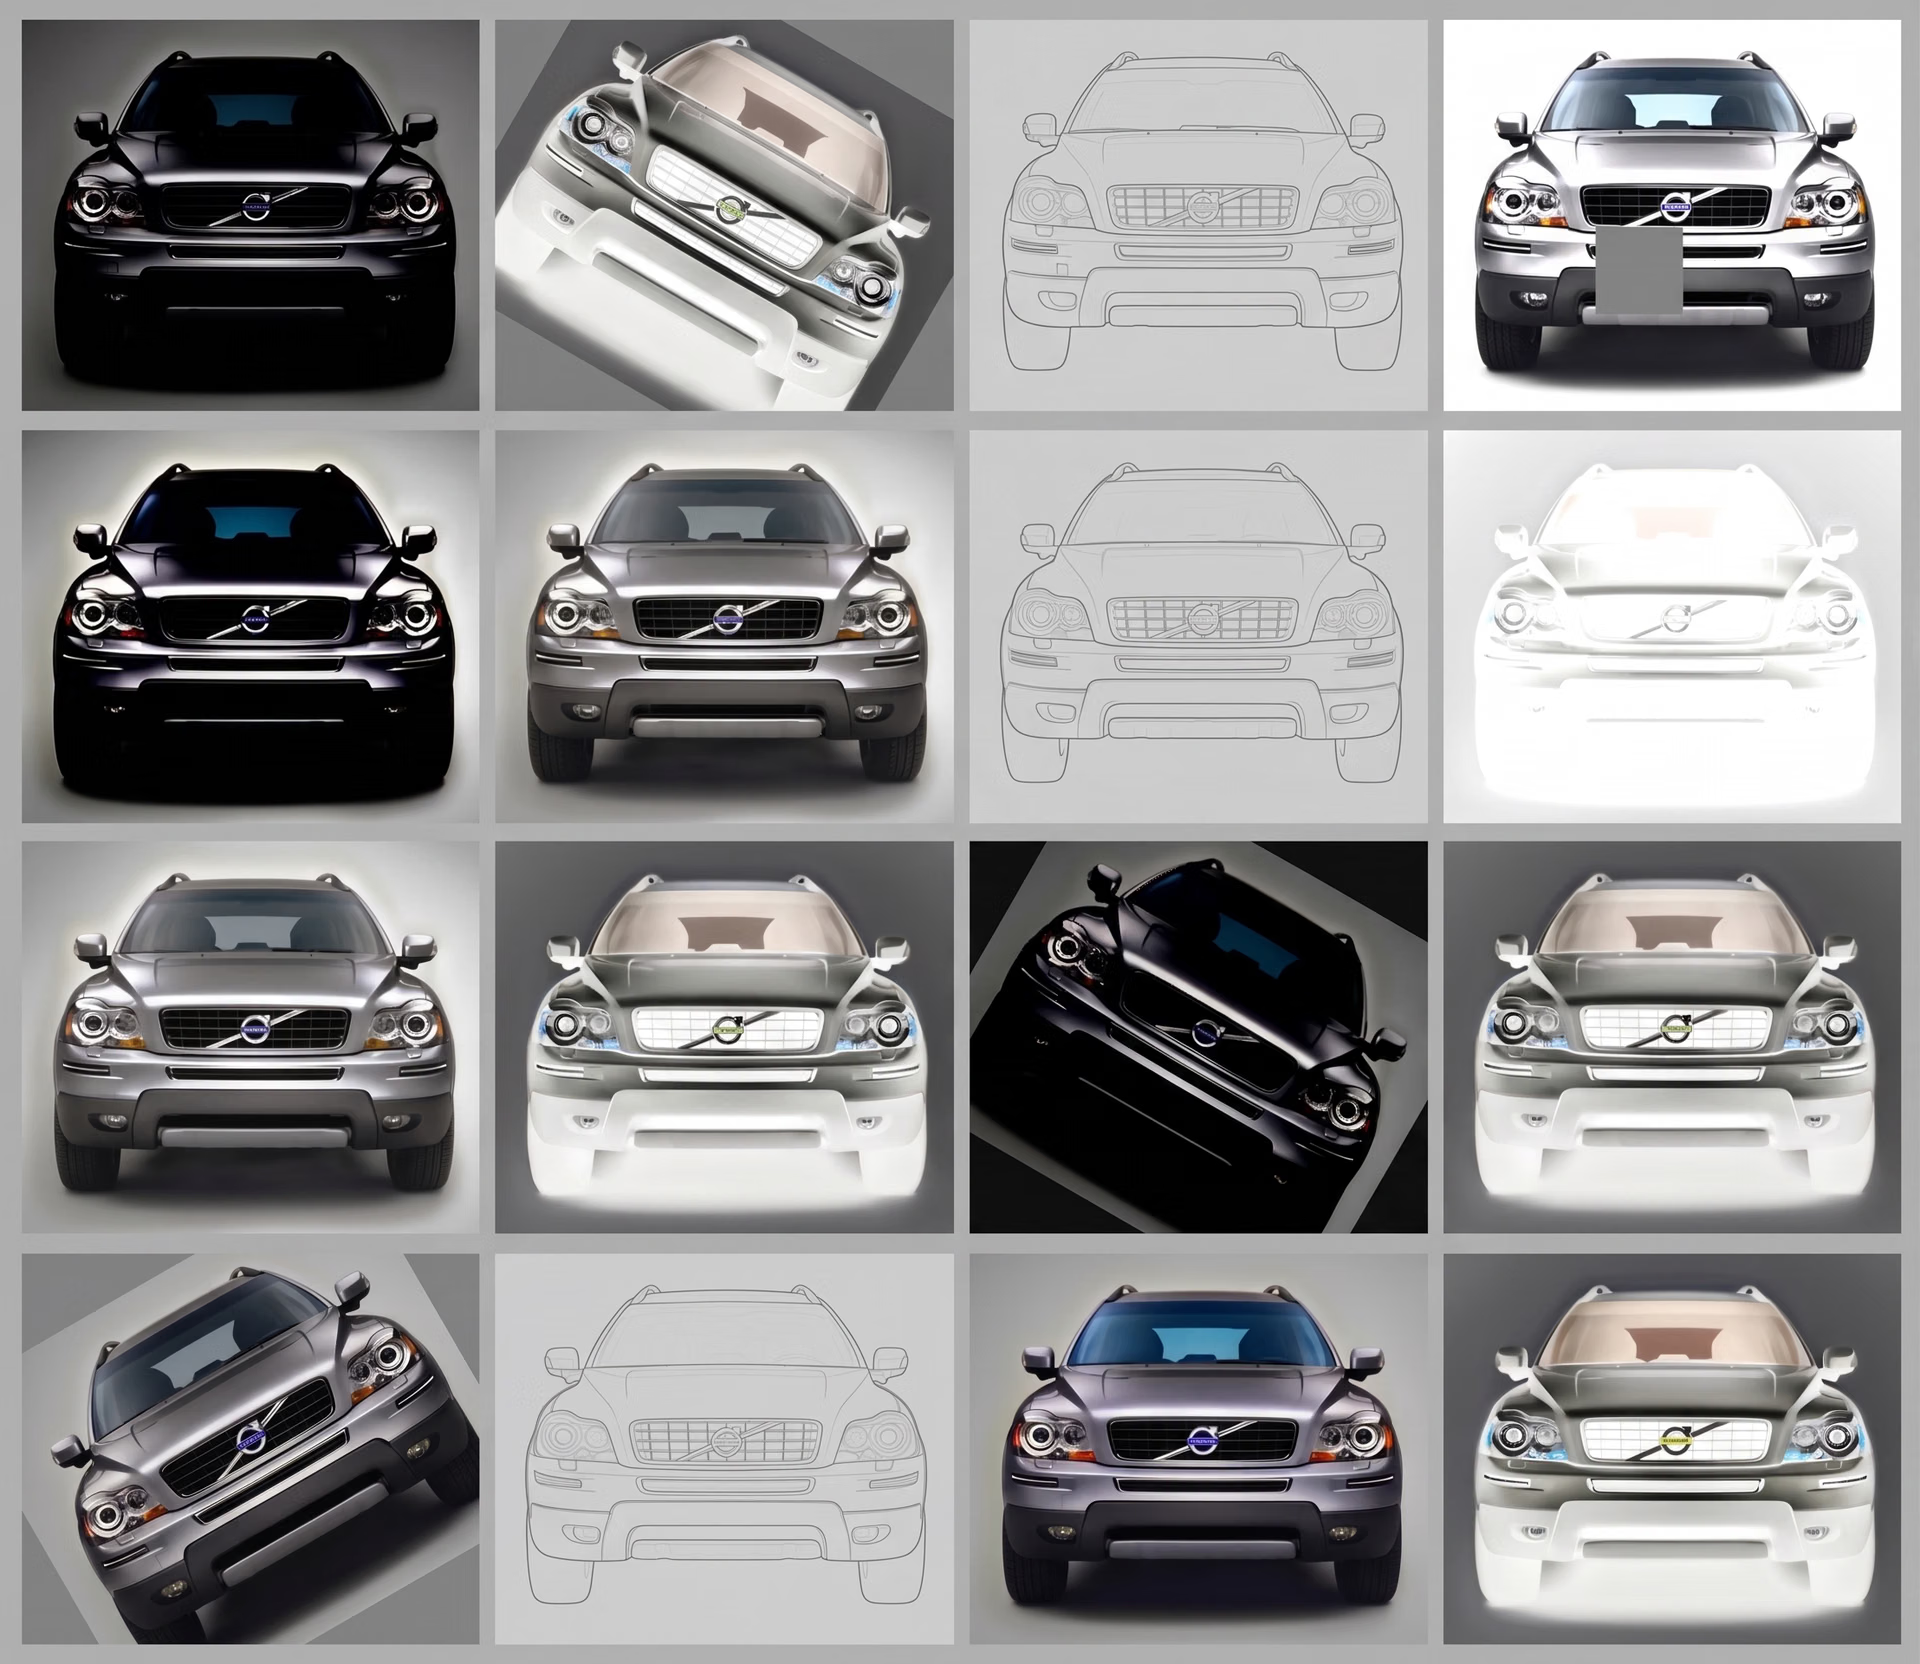
Fig. 1. Esempi di immagini di un’auto aumentate.
L’importanza dell’aumento dei dati nella visione artificiale#
Ecco alcuni dei motivi principali per cui l’aumento dei dati è essenziale per la visione artificiale:
- Riduce la quantità di dati necessaria: raccogliere grandi dataset di immagini richiede tempo e risorse. L’aumento dei dati permette di addestrare i modelli in modo efficace senza dover disporre di dataset enormi.
- Previene l’overfitting: un modello addestrato su pochi esempi può memorizzare i dettagli invece di riconoscere schemi generali. Aggiungere varietà con l’aumento dei dati fa sì che i modelli di Vision AI imparino in modo da poter applicare quanto appreso a dati nuovi e mai visti.
- Riproduce le imperfezioni delle immagini: le immagini nei dataset sono spesso troppo perfette, mentre le foto del mondo reale possono essere sfocate, oscurate o distorte. Aumentare le immagini con rumore, occlusioni o altre variazioni le rende più realistiche.
- Migliora la robustezza del modello: l’addestramento con immagini varie aiuta l’IA a gestire i cambiamenti del mondo reale, rendendola più affidabile in ambienti, condizioni di illuminazione e situazioni diversi.
Quando dovresti usare l’aumento dei dati delle immagini?#
L’aumento dei dati delle immagini è particolarmente utile quando un modello di visione artificiale deve riconoscere oggetti in situazioni diverse, ma non dispone di un numero sufficiente di immagini varie.
Per esempio, se i ricercatori stanno addestrando un modello di Vision AI per identificare specie sottomarine rare, fotografate di rado, il dataset potrebbe essere piccolo o poco vario. Aumentando le immagini, per esempio regolando i colori per simulare diverse profondità dell’acqua, aggiungendo rumore per riprodurre condizioni torbide o modificando leggermente le forme per tenere conto dei movimenti naturali, il modello può rilevare gli oggetti sottomarini con maggiore precisione.
Ecco altre situazioni in cui l’aumento dei dati può fare una grande differenza:
- Bilanciamento del dataset: alcuni oggetti potrebbero comparire meno spesso nei dati di addestramento, introducendo distorsioni nei modelli di Vision AI. L’aumento dei dati aiuta a creare più esempi di oggetti rari, affinché il modello possa riconoscere tutte le categorie in modo equo.
- Adattamento a fotocamere diverse: l’aspetto delle immagini può variare a seconda del dispositivo. L’aumento dei dati aiuta i modelli di Vision AI a funzionare bene con foto di risoluzione, illuminazione e qualità diverse.
- Correzione di piccoli errori di etichettatura: piccoli spostamenti, ritagli o rotazioni aiutano i modelli di visione artificiale a riconoscere correttamente gli oggetti, anche se le etichette originali non sono perfettamente allineate.
Come funziona l’aumento dei dati delle immagini#
Agli albori della visione artificiale, l’aumento dei dati delle immagini consisteva principalmente in tecniche di elaborazione delle immagini di base, come capovolgimento, rotazione e ritaglio, per aumentare la varietà del dataset. Con il miglioramento dell’IA sono stati introdotti metodi più avanzati, come la regolazione dei colori (trasformazioni dello spazio colore), l’aumento della nitidezza o la sfocatura delle immagini (filtri kernel) e la fusione di più immagini (image mixing) per migliorare l’apprendimento.
L’aumento dei dati può avvenire prima e durante l’addestramento del modello. Prima dell’addestramento, si possono aggiungere immagini modificate al dataset per renderlo più vario. Durante l’addestramento, le immagini possono essere modificate casualmente in tempo reale, aiutando i modelli di Vision AI ad adattarsi a condizioni diverse.
Queste modifiche si ottengono usando trasformazioni matematiche. Per esempio, la rotazione inclina un’immagine, il ritaglio ne rimuove alcune parti per simulare punti di vista diversi e le variazioni di luminosità simulano cambiamenti nell’illuminazione. La sfocatura ammorbidisce le immagini, l’aumento della nitidezza rende più chiari i dettagli e la fusione delle immagini combina parti di immagini diverse. I framework di Vision AI e strumenti come OpenCV, TensorFlow e PyTorch possono automatizzare questi processi, rendendo l’aumento dei dati rapido ed efficace.
Tecniche fondamentali di aumento dei dati delle immagini#
Ora che abbiamo visto che cos’è l’aumento dei dati delle immagini, esaminiamo più da vicino alcune tecniche fondamentali usate per arricchire i dati di addestramento.
Regolazione dell’orientamento e della posizione#
I modelli di visione artificiale come YOLO11 devono spesso riconoscere gli oggetti da angolazioni e punti di vista diversi. Per aiutarli, le immagini possono essere capovolte orizzontalmente o verticalmente, così che il modello di IA impari a riconoscere gli oggetti da prospettive diverse.
Allo stesso modo, ruotare leggermente le immagini ne modifica l’angolazione, permettendo al modello di identificare gli oggetti da più prospettive. Anche spostare le immagini in direzioni diverse (traslazione) aiuta i modelli ad adattarsi a piccoli cambiamenti di posizione. Queste trasformazioni consentono ai modelli di generalizzare meglio alle condizioni del mondo reale, in cui la posizione degli oggetti nell’immagine è imprevedibile.
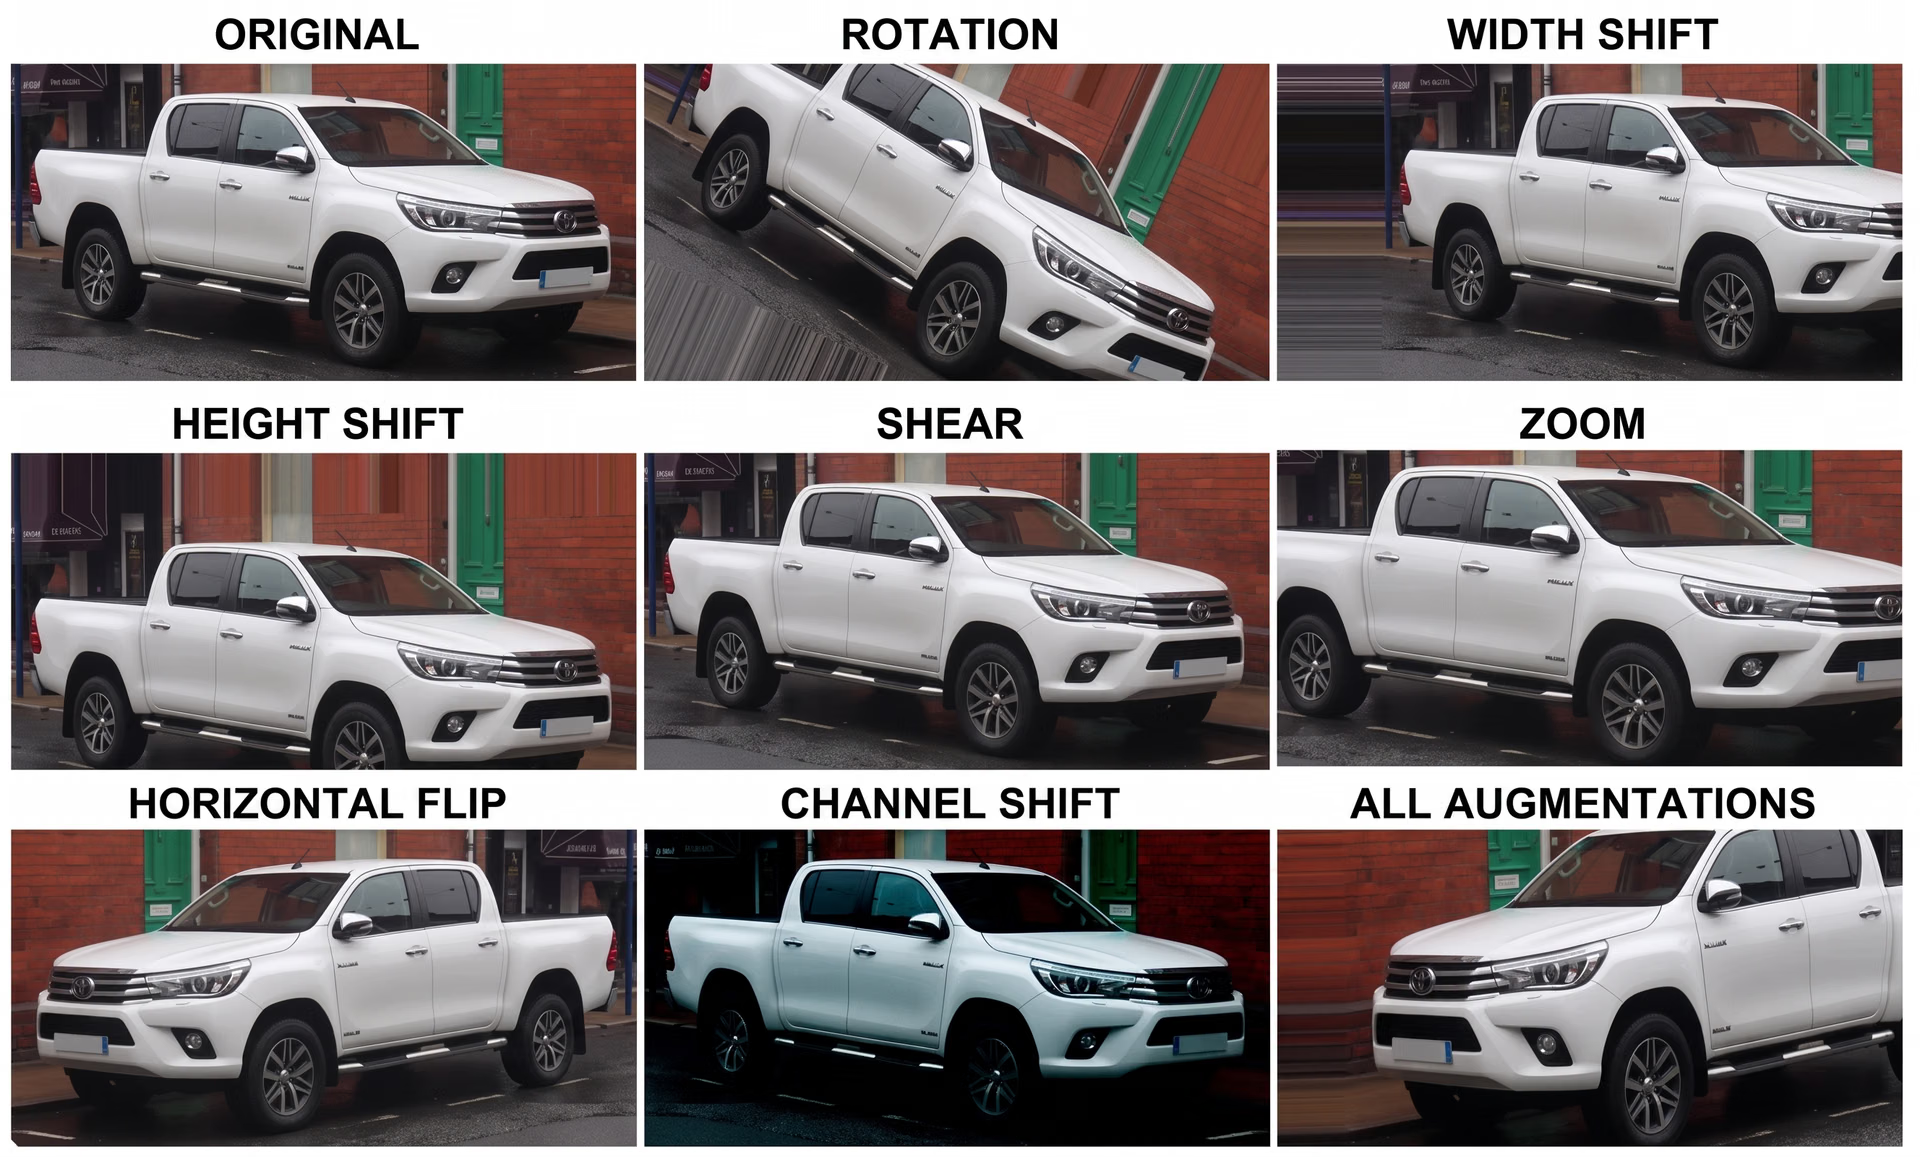
Fig. 2. Diversi metodi di aumento relativi all’orientamento e alla posizione.
Ridimensionamento e ritaglio#
Per quanto riguarda le soluzioni di visione artificiale nel mondo reale, gli oggetti nelle immagini possono apparire a distanze e dimensioni diverse. I modelli di AI per la visione devono essere abbastanza robusti da rilevarli a prescindere da queste differenze.
Per migliorare l'adattabilità, si possono usare i seguenti metodi di aumento dei dati:
- Ridimensionamento: il ridimensionamento cambia le dimensioni dell'immagine mantenendone le proporzioni, consentendo ai modelli di AI di rilevare oggetti a distanze diverse.
- Ritaglio: rimuove le parti non necessarie di un'immagine, aiutando il modello a concentrarsi sulle aree chiave e riducendo le distrazioni dello sfondo.
- Inclinazione: inclinare leggermente un'immagine simula un aspetto obliquo o allungato, aiutando l'AI a riconoscere gli oggetti da angolazioni diverse.
Queste modifiche aiutano i modelli di visione artificiale a riconoscere gli oggetti anche se le dimensioni o la forma cambiano leggermente.
Modifiche della prospettiva e distorsioni#
Gli oggetti nelle immagini possono apparire diversi a seconda dell'angolazione della fotocamera, rendendo difficile il riconoscimento per i modelli di visione artificiale. Per aiutare i modelli a gestire queste variazioni, le tecniche di aumento dei dati possono modificare il modo in cui gli oggetti vengono rappresentati nelle immagini.
Per esempio, le trasformazioni prospettiche possono cambiare l'angolo di visualizzazione, facendo apparire un oggetto come se fosse visto da una posizione diversa. Questo permette ai modelli di AI per la visione di riconoscere gli oggetti anche quando sono inclinati o ripresi da un punto di vista insolito.
Un altro esempio è la trasformazione elastica, che allunga, piega o deforma le immagini per simulare distorsioni naturali, così che gli oggetti appaiano come nelle riflessioni o quando sono sottoposti a pressione.
Modifiche del colore e dell'illuminazione#
Le condizioni di illuminazione e le differenze di colore possono influire notevolmente sul modo in cui i modelli di AI per la visione interpretano le immagini. Poiché gli oggetti possono apparire diversi con impostazioni di illuminazione differenti, le seguenti tecniche di aumento dei dati possono aiutare a gestire queste situazioni:
- Modifiche di luminosità e contrasto: simulare diverse condizioni di illuminazione aiuta i modelli di AI per la visione a riconoscere gli oggetti sia negli ambienti luminosi sia in quelli bui.
- Variazione casuale dei colori: modificare casualmente tonalità, saturazione e bilanciamento dei colori rende i modelli di visione artificiale più adattabili a fotocamere e condizioni di illuminazione diverse.
- Conversione in scala di grigi: convertire le immagini in bianco e nero incoraggia i modelli di AI per la visione a concentrarsi sulle forme e sulle texture invece che sui colori.
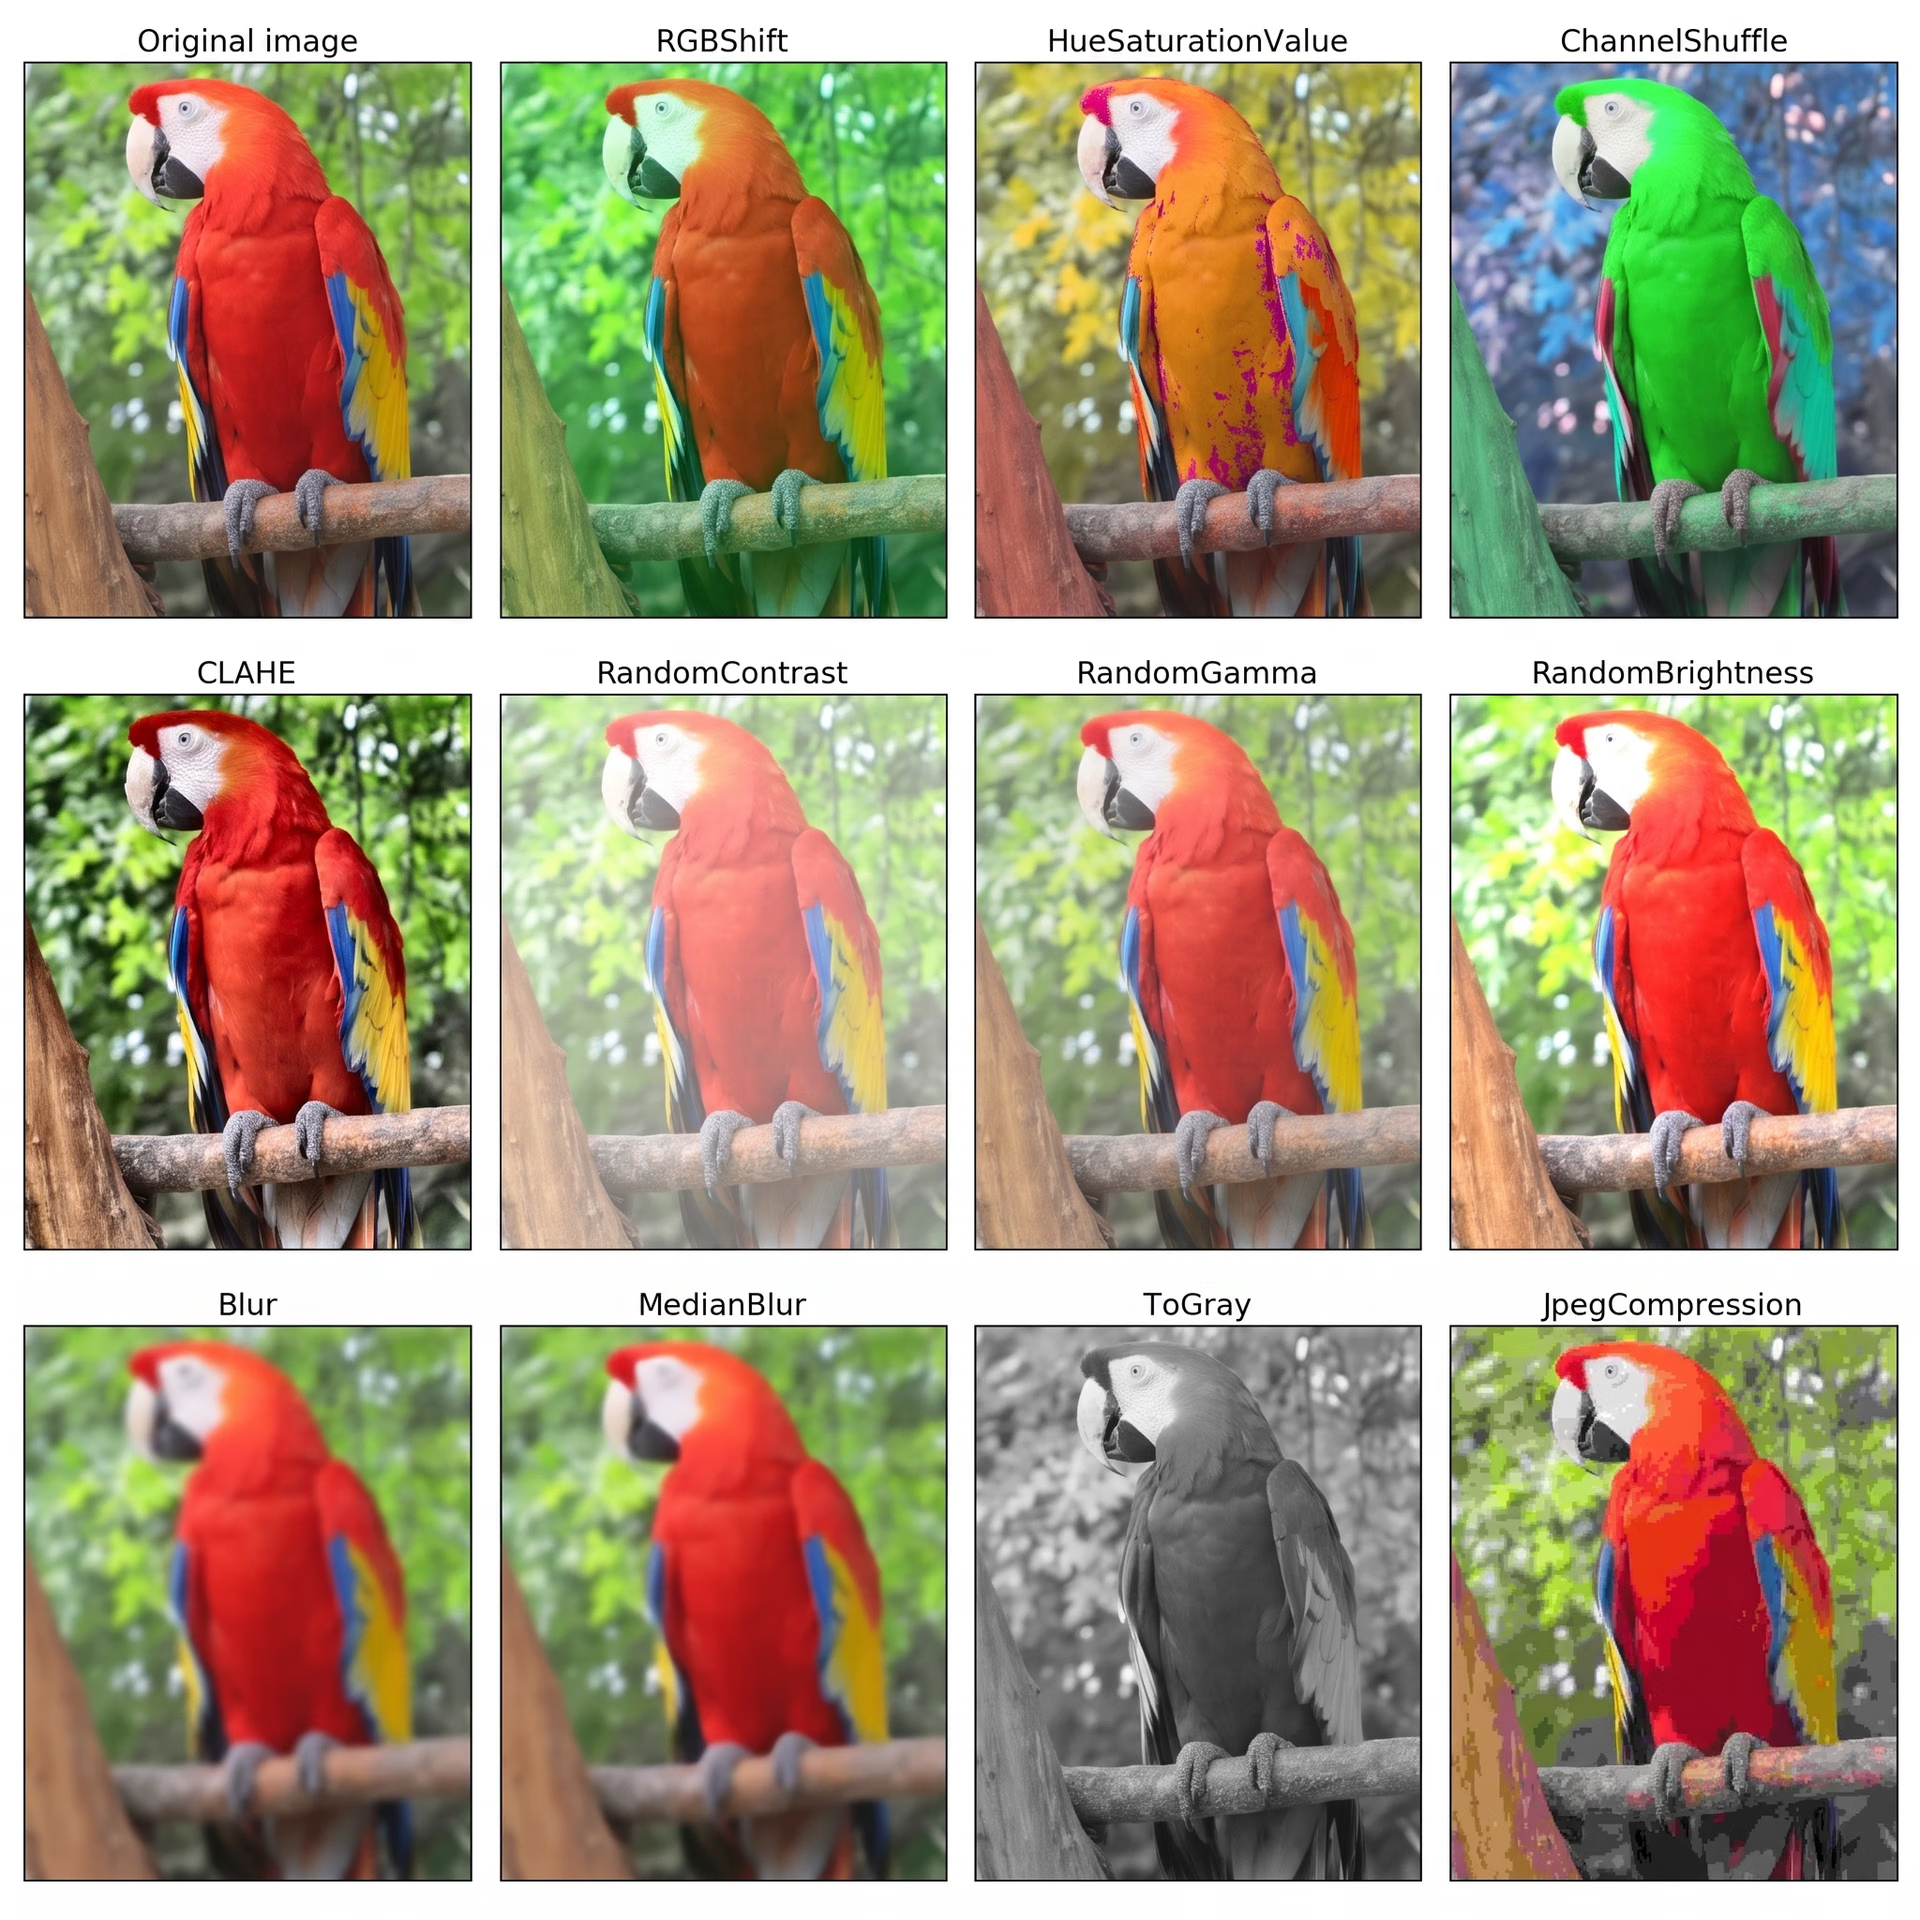
Fig. 3 Esempi di aumenti dei dati relativi alle variazioni di colore.
Tecniche avanzate di aumento dei dati delle immagini#
Finora abbiamo esaminato solo tecniche di aumento dei dati che modificano una singola immagine. Alcuni metodi avanzati, tuttavia, combinano più immagini per migliorare l'apprendimento dell'AI.
Per esempio, MixUp fonde due immagini, aiutando i modelli di visione artificiale a comprendere le relazioni tra gli oggetti e migliorando la capacità di generalizzare in scenari diversi. CutMix fa un ulteriore passo avanti sostituendo una sezione di un'immagine con una parte di un'altra, permettendo ai modelli di apprendere da più contesti all'interno della stessa immagine. CutOut, invece, funziona diversamente: rimuove parti casuali di un'immagine, addestrando i modelli di AI per la visione a riconoscere gli oggetti anche quando sono parzialmente nascosti o coperti.
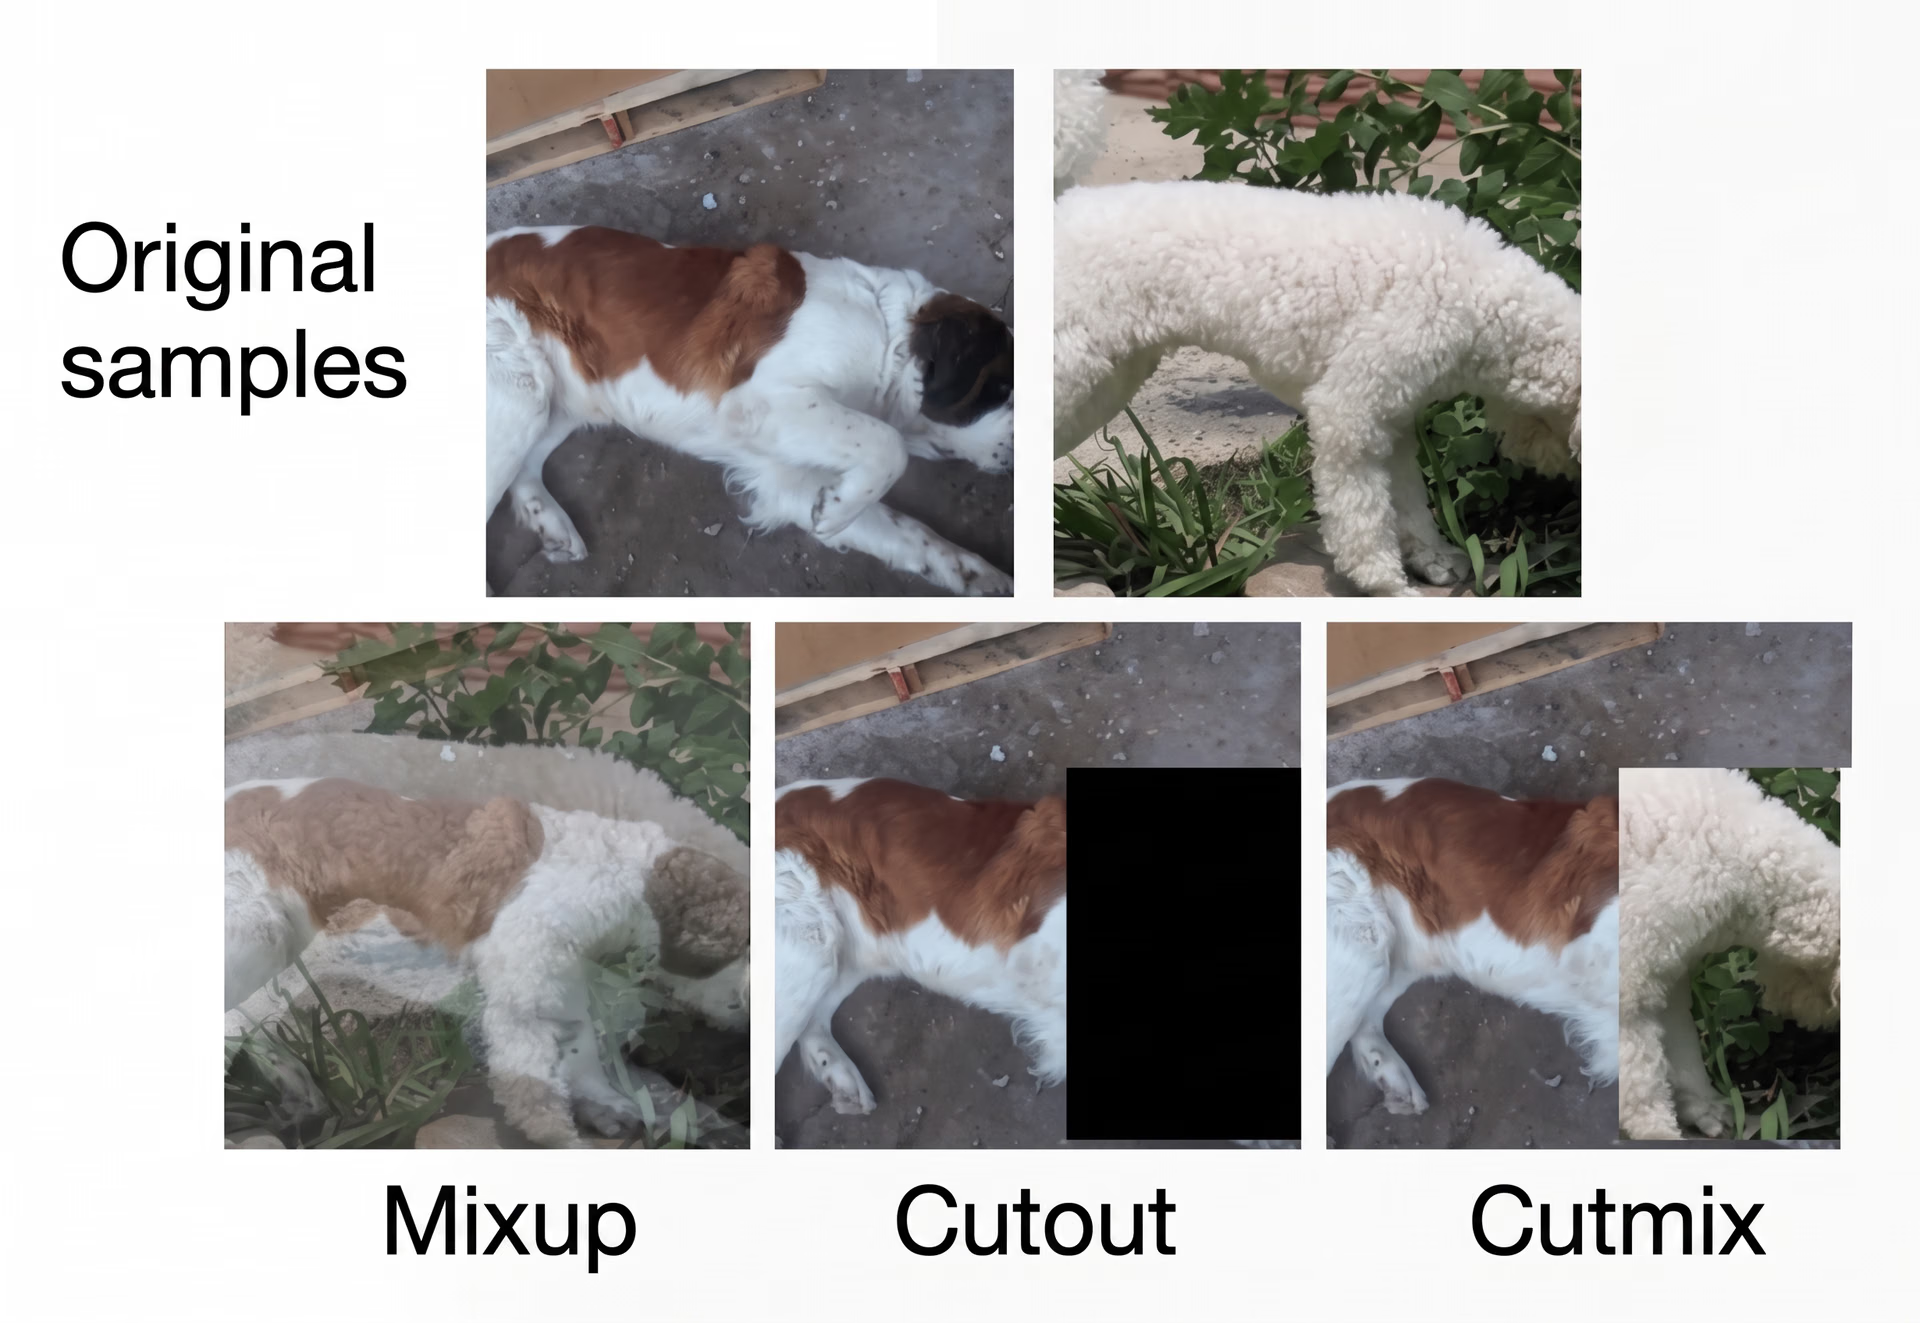
Fig. 4 Tecniche avanzate di aumento dei dati delle immagini.
Il ruolo dell'AI generativa nell'aumento dei dati delle immagini#
L'AI generativa si sta diffondendo in molti settori e nelle applicazioni di tutti i giorni. Probabilmente l'hai già incontrata sotto forma di immagini generate dall'AI, video deepfake o app che creano avatar realistici. Ma, oltre alla creatività e all'intrattenimento, l'AI generativa svolge un ruolo fondamentale nell'addestramento dei modelli di AI per la visione, generando nuove immagini a partire da quelle esistenti.
Invece di limitarsi a capovolgere o ruotare le immagini, può creare variazioni realistiche, modificando le espressioni del viso e gli stili di abbigliamento o persino simulando condizioni meteorologiche diverse. Queste variazioni aiutano i modelli di visione artificiale ad adattarsi meglio e a diventare più precisi in una varietà di scenari reali. I modelli avanzati di AI generativa, come le GAN (reti generative avversarie) e i modelli di diffusione, possono anche ricostruire i dettagli mancanti o creare immagini sintetiche di alta qualità.
Limiti dell'aumento dei dati delle immagini#
Sebbene l'aumento dei dati migliori i dataset di addestramento, ci sono anche alcuni limiti da considerare. Ecco alcune sfide importanti legate all'aumento dei dati delle immagini:
- Diversità limitata dei dati: le immagini aumentate derivano dai dati esistenti e non possono introdurre schemi del tutto nuovi o prospettive rare.
- Possibile distorsione dei dati: trasformazioni eccessive possono rendere le immagini irrealistiche e ridurre potenzialmente la precisione del modello negli scenari reali.
- Maggiore costo computazionale: l'aumento dei dati in tempo reale durante l'addestramento del modello può richiedere una notevole potenza di calcolo, rallentando l'addestramento e aumentando l'uso della memoria.
- Lo squilibrio tra classi rimane: l'aumento dei dati non crea campioni del tutto nuovi, quindi le categorie sottorappresentate possono continuare a causare un apprendimento distorto.
Un'applicazione reale dell'aumento dei dati delle immagini#
Un'applicazione interessante dell'aumento dei dati delle immagini riguarda le auto a guida autonoma, dove le decisioni prese in una frazione di secondo da modelli di visione artificiale come Ultralytics YOLO11 sono fondamentali. Il modello deve saper rilevare con precisione strade, persone e altri oggetti.
Tuttavia, le condizioni reali incontrate da un veicolo a guida autonoma possono essere imprevedibili. Il maltempo, la sfocatura da movimento e i cartelli nascosti possono rendere complesse le soluzioni di AI per la visione in questo settore. Spesso, addestrare i modelli di visione artificiale usando solo immagini del mondo reale non è sufficiente. I dataset di immagini per i modelli impiegati nelle auto a guida autonoma devono essere diversificati, affinché il modello impari a gestire situazioni impreviste.
L'aumento dei dati delle immagini risolve questo problema simulando la nebbia, regolando la luminosità e distorcendo le forme. Queste modifiche aiutano i modelli a riconoscere gli oggetti in condizioni diverse. Di conseguenza, i modelli diventano più intelligenti e affidabili.
Con l'addestramento su dati aumentati, le soluzioni di AI per la visione nelle auto a guida autonoma si adattano meglio e prendono decisioni più sicure. Risultati più precisi significano meno incidenti e una navigazione migliore.
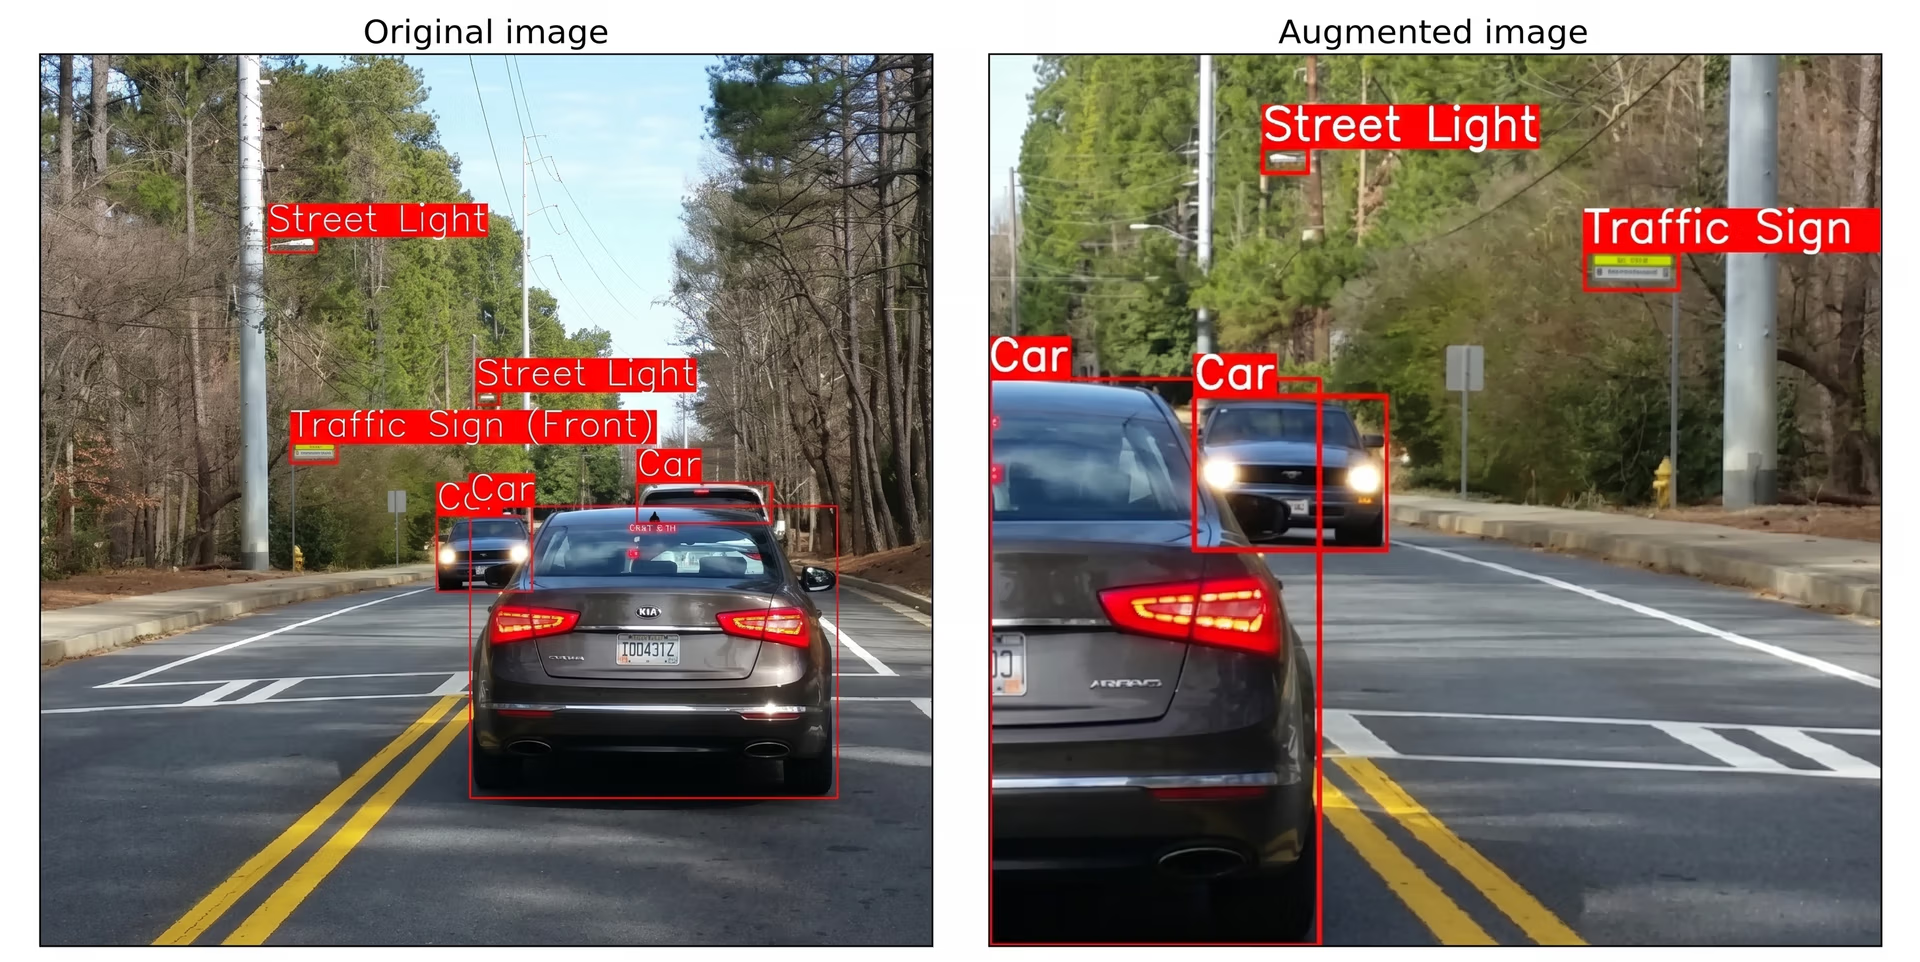
Fig. 5 Un esempio di aumento dei dati delle immagini applicato alle auto a guida autonoma.
Le auto a guida autonoma sono solo un esempio. In realtà, l'aumento dei dati delle immagini è fondamentale in un'ampia gamma di settori, dall'imaging medico all'analisi del commercio al dettaglio. Qualsiasi applicazione basata sulla visione artificiale può trarre potenzialmente vantaggio dall'aumento dei dati delle immagini.
Punti chiave#
I sistemi di AI per la visione devono poter riconoscere gli oggetti in condizioni diverse, ma raccogliere una quantità infinita di immagini del mondo reale per l'addestramento può essere difficile. L'aumento dei dati delle immagini risolve questo problema creando variazioni delle immagini esistenti, aiutando i modelli ad apprendere più rapidamente e a ottenere prestazioni migliori nelle situazioni reali. Migliora la precisione, assicurando che i modelli di AI per la visione come Ultralytics YOLO11 possano gestire illuminazioni, angolazioni e ambienti diversi.
Per aziende e sviluppatori, l'aumento dei dati delle immagini fa risparmiare tempo e fatica, rendendo al contempo più affidabili i modelli di visione artificiale. Dall'assistenza sanitaria alle auto a guida autonoma, molti settori ne dipendono. Con la continua evoluzione dell'AI per la visione, l'aumento dei dati continuerà a essere essenziale per creare modelli più intelligenti e adattabili in futuro.
Unisciti alla nostra community e visita il nostro repository GitHub per vedere l'AI in azione. Scopri le nostre opzioni di licenza e approfondisci l'AI in agricoltura e la visione artificiale nel settore manifatturiero nelle nostre pagine dedicate alle soluzioni.









