Che cos’è la stima monoculare della profondità? Panoramica
Scopri come funziona la stima monoculare della profondità, in cosa si differenzia dai metodi basati su sensori e come consente una percezione 3D scalabile nei sistemi di visione.
 Abirami Vina19 min di lettura
Le auto a guida autonoma sono progettate per capire cosa succede intorno a loro, così da poter guidare in sicurezza. Questo significa andare oltre il semplice riconoscimento di oggetti come pedoni o altri veicoli.
Devono anche sapere a quale distanza si trovano questi oggetti per poter reagire correttamente. Tuttavia, fornire alle macchine questa percezione della distanza non è semplice. A differenza degli esseri umani, non percepiscono naturalmente la profondità a partire dalle immagini e devono imparare esplicitamente a farlo.
Uno dei motivi è che la maggior parte delle fotocamere acquisisce il mondo come immagini piatte e bidimensionali. Trasformare queste immagini in qualcosa che rappresenti la profondità e la struttura 3D del mondo reale è complicato, soprattutto quando i sistemi devono funzionare in modo affidabile nelle condizioni quotidiane.
È interessante notare che la visione artificiale, un ramo dell’IA che si concentra sull’interpretazione e la comprensione dei dati visivi, consente alle macchine di comprendere meglio il mondo a partire dalle immagini. Per esempio, la stima della profondità monoculare è una tecnica di visione artificiale che stima la distanza degli oggetti usando l’immagine di una sola fotocamera.
Imparando indizi visivi come le dimensioni degli oggetti, la prospettiva, la texture e le ombre, questi modelli possono stimare la profondità senza fare affidamento su sensori aggiuntivi come LiDAR o telecamere stereo. In questo articolo vedremo cos'è la stima monoculare della profondità, come funziona e quali sono alcune delle sue applicazioni nel mondo reale.
Una breve introduzione alla stima della profondità monoculare#
La stima della profondità monoculare consente a una macchina di capire quanto sono distanti gli oggetti usando una sola immagine. Poiché si affida a una sola fotocamera, questo approccio offre diversi vantaggi, tra cui costi inferiori e requisiti hardware più semplici.
Per esempio, può essere utilizzata in robot domestici economici che funzionano con una sola fotocamera. Anche a partire da un’unica immagine, il sistema robotico può individuare quali pareti sono più vicine e quali porte più lontane e dedurre la profondità complessiva dello spazio.
Spesso una singola immagine non contiene informazioni sulla scala corretta, quindi la stima della profondità monoculare si concentra in genere sulla profondità relativa. In altre parole, può determinare quali oggetti sono più vicini e quali più lontani, anche se non se ne conoscono le distanze esatte.
Quando un modello viene addestrato su dati con distanze di riferimento o profondità assoluta, come le misurazioni della profondità ottenute da sensori quali LiDAR, può imparare a prevedere distanze in unità del mondo reale, come i metri. Senza questo tipo di dati di riferimento, il modello può comunque dedurre la profondità relativa, ma non stimare in modo affidabile le distanze assolute.
Il risultato della stima della profondità monoculare è in genere una mappa di profondità, cioè un’immagine in cui ogni pixel rappresenta quanto è vicina o lontana la porzione di scena corrispondente. Una mappa di profondità fornisce ai sistemi di visione una comprensione di base della struttura 3D dell’ambiente.
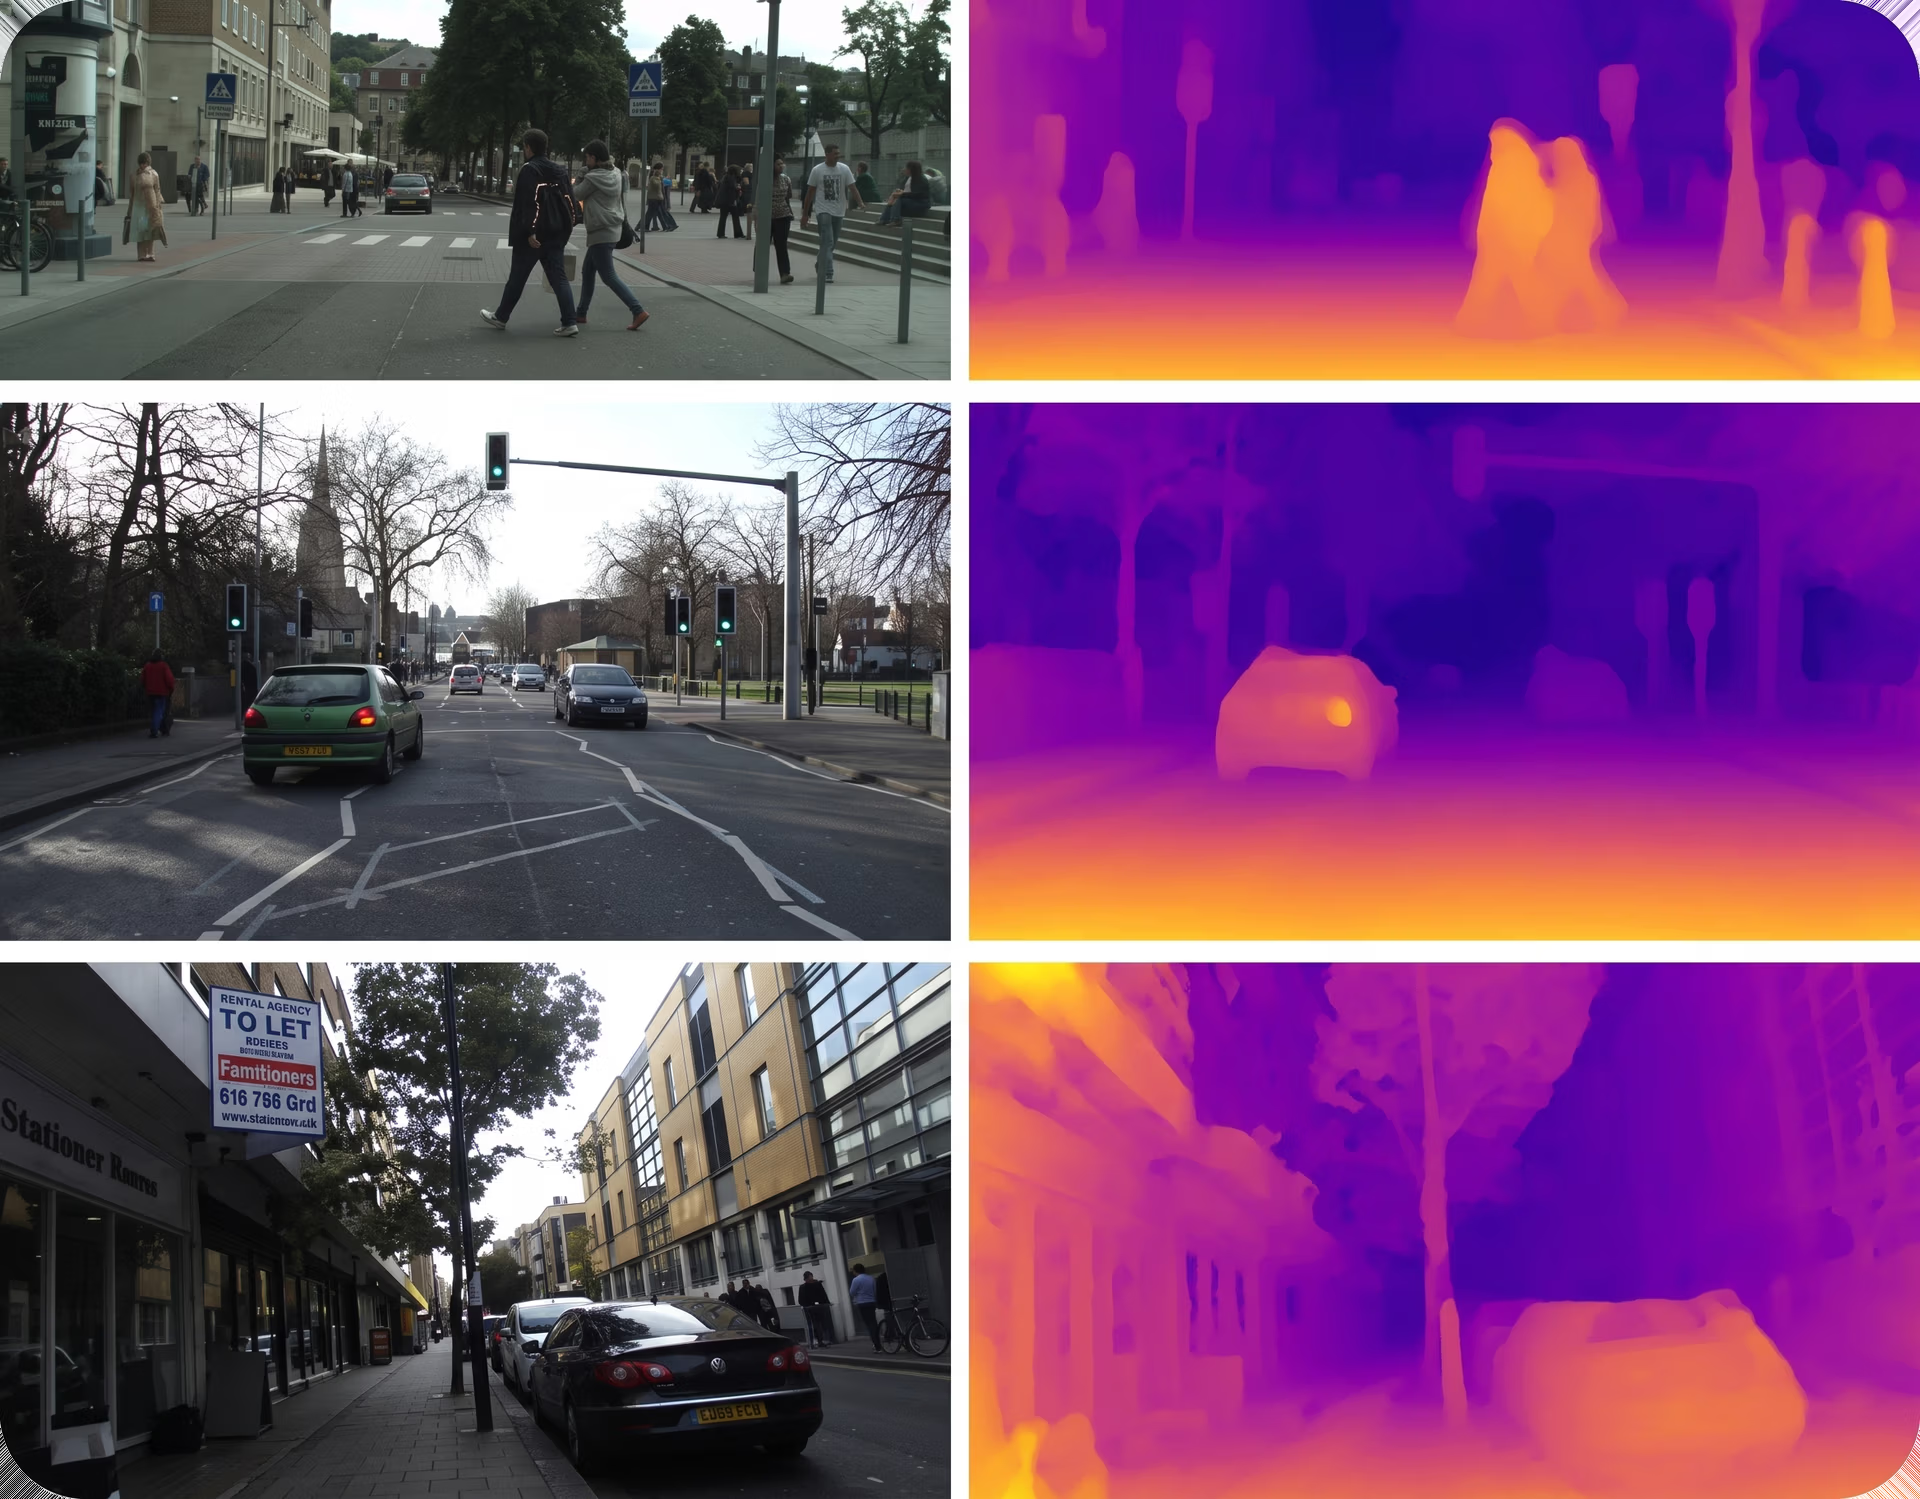
Fig. 1. Esempio di mappa di profondità prevista tramite stima della profondità monoculare (Fonte)
Dai sensori alle immagini: stimare la profondità#
La stima della profondità può essere affrontata in diversi modi, a seconda dei sensori disponibili, dei vincoli hardware e dei requisiti di precisione. I metodi tradizionali si basano spesso su più punti di vista o su sensori specializzati per misurare direttamente la distanza.
Un approccio comune è la visione stereo, che stima la profondità confrontando due immagini sincronizzate acquisite da punti di vista leggermente diversi. Misurando la differenza tra i punti corrispondenti nelle due immagini, il sistema può dedurre quanto sono lontani gli oggetti dalla fotocamera.
Un altro approccio è rappresentato dai sistemi RGB-D (rosso, verde, blu e profondità), che utilizzano sensori di profondità attivi per misurare direttamente la distanza in corrispondenza di ciascun pixel. Questi sistemi possono fornire informazioni precise sulla profondità in ambienti controllati, ma richiedono hardware aggiuntivo.
I metodi basati su LiDAR, invece, utilizzano impulsi laser per generare rappresentazioni tridimensionali precise di una scena. Pur essendo molto precisi, i sensori LiDAR sono spesso costosi e aumentano notevolmente la complessità hardware.
Al contrario, la stima della profondità monoculare deduce la profondità usando una sola immagine RGB. Poiché non dipende da più fotocamere o da sensori specializzati, è più facile da distribuire su larga scala ed è una buona opzione quando i costi e le risorse hardware sono limitati.
Imparare la profondità da una singola immagine#
Quando stimano la profondità da una singola immagine, i modelli monoculari imparano a riconoscere gli indizi visivi che gli esseri umani usano istintivamente per valutare le distanze. Tra questi indizi ci sono le linee prospettiche, le dimensioni degli oggetti, la densità delle texture, la sovrapposizione degli oggetti e le ombre: tutti elementi che suggeriscono quanto gli oggetti siano lontani dalla fotocamera.
Questi indizi contribuiscono insieme a creare una percezione della profondità. Gli oggetti che appaiono più piccoli o sono parzialmente occlusi si trovano spesso più lontano, mentre dettagli più nitidi e dimensioni apparenti maggiori suggeriscono in genere una posizione più vicina.
Per apprendere questi schemi, i modelli di profondità monoculari vengono addestrati su dataset di immagini su larga scala, spesso abbinati a informazioni sulla profondità ottenute da altre fonti, come LiDAR o sistemi stereo. Durante il training, i modelli imparano a correlare gli indizi visivi alla profondità, riuscendo così a dedurre la distanza da una singola immagine in fase di inferenza.
Con dati di training diversificati, i moderni modelli di visione possono generalizzare ciò che hanno imparato a un’ampia varietà di ambienti, incluse scene interne ed esterne, e gestire punti di vista mai incontrati prima.
Panoramica sulle diverse tecniche di stima della profondità monoculare#
Vediamo ora i principali approcci utilizzati per stimare la profondità da una singola immagine e come questi metodi si sono evoluti nel tempo.
Approcci classici e basati sulla geometria#
I primi metodi di stima della profondità si basavano su semplici regole visive legate alla geometria della fotocamera. Indizi come la prospettiva, le dimensioni degli oggetti e il fatto che un oggetto ne coprisse un altro venivano utilizzati per stimare la distanza.
Per esempio, quando due oggetti simili apparivano di dimensioni diverse, si presumeva che quello più piccolo fosse più lontano. Questi approcci funzionavano abbastanza bene in ambienti controllati, in cui fattori come l’illuminazione, la posizione della fotocamera e la disposizione della scena rimanevano costanti.
Tuttavia, nelle scene del mondo reale queste ipotesi spesso non reggono. Le variazioni di illuminazione, i cambiamenti del punto di vista e la maggiore complessità della scena possono produrre stime della profondità inaffidabili, limitando l’efficacia dei metodi classici in contesti non controllati.
I primi approcci di machine learning#
I primi metodi di machine learning hanno reso la stima della profondità più flessibile, imparando schemi direttamente dai dati. Invece di affidarsi solo a regole geometriche fisse, questi modelli cercavano di apprendere la relazione tra informazioni visive e distanza, trattando la previsione della profondità come un problema di regressione basato su indizi quali bordi, texture e variazioni di colore.
La selezione di queste caratteristiche era una parte fondamentale del processo. Gli ingegneri dovevano decidere quali segnali visivi estrarre e come rappresentarli, e le prestazioni del modello dipendevano molto da queste scelte.
Sebbene questo approccio funzionasse meglio dei metodi precedenti, aveva ancora dei limiti. Se le caratteristiche selezionate non fornivano un contesto importante, le previsioni della profondità erano meno accurate. Con l’aumento della complessità e della varietà delle scene, questi modelli faticavano spesso a produrre risultati affidabili.
Algoritmi di deep learning#
La maggior parte dei moderni sistemi di stima della profondità monoculare utilizza il deep learning, ovvero reti neurali con molti livelli capaci di apprendere schemi complessi dai dati. Questi modelli imparano a prevedere la profondità direttamente dalle immagini e a generare mappe di profondità.
Molti approcci si basano su reti neurali convoluzionali (CNN), un tipo di rete neurale progettato per elaborare immagini rilevando schemi come bordi e forme. Questi modelli utilizzano spesso una struttura encoder-decoder: l’encoder estrae caratteristiche visive dall’immagine e il decoder le converte in una mappa di profondità. Elaborare l’immagine a più scale aiuta il modello a cogliere la disposizione complessiva della scena e, al tempo stesso, a identificare con chiarezza i contorni degli oggetti.
I modelli più recenti si concentrano sulla comprensione delle relazioni tra le diverse parti di un’immagine. I modelli basati su Transformer e Vision Transformer (ViT) utilizzano meccanismi di attenzione, che permettono al modello di individuare le regioni più rilevanti dell’immagine e mettere in relazione aree distanti tra loro. Questo aiuta il modello a costruire una comprensione più coerente della profondità nell’intera scena.
Alcuni sistemi combinano entrambi gli approcci. I modelli ibridi CNN-Transformer usano le CNN per acquisire i dettagli locali più fini e i Transformer per modellare il contesto globale della scena. Questo spesso migliora la precisione, ma in genere richiede più risorse computazionali, come memoria e potenza di elaborazione aggiuntive.
Perché la comprensione della profondità è importante per i sistemi di IA visiva#
Approfondendo la stima della profondità monoculare, potresti chiederti perché la comprensione della profondità sia una componente così importante dei sistemi di IA basati sulla visione.
Quando un sistema riesce a stimare quanto sono distanti gli oggetti e le superfici, comprende meglio la disposizione della scena e le relazioni tra i suoi diversi elementi. Questa consapevolezza spaziale è essenziale per prendere decisioni affidabili, soprattutto in applicazioni del mondo reale come la guida autonoma.
Le informazioni sulla profondità aggiungono inoltre un contesto prezioso ad altre attività di visione artificiale. Per esempio, il rilevamento degli oggetti, supportato da modelli come Ultralytics YOLO26, può indicare a un sistema cosa è presente in una scena, mentre la profondità aiuta a capire dove si trovano quegli oggetti rispetto alla fotocamera e tra loro.
Insieme, queste capacità rendono possibili numerose applicazioni di IA visiva, come la creazione di mappe 3D, la navigazione in ambienti complessi e la comprensione della scena nel suo complesso.
I robot e i veicoli autonomi dipendono da queste informazioni per muoversi in sicurezza, evitare gli ostacoli e reagire ai cambiamenti in tempo reale. Per esempio, l’approccio di guida basata solo sulla visione di Tesla si affida a immagini delle fotocamere combinate con la stima della profondità, anziché a LiDAR, per capire quanto sono lontani gli oggetti e come sono posizionati sulla strada.
Come funzionano i modelli di stima della profondità monoculare#
Sebbene le architetture dei modelli siano diverse, la maggior parte dei modelli di stima della profondità monoculare segue un processo simile per convertire una singola immagine in una mappa di profondità. Ecco una breve panoramica dei passaggi principali:
- Input e pre-elaborazione: il workflow inizia con un’immagine di input. Prima di essere passata al modello, l’immagine originale viene di solito ridimensionata, normalizzata e convertita in un tensore, un formato che le reti neurali usano per elaborare i dati delle immagini in modo efficiente.
- Estrazione delle caratteristiche: una rete encoder analizza l’immagine per estrarre caratteristiche visive significative. Queste caratteristiche acquisiscono informazioni come le texture, i contorni degli oggetti e la disposizione complessiva della scena. La maggior parte dei modelli opera a più scale, così da comprendere sia i dettagli più fini sia la struttura globale.
- Ragionamento sulla profondità: utilizzando le caratteristiche estratte, il modello combina i dettagli locali con il contesto globale per dedurre le relazioni spaziali nella scena. In questa fase impara quali regioni dell’immagine sono più vicine alla fotocamera e quali più lontane.
- Generazione della mappa di profondità: un decoder converte quindi queste informazioni in una mappa di profondità densa. A ogni pixel dell’immagine viene assegnato un valore di profondità, spesso combinando le previsioni ottenute a scale diverse per migliorare precisione e coerenza.
Come vengono addestrati i modelli di stima della profondità monoculare#
Il processo appena descritto presuppone che disponiamo già di un modello addestrato o preaddestrato. Ma come si addestra concretamente un modello di stima della profondità monoculare?
Il training inizia con la preparazione dei dati delle immagini, affinché la rete possa elaborarli in modo efficiente. Le immagini di input vengono ridimensionate e normalizzate a una scala uniforme, quindi passate al modello, che genera una mappa di profondità stimata in cui è prevista la distanza per ogni pixel.
La mappa di profondità prevista viene quindi confrontata con i dati di profondità di riferimento tramite una funzione di loss, che misura quanto la previsione del modello si discosta dalla profondità reale. Questo valore di loss rappresenta l’errore corrente del modello e fornisce un segnale utile per migliorarlo.
Un ottimizzatore usa questo segnale per aggiornare il modello modificandone i pesi interni. A tal fine, calcola il gradiente, che descrive come cambia la loss rispetto a ciascun parametro del modello, e applica ripetutamente questi aggiornamenti nel corso di più epoche, ovvero passaggi completi sul dataset di training.
Questo processo iterativo di addestramento supervisionato è guidato da iperparametri come il tasso di apprendimento, che controlla l'ampiezza di ogni passo di aggiornamento, e la dimensione del batch, che determina quante immagini vengono elaborate contemporaneamente. Poiché l'addestramento comporta un gran numero di operazioni matematiche, viene in genere accelerato usando un'unità di elaborazione grafica (GPU), ideale per i calcoli paralleli.
Una volta completato il training, il modello viene valutato su un set di validazione, composto da immagini non utilizzate durante il training, applicando metriche di valutazione standard. Questa valutazione aiuta a misurare quanto bene il modello generalizza a nuovi dati.
Il modello addestrato può quindi essere riutilizzato o sottoposto a fine-tuning per nuovi scenari. Nel complesso, questo processo di training permette ai modelli di stima della profondità monoculare di produrre stime coerenti, essenziali per attività successive come la ricostruzione 3D e il deployment nel mondo reale.
Panoramica sui modelli all’avanguardia e sulle tendenze della ricerca#
La stima della profondità monoculare è migliorata rapidamente, man mano che i modelli sono diventati più capaci di comprendere le scene nel loro insieme anziché concentrarsi solo su piccoli dettagli visivi. I primi approcci producevano spesso mappe di profondità irregolari, soprattutto in ambienti complessi.
I modelli più recenti, come quelli presentati nelle ricerche pubblicate di recente su arXiv, si concentrano maggiormente sul contesto globale, producendo stime di profondità più stabili e realistiche. Modelli noti come MiDaS e DPT hanno contribuito a questo cambiamento, imparando a stimare la profondità da dataset diversi e ad alta risoluzione e generalizzando bene a molte scene.
Modelli più recenti, tra cui ZoeDepth e Depth Anything V2, sviluppano ulteriormente questo lavoro migliorando la coerenza della scala e mantenendo prestazioni elevate in un'ampia gamma di condizioni. I progressi di questo tipo vengono spesso misurati usando dataset di benchmark comuni come KITTI e NYU Depth V2, che includono scene sia esterne sia interne.
Una tendenza evidente è quella di bilanciare precisione e praticità. I modelli più piccoli sono ottimizzati per la velocità e possono funzionare in tempo reale su dispositivi edge o mobili, mentre i modelli più grandi puntano a una risoluzione superiore e a una maggiore precisione nella stima della profondità a lungo raggio. Ad esempio, i modelli Ultralytics YOLO26 per la stima della profondità spaziano dal leggero YOLO26n-depth, pensato per l'uso edge in tempo reale, al più grande e preciso YOLO26x-depth.
Applicazioni della stima della profondità monoculare#
Vediamo alcuni esempi del mondo reale che mostrano come si utilizza la stima della profondità monoculare per dedurre la struttura 3D di una scena a partire da una singola immagine.
In tutti questi casi è importante ricordare che le informazioni sulla profondità sono stime dedotte da indizi visivi, non misurazioni precise. La stima della profondità monoculare è quindi utile per comprendere la disposizione relativa e le relazioni spaziali, ma non sostituisce i sensori progettati per misurare accuratamente la distanza, come LiDAR o i sistemi stereo.
Mappatura del terreno e navigazione con droni#
I droni operano spesso in ambienti in cui i segnali GPS sono inaffidabili, come foreste, cantieri, zone colpite da calamità o aree urbane densamente popolate. Per volare in sicurezza in queste condizioni, devono comprendere il terreno circostante e sapere quanto sono lontani gli ostacoli. In passato, questo richiedeva in genere l’aggiunta di sensori come LiDAR o fotocamere stereo, che aumentano il peso, il consumo energetico e i costi complessivi.
La stima della profondità monoculare è un’alternativa più semplice. Usando una sola fotocamera RGB, i droni possono stimare la profondità dalle immagini e costruire una comprensione 3D di base dell’ambiente circostante. Questo permette loro di rilevare ostacoli come edifici e alberi o cambiamenti improvvisi del terreno e di modificare la traiettoria di volo in tempo reale.
Queste stime della profondità supportano attività di navigazione fondamentali, tra cui l’evitamento degli ostacoli, il controllo dell’altitudine e l’atterraggio in sicurezza. Di conseguenza, i droni leggeri possono svolgere attività di mappatura, ispezione e navigazione senza affidarsi a sensori di profondità specializzati.
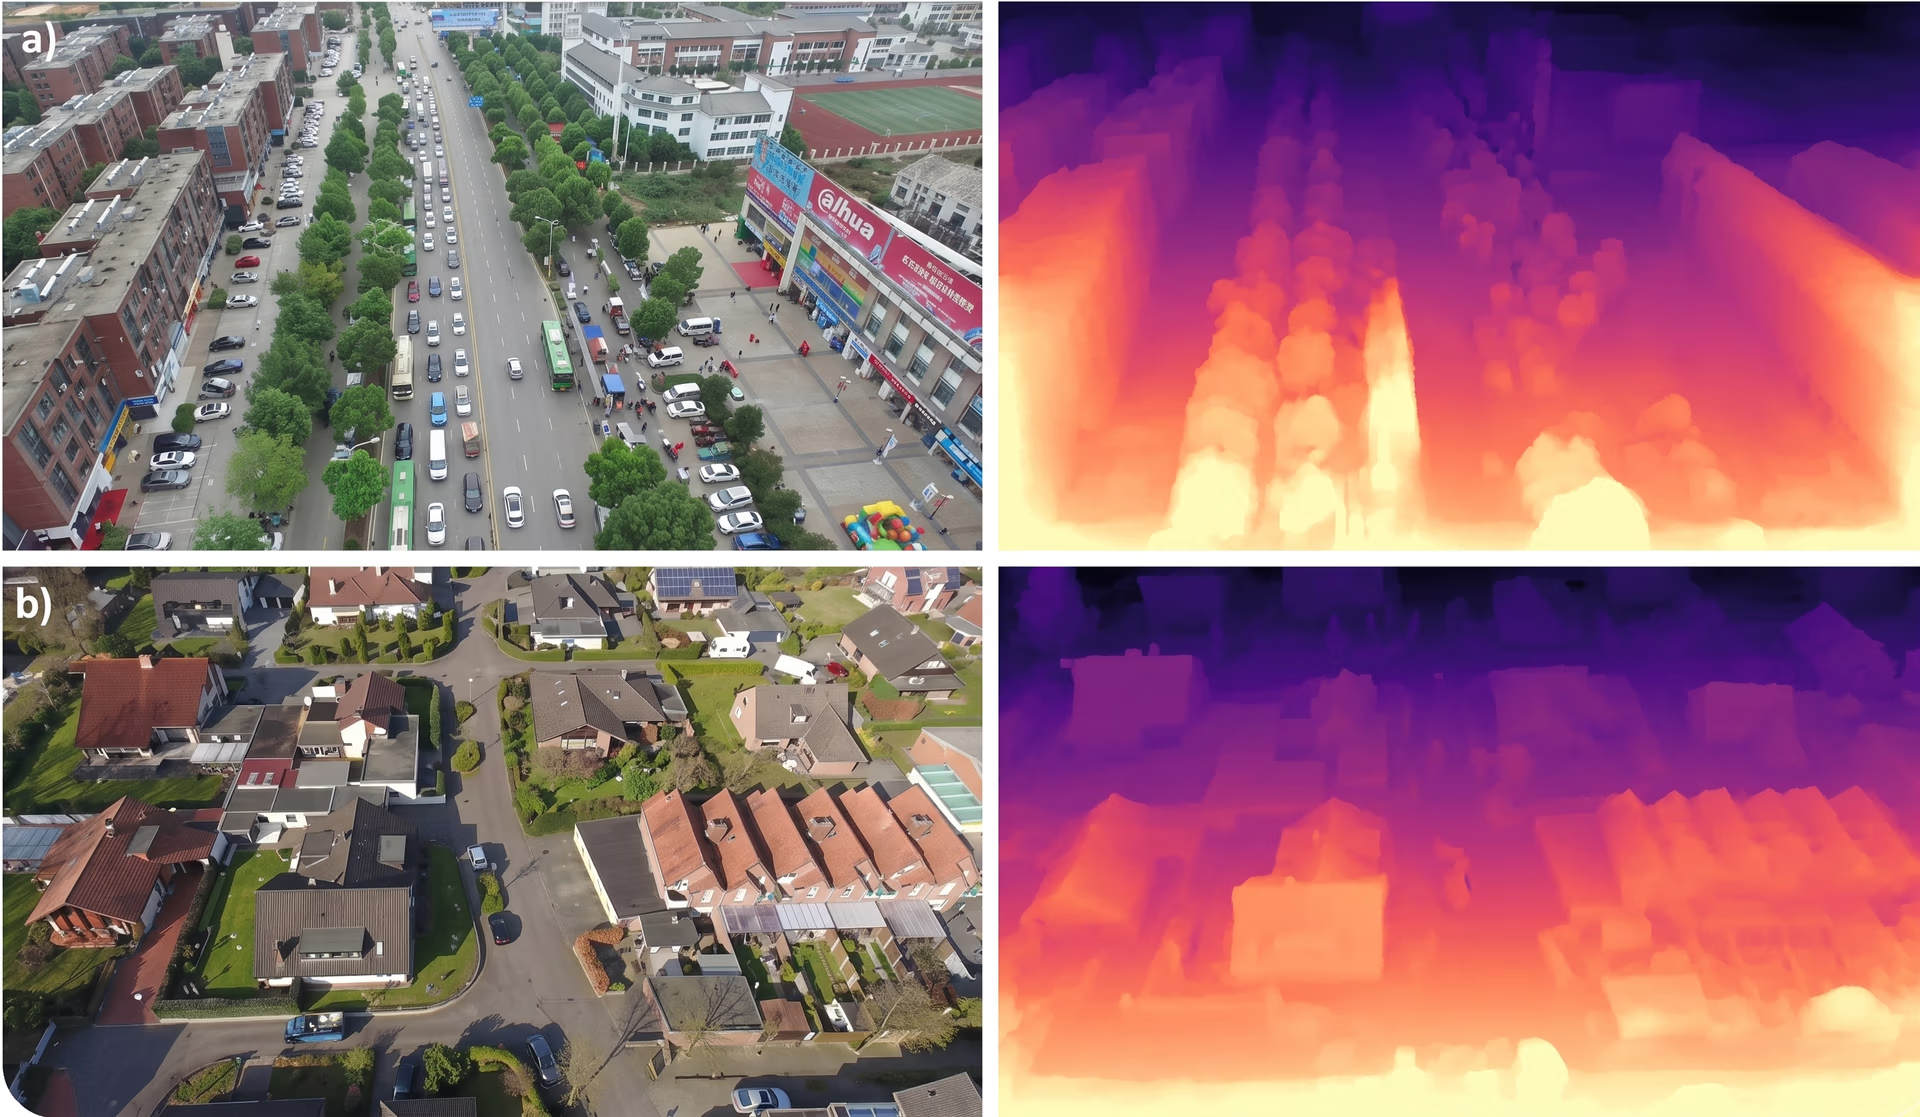
Fig. 2. La stima della profondità monoculare può essere usata per analizzare immagini acquisite da un drone (Fonte)
Colmare i punti ciechi dei veicoli da corsa autonomi#
I veicoli autonomi si affidano in genere molto ai sensori LiDAR, che utilizzano impulsi laser per misurare la distanza e costruire una rappresentazione 3D della strada. Pur essendo molto preciso, LiDAR può avere difficoltà in presenza di dossi con creste accentuate, pendenze ripide, occlusioni o improvvisi cambiamenti di inclinazione del veicolo, restituendo talvolta dati di profondità sparsi o mancanti.
La stima monoculare della profondità può aiutare a colmare queste lacune fornendo informazioni dense sulla profondità da una singola immagine RGB, anche quando i dati LiDAR sono incompleti. Considera uno scenario in cui un'auto a guida autonoma si avvicina ad alta velocità alla sommità di una collina. I raggi LiDAR possono oltrepassare la strada oltre la sommità, lasciando incertezza su ciò che si trova più avanti.
La stima della profondità basata su telecamera, tuttavia, può comunque inferire la forma della strada da indizi visivi come prospettiva e trama, aiutando il veicolo a mantenere una percezione affidabile finché i dati LiDAR non si stabilizzano. Insieme, LiDAR e stima monoculare della profondità consentono una percezione più stabile e un controllo più sicuro in condizioni di guida impegnative.
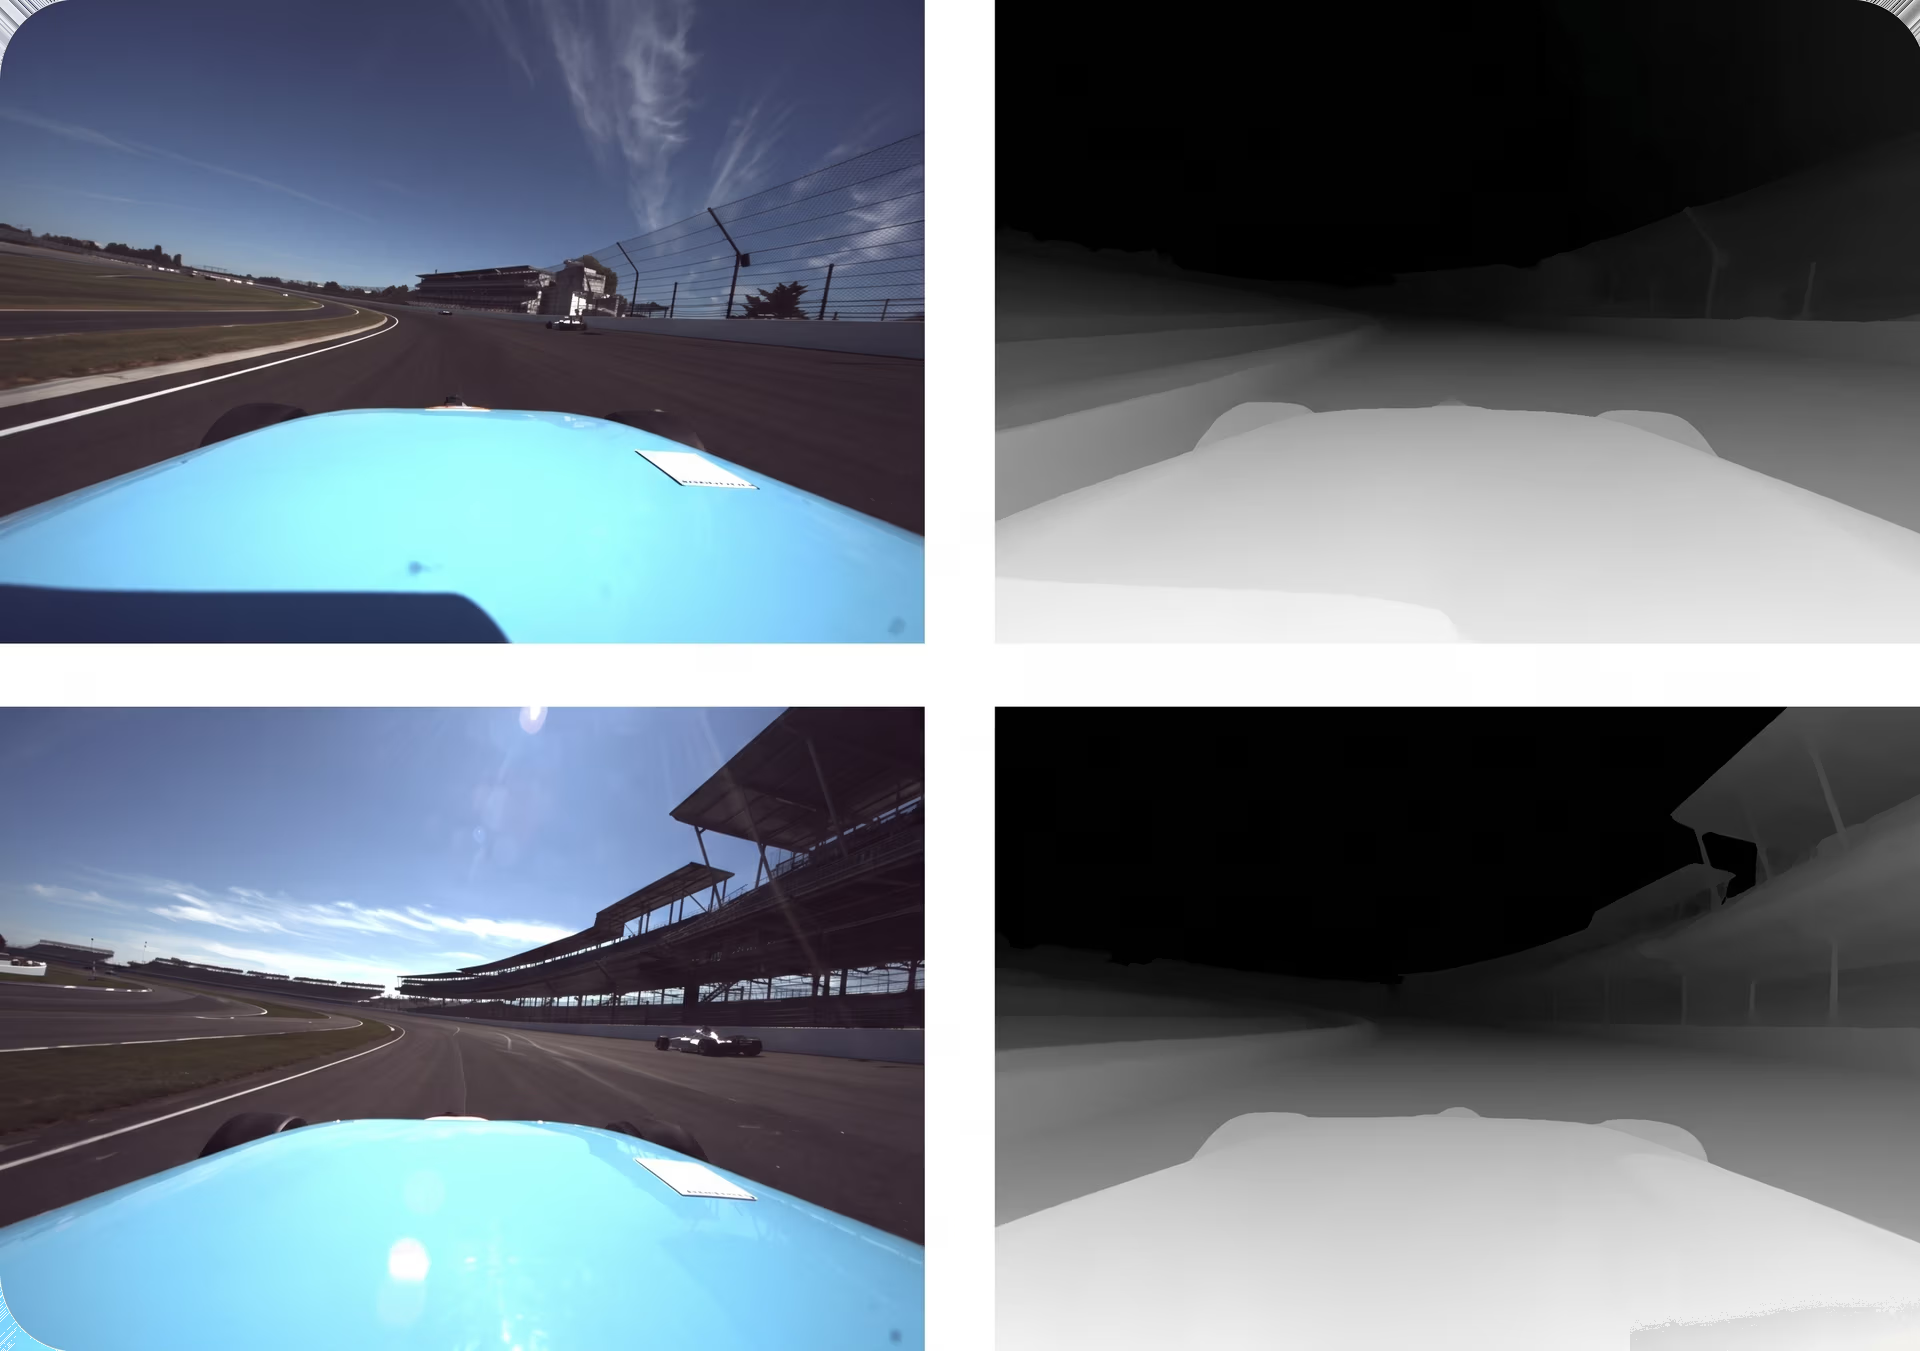
Fig. 3. Visualizzazione dell'uso della stima monoculare della profondità nelle gare automobilistiche autonome (Fonte)
Navigazione robotica ed evitamento degli ostacoli#
I robot vengono spesso utilizzati in luoghi in cui non sono disponibili mappe dettagliate e le condizioni cambiano continuamente. Per muoversi in sicurezza, devono sapere con affidabilità quanto spazio hanno intorno e dove si trovano gli ostacoli.
La stima monoculare della profondità può fornire questa consapevolezza spaziale usando una singola telecamera RGB, senza ricorrere a hardware ingombrante o costoso. Apprendendo indizi visivi come scala e prospettiva, i modelli di stima della profondità possono generare mappe dense della profondità dell'ambiente circostante. In questo modo, i robot possono determinare chiaramente la distanza da superfici e oggetti.
In particolare, combinando le informazioni sulla profondità con attività di computer vision come il rilevamento di oggetti e la segmentazione semantica, i robot possono ottenere una visione più completa dell'ambiente circostante. Possono identificare gli oggetti, comprenderne la distanza e decidere dove è sicuro muoversi. Questo consente di evitare gli ostacoli, rilevare gli spazi liberi e pianificare percorsi in tempo reale.
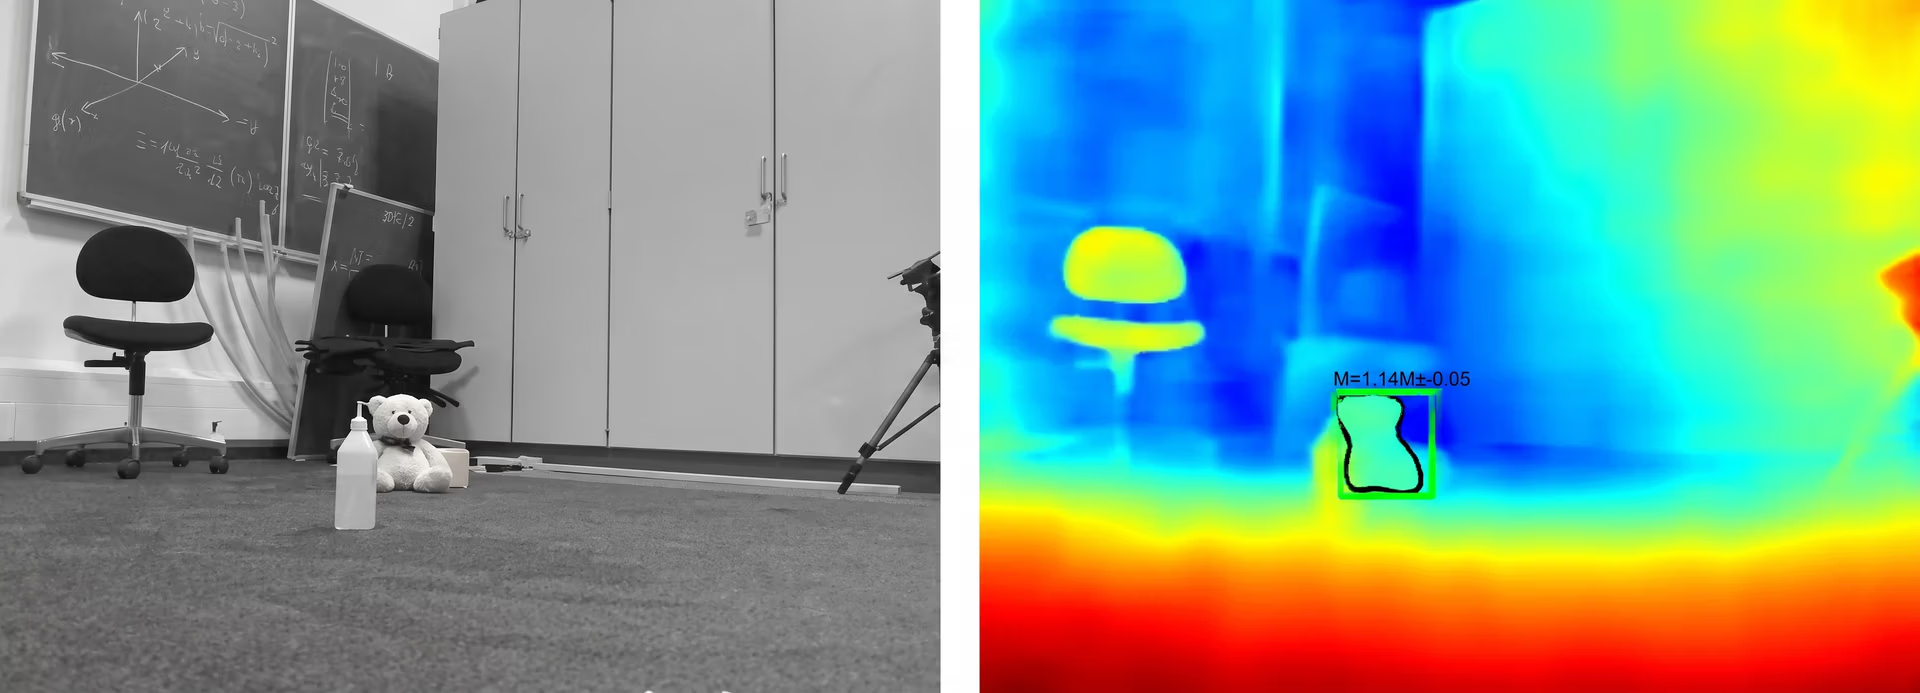
Fig. 4. Rilevamento di oggetti tramite stima monoculare della profondità e rilevamento degli oggetti (Fonte)
Vantaggi e svantaggi della stima monoculare della profondità#
Ecco alcuni dei principali vantaggi dell'uso della stima monoculare della profondità:
- Leggera ed efficiente dal punto di vista energetico: l'uso di una singola telecamera riduce il peso del sistema e il consumo energetico, un aspetto particolarmente importante per robot mobili, droni e sistemi embedded.
- Compatibile con la fusione dei sensori: la stima monoculare della profondità può integrare altri sensori, come LiDAR o radar, colmando le lacune o fornendo ridondanza.
- Funziona in molti ambienti: lo stesso approccio basato su telecamera può essere utilizzato in ambienti interni ed esterni e su piattaforme diverse, senza richiedere modifiche all'hardware.
La stima monoculare della profondità offre vantaggi evidenti, ma ecco alcuni limiti da considerare:
- Precisione inferiore rispetto ai sensori attivi: sebbene stia migliorando rapidamente, la stima monoculare della profondità in genere non può eguagliare la precisione assoluta di LiDAR o dei sensori a luce strutturata in condizioni controllate.
- Sensibilità alle condizioni di illuminazione: le prestazioni possono peggiorare in ambienti poco illuminati, in presenza di ombre marcate, riflessi o scene con trame poco definite.
- Difficoltà di generalizzazione: un modello addestrato in un ambiente potrebbe non adattarsi in modo affidabile a domini mai visti senza adattamento o fine-tuning.
Quando non affidarsi alla stima monoculare della profondità#
La stima monoculare della profondità è un interessante ambito di ricerca, ma è importante capire dove può essere usata concretamente e dove no. Le distanze che restituisce sono stime basate su ciò che il modello vede in un'immagine, non misurazioni esatte effettuate nel mondo reale.
Per questo motivo, la qualità dei risultati può variare in base a fattori come l'illuminazione, la complessità della scena e la sua somiglianza con quelle su cui il modello è stato addestrato. La stima monoculare della profondità è generalmente efficace nel determinare cosa è più vicino e cosa è più lontano, ma non è affidabile quando servono distanze esatte.
Quando la precisione è davvero fondamentale, come nei sistemi critici per la sicurezza, nelle ispezioni industriali o nei robot che devono interagire con gli oggetti con estrema precisione, la profondità deve essere misurata direttamente. Sensori come LiDAR, radar, telecamere stereo o sistemi a luce strutturata sono progettati a questo scopo e forniscono informazioni sulle distanze molto più affidabili.
La stima monoculare della profondità può incontrare difficoltà anche in condizioni visive complesse. Scarsa illuminazione, ombre marcate, superfici riflettenti o trasparenti, nebbia, fumo o scene con pochissime trame visive possono rendere meno affidabili le stime della profondità. Anche la stima della profondità a lunga distanza è un caso in cui in genere i sensori dedicati funzionano meglio.
Nelle soluzioni per il mondo reale, la stima monoculare della profondità funziona al meglio come strumento di supporto, non come soluzione autonoma. Può aggiungere un utile contesto spaziale, aiutare a colmare le lacune quando altri sensori sono limitati e migliorare la comprensione complessiva della scena. Tuttavia, non dovrebbe essere l'unica fonte di informazioni sulla profondità quando sono importanti la precisione, la sicurezza o requisiti rigorosi di affidabilità.
Punti chiave#
La stima monoculare della profondità è una tecnica di visione artificiale che consente alle macchine di stimare la distanza degli oggetti usando l'immagine di una sola telecamera. Apprendendo indizi visivi come prospettiva, dimensione degli oggetti, trama e ombreggiatura, questi modelli di IA possono inferire la struttura 3D di una scena senza ricorrere a sensori come LiDAR o telecamere stereo. Questo rende la stima monoculare della profondità un approccio conveniente e scalabile per applicazioni come la guida autonoma, la robotica e la comprensione delle scene 3D.
Per approfondire l'IA per la visione, visita il nostro repository GitHub e unisciti alla nostra community. Scopri le nostre pagine dedicate alle soluzioni per saperne di più sull'IA nella robotica e sulla visione artificiale nella produzione. Scopri le nostre opzioni di licenza per iniziare subito a usare la visione artificiale!
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









